

Ahoj, ľudia! Volám sa Oleg Anastasiev, pracujem v Odnoklassnikoch v tímu Platformy. Okrem mňa v Odnoklassnikoch pracuje množstvo hardvéru. Máme štyri dátové centrá, v ktorých je približne 500 stojanov s viac ako 8 000 servermi. V určitom momente sme si uvedomili, že zavedenie nového systému riadenia nám umožní efektívnejšie vyťažiť techniku, uľahčiť správu prístupov, automatizovať (re)alokáciu výpočtových zdrojov, urýchliť spustenie nových služieb a rýchlo reagovať na rozsiahle havárie.
Čo z toho vyšlo?
Okrem mňa a množstva hardvéru sú tu aj ľudia, ktorí s týmto hardvérom pracujú: inžinieri, ktorí sú priamo v dátových centrách; sieťové tímy, ktoré konfigurujú sieťové vybavenie; administrátori, alebo SRE, ktorí zabezpečujú odolnosť infraštruktúry; a tímy vývojárov, pričom každá z nich zodpovedá za časť funkcií portálu. Softvér, ktorý vytvárajú, funguje takto:
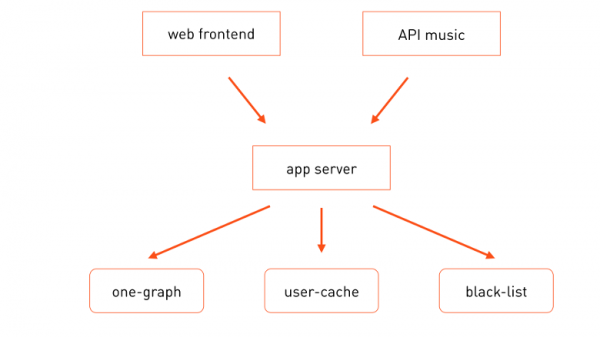
Požiadavky používateľov prichádzajú ako na fronty hlavného portálu , tak aj na iné, napríklad na fronty API hudby. Na spracovanie obchodnej logiky volajú server aplikácií, ktorý pri spracovaní žiadosti vykonáva potrebné špecializované mikroslužby — one-graph (graf sociálnych väzieb), user-cache (cache používateľských profilov) a podobne.
Každá z týchto služieb je nasadená na množstve strojov a každý z nich má zodpovedných vývojárov, ktorí sú zodpovední za fungovanie modulov, ich prevádzku a technologický rozvoj. Všetky tieto služby sa spúšťajú na fyzických serveroch a dovtedy sme spúšťali presne jedno zadanie na jeden server, teda bol špecializovaný na konkrétnu úlohu.
Prečo je to tak? Tento prístup mal niekoľko výhod:
- Jednoduchšie hromadné riadenie. Predpokladajme, že úloha vyžaduje nejaké knižnice, nejaké nastavenia. V takom prípade sa server priradí presne k jednej určitej skupine, opíše sa politika cfengine pre túto skupinu (alebo už bola opísaná) a táto konfigurácia sa centralizovane a automaticky nasadzuje na všetky servery tejto skupiny.
- Zjednodušuje sa diagnostika. Predpokladajme, že sledujete zvýšené zaťaženie procesora a uvedomujete si, že toto zaťaženie mohla vygenerovať len tá úloha, ktorá beží na tomto hardvérovom procesore. Hľadanie vinníka končí veľmi rýchlo.
- Zjednodušuje sa monitoring. Ak je so serverom niečo v neporiadku, monitor o tom informuje a vy presne viete, kto za to môže.
Službe, ktorá sa skladá z niekoľkých replik, je pridelených niekoľko serverov — po jednom na každú. Vtedy je priradenie výpočtových zdrojov pre službu veľmi jednoduché: koľko má služba serverov, toľko môže maximálne zdrojov využiť. 'Jednoduché' tu nie je v tom zmysle, že sa to ľahko používa, ale v tom, že pridelenie zdrojov prebieha ručne.
Takýto prístup nám tiež umožnil robiť špecializované hardvérové konfigurácie pre úlohu, ktorá beží na tomto serveri. Ak úloha uchováva veľké objemy údajov, používame 4U server s rámom na 38 diskov. Ak je úloha čisto výpočtová, môžeme kúpiť lacnejší 1U server. To je efektívne z hľadiska výpočtových zdrojov. Tento prístup nám tiež umožňuje používať štyrikrát menej strojov pri zaťažení, ktoré je porovnateľné s jednou priateľskou sociálnou sieťou.
Takáto efektívnosť využívania výpočtových zdrojov by mala zabezpečiť aj ekonomickú efektívnosť, ak vychádzame z predpokladu, že najdrahšie sú servery. Dlho bola najdrahšia práve technika, a my sme vložili veľa síl do znižovania jej ceny, vymýšľajúc algoritmy zabezpečenia odolnosti voči poruchám na zníženie požiadaviek na spoľahlivosť zariadení. A dnes sme sa dostali do fázy, v ktorej cena servera prestala byť určujúca. Ak nezohľadňujeme najnovšie exotiky, konkrétna konfigurácia serverov v stojane už nemá význam. Teraz máme iný problém — cena miesta, ktoré server zaberá v dátovom centre, t.j. miesta v stojane.
Keď sme si to uvedomili, rozhodli sme sa vypočítať, ako efektívne využívame stojany.
Zobrali sme cenu najvýkonnejšieho servera z ekonomického hľadiska, vypočítali, koľko takýchto serverov môžeme umiestniť do rackov, koľko úloh by sme na nich spustili na základe starej modely „jeden server = jedna úloha“ a ako efektívne by také úlohy mohli využiť hardvér. Vypočítali sme to — a vyplačeme sa. Ukázalo sa, že efektivita využitia rackov je u nás okolo 11 %. Záver je jasný: je potrebné zvýšiť efektivitu využívania dátových centier. Na prvý pohľad je riešenie jasné: treba na jednom serveri spustiť viacero úloh naraz. Ale tu začínajú problémy.
Hromadná konfigurácia sa výrazne komplikuje — teraz nie je možné priradiť serveru len jednu skupinu. Veď na jednom serveri môžu bežať viaceré úlohy z rôznych tímov. Navyše môže byť konfigurácia konfliktujúca pre rôzne aplikácie. Diagnostika je tiež zložitá: ak vidíte zvýšenú spotrebu procesorov alebo diskov na serveri, neviete, ktorá z úloh spôsobuje problémy.
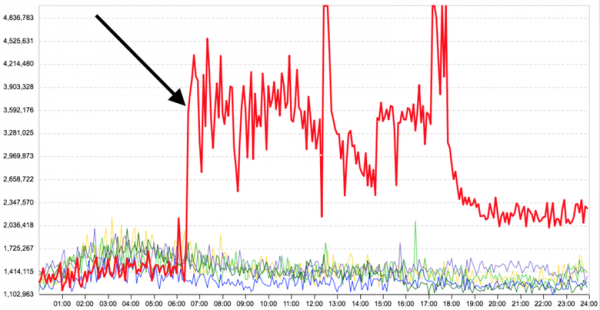
Ale najdôležitejšie je, že medzi úlohami spustenými na jednom stroji nie je izolácia. Napríklad, graf priemerného času odpovede serverovej úlohy pred a po tom, ako sa na tom istom serveri spustila ďalšia, s prvou nesúvisiaca výpočtová aplikácia — čas odpovede hlavnej úlohy sa výrazne zvýšil.
Je zrejmé, že úlohy treba spúšťať buď v kontejnere, alebo vo virtuálnych strojoch. Keďže takmer všetky úlohy sa u nás spúšťajú pod jednou operačnou sústavou (Linux) alebo sú na ňu prispôsobené, nie je potrebné podporovať množstvo rôznych operačných systémov. Podľa toho nie je potrebná virtualizácia, z dôvodu dodatočných režijných nákladov bude menej efektívna ako kontajnerizácia.
Ako implementácia kontajnerov na spúšťanie úloh priamo na serveroch je Docker skvelým kandidátom: obrazy súborových systémov dobre riešia problémy s conflictujúcimi konfiguráciami. Možnosť zostaviť obrazy z viacerých vrstiev nám umožňuje výrazne znížiť objem údajov potrebných na ich nasadenie v infraštruktúre, pričom spoločné časti sú vyčlenené do samostatných základných vrstiev. Tým pádom budú základné (a najobjemnejšie) vrstvy dostatočne rýchlo vyrovnávané v celej infraštruktúre a na dodanie mnohých rôznych typov aplikácií a verzií sa budú musieť prenášať iba malé objemné vrstvy.
Navyše, hotový registr a označovanie obrazov v Dockeri nám poskytujú základné primitívy pre verzionovanie a dodávanie kódu do produkcie.
Docker, rovnako ako akákoľvek iná podobná technológia, nám poskytuje určitú úroveň izolácie kontajnerov priamo z krabice. Napríklad, izolácia pamäte — každému kontajneru je priradený limit na používanie pamäte stroja, nad ktorú neprenikne. Rovnako je možné izolovať kontajnery podľa využitia CPU. Pre nás však bola štandardná izolácia nedostatočná. Ale o tom — nižšie.
Priame spúšťanie kontajnerov na serveroch je len časť problémov. Ďalšia časť súvisí s umiestnením kontajnerov na serveroch. Je potrebné zistiť, ktorý kontajner môže byť umiestnený na akom serveri. To nie je taká jednoduchá úloha, pretože kontajnery je potrebné umiestniť na serveroch čo najhustejšie, pričom by sa nemala znižovať rýchlosť ich práce. Takéto umiestnenie môže byť zložitým aj z hľadiska odolnosti voči zlyhaniu. Často chceme umiestňovať repliky tej istej služby do rôznych rackov alebo dokonca do rôznych sál dátového centra, aby sme pri zlyhaní racku alebo sály nestratili všetky repliky služby naraz.
Ručné rozdeľovanie kontajnerov nie je možnosť, keď máš 8 tisíc serverov a 8—16 tisíc kontajnerov.
Okrem toho sme chceli poskytnúť vývojárom viac samostatnosti pri rozdeľovaní zdrojov, aby si mohli sami umiestniť svoje služby do produkcie bez pomoci administrátora. Pri tom sme chceli zachovať kontrolu, aby nejaká vedľajšia služba nepoužila všetky zdroje našich dátových centier.
Je zrejmé, že potrebujeme riadiacu vrstvu, ktorá by sa týmto automaticky zaoberala.
Tu sme prišli k jednoduchému a prehľadnému obrazu, ktorý všetci architekti milujú: tri štvorec.
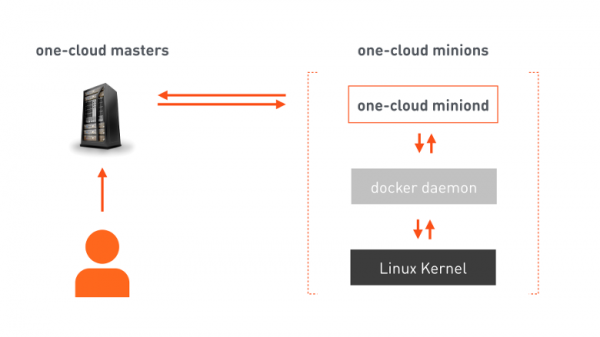
one-cloud masters — vysokodostupný klaster zodpovedajúci za orchestráciu cloudu. Vývojár odosiela do mastera manifest, v ktorom je obsiahnuté všetko potrebné na umiestnenie služby. Master na jeho základe vydáva príkazy vybraným minionom (strojom určeným na spúšťanie kontajnerov). Na minionoch je náš agent, ktorý prijíma príkaz, vydáva už svoje príkazy Dockeru, a Docker konfiguruje linuxový kernel na spustenie príslušného kontajnera. Okrem vykonávania príkazov agent neustále informuje mastera o zmenách stavu ako minionovej mašiny, tak aj spustených na nej kontajnerov.
Rozdelenie zdrojov
A teraz sa pozrime na úlohu zložitejšieho rozdelenia zdrojov pre množstvo minionov.
Výpočtový zdroj v one-cloud — to je:
- Výpočtový výkon procesora požadovaný konkrétnou úlohou.
- Objem pamäte dostupný úlohe.
- Sieťový prenos. Každý z minionov má konkrétny sieťový rozhranie s obmedzenou prenosovou schopnosťou, takže nie je možné rozdeľovať úlohy bez zohľadnenia objemu dát prenášaných cez sieť.
- Disky. Okrem, samozrejme, miesta pre dáta úlohy, tiež určujeme typ disku: HDD alebo SSD. Disky môžu obslúžiť konečné množstvo požiadaviek za sekundu — IOPS. Preto pre úlohy, generujúce viac IOPS, než môže jeden disk obslúžiť, rovnaké „spindles“ — t.j. diskové zariadenia, ktoré je potrebné výlučne rezervovať pre úlohu.
Potom pre niektorú službu, napríklad pre user-cache, môžeme zapísať požadované zdroje takto: 400 procesorových jadier, 2,5 TB pamäte, 50 Gbit/s prenosu v oboch smeroch, 6 TB miesta na HDD, umiestneného na 100 spindloch. Alebo v nám známejšej forme takto:
alloc:
    cpu: 400
    mem: 2500
    lan_in: 50g
    lan_out: 50g
    hdd:100x6T
Zdroje služby user-cache spotrebúvajú len časť všetkých dostupných zdrojov v produkčnej infraštruktúre. Preto chceme urobiť tak, aby náhle, z dôvodu chyby operátora alebo nie, user-cache nespotreboval viac zdrojov, než mu bolo pridelené. Teda musíme limitovať zdroje. Ale na čo by sme mohli viazať kvótu?
Vráťme sa k našej silne zjednodušenej schéme interakcie komponentov a prekreslime to s väčším množstvom detailov — takto:
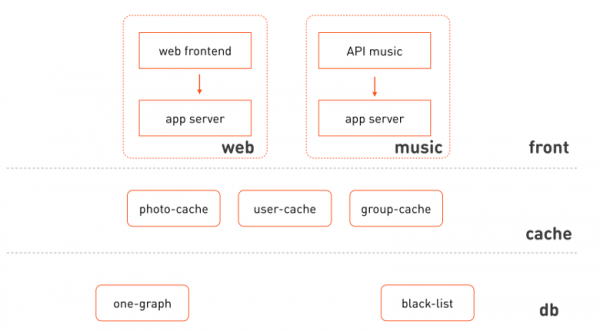
To, čo najviac udrie do očí:
- Webový frontend a hudba používajú izolované klastre toho istého aplikačného servera.
- Môžeme vyčleniť logické vrstvy, ku ktorým tieto klastry patria: fronty, cache, vrstva ukladania a správy údajov.
- Frontend nie je homogénny, sú to rôzne funkčné subsystémy.
- Cache môžeme tiež rozmiestniť podľa subsystému, ktorého údaje cacheujú.
Ešte raz prekreslíme obrázok:
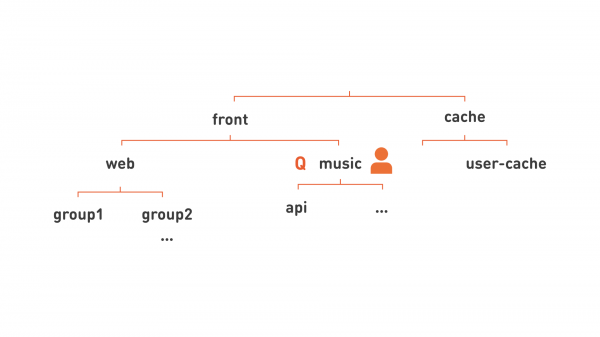
Hľa! Vidíme hierarchiu! To znamená, že môžeme rozdeľovať zdroje vo väčších celkoch: priradiť zodpovedného vývojára na uzol tejto hierarchie, ktorý zodpovedá funkčnému subsystému (ako «music» na obrázku), a k tomuto uzlu hierarchie priradiť kvótu. Takáto hierarchia nám tiež umožňuje flexibilnejšie organizovať služby pre pohodlie správy. Napríklad všetky webové servery, keďže je to veľmi veľká skupina serverov, delíme na niekoľko menších skupín, znázornených na obrázku ako group1, group2.
Zbavením sa nadbytočných čiar môžeme zapísať každý uzol nášho obrázka v plochšej forme: group1.web.front, api.music.front, user-cache.cache.
Tak dospejeme k pojmu „hierarchická fronta“. Má svoje meno, ako „group1.web.front“. Na ňu sa priraďuje kvóta na zdroje a práva používateľov. Osobe z DevOps poskytneme práva na zasielanie služby do fronty, a takýto zamestnanec môže spúšťať niečo vo fronte, zatiaľ čo osobu z OpsDev obdaríme administrátorskými právami, pričom teraz môže spravovať frontu, priraďovať do nej ľudí, dávať týmto ľuďom práva atď. Služby spustené v tejto fronte sa vykonávajú v rámci kvóty fronty. Ak je výpočtová kvóta fronty nedostatočná na súčasné vykonanie všetkých služieb, budú sa vykonávať postupne, čím sa vlastne vytvorí fronta.
Pozrime sa na služby podrobnejšie. Služba má celé meno, ktoré vždy obsahuje meno fronty. Tak služba webového frontu bude mať názov ok-web.group1.web.front. A služba aplikačného servera, na ktorú sa odkazuje, sa bude nazývať ok-app.group1.web.front. Každá služba má manifest, v ktorom sú uvedené všetky potrebné informácie na nasadenie na konkrétnych strojoch: koľko zdrojov táto úloha spotrebuje, aká konfigurácia je pre ňu potrebná, koľko replik by malo byť, vlastnosti na spracovanie chýb tejto služby. A po umiestnení služby priamo na strojoch sa objavujú jej inštancie. Tieto sú tiež jednoznačne pomenované – ako číslo inštancie a meno služby: 1.ok-web.group1.web.front, 2.ok-web.group1.web.front, …
To je veľmi pohodlné: len pohľadom na meno spusteného kontajnera môžeme okamžite zistiť veľa vecí.
A teraz sa bližšie zoznámime s tým, čo tieto inštancie vlastne vykonávajú: s úlohami.
Klasifikácia izolácie úloh
Všetky úlohy v OК (a pravdepodobne kdekoľvek inde) môžu byť rozdelené do skupín:
- Úlohy s krátkou latenciou – prod. Pre takéto úlohy a služby je veľmi dôležité oneskorenie odpovede (latencia), ako rýchlo bude každý z dopytov systémom spracovaný. Príklady úloh: webové fronty, cache, aplikačné servery, OLTP úložiská a pod.
- Výpočtové úlohy – batch. Tu na rýchlosti spracovania každého konkrétneho dopytu nezáleží. Pre nich je dôležité, koľko celkových výpočtov za určitý (veľký) časový úsek táto úloha vykoná (priepustnosť). Takéto budú akékoľvek úlohy MapReduce, Hadoop, strojové učenie, štatistika.
- Pozadie úlohy – idle. Pre takéto úlohy nie je dôležité ani latency, ani throughput. Sem patrí rôzne testovanie, migrácie, prepočty, konverzie dát z jedného formátu do druhého. Na jednej strane sú podobné výpočtovým, na druhej strane nám veľmi nezáleží na ich rýchlom dokončení.
Pozrime sa, ako tieto úlohy spotrebovávajú zdroje, napríklad centrálneho procesora.
Úlohy s krátkou latenciou. Úloha s takýmto modelom spotreby CPU bude vyzerať asi takto:
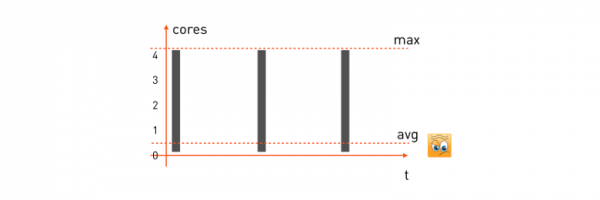
Na spracovanie sa prijíma dopyt od používateľa, úloha začne využívať všetky dostupné jadrá CPU, spracuje, vráti odpoveď, čaká na ďalší dopyt a stojí. Prišiel ďalší dopyt – opäť využila všetko, čo bolo, vypočítala, čakáme na ďalší.
Aby sme zaručili minimálne oneskorenie pre takúto úlohu, musíme vziať maximum spotrebovaných zdrojov a rezervovať potrebný počet jadier na minione (stroji, ktorý bude úlohu vykonávať). Potom bude rezervačná formula pre našu úlohu vyzerať takto:
alloc: cpu = 4 (max)A ak máme minion stroj so 16 jadrami, môžeme na ňom umiestniť presne štyri takéto úlohy. Osobitne zdôrazňujeme, že priemerná spotreba procesora týchto úloh je často veľmi nízka — čo je zrejmé, pretože väčšinu času úloha čaká na požiadavku a nič nerobí.
Výpočtové úlohy. Ich vzor bude o niečo odlišný:
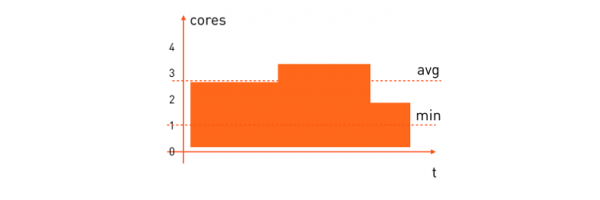
Priemerná spotreba procesorových zdrojov týchto úloh je dostatočne vysoká. Často chceme, aby výpočtová úloha bola vykonaná v určitom čase, preto je potrebné rezervovať minimálny počet procesorov, ktorý je potrebný na to, aby sa celý výpočet dokončil v prijateľnom čase. Jej rezervačná formula bude vyzerať takto:
alloc: cpu = [1,*)„Umiestni, prosím, na minione, kde je aspoň jedno voľné jadro, a ďalej koľko je — všetko zje.“
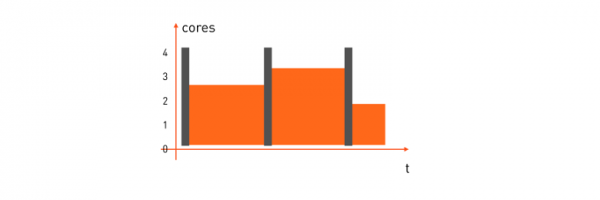
Tu je efektívnosť využitia už oveľa lepšia ako pri úlohách s krátkou latenciou. Ale zisk bude omnoho väčší, ak skombinujeme oba typy úloh na jednom minion stroji a budeme dynamicky rozdeľovať jej zdroje. Keď úloha s krátkou latenciou potrebuje procesor — dostane ho okamžite, a keď sú zdroje nepotrebné — prejdú na výpočtovú úlohu, t.j. nejako takto:
Ale ako to spraviť?
Pre začiatok sa pozrime na prod a jeho alloc: cpu = 4. Musíme rezervovať štyri jadra. V Docker run to môžeme urobiť dvoma spôsobmi:
- Pomocou voľby
--cpuset=1-4, t.j. priradiť úlohe štyri konkrétne jadra na stroji. - Použiť
--cpuquota=400_000 --cpuperiod=100_000, priradiť kvótu na procesorový čas, t.j. určiť, že každých 100 ms reálneho času úloha spotrebuje maximálne 400 ms procesorového času. Vzniknú tie isté štyri jadra.
Ale ktorý z týchto spôsobov sa hodí?
Cpuset vyzerá celkom atraktívne. Úloha má štyri vyhradené jadrá, čo znamená, že cache procesora bude fungovať maximálne efektívne. Má to však aj svoju odvrátenú stránku: museli by sme prevziať zodpovednosť za rozdelenie výpočtov medzi nezapojené jadrá stroja namiesto operačného systému, čo je dosť zložitá úloha, najmä ak sa pokúsime umiestniť na takýto stroj batch úlohy. Testy ukázali, že tu lepšie vyhovuje varianta s kvótou: tak má operačný systém väčšiu slobodu pri výbere jadra pre vykonanie úlohy v danom okamihu a procesorový čas sa rozdeľuje efektívnejšie.
Pozrime sa, ako v dockeri urobiť rezerváciu na minimálny počet jadier. Kvóta pre batch úlohy už nie je použiteľná, pretože obmedziť maximum nie je potrebné, stačí zaručiť minimum. A tu dobre vyhovuje možnosť docker run --cpushares.
Dohodli sme sa, že ak batch vyžaduje záruku minimálneho jedného jadra, uvedieme --cpushares=1024, a ak minimum na dve jadrá, uvedieme --cpushares=2048. Cpu shares nijako nezasahujú do rozdelenia procesorového času, pokiaľ je ho dostatok. Takže, ak prod momentálne nevyužíva všetky svoje štyri jadrá, batch úlohy nemajú žiadne obmedzenia a môžu využiť ďalší procesorový čas. Avšak v situácii nedostatku procesora, ak prod spotreboval všetky svoje štyri jadrá a narazil na kvótu, zostávajúci procesorový čas sa rozdelí proporcionálne podľa cpushares, t. j. v situácii troch voľných jadier jedno získa úloha s 1024 cpushares, a ostatné dve úlohy s 2048 cpushares.
Ale používanie kvóty a shares nestačí. Musíme zabezpečiť, aby úloha s krátkym oneskorením mala prioritu pred batch úlohou pri rozdelení procesorového času. Bez takejto prioritizácie bude batch úloha zaberajúca všetok procesorový čas v momente, keď je potrebný pre prod. V Docker run nie sú žiadne možnosti prioritizácie kontajnerov, ale prichádzajú na pomoc politiky plánovača centrálneho procesora v Linuxe. O nich sa dá podrobne prečítať , a v rámci tohto článku sa nimi prejdeme stručne:
- SCHED_OTHER
Predvolene získavajú všetky bežné používateľské procesy na Linuxovom stroji. - SCHED_BATCH
Určené pre náročné procesy. Pri umiestnení úlohy do procesora sa zavádza takzvaný trest za aktiváciu: taká úloha s menšou pravdepodobnosťou získa zdroje procesora, ak je v danom momente aktuálne používaná úlohou so SCHED_OTHER - SCHED_IDLE
Pozadie s veľmi nízkou prioritou, dokonca nižšou ako nice –19. Používame našu knižnicu s otvoreným kódom , aby sme nastavili požadovanú politiku pri spustení kontajnera volaním
one.nio.os.Proc.sched_setscheduler( pid, Proc.SCHED_IDLE )Ale aj keď neprogramujete v Jave, to isté môžete urobiť pomocou príkazu chrt:
chrt -i 0 $pidZhrnieme všetky naše úrovne izolácie do jednej tabuľky pre prehľadnosť:
Trieda izolácie
Príklad alloc
Možnosti Docker run
sched_setscheduler chrt*
Prod
cpu = 4
--cpuquota=400000 --cpuperiod=100000
SCHED_OTHER
Batch
Cpu = [1, * )
--cpushares=1024
SCHED_BATCH
Idle
Cpu= [2, *)
--cpushares=2048
SCHED_IDLE
*Ak vykonávate chrt zvnútra kontajnera, môže byť potrebná oprávnenie sys_nice, pretože Docker toto oprávnenie predvolene odníma pri spustení kontajnera.
Ale úlohy spotrebovávajú nielen procesor, ale aj prenos, ktorý má ešte väčší vplyv na oneskorenie sieťovej úlohy než nesprávne rozdelenie zdrojov procesora. Preto chceme mať obraz aj pre prenos. To znamená, že keď prod-úloha odosiela nejaké pakety do siete, obmedzujeme maximálnu rýchlosť (vzorec alloc: lan=[*,500mbps) ), s ktorou prod môže robiť. Pre batch garantujeme len minimálny prenos, ale neobmedzujeme maximálnu (vzorec alloc: lan=[10Mbps,*) ) V tomto prípade by mal mať prenos prod prioritu pred batch-úlohami.
Tu Docker nemá žiadne primitíva, ktoré by sme mohli použiť. Ale pomáha nám . Podarilo sa nám dosiahnuť požadovaný výsledok pomocou disciplíny . S jej pomocou vyčleňujeme dve triedy prenosu: vysoko-prioritný prod a nízko-prioritný batch/idle. Nakoniec konfigurácia pre odchádzajúci prenos vyzerá takto:
tu 1:0 — «korňová qdisc» disciplíny hsfc; 1:1 — podradená trieda hsfc s celkovým limitom priepustnosti 8 Gbit/s, pod ktorú spadajú podradené triedy všetkých kontajnerov; 1:2 — podradená trieda hsfc spoločná pre všetky batch a idle úlohy s „dynamickým“ limitom, o ktorom sa hovorí nižšie. Ostatné podradené triedy hsfc sú vyhradené triedy pre aktívne prod-kontajnery s limitmi, ktoré zodpovedajú ich manifestom, — 450 a 400 Mbit/s. Každej triede hsfc je pridelená qdisc fronta fq alebo fq_codel, v závislosti od verzie jadra linux, na zabránenie stratám paketov pri nárazoch v prevádzke.
Obvykle disciplíny tc slúžia na priorizáciu len odchádzajúcej prevádzky. Ale chceme priorizovať aj prichádzajúcu prevádzku, pretože nejaká batch-úloha môže ľahko využiť celý prichádzajúci kanál a získať tak veľký balík prichádzajúcich údajov pre map&reduce. Na to používame modul , ktorý vytvára virtuálne rozhranie ifbX pre každý sieťový rozhranie a presmerováva prichádzajúcu prevádzku z rozhrania do odchádzajúcej prevádzky na ifbX. Potom pre ifbX fungujú všetky tieto disciplíny na kontrolu odchádzajúcej prevádzky, pričom konfigurácia hsfc bude veľmi podobná:
Počas experimentov sme zistili, že najlepšie výsledky hsfc dosahuje, keď je trieda 1:2 neppriorizovanej batch/idle prevádzky obmedzená na strojoch-minionoch na nie viac ako určitú voľnú pásmo. Inak neppriorizovaná prevádzka príliš silno ovplyvňuje latenciu prod-úloh. Aktuálnu hodnotu voľného pásma miniond určuje každú sekundu, merajúci priemernú spotrebu prevádzky všetkými prod-úlohami daného miniona  a odčítava ju z priepustnosti sieťového rozhrania
 s malou rezervou, t.j.

Pásma sú určené pre prichádzajúcu a odchádzajúcu prevádzku nezávisle. A v súlade s novými hodnotami miniond rekonfiguruje limit neppriorizovanej triedy 1:2.
Takto sme implementovali všetky tri triedy izolácie: prod, batch a idle. Tieto triedy majú zásadný vplyv na výkon úloh. Preto sme sa rozhodli umiestniť tento atribút na vrchol hierarchie, aby pri pohľade na meno hierarchickej fronty bolo jasné, s čím máme dočinenia:
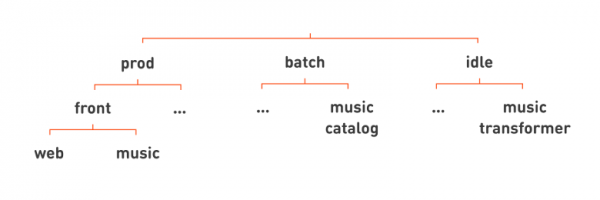
Všetky naše známe web a music fronty sú umiestnené v hierarchii pod prod. Pre príklad pod batch umiestnime službu music catalog, ktorý pravidelne zostavuje katalóg skladieb z množiny nahraných mp3 súborov na „Odnoklassniki“. Príkladom služby pre idle môže byť transformátor hudby, ktorý normalizuje úroveň hlasitosti hudby.
Opäť sme odstránili nadbytočné riadky, môžeme zapísať názvy našich služieb plochšie, dopísať triedu izolácie úlohy na koniec úplného názvu služby: web.front.prod, catalog.music.batch, transformer.music.idle.
A teraz, keď sa pozrieme na názov služby, chápeme nielen to, akú funkciu vykonáva, ale aj jej triedu izolácie, čo znamená, jej kritickosť a pod.
Všetko je skvelé, ale existuje jedna bolestná pravda. Úplne izolovať úlohy, ktoré bežia na jednom stroji, nie je možné.
Čo sa nám podarilo dosiahnuť: ak batch intenzívne spotrebováva iba procesorové zdroje, tak integrovaný plánovač CPU Linux si veľmi dobre plní svoju úlohu, a vplyv na prod-úlohu je takmer žiadny. Ale ak táto batch-úloha začne aktívne pracovať s pamäťou, vzájomný vplyv sa už prejavuje. Dôvodom je, že pri prod-úlohe sa „vysušujú“ procesorové cache pamäte — v dôsledku toho sa v cache zvyšujú zásahy, a procesor spracováva prod-úlohu pomalšie. Taká batch-úloha môže o 10 % zvýšiť oneskorenia našich typických prod-kontejnerov.
Izolovať prenos je ešte ťažšie, pretože moderné sieťové karty majú vnútornú frontu paketov. Ak paket od batch-úlohy sa dostane do fronty ako prvý, znamená to, že bude odoslaný po kábli ako prvý, a s tým sa nedá nič robiť.
Okrem toho sa nám zatiaľ podarilo riešiť iba problém prioritizácie TCP-prenosu: pre UDP prístup s hsfc nefunguje. A dokonca aj v prípade TCP-prenosu, ak batch-úloha generuje veľa prenosu, to tiež zvyšuje oneskorenie prod-úlohy o približne 10 %.
Odolnosť voči zlyhaniam
Jedným z cieľov pri vývoji one-cloud bolo zlepšiť odolnosť voči poruchám Odnoklassnikov. Preto by som sa rád podrobnejšie pozrel na možné scenáre zlyhania a havárie. Poďme začať s jednoduchým scenárom — so zlyhaním kontajnera.
Kontajner sám o sebe môže zlyhať niekoľkými spôsobmi. Môže to byť nejaký experiment, bug alebo chyba v manifeste, kvôli ktorej prod-úloha začne spotrebovávať viac zdrojov, než je uvedené v manifeste. Mali sme prípad: vývojár implementoval jeden zložitý algoritmus, veľa ráz ho prepracovával, až sa tak zamotával, že nakoniec úloha sa stala dosť netriviálne cyklickou. A keďže prod-úloha má vyššiu prioritu než všetky ostatné na rovnakých miniónoch, začala spotrebovávať všetky dostupné prostriedky procesora. V tejto situácii nás zachránila izolácia, skôr konkrétne kvóta na procesorový čas. Ak má úloha pridelenú kvótu, úloha nespotrebuje viac. Preto batch- a iné prod-úlohy, ktoré pracovali na tej istej mašine, si nič nevšimli.
Druhá možná nepríjemnosť — pád kontajnera. A tu nás zachraňujú politiky reštartu, s ktorými sú všetci oboznámení, Docker si s tým dokonale poradí. Takmer všetky prod-úlohy majú politiku reštartu always. Niekedy používame on_failure pre batch-úlohy alebo na ladenie prod-kontajnerov.
A čo môžeme urobiť v prípade nedostupnosti celého minióna?
Očividne spustiť kontajner na inom stroji. Najzaujímavejšie tu je, čo sa deje s IP adresou (adresami) pridelenými kontajneru.
Môžeme kontajnerom priraďovať rovnaké IP adresy, aké majú stroje-minióny, na ktorých sú tieto kontajnery spustené. Potom pri spustení kontajnera na inom stroji sa jeho IP adresa mení a všetci klienti musia pochopiť, že kontajner sa presťahoval, a teraz je potrebné navštevovať inú adresu, čo si vyžaduje samostatnú službu Service Discovery.
Service Discovery — to je praktické. Na trhu je veľa riešení s rôznou mierou odolnosti voči poruchám na organizáciu registra služieb. Často v takýchto riešeniach sa implementuje logika vyvažovača záťaže, uchovávanie dodatočnej konfigurácie vo forme KV-store atď.
Avšak, radi by sme sa obišli bez nutnosti zavádzania samostatného registra, pretože by to znamenalo zavedenie kritického systému, ktorý používajú všetky služby v produkcii. A to znamená, že je to potenciálny bod zlyhania, a treba vybrať alebo vyvinúť veľmi odolné riešenie, čo je očividne veľmi zložité, časovo náročné a drahé.
A ďalším veľkým nedostatkom je, že aby naša stará infraštruktúra fungovala s novou, museli by sme prepracovať všetky úlohy tak, aby využívali nejaký systém Service Discovery. Práce by bolo VEĽMI mnoho a miestami by to bolo takmer nemožné, keď ide o nízkoúrovňové zariadenia pracujúce na úrovni operačného systému alebo priamo so schopnosťami hardvéru. Implementácia tejto funkcionality prostredníctvom ustálených vzorov riešení, ako napríklad by v niektorých prípadoch znamenala dodatočné zaťaženie, v iných by to skomplikovalo prevádzku a vytvorilo nové scénáre zlyhania. Nechceli sme to komplikovať, preto sme sa rozhodli, že použitie Service Discovery bude voliteľné.
V one-cloud IP nasleduje za kontajnerom, t. j. každý prípad úlohy má svoju vlastnú IP adresu. Táto adresa je „statická“: je priradená každému prípadom pri prvom odoslaní služby do cloudu. Ak mala služba počas svojej existencie rôzne počty prípadov, tak v konečnom dôsledku bude mať pridelené toľko IP adries, koľko maximálne bolo prípadov.
Následne sa tieto adresy nemenia: sú priradené raz a pokračujú v existencii počas celej doby služby v produkcii. IP adresy sledujú kontajnery cez sieť. Ak sa kontajner presunie na iný minion, adresa sa presunie s ním.
Týmto spôsobom sa zmena mapovania mena služby na zoznam jej IP adries vyskytuje veľmi zriedka. Ak sa znova pozrieme na mená prípadov služby, o ktorých sme hovorili na začiatku článku (1.ok-web.group1.web.front.prod, 2.ok-web.group1.web.front.prod, …), všimneme si, že pripomínajú FQDN používané v DNS. A skutočne, na zobrazenie mien inštancií služieb v ich IP adresách používame DNS protokol. Tento DNS vráti všetky rezervované IP adresy všetkých kontajnerov — ako bežiacich, tak aj zastavených (povedzme, že sú použité tri repliky a máme tam päť rezervovaných adries — všetkých päť bude vrátených). Klienti, ktorí dostanú tieto informácie, sa pokúsia nadviazať spojenie so všetkými piatimi replikami — a tým zistia tie, ktoré fungujú. Tento spôsob určovania dostupnosti je oveľa spoľahlivejší, neúčastní sa v ňom ani DNS, ani Service Discovery, a teda sa neobjavujú ťažko riešiteľné úlohy s udržovaním aktuálnosti informácií a odolnosti týchto systémov. Viac než to, v kritických službách, od ktorých závisí fungovanie celého portálu, nemusíme DNS vôbec používať, ale jednoducho zasadiť do konfigurácie IP adresy.
Realizácia takéhoto prenosu IP za kontajnermi môže byť netriviálna — a zastavíme sa pri tom, ako to funguje, na nasledujúcom príklade:
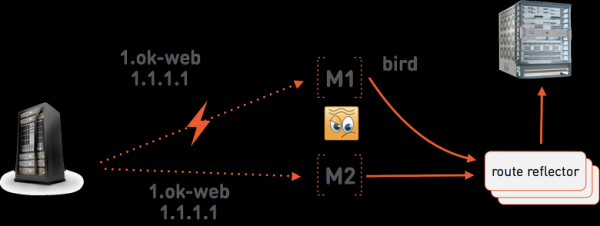
Predpokladajme, že majster one-cloud dá príkaz miniónovi M1 spustiť 1.ok-web.group1.web.front.prod s adresou 1.1.1.1. Na minióne beží , ktorý oznamuje túto adresu špeciálnym serverom . Tieto servery majú BGP reláciu so sieťovým zariadením, do ktorého sa prenáša cesta adresy 1.1.1.1 na M1. M1 už smeruje pakety do kontajnera pomocou prostriedkov Linuxu. Serverov route reflector je tri, pretože ide o veľmi kritickú časť infraštruktúry one-cloud — bez nich sieť v one-cloud nebude fungovať. Umiesťujeme ich do rôznych stojanov, pokiaľ možno umiestnených v rôznych miestnostiach dátového centra, aby sme znížili pravdepodobnosť súčasného zlyhania všetkých troch.
Predpokladajme teraz, že spojenie medzi majstrom one-cloud a miniónom M1 sa stratilo. Majster one-cloud teraz bude konať, vychádzajúc zo predpokladu, že M1 úplne zlyhal. Teda dá príkaz miniónovi M2 spustiť web.group1.web.front.prod s touto istou adresou 1.1.1.1. Teraz máme dva konfliktné trasy v sieti pre 1.1.1.1: na M1 a na M2. Na vyriešenie týchto konfliktov používame Multi Exit Discriminator, ktorý sa uvádza v BGP oznámení. Toto číslo udáva váhu oznamovanej trasy. Z konfliktných sa vyberie trasa s nižšou hodnotou MED. Master one-cloud podporuje MED ako integrálnu súčasť IP adries kontajnerov. Po prvýkrát sa adresa zapisuje s dostatočne vysokým MED = 1 000 000. V prípade havarijného presunu kontajnera master zníži MED, a M2 dostane pokyn oznámiť adresu 1.1.1.1 s MED = 999 999. Prípad, ktorý pracuje na M1, zostane bez pripojenia, a jeho ďalší osud nás veľmi nezaujíma do okamihu obnovenia pripojenia s masterom, kedy bude zastavený ako stará duplikát.
Havarie
Všetky systémy správy dátových centier prijateľne spracovávajú drobné poruchy. Vypadnutie kontajnera je bežné takmer všade.
Pozrime sa, ako spracovávame haváriu, napríklad výpadok elektrickej energie v jednej alebo viacerých miestnostiach dátového centra.
Čo znamená havária pre systém správy dátového centra? Predovšetkým to znamená masívny súčasný výpadok mnohých strojov, a systém správy musí súčasne migrovať veľké množstvo kontajnerov. Ak je havária veľmi rozsiahla, môže sa stať, že všetky úlohy nebudú môcť byť presunuté na iné minionky, pretože kapacita dátového centra klesá pod 100 % zaťaženia.
Havarie často sprevádza aj výpadok riadiacej vrstvy. K tomu môže dôjsť z dôvodu poruchy jej hardvéru, ale častejšie kvôli tomu, že havárie nie sú testované, a riadiaca vrstva sama zlyhá z dôvodu zvýšenej záťaže.
Čo s tým všetkým môžeme urobiť?
Masy migrácií znamenajú, že v infraštruktúre vzniká veľké množstvo operácií, migrácií a umiestnení. Každá migrácia môže trvať nejaký čas, potrebný na doručenie a rozbalenie obrazov kontajnerov na minionky, spustenie a inicializáciu kontajnerov atď. Preto je žiaduce, aby sa dôležitejšie úlohy spúšťali pred menej dôležitými.
Pozrime sa znova na nám známu hierarchiu služieb a pokúsme sa rozhodnúť, ktoré úlohy chceme spustiť ako prvé.
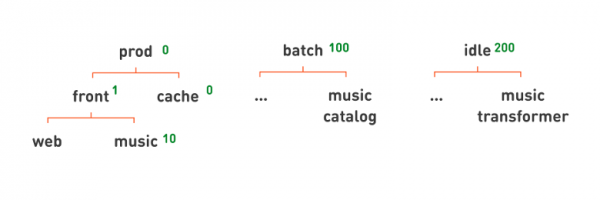
Samozrejme, sú to procesy, ktoré priamo zúčastňujú spracovania požiadaviek používateľov, t. j. prod. Uvádzame to pomocou prioritizácie umiestnenia — číslo, ktoré môže byť priradené frontu. Ak má nejaký front vyššiu prioritu, jeho služby sa umiestňujú ako prvé.
Na prod priraďujeme vyššie priority, 0; na batch — o niečo nižšie, 100; na idle — ešte nižšie, 200. Prioirty sa uplatňujú hierarchicky. Všetky úlohy nižšie v hierarchii budú mať zodpovedajúcu prioritu. Ak chceme, aby sa v rámci prod keš spúšťal pred frontendmi, priradíme priority cache = 0 a front podfronty = 1. Ak však napríklad chceme, aby z frontov sa najprv spúšťal hlavný portál a až potom music front, poslednému môžeme priradiť nižšiu prioritu — 10.
Ďalším problémom je nedostatok zdrojov. Takže sa nám pokazilo veľké množstvo zariadení, celé sály dátového centra, a spustili sme toľko služieb, že teraz na všetkých nie sú dostatočné zdroje. Je potrebné rozhodnúť, ktorými úlohami obetovať, aby fungovali hlavné kritické služby.
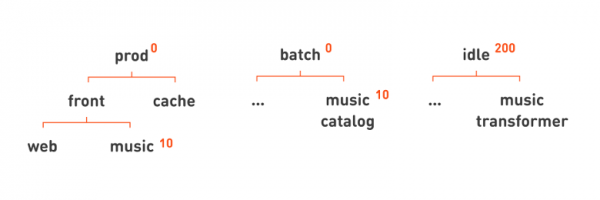
Na rozdiel od priority umiestnenia nemôžeme len tak obetovať všetky batch-úlohy, niektoré z nich sú dôležité pre fungovanie portálu. Preto sme osobitne vyčlenili prioritu vytláčania úloh. Pri umiestnení môže úloha s vyššou prioritou vytlačiť, t. j. zastaviť úlohu s nižšou prioritou, ak už nie sú k dispozícii žiadni voľní minioni. Úloha s nižšou prioritou pravdepodobne zostane neumiestnená, t. j. pre ňu už nebude vhodný minion s dostatkom voľných zdrojov.
V našej hierarchii je veľmi jednoduché určiť takú prioritu vytláčania, aby prod- a batch-úlohy vytláčali alebo zastavovali idle-úlohy, ale nie navzájom, priradením priority pre idle rovnej 200. Rovnako ako v prípade priority umiestnenia môžeme využiť našu hierarchiu na opisovanie zložitejších pravidiel. Napríklad určíme, že funkciou hudby obetujeme, ak nám bude chýbať zdroje pre hlavný webový portál, a priradíme nižšiu prioritu pre príslušné uzly: 10.
Havárie DЦ úplne
Prečo môže zlyhať celé dátové centrum? Živel. Bol dobrý príspevok, ako Elementom sú bezdomovci, ktorí raz zapálili optiku v kolektore, a dátové centrum úplne stratilo spojenie s ostatnými lokalitami. Príčinou výpadku môže byť aj ľudský faktor: operátor môže zadať príkaz, ktorý spôsobí pád celého dátového centra. K takýmto udalostiam môže dôjsť kvôli veľkej chybe. Všeobecne nie je nezvyčajné, že dátové centrá zlyhávajú – u nás sa to stáva každých niekoľko mesiacov.
A toto je to, čo robíme, aby nikto #okživí nepostoval na Twitteri.
Prvá stratégia - izolácia. Každý inštancia one-cloud je izolovaná a môže spravovať stroje len jedného dátového centra. To znamená, že strata cloudu kvôli chybám alebo nesprávnemu príkazu operátora znamená stratu iba jedného dátového centra. Sme na to pripravení: máme politiku rezervácie, v rámci ktorej sú repliky aplikácií a údajov umiestnené vo všetkých dátových centrách. Používame odolné databázy a pravidelne testujeme výpadky.
Keďže dnes máme štyri dátové centrá, existujú aj štyri samostatné, úplne izolované inštancie one-cloud.
Takýto prístup nielenže chráni pred fyzickým výpadkom, ale môže chrániť aj pred chybami operátora.
Čo ďalšie môžeme urobiť s ľudským faktorom? Keď operátor zadá cloudu nejaký zvláštny alebo potenciálne nebezpečný príkaz, môže byť náhle požiadaný, aby vyriešil malú úlohu, aby sa overilo, ako dobre o tom premýšľal. Napríklad, ak ide o hromadné zastavenie mnohých replik alebo proste divný príkaz - zníženie počtu replik alebo zmena názvu obrazu, a nie len čísla verzie v novom manifeste.
Zhrnutie
Charakteristické črty one-cloud:
- Hierarchická a prehľadná schéma pomenovania služieb a kontajnerov, ktorá umožňuje veľmi rýchlo zistiť, o akú úlohu ide, na čo sa vzťahuje a ako funguje a kto za ňu zodpovedá.
- Aplikujeme svoju techniku kombinácie prod- a batch-úloh na miniónoch, aby sme zvýšili efektivitu zdieľania strojov. Namiesto cpuset používame CPU kvóty, shares, politiky plánovača CPU a Linux QoS.
- Úplne izolovať kontajnery bežiace na jednom stroji sa nepodarilo, ale ich vzájomný vplyv zostáva v rozmedzí do 20%.
- Organizácia služieb do hierarchie pomáha pri automatickom odstránení havárií pomocou priorít umiestnenia a vytláčania..
ČASTO KLADENÉ OTÁZKY
Prečo sme si nevybrali hotové riešenie.
- Rôzne triedy izolácie úloh si vyžadujú rôznu logiku pri umiestňovaní na miniony. Ak je možné umiestniť prod-úlohy jednoduchým rezervovaním zdrojov, batch a idle je potrebné umiestniť tak, aby sa sledovala skutočná využiteľnosť zdrojov na strojoch-minionoch.
- Potrebnosť zohľadniť takéto zdroje spotrebovávané úlohami, ako sú:
- priepustnosť siete;
- typy a 'spindle' diskov.
- Potrebnosť uviesť priority služieb pri likvidácii havárií, práva a kvóty tímov na zdroje, čo sa rieši pomocou hierarchických front v one-cloud.
- Potrebnosť mať ľudské pomenovanie kontajnerov na skrátenie času reakcie na havárie a incidenty.
- Nemožnosť jednorazového celoplošného zavedenia Service Discovery; potreba dlhší čas koexistovať s úlohami umiestnenými na fyzických hostiteľoch — to, čo sa rieši „statickými“ IP adresami nasledujúcimi za kontajnermi, a taktiež potreba unikátnej integrácie s veľkou sieťovou infraštruktúrou.
Všetky tieto funkcie by si vyžadovali značné prestavby existujúcich riešení podľa seba a po zhodnotení množstva práce sme si uvedomili, že budeme schopní vyvinúť svoje vlastné riešenie približne s rovnakými nákladmi na prácu. Ale naše riešenie bude oveľa jednoduchšie na prevádzku a rozvoj — neobsahuje zbytočné abstrakcie, ktoré podporujú pre nás nepotrebnú funkcionalitu.
Tým, ktorí čítajú posledné riadky, - ďakujeme za trpezlivosť a pozornosť!
Zdroj: habr.com
