

Dekódovanie správy A. Lesovského z roku 2015 "Hlboký ponor do interných štatistík PostgreSQL"
Vyhlásenie autora správy: Poznamenávam, že táto správa je datovaná do novembra 2015 — uplynuli viac ako 4 roky a veľa času. Verzia 9.4 uvedená v správe už nie je podporovaná. Počas uplynulých 4 rokov bolo vydaných 5 nových verzií, v ktorých sa objavili mnohé novinky, vylepšenia a zmeny týkajúce sa štatistiky a časť materiálu je zastaraná a nie aktuálna. Počas revízie som sa snažil označiť tieto miesta, aby som ťa, čitateľ, nezmiatol. Písať toto však nebudem, je ich príliš veľa a nakoniec by vznikla úplne iná správa.
DBMS PostgreSQL je obrovský mechanizmus, pričom sa tento mechanizmus skladá z mnohých subsystémov, od koordinovanej práce ktorých priamo závisí výkonnosť DBMS. Počas prevádzky je zabezpečované zhromažďovanie štatistík a informácií o práci komponentov, čo umožňuje posúdiť efektívnosť PostgreSQL a prijať opatrenia na zvýšenie výkonu. Avšak týchto informácií je veľmi veľa a sú prezentované v pomerne zjednodušenej podobe. Spracovanie týchto informácií a ich interpretácia je občas celkom netriviálnou úlohou, a "zoologická záhrada" nástrojov a utilít môže ľahko zmiatiť aj pokročilého DBA.
Dobrý deň! Volám sa Alexej. Ako povedal Iľja, budem vám rozprávať o štatistike PostgreSQL.
Štatistika aktivity PostgreSQL. PostgreSQL má dve štatistiky. Štatistika aktivity, o ktorej bude reč. A štatistika plánovača o rozložení dát. Budem rozprávať práve o štatistike aktivity PostgreSQL, ktorá nám umožňuje posúdiť výkonnosť a nejakým spôsobom ju zlepšiť.
Poviem vám, ako efektívne využívať štatistiku na riešenie rôznych problémov, ktoré máte alebo môžu nastať.
Čo nebude v správe? V správe sa nebudem zaoberať štatistikou plánovača, pretože to je samostatná téma na samostatnú správu o tom, ako sú dáta uchovávané v databáze a ako plánovač dopytov získava predstavy o kvalitných a kvantitatívnych charakteristikách týchto dát.
A nebudú žiadne recenzie nástrojov, nebudem porovnávať jeden produkt s druhým. Nebude žiadna reklama. Odstráňme to.
Chcem vám ukázať, že používanie štatistiky je užitočné. Je to potrebné. Použiť ju nie je zlé. Potrebujeme len bežný SQL a základné znalosti o SQL.
A porozprávame sa, akú štatistiku vybrať na riešenie problémov.
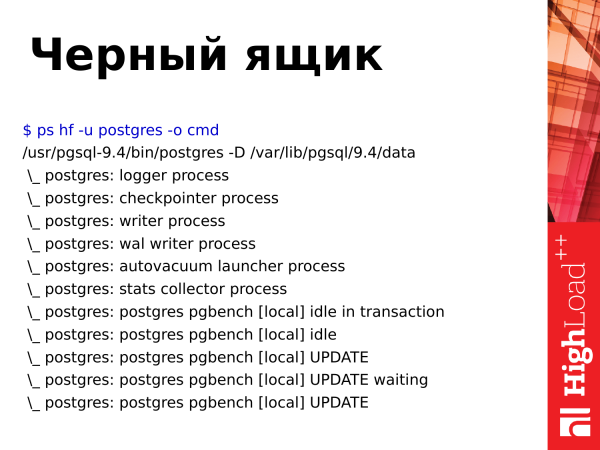
Ak sa pozrieme na PostgreSQL a v operačnom systéme spustíme príkaz na zobrazenie procesov, uvidíme "čiernu skrinku". Uvidíme nejaké procesy, ktoré niečo robia, a z názvu môžeme približne usúdiť, čo tam robia, čomu sa venujú. Ale v podstate ide o čiernu skrinku, dovnútra sa pozrieť nemôžeme.
Môžeme pozrieť zaťaženie procesora v top, môžeme sledovať vyťaženie pamäte pomocou systémových utilít, ale nazrieť dnu do PostgreSQL nemôžeme. Na to potrebujeme iné nástroje.
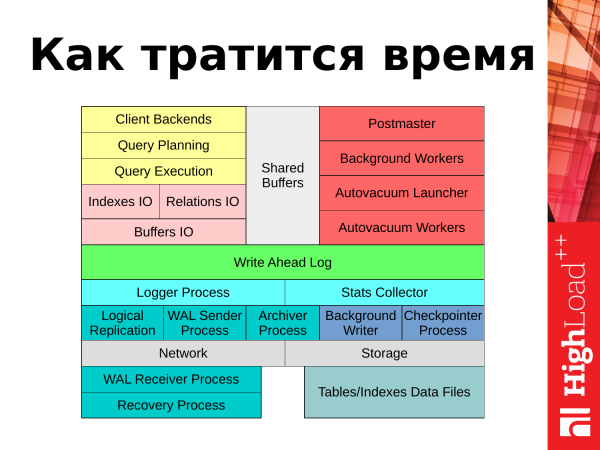
A pokračujúc ďalej, poviem vám, kam sa míňa čas. Ak si predstavíme PostgreSQL vo forme takéhoto schémy, môžeme odpovedať na otázku, kam sa míňa čas. Ide o dve veci: spracovanie klientských požiadaviek od aplikácií a pozadie úloh, ktoré PostgreSQL vykonáva na udržanie svojej funkčnosti.
Ak začneme preskúmavať z ľavého horného rohu, môžeme sledovať, ako sa spracovávajú klientské požiadavky. Požiadavka prichádza od aplikácie a na ďalšiu prácu sa otvorí klientská relácia. Požiadavka sa odovzdáva plánovaču. Plánovač zostaví plán požiadavky. Posiela ho ďalej na vykonanie. Dochádza k nejakému blokovému vstupu-výstupu údajov súvisiacim s tabuľkami a indexmi. Nezbytné údaje sa čítajú z diskov do pamäte do špeciálnej oblasti "shared buffers". Výsledky požiadavky, ak ide o aktualizácie, vymazania, sa zaznamenávajú do denníka transakcií v WAL. Niektoré štatistické informácie sa dostávajú do logu alebo do zberateľa štatistiky. A výsledok požiadavky sa odovzdáva späť klientovi. Po čom môže klient všetko zopakovať s novou požiadavkou.
Čo máme s pozadím úloh a pozadím procesov? Máme niekoľko procesov, ktoré zabezpečujú funkčnosť a udržiavajú databázu v normálnom pracovnom režime. Tieto procesy sa taktiež dotknú v prednáške: je to autovacuum, checkpointer, procesy súvisiace s replikáciou, background writer. Každého z nich budem spomínať v priebehu prednášky.
Aké problémy sú so štatistikou?
- Informácií je veľa. PostgreSQL 9.4 poskytuje 109 metrík na prezeranie štatistiky údajov. Avšak, ak sa v databáze nachádza veľa tabuliek, schém a databáz, všetky tieto metriky sa musia vynásobiť zodpovedajúcim počtom tabuliek a databáz. T. j. informácií sa stáva ešte viac. A je ľahké sa v nich utopiť.
- Nasledujúci problém je ten, že štatistika je prezentovaná spínačmi. Ak sa na túto štatistiku pozrieme, uvidíme neustále sa zvyšujúce spínače. A ak od okamihu resetovania štatistiky uplynulo veľmi veľa času, uvidíme miliardové hodnoty. A tie nám vôbec nič nehovoria.
- Chýba história. Ak sa vám stala nejaká porucha, niečo spadlo pred 15-30 minútami, nebude možné využiť štatistiku a pozrieť sa, čo sa dialo pred 15-30 minútami. To je problém.
- Absencia vstavaného nástroja v PostgreSQL je problém. Vývojári jadra neposkytujú žiadnu utilitu. Nemajú nič také. Jednoducho poskytujú štatistiku v databáze. Použite ju, urobte k nej dotaz, čo chcete, to robte.
- Keďže v PostgreSQL neexistuje vstavaný nástroj, to je dôvod ďalšieho problému. Množstvo externých nástrojov. Každá spoločnosť, ktorá má viac-menej zručných pracovníkov, sa snaží napísať svoj program. A nakoniec je v komunite veľmi veľa nástrojov, ktoré sa dajú použiť na prácu so štatistikou. A v niektorých nástrojoch sú jedny možnosti, v iných nástrojoch nie sú iné možnosti, alebo sú nejaké nové možnosti. A nastáva situácia, že treba používať dva-tri-štyri nástroje, ktoré sa prekrývajú a majú rôzne funkcie. To je veľmi nepríjemné.
Aký z toho vyplýva záver? Je dôležité vedieť brať štatistiku priamo, aby sme nespočívali na programoch, alebo nejako sami zlepšili tieto programy: pridať niektoré funkcie, aby sme dosiahli vlastný zisk.
A sú potrebné základné znalosti SQL. Aby ste získali nejaké údaje zo štatistiky, musíte zostaviť SQL dopyty, t. j. musíte vedieť, ako zostaviť select, join.
Štatistika nám ponúka niekoľko vecí. Môžeme ich rozdeliť do kategórií.
- Prvá kategória zahŕňa udalosti, ktoré sa odohrávajú v databáze. Ide o situácie, keď v databáze prebehne nejaká udalosť: dotaz, prístup k tabuľke, autovakuum, commity, toto všetko sú udalosti. Prislúchajúce tieto udalostiam, počítadlá sa inkrementujú. Môžeme sledovať tieto udalosti.
- Druhá kategória sa týka vlastností objektov ako sú tabuľky a databázy. Majú svoje vlastnosti, ako napríklad veľkosť tabuliek. Môžeme sledovať rast tabuliek, rast indexov. Môžeme posúdiť zmeny v dynamike.
- A tretia kategória je čas strávený na udalosti. Dotaz je udalosť. Má svoju konkrétnu mieru trvania. Tu sa spustil, tu sa skončil. Môžeme to sledovať. Rovnako aj čas čítania bloku z disku alebo zápisu. Takéto veci sú tiež sledované.
Zdroje štatistiky sú reprezentované nasledovne:
- Vo zdieľanej pamäti (shared buffers) je segment pre umiestnenie statických údajov, tam sú aj tie počítadlá, ktoré sa neustále inkrementujú, keď prebiehajú určité udalosti, alebo vznikajú nejaké momenty v práci databázy.
- Všetky tieto počítadlá nie sú prístupné používateľovi a dokonca ani administrátorovi. Tieto sú nízkorozmerové veci. Aby k nim bolo možné pristupovať, PostgreSQL poskytuje rozhranie v podobe SQL funkcií. Môžeme vykonať select výbery pomocou týchto funkcií a získať nejakú metriku (alebo súbor metrík).
- Avšak používanie týchto funkcií nie je vždy pohodlné, preto funkcie sú základom pre pohľady (VIEWs). Toto sú virtuálne tabuľky, ktoré poskytujú štatistiku o konkrétnom subsystéme alebo o určitom súbore udalostí v databáze.
- Tieto vstavané pohľady (VIEWs) sú hlavným používateľským rozhraním na prácu so štatistikou. Sú k dispozícii predvolene bez akýchkoľvek dodatočných nastavení, môžete ich okamžite používať, prezerať a získavať z nich informácie. Existujú aj contrib. Existujú oficiálne contrib. Môžete nainštalovať balík postgresql-contrib (napríklad postgresql94-contrib), načítať potrebný modul v konfigurácii, zadať preň parametre, reštartovať PostgreSQL a môžete používať. (Poznámka. V závislosti od distribúcie, v posledných verziách contrib balík je súčasťou hlavného balíka.).
- Existujú aj neoficiálne contrib. Nie sú súčasťou štandardnej dodávky PostgreSQL. Je ich potrebné buď skompilovať, alebo nainštalovať ako knižnicu. Možnosti môžu byť rôzne v závislosti od toho, čo vymyslel vývojár tohto neoficiálneho contribu.
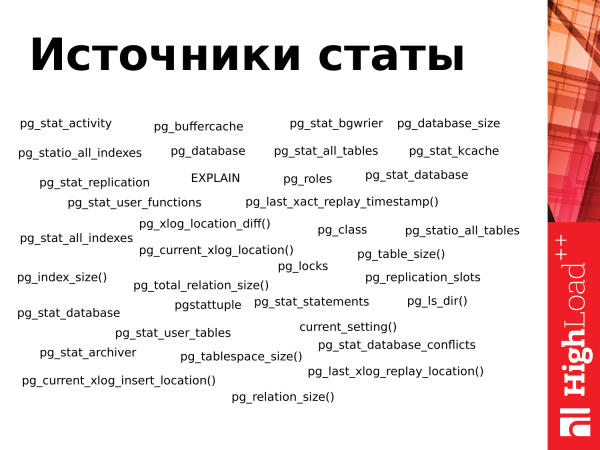
Na tomto slajde sú zobrazené všetky tie pohľady (VIEWs) a časť tých funkcií, ktoré sú k dispozícii v PostgreSQL 9.4. Ako vidíme, je ich veľmi veľa. Môže byť celkom jednoduché sa v tom zamotať, ak sa s tým stretávate po prvýkrát.
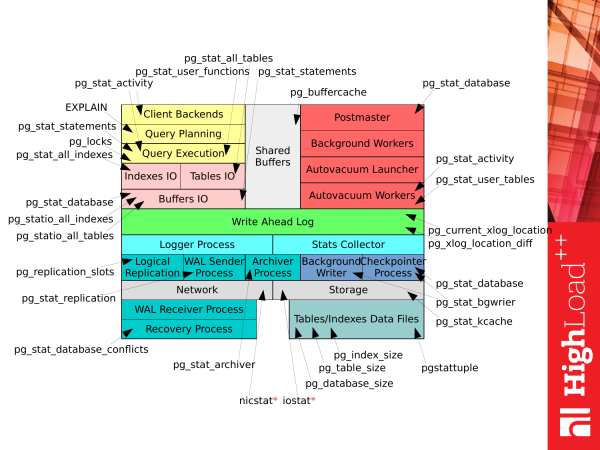
Avšak, ak vezmeme predchádzajúci obrázok Ako sa čas trávi v PostgreSQL a zladíme to s týmto zoznamom, dostaneme takýto obrázok. Každý pohľad (VIEWs) alebo každú funkciu môžeme použiť na rôzne účely na získanie príslušnej štatistiky, keď nám PostgreSQL pracuje. A môžeme získať už nejaké informácie o fungovaní subsystému.
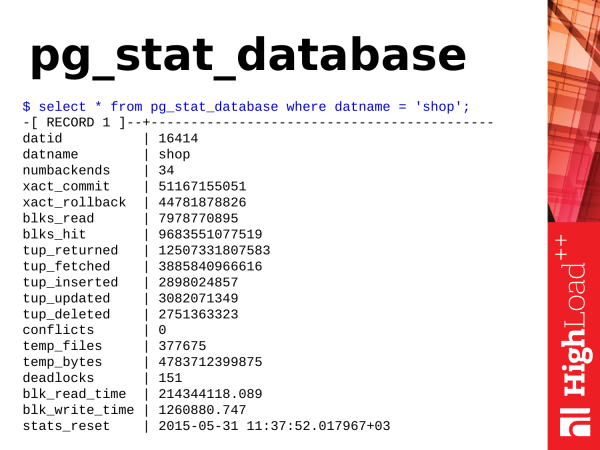
Prvé, čo preskúmame, je pg_stat_database. Ako vidíme, je to pohľad. Obsahuje veľmi veľa informácií. Rôznorodé informácie. A poskytuje veľmi užitočné poznanie o tom, čo sa deje v databáze.
Čo užitočné môžeme z toho získať? Začneme s najjednoduchšími vecami.
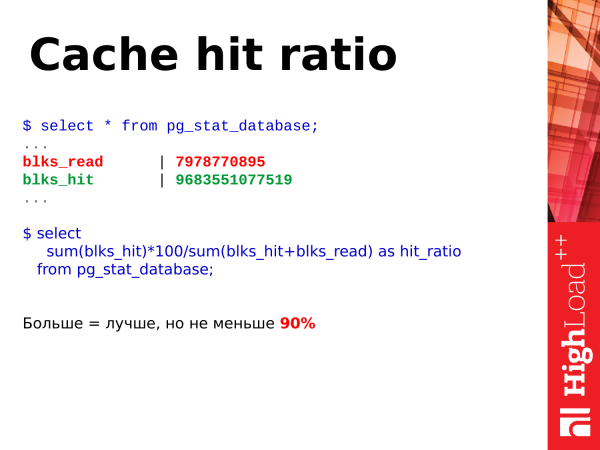
select
sum(blks_hit)*100/sum(blks_hit+blks_read) as hit_ratio
from pg_stat_database;
Prvé, čo môžeme skontrolovať – je percento zásahov do cache. Percento zásahov do cache – je užitočná metrika. Umožňuje posúdiť, aký objem dát sa berie z cache shared buffers, a aký objem sa číta z disku.
Je jasné, že čím vyššie máme zásahy do cache, tým lepšie. Túto metriku posudzujeme ako percento. A ak máme percentuálny pomer týchto zásahov do cache vyšší ako 90 %, je to dobré. Ak klesne pod 90 %, znamená to, že máme nedostatok pamäte na udržanie horúcej "hlavy" dát v pamäti. A aby sa tieto dáta použili, PostgreSQL musí pristupovať k disku a to je pomalšie, ako keby sa dáta čítali z pamäte. A už je potrebné premýšľať o zvýšení pamäte: buď zväčšiť shared buffers, alebo navýšiť hardvérovú pamäť (RAM).
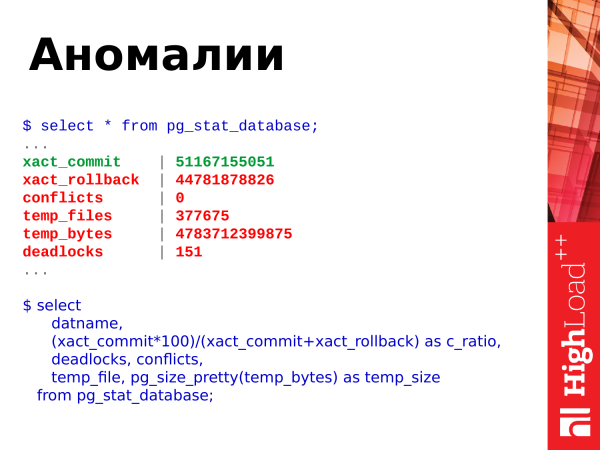
select
datname,
(xact_commit*100)/(xact_commit+xact_rollback) as c_ratio,
deadlocks, conflicts,
temp_file, pg_size_pretty(temp_bytes) as temp_size
from pg_stat_database;
Čo ďalšie môžeme z tohto pohľadu získať? Môžeme sa pozrieť na anomálie, ktoré sa v databáze vyskytujú. Čo je tu zobrazené? Sú tu commits, rollbacks, vytváranie dočasných súborov, ich objem, deadlocks a konflikty.
Tento dopyt môžeme využiť. Tento SQL je celkom jednoduchý. A môžeme si pozrieť tieto údaje u seba.
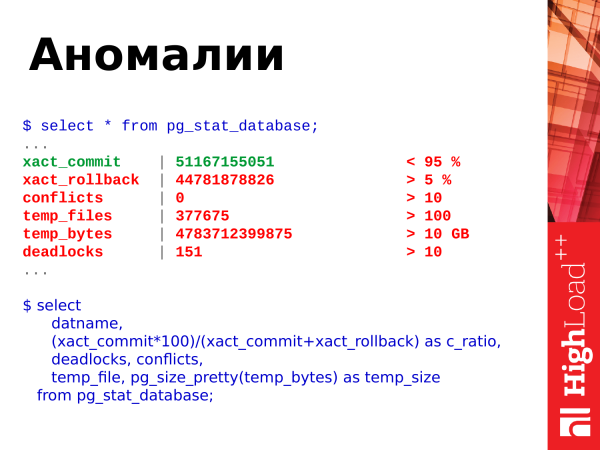
A tu sú hneď prahové hodnoty. Sledujeme pomer medzi commits a rollbacks. Commits sú úspešné potvrdenia transakcie. Rollbacks sú návraty, t.j. transakcia vykonala nejakú prácu, zaťažovala databázu, niečo počítala, a potom došlo k zlyhaniu, a výsledky transakcie sa vyhodia. T.j. pokiaľ je počet rollbackov neustále rastúci, je to zlé. A mali by sme ich nejako predchádzať a upravovať kód, aby sa niečo také nedialo.
Konflikty súvisia s replikáciou. A týmto by sme sa mali tiež vyhnúť. Ak máte nejaké dopyty, ktoré sa vykonávajú na replike a vznikajú konflikty, je potrebné tieto konflikty analyzovať, pozrieť sa, čo sa deje. Podrobnosti nájdete v logoch. A odstrániť konfliktné situácie, aby dopyty aplikácie fungovali bez chýb.
Deadlocky sú tiež zlou situáciou. Keď dopyty bojujú o zdroje, jeden dopyt sa obráti na jeden zdroj a zablokuje ho, druhý dopyt sa obráti na druhý zdroj a tiež ho zablokuje, a potom sa oba dopyty obracajú na zdroje navzájom a zablokujú sa v očakávaní, kedy sused uvoľní zámok. Toto je tiež problémová situácia. Je potrebné ich riešiť na úrovni prepísania aplikácií a serializácie prístupu k zdrojom. A ak vidíte, že sa vám deadlocky neustále zvyšujú, mali by ste sa pozrieť na podrobnosti v logoch, analyzovať vznikajúce situácie a zistiť, aký je problém.
Dočasné súbory sú tiež zlé. Keď užívateľskému dopytu chýba pamäť na uloženie operačných, dočasných údajov, vytvorí súbor na disku. A všetky operácie, ktoré by mohol vykonávať v dočasnom buffri v pamäti, začína vykonávať už na disku. To je pomalé. To zvyšuje čas vykonania dopytu. A klient, ktorý poslal dopyt do PostgreSQL, dostane odpoveď o niečo neskôr. Ak by sa všetky tieto operácie vykonávali v pamäti, Postgres odpovie oveľa rýchlejšie a klient bude menej čakať.
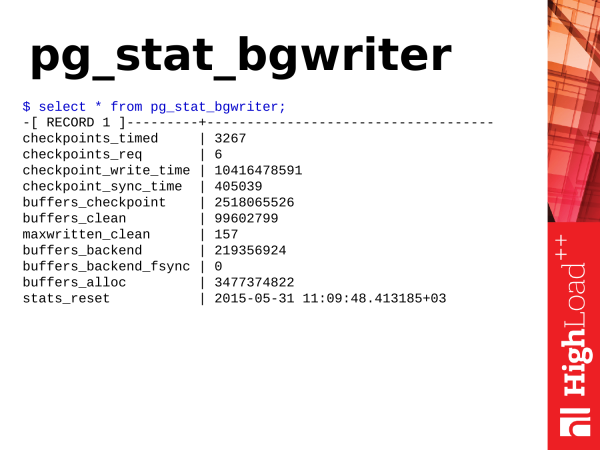
Pg_stat_bgwriter je zobrazenie, ktoré popisuje prácu dvoch pozadových subsystémov PostgreSQL: to sú checkpointer a background writer.
Na začiatok sa pozrime na kontrolné body, tzv. checkpoints. Čo sú kontrolné body? Kontrolný bod je pozícia v denníku transakcií, ktorá oznamuje, že všetky zmeny údajov zaznamenané v denníku boli úspešne synchronizované s údajmi na disku. Proces môže byť v závislosti od záťaže a nastavení dlhý a väčšinou spočíva v synchronizácii „špinavých“ stránok v zdieľaných pamätiach s datovými súbormi na disku. Načo je to potrebné? Keby PostgreSQL stále pristupovalo k disku a bralo z neho údaje a zaznamenávalo údaje pri každom prístupe, bolo by to pomalé. Preto má PostgreSQL segment pamäte, ktorého veľkosť závisí od parametrov v konfigurácii. Postgres umiestňuje do tejto pamäte operatívne údaje na ďalšie spracovanie alebo zobrazenie na požiadavky. V prípade požiadaviek na zmenu údajov sa tieto menia. A máme dve verzie údajov. Jedna je v pamäti, druhá na disku. A periodicky je potrebné tieto údaje synchronizovať. Musíme to, čo bolo zmenené v pamäti, synchronizovať na disk. Na to sú potrebné kontrolné body.
Kontrolný bod prechádza cez zdieľané pamäte, označuje špinavé stránky, ktoré sú potrebné pre kontrolný bod. Potom spúšťa druhý prechod cez zdieľané pamäte. A stránky, ktoré sú označené pre kontrolný bod, už synchronizuje. Takto sa vykonáva synchronizácia údajov už s diskom.
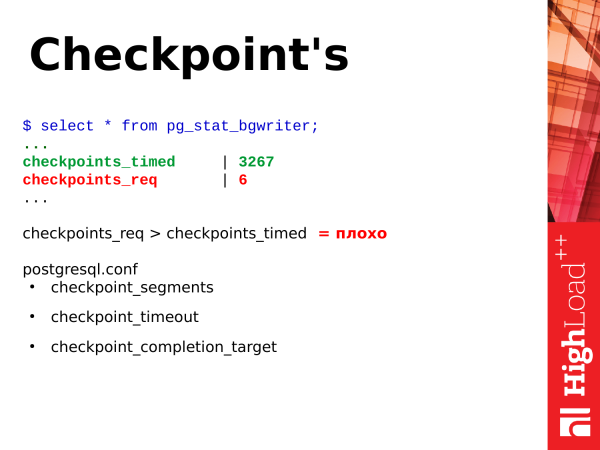
Existujú dva typy kontrolných bodov. Jeden kontrolný bod sa vykonáva na základe časového limitu. Tento kontrolný bod je užitočný a dobrý – checkpoint_timed. A sú kontrolné body na požiadanie – checkpoint required. Takáto kontrolná značka nastáva, keď máme veľmi veľký zápis údajov. Zapísali sme veľmi veľa denníkov transakcií. A PostgreSQL považuje, že potrebuje všetko toto synchronizovať čo najrýchlejšie, vytvoriť kontrolný bod a pokračovať ďalej.
A ak ste sa pozreli na štatistiku pg_stat_bgwriter a videli ste, že máte checkpoint_req oveľa viac ako checkpoint_timed, tak to nie je dobre. Prečo to nie je dobre? Znamená to, že PostgreSQL sa nachádza v neustálej stresovej situácii, keď musí zapisovať údaje na disk. Kontrolný bod na základe časového limitu je menej stresujúci a vykonáva sa podľa vnútorného rozvrhu a ako keby sa ťahá v čase. PostgreSQL má možnosť robiť prestávky v práci a nezapodienať diskový subsystém. To je pre PostgreSQL prospešné. A požiadavky, ktoré sa vykonávajú počas kontrolných bodov, nebudú pociťovať stres z toho, že diskový subsystém je obsadený.
A pre reguláciu kontrolných bodov existujú tri parametre:
checkpoint_segments.checkpoint_timeout.checkpoint_completion_target.
Tieto parametre umožňujú regulovať fungovanie kontrolných bodov. Nebudem sa však na nich zdržovať. Ich vplyv je už samostatná téma.
Pozor: Prezentovaná verzia 9.4 už nie je aktuálna. V súčasných verziách PostgreSQL je parameter checkpoint_segments nahradený parametrami min_wal_size a max_wal_size.
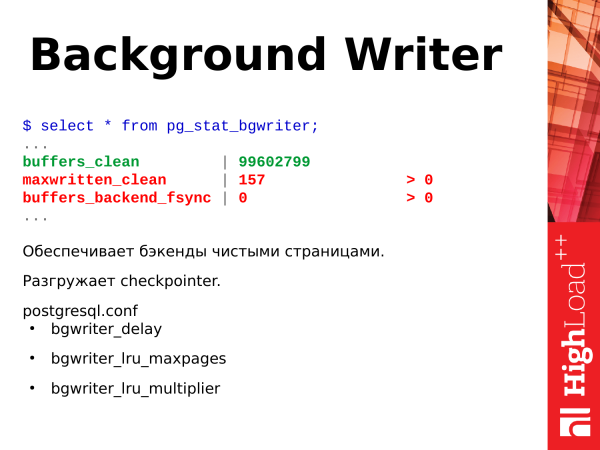
Ďalšou podsystemou je pozadový zapisovač — background writer. Čo robí? Pracuje neustále v nekonečnom cykle. Skenuje stránky v zdieľaných vyrovnávacích pamätiach a špinavé stránky, ktoré nájde, zapisuje na disk. Takto pomáha kontrolórovi vykonávať menej práce v procese vykonávania kontrolných bodov.
Na čo je ešte potrebný? Zabezpečuje potrebu čistých stránok v zdieľaných vyrovnávacích pamätiach, ak by sa náhle potrebovali (v veľkom množstve a naraz) na uloženie dát. Predpokladajme, že nastala situácia, keď na vykonanie požiadavky potrebovali čisté stránky a tie už sú v zdieľaných vyrovnávacích pamätiach. Postgresový backend ich jednoducho vezme a použije, nemusí nič čistiť. Ale ak náhodou také stránky nie sú, backend pozastavuje prácu a začína hľadať stránky, aby ich zapísal na disk a vzal pre svoje potreby — čo negatívne vplýva na čas vykonávania momentálnych požiadaviek. Ak vidíte, že váš parameter maxwritten_clean je veľký, znamená to, že pozadový zapisovač nezvláda svoju prácu a je potrebné zvýšiť parametre bgwriter_lru_maxpages, aby mohol za jeden cyklus vykonať viac práce a viac stránok vyčistiť.
A ďalším veľmi užitočným ukazovateľom je buffers_backend_fsync. Backendy nevykonávajú fsync, pretože je to pomalé. Preposielajú fsync vyššie po I/O zásobníku kontrolórovi. Kontrolór má svoju frontu, periodicky spracováva fsync a synchronizuje stránky v pamäti s súbormi na disku. Ak je fronta kontrolóra veľká a zaplnená, backend je nútený sám vykonávať fsync, čo spomaľuje jeho prácu,, čiže klient dostane odpoveď neskôr, než by mohol. Ak vidíte, že táto hodnota je väčšia ako nula, je to už problém a je potrebné venovať pozornosť nastaveniam pozadového zapisovača a taktiež zhodnotiť výkon diskového pod systému.
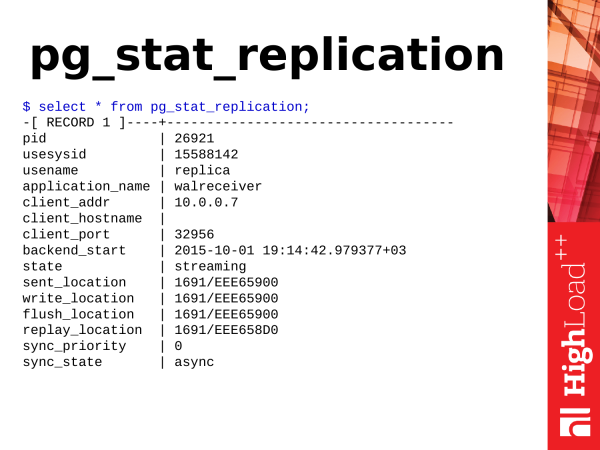
Pozor: _Nasledujúci text popisuje štatistické reprezentácie spojené s replikáciou. Väčšina názvov reprezentácií a funkcií bola premenovaná v Postgres 10. Podstata premenovaní spočívala v nahradení xlog na wal a location na v názvoch funkcií/reprezentácií a podobne. Konkrétny príklad, funkcia pg_xlog_location_diff() bola premenovaná na pg_wal_lsn_diff() Aj tu máme veľa vecí. Ale potrebujeme iba body, ktoré súvisia s lokalizáciou.._
Ak vidíme, že všetky hodnoty sú rovnaké, tak to je ideálny stav a replikácia nezaostáva za majstrom.
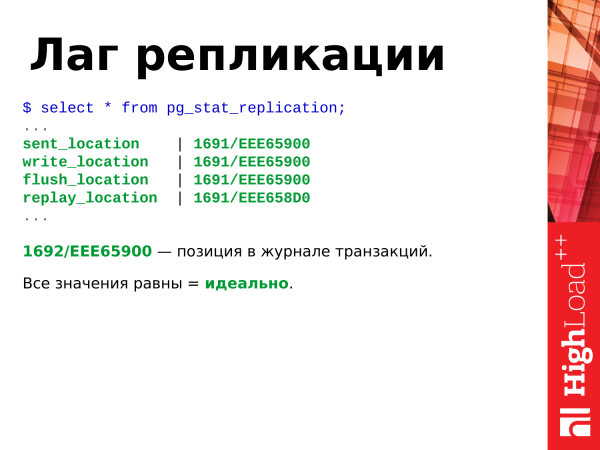
Toto hexadecimálne miesto – to je pozícia v denníku transakcií. Neustále sa zvyšuje, ak je v databáze nejaká aktivita: inserts, deletes atď.
koľko bolo zapísané xlog v bajtoch $ select pg_xlog_location_diff(pg_current_xlog_location(),'0/00000000'); lag replikácie v bajtoch $ select client_addr, pg_xlog_location_diff(pg_current_xlog_location(), replay_location) from pg_stat_replication; lag replikácie v sekundách $ select extract(epoch from now() - pg_last_xact_replay_timestamp());
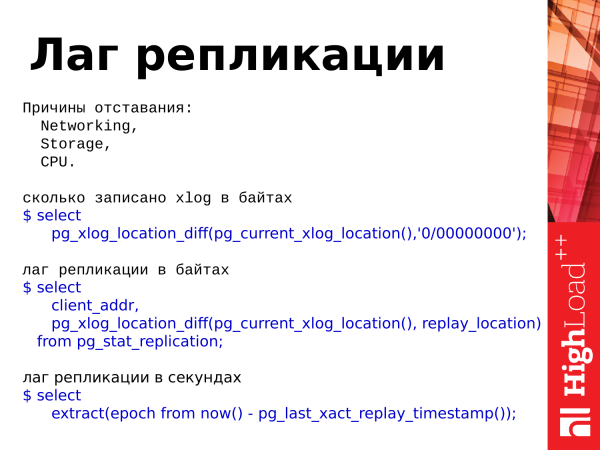
Ak sa tieto veci líšia, znamená to, že je nejaký lag. Lag – to je zaostávanie repliky za majstrom, t. j. dáta sa líšia medzi servermi.Existujú tri dôvody zaostávania:
To je disková subsystém, ktorý nezvláda zápis synchronizácie súborov.
- To sú možné chyby siete, alebo preťaženie siete, keď dáta nestíhajú doraziť k replikácii a nemôže ich reprodukovať.
- A procesor. Procesor – to je veľmi zriedkavý prípad. A videl som to dvakrát alebo trikrát, ale aj to sa môže stať.
- A tu sú tri dotazy, ktoré nám umožňujú využiť štatistiku. Môžeme posúdiť, koľko bolo zapísané v našom denníku transakcií. Existuje taká funkcia
pg_xlog_location_diff a môžeme posúdiť lag replikácie v bajtoch a sekundách. Aj na to používame hodnotu z tohto pohľadu (VIEWs). _Namiesto pg_xlog_location
Poznámka: diff() funkcie môžeme použiť operátor odčítania a odčítať jednu lokalizáciu od druhej. Je to pohodlné.S lagom, ktorý je v sekundách, je jeden aspekt. Ak na majstrovi nedochádza k žiadnej aktivite, transakcia tam bola pred asi 15 minútami a žiadna aktivita nie je, a ak sa na replike pozrieme na tento lag, tak uvidíme lag 15 minút. O tomto treba pamätať. A to môže spôsobiť zmätok, keď sa na ten lag pozriete.
S lagom v sekundách je jedna vec. Ak na hlavnom serveri nie je žiadna aktivita, transakcia tam bola asi pred 15 minútami a aktivita nie je, a ak sa na replikácii pozrieme na tento lag, uvidíme lag 15 minút. Objednávajte si, prosím.
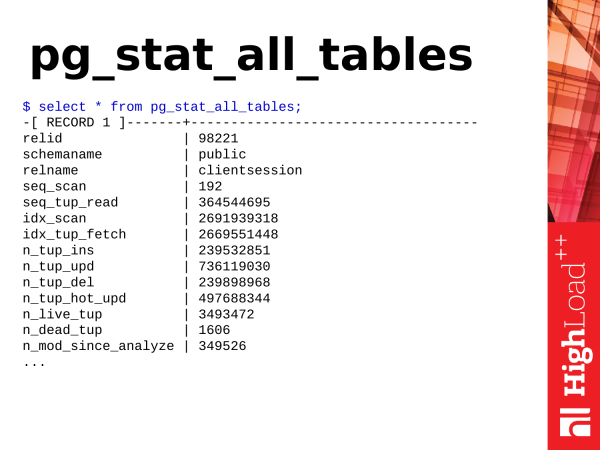
Pg_stat_all_tables – ďalší užitočný pohľad. Zobrazuje štatistiky pre tabuľky. Keď v databáze existujú tabuľky a je s nimi nejaká aktivita, nejaké akcie, túto informáciu môžeme získať z tohto pohľadu.
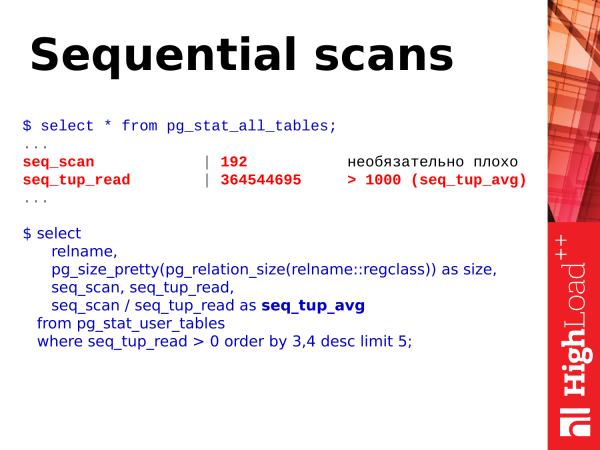
select
relname,
pg_size_pretty(pg_relation_size(relname::regclass)) as size,
seq_scan, seq_tup_read,
seq_scan / seq_tup_read as seq_tup_avg
from pg_stat_user_tables
where seq_tup_read > 0 order by 3,4 desc limit 5;
Prvá vec, na ktorú sa môžeme pozrieť, sú sekvenčné skenovania tabuliek. Samotné číslo po týchto prechodoch ešte nemusí byť zlé a nie je indikátorom toho, že by sme mali niečo podniknúť.
Existuje však druhá metrika – seq_tup_read. To je počet riadkov vrátených v dôsledku sekvenčného skenovania. Ak priemerné číslo presahuje 1 000, 10 000, 50 000, 100 000, to už naznačuje, že možno potrebujete niekde vytvoriť index, aby boli prístupy indexom, alebo možno optimalizovať požiadavky, ktoré používajú také sekvenčné skenovania, aby tomu tak nebolo.
Jednoduchý príklad – povedzme, že dotaz s veľkým OFFSET a LIMIT má cenu. Napríklad sa skenuje 100 000 riadkov v tabuľke a potom sa berie 50 000 požadovaných riadkov, a predchádzajúce skenované riadky sa zahadzujú. To je tiež zlý prípad. Takéto dotazy je potrebné optimalizovať. A tu je taký jednoduchý SQL dotaz, na ktorom to môžete vidieť a ohodnotiť získané čísla.
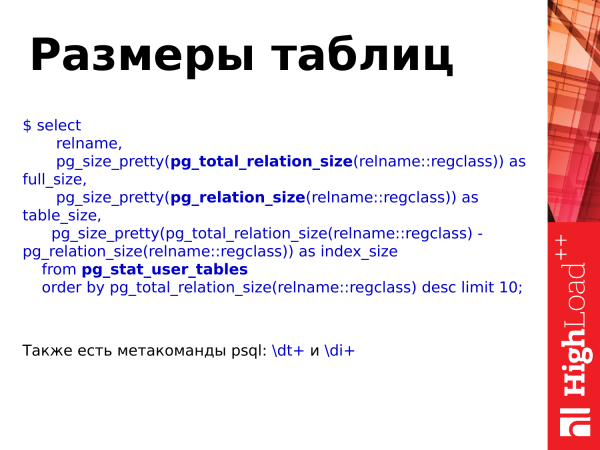
select
relname,
pg_size_pretty(pg_total_relation_size(relname::regclass)) as
full_size,
pg_size_pretty(pg_relation_size(relname::regclass)) as
table_size,
pg_size_pretty(pg_total_relation_size(relname::regclass) -
pg_relation_size(relname::regclass)) as index_size
from pg_stat_user_tables
order by pg_total_relation_size(relname::regclass) desc limit 10;
Veľkosti tabuliek je tiež možné získať pomocou tejto tabuľky a s pomocou dodatočných funkcií pg_total_relation_size(), pg_relation_size().
Všeobecne existujú metakomandy dt a di, ktoré môžeme použiť v PSQL a tiež si pozrieť veľkosti tabuliek a indexov.
Avšak použitie funkcií nám pomáha pozerať sa na veľkosti tabuliek aj s ohľadom na indexy, alebo bez ohľadu na indexy a konať na základe rastu databázy, t. j. ako rastie, s akou intenzitou a už robiť nejaké záväzky o optimalizácii velikosti.
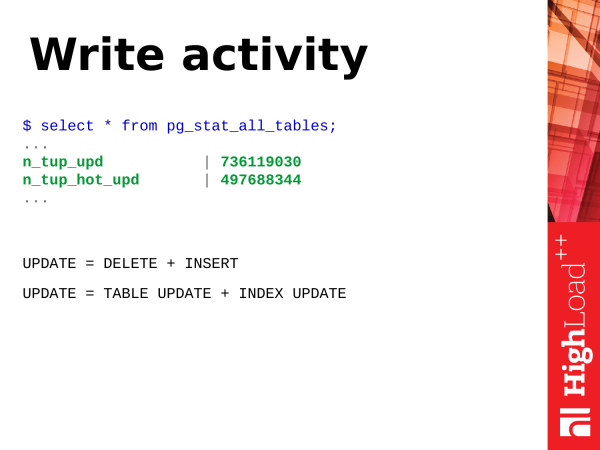
Aktivita na zápis. Čo je zápis? Poďme si prejsť operáciu UPDATE – operácia aktualizácie riadkov v tabuľke. V podstate je update dve operácie (alebo aj viac). Je to vloženie novej verzie riadku a označenie starého riadku ako zastaraného. Následne príde autovakuum a tieto zastarané verzie riadkov vyčistí a označí toto miesto ako dostupné na opätovné použitie.
Navyše, update nie je len aktualizácia tabuľky. Je to aj aktualizácia indexov. Ak máte na tabuľke veľa indexov, pri update je potrebné aktualizovať aj všetky indexy, v ktorých sú zapojené polia, ktoré sa aktualizujú v dopyte. V týchto indexoch budú tiež zastarané verzie riadkov, ktoré je potrebné vyčistiť.
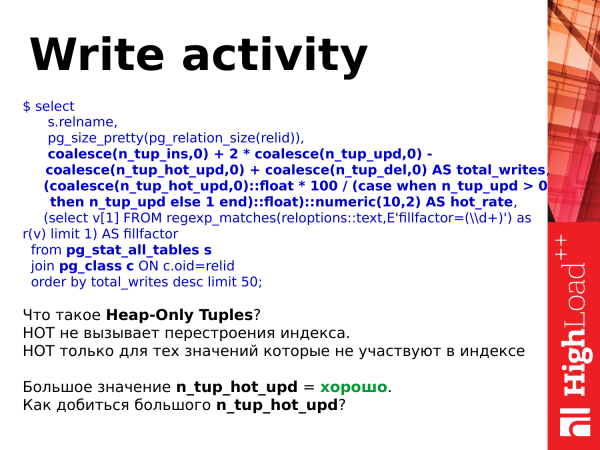
select
s.relname,
pg_size_pretty(pg_relation_size(relid)),
coalesce(n_tup_ins,0) + 2 * coalesce(n_tup_upd,0) -
coalesce(n_tup_hot_upd,0) + coalesce(n_tup_del,0) AS total_writes,
(coalesce(n_tup_hot_upd,0)::float * 100 / (case when n_tup_upd > 0
then n_tup_upd else 1 end)::float)::numeric(10,2) AS hot_rate,
(select v[1] FROM regexp_matches(reloptions::text,E'fillfactor=(\d+)') as
r(v) limit 1) AS fillfactor
from pg_stat_all_tables s
join pg_class c ON c.oid=relid
order by total_writes desc limit 50;
A kvôli svojmu dizajnu, UPDATE sú to ťažkopádne operácie. Ale dajú sa uľahčiť. Existujú hot updates. Objavili sa v PostgreSQL verzii 8.3. A čo to je? Je to ľahká aktualizácia, ktorá nespôsobuje prestavbu indexov. T. j. aktualizovali sme záznam, ale aktualizoval sa len záznam na stránke (ktorá patrí tabuľke), a indexy stále ukazujú na ten istý záznam na stránke. Existuje tu trochu zaujímavá logika, keď príde vacuum, tak tieto reťazce hot prestavuje a všetko pokračuje v práci bez aktualizácie indexov, a všetko sa deje s menšou spotrebou zdrojov.
A keď máte n_tup_hot_upd veľké, tak to je veľmi dobre. To znamená, že ľahké aktualizácie dominujú a je to pre nás lacnejšie z pohľadu zdrojov a všetko je skvelé.
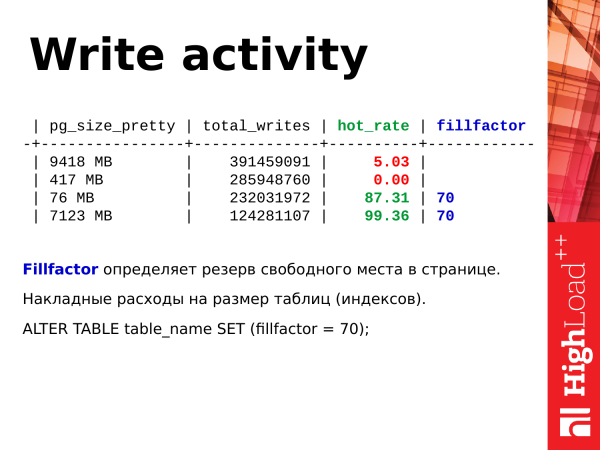
ALTER TABLE table_name SET (fillfactor = 70);Ako zvýšiť objem hot updateov? Môžeme použiť fillfactor. Určuje veľkosť rezervovaného voľného miesta pri vyplňovaní stránky v tabuľke pomocou INSERT’ov. Keď sa do tabuľky dostávajú inserts, úplne zapĺňajú stránku, nezanechávajú v nej žiadne voľné miesto. Potom sa pridá nová stránka. Znova sa údaje zaplnia. A toto správanie je predvolené, fillfactor = 100 %.
Môžeme nastaviť fillfactor na 70 %. T. j. pri vkladoch sa vyhradí nová stránka, ale vyplní sa iba 70 % stránky. A 30 % zostáva ako rezerva. Keď bude potrebné vykonať aktualizáciu, s vysokou pravdepodobnosťou prebehne na tej istej stránke a nová verzia riadku sa umiestni na tú istú stránku. A bude vykonaná hot_update. Týmto sa uľahčuje zápis do tabuliek.
select c.relname,
current_setting('autovacuum_vacuum_threshold') as av_base_thresh,
current_setting('autovacuum_vacuum_scale_factor') as av_scale_factor,
(current_setting('autovacuum_vacuum_threshold')::int +
(current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples))
as av_thresh,
s.n_dead_tup
from pg_stat_user_tables s join pg_class c ON s.relname = c.relname
where s.n_dead_tup > (current_setting('autovacuum_vacuum_threshold')::int
+ (current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples));
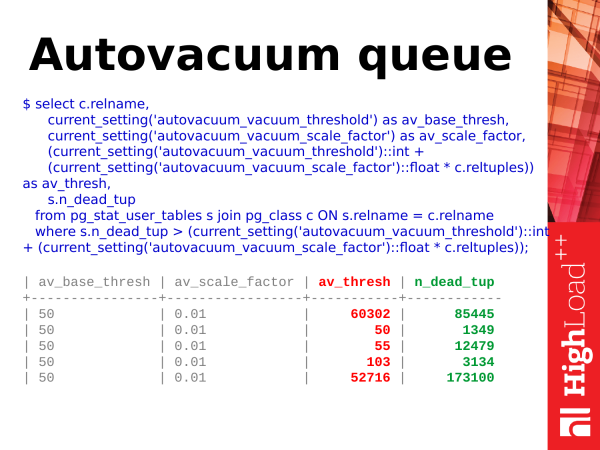
Fronta autovakuumu. Autovakuum je taký podsystem, o ktorom je v štatistikách PostgreSQL veľmi málo informácií. Môžeme len v tabuľkách pg_stat_activity vidieť, koľko máme práve prebiehajúcich vakuumov. Avšak pochopiť, koľko tabuliek je v jeho fronte, je veľmi ťažké.
Poznámka: _Od verzie Postgres 10 sa situácia s monitorovaním autovakuumu výrazne zlepšila — objavila sa reprezentácia pg_stat_progressvakuum, ktorá značne zjednodušila otázku monitorovania autovakuumu.
Môžeme použiť takýto zjednodušený dotaz. A môžeme sa pozrieť, kedy by mal byť vykonaný vakuum. Ale ako a kedy by sa mal spustiť vakuum? Tieto zastarané verzie riadkov, o ktorých som hovoril predtým. Prebehla aktualizácia, nová verzia riadku bola vložená. Objavila sa zastaraná verzia riadku. V tabuľke pg_stat_user_tables existuje taký parameter n_dead_tup. Ukazuje počet "mŕtvych" riadkov. A keď sa počet mŕtvych riadkov zvýši nad určitý prah, autovakuum príde k tabuľke.
A ako sa tento prah vypočíta? Ide o veľmi konkrétny percentuálny podiel od celkového počtu riadkov v tabuľke. Existuje parameter autovacuum_vacuum_scale_factor. Ten stanovuje percentuálny podiel. Predpokladajme, že 10 % + určitý základný prah 50 riadkov. A čo sa stane? Keď je počet mŕtvych riadkov väčší ako "10 % + 50" z celkového počtu riadkov v tabuľke, nastavíme tabuľku na autovakuum.
select c.relname,
current_setting('autovacuum_vacuum_threshold') as av_base_thresh,
current_setting('autovacuum_vacuum_scale_factor') as av_scale_factor,
(current_setting('autovacuum_vacuum_threshold')::int +
(current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples))
as av_thresh,
s.n_dead_tup
from pg_stat_user_tables s join pg_class c ON s.relname = c.relname
where s.n_dead_tup > (current_setting('autovacuum_vacuum_threshold')::int
+ (current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples));
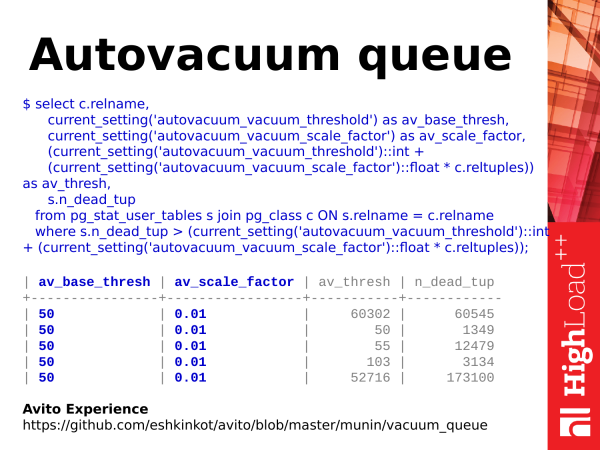
Avšak tu je jeden moment. Základné prahy parametrov av_base_thresh a av_scale_factor môžu byť priradené individuálne. A preto bude prah nie globálny, ale individuálny pre tabuľku. Pre výpočet je potrebné použiť triky a finty. Ak máte záujem, môžete sa pozrieť na skúsenosti našich kolegov z Avito (odkaz na slide je neplatný a bol aktualizovaný v texte).
Napísali pre , ktorý tieto veci zohľadňuje. Je tam dlhý dokument na dva listy. Ale počíta správne a dosť efektívne hodnotí, kde máme veľa požiadaviek na vákuum pre tabuľky, kde málo.
Čo môžeme s týmto spraviť? Ak máme veľkú frontu a automatické vákuum si nedokáže poradiť, môžeme zvýšiť počet pracovníkov vákuum, alebo jednoducho urobiť vákuum agresívnejšie, aby sa spúšťalo skôr, spracovávalo tabuľku na malé kúsky. A tým pádom sa fronta zníži. — Najdôležitejšie je sledovať záťaž na diskoch, pretože vákuum nie je zadarmo, hoci s príchodom SSD/NVMe zariadení sa problém stal menej viditeľným.
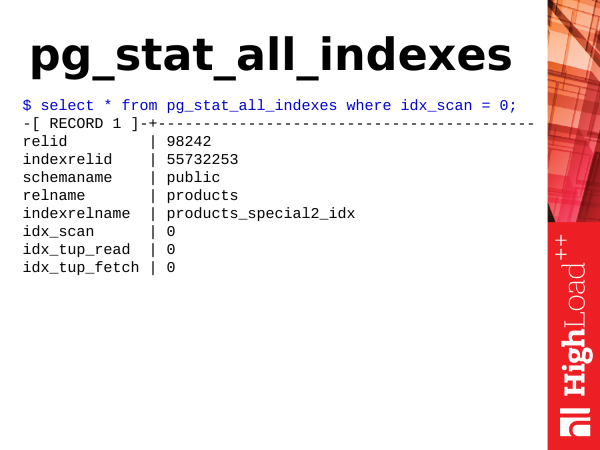
Pg_stat_all_indexes – to sú štatistiky pre indexy. Je to malé. A môžeme získať informácie o používaní indexov. Môžeme napríklad určiť, ktoré indexy sú zbytočné.
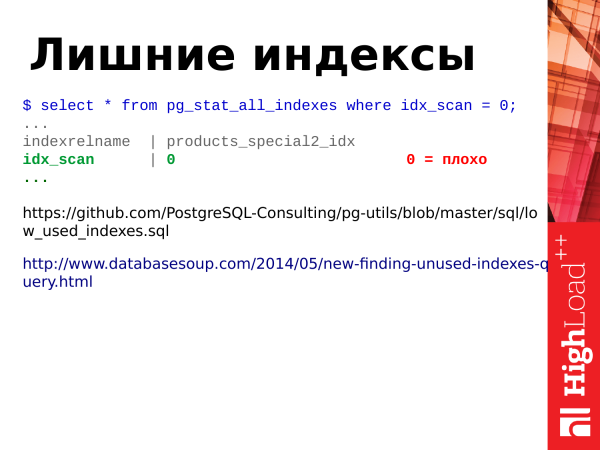
Ako som už povedal, aktualizácia – to nie je len aktualizácia tabuliek, ale aj aktualizácia indexov. Teda, ak máme v tabuľke veľa indexov, pri aktualizácii riadkov v tabuľke je potrebné aj aktualizovať indexy indexovaných polí, a ak máme nevyužité indexy, pre ktoré nie sú žiadne skenovania indexov, sú balastom. A mali by sme sa ich zbaviť. Na to potrebujeme pole idx_scan. Jednoducho sa pozrieme na počet skenovaní indexu. Ak indexy nemajú žiadne skenovania za relatívne dlhé obdobie uchovávania štatistiky (minimálne 2-3 týždne), pravdepodobne sú to zlé indexy, mali by sme sa ich zbaviť.
Poznámka: Pri hľadaní nevyužitých indexov v prípade klastra prúdovej replikácie je potrebné skontrolovať všetky uzly klastra, pretože štatistika nie je globálna, a ak index nie je využívaný na master, môže byť využívaný na replikách (ak tam je záťaž).
Dve odkazy:
Toto sú pokročilé príklady dotazov na to, ako hľadať nevyužité indexy.
Druhý odkaz je vcelku zajímavý požadavek. Skrývá se za ním velmi netriviální logika. Doporučuji ho k prostudování.
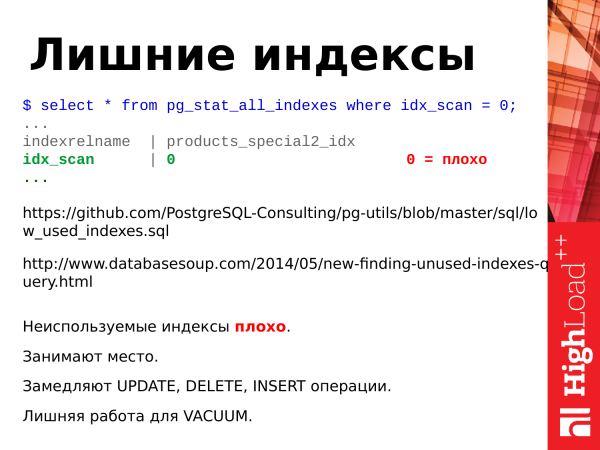
Co dalšího by se mělo shrnout o indexech?
Nepoužívané indexy jsou špatné.
Zabírají místo.
Zpomalují operace aktualizace.
Nepotřebná práce pro vakuum.
Pokud odstraníme nepoužívané indexy, jenom tím zlepšíme databázi.
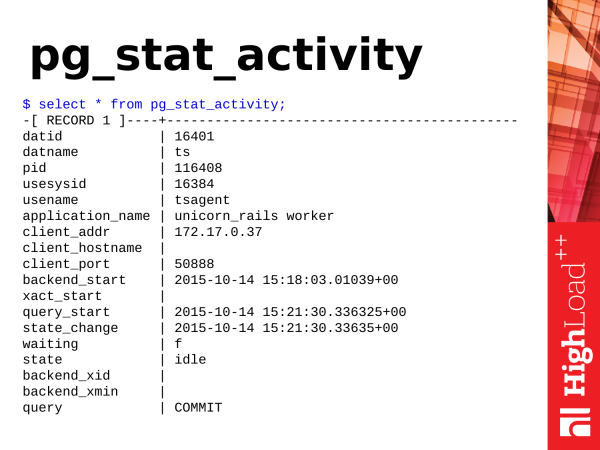
Dalším zobrazením je pg_stat_activity. Je to ekvivalent nástroje ps, pouze v PostgreSQL. Pokud pss 'ps' sledujete procesy v operačním systému, pak pg_stat_activity vám ukáže aktivitu uvnitř PostgreSQL.
Co užitečného si odtud můžeme vzít?
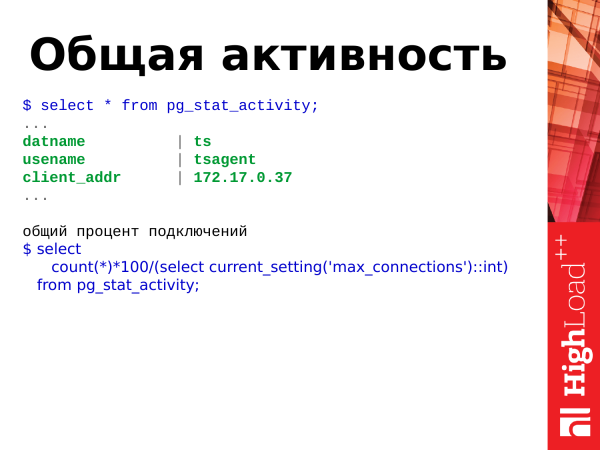
select
count(*)*100/(select current_setting('max_connections')::int)
from pg_stat_activity;
Můžeme se podívat na celkovou aktivitu, co se v databázi děje. Můžeme provést nové nasazení. Pokud se nám všechno zhroutí, nové připojení nejsou přijímána, v aplikaci se objevují chyby.
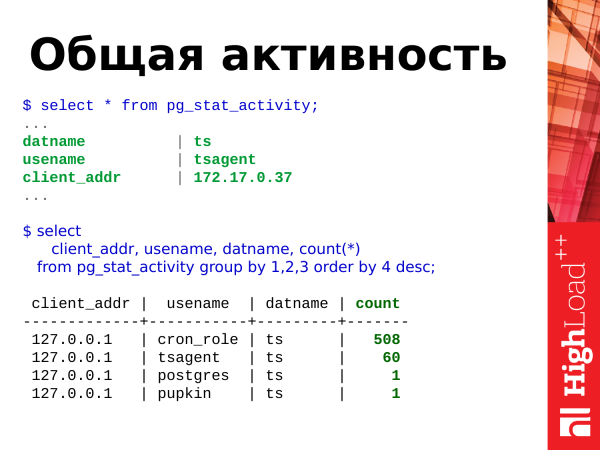
select
client_addr, usename, datname, count(*)
from pg_stat_activity group by 1,2,3 order by 4 desc;
Můžeme provést takový dotaz a podívat se na celkový podíl připojení vzhledem k maximálnímu limitu připojení a zjistit, kdo zaujímá nejvíce spojení. V tomto konkrétním případě vidíme, že uživatel cron_role otevřel 508 připojení. Něco se mu stalo. Je potřeba se s tím vypořádat a zjistit, co se děje. A je velmi pravděpodobné, že se jedná o nějaký anomální počet připojení.
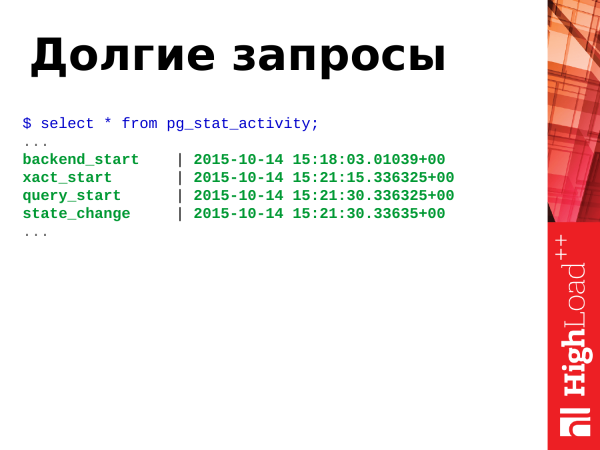
Pokud máme OLTP zátěž, dotazy by měly probíhat rychle, velmi rychle a neměly by být dlouhé dotazy. Avšak, pokud se objevují dlouhé dotazy, krátkodobě to není nic hrozného, ale v dlouhodobém horizontu dlouhé dotazy škodí databázi, zvyšují efekt bloat tabulek, kdy dochází k fragmentaci tabulek. Jak od bloat, tak od dlouhých dotazů se je potřeba zbavit.
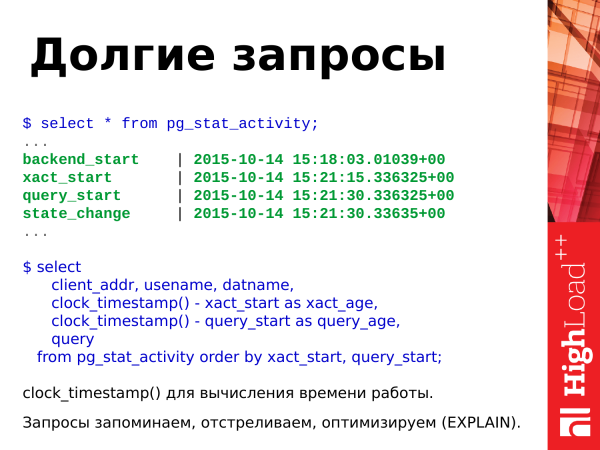
select
client_addr, usename, datname,
clock_timestamp() - xact_start as xact_age,
clock_timestamp() - query_start as query_age,
query
from pg_stat_activity order by xact_start, query_start;
Všimněte si: tímto dotazem můžeme určit dlouhé dotazy a transakce. Používáme funkci clock_timestamp() k určení doby trvání. Dlouhé dotazy, které jsme našli, si můžeme zapamatovat a provést explain, podívat se na plány a nějakým způsobem optimalizovat. Aktuální dlouhé dotazy zastavujeme a dále pokračujeme.
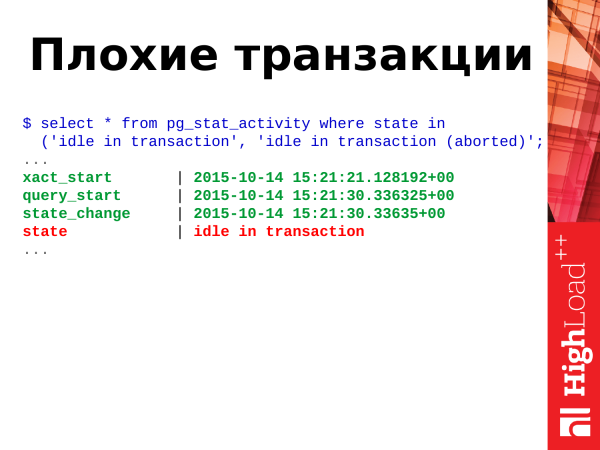
select * from pg_stat_activity where state in
('idle in transaction', 'idle in transaction (aborted)';
Špatné transakce jsou transakce ve stavu idle in transaction a idle in transaction (aborted).
Čo to znamená? Transakcie majú niekoľko stavov. A jeden z týchto stavov môže nadobudnúť akýkoľvek čas. Na určenie stavov máme pole state v tejto reprezentácii. A používame ho na určenie stavu.
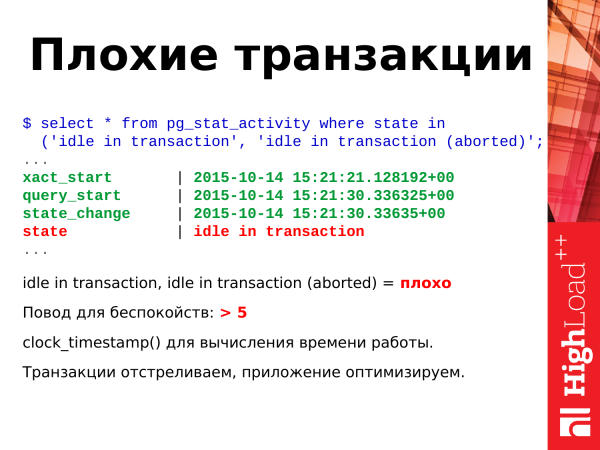
select * from pg_stat_activity where state in
('idle in transaction', 'idle in transaction (aborted)';
A ako som už spomenul vyššie, tieto dva stavy idle in transaction a idle in transaction (aborted) – sú zlé. Čo to znamená? To je, keď aplikácia otvorila transakciu, vykonala nejaké akcie a potom šla svojou cestou. Transakcia zostala otvorená. Visí, nič sa s ňou nedeje, zaberá pripojenie, blokuje zmenené riadky a potenciálne ešte zvyšuje bloat iných tabuliek, kvôli architektúre transakčného stroja Postrges. A takéto transakcie by sa mali tiež zrušiť, pretože sú škodlivé za akýchkoľvek okolností.
Ak vidíte, že ich máte v databáze viac ako 5-10-20, je čas sa znepokojovať a začať s nimi niečo robiť.
Tu tiež používame pre čas výpočtu clock_timestamp(). Transakcie rušíme, aplikáciu optimalizujeme.
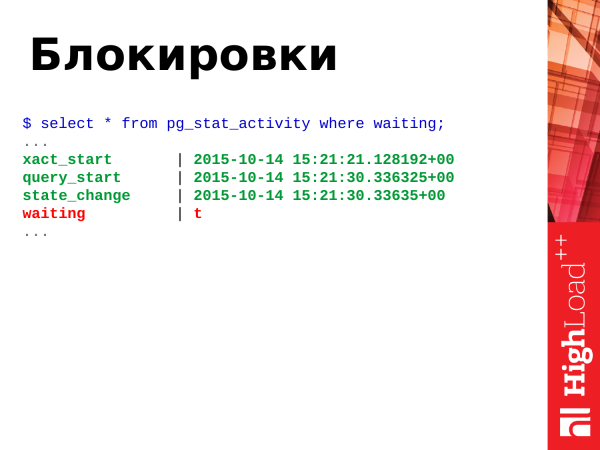
Ako som už spomenul vyššie, blokácie – to je, keď sa dve a viac transakcií bijú o jeden alebo skupinu zdrojov. Na to máme pole waiting s boolean hodnotou true alebo nepravda.
True – to znamená, že proces čaká, treba niečo robiť. Keď je proces v čakaní, znamená to, že klient, ktorý inicioval tento proces, tiež čaká. Klient v prehliadači sedí a tiež čaká.
Pozor: _Od verzie Postgres 9.6 bolo pole waiting odstránené a namiesto neho boli pridané dve informatívnejšie polia wait_event_type a wait_event._
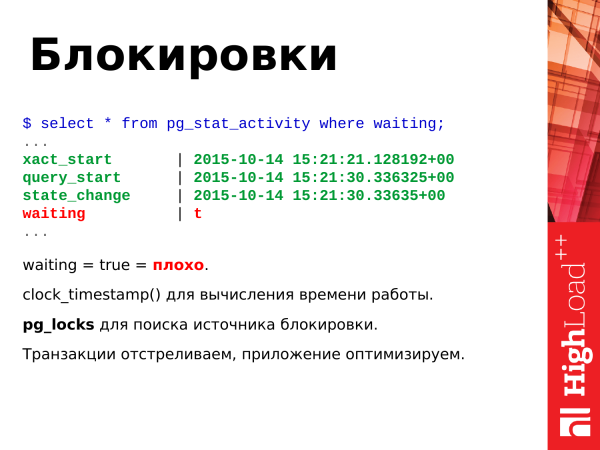
Čo robiť? Ak vidíte true po dlhú dobu, znamená to, že sa treba zbaviť takýchto požiadaviek. Tieto transakcie jednoducho rušíme. Vývojárom hovoríme, aby nejako optimalizovali, aby nedošlo k pretekaniu o zdroje. A potom vývojári optimalizujú aplikáciu, aby sa niečo také nevyskytovalo.
A konečne, ale potenciálne nie fatálny prípad – to je vznik deadlockov. Dve transakcie aktualizovali dva zdroje, potom sa odvolávajú na ne znova, už na opačné zdroje. PostgreSQL v takom prípade zoberie a sám zruší transakciu, aby iná mohla pokračovať v práci. Je to bezvýchodisková situácia a sama sa nerieši. Preto PostgreSQL nútený prijímať krajné opatrenia.
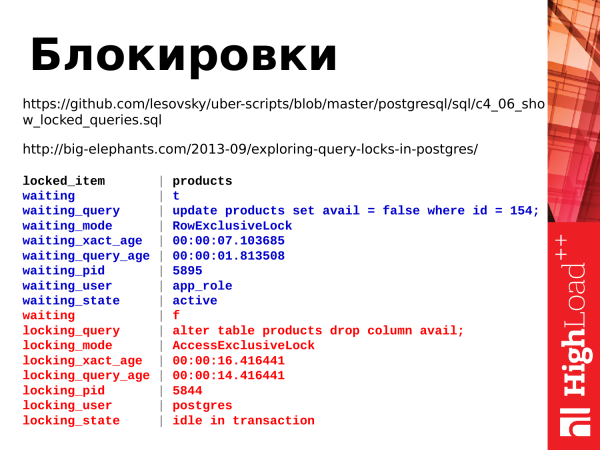
A tu sú dva dotazy, ktoré umožňujú sledovať blokácie. Používame reprezentáciu pg_locks, ktorý umožňuje sledovať ťažké uzamknutia.
A prvý odkaz – to je samotný text požiadavky. Je pomerne dlhý.
A druhý odkaz – to je článok o uzamknutiach. Je užitočné si ho prečítať, je veľmi zaujímavý.
Takže, čo vidíme? Vidíme dva požiadavky. Transakciu s ALTER TABLE – to je blokujúca transakcia. Spustila sa, ale nedokončila a aplikácia, ktorá túto transakciu zablokovala, sa niekde zaoberá inými záležitosťami. A druhý požiadavok – update. Čaká, kým sa dokončí alter table, aby mohol pokračovať vo svojej práci.
Takto môžeme zistiť, kto koho zamkol, drží a môžeme sa tým ďalej zaoberať.
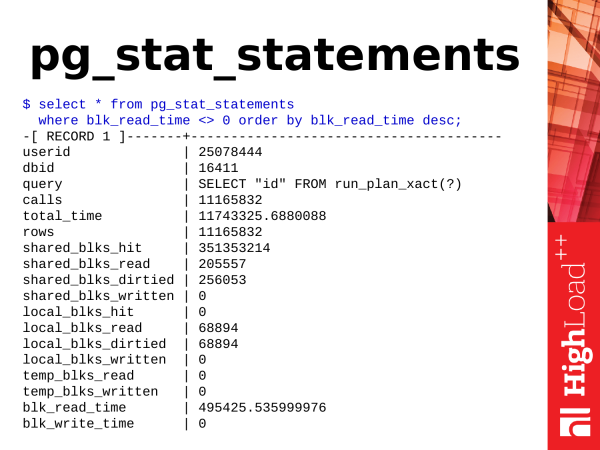
Ďalší modul – to je pg_stat_statements. Ako som už povedal, je to modul. Aby sme ho využili, musíme načítať jeho knižnicu v konfigurácii, reštartovať PostgreSQL, nainštalovať modul (jedným príkazom) a potom sa nám objaví nové zobrazenie.
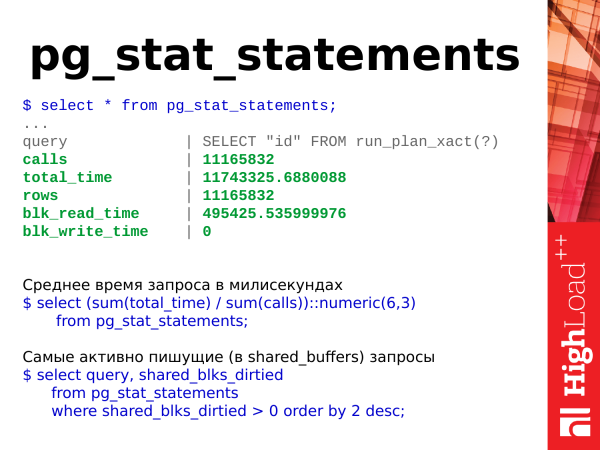
Priemerný čas požiadavky v milisekundách
$ select (sum(total_time) / sum(calls))::numeric(6,3)
from pg_stat_statements;

Najaktívnejšie zapisujúce (v shared_buffers) požiadavky
$ select query, shared_blks_dirtied
from pg_stat_statements
where shared_blks_dirtied > 0 order by 2 desc;
Čo môžeme z toho získať? Ak hovoríme o základných veciach, môžeme získať priemerný čas vykonania požiadavky. Čas rastie, znamená to, že PostgreSQL odpovedá pomaly a treba niečo podniknúť.
Môžeme si pozrieť najaktívnejšie zapisujúce transakcie v databáze, ktoré menia údaje v shared buffers. Pozrieť, kto u nás aktualizuje alebo odstraňuje dáta.
A môžeme si jednoducho pozrieť rôznu štatistiku týkajúcu sa týchto požiadaviek.
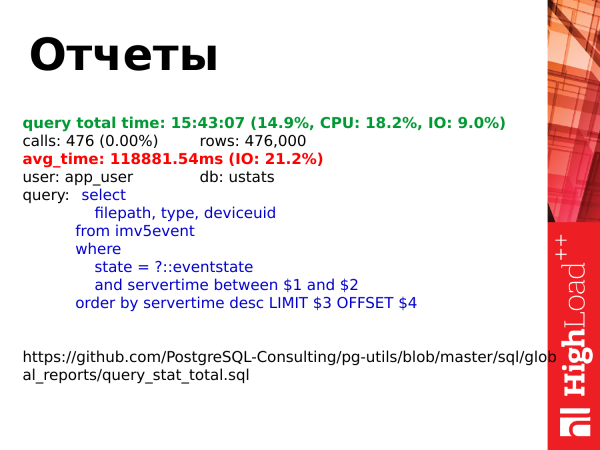
Integrujeme Grafanu s Omnibus pg_stat_statements používame na generovanie správ. Raz denne vymažeme štatistiku. Akumulujeme ju. Pred vymazaním štatistiky nabudúce vytvoríme správu. Tu je odkaz na správu. Môžete si ju pozrieť.
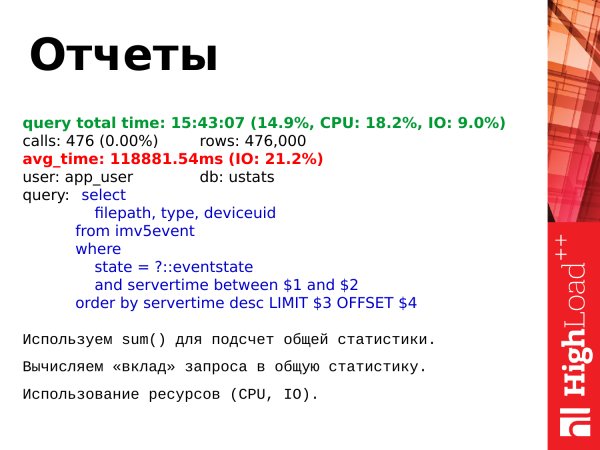
Čo robíme? Počítame celkovú štatistiku pre všetky požiadavky. Potom pre každú požiadavku počítame jej individuálny príspevok k tejto celkovej štatistike.
A čo môžeme vidieť? Môžeme vidieť súhrnný čas vykonania všetkých požiadaviek konkrétneho typu na pozadí všetkých ostatných požiadaviek. Môžeme sa pozrieť na využitie procesora a vstupu-výstupu vzhľadom na celkový obraz. A už optimalizovať tieto požiadavky. Vytvárame top požiadavky podľa tejto správy a už dostávame podnety na to, čo optimalizovať.
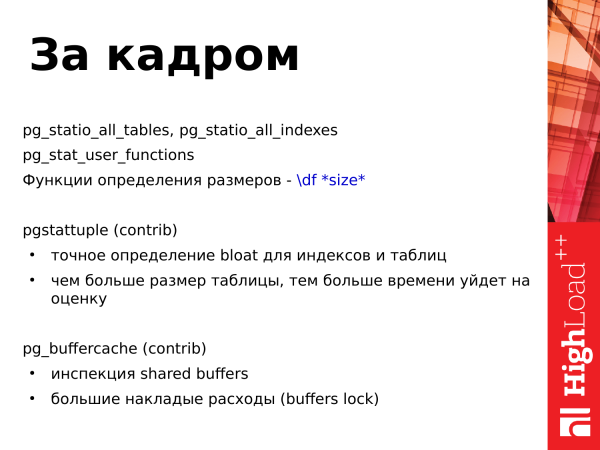
Čo nám ostalo za kamerou? Ostalo ešte niekoľko predstavení, ktoré som sa rozhodol nezohľadniť, pretože čas je obmedzený.
Existuje pgstattuple – to je tiež ďalší modul zo štandardného balíka contribs. Umožňuje oceniť bloat tabuľky, tzv. fragmentáciu tabuľky. A ak je fragmentácia veľká, je potrebné ju odstrániť, použiť rôzne nástroje. A funkcia pgstattuple pracuje dlhú dobu. A čím viac tabuliek, tým dlhšie bude pracovať.
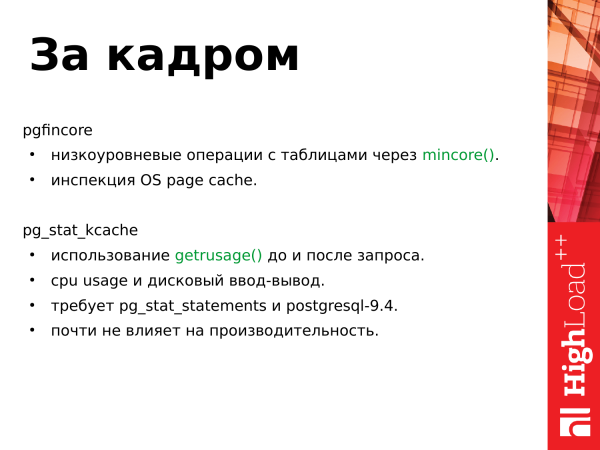
Nasledujúci contrib – to je pg_buffercache. Umožňuje vykonávať inšpekciu zdieľaných bufferov: akou intenzitou a pod ktoré tabuľky sú stránky bufferu využívané. A jednoducho umožňuje nazrieť do zdieľaných bufferov a zhodnotiť, čo sa tam deje.
Ďalší modul – to je pgfincore. Umožňuje vykonávať nízkoúrovňové operácie s tabuľkami cez systémový volaný mincore(), t. j. umožňuje načítať tabuľku do zdieľaných bufferov alebo ju vyprázdniť. A okrem iného umožňuje vykonať inšpekciu stránkového cache operačného systému, t. j. akú plochu zaberá tabuľka v page cache, v zdieľaných bufferoch a jednoducho umožňuje zhodnotiť zaťaženie tabuľky.
Nasledujúci modul – pg_stat_kcache. Používa tiež systémový volaný getrusage(). A vykonáva ho pred a po vykonaní dopytu. A v získanej štatistike umožňuje zhodnotiť, koľko nás dopyt stálo na vykonávanie diskového vstupu-výstupu, t. j. operácie s súborovým systémom a sleduje použitie procesora. Avšak modul je mladý (ehm-ehm) a pre svoju prácu vyžaduje PostgreSQL 9.4 a pg_stat_statements, o ktorých som hovoril skôr.
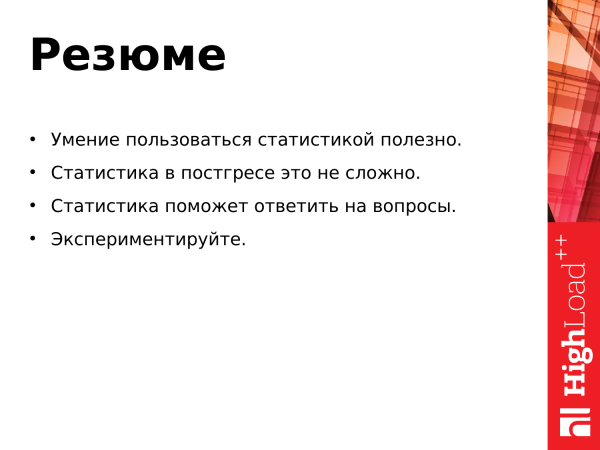
Schopnosť používať štatistiku – je užitočná. Nepotrebujete žiadne externé programy. Môžete si sami nazrieť, pozrieť sa, niečo urobiť, vykonať.
Používať štatistiku nie je ťažké, je to bežný SQL. Zostavili ste dopyt, zostavili, odoslali, pozreli sa.
Štatistika pomáha odpovedať na otázky. Ak máte otázky, obraciate sa na štatistiku – pozriete sa, urobíte závery, analyzujete výsledky.
A experimentujte. Dopytov je veľa, dát je veľa. Vždy je možné optimalizovať nejaký už existujúci dopyt. Môžete si vytvoriť svoju verziu dopytu, ktorá vám viac vyhovuje ako originál a používať ho.
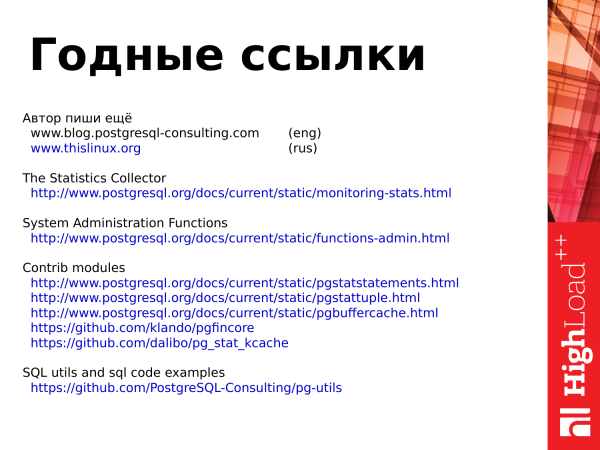
Odkazy
Užitočné odkazy, ktoré sa objavili v článku, podľa materiálov ktorého bola prezentácia.
Autor píše ešte
(eng)
Zberateľ štatistiky
Funkcie správy systému
Contrib moduly
SQL utils a príklady SQL kódu
Ďakujem všetkým za pozornosť!
Zdroj: habr.com
