

Ahojte všetci! Som vývojár CV v KROK. Už 3 roky realizujeme projekty v oblasti CV. Počas tohto času sme robili rôzne veci, ako napríklad: monitorovali vodičov, aby počas jazdy nepili, nefajčili, nehovorili po telefóne a pozerali na cestu, a nie na sny alebo do oblakov; zachytávali nadšencov jazdiacich na vyhradených pruhoch a zaberajúcich viacero miest na parkovisku; dohliadali na to, aby zamestnanci nosili prilby, rukavice a podobne; identifikovali zamestnanca, ktorý sa snaží dostať na objekt; sčítali všetko, čo sa dalo.
Na čo to všetko hovorím?
Počas realizácie projektov sme narazili na množstvo problémov, s niektorými z nich ste už možno oboznámení, alebo sa s nimi oboznámite v budúcnosti.
Modelujeme situáciu
Predstavme si, že sme zamestnali v mladej spoločnosti “N”, ktorej činnosť súvisí s ML. Pracujeme na ML (DL, CV) projekte, potom z nejakých dôvodov prejdeme na inú prácu, proste si dáme prestávku, a vraciame sa k svojej alebo cudzej neurónovej sieti.
- Nastáva moment pravdy, potrebujeme si nejako spomenúť, na čom sme sa zastavili, aké hyperparametre sme skúšali a čo je najdôležitejšie, aké výsledky to prinieslo. Existuje množstvo možností, ako si každý uchovával informácie o všetkých spusteniach: v hlave, v konfiguračných súboroch, v zápisníku, v pracovnom prostredí v cloude. Mal som možnosť vidieť možnosť, kde hyperparametre boli uchovávané ako zakomentované riadky v kóde, skrátka, fantázia. A teraz si predstavte, že sa vraciate nie k svojmu projektu, ale k projektu osoby, ktorá spoločnosť opustila a zdedili ste po nej kód a model s názvom model_1.pb. Pre úplnosť obrazu a prenesenie celej bolesti si predstavte, že ste aj začínajúci špecialista.
- Pokračujme ďalej. Na spustenie kódu potrebujeme a všetkým, ktorí s ním budú pracovať, je potrebné vytvoriť prostredie. Často sa stáva, že ani to nám z nejakých dôvodov nezanechali. To môže tiež byť netriviálna úloha. Na tento krok sa nám nechce strácať čas, že?
- Trénujeme model (napríklad detektor áut). Dostali sme sa do momentu, kedy je celkom fajn — je najvyšší čas uložiť výsledok. Nazveme ho car_detection_v1.pb. Potom trénujeme ďalší — car_detection_v2.pb. Po určitom čase naši kolegovia alebo my sami školíme ešte a ešte, pričom používame rôzne architektúry. Nakoniec sa vytvorí množstvo artefaktov, informácie o ktorých treba starostlivo zbierať (ale to urobíme neskôr, máme predsa zatiaľ dôležitejšie veci).
- A to je všetko! Máme model! Môžeme prejsť na školenie ďalšieho modelu, vypracovanie architektúry pre riešenie novej úlohy, alebo môžeme ísť na čaj? A kto bude nasadzovať?
Identifikujeme problémy
Práca na projekte alebo produkte je úsilím mnohých ľudí. A s časom prichádzajú a odchádzajú ľudia, projektov je viac, a samotné projekty sú zložitejšie. Tak či onak, situácie z opísaného cyklu (a nielen tie) sa vyskytujú v rôznych kombináciách od iterácie k iterácii. Všetko to vedie k plytvaniu časom, zmätku, nervom, možno — k nespokojnosti zákazníka, a nakoniec — k zmeškaným peniazom. Hoci všetci zvyčajne chodíme po starých hrabošoch, myslím, že nikto si nepraje prežívať tieto momenty znova a znova.
Takže sme prešli jedným cyklom vývoja a vidíme, že sú problémy, ktoré je potrebné vyriešiť. Na to potrebujeme:
- pohodlne ukladať výsledky práce;
- zjednodušiť proces zapojenia nových zamestnancov;
- zjednodušiť proces nasadzovania vývojového prostredia;
- nastaviť proces verzionovania modelov;
- mať pohodlný spôsob validácie modelov;
- nájsť nástroj na správu stavu modelov;
- nájsť spôsob doručenia modelov do produkcie.
Zjavne je potrebné vymyslieť workflow, ktorý by umožňoval ľahko a pohodlne spravovať tento životný cyklus? Takáto prax má názov MLOps.
MLOps, alebo DevOps pre strojové učenie, umožňuje tímom dátových analytikov a IT špecialistov spolupracovať a taktiež zvyšovať tempo vývoja a nasadzovania modelov pomocou monitorovania, overovania a systému správy pre modely strojového učenia.
Môžete , čo o tom myslia chlapci z Googlu. Z článku je jasné, že MLOps je celkom objemná vec.
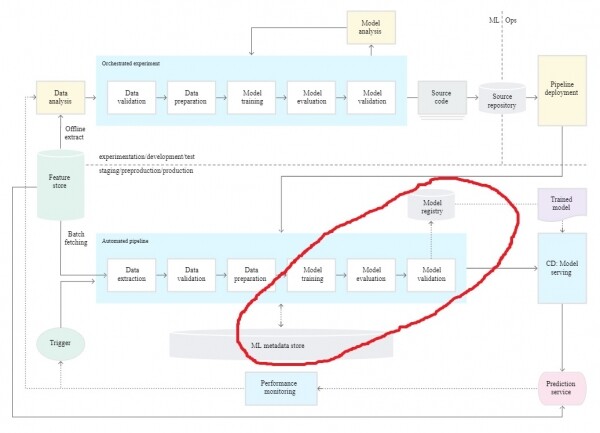
Ďalej vo svojom článku opíšem len časť procesu. Na jeho realizáciu využijem nástroj MLflow, pretože ide o projekt s otvoreným zdrojovým kódom, ktorý si vyžaduje len malé množstvo kódu na pripojenie a má integráciu s populárnymi ML rámcami. Môžete si na internete vyhľadať aj iné nástroje, ako napríklad Kubeflow, SageMaker, Trains a podobne, a možno nájdete ten, ktorý lepšie vyhovuje vašim potrebám.
"Budujeme" MLOps na príklade použitia nástroja MLFlow
MLFlow je platforma s otvoreným zdrojovým kódom pre správu životného cyklu ML modelov ().
MLflow obsahuje štyri komponenty:
- MLflow Tracking — rieši otázky zaznamenávania výsledkov a parametrov, ktoré k týmto výsledkom viedli;
- MLflow Project — umožňuje zabaliť kód a reprodukovať ho na akejkoľvek platforme;
- MLflow Models — zodpovedá za nasadenie modelov do produkcie;
- MLflow Registry — umožňuje uchovávať modely a spravovať ich stav v centralizovanom úložisku.
MLflow operuje s dvoma entitami:
- spustenie — je to kompletný cyklus učenia, parametre a metriky, ktoré chceme registrovať;
- experiment — je to "téma", ktorá spája spustenia.
Všetky kroky príkladu sú realizované na operačnom systéme Ubuntu 18.04.
1. Rozkládame server
Aby sme mohli ľahko spravovať náš projekt a získať všetky potrebné informácie, rozložíme server. MLflow tracking server má dva hlavné komponenty:
- backend store — zodpovedá za uchovávanie informácií o registrovaných modeloch (podporuje 4 DBMS: mysql, mssql, sqlite a postgresql);
- artifact store — zodpovedá za uchovávanie artefaktov (podporuje 7 variantov uchovávania: Amazon S3, Azure Blob Storage, Google Cloud Storage, FTP server, SFTP Server, NFS, HDFS).
Ako artifact store pre jednoduchosť vezmeme SFTP server.
- vytvárame skupinu
$ sudo groupadd sftpg - pridávame používateľa a nastavujeme mu heslo
$ sudo useradd -g sftpg mlflowsftp $ sudo passwd mlflowsftp - upravením niekoľkých nastavení prístupu
$ sudo mkdir -p /data/mlflowsftp/upload $ sudo chown -R root.sftpg /data/mlflowsftp $ sudo chown -R mlflowsftp.sftpg /data/mlflowsftp/upload - pridávame niekoľko riadkov do /etc/ssh/sshd_config
Match Group sftpg ChrootDirectory /data/%u ForceCommand internal-sftp - reštartujeme službu
$ sudo systemctl restart sshd
Ako backend store vezmeme postgresql.
$ sudo apt update
$ sudo apt-get install -y postgresql postgresql-contrib postgresql-server-dev-all
$ sudo apt install gcc
$ pip install psycopg2
$ sudo -u postgres -i
# Vytvorenie nového používateľa: mlflow_user
[postgres@user_name~]$ createuser --interactive -P
Zadajte názov rolí na pridanie: mlflow_user
Zadajte heslo pre novú rolu: mlflow
Zadajte ho znova: mlflow
Mala by byť nová rola superužívateľom? (y/n) n
Mala by nová rola mať právo vytvárať databázy? (y/n) n
Mala by nová rola mať právo vytvárať ďalšie nové roly? (y/n) n
# Vytvorenie databázy mlflow_bd, ktorú vlastní mlflow_user
$ createdb -O mlflow_user mlflow_db
Na spustenie servera je potrebné nainštalovať nasledujúce python balíky (odporúčam vytvoriť samostatné virtuálne prostredie):
pip install mlflow
pip install pysftp
Spúšťame náš server
$ mlflow server
                 --backend-store-uri postgresql://mlflow_user:mlflow@localhost/mlflow_db
                 --default-artifact-root sftp://mlflowsftp:mlflow@sftp_host/upload
                --host server_host
                --port server_port
2. Pridávame sledovanie
Aby sa výsledky našich tréningov nestratili, aby budúce generácie vývojárov rozumeli tomu, čo sa vlastne dialo, a starší kolegovia aj vy mohli pokojne analyzovať proces učenia, musíme pridať sledovanie. Sledovanie znamená uchovávanie parametrov, metrik, artefaktov a akejkoľvek ďalšej informácie o behu učenia, v našom prípade, na serveri.
Na ukážku som vytvoril malý na Keras na segmentáciu všetkého, čo sa nachádza v . Na pridanie sledovania som vytvoril súbor mlflow_training.py.
Tu sú riadky, v ktorých sa deje to najzaujímavejšie:
def run(self, epochs, lr, experiment_name):
        # získanie id experimentu, vytvorenie experimentu v jeho neprítomnosti
        remote_experiment_id = self.remote_server.get_experiment_id(name=experiment_name)
        # vytvorenie "behu" a získanie jeho id
        remote_run_id = self.remote_server.get_run_id(remote_experiment_id)

        # určte, že chceme ukladať výsledky na vzdialenom serveri
        mlflow.set_tracking_uri(self.tracking_uri)
        mlflow.set_experiment(experiment_name)

        with mlflow.start_run(run_id=remote_run_id, nested=False):
            mlflow.keras.autolog()
            self.train_pipeline.train(lr=lr, epochs=epochs)

        try:
            self.log_tags_and_params(remote_run_id)
        except mlflow.exceptions.RestException as e:
            print(e)
Tu self.remote_server je malá obálka nad metódami mlflow.tracking. MlflowClient (urobil som to pre pohodlie), pomocou ktorých vytváram experiment a spustenie na serveri. Následne uvádzam, kam by sa mali ukladať výsledky spustenia (mlflow.set_tracking_uri(self.tracking_uri)). Pripojujem automatické logovanie mlflow.keras.autolog(). V súčasnosti MLflow Tracking podporuje automatické logovanie pre TensorFlow, Keras, Gluon XGBoost, LightGBM, Spark. Ak ste nenašli svoj rámec alebo knižnicu, vždy môžete logovať explicitne. Spúšťame učenie. Registrujeme značky a vstupné parametre na vzdialenom serveri.
Niekoľko riadkov a vy, ako všetci ostatní, máte prístup k informáciám o všetkých spusteniach. Super?
3. Pripravujeme projekt
Teraz spravíme tak, aby spustenie projektu bolo jednoduché. Na to pridáme do koreňového adresára súbor MLproject a conda.yaml.
MLproject
name: flow_segmentation
conda_env: conda.yaml

entry_points:
  main:
    parameters:
        categories: {help: 'zoznam kategórií z coco dataset'}
        epochs: {type: int, help: 'počet epoch pri tréningu'}

        lr: {type: float, default: 0.001, help: 'učebná miera'}
        batch_size: {type: int, default: 8}
        model_name: {type: str, default: 'Unet', help: 'Unet, PSPNet, Linknet, FPN'}
        backbone_name: {type: str, default: 'resnet18', help: 'napríklad resnet18, resnet50, mobilenetv2 ...'}

        tracking_uri: {type: str, help: 'adresa servera'}
        experiment_name: {type: str, default: 'My_experiment', help: 'názov experimentu na vzdialenom a lokálnom serveri'}
    command: "python mlflow_training.py
            --epochs={epochs}
            --categories={categories}
            --lr={lr}
            --tracking_uri={tracking_uri}
            --model_name={model_name}
            --backbone_name={backbone_name}
            --batch_size={batch_size}
            --experiment_name={experiment_name}"
MLflow Projekt má niekoľko vlastností:
- Name — názov vášho projektu;
- Environment — v mojom prípade conda_env označuje, že na spustenie sa používa Anaconda a popis závislostí sa nachádza v súbore conda.yaml;
- Entry Points — uvádza, aké súbory a s akými parametrami môžeme spustiť (všetky parametre pri spustení učenia sa automaticky logujú)
conda.yaml
name: flow_segmentation
channels:
  - defaults
  - anaconda
dependencies:
  - python==3.7
  - pip:
    - mlflow==1.8.0
    - pysftp==0.2.9
    - Cython==0.29.19
    - numpy==1.18.4
    - pycocotools==2.0.0
    - requests==2.23.0
    - matplotlib==3.2.1
    - segmentation-models==1.0.1
    - Keras==2.3.1
    - imgaug==0.4.0
    - tqdm==4.46.0
    - tensorflow-gpu==1.14.0
Ako prostredie vykonávania môžete použiť docker, pre podrobnejšie informácie sa obráťte na .
4. Spúšťame učenie
Klonujeme projekt a prechádzame do adresára projektu:
git clone https://github.com/simbakot/mlflow_example.git
cd mlflow_example/
Na spustenie potrebujete nainštalovať knižnice
pip install mlflow
pip install pysftp
Keďže v príklade používam conda_env, Anaconda by mala byť nainštalovaná na vašom počítači (ale to sa dá obísť aj ručnou inštaláciou všetkých potrebných balíkov a experimentovaním s parametrami spustenia).
Všetky prípravné kroky sú dokončené a môžeme začať s tréningom. Z koreňa projektu:
$ mlflow run -P epochs=10 -P categories=cat,dog -P tracking_uri=http://server_host:server_port .Po zadaní príkazu sa automaticky vytvorí conda prostredie a spustí sa tréning.
V príklade vyššie som zadal počet epoch na učenie a kategórie, na ktoré chceme segmentovať (plný zoznam je možné pozrieť si ) a adresu našej vzdialenej servera.
Plný zoznam možných parametrov si môžete pozrieť v súbore MLproject.
5. Hodnotíme výsledky učenia
Po dokončení učenia sa môžeme v prehliadači prepraviť na adresu nášho servera
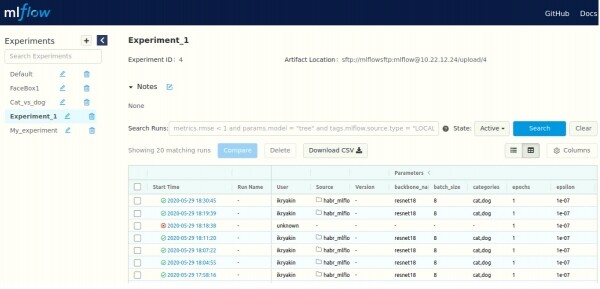
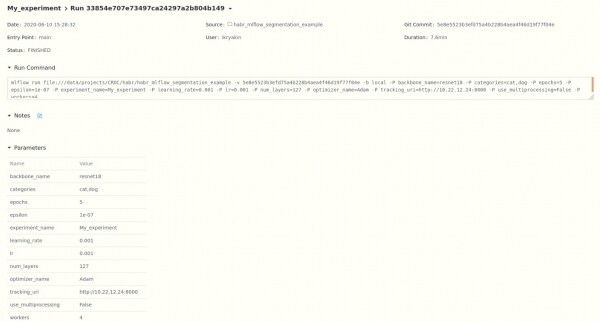
Tu vidíme zoznam všetkých experimentov (vľavo hore), ako aj informácie o spusteniach (uprostred). Môžeme si pozrieť podrobnejšie informácie (parametre, metriky, artefakty a nejaké ďalšie informácie) k každému spusteniu.
Pri každej metrike môžeme pozorovať históriu zmien
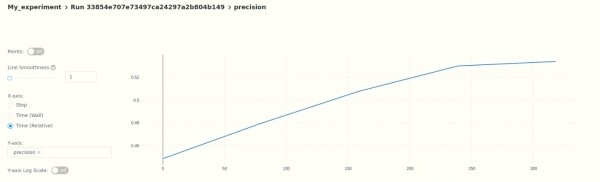
T.j. momentálne môžeme analyzovať výsledky v "ručne" režime, tiež môžete nastaviť aj automatickú validáciu pomocou MLflow API.
6. Registrovanie modelu
Po tom, čo sme analyzovali náš model a rozhodli sme sa, že je pripravený na nasadenie, pristupujeme k jeho registrácii, na to vyberáme potrebné spustenie (ako je uvedené v predchádzajúcom bode) a posúvame sa smerom dole.
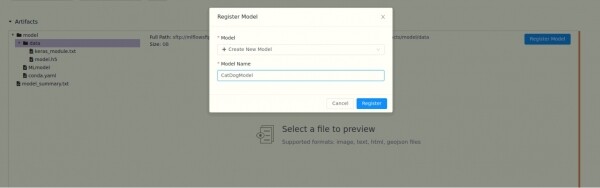
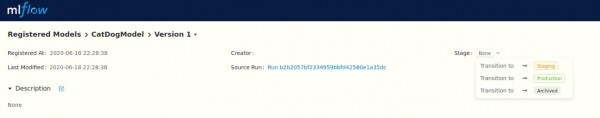
Po tom, čo sme modelu pridelili názov, dostane aj verziu. Pri ukladaní iného modelu s rovnakým názvom sa verzia automaticky zvýši.
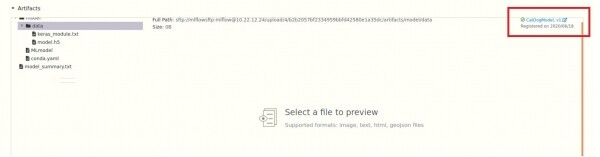
Pre každý model môžeme pridať popis a zvoliť jeden z troch stavov (Staging, Production, Archived), neskôr sa pomocou API môžeme odkazovať na tieto stavy, čo spolu s versionovaním poskytuje ďalšiu flexibilitu.
Máme tiež pohodlný prístup ku všetkým modelom
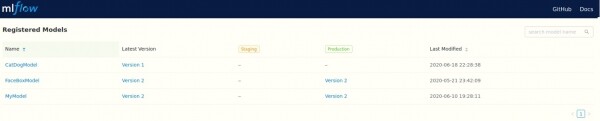
a ich verziám
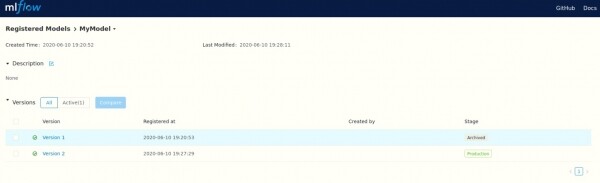
Ako v predchádzajúcom bode, všetky operácie je možné vykonať pomocou API.
7. Nasadenie modelu
V tejto fáze už máme natrénovaný (keras) model. Príklad, ako ho možno použiť:
class SegmentationModel:
    def __init__(self, tracking_uri, model_name):

        self.registry = RemoteRegistry(tracking_uri=tracking_uri)
        self.model_name = model_name
        self.model = self.build_model(model_name)

    def get_latest_model(self, model_name):
        registered_models = self.registry.get_registered_model(model_name)
        last_model = self.registry.get_last_model(registered_models)
        local_path = self.registry.download_artifact(last_model.run_id, 'model', '.\/')
        return local_path

    def build_model(self, model_name):
        local_path = self.get_latest_model(model_name)

        return mlflow.keras.load_model(local_path)

    def predict(self, image):
        image = self.preprocess(image)
        result = self.model.predict(image)
        return self.postprocess(result)

    def preprocess(self, image):
        image = cv2.resize(image, (256, 256))
        image = image / 255.
        image = np.expand_dims(image, 0)
        return image

    def postprocess(self, result):
        return result
Tu self.registry je opäť malou vrstvou nad mlflow.tracking.MlflowClient pre pohodlie. Podstata spočíva v tom, že sa obraciam na vzdialený server a hľadám tam model s určeným názvom, pričom najnovšiu produkčnú verziu. Potom sťahujem artifact lokálne do zložky .\/model a zostavujem model z tejto adresára mlflow.keras.load_model(local_path). Teraz môžeme využiť náš model. CV (ML) vývojári sa môžu nerušene venovať zlepšovaniu modelu a publikovať nové verzie.
Na záver
Predstavil som systém, ktorý umožňuje:
- centralizovane uchovávať informácie o ML modeloch, priebehu a výsledkoch učenia;
- rýchlo nasadiť vývojové prostredie;
- sledovať a analyzovať priebeh práce na modeloch;
- pohodlne spravovať verziovanie a stav modelov;
- ľahko nasadiť získané modely.
Tento príklad je hrací a slúži ako východiskový bod na vybudovanie vlastného systému, ktorý možno bude zahŕňať automatizáciu hodnotenia výsledkov a registráciu modelov (p.5 a p.6) alebo pridáte verziovanie datasets, alebo možno niečo iné? Chcel som poskytnúť myšlienku, že potrebujete MLOps ako celok, MLflow je iba prostriedok k dosiahnutiu cieľa.
Napíšte, aké problémy, s ktorými ste sa stretli, som nezobrazil?
Čo by ste pridali do systému, aby pokrýval vaše potreby?
Aké nástroje a prístupy používate na vyriešenie všetkých alebo časti problémov?
P.S. Nechám pár odkazov:
github projekt —
MLflow —
Môj pracovný email, pre otázky — ikryakin@croc.ru
V našej spoločnosti sa pravidelne konajú rôzne podujatia pre IT odborníkov, napríklad 8. júla o 19:00 moskovského času sa uskutoční online meetup o CV. Ak máte záujem, môžete sa zúčastniť, registrácia je otvorená. .
Zdroj: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish