

Monitorovanie sa stalo veľmi dôležitou súčasťou rastúcich cloudových riešení s rastúcou zložitostí distribuovaných systémov. Je nevyhnutné na pochopenie ich správania. Potrebujeme škálovateľné nástroje, ktoré dokážu zhromažďovať údaje zo všetkých služieb — a poskytnúť odborníkom jediné rozhranie s analýzou výkonu, zobrazením chýb, dostupnosťou a protokolmi.
Tieto nástroje musia byť efektívne a výkonné. V tomto článku preskúmame dva populárne technologické stacky: EFK (Elasticsearch) a PLG (Loki) a podrobne si objasníme ich architektúry a rozdiely.
Stack EFK
Možno ste už počuli o veľmi populárnom ELK alebo EFK. Stack sa skladá z viacerých samostatných častí: Elasticsearch (objektové úložisko), Logstash alebo FluentD (zhromažďovanie a agregácia protokolov) a Kibana na vizualizáciu.
Typická schéma práce vyzerá takto:
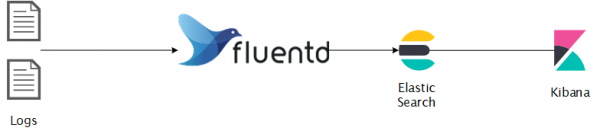
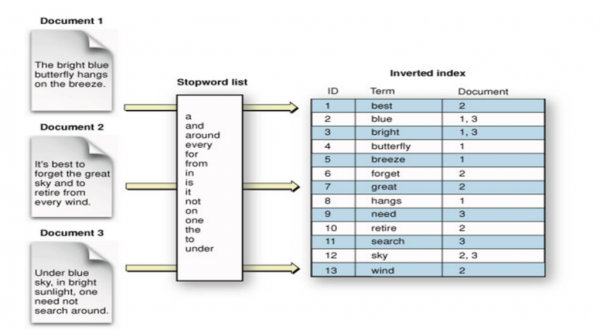
Elasticsearch — distribuované objektové úložisko s vyhľadávaním a analýzou v reálnom čase. Vynikajúce riešenie pre čiastočne štruktúrované údaje, napríklad protokoly. Informácie sa ukladajú vo formáte JSON, indexujú sa v reálnom čase a distribuujú po uzloch klastra. Používa sa inverzný index, ktorý obsahuje všetky unikátne slová a s nimi súvisiace dokumenty na full-textové vyhľadávanie, ktoré je zase založené na vyhľadávacom engíne Apache Lucene.
FluentD — to je zberateľ údajov, ktorý vykonáva unifikáciu údajov pri ich zbere a spotrebe. Snaží sa usporiadať dáta do JSON, ak je to možné. Jeho architektúra je rozšíriteľná, existuje viac ako , podporovaných komunitou, pre všetky možné situácie.
Kibana — nástroj na vizualizáciu údajov pre Elasticsearch s rôznymi doplnkovými funkciami, napríklad analýzou časových radov, grafami, strojovým učením a ďalším.
Architektúra Elasticsearch
Údaje klastra Elasticsearch sú uložené rozptýlene po všetkých jeho uzloch. Klastra sa skladá z viacerých uzlov na zlepšenie dostupnosti a odolnosti. Akýkoľvek uzol môže vykonávať všetky úlohy klastra, ale v veľkých škálovateľných nasadeniach sa uzlom zvyčajne priraďujú konkrétne úlohy.
Typy uzlov klastra:
- master node — spravuje klastra, potrebujeme minimálne tri, jeden je vždy aktívny;
- data node — uchováva indexované údaje a vykonáva s nimi rôzne úlohy;
- ingest node — organizuje konveje pre transformáciu dát pred indexovaním;
- coordinating node — smerovanie požiadaviek, skrátenie fázy spracovania vyhľadávania, koordinácia masívneho indexovania;
- alerting node — spúšťanie úloh pre upozornenia;
- machine learning node — spracovanie úloh strojového učenia.
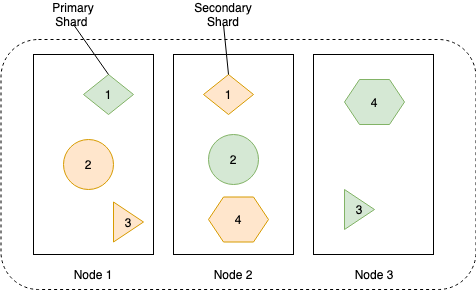
Na diagrame nižšie je znázornené, ako sa dáta ukladajú a replikujú medzi uzlami na dosiahnutie vyššej dostupnosti dát.
Dáta každého replikátu sú uložené v invertovanom indexe, schéma nižšie ukazuje, ako to prebieha:
Inštalácia
Podrobnosti si môžete pozrieť , použijem helm chart:
$ helm install efk-stack stable/elastic-stack --set logstash.enabled=false --set fluentd.enabled=true --set fluentd-elasticsPLG stack
Nenechajte sa prekvapiť, ak nemôžete nájsť túto skratku, pretože ju viac poznajú ako Grafana Loki. V každom prípade tento stack naberá popularitu, pretože používa presné technické riešenia. Možno ste už počuli o Grafane, populárnom nástroji na vizualizáciu. Jej tvorcovia, inšpirujúci sa Prometheus, vyvinuli Loki, horizontálne škálovateľný vysoko výkonný systém agregácie logov. Loki indexuje len metadata, nie samotné logy, toto technické riešenie umožnilo, aby bol jednoducho použiteľný a ekonomicky výhodný.
Promtail — agent na odosielanie logov z operačného systému do klastra Loki. Grafana — vizualizačný nástroj založený na dátach z Loki.
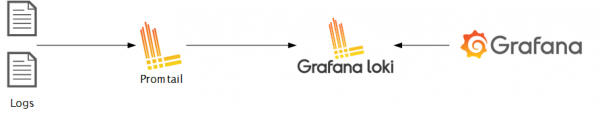
Loki je postavený na rovnakých princípoch ako Prometheus, preto je vhodný na uchovávanie a analýzu logov Kubernetes.
Architektúra Loki
Loki môže byť spustený ako v režime jedného procesu, tak aj vo forme viacerých procesov, čo zabezpečuje horizontálne škálovanie.
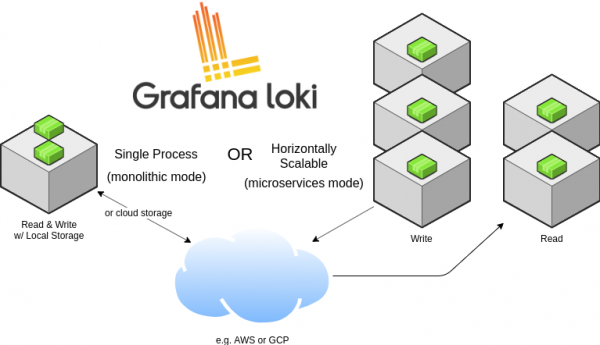
Môže tiež fungovať ako monolitná aplikácia alebo ako mikroservis. Spustenie ako jedného procesu sa môže hodiť pre miestny vývoj alebo pre menšie monitorovanie. Pre priemyselné nasadenie a škálovateľné zaťaženie sa odporúča používať mikroservisnú variantu. Cesty na zápis a čítanie dát sú oddelené, takže ho možno dosť jemne nastaviť a škálovať podľa potreby.
Pozrime sa na architektúru systému zbierania logov bez detailov:
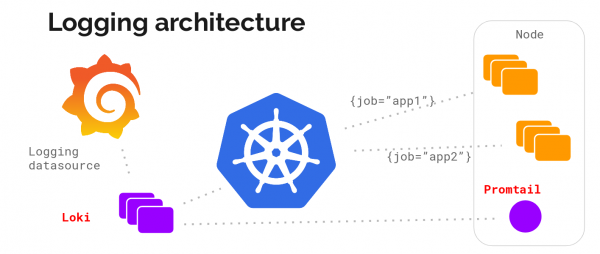
A tu je opis (mikroservisná architektúra):
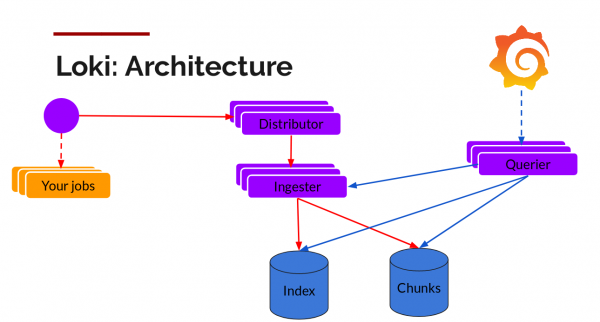
Zložky:
Promtail — agent inštalovaný na uzloch (vo forme súboru služieb), ktorý získa protokoly z úloh a osloví API Kubernetes pre získanie metadát, ktorými budú označené protokoly. Potom ich odošle do hlavnej služby Loki. Pre porovnávanie metadát sú podporované rovnaké pravidlá pre označovanie ako v Prometheovi.
Distribútor — služba-distribútor fungujúca ako buffer. Pre spracovanie miliónov záznamov balí prichádzajúce dáta, komprimujúc ich do blokov po príchode. Súčasne pracuje niekoľko prijímačov dát, ale protokoly patriace jednému toku prichádzajúcich dát musia byť iba v jednom z nich pre všetky jeho bloky. Je to organizované ako kruh prijímačov a sekvenčné hashovanie. Pre odolnosť a redundanciu sa to robí n-krát (3, ak nie je nastavené inak).
Ingester — služba-prijímač. Bloky dát prichádzajú komprimované s pridanými protokolmi. Akonáhle je blok dostatočne veľký, blok sa odošle do databázy. Metadáta idú do indexu, a dáta z bloku s protokolom sa dostanú do Chunks (zvyčajne to je objektové úložisko). Po odoslaní prijímač vytvorí nový blok, do ktorého budú pridávané nové záznamy.
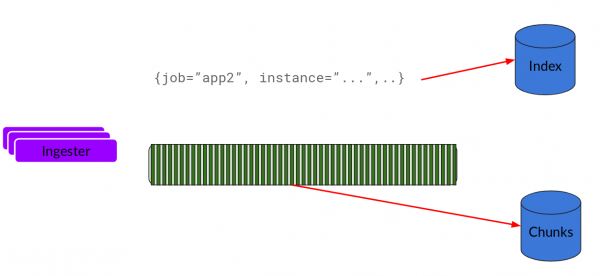
Index — databáza, ako DynamoDB, Cassandra, Google BigTable a podobne.
Chunks — bloky protokolov v komprimovanej podobe, zvyčajne uložené v objektovom úložisku, napríklad S3.
Dotazovateľ — cesta čítania, ktorá vykonáva všetku prácu. Sleduje časový rozsah a značky, po čom sa pozrie na index pre vyhľadávanie zhôd. Potom číta bloky dát a filtruje ich na základe výsledkov.
A teraz sa pozrime na všetko v akcii.
Inštalácia
Pre inštaláciu do Kubernetes je najjednoduchšie použiť helm. Predpokladáme, že ste ho už nainštalovali a nastavili ( pozn. prekladateľa)
Pridávame repozitár a inštalujeme balík.
$ helm repo add loki https://grafana.github.io/loki/charts
$ helm repo update
$ helm upgrade --install loki loki/loki-stack --set grafana.enabled=true,prometheus.enabled=true,prometheus.alertmanager.persistentVolume.enabled=false,prometheus.server.persistentVolume.enabled=false
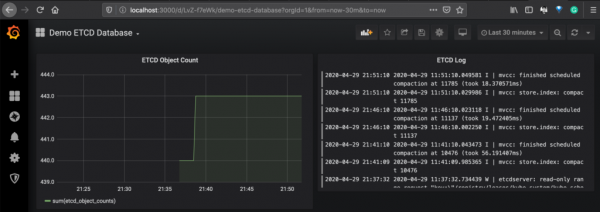
Nižšie je uvedený príklad panelu, na ktorom sú zobrazené dáta z Prometheusa pre metriky Etcd a Loki pre protokoly podov Etcd.
A teraz sa poďme pozrieť na architektúru oboch systémov a porovnať ich možnosti navzájom.
Porovnanie
Dotazovací jazyk
V Elasticsearch sa používa Query DSL a Lucene query language, ktoré umožňujú fulltextové vyhľadávanie. Ide o osvedčený silný vyhľadávací engine s širokou podporou operátorov. S jeho pomocou môžete vyhľadávať v kontexte a triediť podľa relevancie.
Na druhej strane ringu je LogQL, aplikovaný v Loki, nástupca PromQL (Prometheus query language). Používa štítky logov na filtrovanie a výber údajov z logov. Je možné použiť niektoré operátory a aritmetiku, ako je opísané , ale z pohľadu možností zaostáva za Elastic language.
Keďže sú dotazy v Loki spojené so štítkami – ich je ľahké skombinovať s metrikami, čím je jednoduchšie organizovať operačný monitoring.
Škálovateľnosť
Obe stacky sú horizontálne škálovateľné, ale v prípade Loki je to jednoduchšie, pretože má oddelené cesty na čítanie a zápis údajov, ako aj mikroservisnú architektúru. Loki môže byť prispôsobený vašim potrebám a môže byť použitý na veľmi veľké objemy údajov z logov.
Multi-tenancy
Multi-tenancy klastra je spoločná téma na zníženie OPEX, oba stacky zabezpečujú multi-tenancy. Pre Elasticsearch existuje niekoľko rozdelenia klientov: samostatný index pre každého klienta, routovanie na základe klienta, jedinečné polia klienta, vyhľadávacie filtre. V Loki existuje v podobe hlavičky HTTP X-Scope-OrgID.
Cena
Loki je veľmi ekonomicky efektívny kvôli tomu, že nevytvára indexovanie údajov, ale len metadát. Týmto spôsobom sa dosahuje a pamäti (cache), pretože objektové úložisko je lacnejšie ako blokové, ktoré sa používa v klastri Elasticsearch.
Záver
Stack EFK sa môže používať na rôzne účely, poskytujúc maximálnu flexibilitu a multifunkčný rozhranie Kibana na analýzu, vizualizáciu a dotazy. Môže byť ďalej vylepšený možnosťami strojového učenia.
Stack Loki je užitočný v ekosystéme Kubernetes kvôli mechanizmu objavovania metadát. Údaje na monitorovanie založené na časových radoch v Grafana a logoch je možné ľahko mapovať.
Pokiaľ ide o náklady a dlhodobé uchovávanie logov, Loki je skvelou voľbou pre vstup do cloudových riešení.
Na trhu existuje viac alternatív — niektoré môžu byť lepšie pre vás. Napríklad pre GKE je k dispozícii integrácia Stackdriver, ktorá ponúka vynikajúce riešenie na monitoring. Nezaradili sme ich do našej analýzy v tomto článku.
Odkazy:
Článok bol preložený a pripravený pre Habr zamestnancami — intenzívne kurzy, videoškolenia a firemné vzdelávanie od odborníkov v praxi (Kubernetes, DevOps, Docker, Ansible, Ceph, SRE, Agile)
Zdroj: habr.com
