

Hlavným cieľom Patroni je zabezpečiť vysokú dostupnosť pre PostgreSQL. Ale Patroni je len šablóna, nie hotový nástroj (čo je v podstate uvedené aj v dokumentácii). Na prvý pohľad, po nastavení Patroni v testovacej laboratórii, môžeme vidieť, aký je to skvelý nástroj a ako ľahko spracováva naše pokusy o rozpad klasteru. Avšak v praxi, v produkčnom prostredí, sa nie vždy všetko odohráva tak krásne a elegantne ako v testovacej laboratórii.
Povedzme si niečo o mne. Začínal som ako systémový administrátor. Pracoval som vo webovom vývoji. Od roku 2014 pracujem v spoločnosti Data Egret. Firma sa zaoberá konzultáciami v oblasti Postgres. A my sa staráme práve o Postgres a každý deň pracujeme s Postgres, takže máme rôznu odbornosť týkajúcu sa prevádzky.
A na konci roku 2018 sme začali pomaly používať Patroni. A získali sme určité skúsenosti. Diagnostikovali sme ho, ladili sme ho a dostali sme sa k svojim osvedčeným praxiam. A v tejto prednáške vám o nich poviem.
Okrem Postgres mám rád Linux. Rád sa v ňom hrabem a skúmam, rád zostavujem jadro. Zaujímajú ma virtualizácia, kontajnery, Docker, Kubernetes. Zaujíma ma to všetko, pretože sa prejavujú staré administrátorské návyky. Rád sa zaoberám monitorovaním. A mám rád postgresové záležitosti, súvisiace s administráciou, ako je replikácia a zálohovanie. Vo svojom voľnom čase píšem v Go. Nie som softvérový inžinier, píšem len pre seba v Go. A baví ma to.
- Myslím, že mnohí z vás vedia, že v Postgres nie je vysoká dostupnosť (HA) priamo z krabice. Aby sme dosiahli HA, musíme niečo nainštalovať, nastaviť, vynaložiť úsilie a získať to.
- Existuje niekoľko nástrojov a Patroni je jedným z nich, ktorý veľmi dobre rieši HA. Ale po nainštalovaní všetkého v testovacej laboratórii a spustení môžeme vidieť, že všetko funguje, môžeme reprodukovať nejaké problémy a pozrieť sa, ako ich Patroni spracováva. A zistíme, že všetko to funguje skvele.
- Ale v praxi sme sa stretli s rôznymi problémami. A o týchto problémoch vám poviem.
- Povedzme si, ako sme to diagnostikovali, čo sme nastavovali – pomohlo nám to alebo nie.
- Nebudem rozprávať o tom, ako nainštalovať Patroni, pretože to sa dá vyhľadať na internete, môžete si pozrieť konfiguračné súbory, aby ste pochopili, ako to všetko funguje a ako sa nastavuje. Môžete sa oboznámiť so schémami a architektúrami a nájsť informácie o tom na internete.
- Nebudem rozprávať o cudzom skúsenosti. Budem hovoriť len o tých problémoch, ktorým sme čelili my sami.
- A nebudem rozprávať o problémoch, ktoré presahujú Patroni a PostgreSQL. Ak napríklad ide o problémy spojené s vyvažovaním, keď sa nám rozpadol klaster, o tom hovoriť nebudem.
A malý disclaimer predtým, než začneme našu prezentáciu.
Všetky tieto problémy, s ktorými sme sa stretli, sa vyskytli v prvých 6-7-8 mesiacoch používania. S časom sme si vyvinuli svoje vlastné interné best practices. A problémy nám zmizli. Preto sa prezentácia plánovala približne pred pol rokom, keď to všetko bolo fresh v hlave a dobre som to všetko pamätal.
Počas prípravy prezentácie som opäť preštudoval staré postmortemy, pozeral logy. A niektoré detaily mohli zabudnúť, alebo niektoré detaily mohli byť nedostatočne preskúmané pri analýze problémov, preto v niektorých momentoch môže pôsobiť, že problémy boli posúdené neúplne, alebo je tam nedostatok informácií. A preto sa za tento moment ospravedlňujem.
Čo je to Patroni?
- Je to vzor na vytvorenie HA. Tak je napísané v dokumentácii. A z môjho pohľadu je to veľmi správne upresnenie. Patroni nie je strieborná guľka, ktorá vyrieši všetky vaše problémy, t.j. je potrebné vyvinúť úsilie, aby to začalo fungovať a prinášalo prospech.
- Je to agenta služba, ktorá sa inštaluje na každú službu s databázou a ktorá je akýmsi init systémom pre váš Postgres. Spúšťa Postgres, zastavuje, reštartuje, mení konfiguráciu a mení topológiu vášho klastra.
- Aby sa teda uchovával stav klastra a jeho aktuálne zobrazenie, ako vyzerá, je potrebné nejaké úložisko. A z tohto hľadiska sa Patroni vybral cestou uchovávania stavu vo vonkajšej sústave. Tento systém je distribuované úložisko konfigurácie. Môžu to byť Etcd, Consul, ZooKeeper, alebo kubernetes’ký Etcd, teda nejaká z týchto možností.
- Jednou z vlastností Patroni je, že automatický failover dostanete z krabice, stačí ho nastavit. Když porovnáme s Repmgr, failover je zde součástí. S Repmgr získáme switchover, ale pokud chceme automatický failover, musíme ho nastavit zvlášť. V Patroni je automatický failover již v základu.
- A je tu mnoho dalších věcí. Například správa konfigurací, zavádění nových replik, zálohování atd. Ale to je mimo rozsah této prezentace, o tom mluvit nebudu.
A malý závěr – hlavní úkol Patroni je dobře a spolehlivě provádět automatický failover, aby zůstal náš cluster funkční a aplikace si nevšimla změn v topologii clusteru.
Ale když začneme používat Patroni, náš systém se trochu zkomplikuje. Pokud jsme předtím měli Postgres, s použitím Patroni získáváme samotnou Patroni, DCS, kde se uchovává stav. A všechno to musí nějak fungovat. Takže, co se může pokazit?
Může se pokazit:
- Může se pokazit Postgres. Může to být master nebo replikace, jedna z nich může přestat fungovat.
- Může se pokazit samotná Patroni.
- Může se pokazit DCS, kde se uchovává stav.
- A může se pokazit síť.
Všechny tyto aspekty budu zvažovat v prezentaci.
Budu zvažovat případy podle jejich složitosti, ne z hlediska toho, že případ zasahuje do mnoha komponentů. Ale z hlediska subjektivních pocitů, že tento případ byl pro mě složitý, bylo těžké ho rozebrat... a naopak, některé případy byly lehké a bylo snadné je rozebrat.
A první případ je nejjednodušší. To je ten případ, kdy jsme vzali cluster databází a na tom samém clusteru jsme nasadili naše DCS úložiště. To je nejčastější chyba. Je to chyba v architektuře, tedy kombinování různých komponentů na jednom místě.
Takže, došlo k failoveru, jdeme zjistit, co se stalo.
A nás zajímá, kdy došlo k failoveru. Tedy nás zajímá ten okamžik, kdy došlo k změně stavu clusteru.
Ale failover není vždy okamžitý, tedy nezabírá určitou časovou jednotku, může se protáhnout. Může trvat delší dobu.
Preto má čas začatia a čas ukončenia, t. j. ide o dlhodobú udalosť. A všetky udalosti delíme na tri intervaly: máme čas pred failoverom, počas failoveru a po failoveri. T. j. zohľadňujeme všetky udalosti v tejto časovej osi.
A prvé, čo spravíme, keď nastane failover, je hľadanie príčiny, čo sa stalo, čo spôsobilo, že došlo k failoveru.
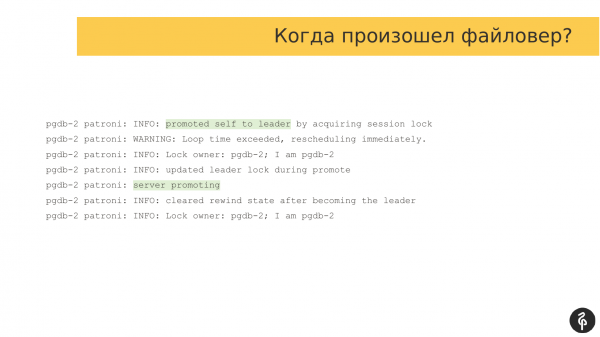
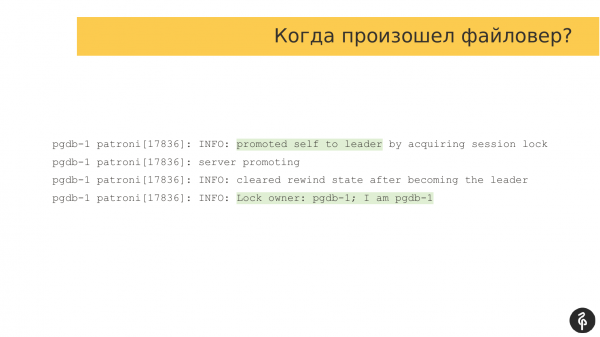
Ak sa pozrieme na logy, tak to budú klasické logy Patroni. V nich nám oznamuje, že server sa stal hlavným, a úloha hlavného prešla na tento uzol. Tu je to zvýraznené.
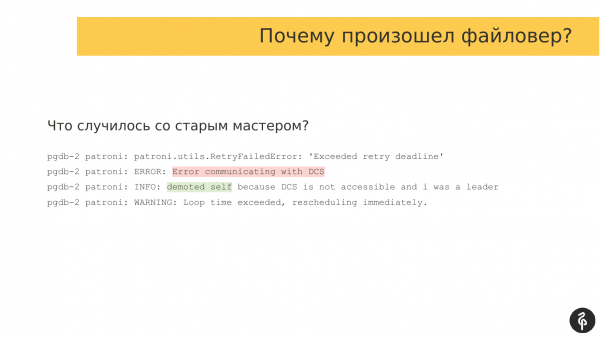
Ďalej musíme pochopiť, prečo došlo k failoveru, t. j. aké sa udiali udalosti, ktoré spôsobili presun úlohy hlavného z jedného uzla na druhý. A v tomto prípade je to jednoduché. Máme chybu pri komunikácii so systémom úložiska. Hlavný server zistil, že nemôže pracovať s DCS, t. j. vznikol nejaký problém s interakciou. A hovorí, že už nemôže byť hlavným a vzdáva sa svojich právomocí. Táto veta „demoted self“ to presne vyjadruje.
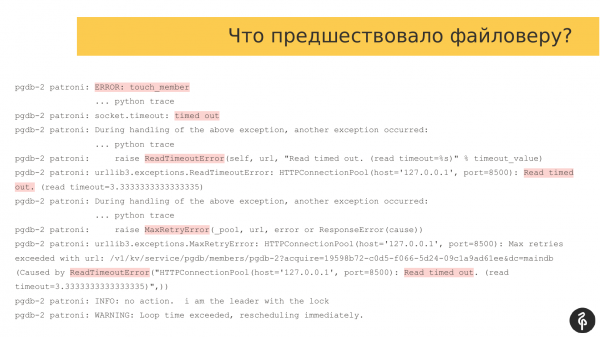
Ak sa pozrieme na udalosti, ktoré predchádzali failoveru, môžeme tam vidieť tie isté príčiny, ktoré boli problémom pre pokračovanie činnosti hlavného servera.
Ak sa pozrieme na logy Patroni, uvidíme, že máme množstvo rôznych chýb, časových limitov, t. j. agent Patroni nemôže pracovať s DCS. V tomto prípade to je Consul agent, s ktorým sa komunikuje cez port 8500.
A problém predstavuje to, že Patroni a databáza sú spustené na tom istom hostiteľovi. A na tomto uzle boli spustené servery Consul. Vytvorením záťaže na serveri sme spôsobili problémy aj pre serverov Consul. Neboli schopní normálne komunikovať.
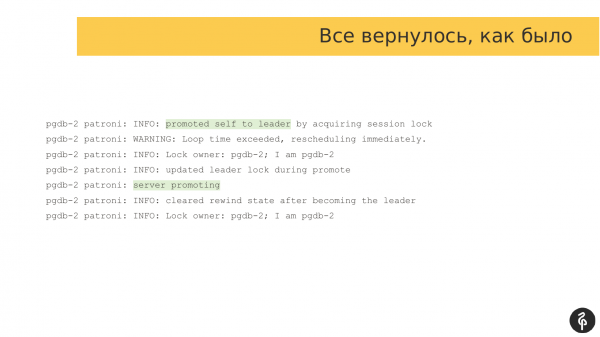
Po určitom čase, keď záťaž klesla, náš Patroni mohol znovu komunikovať s agentmi. Normálna činnosť sa obnovila. A ten istý server Pgdb-2 sa opäť stal hlavným. T. j. došlo k malému prevratu, kvôli ktorému uzol vzdal svoje práva hlavného, a potom si ich znova prevzal, t. j. všetko sa vrátilo do pôvodného stavu.
A to môže byť považované za falošné vyvolanie, alebo sa môže považovať za to, že Patroni všetko spravil správne. T. j. pochopil, že nedokáže udržať stav klastre a vzdal sa svojich právomocí.
A problémát az okozta, hogy a Consul-szerverek ugyanazon a hardveren vannak, mint az adatbázisok. Ennek megfelelően bármilyen terhelés, legyen az lemez- vagy processzorterhelés, szintén hatással van a Consullal való interakcióra.
Úgy döntöttünk, hogy ennek nem szabad együtt élnie, külön klusztert hoztunk létre a Consul számára. A Patroni már külön Consul-lal működött, azaz volt egy külön Postgres kluszter és egy külön Consul kluszter. Ez egy alapvető útmutató arról, hogyan kell ezeket a dolgokat elosztani és fenntartani, hogy ne éljenek együtt.
Alternatív megoldásként lehet játszani a ttl, loop_wait, retry_timeout paraméterekkel, azaz próbálkozni ezen paraméterek növelésével, hogy túléljük ezeket a rövid ideig tartó terhelési csúcsokat. De ez nem a legjobb megoldás, mert ez a terhelés időben elhúzódhat. És egyszerűen túllépjük a paraméterek határait. Ez nem feltétlenül segít.
Az első probléma, ahogy értettük, egyszerű. A DCS-t az adatbázissal együtt helyeztük el, és problémát kaptunk.
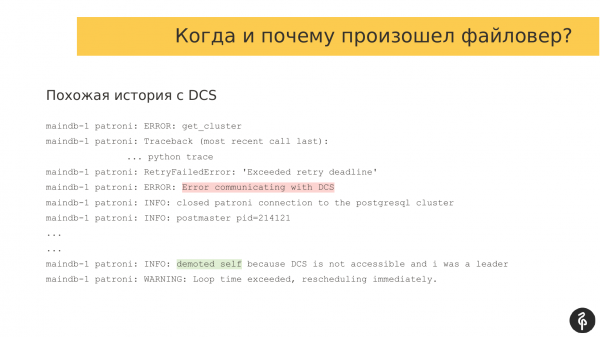
A második probléma hasonlít az elsőre. Az a hasonlósága, hogy ismét problémáink vannak a DCS rendszerrel való interakcióval.
Ha megnézzük a naplókat, látni fogjuk, hogy ismét kommunikációs hiba történt. A Patroni azt mondja, hogy nem tudok kommunikálni a DCS-sel, ezért az aktuális mester replika módba lép.
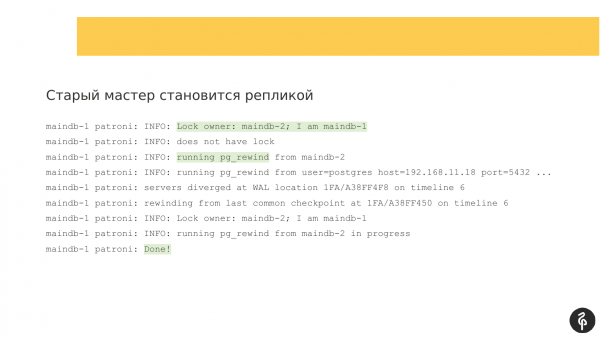
A régi mester replika lesz, itt a Patroni úgy működik, ahogy kell. Elindítja a pg_rewind-t, hogy visszatekerje a tranzakciós naplót, majd csatlakozik az új mesterhez, és már utóléri az új mestert. Itt a Patroni igenis azt teszi, amit kell.
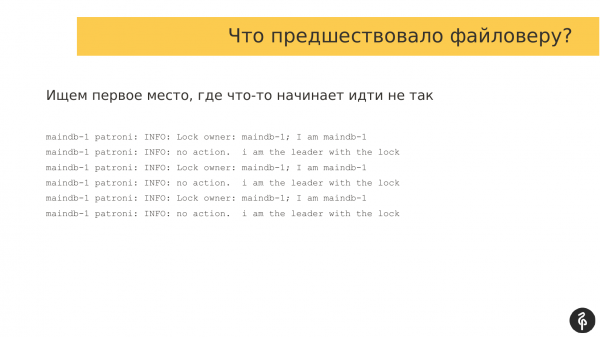
Itt meg kell találnunk azt a helyet, amely megelőzte a file veret, azaz azokat a hibákat, amelyek oka volt annak, hogy a file verett történt. Ilyen szempontból a naplókkal viszonylag könnyű dolgozni a Patroni esetében. Meghatározott időközönként ugyanazokat az üzeneteket írja. Ha gyorsan kezdjük el visszatekerni ezeket a naplókat, akkor a naplók változottak, tehát valamilyen probléma kezdődött. Gyorsan visszatérünk erre a pontra, és megnézzük, mi történik.
Normális helyzetben a naplók nagyjából így néznek ki. Ellenőrizzük a zárolás tulajdonosát. Ha a tulajdonos például megváltozott, akkor bekövetkezhetnek olyan események, amelyekre a Patroni reagálnia kell. De ebben az esetben minden rendben van. Keressük azt a helyet, amikor a hibák megkezdődtek.
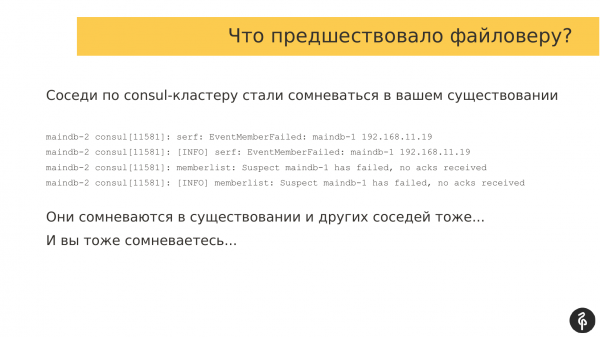
Ak posunieme až na miesto, kde sa začali objavovať chyby, vidíme, že sa nám aktivoval auto-failover. A keďže naše chyby mali súvislosť s interakciou s DCS a v našom prípade sme používali Consul, pozrieme sa aj do logov Consulu, čo sa tam dialo.
Približne porovnávajúc čas failoveru a čas v logoch Consulu, vidíme, že naši susedia v klastri Consul začali pochybovať o existencii ostatných účastníkov klastra Consul.
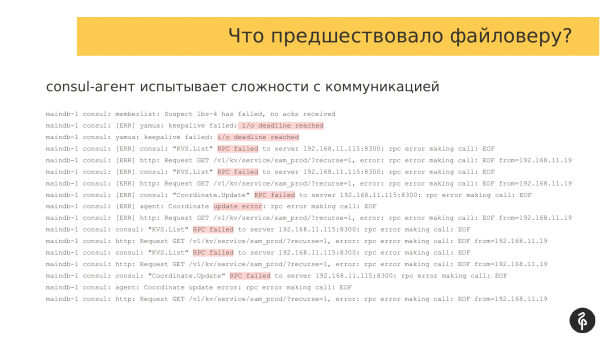
A ak sa pozrieme aj na logy ostatných agentov Consul, môžete vidieť, že tam sa deje nejaký sieťový kolaps. A všetci účastníci klastra Consul pochybujú o existencii jeden druhého. A to viedlo k failoveru.
Ak sa pozrieme na to, čo sa dialo pred týmito chybami, môžeme vidieť, že existujú rôzne chyby, napríklad deadline, RPC failed, t. j. jasne nejaký problém s interakciou medzi účastníkmi klastra Consul.
Najjednoduchšia odpoveď je opraviť sieť. No ja, stojac na tribúne, môžem o tom ľahko vyhlásiť. Ale okolnosti sú také, že nie vždy si zákazník môže dovoliť opraviť sieť. Môže žiť v DC a nemusí mať možnosti opravovať sieť, ovplyvňovať zariadenia. A preto sú potrebné nejaké iné možnosti.
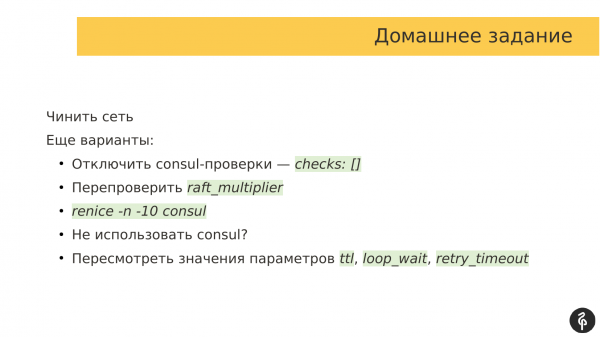
Možnosti sú:
- Najjednoduchšia možnosť, ktorá je napísaná, myslím, že dokonca aj v dokumentácii, je vypnúť kontroly Consul, t. j. jednoducho odovzdať prázdne pole. A hovoríme agentovi Consulu, aby nepoužíval žiadne kontroly. Vďaka týmto kontrolám môžeme ignorovať tieto sieťové búrky a nepožiadať o failover.
- Iná možnosť je prekontrolovať raft_multiplier. To je parameter samotného servera Consul. Predvolene je nastavený na hodnotu 5. Táto hodnota je odporúčaná v dokumentácii pre staging prostredia. V podstate to ovplyvňuje frekvenciu výmeny správ medzi účastníkmi siete Consul. Tento parameter ovplyvňuje rýchlosť služobnej komunikácie medzi účastníkmi klastra Consul. A pre produkciu sa už odporúča znížiť ho, aby uzly častejšie vymenili správy.
- Iný prístup, ktorý sme začali používať, je zvýšenie priority procesov Consul v porovnaní s ostatnými procesmi pre plánovač operačného systému. Existuje parameter "nice", ktorý presne určuje prioritu procesov, ktorú plánovač OS zohľadňuje pri plánovaní. Znížili sme hodnotu nice pre agentov Consul, teda sme zvýšili prioritu, aby operačný systém poskytoval procesom Consul viac času na prácu a vykonanie svojho kódu. V našom prípade to vyriešilo náš problém.
- Ďalšia možnosť je, že nepoužívame Consul. Mám známeho, ktorý je veľký zastánca Etcd. A pravidelne o tom diskutujeme, čo je lepšie, Etcd alebo Consul. Čo sa týka toho, čo je lepšie, obvykle sa zhodneme na tom, že Consul má agenta, ktorý musí byť spustený na každom uzle s databázou. T.j. interakcia Patroni s klastrom Consul prebieha cez tohto agenta. A tento agent sa stáva úzkym miestom. Ak sa niečo stane s agentom, Patroni už nemôže pracovať s klastrom Consul. A to je problém. Na strane Etcd nie je žiadny agent. Patroni môže priamo pracovať so zoznamom serverov Etcd a komunikovať s nimi. V tomto ohľade, ak vo vašej spoločnosti používate Etcd, bude asi Etcd lepšou voľbou ako Consul. Ale sme u našich zákazníkov vždy obmedzení tým, čo si zvolil a používa svoj klient. A väčšinou máme Consul u všetkých klientov.
- A posledný bod – je prehodnotiť hodnoty parametrov. Môžeme zvýšiť tieto parametre, dúfajúc, že naše krátkodobé sieťové problémy budú krátke a nepresiahnu interval týchto parametrov. Takto môžeme znížiť agresivitu Patroni pri vykonávaní auto-failover, ak sa vyskytujú nejaké sieťové problémy.
Myslím, že mnohí, ktorí používajú Patroni, sú oboznámení s touto príkazom.
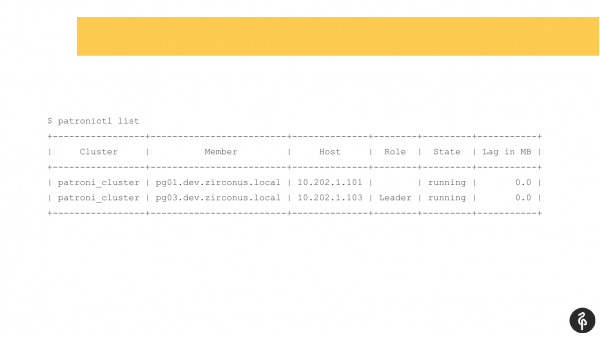
Tento príkaz ukazuje aktuálny stav klastru. A na prvý pohľad sa táto situácia môže javiť ako normálna. Máme majstra, máme replikáciu, žiadna latencia replikácie nie je. Ale táto situácia je normálna len dovtedy, kým nevieme, že v tomto klastre by mali byť tri uzly, nie dva.
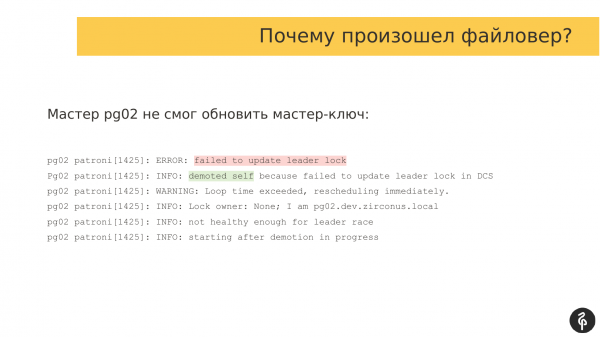
Vznikol autofailover. Po tomto autofailoveri nám zmizla replika. Musíme zistiť prečo zmizla a obnoviť ju späť. Opäť sa ideme pozrieť do logov a zistiť, prečo nastal autofailover.
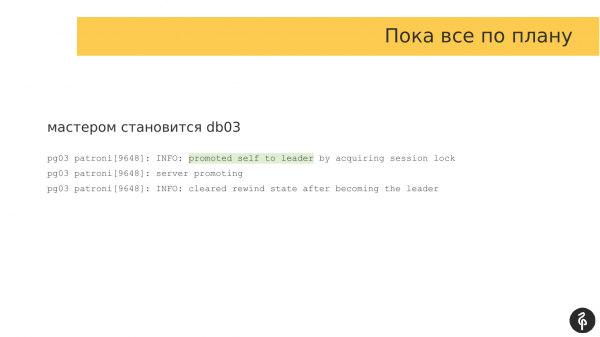
V tomto prípade sa druhá replika stala majstrom. Tu je všetko v poriadku.
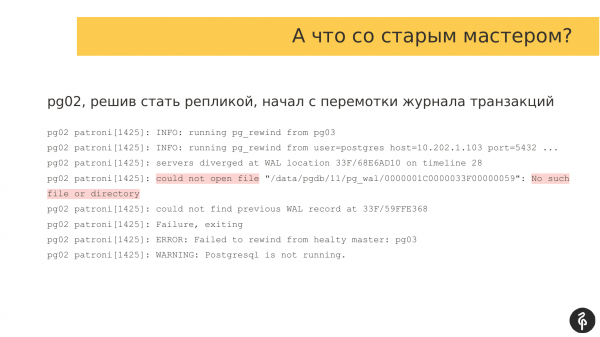
Musíme sa pozrieť na replikáciu, ktorá vypadla a nie je v klusteri. Otvoríme logy Patroni a skontrolujeme, že pri pokuse o pripojenie ku klasteru nastal problém počas fázy pg_rewind. Na pripojenie ku klasteru je potrebné resetovať transakčný log, požiadať správne transakčné logy od majstra a podľa nich dobehnúť majstra.
V tomto prípade nemáme transakčný log a replika sa nemôže spustiť. Preto zastavíme PostgreSQL s chybou. A preto nie je v klusteri.
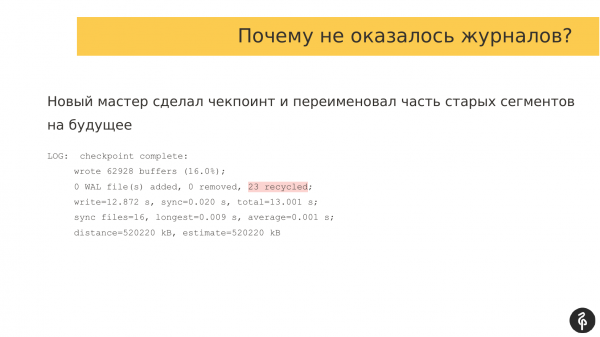
Musíme zistiť, prečo nie je v klusteri a prečo neexistujú logy. Ideme na nového majstra a pozrieme sa, čo má v logoch. Ukazuje sa, že počas pg_rewind došlo k checkpointu. A časť starých transakčných logov bola jednoducho premenovaná. Keď sa starý majster pokúsil pripojiť k novému majstrovi a požiadal o tieto logy, už boli premenované, jednoducho ich nebolo.
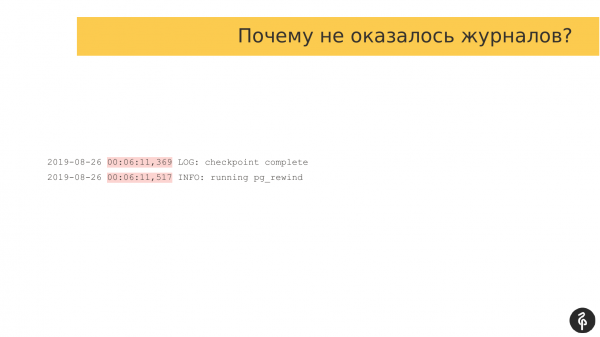
Porovnával som časové pečiatky, kedy sa tieto udalosti stali. A tam je rozdiel doslova 150 milisekúnd, teda v 369 milisekundách sa dokončil checkpoint a WAL segmenty boli premenované. A len v 517 milisekundách po 150 milisekundách sa začal rewind na starej replice. Teda doslova 150 milisekúnd nám stačilo, aby sa replika nemohla pripojiť a rozbehnúť.
Aké sú možnosti?
Pôvodne sme používali replikačné sloty. Zdalo sa nám, že je to dobré. Hoci v prvom štádiu prevádzky sme sloty vypínali. Mysleli sme si, že ak sloty nahromadia veľa WAL segmentov, môžeme zrútiť majstra. Ten spadne. Niekedy sme sa mučili bez slotov. A pochopili sme, že sloty potrebujeme, a vrátili sme ich späť.
Ale je tu problém, že keď sa hlavný server prepnul na replikáciu, zmazal sloty a spolu so slotmi aj WAL segmenty. Aby sme predišli tomuto problému, rozhodli sme sa zvýšiť parametre wal_keep_segments. Predvolene je to 8 segmentov. Zvýšili sme to na 1 000 a skontrolovali, koľko máme voľného miesta. A darovali sme 16 gigabajtov na wal_keep_segments. T.j. pri prepínaní máme vždy na všetkých uzloch rezervu 16 gigabajtov transakčných záznamov.
A navyše – to je ešte relevantné pre dlhodobé údržbové úlohy. Predpokladajme, že potrebujeme aktualizovať jednu z replik. A chceme ju vypnúť. Musíme aktualizovať softvér, možno operačný systém, ešte niečo. A keď vypneme replikáciu, aj pre túto replikáciu sa zmaže slot. A ak používame malý wal_keep_segments, tak pri dlhodobom vypnutí repliky sa transakčné záznamy prehrávajú. Zapneme replikáciu, požiada o tie transakčné záznamy, kde zastavila, ale na hlavnom serveri ich nemusí byť. A replikácia sa tiež nebude môcť pripojiť. Preto držíme veľkú rezervu záznamov.
Máme produkčnú databázu. Tam už fungujú projekty.
Došlo k súborovému zlyhaniu. Prišli sme a pozreli sa – všetko je v poriadku, repliky sú na svojich miestach, nie je žiadne oneskorenie replikácie. Chyby v záznamoch tiež nie sú, všetko je v poriadku.
Produktový tím hovorí, že by mali byť nejaké údaje, ale vidíme ich v jednom zdroji, avšak v databáze ich nevidíme. A musíme zistiť, čo sa s nimi stalo.
Je jasné, že pg_rewind ich prepísal. Okamžite sme to pochopili, ale išli sme sa pozrieť, čo sa stalo.
V logoch vždy môžeme nájsť, kedy došlo k súborovému zlyhaniu, kto sa stal hlavným serverom a môžeme určiť, kto bol starým hlavným serverom a kedy chcel byť replikou, t.j. potrebujeme tieto logy, aby sme zistili objem transakčných záznamov, ktoré boli stratené.
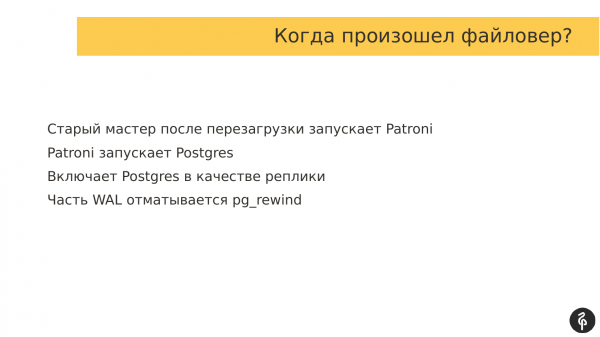
Náš starý hlavný server bol reštartovaný. A v automatickom spúšťaní bol predpísaný Patroni. Spustil sa Patroni. Následne spustil Postgres. Presnejšie, pred spustením Postgresu a predtým, ako ho urobil replikou, spustil proces pg_rewind. Zodpovedne, prepísal časť transakčných záznamov, stiahol nové a pripojil sa. Tu Patroni fungoval výborne, t.j. ako mal. Náš klaster sa obnovil. Mali sme 3 uzly, po súborovom zlyhaní 3 uzly – všetko skvelé.
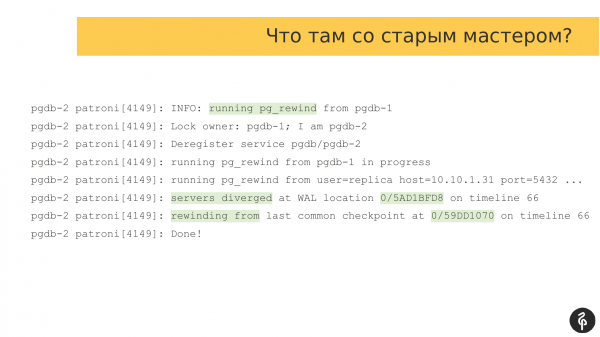
Stratili sme časť dát. Musíme zistiť, koľko sme stratili. Hľadáme presne ten okamih, keď sa uskutočnil rewind. Môžeme to nájsť podľa takýchto záznamov v denníku. Spustil sa rewind, niečo tam spravil a skončil.
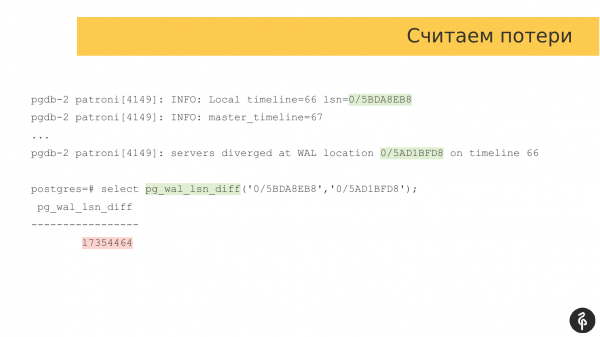
Musíme nájsť tú pozíciu v denníku transakcií, na ktorej sa zastavil starý master. V tomto prípade – to je táto značka. A potrebujeme druhú značku, t.j. vzdialenosť, o ktorú sa starý master líši od nového.
Berieme bežný pg_wal_lsn_diff a porovnávame tieto dve značky. A v tomto prípade dostávame 17 megabajtov. Či je to veľa alebo málo, si rozhodne každý sám. Pretože pre niekoho je 17 megabajtov málo, pre niekoho je to veľa a neprijateľné. Tu už každý určuje individuálne podľa potrieb biznisu.
Ale čo sme zistili pre seba?
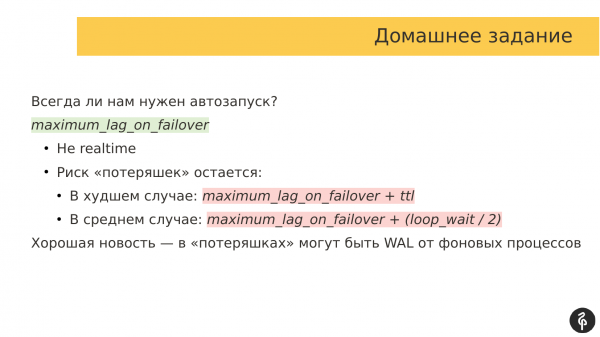
Po prvé, musíme si rozhodnúť – potrebujeme vždy automatické spúšťanie Patroni po reštarte systému? Častejšie je to tak, že musíme ísť na starý master, pozrieť sa, ako ďaleko sa dostal. Možno preinšpektovať segmenty denníka transakcií, pozrieť sa, čo tam je. A zistiť – môžeme tieto dáta stratiť alebo potrebujeme spustiť starý master v standalone režime, aby sme získali tieto dáta.
A až potom by sme mali prijať rozhodnutia, že môžeme tieto dáta zahodiť alebo ich môžeme obnoviť, pripojiť tento uzol ako repliku do nášho klastrového systému.
Okrem toho existuje parameter "maximum_lag_on_failover". Ako si pamätám, tento parameter má predvolené hodnoty 1 megabajt.
Ako to funguje? Ak naša replika zaostáva o 1 megabajt dát podľa replikácie, táto replika sa nezúčastňuje volieb. A ak náhodou dôjde k failoveru, Patroni sleduje, ktoré repliky zaostávajú. Ak zaostávajú o veľké množstvo denníkov transakcií, nemôžu sa stať majstrom. Je to veľmi dobrá ochranná funkcia, ktorá zabraňuje strate veľkého množstva dát.
Ale problém je v tom, že oneskorenie replikácie v klastre Patroni a DCS sa aktualizuje s určitým intervalom. Podľa môjho názoru je predvolené nastavenie ttl 30 sekúnd.
Môže sa stať, že latencia replikácie pre repliky v DCS je jedna, ale v skutočnosti môže byť úplne iná latencia alebo môže vôbec neexistovať, t. j. táto vec nie je realtime. A nie vždy odráža skutočný obraz. Takže na nej nie je rozumné budovať zložitú logiku.
A riziko strát vždy zostáva. A v najhoršom prípade jedna rov nice, a v priemernom prípade iná rov nice. T. j. keď plánujeme zavedenie Patroni a posudzujeme, koľko dát môžeme stratiť, mali by sme sa spoliehať na tieto vzorce a mať približnú predstavu o tom, koľko dát môžeme stratiť.
A dobrá správa je. Keď starý master prešiel pred, môže ísť vpred vďaka nejakým pozadiu procesom. T. j. nejaký bol autovakuum, zapísal dáta, uložil ich do žurnálu transakcií. A tieto dáta môžeme pokojne ignorovať a stratiť. V tom nie je žiadny problém.
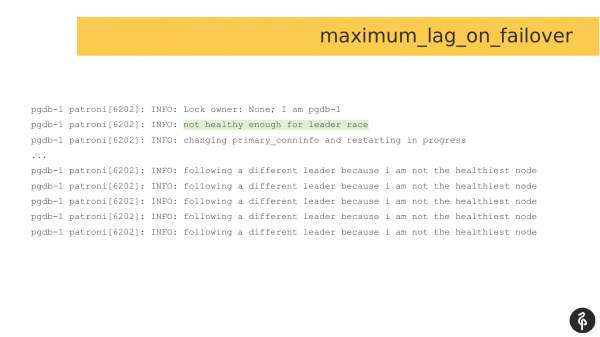
Takto vyzerajú logy, ak je nastavený maximum_lag_on_failover a došlo k failoveru, a treba vybrať nového majstra. Replika sa hodnotí ako neschopná zúčastniť sa volieb. A odmieta účastniť sa pretekov o lídra. A čaká, kým bude vybraný nový majster, aby sa potom k nemu pripojila. To je dodatočné opatrenie proti strate údajov.
Naša produktová tím napísal, že ich produkt má problémy pri práci s Postgres. Zároveň nie je možné sa pripojiť na samotného majstra, pretože nie je dostupný cez SSH. A autofailover sa tiež nedeje.
Tento host bol nútene reštartovaný. Kvôli reštartu došlo k autofailoveru, aj keď bolo možné vykonať aj ručný autofailover, ako teraz chápem. A po reštarte už ideme skontrolovať, čo sme mali s aktuálnym majstrom.
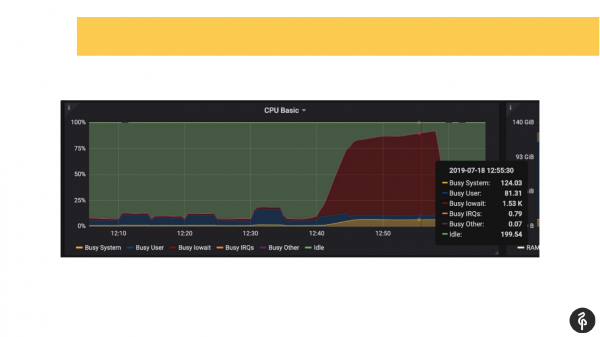
Zároveň sme vopred vedeli, že máme problémy s diskami, t. j. sme už podľa monitorovania vedeli, kde hľadať a čo skúmať.
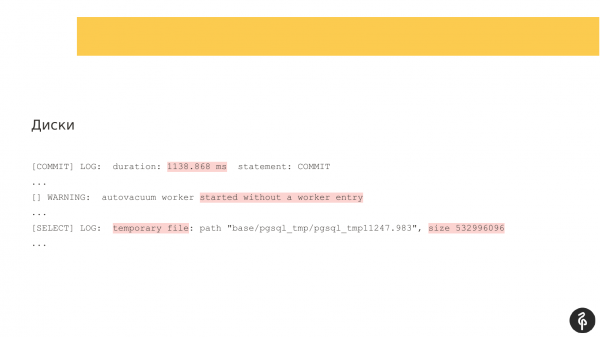
Vošli sme do postgresového logu, začali sme sledovať, čo sa tam deje. Videli sme komity, ktoré trvajú jednu-dve-tri sekundy, čo je úplne nenormálne. Videli sme, že sa autovakuum spúšťa veľmi dlho a zvláštne. A videli sme dočasné súbory na disku. T. j. to všetko sú znaky problémov s diskami.
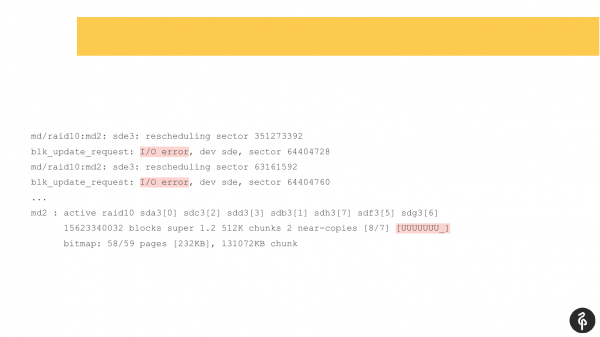
Prejavili sme do systémového dmesg (do logu jadrových správ). A videli sme, že máme problém s jedným z diskov. Disková subsystémová predstavovala software Raid. Pozreli sme sa na /proc/mdstat a zistili sme, že nám chýba jeden disk. To znamená, že tu je Raid z 8 diskov, jedného nám chýba. Ak sa pozrieme pozorne na snímku, vo výstupe môžeme vidieť, že nám tam chýba sde. Podľa všetkého nám vypadol disk. To spustilo diskové problémy a aplikácie tiež zažili problémy pri práci s klastrom Postgres.
A v tomto prípade by nám Patroni nijako nepomohol, pretože Patroni nemá úlohu monitorovať stav servera, stav disku. Musíme takéto situácie sledovať externým monitorovaním. Do externého monitorovania sme prakticky pridali monitorovanie diskov.
A mala som takú myšlienku – mohol by nám pomôcť fencing, alebo soft watchdog? Mysleli sme si, že to nám asi nepomôže v tomto prípade, pretože počas problémov Patroni naďalej interagoval s klastrom DCS a nevidel žiadny problém. To znamená, že z pohľadu DCS a Patroni s klastrom bolo všetko v poriadku, hoci v skutočnosti boli problémy s diskom, boli problémy s dostupnosťou databázy.
Podľa môjho názoru ide o jeden z najstrrangejších problémov, ktoré som skúmala veľmi dlho, prečítala som si veľmi veľa logov, prekopala som a nazvala som ho klaster-simulantom.
Problém spočíval v tom, že starý master nemohol byť normálnou replikou, to znamená, že Patroni ho spúšťal, Patroni ukazoval, že tento uzol je prítomný ako replika, ale zároveň nebol normálnou replikou. Teraz uvidíte, prečo. Toto som si uchovala z rozboru toho problému.
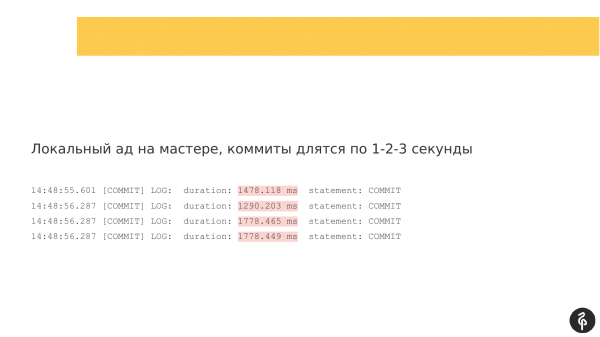
A od čoho to všetko začalo? Začalo to, ako v predchádzajúcom probléme, s diskovými spomaľovaniami. Mali sme komitovanie po sekunde, dve.
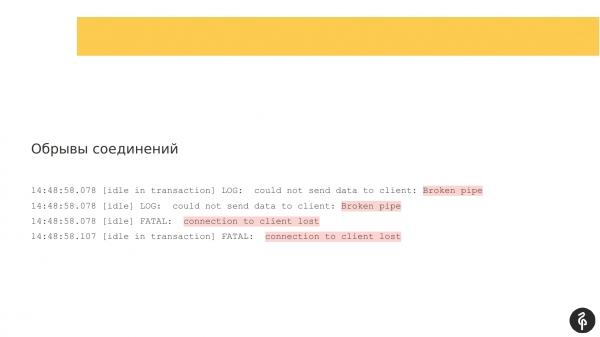
Boli prerušenia pripojení, to znamená, že klienti sa odpojovali.
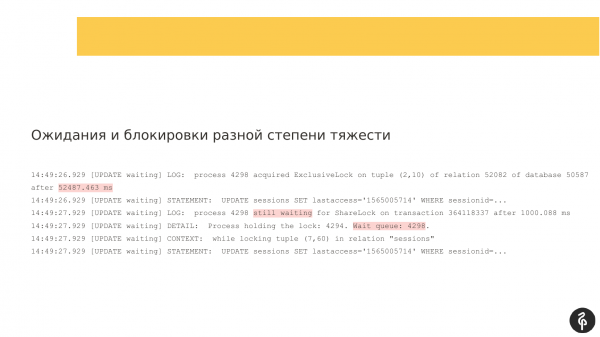
Boli zámky rôznej závažnosti.
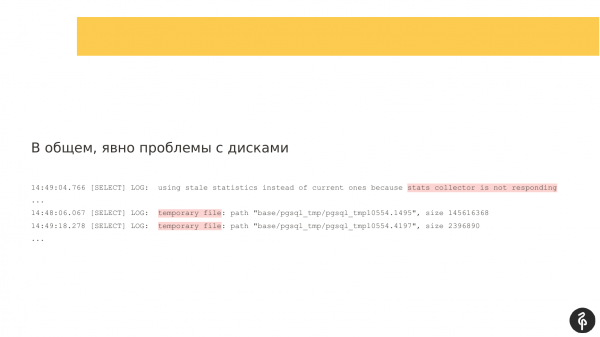
A podľa toho disková subsystém nebola veľmi pohotová.
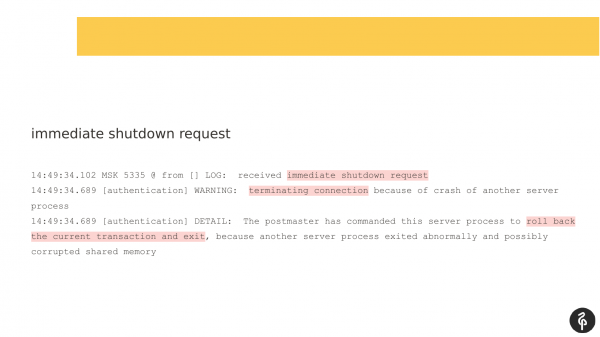
A najzáhadnejšie pre mňa – to bola ihneď doručená požiadavka na vypnutie. V Postgres existujú tri režimy vypínania:
- To je graceful, keď čakáme, kým sa všetci klienti odpoja sami.
- Existuje fast, keď nutíme klientov, aby sa odpojili, pretože ideme na vypnutie.
- A immediátna. V tomto prípade immediátna ani neinformuje klientov, že sa majú odpojiť, jednoducho sa vypne bez varovania. A všetkým klientom už operačný systém odosiela správu RST (TCP správa, že pripojenie bolo prerušené a klient už nemá čo robiť).
Kto poslal tento signál? Pozadia procesy Postgres si navzájom takéto signály neposielajú, t. j. je to kill-9. Navzájom si takéto neposielajú, len na také reagujú, t. j. ide o núdzový reštart Postgres. Kto to poslal, neviem.
Pozrel som sa na príkaz „last“ a videl som jednu osobu, ktorá sa tiež prihlásila na tento server spolu s nami, ale hanbil som sa položiť otázku. Možno, to bolo kill -9. V logoch by som videl kill -9, pretože Postgres zapisuje, že prijal kill -9, ale toto som v logoch nevidel.
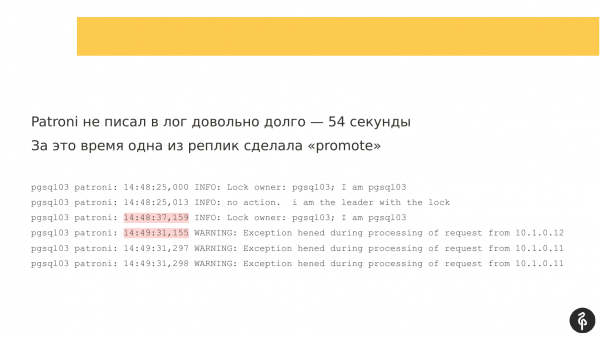
Pri hlbšom skúmaní som si všimol, že Patroni dlho nepísal do logu – 54 sekúnd. A ak porovnám dva časové odtlačky, tu približne 54 sekúnd neboli žiadne správy.
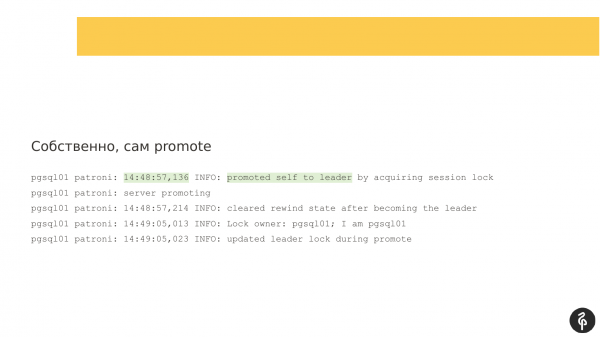
A za tento čas došlo k autofailoveru. Patroni opäť fungoval skvele. Naša stará učiteľka bola neprístupná, niečo sa s ňou dialo. A začali sa voľby nového učiteľa. Tu to všetko fungovalo dobre. Náš pgsql01 sa stal novým lídrom.
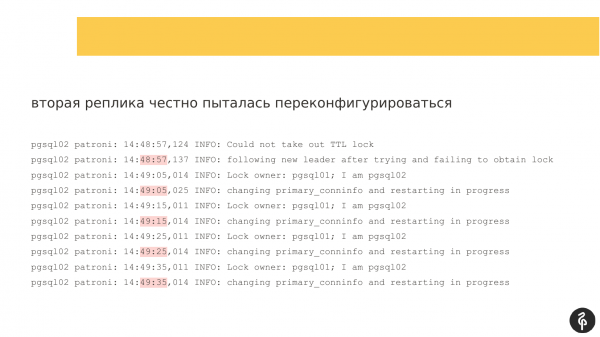
Máme replikáciu, ktorá sa stala učiteľom. A je tu druhá replikácia. A s druhou replikáciou boli práve problémy. Snažila sa prekonfigurovať. Ako chápem, snažila sa zmeniť recovery.conf, reštartovať Postgres a pripojiť sa k novému učiteľovi. Každých 10 sekúnd píše správy, že sa snaží, ale nedarí sa jej.
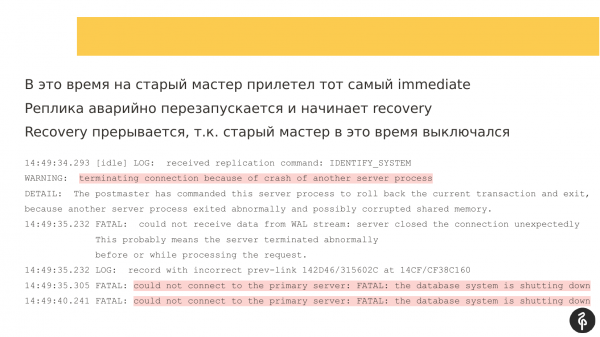
A počas týchto pokusov dostáva starý učiteľ signál immediate-shutdown. Učiteľ sa reštartuje. A tiež sa obnova zastavuje, pretože starý učiteľ ide do reštartovania. T. j. replikácia sa k nemu nemôže pripojiť, pretože je v režime vypínania.
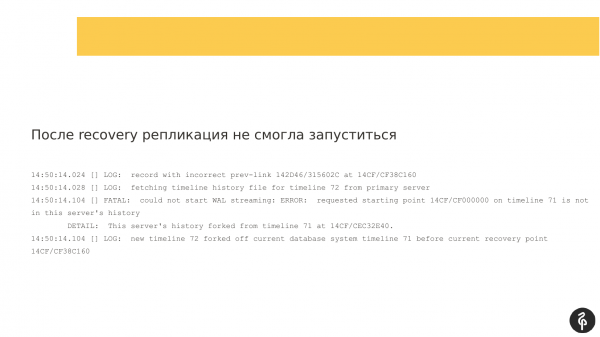
V nejakom momente sa to samo rozbehlo, ale replikácia pri tom sa nespustila.
Mám jedinú hypotézu, že v recovery.conf bola adresa starého učiteľa. A keď sa objavil nový učiteľ, druhá replikácia sa stále snažila pripojiť k starému učiteľovi.
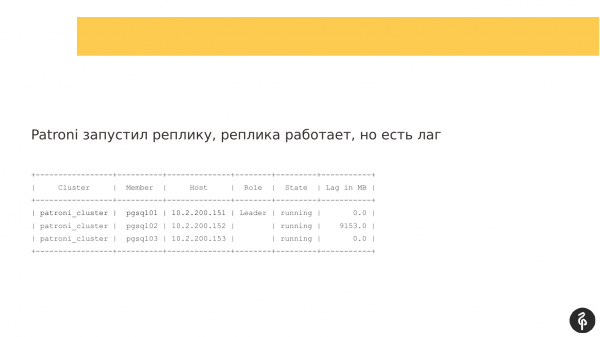
Keď sa Patroni spustil na druhej replikácii, uzol sa spustil, ale nemohol sa pripojiť k replikácii. A vytvoril sa oneskorenie replikácie, ktoré vyzeralo asi takto. T. j. všetky tri uzly boli na mieste, ale druhý uzol zaostal.
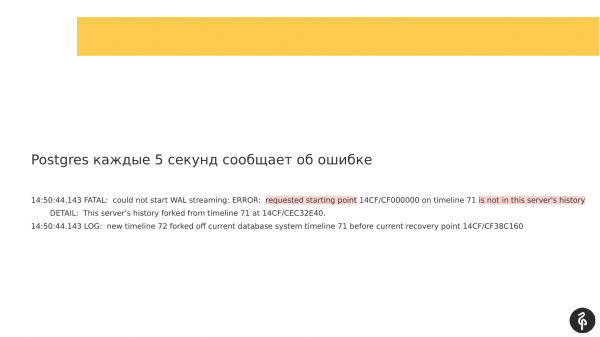
Ak sa pozrieme na logy, ktoré sa písali, bolo vidieť, že replikácia sa nemôže spustiť, pretože transakčné záznamy sa líšia. A tie transakčné záznamy, ktoré ponúka master a sú uvedené v recovery.conf, jednoducho nevyhovujú nášmu aktuálnemu uzlu.
A tu som urobil chybu. Mal som prísť a pozrieť sa, čo je v recovery.conf, aby som overil svoju hypotézu, že sa pripájame k nesprávnemu masterovi. Ale vtedy som sa len začínal orientovať a nenapadlo ma to, alebo som si všimol, že replikácia zaostáva a bude ju potrebné znova previesť, t. j. pracoval som na to len tak naoko. To bola moja chyba.
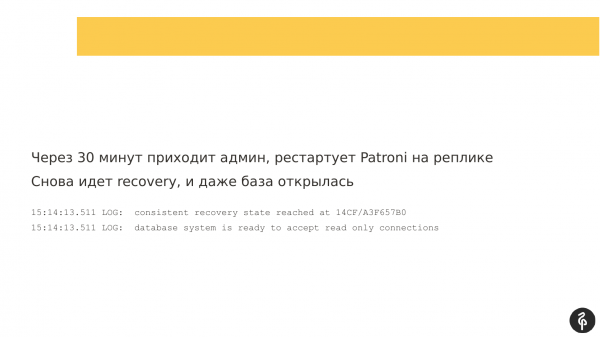
O 30 minút prišiel administrátor, t. j. ja som reštartoval Patroni na replike. Už som na nej zanechal nádej, myslel som, že ju treba preinštalovať. A povedal som si - reštartujem Patroni, možno sa objaví niečo dobré. Spustil sa recovery. A databáza sa dokonca otvorila, bola pripravená prijímať pripojenia.
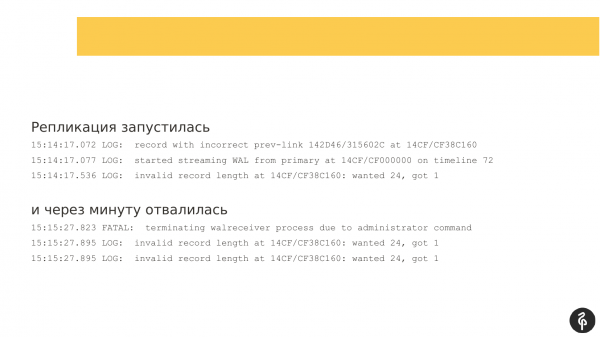
Replikácia sa spustila. Ale o minútu sa opäť odpojila s chybou, že jej nevyhovujú transakčné záznamy.
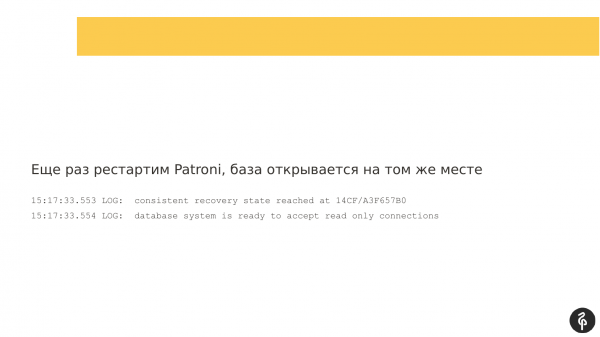
Pomyslel som si, že ju skúsim reštartovať ešte raz. Znovu som reštartoval Patroni, pričom som neraštartoval Postgres, ale iba Patroni v nádeji, že magicky spustí databázu.
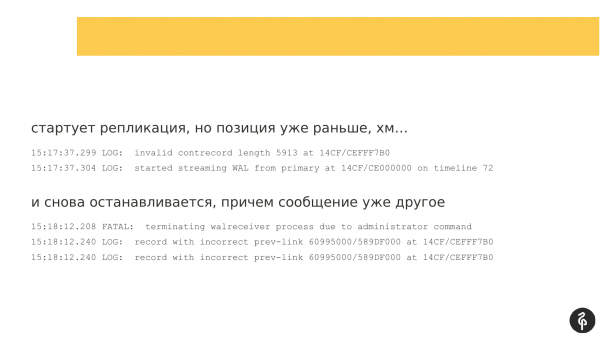
Replikácia sa opäť spustila, ale záznamy v transakčnom logu sa líšili, boli iné, než pri predchádzajúcej pokuse o spustenie. Replikácia sa opäť zastavila. A správa bola opäť trošku iná. A nebola pre mňa veľmi informatívna.
A tu mi napadlo – čo ak reštartujem Postgres, zatiaľ na aktuálnom masterovi urobím checkpoint, aby som posunul bod v transakčnom logu o kúsok ďalej, aby sa recovery začalo z iného momentu? Plus, mali sme tam aj zásoby WAL.
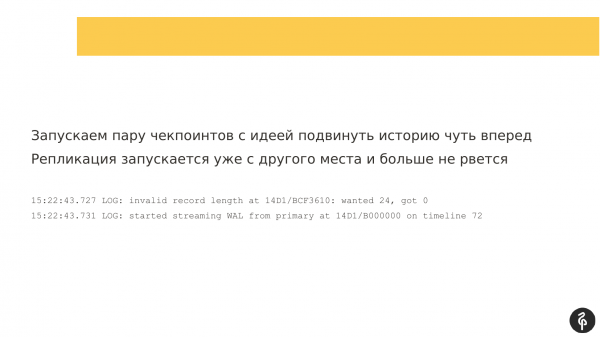
Reštartoval som Patroni, urobil som niekoľko checkpoints na majstrovskom serveri, niekoľko restart-poinov na replike, keď sa otvorila. A to pomohlo. Dlho som rozmýšľal, prečo to pomohlo a ako to fungovalo. A replikácia sa spustila. A replikácia už viac neprerušovala.
Takýto problém je pre mňa jedným z najzáhadnejších, nad ktorým sa stále zamýšľam, čo sa tam naozaj dialo.
Aké sú tu závery? Patroni môže fungovať, ako sa zamýšľalo, a bez akýchkoľvek chýb. Ale nie je to 100 % záruka, že je všetko v poriadku. Replika sa môže spustiť, ale môže byť v polofunkčnom stave, a aplikácia nemôže pracovať s takouto replikou, pretože tam budú staré údaje.
A po failoveri je vždy potrebné skontrolovať, či je s klastrom všetko v poriadku, t.j. je potrebný počet replik, žiadny lag replikácie.
A počas preskúmávania týchto problémov formulujem odporúčania. Snažil som sa ich zhrnúť do dvoch snímok. Pravdepodobne by sa všetky príbehy dali zhrnúť do dvoch snímok a len ich rozprávať.
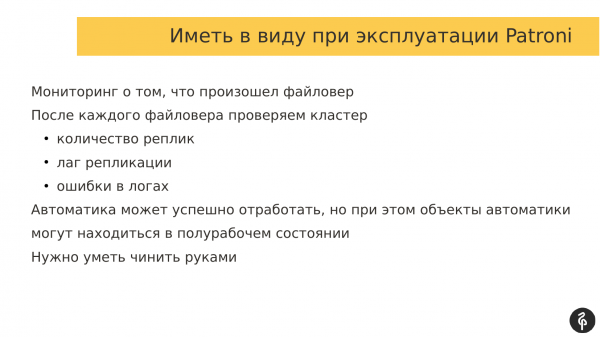
Keď používate Patroni, musíte mať monitoring. Vždy musíte vedieť, kedy došlo k autofailoveru, pretože ak neviete, že ste mali autofailover, nekontrolujete klaster. A to je zle.
Po každom failoveri vždy musíme ručne skontrolovať klaster. Musíme sa uistiť, že máme vždy aktuálny počet replik, žiadny lag replikácie, v logoch nie sú žiadne chyby súvisiace s prúdovou replikáciou, s Patroni, so systémom DCS.
Automatika môže úspešne fungovať, Patroni je veľmi dobrý nástroj. Môže fungovať, ale to neprivedie klaster do požadovaného stavu. A ak to nezistíme, budeme mať problémy.
A Patroni nie je strieborná guľka. Musíme mať aj predstavu, ako funguje Postgres, ako funguje replikácia a o tom, ako Patroni funguje s Postgres, a ako je zabezpečená interakcia medzi uzlami. To je potrebné na to, aby sme vedeli vlastnými rukami opraviť vznikajúce problémy.
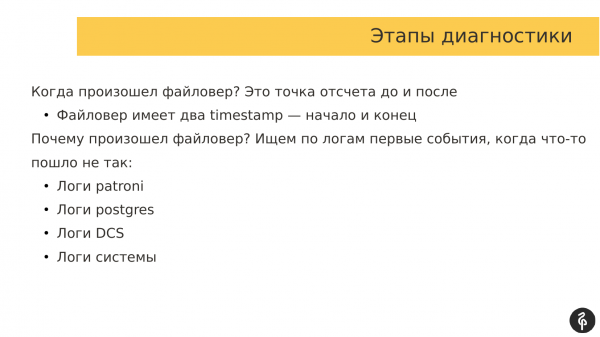
Ako sa pristupujem k otázke diagnostiky? Tak sa stalo, že pracujeme s rôznymi klientmi a nikto nemá ELK stack, a musíme sa prekopávať v logoch, otvorením 6 konzol a 2 kariet. Na jednej karte sú logy Patroni pre každý uzol, na druhej karte sú logy Consul alebo Postgres podľa potreby. Diagnostikovať to je veľmi ťažké.
Aké prístupy som si vypracoval? Po prvé, vždy sa pozerám, kedy došlo k failoveru. A pre mňa je to určitý zlomy. Pozerám sa, čo sa stalo pred failoverom, počas failoveru a po failoveru. Failover má dva časové údaje: čas začiatku a konca.
Ďalej v logoch sledujem udalosti pred failoverom, čo predchádzalo failoveru, t. j. hľadám dôvody, prečo došlo k failoveru.
A to dáva obraz o tom, čo sa dialo a čo môžeme urobiť v budúcnosti, aby sa takéto okolnosti neopakovali (a aby k failoveru nedošlo).
A kam sa zvyčajne pozeráme? Pozriem sa:
- Najprv na logy Patroni.
- Potom sa pozriem na logy Postgres, alebo na logy DCS v závislosti od toho, čo som našiel v logoch Patroni.
- A logy systému niekedy tiež dávajú pochopenie toho, čo bolo príčinou failoveru.
Ako som na tom s Patroni? K Patroni sa staviam veľmi pozitívne. Podľa mňa je to najlepšie, čo je dnes k dispozícii. Poznám veľa iných produktov. To sú Stolon, Repmgr, Pg_auto_failover, PAF. 4 nástroje. Vyskúšal som ich všetky. Patroni sa mi páči najviac.
Ak sa ma niekto opýta: „Odporúčam Patroni?“. Povedal by som, že áno, pretože sa mi Patroni páči. A myslím, že som sa naučil, ako ho spravovať.
Ak vás zaujíma, aké ďalšie problémy môžu byť s Patroni, okrem tých, ktoré som spomenul, môžete sa vždy pozrieť na stránku na GitHub. Tam je množstvo rôznych príbehov a diskutuje sa tam o mnohých zaujímavých problémoch. A nakoniec sa nejaké chyby nahlásili a vyriešili, t. j. je to zaujímavé čítanie.
Tam sú zaujímavé príbehy o tom, ako si ľudia strieľajú do vlastnej nohy. Je to veľmi poučné. Čítaš a chápeš, že takto sa to robiť nedá. Mal som si to zapísať.
A chcel by som sa veľmi poďakovať spoločnosti Zalando za to, že rozvíjajú tento projekt, a to konkrétne Aleksandrovi Kukuškovi a Alexejovi Kljukinovi. Alexej Kljukin je jedným z spoluautorov, už v Zalando nepracuje, ale sú to dvaja ľudia, ktorí začali pracovať s týmto produktom.
A mám pocit, že Patroni je veľmi cool vec. Som rád, že existuje, je s ňou zaujímavé pracovať. A veľké ďakujem všetkým prispievateľom, ktorí píšu záplaty pre Patroni. Dúfam, že Patroni s časom bude stále zrelší, lepší a funkčnejší. Už teraz je funkčný, ale dúfam, že sa ešte zlepší. Takže ak plánujete implementovať Patroni, nebojte sa. Je to dobré riešenie, dá sa nasadiť a používať.
Na tomto je všetko. Ak máte nejaké otázky, pýtajte sa.
Otázky
Ďakujem za prezentáciu! Ak po failovere je potrebné sa tam pozrieť veľmi dôkladne, tak na čo potrebujeme automatický failover?
Pretože je to nová vec. Pracujeme s ňou len rok. Radšej sa poistíme. Chceme sa prihlásiť a skontrolovať, či všetko fungovalo správne. Toto je úroveň dospelého nedôvery – radšej to skontrolovať a pozrieť sa.
Napríklad, ráno sme sa prihlásili a pozreli sa, že?
Nie ráno, zvyčajne sa dozvieme o autofailovere takmer okamžite. Prichádzajú nám upozornenia, vidíme, že došlo k autofailoveru. Takmer okamžite sa prihlásime a pozrieme sa. Ale všetky tieto kontroly by mali byť prenesené na úroveň monitorovania. Ak sa obraciame na Patroni cez REST API, existuje história. Podľa histórie môžeme sledovať časové pečiatky, kedy došlo k failoveru. Na základe toho môžeme robiť monitorovanie. Môžeme sledovať históriu, koľko tam bolo udalostí. Ak nám pribudlo udalostí, znamená to, že došlo k autofailoveru. Môžeme sa prihlásiť a pozrieť sa. Alebo naša automatizácia v monitorovaní skontrolovala, že máme všetky repliky na mieste, nie je žiadne oneskorenie a všetko je v poriadku.
Ďakujeme!
Veľké ďakujem za skvelý príbeh! Ak sme presunuli DCS klaster ďaleko od Postgres klastru, musíme tento klaster pravidelne spravovať? Aké sú najlepšie praktiky na to, že niektoré časti DCS klastru treba vypnúť, urobiť s nimi niečo a podobne? Ako pri tom žije celá táto konštrukcia? A akým spôsobom tieto veci robiť?
Pre jednu spoločnosť bolo potrebné vytvoriť maticu problémov, čo sa stane, ak zlyhá nejaká súčasť alebo viacero súčastí. Podľa tejto matice postupne prechádzame všetkými súčasťami a vytvárame scenáre v prípade zlyhania týchto komponentov. Zodpovedajúce k každému scenáru zlyhania môže existovať plán akcií na obnovenie. A v prípade DCS je to súčasť štandardnej infraštruktúry. A administrátor to spravuje a už sa spoliehame na administrátorov, ktorí to spravujú a na jeho schopnosti to opraviť v prípade havárie. Ak DCS nie je vôbec prítomný, tak ho nasadzujeme my, ale pritom ho príliš nesledujeme, pretože nezodpovedáme za infraštruktúru, ale dávame odporúčania ako a čo monitorovať.
T. j. správne som pochopil, že treba vypnúť Patroni, vypnúť failover, vypnúť všetko predtým, ako robíme niečo s hostiteľmi?
To závisí na tom, kolik uzlů máme v DCS klastru. Pokud je uzlů hodně a pokud porušíme pouze jeden z uzlů (replikaci), klastra si udržuje kvorum. A Patroni zůstává funkční. A nic se nespouští. Pokud máme složité operace, které zasahují více uzlů, jejichž absence může rozložit kvorum, pak ano, možná má smysl pozastavit Patroni. Má příslušný příkaz – patronictl pause, patronictl resume. Jednoduše pozastavíme, a automatické přepnutí se v tuto dobu nespustí. Provádíme údržbu na DCS klastru, poté pozastavení zrušíme a pokračujeme v práci.
Ďakujem pekne!
Veľmi pekne ďakujem za prezentáciu! Ako produktový tím reaguje na to, že môžu dôjsť k strate dát?
Produktovým tímom to je jedno, ale tímoví lídri sú nervózni.
Aké sú tam záruky?
S zárukami je to veľmi ťažké. Existuje prezentácia od Alexandra Kukuškina 'Ako vypočítať RPO a RTO', t. j. čas obnovy a koľko dát môžeme stratiť. Myslím, že je potrebné nájsť tieto snímky a študovať ich. Pokiaľ si pamätám, sú tam konkrétne kroky, ako tieto veci počítať. Koľko transakcií môžeme stratiť, koľko dát môžeme stratiť. Ako alternatívu môžeme použiť synchronnú replikáciu na úrovni Patroni, ale to je dvojsečná zbraň: buď máme spoľahlivosť dát, alebo strácame na rýchlosti. Existuje synchronná replikácia, ale ona tiež nezaručuje 100%-nú ochranu pred stratou dát.
Alexej, ďakujem za skvelú prezentáciu! Máte skúsenosti s použitím Patroni pre ochranu na nule? T. j. spolu so synchronným uzlom? To je prvá otázka. A druhá otázka. Použili ste rôzne riešenia. Použili sme Repmgr, ale bez automatického prepínania a teraz plánujeme pridať automatické prepínanie. Zvažujeme Patroni ako alternatívne riešenie. Čo môžete povedať o výhodách v porovnaní s Repmgr?
Prvá otázka bola o synchronných replikách. Nikto u nás synchronnú replikáciu nepoužíva, pretože sa všetci boja (Už používajú niektorí klienti, problémy s výkonom v podstate nezaznamenali — Poznámka prednášajúceho). Ale pre seba sme si vypracovali pravidlo, že v klastri synchronnej replikácie musia byť minimálne tri uzly, pretože ak máme dva uzly a ak master alebo replika vypadnú, Patroni prevedie tento uzol do samostatného režimu, aby aplikácia mohla pokračovať v prevádzke. V tomto prípade existuje riziko straty dát.
Pokiaľ ide o druhú otázku, používali sme Repmgr a stále ho používame u niektorých klientov z historických dôvodov. Čo k tomu povedať? V Patroni je automatické prechádzanie na failover out-of-the-box, zatiaľ čo v Repmgr ide automatické prechádzanie na failover ako dodatočná funkcia, ktorú treba aktivovať. Musíme spustiť Repmgr daemon na každom uzle a potom môžeme nastaviť automatické prechádzanie na failover.
Repmgr kontroluje, či sú uzly Postgres živé. Procesy Repmgr kontrolujú existenciu navzájom, to nie je veľmi efektívny prístup, pretože môžu nastať zložitý prípady sieťovej izolácie, pri ktorých sa veľký Repmgr klaster môže rozpadnúť na niekoľko malých a pokračovať v prevádzke. Už dlhú dobu nesledujem Repmgr, možno to už opravili... alebo nie. No vyčlenenie informácií o stave klastru do DCS, ako to robí Stolon, Patroni, je najživotaschopnejšia možnosť.
Alexej, mám otázku, možno nevyberanú. Vo jednom z prvých príkladov DCS ste presunuli z lokálneho stroja na vzdialený uzol. Chápeme, že sieť je vec, ktorá má svoje špecifiká, žije sama o sebe. A čo sa stane, ak sa z nejakého dôvodu DCS-klaster stane nedostupným? Dôvody spomínať nebudem, môže ich byť množstvo: od krivých rúk sieťarov po reálne problémy.
Nepreriekol som to nahlas, ale klaster DCS by mal byť taktiež odolný voči poruchám, t.j. mal by mať nepárny počet uzlov, aby sa mohol získať kvorum. Čo sa stane, ak sa klaster DCS stane nedostupným, alebo sa nemôže získať kvorum, t.j. prichádzajú k nejakému sieťovému rozdeleniu alebo zlyhaniu uzlov? V tomto prípade prechádza klaster Patroni do režimu len na čítanie. Klaster Patroni nemôže určiť stav klastru a čo má robiť. Nemôže sa spojiť s DCS a uložiť tam nový stav klastru, preto celý klaster prechádza do režimu len na čítanie. A čaká buď na manuálny zásah od operátora, alebo kým sa DCS neobnoví.
V podstate sa DCS pre nás stáva službou rovnako dôležitou, ako je samotná databáza?
Áno, v mnohých moderných spoločnostiach je Service Discovery neoddeliteľnou súčasťou infraštruktúry. Zavádza sa dokonca skôr, ako sa v infraštruktúre objaví databáza. Povedzme, že infraštruktúra bola spustená, vybavila sa v DCentrále a hneď máme Service Discovery. Ak je to Consul, môže byť postavený aj DNS. Ak je to Etcd, môže to byť časť z klasteru Kubernetes, v ktorom sa už rozbehne všetko ostatné. Myslím si, že Service Discovery je už neoddeliteľnou súčasťou moderných infraštruktúr. A premýšľa sa o ňom oveľa skôr, ako o databázach.
Ďakujeme!
Zdroj: habr.com
