

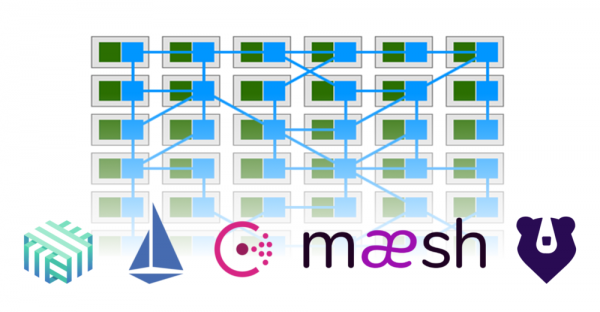
Pozn. prekl.: autor tohto článku (Luc Perkins) — vývojový advokát v organizácii CNCF, ktorá je domovom pre také Open Source projekty ako Linkerd, SMI (Service Mesh Interface) a Kuma (mimochodom, zamysleli ste sa niekedy, prečo v tomto zozname nie je Istio?..). Opäť sa snažiac priniesť do DevOps komunity lepšie porozumenie módnemu trendu zvanému „service mesh“, uvádza 16 charakteristických funkcií, ktoré poskytujú podobné riešenia.
Dnes — jedna z najhorúcejších tém v oblasti softvérového inžinierstva (a právom!). Považujem túto technológiu za mimoriadne perspektívnu a snívam o tom, že budem svedkom jej širokého rozšírenia (samozrejme, keď to bude mať zmysel). Napriek tomu je stále obklopená aurou tajomstva pre väčšinu ľudí. Tí, ktorí s ňou dobre oboznámení zvyčajne majú problém formulovať jej výhody a čo konkrétne predstavuje (vrátane vášho pokorného sluha). V článku sa pokúsim situáciu napraviť, uvedením rôznych scenárov použitia „servisných sietí“*.
* Pozn. prekl.: tu a ďalej v článku sa bude používať práve tento preklad („servisná sieť“) pre stále nový termín service mesh.
Ale najprv chcem uviesť niekoľko poznámok:
- Nikdy som nepracoval so servisnými sieťami a nepoužíval ich mimo projektov, ktoré som začal v rámci vlastného vzdelávania. Na druhej strane, presne ja som napísal množstvo dokumentácie pre internú service mesh spoločnosti Twitter v roku 2015 (vtedy sa ešte ani len nenazývala „servisná sieť“) a zúčastnil som sa na vývoji webovej stránky a dokumentácie pre , takže to niečo znamená.
- Môj zoznam je orientačný a neúplný. Je celkom možné, že existujú mi neznáme scenáre použitia, a postupom času sa určite objavia nové možnosti, keď sa technológia rozvíja a rastie jej popularita.
- Zároveň však nie každá existujúca implementácia service mesh podporuje všetky uvedené prípady použitia. Preto treba moje vyjadrenia ako „service mesh môže…“ chápať ako „jednotlivé, a možno aj všetky populárne implementácie service mesh môžu…“.
- Poradie príkladov nemá žiadny význam.
Stručný zoznam:
- objavovanie služieb;
- šifrovanie;
- autentifikácia a autorizácia;
- vyvažovanie záťaže;
- circuit breaking;
- automatiké škálovanie;
- kanárske nasadzovanie;
- modro-zelené nasadzovanie;
- kontrola zdravia;
- load shedding;
- mirroring traffic;
- isolation;
- rate limiting, retries, and timeouts;
- telemetry;
- audit;
- visualization.
1. Service Discovery
TL;DR: Connect to other services in the network using simple names.
Services should be able to automatically 'discover' each other using adequate names—such as, service.api.production, pets/staging alebo cassandra. Cloud environments are different in their elasticity, and one name can hide many instances of a service. It's clear that in such a situation, it's physically impossible to hard-code all IP addresses.
Moreover, when one service finds another, it should be able to send requests to that service without fearing they will land on the input of a non-working instance. In other words, the service mesh should monitor the health of all service instances and maintain a list of hosts in the most up-to-date state.
Each service mesh implements service discovery mechanisms in its own way. Currently, the most common method is delegating to external processes like DNS Kubernetes. In the past at Twitter, we used a naming system for these purposes . Additionally, the service mesh technology enables the emergence of custom naming mechanisms (although I have yet to encounter an SM implementation with such functionality).
2. Encryption
TL;DR: Eliminate unencrypted traffic between services and let this process be automated and scalable.
It's nice to know that intruders cannot penetrate your internal network. Firewalls are excellent at this. But what happens if a hacker does manage to get inside? Will they be able to do whatever they want with the in-service traffic? Let's hope that it doesn't come to that. To prevent such scenarios, a zero-trust network should be implemented, where all traffic between services is encrypted. Most modern service meshes achieve this through mutual (mutual TLS, mTLS). In some cases, mTLS works across entire clouds and clusters (I believe even interplanetary communications might be structured similarly someday).
Of course, mTLS is not required for service meshKaždá služba si môže sama postarať o svoje TLS, no to znamená, že bude potrebné nájsť spôsob, ako generovať certifikáty, distribuuje ich medzi hostiteľmi služby a zahrnúť do aplikácie kód, ktorý tieto certifikáty načíta z súborov. Áno, nezabudnite ani na aktualizáciu týchto certifikátov v určitých intervaloch. Služobné siete automatizujú mTLS pomocou systémov ako , ktoré zase automatizujú proces vydávania a rotácie certifikátov.
3. Autentifikácia a autorizácia
TL;DR: Určte, kto je iniciátorom požiadavky, a definujte, čo mu je povolené robiť ešte predtým, než požiadavka dorazí k službe.
Služby často chcú vedieť, kto kto vykonáva požiadavku (autentifikácia), a na základe týchto informácií rozhodnú, čo čo tomuto subjektu je povolené robiť (autorizácia). V tomto prípade za zámenom „kto“ môžu byť skryté:
- Iné služby. To sa nazýva „autentifikácia peer'a“. Napríklad služba
webchce získať prístup k službedb.Služobné siete zvyčajne riešia takéto problémy pomocou mTLS: certifikáty v tomto prípade pôsobia ako nevyhnutný identifikátor. - Niektorí užívatelia - ľudia. To sa nazýva „autentifikácia požiadavky“. Napríklad užívateľ
haxor69chce zakúpiť novú lampu. Služobné siete poskytujú rôzne mechanizmy, ako napríklad .Mnohí z nás to museli robiť v kóde aplikácie. Príde požiadavka, prehliadneme tabuľku
users, nájdeme užívateľa a porovnáme heslo, potom skontrolujeme stĺpecpermissionsa tak ďalej. V prípade service mesh sa to deje ešte predtým, než požiadavka dorazí k službe.
Po tom, čo sme určili, od koho prišla požiadavka, je potrebné určiť, čo je tomuto subjektu povolené robiť. Niektoré service mesh umožňujú definovať základné politiky (o tom, kto a čo smie robiť) vo forme súborov YAML alebo v príkazovom riadku, zatiaľ čo iné ponúkajú integráciu s rámcami ako . Konečným cieľom je zabezpečiť, aby vaše služby akceptovali akékoľvek požiadavky, s odvážnou domnienkou, že pochádzajú z dôveryhodného zdroja a toto konanie je povolené.
4. Balanced Load
TL;DR: Rozdeľte záťaž medzi inštanciami služby podľa určitého vzoru.
Služba v rámci servisnej sekty sa veľmi často skladá z množstva identických exemplárov. Napríklad, dnes služba cache sa skladá z 5 kópií, a zajtra sa ich počet môže zvýšiť na 11. Požiadavky smerujúce do cache, musia byť rozdeľované podľa určitého cieľa. Napríklad minimalizovať oneskorenie alebo maximalizovať pravdepodobnosť dostania sa k funkčnému exempláru. Najčastejšie sa používa algoritmus kruhového servisu (Round-robin), ale existuje aj množstvo ďalších - napríklad metóda vážených (weighted) požiadaviek (je možné vybrať preferované ciele), kruhové (ring) hashovanie (používanie konzistentného hashovania pre upstream hostiteľov) alebo metóda najmenej požiadaviek (prioritizácia exemplára s najmenším počtom požiadaviek).
Klasické vyvažovače majú aj ďalšie funkcie, ako je HTTP caching a ochrana pred DDoS, ale nie sú veľmi relevantné pre typ trafficu east-west (t.j. pre traffic v rámci dátového centra - pozn. prekl.). (typická oblasť aplikácie service mesh). Samozrejme, nie je nutné používať service mesh na vyvažovanie záťaže, avšak umožňuje nastaviť a kontrolovať politiky vyvažovania pre každú službu z centralizovanej riadiacej vrstvy, čím eliminuje potrebu spúšťať a nastavovať samostatné vyvažovače v sieťovej stohu.
5. Pretrhnutie okruhu (circuit breaking)
TL;DR: Zastavte traffic k problematickej službe a kontrolujte škody v najhorších scénaroch.
Ak z akéhokoľvek dôvodu služba nezvláda traffic, service mesh poskytuje niekoľko možností, ako tento problém vyriešiť (o iných bude reč v príslušných častiach). Pretrhnutie okruhu je najtvrdší spôsob odpojenia služby od trafficu. Avšak samo o sebe to nedáva zmysel - potrebný je záložný plán. Môže byť predpokladané spätné tlakom () na služby, ktoré vykonávajú požiadavky (len nezabudnite nastaviť svoju service mesh na to!), alebo, napríklad, zafarbenie statusovej stránky na červeno a presmerovanie používateľov na alternatívnu stránku s "padlým veľrybím" ("Twitter je dole").
Služobné siete umožňujú nielen určiť, kedy následne dôjde k odpojeniu a čo nasleduje. V tomto prípade "keď" môže zahŕňať akúkoľvek kombináciu zadaných parametrov: celkový počet požiadaviek za určité obdobie, počet paralelných pripojení, čakajúce požiadavky, aktívne opakované pokusy atď.
Určite nebudete chcieť zneužívať circuit breaking, ale je príjemné vedieť, že máte záložný plán na prípad núdze.
6. Automatiké škálovanie
TL;DR: Zvyšujte alebo znižujte počet inštancií služby v závislosti od stanovených kritérií.
Service mesh nie sú plánovače, preto sami nevykonávajú škálovanie. Môžu však poskytovať informácie, na základe ktorých plánovače prijímajú rozhodnutia. Keďže service mesh majú prístup k celému toku dát medzi službami, majú rozsiahle informácie o tom, čo sa deje: ktoré služby čelili problémom, ktoré sú príliš málo využívané (pridelené zdroje sa zbytočne míňajú) atď.
Napríklad Kubernetes škálovanie služieb na základe využitia CPU a pamäte podmi. (pozri našu prednášku "“ — pozn. prekl.)", ale ak sa rozhodnete vykonávať škálovanie na základe akéhokoľvek iného parametra (v našom prípade - týkajúceho sa prenosu), bude potrebná osobitná metrika. Sprievodca ukazuje, ako to dosiahnuť pomocou , a , ale samotný proces je dosť zložitý. Radi by sme, aby service mesh tento proces zjednodušila, umožňujúc jednoducho nastaviť podmienky ako "zvýši počet inštancií služby auth, ak počet čakajúcich požiadaviek prekročí prahovú hodnotu počas minúty".
7. Kanárske nasadzovanie
TL;DR: Testujte nové funkcie alebo verzie služby na podmnožine používateľov.
Predstavte si, že vyvíjate nejaký SaaS produkt a plánujete spustiť jeho novú vynikajúcu verziu. Testovali ste ju v stagingu a fungovala skvele. Napriek tomu vás však prepadávajú určité obavy o jej správanie v reálnych podmienkach. Inými slovami, je potrebné otestovať novú verziu na skutočných úlohách, bez rizika straty dôvery používateľov. Kanárkové nasadenia sú na to ideálne. Umožňujú predviesť novú funkciu malej skupine používateľov. Táto skupina môže pozostávať z najvernejších používateľov, tých, ktorí používajú bezplatnú verziu produktu, alebo od používateľov, ktorí sa ponúkli, že budú „zvláštnymi králikmi“.
Service mesh-e to umožňujú, pretože umožňujú určiť kritériá, ktoré definujú, kto a ktorú verziu aplikácie uvidí, a príslušne smerujú prevádzku. Pri tom sa pre samotné služby nič nemení. Verzia 1.0 služby si myslí, že všetky požiadavky prichádzajú od používateľov, ktorí ju mali vidieť, a verzia 1.1 to isté predpokladá vo vzťahu k svojim používateľom. A vy, medzitým, môžete meniť percento prevádzky medzi starou a novou verziou, presmerovaním rastúceho počtu používateľov na novú, ak funguje stabilne a vaši „experimentálni“ dávajú súhlas.
8. Modro-zelené nasadenia
TL;DR: Vydajte novú vynikajúcu funkciu, ale buďte pripravení okamžite sa vrátiť späť.
Zmysel tkvie v tom, že spustíte nový „modrý“ servis paralelne so starým, „zeleným“. Ak všetko pôjde hladko a nový servis si dobre vedie, starý sa dá postupne vypnúť. (Bohužiaľ, raz tento nový „modrý“ servis opakuje osud „zeleného“ a zmizne...) Modro-zelené nasadenia sa líšia od kanárkových tým, že nová funkcia zasahuje všetkých používateľov (a nie len časť); zmysel spočíva v tom, mať pripravenú „záložnú prístav“, ak by niečo išlo zle.
Service mesh poskytujú veľmi pohodlný spôsob testovania "modrej" služby a okamžitého prechodu na funkčnú "zelenú" v prípade porúch. Nehovoriac o tom, že súčasne poskytujú množstvo informácií (pozri bod "Telemetria" nižšie) o fungovaní "modrej", čo pomáha pochopiť, či je pripravená na plné nasadenie.
Pozn. prekl.: Viac o rôznych stratégiách nasadenia v Kubernetes (vrátane spomenutých canary, blue/green a ďalších) si môžete prečítať v .
9. Kontrola zdravia
TL;DR: Sledujte, ktoré inštancie služieb sú funkčné a reagujte na tie, ktoré prestanú byť.
Kontrola zdravia (health check) pomáha rozhodnúť, či sú inštancie služby pripravené prijímať a spracovávať prevádzku. Napríklad v prípade HTTP služieb môže kontrola zdravia vyzerať ako GET požiadavka na endpoint /health. Odpoveď 200 OK znamená, že inštancia je zdravá, akákoľvek iná odpoveď znamená, že nie je pripravená prijímať prevádzku. Service mesh umožňujú určiť, akým spôsobom bude kontrolovaná funkčnosť, ako aj frekvenciu, s ktorou sa táto kontrola vykonáva. Túto informáciu možno potom využiť na iné účely - napríklad na vyvažovanie záťaže a obmedzenie okruhu (circuit breaking).
Týmto spôsobom kontrola zdravia nevystupuje ako samostatný scenár použitia, ale zvyčajne sa používa na dosiahnutie iných cieľov. V závislosti od výsledkov health check môže byť potrebné vykonať vonkajšie (vo vzťahu k iným cieľom služobných sietí) akcie: napríklad aktualizovať stavovú stránku, vytvárať issues na GitHub alebo vypĺňať tiket JIRA. A service mesh ponúka pohodlný mechanizmus na automatizáciu všetkého toho.
10. Odporúčanie záťaže (load shedding)
TL;DR: Presmerujte prevádzku v reakcii na dočasný nárast v používaní.
Ak sa nejaká služba ocitne preťažená prevádzkou, môžete dočasne presmerovať časť tejto prevádzky na iné miesto (t.j. "zhodiť", "prelievať" (shed) ju tam). Napríklad na záložnú službu alebo dátové centrum, alebo do trvalého témat. V dôsledku toho služba naďalej spracováva časť požiadaviek namiesto toho, aby zlyhala a úplne prestala spracovávať všetko. Zníženie zaťaženia je lepšie ako pretrhnutie reťazca, ale i tak sa neodporúča nadmerne ho využívať. Umožňuje to zabrániť kaskádovým zlyhaniam, pri ktorých zlyhajú downstream služby.
11. Paralelizácia/zrkadlenie prevádzky
TL;DR: Odošlite jeden požiadavok na viacerých miestach naraz.
Niekedy vzniká potreba odoslať požiadavku (alebo určitý výber požiadaviek) na viaceré služby naraz. Typickým príkladom je odosielanie časti produkčnej prevádzky na testovací server. Hlavný webový server produkcie odošle požiadavku na podriadenú službu products.production a len na ňu. A service mesh inteligentne kopíruje túto požiadavku a odosiela ju na products.staging, o čom webový server ani netuší.
Ďalší súvisiaci scenár používania service mesh, ktorý sa dá realizovať na vrchu paralelizácie prevádzky, je . Predpokladá odosielanie rovnakých požiadaviek rôznym verziám služby a kontrolu toho, či sa všetky verzie správajú rovnako. Zatiaľ som sa nestretol s implementáciou service mesh s integrovaným systémom regresného testovania, akým je napríklad , ale sama idea sa zdá perspektívna.
12. Izolácia
TL;DR: Rozdeľte svoju service mesh na mini-siete.
Tiež známa ako segmentácia, izolácia je umenie rozdeľovania service mesh na logicky oddelené segmenty, ktoré o sebe nič nevedia. Izolácia je trochu podobná vytváraniu virtuálnych privátnych sietí. Zásadný rozdiel je však v tom, že stále môžete využívať všetky výhody service mesh (ako napríklad objavovanie služieb), ale s dodatočnou bezpečnosťou. Napríklad, ak sa útočník dostane do služby v jednej z podsietí, nebude môcť vidieť, aké služby sú spustené v iných podsieťach, alebo zachytiť ich prevádzku.
Okrem toho môžu byť výhody aj organizačné. Možno budete chcieť rozdeliť služby do podsietí v závislosti od štruktúry spoločnosti a oslobodiť vývojárov od kognitívnej záťaže spôsobenej potrebou mať na pamäti celú service mesh.
13. Obmedzenie počtu požiadaviek, opakované pokusy a časové limity
TL;DR: Už viac nie je potrebné zahrnúť do kódu základné úlohy správy požiadaviek.
Všetky tieto veci by sa dali považovať za samostatné prípady použitia, ale rozhodol som sa ich zlúčiť kvôli jednej spoločnej vlastnosti: prevádzajú úlohy správy životného cyklu požiadaviek, ktoré zvyčajne spracovávajú aplikačné knižnice. Ak vyvíjate webový server v Ruby on Rails (nesúvisiaci so service mesh), ktorý vykonáva požiadavky na backendové služby cez , aplikácia sa bude musieť sama rozhodnúť, čo robiť, ak N požiadaviek zlyhá. Taktiež bude potrebné zistiť, ako veľký objem prevádzky tieto služby dokážu spracovať a 'hardcode' tieto parametre pomocou špeciálne knižnice. Navyše, aplikácia sa bude musieť rozhodnúť, kedy je lepšie vzdať sa a nechať požiadavku "prekročiť platnosť" (po timeout). A na to, aby sa zmenil ktorýkoľvek z vyššie uvedených parametrov, bude potrebné zastaviť webový server, prekonfigurovať a znova spustiť.
Presun týchto úloh do service mesh znamená nielen to, že vývojári služieb nad nimi nebudú musieť premýšľať, ale aj to, že ich bude možné posúdiť z globálnejšieho hľadiska. Ak sa používa zložitý reťazec služieb, povedzme A → B → C → D → E, je potrebné zohľadniť celý životný cyklus požiadavky. Ak je cieľom predĺžiť timeouty v službe C, je logické urobiť to všetko naraz, a nie po častiach: aktualizovať kód služby a čakať, až bude pull request prijatý a CI systém nasadí aktualizovanú službu.
14. Teleméria
TL;DR: Zhromažďujte všetky potrebné (aj menej potrebné) informácie od služieb.
Teleméria je všeobecný termín, ktorý zahŕňa metriky, distribuované trasovanie a logy. Service mesh ponúkajú mechanizmy na zber a spracovanie všetkých troch typov údajov. Tu sa to stáva trochu neurčitým, pretože počet možných variantov je príliš veľký. Na zber metrík existujú a ďalšie nástroje, na zber logov môžete použiť , , a ďalšie. (napríklad ClickHouse s naším pre K8s - pozn. prekl.), pre distribuované trasovanie existuje a podobne. Každý service mesh môže podporovať jedny nástroje a nepodporovať iné. Bude zaujímavé sledovať, či projekt poskytne určitú konvergenciu.
V tomto prípade je výhodou technológie service mesh to, že sidecar kontajnery môžu zhromaždiť všetky vyššie uvedené údaje zo svojich služieb. Inými slovami, dostávate jednotný systém zberu telemetrie a service mesh dokáže spracovať všetky tieto informácie rôznymi spôsobmi. Napríklad:
- sledovať logy z určitej služby v CLI;
- sledovať objem požiadaviek z panela na monitorovanie service mesh;
- zhromažďovať distribuované trasovanie a presmerovať ich do systému ako Jaeger.
Pozor, subjektívny názor: Všeobecne povedané, telemetria je oblasť, do ktorej je silný zásah service mesh nežiaduci. Zber základných informácií a sledovanie niektorých „zlatých metrík“ ako percento úspešných požiadaviek a oneskorenia je v poriadku, ale poďme dúfať, že nebudeme svedkami vzniku akýchsi Frankensteinových stackov, ktoré sa pokúsia nahradiť špecializované systémy, z ktorých niektoré už preukázali svoje kvality a sú dobre preskúmané.
15. Audit
TL;DR: Kto zabúda historické lekcie, je odsúdený ich opakovať.
Audit je umenie pozorovania dôležitých udalostí v systéme. V prípade service mesh to môže znamenať sledovanie toho, kto robil požiadavky na konkrétne endpointy určitých služieb alebo koľkokrát sa v poslednom mesiaci vyskytla nejaká udalosť súvisiaca s bezpečnosťou.
Je jasné, že audit je veľmi úzko spätý s telemetriou. Rozdiel spočíva v tom, že telemetria sa zvyčajne spája s vecami ako výkonnosť a technická elegancia, zatiaľ čo audit môže mať vzťah k právnym a iným otázkam, ktoré presahujú prísne technickú sféru (napríklad dodržiavanie GDPR – Všeobecného nariadenia EÚ o ochrane údajov).
16. Vizualizácia
TL;DR: Nech žije React.js – nevyčerpateľný zdroj bizarných rozhraní.
Možno existuje vhodnejší termín, ale ja ho nepoznám. Mám na mysli grafické znázornenie service mesh alebo jej niektorých komponentov. Tieto vizualizácie môžu zahŕňať ukazovatele ako priemerné oneskorenia, informácie o konfigurácii sidecar kontajnerov, výsledky kontrol zdravia a upozornenia.
Práca v prostredí zameranom na služby je spojená s omnoho väčšou kognitívnou záťažou v porovnaní s Jeho Vel'ičenstvom Monolitom. Preto je potrebné znižovať kognitívny tlak za každú cenu. Banálny grafický rozhranie pre service mesh, ktoré umožňuje kliknúť na tlačidlo a získať požadovaný výsledok, môže mať rozhodujúci význam pre rast popularity tejto technológie.
Neboli zahrnuté v zozname
Pôvodne som mal v úmysle zahrnúť do zoznamu ešte niekoľko scenárov použitia, ale neskôr som sa rozhodol to neurobiť. Tu sú spolu s dôvodmi môjho rozhodnutia:
- Multi-dátové centrum. V mojom ponímaní to nie je len scénar použitia, ale skôr úzka a konkrétna oblasť aplikácie servisných sietí alebo niektorých funkcií, ako je objavovanie služieb.
- Ingress a egress. Je to súvisiaca oblasť, ale obmedzil som sa (možno umelo) na scenár použitia „východ-západ” toku. Ingress a egress si zaslúžia samostatný článok.
Záver
Na tomto mieste je zatiaľ všetko! Ešte raz, tento zoznam je dosť podmienený a pravdepodobne nie je úplný. Ak máte pocit, že som niečo prehliadol alebo sa v niečom zmýlil, neváhajte ma kontaktovať na Twitteri (). Prosím, dodržiavajte pravidlá slušnosti.
P.S. od prekladateľa
Ako základ pre titulnú ilustráciu článku bolo použité obrázok z článku „“ (autor — Gregory MacKinnon). Na ňom je znázornené, ako časť funkcionality z aplikácií (zelenou farbou) prešla na service mesh, zabezpečujúcu vzťahy medzi nimi (modrou farbou).
Prečítajte si tiež na našom blogu:
- «»;
- «»;
- «».
Zdroj: habr.com
