

V SQL opisujete „čo“ chcete získať, nie „ako“ by sa to malo vykonávať. Preto problém s vývojom SQL dotazov v štýle „ako to vyzerá, tak to napíšem“ zaujíma svoje čestné miesto, popri .
Dnes si na veľmi jednoduchých príkladoch pozrieme, k čomu to môže viesť v kontexte používania GROUP/DISTINCT a LIMIT spolu s nimi.
Ak ste napísali v dotaze „najskôr spoj tieto tabuľky, a potom vyhoď všetky duplikáty, musí zostať len jeden príklad na každý kľúč“ — presne tak to bude fungovať, aj keď spojenie vôbec nebolo potrebné.
A niekedy sa stane, že to „jednoducho funguje“, niekedy to má nepríjemný dopad na výkon, a niekedy to dá úplne neočakávané efekty z pohľadu vývojára.
No, možno nie tak pôsobivé, ale...
„Sladká dvojica“: JOIN + DISTINCT
SELECT DISTINCT
  X.*
FROM
  X
JOIN
  Y
    ON Y.fk = X.pk
WHERE
  Y.bool_condition;
Je jasné, čo chceli vybrať také záznamy X, pre ktoré v Y existujú súvisiace s vykonávanou podmienkou. Napísali sme dotaz cez JOIN — dostali sme nejaké hodnoty pk viackrát (presne toľkokrát, koľko vyhovujúcich záznamov sa našlo v Y). Ako ich odstrániť? Samozrejme STDEV!
Obzvlášť „teší“, keď sa pre každý záznam X nájdú stovky súvisiacich záznamov Y, a potom hrdinsky zlikvidujeme duplikáty...
Ako to opraviť? Najprv si uvedomiť, že úlohu je možné modifikovať na „vybrať také záznamy X, pre ktoré v Y existuje ASPOŇ JEDEN súvisiaci s vykonávanou podmienkou“ — veď z prvej Y-záznamu nám nič nepotrebujeme.
Vnorený EXISTS
SELECT
  *
FROM
  X
WHERE
  EXISTS(
    SELECT
      NULL
    FROM
      Y
    WHERE
      fk = X.pk AND
      bool_condition
    LIMIT 1
  );
Niektoré verzie PostgreSQL chápu, že v EXISTS stačí nájsť prvý záznam, staršie — nie. Preto vždy uprednostňujem uvádzať LIMIT 1 vnútri EXISTS.
LATERAL JOIN
SELECT
  X.*
FROM
  X
, LATERAL (
    SELECT
      Y.*
    FROM
      Y
    WHERE
      fk = X.pk AND
      bool_condition
    LIMIT 1
  ) Y
WHERE
  Y IS DISTINCT FROM NULL;
Tento variant tiež umožňuje, ak je to potrebné, naraz vrátiť nejaké údaje z nájdeného súvisiaceho Y-záznamu. Podobný variant je preskúmaný v článku .
„Prečo platiť viac“: DISTINCT [ON] + LIMIT 1
Dodatočná výhoda takýchto transformácií dotazu spočíva v možnosti ľahko obmedziť prehľadávanie záznamov, ak potrebujeme iba jeden alebo niekoľko z nich, ako v nasledujúcom prípade:
SELECT DISTINCT ON(X.pk)
  *
FROM
  X
JOIN
  Y
    ON Y.fk = X.pk
LIMIT 1;
Teraz čítame dotaz a snažíme sa pochopiť, čo sa navrhuje, aby databázový systém vykonal:
- spájame tabuľky
- unikalizujeme podľa X.pk
- z zostávajúcich záznamov vyberáme nejaký jeden
Čo teda dostaneme? „Nejaký jeden záznam“ z unikálnych — a ak by sme brali tento jeden z nie neunikálnych, zmenil by sa nejakým spôsobom výsledok? .. „Ak nie je rozdiel, prečo platiť viac?“
SELECT
  *
FROM
  (
    SELECT
      *
    FROM
      X
    -- sem môžete vložiť vhodné podmienky
    LIMIT 1 -- +1 Limit
  ) X
JOIN
  Y
    ON Y.fk = X.pk
LIMIT 1;
A presne tá istá téma s GROUP BY + LIMIT 1.
„Chcel by som len spýtať“: implicitný GROUP + LIMIT
Podobné veci sa objavujú pri rôznych overeniach neprázdnosti tabuľky alebo CTE počas vykonania dotazu:
...
CASE
  WHEN (
    SELECT
      count(*)
    FROM
      X
    LIMIT 1
  ) = 0 THEN ...
Agregátne funkcie (count/min/max/sum/...) sa úspešne vykonávajú na celom súbore, aj bez explicitného určenia je prítomný, definícia pohľadu musí obsahovať. Lenže s LIMIT sa veľmi nekamarádia.
Vývojár môže myslieť „ak tam sú záznamy, tak nepotrebujem viac LIMIT“. Ale takto to nerobte! Pretože pre databázu to znamená:
- počítaj, čo chcú všetky záznamy
- vydaj toľko riadkov, koľko žiadajú
V závislosti od cieľových podmienok tu môže byť vhodné vykonať jednu z výmien:
(count + LIMIT 1) = 0naNOT EXISTS(LIMIT 1)(count + LIMIT 1) > 0naEXISTS(LIMIT 1)count >= Nna(SELECT count(*) FROM (... LIMIT N))
„Koľko vážiť v gramoch“: DISTINCT + LIMIT
SELECT DISTINCT
  pk
FROM
  X
LIMIT $1
Naivný vývojár môže úprimne predpokladať, že vykonanie dotazu sa zastaví, keď len nájdeme $1 prvých rôznych hodnôt.
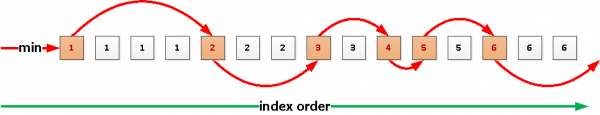
Kedykoľvek v budúcnosti to môže fungovať vďaka novému uzlu Index Skip Scan, ktorého implementácia sa momentálne pripravuje, ale zatiaľ — nie.
Zatiaľ sa najprv vytiahnu všetky záznamy, unikalizujú a až z nich vráti koľko je požadované. Obzvlášť smutné môže byť, ak sme chceli niečo ako $1 = 4, a záznamov v tabuľke je stovky tisíc...
Aby sme sa zbytočne nesmutnili, využijeme rekurzívny dotaz :
Zdroj: habr.com
