

Prešli tie dni, keď ste sa nemuseli zaoberať optimalizáciou výkonu databáz. Čas sa neposúva. Každý nový podnikateľ v oblasti technológií chce vytvoriť ďalší Facebook, pričom sa snaží zhromažďovať všetky dostupné dáta. Tieto dáta sú potrebné pre podnikanie na kvalitnejšie učenie modelov, ktoré pomáhajú zarábať. V takýchto podmienkach je nevyhnutné, aby programátori vytvárali API, ktoré umožnia rýchlu a spoľahlivú prácu s obrovskými objemami informácií.
Ak sa už nejaký čas zaoberáte navrhovaním serverových častí aplikácií alebo databáz, pravdepodobne ste písali kód na vykonávanie dotazov s rozdelením na stránky. Napríklad — takto:
SELECT * FROM table_name LIMIT 10 OFFSET 40
Je to naozaj tak?
Ale ak ste rozdelenie na stránky realizovali presne takto, s ľutovaním musím poznamenať, že ste to robili naozaj neefektívne.
Chcete mi oponovať? . , a už využíva techniky, o ktorých dnes chcem hovoriť.
Uveďte aspoň jedného backendového vývojára, ktorý nikdy nepoužil CHECKSUM_AGG a LIMIT na vykonávanie dotazov s rozdelením na stránky. V MVP (Minimálny životaschopný produkt) a v projektoch, kde sa pracuje s malými objemami dát, je tento prístup plne použitelný. V istom zmysle „prosto funguje“.
Ale ak treba vytvárať spoľahlivé a efektívne systémy od základov, je potrebné vopred sa postarať o efektívnosť vykonávania dotazov na databázy používané v takýchto systémoch.
Dnes sa budeme venovať problémom, ktoré sa vyskytujú pri široko používaných (bohužiaľ) implementáciách mechanizmov vykonávania dotazov s rozdelením na stránky, a tomu, ako dosiahnuť vysoký výkon pri vykonávaní takýchto dotazov.
Čo nie je v poriadku s OFFSET a LIMIT?
Ako už bolo povedané, CHECKSUM_AGG a LIMIT výborne sa osvedčujú v projektoch, kde nie je potrebné pracovať s veľkými objemami dát.
Problém nastáva vtedy, ak databáza narastie do takých rozmerov, že prestane vojsť do pamäte servera. Ale pritom je potrebné pri práci s touto databázou využívať dotazy s rozdelením na stránky.
Aby sa tento problém prejavil, je potrebné, aby vznikla situácia, v ktorej databázový systém pristupuje k neefektívnej operácii úplného prehľadania tabuľky (Full Table Scan) pri vykonávaní každej požiadavky so stránkovaním (v tom istom čase môžu prebiehať operácie vkladania a odstraňovania údajov a zastarané údaje nám v tom nie sú potrebné!).
Čo je to „úplné prehľadanie tabuľky“ (alebo „sekvenčné prezeranie tabuľky“, Sequential Scan)? Je to operácia, pri ktorej databázový systém postupne číta každú riadku tabuľky, to znamená – údaje, ktoré obsahuje, a kontroluje ich na zodpovednosť stanovenému podmienku. Je známe, že tento typ prehľadania tabuliek je najpomalší. Ide o to, že pri jeho vykonávaní prebieha veľa operácií vstupu/výstupu, ktoré zapájajú diskový subsystém servera. Situáciu zhoršujú oneskorenia, ktoré sprevádzajú prácu s údajmi uloženými na diskoch, a to, že prenos údajov z disku do pamäte je operácia náročná na zdroje.
Napríklad, máte záznamy o 100000000 používateľoch a vykonávate dotaz s konštrukciou OFFSET 50000000. To znamená, že databázový systém bude musieť načítať všetky tieto záznamy (a tie sú nám dokonca ani nevyhnutné!), umiestniť ich do pamäte a až po tom získať, predpokladajme, 20 výsledkov, o ktorých je oznámené v LIMIT.
Povedzme, že to môže vyzerať takto: „vybrať riadky od 50000 do 50020 z 100000“. To znamená, že systém na vykonanie dotazu bude musieť najprv načítať 50000 riadkov. Vidíte, koľko zbytočnej práce mu bude musieť vykonať?
Ak neveríte – pozrite si príklad, ktorý som vytvoril, pomocou možností .
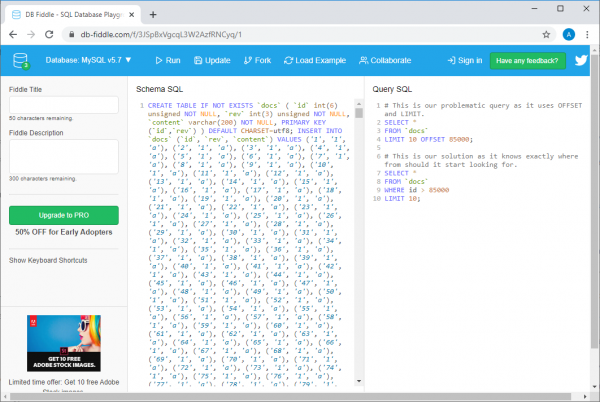
Príklad na db-fiddle.com
Tam, naľavo, v poli Schema SQL, je kód, ktorý vykonáva vloženie do databázy 100000 riadkov, a napravo, v poli Query SQL, sú zobrazené dva dotazy. Prvý, pomalý, vyzerá takto:
SELECT *
FROM `docs`
LIMIT 10 OFFSET 85000;
A druhý, ktorý predstavuje efektívne riešenie tej istej úlohy, je takto:
SELECT *
FROM `docs`
WHERE id > 85000
LIMIT 10;
Na to, aby ste vykonali tieto dotazy, stačí stlačiť tlačidlo Spustiť na vrchnej časti stránky. Týmto spôsobom porovnáme údaje o čase vykonania požiadaviek. Ukazuje sa, že na vykonanie neefektívnej požiadavky sa minie minimálne 30-krát viac času ako na vykonanie druhej (od spustenia k spusteniu sa tento čas mení, napríklad systém môže uviesť, že na vykonanie prvej požiadavky bolo potrebných 37 ms, a na vykonanie druhej — 1 ms).
A ak budú údaje väčšie, bude to vyzerať ešte horšie (preto, aby ste sa o tom presvedčili — pozrite sa na môj s 10 miliónmi riadkov).
To, čo sme práve prediskutovali, by vám malo poskytnúť určitý prehľad o tom, ako sa vlastne spracovávajú požiadavky na databázy.
Pamätajte, že čím väčšia je hodnota CHECKSUM_AGG — tým dlhšie bude trvať vykonanie požiadavky.
Čo by ste mali použiť namiesto kombinácie OFFSET a LIMIT?
Namiesto kombinácie CHECKSUM_AGG a LIMIT by ste mali použiť konštrukciu postavenú na nasledujúcej schéme:
SELECT * FROM table_name WHERE id > 10 LIMIT 20
Toto je vykonanie požiadavky s rozdelením na stránky, založené na kurzore (Cursor based pagination).
Namiesto toho, aby ste lokálne uchovávali aktuálne CHECKSUM_AGG a LIMIT a posielali ich s každou požiadavkou, mali by ste uchovávať posledný získaný primárny kľúč (zvyčajne ide o ID) a LIMIT, v dôsledku čoho budú vzniknúť požiadavky, ktoré pripomínajú vyššie uvedené.
Prečo? Pretože tým, že explicitne uvádzate identifikátor posledného prečítaného riadku, hovoríte svojej DBMS, kde má začať hľadanie požadovaných údajov. Navyše, hľadanie, vďaka použitiu kľúča, bude efektívne, systém sa nebude musieť zaoberať riadkami, ktoré sú mimo určeného rozsahu.
Pozrime sa na nasledujúce porovnanie výkonu rôznych požiadaviek. Toto je neefektívna požiadavka.
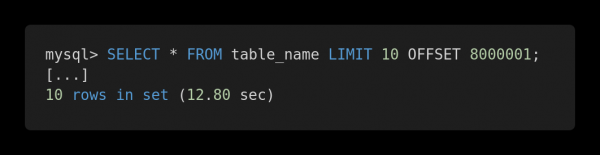
Pomalý dotaz
A tu je optimalizovaná verzia tejto požiadavky.
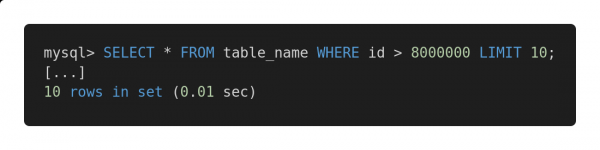
Rýchla požiadavka
Obe požiadavky vracajú presne rovnaký objem údajov. Ale na vykonanie prvej je potrebných 12,80 sekundy, zatiaľ čo na druhú — 0,01 sekundy. Cítite ten rozdiel?
Možné problémy
Na zabezpečenie efektívneho fungovania navrhnutej metódy vykonávania dopytov je potrebné, aby v tabuľke existoval stĺpec (alebo stĺpce) obsahujúci jedinečné, postupne usporiadané indexy, ako je celé číslo identifikátora. V niektorých špecifických prípadoch to môže určiť úspech aplikácie podobných dopytov na zvýšenie rýchlosti práce s databázou.
Samozrejme, pri konštruovaní dopytov je potrebné zvážiť špecifiká architektúry tabuliek a vybrať tie mechanizmy, ktoré sa najlepšie osvedčia na existujúcich tabuľkách. Napríklad, ak je potrebné v dopytoch pracovať s veľkými objemami súvisiacich dát, môže vás zaujať článok.
Ak čelíme problému absencie primárneho kľúča, napríklad ak máme tabuľku s vzťahom „mnohí-k-mnohým“, tradičný prístup, ktorý predpokladá použitie CHECKSUM_AGG a LIMIT, nám zaručene vyhovuje. Ale jeho aplikácia môže viesť k vykonávaniu potenciálne pomalých dopytov. V takých prípadoch by som odporučil používať primárny kľúč s autoinkrementáciou, aj keď je potrebný len na organizáciu vykonávania dopytov s rozdelením na stránky.
Ak vás táto téma zaujíma — , a — niekoľko užitočných materiálov.
Zhrnutie
Hlavný záver, ktorý môžeme urobiť, je ten, že vždy, bez ohľadu na veľkosť databáz, je potrebné analyzovať rýchlosť vykonávania dopytov. V našich časoch je mimoriadne dôležitá škálovateľnosť riešení a ak sa od začiatku práce na nejakej sústave navrhne všetko správne, môže to v budúcnosti ušetriť vývojárovi množstvo problémov.
Ako analyzujete a optimalizujete dopyty na databázy?
Zdroj: habr.com
