

Volám sa Viktor Jagofarov a zameriavam sa na rozvoj platformy Kubernetes v spoločnosti DomKlik ako technický vedúci vývoja v tíme Ops (prevádzka). Chcel by som sa podeliť o to, ako sú naše procesy Dev Ops zorganizované, o špecifikách prevádzky jedného z najväčších k8s klastrov v Rusku, ako aj o DevOps/SRE praktikách, ktoré naša tím aplikuje.
Tím Ops
V tíme Ops aktuálne pracuje 15 ľudí. Traja z nich sú zodpovední za kanceláriu, dvaja pracujú v inom časovom pásme a sú k dispozícii aj v noci. Týmto spôsobom je vždy niekto z Ops pri monitore a pripravený reagovať na incident akejkoľvek zložitosti. Nočné služby nemáme, čo chráni našu psychiku a umožňuje všetkým sa vyspať a tráviť voľný čas nielen za počítačom.
Kompetencie sú rôzne: sieťoví špecialisti, DBA, odborníci na ELK stack, Kubernetes administrátori/vývojári, odborníci na monitorovanie, virtualizáciu, hardvér a pod. Spojuje nás jedno — každý z nás môže v určitej miere nahradiť akéhokoľvek iného člena tímu: napríklad pridať nové uzly do k8s klastru, aktualizovať PostgreSQL, napísať CI/CD pipeline + Ansible, automatizovať niečo v Pythone/Bashi/Go, pripojiť hardvér v datovom centre. Silné kompetencie v určitej oblasti nebránia zmeniť smerovanie a začať sa rozvíjať v inej oblasti. Napríklad, do spoločnosti som nastupoval ako špecialista na PostgreSQL, ale teraz je mojou hlavnou zodpovednosťou správa klastrov Kubernetes. V tíme je každý rast vítaný a veľmi je rozvinutý pocit spoločnej podpory.
Mimochodom, hľadáme. Požiadavky na kandidátov sú celkom štandardné. Osobne je pre mňa dôležité, aby sa človek zapadol do kolektívu, bol nekonfliktný, ale tiež vedel obhájiť svoj názor, mal túžbu rozvíjať sa a nebál sa skúšať niečo nové, navrhoval svoje nápady. Rovnako sú potrebné zručnosti programovania v skriptovacích jazykoch, znalosť zásad Linuxu a anglického jazyka. Angličtina je potrebná len na to, aby človek v prípade problému mohol rýchlo nájsť jeho riešenie za 10 sekúnd, nie za 10 minút. So špecialistami s hlbokými znalosťami Linuxu je teraz veľmi ťažké: je to smiešne, ale dvaja z troch kandidátov nevedia odpovedať na otázku „Čo je to Load Average? Z čoho sa skladá?“, a otázku „Ako získať core dump z C-programu“ považujú za niečo z ríše superhrdinov… alebo dinosaurov. S tým sa musíme zmieriť, pretože väčšina ľudí má zvyčajne silne vyvinuté iné kompetencie, a „linuxu“ sa naučíme. Odpoveď na otázku „prečo to všetko potrebujeme vedieť DevOps-inžinierovi v súčasnom svete cloudov“ musíme nechať mimo článku, ale ak by sme mali povedať to tromi slovami: všetko toto je potrebné.
Tím Tools
V automatizácii má veľkú úlohu tím Tools. Ich hlavnou úlohou je vytváranie pohodlných grafických a CLI nástrojov pre vývojárov. Napríklad naša interná aplikácia Confer umožňuje doslova dvoma kliknutiami myši nasadiť aplikáciu do Kubernetes, nastaviť jej zdroje, kľúče z trezoru atď. Predtým sme používali Jenkins + Helm 2, ale museli sme vyvinúť vlastný nástroj, aby sme eliminovali kopírovanie a priniesli jednotnosť do životného cyklu softvéru.
Tím Ops nepíše pipeline za vývojárov, ale môže poskytnúť poradenstvo o akýchkoľvek otázkach pri ich písaní (niektorí ešte stále používajú Helm 3).
DevOps
Čo sa týka DevOps, vidíme to takto:
Tímy Dev píšu kód, nasadzujú ho cez Confer do dev -> qa/stage -> prod. Zodpovednosť za to, aby kód nezastavoval a nevyhadzoval chyby, leží na tímok Dev a Ops. Počas dňa by na incident so svojou aplikáciou mal primárne reagovať dispečer z tímu Ops, a v noci a večer by mal dispečer administrátor (Ops) prebudiť dispečera vývojára, ak si je istý, že problém nie je v infraštruktúre. Všetky metriky a alarmy v monitorovaní sa objavujú automaticky alebo poloautomatically.
Zóna zodpovednosti Ops začína okamihom nasadenia aplikácie do produkcie, no zodpovednosť Dev sa tým nekončí — robíme jednu vec a sme na jednej lodi.
Vývojári radia administrátorom, ak potrebujú pomoc pri písaní administrátorského mikroslužby (napríklad, Go backend + HTML5), a administrátori radia vývojárom ohľadom akýchkoľvek otázok týkajúcich sa infraštruktúry alebo otázok spojených s k8s.
Mimochodom, nemáme žiadny monolit, len mikroslužby. Ich počet sa zatiaľ pohybuje medzi 900 a 1000 v produkčnom k8s klastre, ak meráme podľa množstva. nasadeniaPočet podov sa pohybuje medzi 1700 a 2000. V produkčnom klastre je teraz okolo 2000 podov.
Presné čísla nemôžem uviesť, pretože sledujeme zbytočné mikroslužby a odstraňujeme ich v polautomatickom režime. Sledovanie zbytočných entít v k8s nám pomáha , čo nám výrazne šetrí zdroje a peniaze.
Správa resursov
Monitorovanie
Kameňom úrazu pri prevádzke veľkého klastra sa stáva správne vybudovaný a informatívny monitoring. Zatiaľ sme nenašli univerzálne riešenie, ktoré by pokrylo 100 % všetkých požiadaviek na monitoring, a preto občas vytvárame rôzne prispôsobené riešenia v tejto oblasti.
- ZabbixStarý dobrý monitoring, ktorý je primárne určený na sledovanie celkového stavu infraštruktúry. Hovorí nám, keď node umiera z hľadiska CPU, pamäte, diskov, siete a podobne. Nič nadprirodzené, ale máme aj samostatný DaemonSet agentov, pomocou ktorých napríklad sledujeme stav DNS v klastri: hľadáme pomalé pody coredns, overujeme dostupnosť externých hostiteľov. Mohlo by sa zdať, prečo si s tým robiť starosti, ale pri veľkých objemoch prevádzky je tento komponent vážnym bodom zlyhania. Už som predtým , ako som bojoval s výkonom DNS v klastri.
- Prometheus Operator. Sada rôznych exportérov poskytuje dobrý prehľad o všetkých komponentoch klastra. Potom to všetko vizualizujeme na veľkých dashboardoch v Grafana a na upozornenia používame alertmanager.
Ďalším užitočným nástrojom pre nás sa stal . Napísali sme ho po tom, čo sme sa niekoľkokrát stretli so situáciou, kedy jedna tím prekrýva svojimi spôsobmi Ingress druhého tímu, čo spôsobovalo chyby 50x. Teraz pred nasadením na produkciu vývojári kontrolujú, že nikoho nezasiahnu, a pre môj tím je to dobrý nástroj na primárnu diagnostiku problémov s Ingressami. Zaujímavé je, že pôvodne bol napísaný pre adminov a vyzeral celkom „hrubo“, ale po tom, čo si nástroj obľúbili dev-tímy, sa výrazne premenil a už nevyzerá ako „admin urobil webové rozhranie pre adminov“. Čoskoro tento nástroj opustíme a podobné situácie budú overované ešte pred nasadením pipeline.
Zdroje tímov v „Kube“
Predtým, než sa pustíme do príkladov, stojí za to vysvetliť, ako u nás funguje prideľovanie zdrojov pre mikroslužby.
Aby bolo jasné, aké tímy a v akých množstvách využívajú svoje zdroje (procesor, pamäť, lokálny SSD), prideľujeme na každý tím svoj namespace v „Kube“ a obmedzujeme jeho maximálne možnosti podľa procesora, pamäte a disku, vopred dohodli potreby tímov. Zodpovedne, jeden tím vo všeobecnosti nezablokuje pre nasadenie celý klaster, ak si vyhradí tisíce jadier a terabajty pamäte. Prístupy do namespace sa vydávajú cez AD (používame RBAC). Namespace a ich limity sa pridávajú cez pull-request do GIT-repozitára, a potom sa cez Ansible-pipeline všetko automaticky nasadí.
Príklad prideľovania zdrojov pre tím:
namespaces:

  chat-team:
    pods: 23
    limits:
      cpu: 11
      memory: 20Gi
    requests:
      cpu: 11
      memory: 20Gi
Requesty a limity
V „Kube“ Požiadavka — to je množstvo garantovane vyhradených zdrojov pre pod (jeden alebo viac Docker kontajnerov) v klastri. Limit — to je negarantované maximum. Často môžete vidieť na grafoch, ako nejaký tím si nastavil príliš veľa requestov pre všetky svoje aplikácie a nemôže nasadiť aplikáciu do „Kube“, pretože pod ich namespace sú všetky requesty už „vynaložené“.
Správny spôsob, ako z takej situácie vyjsť: sledovať reálnu spotrebu zdrojov a porovnať ju s požadovaným množstvom (Request).
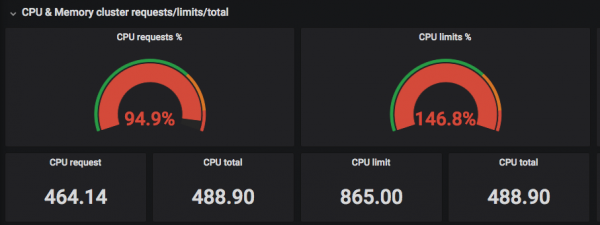
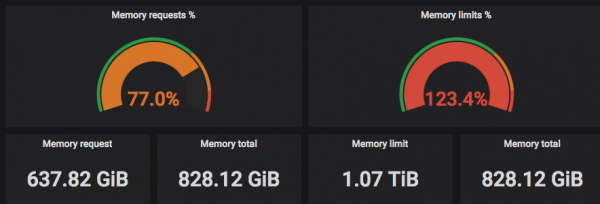
Na snímkach obrazovky vyššie je vidieť, že „požadované“ (Requested) CPU sa prispôsobujú reálnemu počtu vlákien, a Limity môžu presahovať reálny počet procesorových vlákien =)
Teraz si podrobne rozoberieme nejaký namespace (vybral som namespace kube-system — systémový namespace pre komponenty samotného «Kuba») a pozrieme sa na pomer skutočne použitého procesorového času a pamäte k požadovanému:
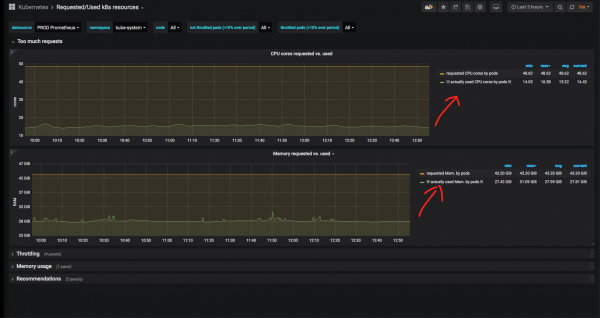
Je zrejmé, že pamäť a CPU rezervované pre systémové služby sú oveľa vyššie, než je skutočne použité. V prípade kube-system je to ospravedlniteľné: občas sa stalo, že nginx ingress controller alebo nodelocaldns na vrchole spotrebovávali CPU a zaberali veľmi veľa RAM, takže tu je taká rezerva ospravedlniteľná. Okrem toho, nemôžeme sa spoliehať na grafy za posledné 3 hodiny: ideálne je vidieť historické metriky za dlhšie časové obdobie.
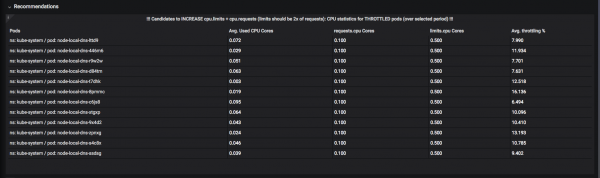
Bola vyvinutá sústava „odporúčaní“. Napríklad tu môžeme vidieť, aké zdroje by bolo lepšie zvýšiť „limity“ (horná povolená hranica), aby nedochádzalo k „throttlingu“: momentu, keď už boli minulé CPU alebo pamäť v pridelenom časovom kvante a čaká, kým ho „rozmrazia“:
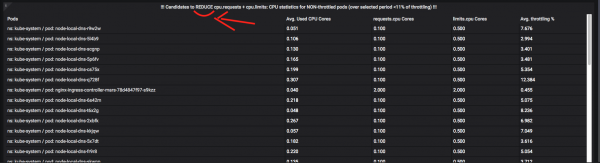
A tu sú pod, ktorým by sa mali obmedziť apetity:
O throttling + monitoring zdrojov je možné napísať niekoľko článkov, takže sa pýtajte v komentároch. V skratke môžem povedať, že úloha automatizácie takýchto metrík je dosť zložitá a vyžaduje veľa času a akrobatických kúskov s „okennými“ funkciami a „CTE“ Prometheus / VictoriaMetrics (tieto pojmy sú v úvodzovkách, pretože v PromQL skoro nie je nič podobného a musíme zostavovať hrozné dotazy na niekoľko obrazoviek textu a zaoberať sa ich optimalizáciou).
Nakoniec majú vývojári nástroje na monitoring svojich namespaces v „Kube“ a sú schopní si sami vyberať, kde a kedy pre aké aplikácie môžu „strihnúť“ zdroje, a ktorým podom môžu pre celú noc odovzdať celý CPU.
Metodológie
Vo firme, ako je teraz módne, dodržiavame DevOps- a SRE-praktiky. Keď má firma 1000 mikroslužieb, približne 350 vývojárov a 15 administrátorov na celú infraštruktúru, musí sa „byť módnym”: za všetkými týmito „buzzwordmi” sa skrýva naliehavá potreba automatizácie všetkého a všetkého, a administrátori by nemali byť úzkym miestom v procesoch.
Ako Ops poskytujeme rôzne metriky a dashboards pre vývojárov, týkajúce sa rýchlosti odpovede služieb a ich chýb.
Používame také metodológie ako: , a , kombinovaním ich spolu. Snažíme sa minimalizovať množstvo dashboardov tak, aby z jedného pohľadu bolo jasné, ktorý servis teraz degraduje (napríklad kódy odpovedí za sekundu, čas odpovedí podľa 99. percentilu) a tak ďalej. Ako náhle sa objavia nejaké nové metriky pre spoločné dashboardy, okamžite ich vytvoríme a pridáme.
Nerobil som grafy už mesiac. Asi je to dobré znamenie: to znamená, že väčšina „požiadaviek“ už bola splnená. Niekedy sa stalo, že som aspoň raz denne robil nejaký nový graf.
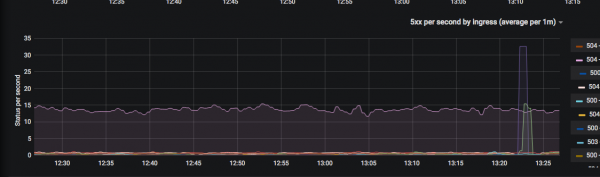
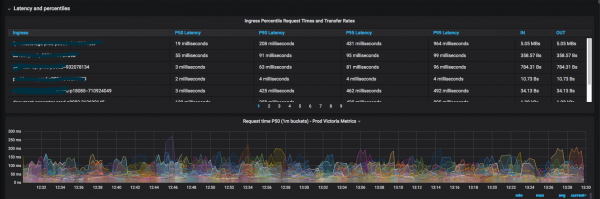
Výsledok je cenný tým, že teraz vývojári dosť zriedka chodia za administrátormi s otázkami „kde nájsť nejakú metriku“.
Implementácia Service Mesh nie je ďaleko a malo by to výrazne uľahčiť život všetkým; kolegovia z Tools už sú blízko k implementácii abstrahovaného „Istio zdravého človeka“: životný cyklus každého HTTP(s) požiadavku bude viditeľný v monitoringu a vždy bude možné pochopiť „v akom štádiu sa všetko pokazilo“ pri medzi-service (a nielen) interakciách. Prihláste sa na odber noviniek z hubu spoločnosti DomClick. =)
Podpora infraštruktúry Kubernetes
Historicky sa to takto vyvinulo, že používame upravenú verziu Kubespray — Ansible-úloha na nasadenie, rozšírenie a aktualizáciu Kubernetes. V nejakom momente bola z hlavnej vetvy odstránená podpora non-kubeadm inštalácií a proces prechodu na kubeadm nebol navrhnutý. Nakoniec spoločnosť Southbridge urobila svoj fork (s podporou kubeadm a rýchlym opravením kritických problémov).
Proces aktualizácie všetkých klastrov k8s vyzerá takto:
- Bereme Kubespray od Southbridge, porovnáme s našou vetvou, a zlúčime.
- Zverejníme aktualizáciu v Stress-„Kubo“.
- Zverejňujeme aktualizáciu po jednej node (v Ansible je to „serial: 1“) v Dev-„Kubo“.
- Aktualizujeme Prod v sobotu večer po jednej node.
V budúcnosti plánujeme nahradiť Kubespray niečím rýchlejším a prejsť na kubeadm.
Máme tri „Kuba“: Stress, Dev a Prod. Plánujeme spustiť ďalšie (hot standby) Prod-„Kubo“ v druhom DC. Stress a Dev žijú vo „virtuálnych strojoch“ (oVirt pre Stress a VMWare cloud pre Dev). Prod-„Kubo“ žije na „holom železe“ (bare metal): sú to rovnaké nody s 32 CPU vláknami, 64-128 GB pamäti a 300 GB SSD RAID 10 — je ich celkom 50. Tri „tenké“ nody sú vyhradené pre „majstrou“ Prod-„Kuba“: 16 GB pamäti, 12 CPU vláknami.
Pre produkciu preferujeme používať „holé železo“ a vyhýbame sa zbytočným vrstvám, ako sú OpenStack: nepotrebujeme „hlučných susedov“ a CPU steal timeA navy a zložitost správy se přibližně zdvojnásobí v případě in-house OpenStack.
Pro CI/CD kubových a dalších infrastrukturních komponent používáme samostatný GIT server, Helm 3 (přešli jsme poměrně bolestivě z Helmu 2, ale jsme velmi rádi za tuto možnost atomic), Jenkins, Ansible a Docker. Máme rádi feature branches a nasazení do různých prostředí z jednoho repozitáře.
Záver
Takto, v obecných rysech, v společnosti DomClick vypadá proces DevOps z pohledu provozního inženýra. Článek se ukázal být méně technický, než jsem očekával: proto sledujte novinky DomClick na Habré: budou drsnější články o Kubernetes a nejen o něm.
Zdroj: habr.com
