

Keď prichádzate k produktu, ktorý sa vyvíja viac ako desať rokov, nie je prekvapujúce, že v ňom nájdete zastarané technológie. Ale čo ak o pol roka budete musieť udržiavať záťaž desaťkrát vyššiu a cena výpadkov vzrastie stonásobne? V takom prípade potrebujete skvelého Highload inžiniera. Ale bez neho mi problém zverili do rúk. V prvej časti článku opíšem, ako sme prechádzali z Redis na Redis-cluster, a v druhej časti dám rady, ako začať používať cluster a na čo sa zamerať pri jeho prevádzke.
Výber technológie
Je tak zlý samostatný Redis (standalone redis) v konfigurácii 1 master a N slave? Prečo ho nazývam zastaranou technológiou?
Nie, Redis nie je tak zlý... Avšak, existujú niektoré nedostatky, ktoré nemožno ignorovať.
Po prvé, Redis nepodporuje mechanizmy pre obnovu po páde mastera. Na riešenie tohto problému sme použili konfiguráciu s automatickým prenášaním VIP na nového mastera, zmenou úlohy jedného zo slave a prepínaním ostatných. Tento mechanizmus fungoval, ale nazvať ho spoľahlivým riešením sa nedalo. Po prvé, dochádzalo k falošným poplachom, a po druhé, bol jednorazový a po aktivácii boli potrebné manuálne kroky na obnovenie.
Po druhé, existencia iba jedného mastera viedla k problému s shardovaním. Museli sme vytvoriť niekoľko nezávislých clustrov „1 master a N slave“, potom ručne rozložiť databázy po týchto strojoch a dúfať, že zajtra sa jedna z databáz nepreplní natoľko, že ju bude potrebné presunúť na samostatný inštanc.
Aké sú možnosti?
- Najdrahšie a najbohatšie riešenie — Redis-Enterprise. Toto je krabicové riešenie s plnou technickou podporou. Napriek tomu, že sa to z technického hľadiska zdá byť ideálne, z ideologických dôvodov nám to nevyhovovalo.
- Redis-cluster. Z krabice je k dispozícii podpora pre automatické prepínanie mastera a shardovanie. Rozhranie sa takmer nelíši od bežnej verzie. Vyzerá nádejne, o úskaliach sa porozprávame ďalej.
- Tarantool, Memcache, Aerospike a iné. Všetky tieto nástroje robia zhruba to isté. Každý z nich má však svoje nevýhody. Rozhodli sme sa nedávať všetky vajíčka do jedného košíka. Memcache a Tarantool používame na iné úlohy a, aby som to predbehol, poviem, že v našej praxi s nimi bolo viac problémov.
Špecifikácia použitia
Pozrime sa, aké úlohy sme historicky riešili pomocou Redis a akú funkcionalitu sme využívali:
- Cache pred požiadavkami na vzdialené služby ako 2GIS | Golang
GET SET MGET MSET "VYBER DB"
- Cache pred MYSQL | PHP
GET SET MGET MSET SCAN "KĽÚČ PODĽA VZORCA" "VYBER DB"
- Hlavné úložisko pre službu správy relácií a koordinátov vodičov | Golang
GET SET MGET MSET "VYBER DB" "PRIDAŤ GEO KĽÚČ" "ZÍSKAŤ GEO KĽÚČ" SCAN
Ako vidíte, žiadna vyššia matematika. V čom teda spočíva zložitosti? Rozoberme to osobitne pri každej metóde.
Metóda
Popis
Zvláštnosti Redis-clustra
Riešenie
GET SET
Zapísať/čítať kľúč
MGET MSET
Zapísať/čítať niekoľko kľúčov
Kľúče budú ležať na rôznych uzloch. Hotové knižnice dokážu robiť Multi-operácie len v rámci jedného uzla
Nahradiť MGET za pipeline z N GET operácií
VYBER DB
Vybrať databázu, s ktorou budeme pracovať
Nepodporuje niekoľko databáz
Ukladať všetko do jednej databázy. Pridať kľúčom prefixy
SCAN
Prejsť všetkými kľúčmi v databáze
Keďže máme jednu databázu, prechádzať všetkými kľúčmi v clustre je príliš náročné
Udržiavať invariant v rámci jedného kľúča a robiť HSCAN podľa tohto kľúča. Alebo sa úplne vzdať
GEO
Operácie práce s geokľúčom
Geokľúč nie je šardovaný
KĽÚČ PODĽA VZORCA
Hľadanie kľúča podľa vzoru
Keďže máme jednu databázu, budeme hľadať podľa všetkých kľúčov v clustre. Príliš náročné
Vzdávať sa alebo udržiavať invariant, ako pri SCAN-e
Redis vs Redis-cluster
Čo strácame a čo získavame pri prechode na klaster?
- Nevýhody: strácame funkčnosť niekoľkých databáz.
- Ak chceme ukladať v jednom klastri logicky nesúvisiace dáta, budeme musieť robiť obskurné riešenia vo forme prefixov.
- Strácame všetky operácie 'podľa databázy', ako SCAN, DBSIZE, CLEAR DB atď.
- Multi-operácie sa stali oveľa zložitejšími na implementáciu, pretože môže byť potrebné sprístupniť niekoľko uzlov.
- Výhody:
- Odolnosť voči chybám vo forme havarijného prepínania primárneho uzla.
- Šardovanie na strane Redis.
- Prenos dát medzi uzlami atomicky a bez prestojov.
- Pridanie a pre-rozdelenie kapacít a záťaží bez prestojov.
Urobil by som záver, že ak nepotrebujete zabezpečiť vysokú úroveň odolnosti voči zlyhaniu, presun na klaster za to nestojí, pretože to môže byť nezanedbateľná úloha. Ale ak by ste mali na výber medzi samostatnou verziou a klastrom, mali by ste si vybrať klaster, pretože nie je horší a navyše vám uľahčí časť starostí.
Príprava na presun
Začneme s požiadavkami na presun:
- Musí byť bezproblémový. Úplné zastavenie služby na 5 minút nás neuspokojí.
- Musí byť čo najbezpečnejší a postupný. Chceme mať určitú kontrolu nad situáciou. Hromadne presunúť všetko a modliť sa za tlačidlo na návrat nechceme.
- Minimálne straty dát pri presune. Rozumieme, že presunúť atomárne bude veľmi ťažké, preto pripúšťame určitú desynchronizáciu medzi dátami v bežnom a klastrovom Redis.
Údržba klasteru
Pred samotným presunom by ste sa mali zamyslieť nad tým, či môžeme udržiavať klaster:
- Grafy. Používame Prometheus a Grafana na grafy zaťaženia procesorov, používanú pamäť, počet klientov, počet operácií GET, SET, AUTH a pod.
- Odbornosť. Predstavte si, že zajtra bude pod vašou zodpovednosťou obrovský klaster. Ak sa pokazí, nikto okrem vás ho nebude môcť opraviť. Ak začne spomaľovať – všetci sa obrátia na vás. Ak bude potrebné pridať zdroje alebo prekonať zaťaženie – opäť na vás. Aby ste sa v 25. roku nezapratali, je dobré predvídať tieto prípady a vopred skontrolovať, ako sa technológia zachová pri rôznych akciách. O tom si podrobnejšie povieme v sekcii "Odbornosť".
- Monitorovanie a oznámenia. Keď sa klaster pokazí, chceš sa o tom dozvedieť ako prvý. Tu sme sa obmedzili na informovanie o tom, že všetky uzly vracajú rovnaké informácie o stave klasteru (áno, môže to byť aj inak). A ostatné problémy rýchlejšie zistíte prostredníctvom oznámení služieb-klientov Redis.
Presun
Ako budeme prechádzať:
- Najprv je potrebné pripraviť knižnicu na prácu s klastrom. Ako základ pre verziu v Gо sme zobrali go-redis a trochu si ho upravili. Implementovali sme Multi-metódy cez pipeline-y, ako aj trochu upravili pravidlá opakovania požiadaviek. S verziou pre PHP sme mali viac problémov, ale nakoniec sme sa rozhodli pre php-redis. Nedávno zaviedli podporu klastru a podľa nášho názoru vyzerá dobre.
- Ďalej je potrebné rozbehnúť samotný klaster. Robí sa to doslova v dvoch príkazoch na základe konfiguračného súboru. Podrobnejšie nastavenie prediskutujeme nižšie.
- Pre postupný prechod používame dry-mode. Keďže máme dve verzie knižnice s rovnakým rozhraním (jednu pre bežnú verziu, druhú pre klaster), nie je nič jednoduchšie, ako vytvoriť obal, ktorý bude pracovať s jednotlivou verziou a zároveň duplikovať všetky požiadavky do klastera, porovnávať odpovede a zapisovať rozdiely do logov (v našom prípade do NewRelic). Týmto spôsobom, aj keď pri nasadení klastrová verzia zlyhá, náš produkčný systém to neovplyvní.
- Keď nasadíme klaster v dry-režime, môžeme pokojne sledovať graf rozdielov odpovedí. Ak podiel chýb pomaly, ale isto smeruje k nejakej malej konštante, znamená to, že je všetko v poriadku. Prečo sú stále rozdiely? Pretože zápis v jednotlivých verziách prebieha niekoľko skôr ako v klasteri, a vďaka mikrozáznamu sa môžu dáta rozchádzať. Ostáva len pozrieť sa na logy rozdielov, a ak sú všetky vysvetliteľné neatomárnosťou zápisu, môžeme ísť ďalej.
- Teraz môžeme prepnúť dry-mode na opačnú stranu. Zapisovať a čítať budeme z klastera, a duplikovať do jednotlivých verzií. Prečo? V priebehu nasledujúceho týždňa chceme sledovať prácu klastera. Ak sa náhodou ukáže, že v špičke zaťaženia sú problémy, alebo sme niečo nepredpokladali, vždy máme možnosť núdzového návratu ku starému kódu a aktuálnym dátam vďaka dry-mode.
- Ostáva len vypnúť dry-mode a demontovať jednotlivú verziu.
Expertíza
Najprv stručne o zariadení klastera.
Najprv, Redis je key-value úložisko. Ako kľúč sa používajú ľubovoľné reťazce. Ako hodnoty môžu byť použité čísla, reťazce a celé štruktúry. Týchto je nespočetne veľa, ale pre pochopenie celkového zariadenia nám to nie je dôležité.
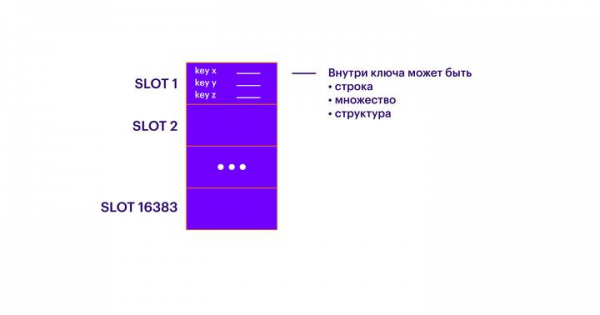
Nasledujúca úroveň abstrakcie po kľúčoch sú sloty (SLOTS). Každý kľúč patrí jednému z 16 383 slotov. V rámci každého slotu môže byť ľubovoľný počet kľúčov. Takto sa všetky kľúče rozdeľujú na 16 383 neprenikanových množín.
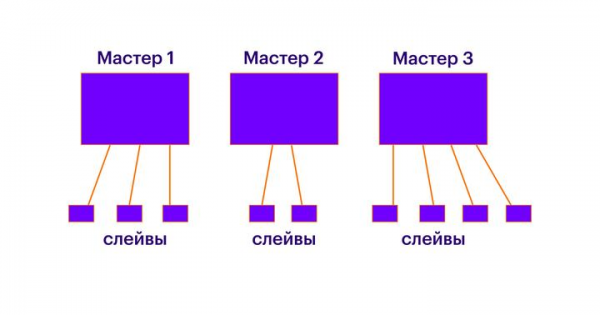
Ďalej by v klastri malo byť N hlavné uzly. Každý uzol je možné predstaviť ako samostatný inštanciu Redis, ktorý vie všetko o ostatných uzloch v klastri. Každý hlavný uzol obsahuje určité množstvo slotov. Každý slot patrí iba jednému hlavnému uzlu. Všetky sloty treba prerozdeľovať medzi uzly. Ak niektoré sloty nie sú prerozdelené, kľúče, ktoré obsahujú, budú nedostupné. Každý hlavný uzol je zmysluplné spustiť na samostatnom logickom alebo fyzickom stroji. Taktiež stojí za to pamätať, že každý uzol pracuje iba na jednom jadre, a ak chcete spustiť niekoľko inštancií Redis na jednom logickom stroji, uistite sa, že budú bežať na rôznych jadrách (toto sme neskúšali, ale teoreticky by to malo fungovať). V podstate hlavné uzly zabezpečujú bežné shardovanie a väčší počet hlavných uzlov umožňuje škálovanie zápisových a čítacích požiadaviek.
Po tom, čo sú všetky kľúče rozdelené podľa slotov a sloty rozmiestnené medzi hlavné uzly, k každému hlavnému uzlu je možné pridať ľubovoľný počet slave uzlov. V rámci každej takej dvojice "hlavný-slave" bude fungovať bežná replikácia. Slave sú potrebné na škálovanie čítacích požiadaviek a na núdzové prepnutie v prípade zlyhania hlavného uzla.
Teraz sa poďme rozprávať o operáciách, ktoré by sme mali vedieť vykonávať.
Na systém sa budeme obracať cez Redis-CLI. Keďže Redis nemá jediné vstupné miesto, nasledujúce operácie je možné vykonať na ktoromkoľvek z uzlov. V každom bode osobitne upozorňujem na možnosť vykonania operácie pod zaťažením.
- Prvé a najdôležitejšie, čo budeme potrebovať: operácia cluster nodes. Táto operácia vracia stav klastra, zobrazuje zoznam uzlov, ich úlohy, prerozdelenie slotov a pod. Ďalšie informácie je možné získať pomocou cluster info a cluster slots.
- Bolo by dobré vedieť pridávať a odstraňovať nody. Na to sú operácie cluster meet a cluster forget. Upozorňujem, že cluster forget je potrebné aplikovať na KAŽDÚ nodu, či už na majstrov, alebo na repliky. Cluster meet stačí vyvolať len na jednej node. Toto rozlíšenie môže zneisťovať, preto je lepšie sa o ňom dozvedieť predtým, ako uvediete cluster do prevádzky. Pridanie nody sa bezpečne vykonáva v prevádzke a nijako neovplyvňuje fungovanie clusteru (čo je logické). Ak však plánujete odstrániť nodu z clusteru, mali by ste sa uistiť, že na nej nezostali sloty (inak riskujete stratu prístupu ku všetkým kľúčom na tejto nodu). Tiež neodstraňujte majstra, ktorý má slave, inak sa bude vykonávať zbytočné hlasovanie za nového majstra. Ak na nodách už nie sú sloty, tak to nie je veľký problém, ale načo si pridávať zbytočné voľby, keď môžeme najprv odstrániť slaves.
- Ak je potrebné násilne vymeniť miesta majstra a slava, hodí sa príkaz cluster failover. Pri jeho vyvolaní v prevádzke je potrebné chápať, že počas vykonávania operácie bude majster nedostupný. Zvyčajne prechod trvá menej než sekundu, ale nie je atomárny. Môžete počítať s tým, že časť požiadaviek na majstra v tuto dobu skončí chybou.
- Pred odstránením uzla z klastru by na ňom nemali zostať žiadne sloty. Je lepšie ich presunúť pomocou príkazu cluster reshard. Sloty budú presunuté z jedného mastera na iný. Celá operácia môže trvať niekoľko minút, v závislosti od množstva prenášaných údajov, avšak proces presunu je bezpečný a nijako neovplyvňuje fungovanie klastru. Týmto spôsobom je možné preniesť všetky údaje z jedného uzla na druhý priamo pod záťažou, bez obavy o ich dostupnosť. Existujú však aj nuansy. Po prvé, presun údajov je spojený s určitou záťažou na uzle prijímajúcom a odosielajúcom. Ak je uzol prijímajúci už silne zaťažený procesorom, nemalo by sa ho ešte viac zaťažovať prijímaním nových údajov. Po druhé, akonáhle na odosielajúcom masterovi nezostane ani jeden slot, všetci jeho slave okamžite prejdú k masterovi, na ktorý boli tieto sloty presunuté. Problém spočíva v tom, že všetci títo slave sa naraz pokúsia synchronizovať údaje. A ešte budete mať šťastie, ak to bude čiastočná, a nie úplná synchronizácia. Zohľadnite to a skombinujte operácie presunu slotov a odpojenia/presunu slave. Alebo sa spoliehajte na to, že máte dostatočné rezervy.
- Čo robiť, ak počas presunu zistíte, že ste niekde stratili sloty? Dúfam, že sa vás tento problém nedotkne, ale ak áno, existuje operácia cluster fix. Táto operácia rozloží sloty po uzloch náhodne. Odporúčam skontrolovať jej fungovanie po predchádzajúcom odstránení uzla s rozdelenými slotmi z klastru. Keďže údaje v nerozdelených slotoch sú už tak či tak nedostupné, obávať sa problémov s dostupnosťou týchto slotov je už neskoro. Na rozdelené sloty operácia nemá vplyv.
- Ďalšia užitočná operácia je monitor. Umožňuje v reálnom čase vidieť celý zoznam požiadaviek, ktoré prichádzajú na uzol. Navyše, na základe nej môžete vykonať grep a zistiť, či existuje potrebný prenos.
Je potrebné spomenúť aj proces núdzového preklapania master uzla. Stručne povedané, existuje a podľa môjho názoru funguje skvele. Avšak netreba si myslieť, že ak vytrhnete kábel zo zástrčky na stroji s master uzlom, Redis okamžite preklopí a klienti si nevšimnú stratu. Z mojej praxe preklápanie trvá niekoľko sekúnd. Počas tohto času bude časť dát nedostupná: zistí sa nedostupnosť mastera, uzly volia nového, slave uzly preklopí, dáta sa synchronizujú. Najlepší spôsob, ako sa presvedčiť, že schéma funguje, je uskutočniť lokálne cvičenia. Zriaďte si klaster na svojom notebooku, zaťažte ho minimálne, simulujte pád (napríklad zablokovaním portov), ohodnoťte rýchlosť preklapania. Podľa mňa len po takomto hraní jeden alebo dva dni si môžete byť istí funkciou technológie. Alebo sa spoľahnúť, že softvér, ktorý používa polovica internetu, určite funguje.
Konfigurácia
Často je konfigurácia prvé, čo je potrebné na začiatok práce s nástrojom. A keď už všetko funguje, nechce sa nám dotýkať nastavení. Je potrebné vynaložiť určité úsilie, aby ste sa donútili vrátiť sa k nastaveniam a starostlivo ich prejsť. Z mojej pamäte sme mali aspoň dva vážne výpadky kvôli nepozornosti k konfigurácii. Venovať osobitnú pozornosť nasledujúcim bodom:
- timeout 0
Čas, po ktorom sa uzatvárajú neaktívne pripojenia (v sekundách). 0 — neuzatvárajú sa.
Nie každá naša knižnica vedela správne uzatvárať pripojenia. Ak túto nastavenie vypneme, riskujeme, že narazíme na limit počtu klientov. Na druhej strane, ak takýto problém existuje, automatické prerušenie stratených pripojení ho zamaskuje a možno si ho nevšimneme. Okrem toho, nie je vhodné zapínať toto nastavenie pri použití persist pripojení. - Save x y & appendonly yes
Uloženie RDB snímky.
Problémy RDB/AOF podrobne preberieme nižšie. - stop-writes-on-bgsave-error no & slave-serve-stale-data yes
Ak je to zapnuté, pri poruche RDB snímky master prestane prijímať požiadavky na zmeny. Ak je pripojenie s masterom prerušené, slave môže pokračovať v odpovedaní na požiadavky (áno). Alebo prestane odpovedať (nie).
Nie sme spokojní so situáciou, keď sa Redis zmení na tekvicu. - repl-ping-slave-period 5
Po uplynutí tohto času začneme mať obavy, že master zlyhal a je čas na vykonanie failoveru.
Bude potrebné ručne nájsť rovnováhu medzi falošnými spúšťacími signálmi a vykonávaním failoveru. Našou praxou je to 5 sekúnd. - repl-backlog-size 1024mb & epl-backlog-ttl 0
Presne toľko dát môžeme uchovávať v vyrovnávacej pamäti pre odpojenú replikáciu. Ak sa vyrovnávacia pamäť naplní, bude potrebné kompletné synchronizovanie.
Praxe ukazuje, že je lepšie nastaviť väčšiu hodnotu. Dôvodov, prečo môže replikácia začať zaostávať, je veľa. Ak zaostáva, vaše hlavné zariadenie má pravdepodobne problémy, a úplná synchronizácia sa stane poslednou kvapkou. - maxclients 10000
Maximálny počet súčasných klientov.
Našou skúsenosťou je, že je lepšie nastaviť väčšiu hodnotu. Redis sa výborne vyrovnáva s 10 tisícami pripojení. Len sa uistite, že má systém dostatok zásuviek. - maxmemory-policy volatile-ttl
Pravidlo, podľa ktorého sa vymazávajú kľúče pri dosiahnutí limitu dostupnej pamäte.
Dôležité nie je len pravidlo, ale aj pochopenie, ako to bude prebiehať. Redis možno pochváliť za schopnosť plynulo fungovať pri dosiahnutí limitu pamäte.
Problémy RDB a AOF
Hoci Redis uchováva všetky informácie v operačnej pamäti, existuje aj mechanizmus na ukladanie dát na disk. Presnejšie povedané, tri mechanizmy:
- RDB-snapshot — kompletný obraz všetkých dát. Nastavuje sa pomocou konfigurácie SAVE X Y a číta sa ako „Uchovávať kompletný snapshot všetkých dát každých X sekúnd, ak sa zmenil aspoň Y kľúčov.“
- Append-only file — zoznam operácií v poradí ich vykonávania. Pridáva nové prichádzajúce operácie do súboru každých X sekúnd alebo každých Y operácií.
- RDB a AOF — kombinácia dvoch predchádzajúcich.
Každá metóda má svoje výhody a nevýhody, nebudem ich všetky vymenúvať, len upozorním na niektoré menej zjavné, podľa mňa dôležité aspekty.
Po prvé, pre uloženie RDB-snapshotu je potrebné spustiť FORK. Ak je údajov veľa, môže to spôsobit zamrznutie celého Redis na obdobie od niekoľkých milisekúnd až po sekundu. Okrem toho, systému je potrebné prideliť pamäť na taký snapshot, čo vedie k potrebe udržať na logickej mašine dvojité zásoby operačnej pamäte: ak je pre Redis pridelených 8 GB, na virtuálnom stroji s ním by malo byť k dispozícii 16.
Po druhé, existujú problémy s čiastočnou synchronizáciou. V režime AOF pri opätovnom pripojení slave namiesto čiastočnej synchronizácie môže prebiehať plná. Prečo sa to deje, som nepochopil. Ale je dobré na to pamätať.
Tieto dva body už nútia zamyslieť sa nad tým, či sú nám tieto dáta na disku naozaj potrebné, ak sú už aj tak všetky duplikované slave-mi. Stratiť dáta môžeme len pri zlyhaní všetkých slave-ov, a to je problém na úrovni 'požiar v DDC'. Ako kompromis môžeme navrhnúť uchovávanie dát len na slave-och, ale v takom prípade musíme zabezpečiť, aby nikdy nezískali status master pri havarijnom obnovení (pre to existuje nastavenie priorít slave-ov v ich konfigurácii). V každom konkrétnom prípade zvažujeme, či uchovávať dáta na disku, a väčšinou odpovedáme 'nie'.
Záver
Na záver by som rád dúfal, že som dokázal poskytnúť všeobecnú predstavu o fungovaní redis-cluster-a tým, ktorí o ňom úplne nepočuli, a tiež som upozornil na niektoré menej zjavné body pre tých, ktorí ho už dávno používajú.
Ďakujem za váš čas a, ako obvykle, komentáre na tému sú vítané.
Zdroj: habr.com
