

– O, žiadne útočisko neprežije zásah meteoritu. Ale ako každý, aj vy máte rezervu, takže sa nemusíte obávať.
Stanislav Lem, „Hviezdne denníky Ijona Tichého“
Zálohovanie znamená uchovanie kópie údajov niekde mimo hlavného miesta ich uloženia.
Hlavným cieľom zálohovania je obnovenie údajov po ich strate. V súvislosti s tým sa často počuje, že pri existencii repliky databázy je možné vždy obnoviť údaje z nej, a zálohovanie nie je potrebné. V skutočnosti však zálohovanie umožňuje vyriešiť minimálne tri úlohy, ktoré nie je možné vyriešiť pomocou repliky, a replikáciu bez zálohy nie je možné inicializovať.
Po prvé, záloh sa môže využiť na obnovenie údajov po logickej chybe. Napríklad, ak účtovník odstráni skupinu transakcií, alebo administrátor DB zničí tabuľkový priestor. Obe operácie sú z pohľadu databázy úplne legitímne a proces replikácie ich reprodukuje v repre databáze.
Po druhé, moderné SÚDB sú veľmi spoľahlivé softvérové systémy, avšak občas môže dôjsť k poškodeniu vnútorných štruktúr databázy, po ktorom dôjde k strate prístupu k údajom. Čo je obzvlášť zúfalé, toto porušenie sa zvyčajne deje pri vysokom zaťažení alebo pri inštalácii nejakého updatu. Ale ako vysoké zaťaženie, tak pravidelné aktualizácie naznačujú, že databáza rozhodne nie je testovacia a údaje, ktoré sú v nej uložené, sú cenné.
Napokon, tretia úloha, ktorú je možné vyriešiť iba so zálohou, je klonovanie databázy, napríklad na účely testovania.
Zálohovanie databáz sa vo svojej podstate zakladá na jednom z dvoch princípov:
- Výber údajov s následným ukladaním v ľubovoľnom formáte;
- Snapshot stavu súborov DB a uchovávanie logov.
Poďme sa pozrieť na tieto princípy a na nástroje, ktoré ich realizujú, podrobnejšie.
Export dát
V súbore utilít, ktoré sú priložené k akejkoľvek SÚDB, musia byť nevyhnutne nástroje na export a import údajov. Údaje sa ukladajú buď v textovom formáte, alebo v binárnom formáte špecifickom pre konkrétnu SÚDB. V nasledujúcej tabuľke je uvedený zoznam týchto nástrojov:
Binárny formát
Textový formát
Oracle
DataPump Export/DataPump Import
Export/import
SQL*Plus/SQL*Loader
PostgreSQL
pg_dump, pg_dumpall/pg_restore
pg_dump, pg_dumpall/psql
Microsoft SQL Server
bcp
bcp
DB2
unload/load
unload/load
MySQL
mysqldump, mysqlpump/mysql, mysqlimport
Kľúč-hodnota, grafový*
mongodump/mongorestore
mongoexport/mongoimport
Cassandra
nodetool snapshot/sstableloader
cqlsh
Textový formát je dobrý tým, že ho možno upravovať alebo dokonca vytvárať externými programami, zatiaľ čo binárny formát je dobrý tým, že umožňuje rýchlejšie vypúšťať a načítať dáta z dôvodu úspory zdrojov na transformáciu formátov.
Napriek jednoduchosti a zrejmosti myšlienky vypúšťania dát sa tento spôsob pre zálohovanie zaťažených priemyselných databáz zriedka používa. Tu sú dôvody, prečo vypúšťanie nie je vhodné pre poriadne zálohovanie:
- vypúšťanie vykonáva významnú záťaž na systém zdroja;
- vypúšťanie trvá veľa času – do konca procesu sa stane už neaktuálnym;
- uskutočniť konzistentné vypúšťanie celej databázy pri vysokej záťaži je prakticky nemožné, pretože DBMS musí uchovávať snímku svojho stavu v čase začiatku vypúšťania. Čím viac transakcií sa vykoná od okamihu začiatku vypúšťania, tým väčší objem snímky (neaktuálnych kópií dát v PostgreSQL, undo priestoru v Oracle, tempdb v Microsoft SQL Server, a pod.);
- vypúšťanie zachováva logickú štruktúru dát, ale nezachováva ich fyzickú štruktúru – parametre fyzického ukladania tabuliek, indexy a pod.
Napriek tomu má vypúšťanie aj výhody:
- vysoká selektivita: možno vypustiť jednotlivé tabuľky, jednotlivé polia a dokonca jednotlivé riadky;
- vypustené dáta môžu byť načítané do databázy inej verzie, a ak je vypúšťanie vykonané v textovom formáte, aj do inej databázy.
Takže sa vypúšťanie používa najmä pre také úlohy ako zálohovanie malých tabuliek (napríklad referenčných) alebo šírenie súborov s ďalšou verziou aplikácie.
Najbežnejšou metódou zálohovania databáz je kopírovanie súborov databázy.
„Studené“ ukladanie súborov DB
Zrejmá myšlienka – zastaviť databázu a skopírovať všetky jej súbory. Takáto záloha sa nazýva „studená“. Tento spôsob je extrémne spoľahlivý a jednoduchý, ale má dva zjavné nedostatky:
- Z "studených" záloh je možné obnoviť len také stavy databázy, aké existovali v momente zastavenia; transakcie vykonané po reštarte databázy sa do "studenej" zálohy nedostanú.
- Ďaleko nie každá databáza má technologické okno, kedy ju je možné zastaviť.
Ak vám "studene" zálohovanie vyhovuje, treba pamätať na to, že
- "studená" kópia by občas mala obsahovať aj denníky. Metódy určovania, ktoré denníky by mali byť v "studené" kópii, sú individuálne pre každú DBMS. Napríklad v Oracle je potrebné skopírovať takzvané online redo, teda fixovaný počet súborov denníka v špeciálnom adresári, a to aj vtedy, keď je databáza zastavená správne. V PostgreSQL je potrebné uložiť všetky denníky počnúc tým, ktorý obsahuje posledný bod kontrolu, informácie o ktorom sú obsiahnuté v ovládacom súbore.
- adresár databázy môže obsahovať dosť veľké súbory dočasných tabuliek, ktoré nie je nutné zahrnúť do zálohy. Mimochodom, táto poznámka platí aj pre "horúce" zálohovanie.
"Horúce" uloženie súborov
Väčšina záloh moderných databáz sa vykonáva kopírovaním súborov databázy bez zastavenia databázy. Tu sa objavuje niekoľko problémov:
- V momente začatia kopírovania obsah databázy nemusí súhlasiť s obsahom súborov, pretože časť informácií je v cache a ešte nebola zapísaná na disk.
- Počas kopírovania sa môže obsah databázy meniť. Ak sa používajú modifikovateľné štruktúry dát, mení sa obsah súborov, a pri používaní nemodifikovateľných štruktúr sa mení súborový súbor: objavujú sa nové súbory a staré sa odstraňujú.
- Keďže zápis dát do databázy a čítanie súborov DB nie sú nijako synchronizované, program na zálohovanie môže prečítať nekorektnú stránku, kde polovica bude z starej verzie stránky a druhá polovica – z novej.
Aby bola záloha koherentná, pre každú DBMS existuje príkaz, ktorý oznamuje, že bol zahájený proces zálohovania. Syntax tohto príkazu sa môže líšiť:
- v Oracle je to samostatný príkaz ALTER DATABASE/TABLESPACE BEGIN BACKUP;
- v PostgreSQL – funkcia pg_start_backup();
- Príprava na zálohovanie v Microsoft SQL Server a DB2 sa vykonáva implicitne počas vykonávania príkazu BACKUP DATABASE;
- V MySQL Enterprise, Cassandre a MongoDB sa príprava vykonáva implicitne externým nástrojom – mysqlbackup, OpsCenter a Ops Manager, resp.
Napriek syntaktickým rozdielom sa proces prípravy na zálohovanie javí ako rovnaký.
Takto vyzerá príprava na zálohovanie v DBMS s meniteľnými diskovými štruktúrami, teda vo všetkých tradičných diskových relačných systémoch:
- Uložení okamihu začiatku zálohovania; záloha by mala obsahovať záznamy databázy od tohto okamihu.
- Vykonáva sa kontrolný bod, teda všetky zmeny, ktoré nastali na stránkach dát pred zapamätneným okamihom, sa zapisujú na disk. To zaručuje, že záznamy pred začiatkom zálohovania nebudú pri obnove potrebné.
- Zahájenie špeciálneho režimu protokolovania: ak sa stránka dát zmenila prvýkrát po načítaní z disku, namiesto toho, aby zaznamenávala zmenu stránky do protokolu, databáza tam zaznamená celú stránku. Pri vykonávaní prípravnej procedúry sa všetky stránky zapisujú na disk, a preto pri prvom zmene sa blok vždy zaznamená do protokolu v celosti. Ak však počas zálohovania bude stránka znovu zapísaná na disk, nasledujúca zmena opäť spôsobí, že v protokole sa objaví kompletná kópia stránky. To zaručuje, že ak sa náhodou pri kopírovaní súboru s dátami stránka stane neplatnou, aplikácia protokolu ju opäť urobí platnou.
- Zablokuje sa zmena hlavičiek súborov dát, teda tej časti, ktorej zmeny nie sú zaznamenané v protokoloch. To zaručuje, že hlavička bude skopírovaná správne, a potom k súboru dát správne budú aplikované protokoly.
Po vykonaní všetkých vyššie uvedených postupov je možné kopírovať súbory údajov pomocou operačného systému – cp, rsync a ďalších. Aktivácia režimu zálohovania znižuje výkon databázy: po prvé, zvyšuje sa objem protokolov, a po druhé, ak dôjde k poruche v režime zálohovania, obnova bude dlhšia, pretože hlavičky súborov údajov sa neaktualizujú. Čím rýchlejšie sa zálohovanie dokončí, tým lepšie pre databázu, preto je tu vhodné použiť prostriedky ako snímok (snapshot) súborového systému alebo oddelenie zrkadla (BCV) v diskovom poli. Niektoré DBMS (Oracle, PostgreSQL) poskytujú administrátorovi možnosť samostatne si vybrať spôsob kopírovania, iné (Microsoft SQL Server) ponúkajú rozhranie na integráciu vlastných zálohovacích utilít s mechanizmami súborových systémov alebo úložných systémov.
Po dokončení zálohovania je potrebné prepnúť databázu späť do normálneho stavu. V Oracle sa to robí príkazom ALTER DATABASE/TABLESPACE END BACKUP, v PostgreSQL volaním funkcie pg_stop_backup(), a v iných databázach pomocou vnútorných podprogramov príslušných príkazov alebo externých služieb.
Takto vyzerá časová schéma procesu zálohovania:
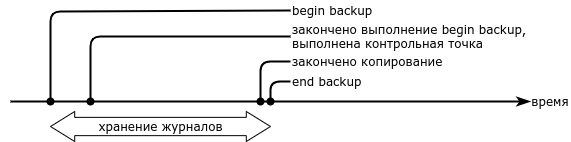
- Príprava na zálohovanie (begin backup) trvá čas, niekedy značný. Aj keď sa používajú zrkadlové zväzky alebo súborové systémy s možnosťou vytvárania snímok, proces zálohovania nebude okamžitý.
- Spolu so súbormi údajov je potrebné uchovať protokoly od okamihu začatia prípravy na zálohovanie až po okamih, keď sa databáza vráti do normálneho stavu.
- Z tejto zálohy je možné sa obnoviť v momente, keď sa databáza vrátila do normálneho stavu. Obnovenie na skôr neexistuje.
So zálohami databáz, ktoré používajú nemenné štruktúry dát (snímky pamäte, LSM-stromy), je situácia jednoduchšia. Príprava na zálohovanie pozostáva z nasledujúcich krokov:
- Údaje z pamäte sa presúvajú na disk.
- Zaznamenáva sa zoznam súborov, ktoré sa dostanú do zálohy. Až do dokončenia procesu zálohovania je databáze zakázané odstrániť tieto súbory, aj keď sa stanú nepotrebnými.
Po signále o ukončení zálohovania môže databáza s nemennými štruktúrami opäť odstraňovať nepotrebné súbory.
Obnovenie do bodu
Záloha umožňuje obnoviť stav databázy v momente, keď sa ukončila príkaz na návrat z režimu zálohovania. Avšak havária, po ktorej bude potrebné obnovenie, môže nastať kedykoľvek. Úlohou obnovenia stavu databázy do ľubovoľného okamihu sa nazýva „obnovenie do bodu“ (point-in-time recovery).
Aby bola táto možnosť zabezpečená, je potrebné uchovávať záznamy databázy od momentu ukončenia zálohovania a v priebehu obnovenia pokračovať v aplikovaní záznamov na obnovenú kópiu. Po tom, ako bola databáza obnovená zo zálohy v čase ukončenia kopírovania, je stav databázy (súborov a cacheovaných stránok) zaručene správny, takže nie je potrebný žiadny špeciálny režim zaznamenávania. Aplikovaním záznamov do potrebného momentu môžeme získať stav databázy v akomkoľvek čase.
Ak je rýchlosť obnovenia zálohy obmedzená iba priepustnosťou disku, rýchlosť aplikovania záznamov je zvyčajne obmedzená výkonom procesora. Ak sa v hlavnej databáze zmeny dejú paralelne, pri obnovení sa všetky zmeny vykonávajú postupne – v poradí čítania zo záznamu. Tým pádom je čas obnovenia lineárne závislý od toho, ako ďaleko je bod obnovenia od bodu ukončenia zálohovania. Z tohto dôvodu je potrebné pomerne často robiť úplné zálohy – minimálne raz za týždeň pre databázy s malou transakčnou záťažou a až po dennú zálohu pre vysoko zaťažené databázy.
Inkrementálne zálohovanie
Aby sme urýchlili obnovenie do bodu, bolo by dobré mať možnosť vykonávať zálohovanie čo najčastejšie, ale zároveň nezapĺňať nadbytočne miesto na diskoch a nezaťažovať databázu úlohami zálohovania.
Riešením problému je inkrementálne zálohovanie, teda kopírovanie iba tých strán dát, ktoré sa zmenili od posledného zálohovania.
Inkrementálne zálohovanie má zmysel len pre SÚDB, ktoré používajú meniteľné štruktúry údajov.
Inkrement sa môže odčítať buď od úplnej zálohy (kumulatívna záloha), alebo od akejkoľvek predchádzejúcej kópie (diferenciálna kópia).
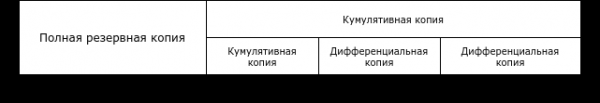
Bohužiaľ, neexistuje jednotná terminológia a rôzni výrobcovia používajú rôzne termíny:
Diferenciálna
Kumulatívna
Oracle
Differential
Cumulative
PostgresPro
Incremental
—
Microsoft SQL Server
—
Differential
IBM DB2
Delta
Incremental
Pri existencii inkrementálnych kópií vyzerá proces obnovovania do bodu nasledovne:
- obnovuje sa posledná úplná záloha, vykonaná pred momentom obnovy;
- na úplnú kópiu sa obnovujú inkrementálne kópie;
- aplikujú sa protokoly od bodu začiatku zálohovania do bodu obnovy.
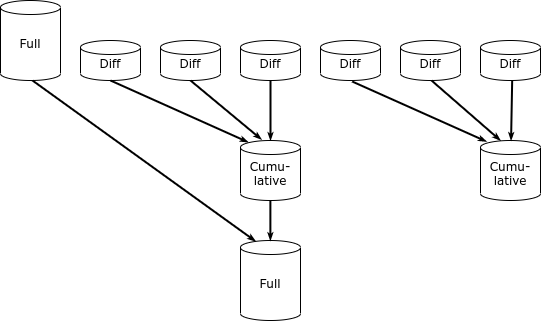
Existencia kumulatívnej kópie urýchľuje proces obnovenia. Napríklad na obnovenie stavu databázy do bodu medzi T3 a T4 je potrebné obnoviť dve inkrementálne kópie, a na obnovenie do bodu po T4 – len jednu.
Je zrejmé, že objem jednej kumulatívnej kópie je menší ako objem niekoľkých diferenciálnych kópií, pretože niektoré stránky sa menili niekoľkokrát a každá inkrementálna kópia obsahuje svoju verziu stránky.
Existujú tri spôsoby vytvárania inkrementálnej kópie:
- vytvorenie úplnej kópie a výpočet rozdielu s predchádzajúcou úplnou kópiou;
- analýza protokolov, vytvorenie zoznamu zmenených stránok a zálohovanie stránok zahrnutých v zozname;
- žiadať o zmenené stránky v databáze.
Prvý spôsob šetrí diskový priestor, ale nerieši úlohu zníženia záťaže na databáze. Navyše, ak máme úplnú zálohu, previesť ju na inkrementálnu je nesmyselné, pretože obnova úplnej kópie je rýchlejšia ako obnova predchádzajúcej úplnej kópie a inkrementu. Úlohu šetrenia diskového priestoru pri takomto prístupe je lepšie preniesť na špeciálne komponenty so zabudovanými mechanizmami deduplikácie. Môžu to byť špeciálne úložiská (EMC DataDomain, HPE StorageWorks VLS, celá línia NetApp) alebo softvérové produkty (ZFS, Veritas NetBackup PureFile, Deduplikácia údajov Windows Server).
Druhý a tretí spôsob sa líšia mechanizmom určovania zoznamu zmenených stránok. Analýza protokolov je náročnejšia na zdroje a zároveň na jej realizáciu je potrebné poznať štruktúru protokolových súborov. Najjednoduchšie je opýtať sa samotnej databázy, ktoré stránky sa zmenili, ale na to musí mať jadro DBMS funkčnosť sledovania zmenených blokov (block change tracking).
Funkcionalita inkrementálneho zálohovania bola prvýkrát vytvorená v softvéri Oracle Recovery Manager (RMAN), ktorý sa objavil v releas Oracle 8i. Oracle ihneď implementoval sledovanie zmenených blokov, takže nie je potrebné analyzovať protokoly.
PostgreSQL nesleduje zmenené bloky, takže nástroj pg_probackup, vyvinutý ruskou spoločnosťou Postgres Professional, určuje zmenené stránky prostredníctvom analýzy protokolu. Avšak spoločnosť dodáva aj DBMS PostgresPro, ktorý zahŕňa rozšírenie ptrack, sledujúce zmeny stránok. Pri používaní pg_probackup s DBMS PostgresPro nástroj žiada o zmenené stránky priamo od databázy – presne tak, ako RMAN.
Microsoft SQL Server, rovnako ako Oracle, sleduje zmenené stránky, ale príkaz BACKUP umožňuje vykonávať iba úplné a kumulatívne zálohy.
V DB2 je možnosť sledovania zmenených stránok, ale predvolene je táto funkcia vypnutá. Po jej zapnutí bude DB2 umožňovať vykonávať úplné, diferencované a kumulatívne zálohy.
Dôležité je, že popísané prostriedky (okrem pg_probackup) sa od súborových prostriedkov zálohovania líšia tým, že žiadajú obrázky stránok od databázy, a nie čítajú dáta z disku samostatne. Nevýhodou tohto prístupu je mierne dodatočné zaťaženie databázy. Avšak túto nevýhodu viac než vyváži fakt, že prečítaná stránka je vždy správna, a preto nie je potrebné aktivovať počas zálohovania špeciálny režim zaznamenávania.
Ešte raz si všimnite, že existencia inkrementálnych záloh neodstráňuje požiadavky na prítomnosť protokolov na obnovenie do ľubovoľného bodu v čase. Preto sa v priemyselných databázach protokoly neustále prepisujú na externý nosič, zatiaľ čo zálohy, úplné a/alebo inkrementálne, sa vytvárajú podľa rozvrhu.
Najlepšia realizácia myšlienky inkrementálneho zálohovania je programovo-hardware komplex (v terminológii Oracle – engineered system) Zero Data Loss Recovery Appliance – špecializované riešenie Oracle pre zálohovanie vlastnej DB. Komplex predstavuje klaster serverov s veľkým objemom diskov, na ktoré je nainštalovaná modifikovaná verzia softvéru Recovery Manager a môže pracovať ako s inými programovo-hardware komplexmi Oracle (Database Appliance, Exadata, SPARC Supercluster), tak aj s databázami Oracle na tradičnej infraštruktúre. Na rozdiel od „bežného“ RMAN, v ZDLRA je implementovaná koncepcia „večného inkrementu“ (incremental forever). Systém jednorazovo vytvorí úplnú kópiu databázy a potom robí iba inkrementálne kópie. Dodatočné moduly RMAN umožňujú spájať kópie a vytvárať nové úplné kópie z inkrementálnych.
Na počesť ruských vývojárov treba poznamenať, že aj pg_probackup dokáže spájať inkrementálne kópie.
Na rozdiel od mnohých podobných otázok, otázka „ktorá metóda zálohovania je najlepšia“ má jednoznačnú odpoveď – najlepšie je natívny nástroj pre použitý DBMS, ktorý zabezpečuje možnosť inkrementálneho zálohovania.
Pre administrátora DB sú oveľa dôležitejšie otázky výberu stratégie zálohovania a integrácia prostriedkov zálohovania databáz do firemnej infraštruktúry. Ale tieto otázky presahujú rámec tohto článku.
Zdroj: habr.com
