

Prejdeme na koncept monitorovania Kubernetes, oboznámime sa s nástrojom Prometheus a porozprávame sa o alertingu.
Téma monitorovania je rozsiahla, v rámci jedného článku ju nemožno prebrať. Cieľom tohto textu je poskytnúť prehľadné zameranie na nástroje, koncepty a prístupy.
Materiál článku — výťah z . Ak sa chcete podrobiť úplnému vzdelaniu — prihláste sa na kurz o .
Čo sa monitoruje v Kubernetes clase
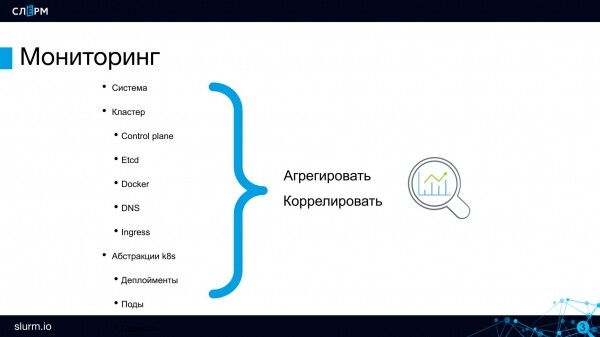
Fyzické servery. Ak je Kubernetes cluster nasadený na vlastných serveroch, je potrebné sledovať ich stav. S týmto úkonom si poradil Zabbix; ak s ním pracujete, nemusíte sa vzdať, konflikty nenastanú. O stave našich serverov sa stará práve Zabbix.
Prejdime k monitorovaniu na úrovni clustra.
Komponenty Control Plane: API, Scheduler a ďalšie. Minimálne je potrebné sledovať, aby servery API alebo etcd boli viac ako 0. Etcd dokáže poskytovať množstvo metrik: o diskoch, na ktorých beží, o zdraví svojho clustra etcd a ďalších.
Docker existuje už dávno a o jeho problémoch je všetkým dobre známe: množstvo kontajnerov spôsobuje zamieňania a iné problémy. Preto by sme sami Docker, ako systém, mali tiež kontrolovať, aspoň na dostupnosť.
DNS. Ak v clustre vypadne DNS, vypadne aj celý servis Discovery, prestanú fungovať požiadavky medzi podmi. V mojej praxi sa podobným problémom nestretol, avšak to neznamená, že o stave DNS nie je potrebné sledovať. Oneskania v požiadavkách a niektoré iné metriky je možné sledovať na CoreDNS.
Ingress. Je potrebné monitorovať dostupnosť ingressov (vrátane Ingress Controller) ako vstupných bodov do projektu.
Hlavné komponenty clustra sme prebrali — teraz sa ponoríme nižšie, na úroveň abstrakcií.
Na prvý pohľad sa zdá, že aplikácie bežia v podoch, čo znamená, že by sa mali monitorovať, ale v skutočnosti to nie je pravda. Pody sú efemérne: dnes bežia na jednom serveri, zajtra na inom; dnes ich je 10, zajtra 2. Preto len pody nikto nemonitoruje. V rámci mikroslužbovej architektúry je dôležitejšie kontrolovať dostupnosť aplikácie ako celku. Najmä overovať dostupnosť endpointov služby: funguje niečo? Ak je aplikácia dostupná, tak čo sa deje za ňou, koľko je teraz replik — to sú otázky druhej úrovne. Sledovať jednotlivé inštancie nie je potrebné.
Na poslednej úrovni je potrebné monitorovať fungovanie samotnej aplikácie, zaznamenávať podnikové metriky: počet objednávok, správanie používateľov a ďalšie.
Prometheus
Najlepším systémom na monitorovanie klastru je . Neviem o žiadnom nástroji, ktorý by sa mohol porovnať s Prometheus, pokiaľ ide o kvalitu a pohodlie. Skvele sa hodí na flexibilnú infraštruktúru, preto keď sa povie „monitorovanie Kubernetes“, väčšinou sa myslí práve na Prometheus.
Existujú dva spôsoby, ako začať pracovať s Prometheus: pomocou Helm môžete nainštalovať bežný Prometheus alebo Prometheus Operator.
- Bežný Prometheus. S ním je všetko v poriadku, ale je potrebné nastavovať ConfigMap — v podstate písať textové konfiguračné súbory, ako sme to robili predtým, pred mikroslužobnou architektúrou.
- Prometheus Operator je trochu zložitější, ale práca s ním je jednoduchšia: existujú samostatné objekty, abstrakcie sa pridávajú do klastru, takže je ich oveľa pohodlnejšie kontrolovať a nastavovať.
Aby ste sa oboznámili s produktom, odporúčam najprv nainštalovať bežný Prometheus. Budete musieť všetko nastaviť cez konfiguračný súbor, ale to vám prospeje: zorientujete sa, čo k čomu patrí a ako sa nastavuje. V Prometheus Operator sa hneď dostanete na vyššiu úroveň abstrakcie, aj keď sa chcete ponoriť do hlbín, tak vám to bude možné.
Prometheus je dobre integrovaný s Kubernetes: môže sa obracať na API Server a vzájomne s ním interagovať.
Prometheus je populárny, preto ho podporuje množstvo aplikácií a programovacích jazykov. Podpora je potrebná, pretože Prometheus má svoj vlastný formát metrík a na jeho prenos je potrebná buď knižnica v aplikácii, alebo hotový exportér. A takých exportérov je dosť. Napríklad existuje PostgreSQL Exporter: berie dáta z PostgreSQL a konvertuje ich do formátu Prometheus, aby s nimi mohol Prometheus pracovať.
Architektúra Prometheus
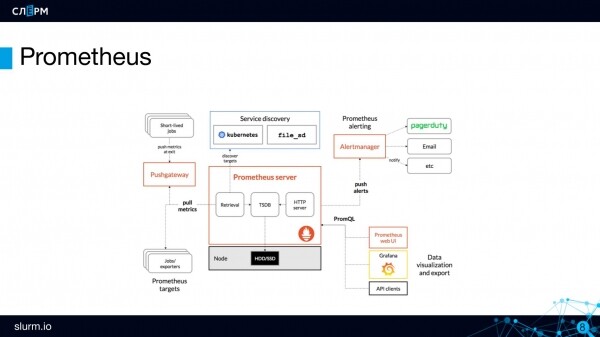
Prometheus Server — to je serverová časť, mozog Prometheus. Tu sa uchovávajú a spracovávajú metriky.
Metriky uchováva time series database (TSDB). TSDB nie je samostatná databáza, ale balík v jazyku Go, ktorý je zabudovaný v Prometheus. Hlavne, všetko sa nachádza v jednom binárnom súbore.
Nehrajte si s dátami v TSDB dlho
Infrastruktúra Prometheus nie je vhodná na dlhodobé uchovávanie metrík. Predvolená doba uchovávania je 15 dní. Toto obmedzenie je možné prekročiť, ale je potrebné mať na pamäti: čím viac dát budete uchovávať v TSDB a čím dlhšie to budete robiť, tým viac zdrojov bude spotrebúvať. Uchovávanie historických dát v Prometheus sa považuje za zlú prax.
Ak máte obrovský prenos, počet metrík sa počíta na stovky tisíc za sekundu, je lepšie obmedziť ich uchovávanie podľa objemu disku alebo podľa času. Zvyčajne sa v TSDB uchovávajú "horúce dáta", metriky doslova za niekoľko hodín. Pre dlhodobé uchovávanie sa používajú externé úložiská v databázach, ktoré sú na to naozaj vhodné, napríklad InfluxDB, ClickHouse a tak ďalej. Viac dobrých recenzií som videl na ClickHouse.
Prometheus Server funguje na modeli pull: sám sa chodí po metriky do tých endpointov, ktoré sme mu poskytli. Povedali sme: „chod do API Server“, a on tam raz za n-krát sekúnd ide a berie metriky.
Pre objekty s krátkou životnosťou (job alebo cron job), ktoré sa môžu objaviť medzi obdobiami skenovania, existuje komponent Pushgateway. Do neho sa posielajú metriky od krátkodobých objektov: job sa spustil, vykonal akciu, poslal metriky do Pushgateway a skončil. O chvíľu Prometheus vo svojom rytme príde a zoberie tieto metriky z Pushgateway.
Na nastavenie upozornení v Prometheus existuje samostatný komponent — Alertmanager. A pravidlá upozornení — alerting rules. Napríklad, je potrebné vytvoriť alert v prípade, ak sú API servery 0. Keď sa udalosť spustí, alert sa odovzdáva do alert managera na ďalšie odoslanie. V alert manageri sú dostatočne flexibilné nastavenia routovania: jednu skupinu alertov je možné odoslať do Telegramu adminov, inú do chatu vývojárov, tretiu do chatu infraštruktúry. Oznámenia môžu prichádzať do Slacku, Telegramu, na email a do iných kanálov.
A nakoniec poviem o killer-funkcii Prometheus — Discovering. Pri práci s Prometheus nie je potrebné uvádzať konkrétne adresy objektov na monitorovanie, stačí zadať ich typ. To znamená, že nemusíte písať „tu je IP adresa, tu je port — monitoruj“, namiesto toho musíte určiť, akými princípmi nachádzať tieto objekty (targets — ciele). Prometheus sám, v závislosti od toho, aké objekty sú teraz aktívne, vytiahne potrebné a pridá ich na monitorovanie.
Takýto prístup dobre zapadá do štruktúry Kubernetes, kde sa tiež všetko mení: dnes 10 serverov, zajtra 3. Aby ste každého raz neudávali IP adresu servera, napíšete raz, ako ho nájsť — a Discovering to bude robiť.
Jazyk Prometheus sa nazýva PromQL. S pomocou tohto jazyka môžete získať hodnoty konkrétnych metrík a potom ich transformovať, stavať na nich analytické výstupy.
https://prometheus.io/docs/prometheus/latest/querying/basics/

Jednoduchý dotaz

    container_memory_usage_bytes

Matematické operácie

    container_memory_usage_bytes / 1024 / 1024

Vstavané funkcie

    sum(container_memory_usage_bytes) / 1024 / 1024

Upresnenie dotazu

    100 - avg by (instance) (rate(node_cpu_seconds_total{mode="idle"}[5m]) * 100)
Webové rozhranie Prometheus
Prometheus má svoje, pomerne minimalistické webové rozhranie. Vhodné len na debugging alebo demonštráciu.
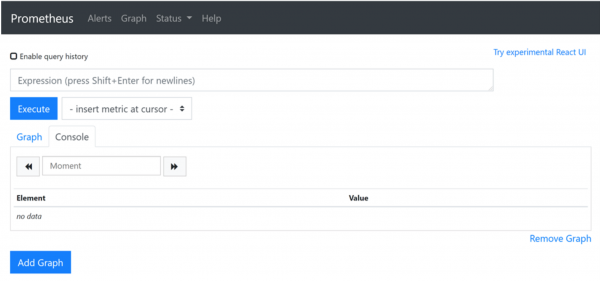
V riadku Expression môžete písať dotaz v jazyku PromQL.
Na karte Alerts sú pravidlá pre alerty — alerting rules, a tie majú tri statusy:
- inactive — ak je alert momentálne neaktívny, to znamená, že je všetko v poriadku a nevyžaduje zásah;
- pending — to je v prípade, ak alert spustil, ale zaslanie ešte neprebehlo. oneskorenie sa nastavuje na kompenzáciu blikajúcich sietí: ak sa služba počas minúty obnovila, alarm hlásiť nie je potrebné;
- firing — to je tretí status, keď alert sa rozsvieti a posiela správy.
V menu Status nájdete prístup k informáciám o tom, čo vlastne Prometheus predstavuje. Tam je tiež prechod na ciele (targets), o ktorých sme hovorili vyššie.
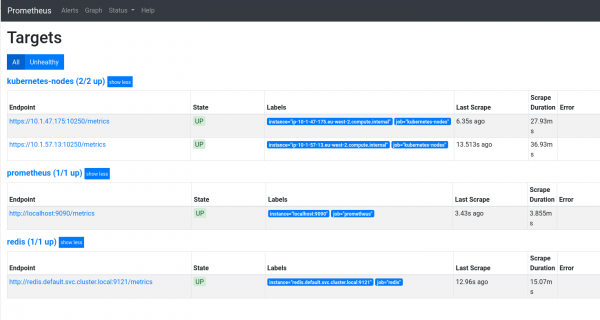
Podrobnejší prehľad rozhrania Prometheus nájdete .
Integrácia s Grafana
Vo webovom rozhraní Prometheus nenájdete pekné a prehľadné grafy, z ktorých by bolo možné urobiť závery o stave klastru. Aby ich bolo možné vytvárať, Prometheus sa integruje s Grafana. Vznikajú takto takéto dashboardy.
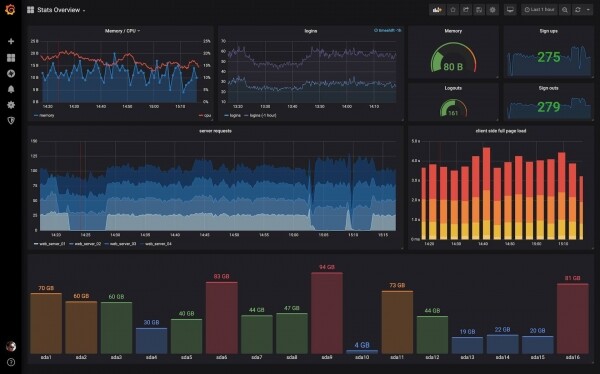
Nastaviť integráciu Prometheus a Grafana nie je vôbec ťažké, inštrukcie nájdete v dokumentácii: , no a týmto skončím.
V nasledujúcich článkoch budeme pokračovať v téme monitorovania: porozprávame o zbieraní a analýze logov pomocou Grafana Loki a alternatívnych nástrojov.
Autor: Marcel Ibraev, certifikovaný administrátor Kubernetes, praktikující inženýr ve společnosti , rečník a vývojár kurzov Slyrm.
Zdroj: habr.com
