

Úvod
Pred niekoľkými mesiacmi sa mi naskytla úloha vyvinúť vysoko dostupný klaster pre , ktorý funguje v niekoľkých dátových centrách prepojených optickým vláknom v rámci jedného mesta a odoláva poruche (napríklad výpadku energie) jedného dátového centra. Ako softvér, ktorý zaisťuje vysokú dostupnosť, som zvolil , pretože je to oficiálne riešenie od RedHat pre vytváranie vysoko dostupných klastrov. Je dobré tým, že RedHat zabezpečuje jeho podporu a že ide o univerzálne (modulárne) riešenie. S jeho pomocou bude možné zabezpečiť vysokú dostupnosť nielen pre PostgreSQL, ale aj pre iné služby, buď použitím štandardných modulov, alebo vytvorením vlastných podľa konkrétnych potrieb.
K tomuto riešeniu sa objavila oprávnená otázka: aká vysoká bude dostupnosť vysoko dostupného klastru? Na preskúmanie tejto témy som vytvoril testovací systém, ktorý imituje rôzne poruchy na uzloch klastru, očakáva obnovenie funkčnosti, obnovuje nefunkčný uzol a pokračuje v testovaní v cykle. Pôvodne sa tento projekt volal hapgsql, ale časom ma omrzelo toto meno, v ktorom bola len jedna samohláska. Preto som začal nazývať vysoko dostupné databázy (a float IP, ktoré na ne odkazujú) krogan (postava z počítačovej hry, ktorá má všetky dôležité orgány duplikované), a uzly, klastry a samotný projekt – tuchanka (planéta, kde žijú krogania).
Teraz vedenie povolilo . README bude čoskoro preložené do angličtiny (pretože sa očakáva, že hlavnými používateľmi budú vývojári Pacemaker a PostgreSQL), a starú ruskú verziu README som sa rozhodol upraviť (čiastočne) vo forme tohto článku.
Klastre sa nasadzujú na virtuálnych strojoch . Celkovo bude nasadených 12 virtuálnych strojov (spolu 36GiB), ktoré vytvoria 4 vysoko dostupné klastry (rôzne varianty). Prvé dva klastry pozostávajú z dvoch serverov PostgreSQL, ktoré sú umiestnené v rôznych dátových centrách, a spoločného servera witness c quorum device (umiestnené na lacnom virtuálnom stroji v treťom dátovom centre), ktorý rozuzlí nejasnosť 50%/50%, dávajúc svoj hlas jednej zo strán. Tretí klaster je v troch dátových centrách: jeden master, dva slave, bez quorum device. Štvrtý cluster pozostáva zo štyroch serverov PostgreSQL, po dva na dátové centrum: jeden je hlavný, ostatné sú repliky, a tiež používa witness c quorum device. Štvrtý zvláda výpadok dvoch serverov alebo jedného dátového centra. Toto riešenie môže byť, ak je to potrebné, rozšírené na väčší počet replik.
Služba presného času tiež je prekonfigurovaná na vysokú dostupnosť, pričom sa používa metóda ntpd (orphan mode). Spoločný server witness zohráva úlohu centrálny NTP server, poskytujúc svoj čas všetkým clusterom, čím synchronizuje všetky servery medzi sebou. Ak witness vypadne alebo bude izolovaný, začne svoj čas poskytovať jeden zo serverov klastrov (v rámci klastru). Pomocný vyrovnávací HTTP proxy taktiež je spustený na witness, s jeho pomocou majú ostatné virtuálne stroje prístup k Yum-repozitárom. V skutočnosti budú takéto služby, ako presný čas a proxy, určite hostené na vyhradených serveroch, zatiaľ čo v stánku sú hostené na witness len kvôli úspore počtu virtuálnych strojov a miesta.
Verzie
v0. Funguje s CentOS 7 a PostgreSQL 11 na VirtualBox 6.1.
Štruktúra klastrov
Všetky clustre sú určené na umiestnenie v niekoľkých dátových centrách, sú prepojené do jednej plochej siete a musia odolávať výpadku alebo sieťovej izolácii jedného dátového centra. Preto nedá vykonať použiť na ochranu pred split-brain štandardnú technológiu Pacemaker, ktorá sa nazýva STONITH (Shoot The Other Node In The Head) alebo fencing. Jej podstata: ak uzly v klastri začnú podozrievať, že s niektorou uzlom sa deje niečo zlé, nenapája sa alebo sa správa nesprávne, tak ho nútene odpoja cez „externé“ zariadenia, ako napríklad riadiacu kartu IPMI alebo UPS. Ale toto funguje len v prípadoch, keď pri jednotkovom výpadku servera IPMI alebo UPS naďalej fungujú. Tu sa plánuje ochrana pred oveľa katastrofickejším výpadkom, keď zlyhá (napr. je odpojené od napájania) celé dátové centrum. A pri takomto výpadku všetky stonith-zariadenia (IPMI, UPS atď.) tiež nebudú fungovať.
Namiesto toho v základnom systéme leží myšlienka kvóra. Všetky uzly majú hlas a môžu pracovať len tie, ktoré vidia viac ako polovicu všetkých uzlov. Tento počet „polovica+1“ sa nazýva kvórum. Ak sa kvórum nenazbiera, uzol sa rozhodne, že sa nachádza v sieťovej izolácii a musí odpojiť svoje zdroje, t.j. to je taká ochrana proti split-brain. Ak softvér, ktorý zodpovedá za takéto správanie, nefunguje, mal by sa aktivovať watchdog, napríklad na báze IPMI.
Ak je počet uzlov párny (klaster v dvoch dátových centrách), môže vzniknúť takzvaná neurčitosť 50%/50% (fifty-fifty), kedy sieťová izolácia rozdelí klaster presne napoly. Preto sa pre párny počet uzlov pridáva quorum device — nenáročný démon, ktorý môže byť spustený na najlacnejšej virtuálke v treťom dátovom centre. Dáva svoj hlas jednému z segmentov (ktorý vidí), čím odstraňuje neurčitosť 50%/50%. Server, na ktorom bude spustené quorum device, som nazval witness (terminológia z repmgr, páčila sa mi).
Zdroje môžu presúvať svoje umiestnenie, napríklad z nefunkčných serverov na funkčné, alebo na príkaz systémových administrátorov. Aby klienti vedeli, kde sa nachádzajú potrebné zdroje (kam sa pripojiť?), používajú sa plávajúce IP (float IP). To sú IP, ktoré môže Pacemaker presúvať medzi uzlami (všetko je v plochej sieti). Každý z nich symbolizuje zdroj (službu) a bude sa nachádzať tam, kam je potrebné pripojiť sa, aby sa získal prístup k tejto službe (v našom prípade DB).
Tuchanka1 (schéma s utesnením)
Struktura
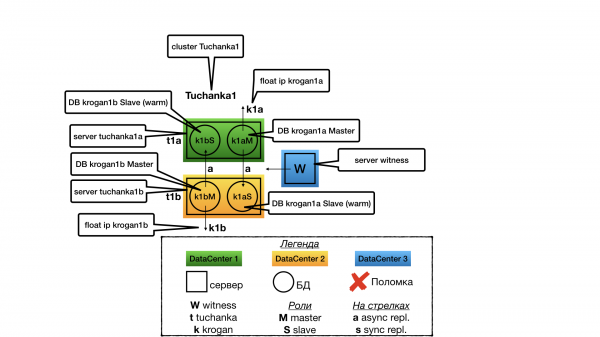
Myšlienka bola v tom, že máme mnoho drobných databáz s nízkym zaťažením, pre ktoré nie je výhodné udržiavať vyhradený slave-server v režime hot standby pre read only transakcie (nie je potrebné takto zbytočne míňať zdroje).
V každom dátovom centre je jeden server. Na každom serveri sú dve inštancie PostgreSQL (v terminológii PostgreSQL sa volajú klastre, ale aby sa predišlo zmätku, budem ich nazývať inštanciami (podobne ako iné DB) a klastrami budem nazývať iba klastre Pacemaker). Jeden inštancia funguje v režime majstra a len ona poskytuje služby (iba na ňu vedie float IP). Druhá inštancia funguje ako otrok pre druhé dátové centrum a bude poskytovať služby iba v prípade, že jej majster zlyhá. Keďže väčšinu času poskytuje služby (vykonáva dotazy) iba jedna inštancia z dvoch (majster), všetky prostriedky servera sú optimalizované pre majstra (vyčlenená pamäť pre cache shared_buffers atď.), ale tak, aby aj druhá inštancia mala dostatok prostriedkov (nech aj na suboptimálnu prácu cez cache súborového systému) v prípade zlyhania jedného z dátových centier. Otrok neposkytuje služby (nevykonáva read only dotazy) za normálnej prevádzky klastru, aby nedošlo k boju o prostriedky s majstrom na tej istej mašine.
V prípade dvoch uzlov je vysoká dostupnosť možná iba pri asynchrónnej replikácii, pretože pri synchronizovanej replikácii zlyhanie otroka vedie k zastaveniu majstra.
Zlyhanie witness
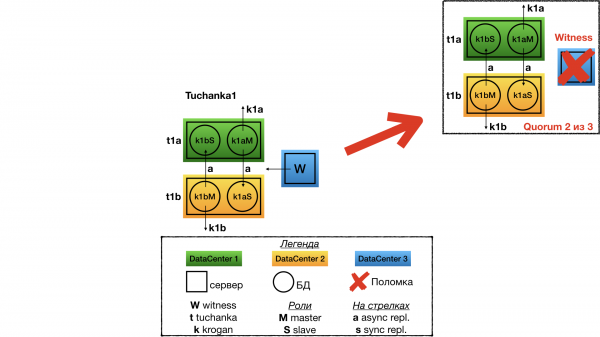
Zlyhanie witness (quorum device) sa budem zaoberať iba pre klaster Tuchanka1, so všetkými ostatnými bude rovnaký príbeh. Pri zlyhaní witness v štruktúre klastru sa nič nezmení, všetko bude aj naďalej fungovať tak, ako fungovalo. Ale kvórum sa stane rovné 2 z 3, a preto akékoľvek nasledujúce zlyhanie bude fatálne pre klaster. A tak či tak bude nutné okamžite opraviť.
Zlyhanie Tuchanka1
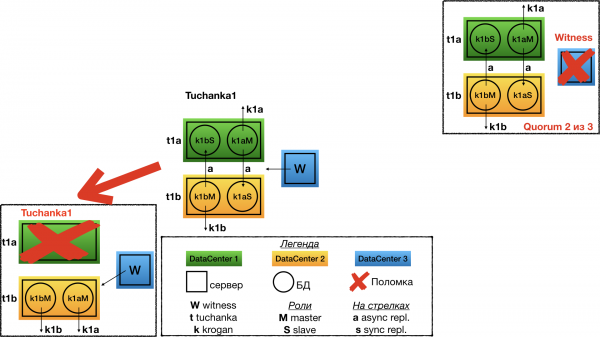
Zlyhanie jedného z dátových centier pre Tuchanka1. V tomto prípade witness odovzdáva svoj hlas druhému uzlu na druhom dátovom centre. Tam sa bývalý otrok premení na majstra, výsledkom čoho na jednom serveri pracujú obaja majstri a na nich smerujú oba ich float IP.
Tuchanka2 (klasické)
Struktura
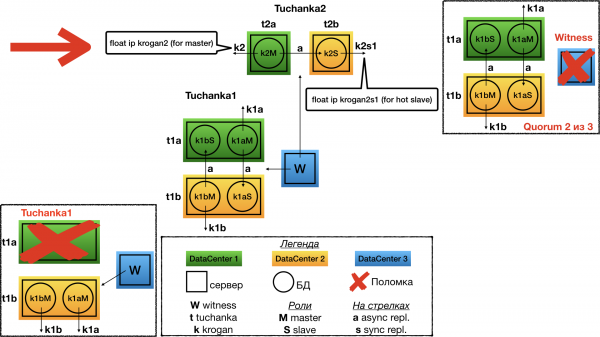
Klasické schéma z dvoch uzlov. Na jednom beží majster, na druhom otrok. Obaja môžu vykonávať dotazy (otrok iba read only), preto na oboch smerujú float IP: krogan2 — na majstra, krogan2s1 — na otroka. Vysoká dostupnosť bude aj u majstra, aj u otroka.
V prípade dvoch uzlov je vysoká dostupnosť možná iba pri asynchrónnej replikácii, pretože pri synchronizovanej replikácii zlyhanie otroka vedie k zastaveniu majstra.
Zlyhanie Tuchanka2
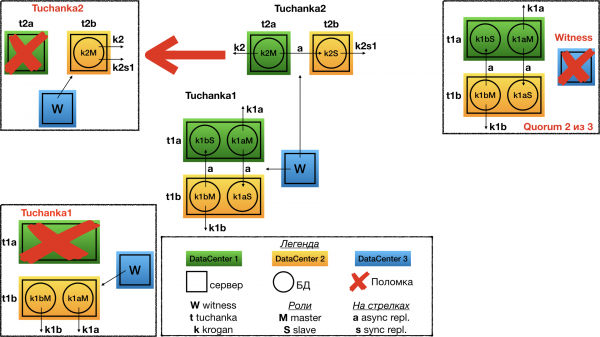
Pri zlyhaní jedného z dátových centier witness hlasuje za druhý. Na jedinom fungujúcom dátovom centre bude spustený master a naň budú ukazovať oba float IP: master a slave. Samozrejme, inštancia musí byť nastavená tak, aby mala dostatok zdrojov (limitov na pripojenia atď.) na to, aby súčasne akceptovala všetky pripojenia a požiadavky od master a slave float IP. To znamená, že pri bežnej prevádzke by mala mať dostatočnú rezervu po limitoch.
Tuchanka4 (veľa slave)
Struktura
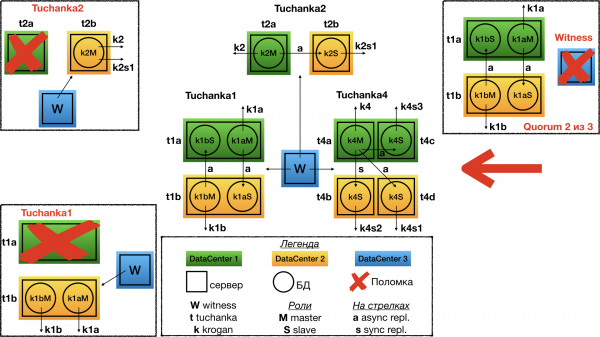
Už iný extrém. Existujú DB, na ktoré prichádza veľmi veľa požiadaviek read-only (typický prípad vysoce zaťaženej stránky). Tuchanka4 — to je situácia, keď môže byť troch alebo viac slave na spracovanie takýchto požiadaviek, ale predsa len nie príliš veľa. Pri veľmi vysokom počte slave bude potrebné vymýšľať hierarchický systém replikácie. V minimálnom prípade (na obrázku) sa v každom z dvoch dátových centier nachádzajú po dva servery, na ktorých beží jedna inštancia PostgreSQL.
Ďalšou zvláštnosťou tohto schémy je, že tu už je možné usporiadať jednu synchronnú replikáciu. Je nastavená tak, aby replikovala, ak je to možné, do iného dátového centra, a nie na replikát v tej istej dátovej centrále, kde je aj master. Na master a na každého slave ukazuje float IP. V skutočnosti by medzi slave potrebná vyváženosť požiadaviek prostredníctvom nejakého sql proxy, napríklad na strane klienta. Rôznemu typu klientov môže byť potrebný rôzny typ sql proxy, a len vývojári klientov vedia, ktorým typom potrebujú. Táto funkčnosť môže byť realizovaná buď externým démonom, alebo knižnicou klienta (connection pool) atď. Všetko toto presahuje rámec témy odolného klastrového DB (odolnosť SQL proxy je možné realizovať nezávisle, súčasne s odolnosťou klienta).
Porucha Tuchanka4
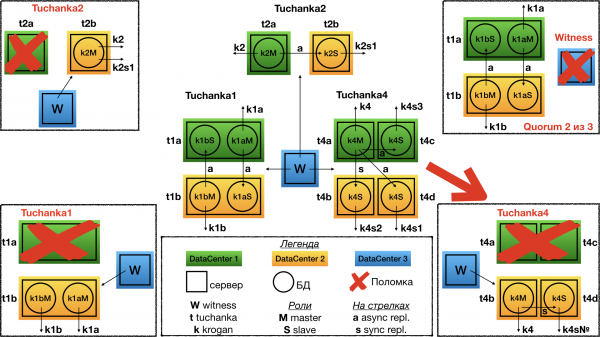
Pri poruche jedného dátového centra (t.j. dvoch serverov) witness hlasuje za druhý. V dôsledku toho v druhom dátovom centre pracujú dva servery: na jednom beží master a naň ukazuje master float IP (na prijímanie read-write požiadaviek); a na druhom serveri pracuje slave so synchronnou replikáciou a naň ukazuje jeden zo slave float IP (na read only požiadavky).
Prvá vec, ktorú treba poznamenať: pracovným slave float IP nebude všetko, ale iba jeden. A pre správnu funkčnosť s ním bude potrebné, aby sql proxy presmeroval všetky požiadavky na jediný zostávajúci float IP; a ak nie, sql proxy môžete v URL na pripojenie uviesť všetky float IP slave oddelené čiarkou. V takom prípade s libpq pripojenie bude na prvý pracovný IP, ako je to nastavené v automatizovanom testovaní. Možno, že v iných knižniciach, ako napríklad JDBC, to tak fungovať nebude a je potrebné sql proxy. Je to tak preto, že float IP pre slave majú zakázané súčasne sa zvyšovať na jednom serveri, aby sa rovnomerne rozdeľovali medzi slave servery v prípade, že ich pracuje niekoľko.
Druhé: aj v prípade zlyhania dátového centra zostane zachovaná synchronná replikácia. A aj keď dôjde k sekundárnemu zlyhaniu, t.j. v zostávajúcom dátovom centre zlyhá jeden z dvoch serverov, klaster síce prestane poskytovať služby, ale stále si uchová informácie o všetkých potvrdených transakciách, ku ktorým dal potvrdenie o commite (nedôjde k strate informácií pri sekundárnom zlyhaní).
Tuchanka3 (3 dátové centrá)
Struktura
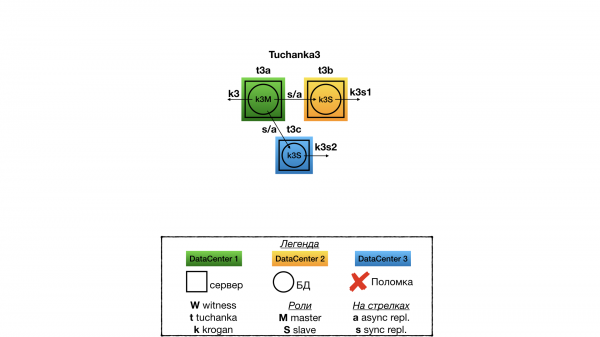
Toto je klaster pre situáciu, keď sú tri plne funkčné dátové centrá, v ktorých každý obsahuje plne funkčný databázový server. V tomto prípade quorum device nie je potrebný. V jednom dátovom centre funguje master, v dvoch ostatných — slaves. Replikácia je synchronná, typu ANY (slave1, slave2), čo znamená, že klient dostane potvrdenie o commite, keď ktorýkoľvek z slave odpovie ako prvý, že prijal commit. Na zdroje ukazuje jeden float IP pre mastera a dva pre slaves. Na rozdiel od Tuchanka4 sú všetky tri float IP odolné voči zlyhaniu. Pre vyvažovanie SQL požiadaviek len na čítanie môžete použiť sql proxy (s oddelenou odolnosťou voči zlyhaniu), alebo polovici klientov priradiť jeden slave float IP a druhej polovici — druhý.
Zlyhanie Tuchanka3
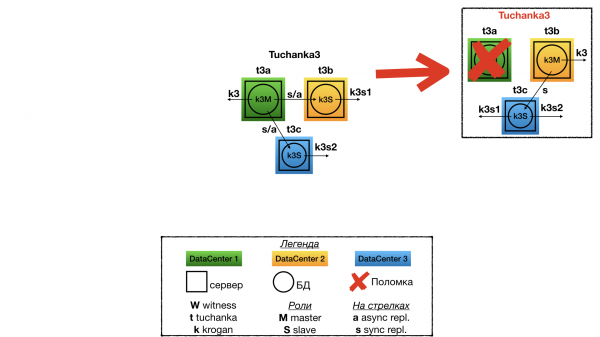
Pri zlyhaní jedného z dátových centier zostanú dve. V jednom je spustený master a float IP od mastera, vo druhom — slave a oba slave float IP (na inštancii by mal byť zdvojený zásobník zdrojov, aby prijal všetky pripojenia z oboch slave float IP). Medzi masterom a slave je synchronná replikácia. Klaster tiež uchová informácie o potvrdených a schválených transakciách (nedôjde k strate informácií) v prípade zničenia dvoch dátových centier (ak nie sú zničené súčasne).
Podrobné opisy súborovej štruktúry a nasadenia som sa rozhodol neuvádzať. Kto chce experimentovať, môže si všetko prečítať v README. Pripájame len popis automatizovaného testovania.
Systém automatizovaného testovania
Na overenie odolnosti klastrov s imitáciou rôznych porúch bol vytvorený systém automatizovaného testovania. Spúšťa sa skriptom test/failure. Skript môže prijímať ako parametre čísla klastrov, ktoré sa majú testovať. Napríklad tento príkaz:
test/failure 2 3bude testovať len druhý a tretí klaster. Ak nie sú parametre zadané, testovať sa budú všetky klastre. Všetky klastre sa testujú paralelne a výsledok sa zobrazuje v paneli tmux. Tmux používa vyhradený tmux server, takže skript je možné spúšťať z defaultného tmux, vytvorí sa vnorený tmux. Odporúčam používať terminál v veľkom okne a s malým písmom. Pred začiatkom testovania sa všetky virtuálne stroje vrátia späť na snapshot v momente ukončenia skriptu. setup.
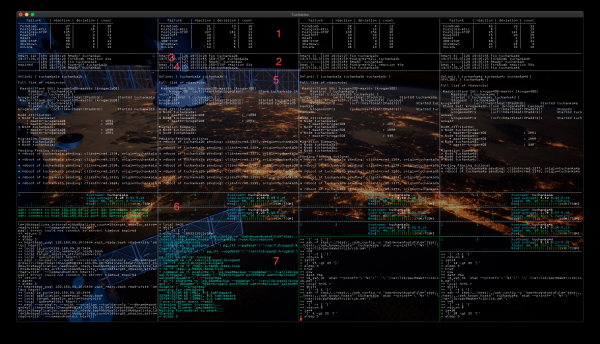
Terminál je rozdelený na stĺpce podľa počtu testovaných klastrov, predvolene (na snímke) ich je štyri. Obsah stĺpcov podrobne opíšem na príklade Tuchanka2. Panely na snímke sú číslované:
- Tu sa zobrazuje štatistika testov. Stĺpce:
- failure — názov testu (funkcie v skripte), ktorý simuluje poruchu.
- reaction — priemerne aritmetický čas v sekundách, za ktorý klaster obnovil svoju funkčnosť. Meria sa od začiatku práce skriptu, ktorý simuluje poruchu, až do momentu, keď klaster obnoví svoju funkčnosť a je schopný pokračovať v poskytovaní služieb. Ak je čas veľmi krátky, napríklad šesť sekúnd (to sa stáva v klastroch s viacerými otrokmi (Tuchanka3 a Tuchanka4)), znamená to, že porucha sa vyskytla na asynchrónnom otrokovi a nijako neovplyvnila funkčnosť, nedošlo k prepínaniu stavu klastru.
- deviation — zobrazuje rozptyl (presnosť) hodnoty reaction metódou «štandardná deviácia».
- count — koľkokrát bol tento test vykonaný.
- Krátky denník umožňuje posúdiť, čím sa klaster v aktuálnom momente zaoberá. Zobrazuje sa číslo iterácie (testu), časová značka a názov operácie. Príliš dlhé vykonávanie (> 5 minút) naznačuje nejaký problém.
- heart (srdce) — aktuálny čas. Pre vizuálnu hodnotenie funkčnosti majster do jeho tabuľky sa neustále zapisuje aktuálny čas pomocou float IP majstra. V prípade úspechu sa výsledok zobrazuje na tomto paneli.
- beat (pulz) — "aktuálny čas", ktorý bol predtým zaznamenaný skriptom heart v majstrovi, teraz sa číta z služobníka cez jeho float IP. Umožňuje vizuálne posúdiť funkčnosť služobníka a replikácie. Na Tuchanka1 nie sú služobníci s float IP (nie sú tu služobníci poskytujúci služby), ale sú tam dva inštancie (DB), preto tu bude zobrazené nie beat, a heart druhého inštancie.
- Monitorovanie stavu klasteru pomocou utilitky
pcs mon. Zobrazuje štruktúru, rozdelenie zdrojov medzi uzlami a ďalšie užitočné informácie. - Tu sa zobrazuje systémové monitorovanie z každej virtuálky klasteru. Takýchto panelov môže byť viac — koľko virtuálok má klaster. Dva grafy CPU Load (v virtuálkach po dva procesory), názov virtuálky, System Load (nazývaný ako Load Average, pretože je priemerný za 5, 10 a 15 minút), údaje o procesoch a rozdelenie pamäte.
- Trasovanie skriptu, ktorý vykonáva testovanie. V prípade poruchy — náhleho prerušenia činnosti alebo nekonečnej slučky čakania — tu môžete vidieť príčinu tohto správania.
Testovanie sa vykonáva v dvoch etapách. Najprv skript prejde všetkými druhmi testov, náhodne vyberajúc virtuálku, na ktorú sa tento test aplikuje. Potom sa vykonáva nekonečná slučka testovania, virtuálky a poruchy sa každý raz vyberajú náhodne. Náhle ukončenie testovacieho skriptu (dolný panel) alebo nekonečná slučka čakania na niečo (> 5 minút doba vykonávania jednej operácie, to je viditeľné v trasovaní) naznačuje, že niektorý z testov na tomto klastere zlyhal.
Každý test pozostáva z nasledujúcich operácií:
- Spustenie funkcie, ktorá simuluje poruchu.
- Ready? — čakanie na obnovenie funkčnosti klasteru (keď sú poskytované všetky služby).
- Zobrazuje sa čas čakania na obnovenie klasteru (reaction).
- Fix — klaster sa "opravia". Po tom by sa mal vrátiť do úplne funkčného stavu a pripravenosti na ďalšiu poruchu.
Tu je zoznam testov s popisom, čo robia:
- ForkBomb: vytvára "Out of memory" pomocou fork-bomby.
- OutOfSpace: preplňuje disk. Test je však skôr symbolický, pri tej zanedbateľnej záťaži, ktorá vzniká pri testovaní, zlyhanie PostgreSQL pri preplnení disku zvyčajne nenastáva.
- Postgres-KILL: zabíja PostgreSQL príkazom
killall -KILL postgres. - Postgres-STOP: pozastavuje PostgreSQL príkazom
killall -STOP postgres. - PowerOff: „vypína“ virtuálny stroj príkazom
VBoxManage controlvm "virtuálny stroj" poweroff. - Reset: reštartuje virtuálny stroj príkazom
VBoxManage controlvm "virtuálny stroj" reset. - SBD-STOP: pozastavuje démon SBD príkazom
killall -STOP sbd. - ShutDown: prostredníctvom SSH posiela na virtuálny stroj príkaz
systemctl poweroff, systém korektne dokončuje prácu. - UnLink: sieťová izolácia, príkaz
VBoxManage controlvm "virtuálny stroj" setlinkstate1 off.
Ukončenie testovania buď prostredníctvom štandardného príkazu tmux "kill-window" Ctrl-b &, alebo príkazom "detach-client" Ctrl-b d: v tomto prípade testovanie končí, tmux sa zatvára, virtuálne stroje sa vypínajú.
Identifikované problémy počas testovania
V súčasnosti watchdog démon sbd spravuje zastavenie pozorovaných démonov, ale nie ich zamŕzanie. A následne, nesprávne sa riešia poruchy, ktoré vedú k zamŕzaniu len Corosync a Pacemaker, ale pritom nezamŕzajú sbd. Pre kontrolu Corosync u klienta , akceptované do vetvy master. Sľúbili (v PR#83), že aj pre Pacemaker bude niečo podobné, dúfam, že k RedHat 8 to spravia. Ale takéto "poruchy" sú teoretické, ľahko sa imitujú umelo pomocou, napríklad,
killall -STOP corosync, ale nikdy sa nevyskytujú v reálnom živote.U Pacemaker v verzii pre CentOS 7 nesprávne nastavené sync_timeout u quorum device, v dôsledku čoho , na ktorý mal prejsť master. Opravené zvýšením sync_timeout u quorum device počas nasadzovania (v skripte
setup/setup1). Táto úprava nebola prijatá vývojármi Pacemaker, namiesto toho sľúbili prepracovať infraštruktúru takým spôsobom (v nejakom neurčitom čase), aby sa tento timeout vypočítaval automaticky.Ak pri konfigurácii databázy je uvedené, že v
LC_MESSAGES(textové správy) môže byť použitý Unicode, napríklad,ru_RU.UTF-8, tak pri spustení postgres v prostredí, kde locale nie je UTF-8, povedzme v prázdnom prostredí (tu pacemaker+pgsqlms(paf) spúšťa postgres), potom . Vývojári PostgreSQL sa dodnes nedohodli, čo s tým robiť. Tento problém sa obchádza, treba nastaviťLC_MESSAGES=en_US.UTF-8pri konfigurácii (vytváraní) inštancie DB.Ak je nastavený wal_receiver_timeout (predvolene 60 sekúnd), pri teste PostgreSQL-STOP na masteri v klastroch tuchanka3 a tuchanka4 . Replikácia je tam synchronná, takže sa zastaví nielen pracovník, ale aj nový master. Riešením je nastaviť wal_receiver_timeout=0 pri konfigurácii PostgreSQL.
Príležitostne som pozoroval zadržiavanie replikácie v PostgreSQL pri teste ForkBomb (preplnenie pamäte). . Takéto situácie som zažil len v klastroch tuchanka3 a tuchanka4, kde kvôli synchronnej replikácii zadržiaval master. Problém sa sám vyriešil po dlhšom čase (približne dve hodiny). Potrebné je ďalšie preskúmanie, aby sa to napravil. Podľa symptómov to pripomína predchádzajúcu chybu vyvolanú inou príčinou, ale s rovnakými následkami.
Obrázok kroganov je prevzatý z s povolením autora:
Zdroj: habr.com
