

Prejdeme si základy logovania v Dockeri a Kubernetes a potom sa pozrieme na dve nástroje, ktoré sa dajú s dôverou používať v produkcii: Grafana Loki a stack EFK (Elasticsearch + Fluent Bit + Kibana).
Materiál článku — výťah z . Ak máte chuť a najmä výrobnú potrebu, môžete absolvovať kompletné školenie — prihláste sa na kurz z .
Logovanie v Dockeri
Na úrovni Kubernetes sú aplikácie spustené v podoch, ale na nižšej úrovni zvyčajne fungujú v Dockeri. Preto je potrebné nastaviť logovanie tak, aby sa zbierali logy z kontajnerov. Kontajnery spúšťa Docker — znamená to, že sa treba zorientovať, ako je logovanie nastavené na úrovni Dockera.
Dúfam, že každý čitateľ vie: logy aplikácie by sa mali zapisovať do stdout/stderr, a nie dovnútra kontajnera. Logy agreguje Docker Daemon, a on pracuje práve s tými logmi, ktoré sa posielajú na stdout/stderr. Okrem toho zapisovanie logov dovnútra kontajnera prináša problémy: kontajner narastá kvôli rastúcemu logu (keďže vo vnútri kontajnera pravdepodobne nie je žiadny Logrotate), a Docker Daemon o tomto logu ani nevie.
Docker má niekoľko log-drivers alebo pluginov na zber logov kontajnerov. V bezplatnej verzii Docker Community Edition (CE) je menej log-driverov než v komerčnej Docker Enterprise Edition (EE).
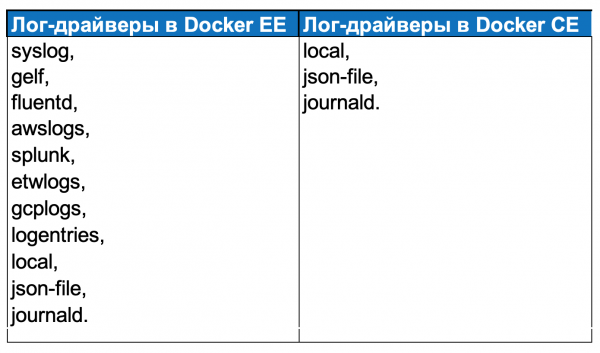
Docker EE som nikdy nepoužíval v praxi: v Southbridge sa snažíme dodržiavať riešenia Open Source, a väčšine našich klientov nie sú potrebné ďalšie funkcie Docker EE.
Log-drivery v Docker CE:
local — zápis logov do vnútorných súborov Docker Daemon;
json-file — vytvorenie json-logu v priečinku každého kontajnera;
journald — odosielanie logov do journald.
Nastavenia logovania v Dockeri sa nachádzajú v súbore daemon.json.
V poli “log-driver” uvádzajú plugin a v poli “log-opts” — jeho nastavenia. V príklade vyššie je uvedený plugin “json-file”, obmedzenie veľkosti logu — “max-size”: “10m”; obmedzenie počtu súborov (nastavenia rotácie) — “max-file”: “3”; ako aj hodnoty, ktoré sa pripoja k logom.
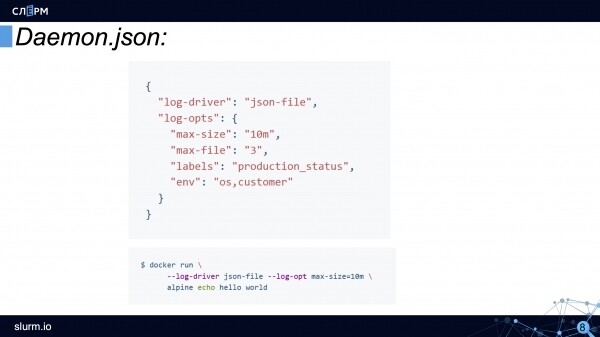
Niektoré nastavenia log-drivery je možné nastaviť pomocou príkazovej utilitky. Je to pohodlné, ak je potrebné spustiť samostatný kontajner s iným log-driverom.
Tu je, ako vyzerá schéma logovania v Dockeri:
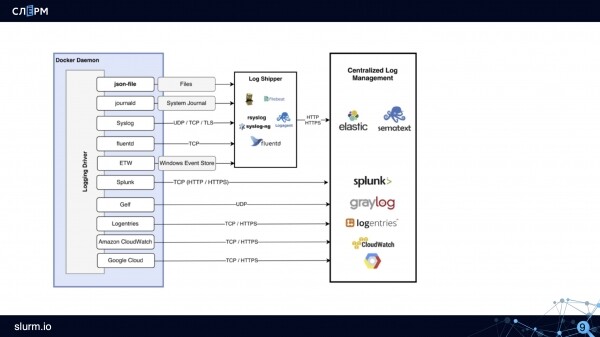
Ako schéma funguje: log-driver, napríklad json-file, vytvára súbory. Zbierky logov (Rsyslog, Fluentd, Logagent a ďalšie) tieto súbory zhromažďujú a prenášajú na uloženie do Elastic, Sematext alebo iných úložísk.
Vlastnosti logovania v Kubernetes
Zjednodušene schéma logovania v Kubernetes vyzerá takto: existuje pod, v ktorom je spustený kontajner, kontajner posiela logy do stdout/stderr. Potom Docker vytvorí súbor a zapisuje logy, ktoré potom môže rotovať.
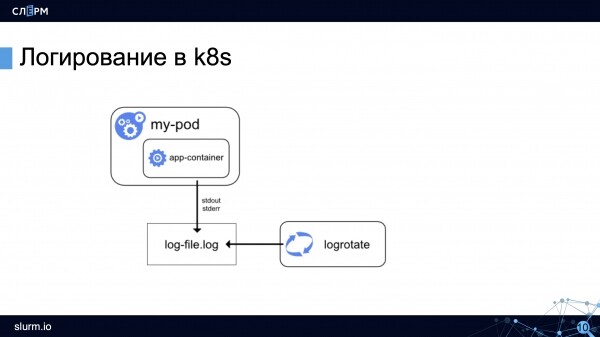
Pozrime sa na vlastnosti logovania v Kubernetes.
Uchovávať logy medzi nasadenými verziami. To je nevyhnutná podmienka pre správne nastavenie logovania. Ak sa logy medzi nasadením neuchovávajú, pri vydaní novej verzie aplikácie budú logy predchádzajúcej verzie prepísané, reštart kontajnera tiež spôsobí stratu logov. Kubernetes má príznak —previous, ktorý umožňuje pozrieť logy aplikácie pred posledným reštartom Pod, ale nie hlbšie.
Agregovať logy zo všetkých inštancií. Ak sú mikroservisy hosťované v cloudových prostrediach, za kontrolu systému zodpovedá cloudový poskytovateľ. Ak sú mikroservisy na vlastnom hardvéri, je potrebné zhromažďovať nielen logy z kontajnerov, ale aj logy zo systému.
Predtým neexistovali pohodlné nástroje na zbieranie logov zo systému aj z mikroservisov. Zvyčajne jeden nástroj zbieral systémové logy (napríklad Rsyslog), druhý — logy z Dockeru (napríklad journal-bit s nastavením log-drivra Docker na journald). Skúšali sme používať journal-bit – zbierať logy aj z kontajnerov (v log-drivri Docker určiť, že sa majú logy zapisovať do journald), a zo systému (v CentOS 7 už existuje systemd a journald). Riešenie je funkčné, ale nie ideálne. Ak je logov veľa, journal-bit začína spomaľovať, správy sa strácajú.
Experimenty pokračovali — a našiel sa iný spôsob. V CentOS 7 sa hlavné systémové logy (messages, audit, secure) duplikujú v var-logs vo forme súborov. V Dockeri je tiež možné nastaviť uchovanie logov do súborov json. Tieto súbory z CentOS 7 a Dockeru je následne možné zbierať spolu.
S časom sa stalo populárnym riešenie ELK Stack. Je to kombinácia niekoľkých nástrojov: Elasticsearch, Logstash a Kibana.
Elasticsearch uchováva logy z kontajnerov, Logstash zhromažďuje logy z inštancií, Kibana umožňuje spracovávať získané logy a vytvárať na ich základe grafy. Niektorý čas sa ELK Stack aktívne používal, ale podľa môjho názoru mu vypršal čas. Neskôr vysvetlím, prečo.
Pridať metadata. Pody, aplikácie, kontajnery môžu byť spustené kdekoľvek. Navyše, jedno aplikačné možno mať viacero inštancií. Logy sú zaznamenané v jednom formáte, a my musíme pochopiť, ktorá replika to je, ktorý Pod to píše, v akom namespace sa nachádza. Preto je potrebné pridať k logom metadata.
Získavať logy. Zaujímavé, ale náklady na podporu systému logovania a monitorovania môžu prekročiť náklady na samotnú aplikáciu. Keď vám prichádzajú desiatky a stovky tisíc logov za sekundu, zdá sa to byť prirodzené, no stále je potrebné poznať hranicu. Jeden zo spôsobov, ako túto hranicu nájsť, je parsovanie logov.
Vo všeobecnosti nie je potrebné zhromažďovať a uchovávať všetky logy, treba posielať na uchovávanie iba časť — napríklad logy so statusom „warning“ alebo „error“. Ak ide o logy nginx alebo ingress-kontrolérov, je možné uchovávať iba tie, ktorých status nie je 200. Ale to nie je univerzálny poradca: ak budujete analýzu na základe logov Nginx, je jasné, že by ste ich mali zbierať.
Nedávajú zlý filter na logy, pretože odfiltrované údaje nemusia stačiť na normálnu analýzu. Na druhej strane, možno by analytiku bolo lepšie vykonávať na úrovni zbierania metrických údajov. Potom nebude potrebné uchovávať stovky tisíc riadkov s kódom 200. Jeden z prístupov je získavať informácie o prenose a chybách z metrických údajov ingress-kontrolérov.
Vo všeobecnosti, treba dôkladne zvážiť: čo chcete uchovávať a ako dlho, pretože inak nastane situácia, keď systém logovania zaberá viac zdrojov než hlavný projekt.
Zatiaľ neexistuje štandardné riešenie pre logovanie. Na rozdiel od monitorovania, kde existuje jedno najbežnejšie riešenie Prometheus, v logovaní nie je žiadny štandard.
V rámci tejto prednášky sa pozrieme na dva nástroje: jeden populárny a druhý — získavajúci na popularite. Okrem nich existujú aj iné, ale v tomto článku sa ich dotkneme.
S prihliadnutím na všetky vyššie uvedené vlastnosti môžeme teraz predstaviť logovanie v Kubernetes na nasledujúcej schéme:
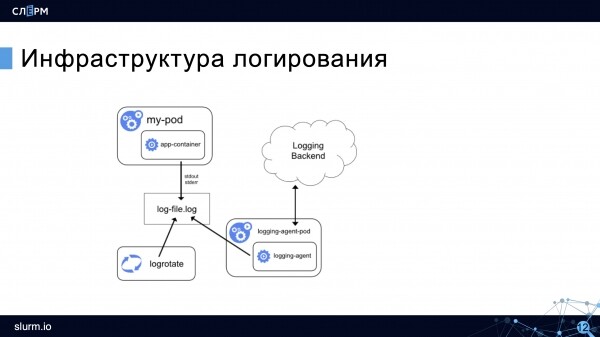
Zostáva log kontajnera, rotácia, ale objaví sa agent-zberateľ, ktorý zhromažďuje logy a posiela ich na uchovávanie (na schéme — do Logging Backend). Agent pracuje na každej node a zvyčajne je spustený v Kubernetes.
Teraz si pozrieme nástroje na logovanie.
Grafana Loki
sa objavil nedávno, no už sa stal dosť známym. Jeho výhody: ľahko sa inštaluje, spotrebúva málo zdrojov, nevyžaduje inštaláciu Elasticsearch, pretože uchováva údaje v TSDB (časovej databáze). V predchádzajúcom článku som písal, že v takej databáze uchováva údaje Prometheus, a to je jedna z mnohých podobností týchto dvoch produktov. Vývojári dokonca tvrdia, že Loki je "Prometheus pre svet logovania".
Malé odbočenie k TSDB pre tých, ktorí nečítali : TSDB sa výborne vyrovnáva so skladovaním veľkého množstva údajov, časových radov, ale nie je určená na dlhodobé uchovávanie. Ak z nejakého dôvodu potrebujete uchovávať logy dlhšie ako dva týždne, je lepšie nastaviť ich prenos do inej databázy.
Ďalšia výhoda Loki - na vizualizáciu údajov sa používa Grafana. Veľmi praktické: v Grafane sledujeme údaje zo sledovania a tam tiež, pripojením Loki, sledujeme logy. Na základe logov môžeme vytvárať grafy.
Architektúra Loki vyzerá približne takto:
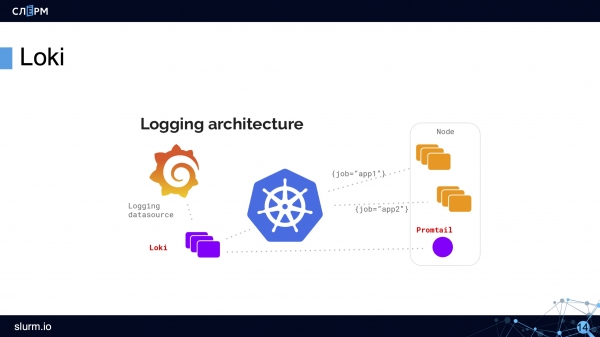
Pomocou DaemonSet sa na všetkých serveroch klastru rozvíja agent - Promtail alebo Fluent Bit. Agent zbiera logy. Loki ich preberá a uchováva v TSDB. K logom sa okamžite pridávajú metadata, čo je praktické: môžete filtrovať podľa Pods, namespaces, mien kontajnerov a dokonca aj podľa štítkov.
Loki funguje v známom rozhraní Grafana. Loki má dokonca svoj vlastný jazyk dotazov, ktorý sa nazýva LogQL - názov a syntax pripomínajú PromQL v Prometheovi. V rozhraní Loki sú nápovedy s dotazmi, takže ich nemusíte poznať naspamäť.
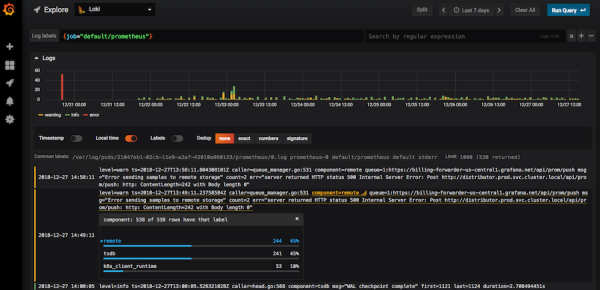
Loki v rozhraní Grafana
Použitím filtrov v Loki môžete nájsť kódy ("400", "404" a akýkoľvek iný); pozrieť logy z celej nody; filtrovať všetky logy, kde je slovo "error". Ak kliknete na log, otvorí sa karta so všetkými informáciami o udalosti.
V Loki je dostatok nástrojov, ktoré umožňujú vyhľadávať potrebné logy, i keď úprimne, technicky by ich mohlo byť aj viac. Teraz sa Loki aktívne vyvíja a získa popularitu.
Elastic + Fluent Bit + Kibana (EFK Stack)
Stack EFK je klasickejší a zároveň rovnako populárny nástroj na logovanie.
Na začiatku článku sa spomínal ELK (Elasticsearch + Logstash + Kibana), ale tento stack zastaráva kvôli málo výkonnému a pritom zdrojovo náročnému Logstash. Namiesto neho sa začal používať ľahší a výkonný Fluentd, a o niečo neskôr mu na pomoc prišiel — ešte ľahší a ešte výkonné agent na zber dát.
Ak veríme vývojárom, Fluent Bit je viac ako 100-krát lepší z pohľadu výkonu ako Fluentd: „kde Fluentd spotrebuje 20 MB RAM, Fluent Bit bude spotrebovávať 150 KB“ — priama citácia z dokumentácie. Poznávajúc toto, sa Fluent Bit začne používať častejšie.
Fluent Bit má menej možností ako Fluentd, ale základné požiadavky pokrýva, takže väčšinou používame Fluent Bit.
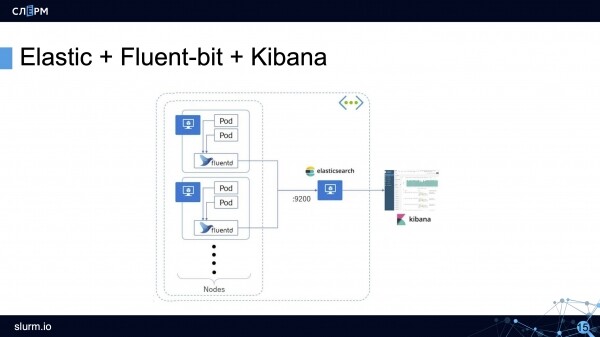
Schéma fungovania stacku EFK: agent zbiera logy zo všetkých podov (zvyčajne ide o DaemonSet, ktorý je spustený na všetkých serveroch klastrov) a posiela ich do úložiska (Elasticsearch, PostgreSQL alebo Kafka). Kibana sa pripája k úložisku a získava odtiaľ všetky potrebné informácie.
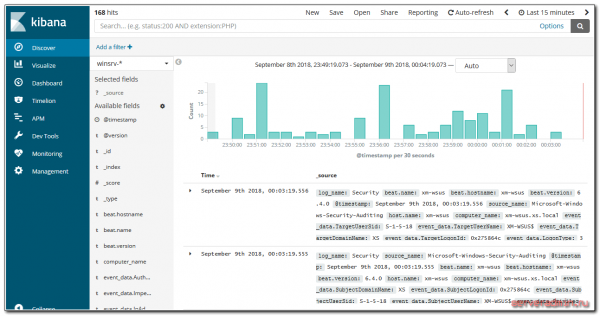
predstavuje informácie v pohodlnom webovom rozhraní. Sú tam grafy, filtre a mnohé ďalšie.
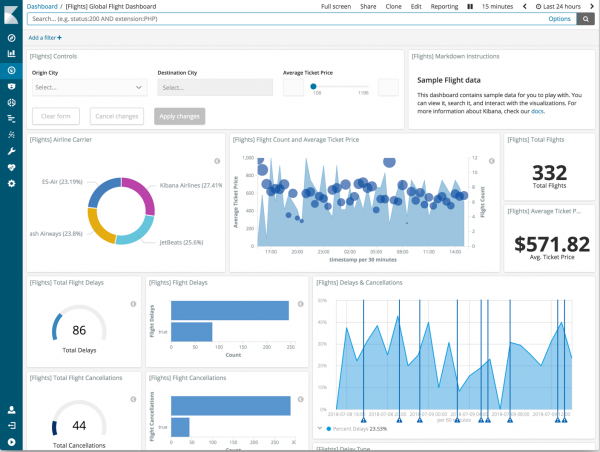
Na základe logov je možné vytvárať celé dashboardy.
Možnosti Fluent Bit
Keďže o Fluent Bit sa zvyčajne počulo menej ako o Logstash, pozrime sa na neho podrobnejšie. Fluent Bit je logicky rozdelený do 6 modulov, na niektoré moduly je možné pridať pluginy, ktoré rozširujú možnosti Fluent Bit.
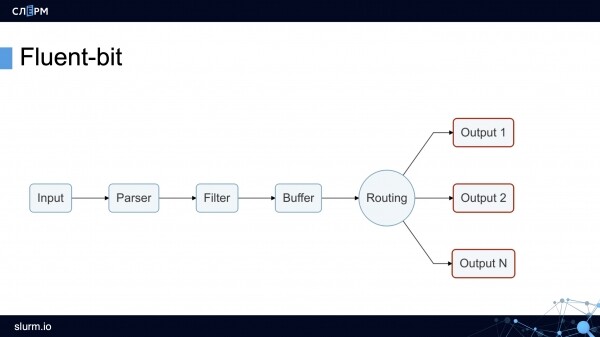
Modul Input zbiera logy z súborov, služieb systemd a dokonca aj z tcp-socket (stačí len určiť endpoint a Fluent Bit začne tam chodiť). Tieto možnosti sú dostatočné na zbieranie logov zo systému aj z kontajnerov.
V produkcii najčastejšie používame pluginy (môže byť nasmerovaný na priečinok s logami) a (môže mu byť povedané, z ktorých služieb zbierať logy).
Modul Parser privedie logy do jednotného formátu. Predvolene sú logy Nginx reprezentované ako reťazec. Pomocou pluginu je možné tento reťazec transformovať do formátu JSON: nastaviť polia a ich hodnoty. S JSON je oveľa jednoduchšie pracovať ako s reťazcovým logom, pretože existujú flexibilnejšie možnosti triedenia.
Modul Filter. Na tejto úrovni sa triedia nepotrebné logy. Napríklad na uchovanie sa odosielajú logy iba s hodnotou „warning“ alebo s určitými štítkami. Vybrané logy sa ukladajú do bufferu.
Modul Buffer. Fluent Bit má dva typy vyrovnávacích pamětí: paměťovou a diskovou. Vyrovnávací paměť je dočasné úložiště logů, které je potřeba v případě chyb nebo selhání. Každý chce šetřit operační paměť, proto se obvykle volí disková vyrovnávací paměť. Je však třeba brát v úvahu, že logy se před uložením na disk stejně načítají do paměti.
Modul Routing/Output obsahuje pravidla a adresy pro odesílání logů. Jak již bylo zmíněno, logy lze odesílat do Elasticsearch, PostgreSQL nebo například Kafka.
Zajímavé je, že z Fluent Bit lze logy odesílat do Fluentd. Protože první způsob je lehčí a méně funkční, přes něj je možné sbírat logy a odesílat je do Fluentd, kde je pomocí dalších pluginů dále zpracovávat a odesílat do úložišť.
Pokud plánujete používat Elasticsearch…
Na závěr dva tipy pro ty, kdo plánují používat Elasticsearch jako úložiště logů v produkčním prostředí.
- Nastavte upozornění pomocí . Tento program vyčleňuje z celkového toku logů důležité zprávy a posílá na ně upozornění na e-mail nebo do jiného kanálu. Bohužel, nedávno přišla .
- Rotujte logy pomocí aplikace nebo voláním API Elasticsearch. Samotný Elastic nyní činí významné kroky k řízení životního cyklu indexů bez použití externích nástrojů. V zásadě nemá smysl uchovávat logy dlouho: je nepravděpodobné, že by nějaký log byl potřebný po dvou týdnech — pokud je skutečně kritický, za dvě týdny bude jistě zpracován. V krajním případě lze staré logy archivovat a odesílat někam na dlouhodobé uchovávání. Slyšel jsem o speciálních logách, které je podle zákona nutné uchovávat až 5 let. Osobně jsem se s tím nesetkal, ale podobné informace bych nepovažoval za běžné logy a možná bych je dokonce uchovával odděleně.
Pokračování následuje…
Autor: Marcel Ibraev, certifikovaný administrátor Kubernetes, praktikující inženýr ve společnosti , řečník a autor kurzů .
Zdroj: habr.com
