

Pred začiatkom kurzu pripravili sme pre vás ďalší užitočný preklad.
Grafové databázy sú dôležitou technológiou pre databázových špecialistov. Snažím sa sledovať inováciami a novými technológiami v tejto oblasti a po práci s relačnými a NoSQL databázami vidím, že úloha grafových databáz sa stáva čoraz významnejšou. Pri práci so zložitými hierarchickými dátami sú tradičné databázy, ale aj NoSQL málo efektívne. Často sa s rastúcim počtom úrovní väzieb a veľkosťou databázy pozoruje pokles výkonu. A so zložitými vzťahmi rastie aj počet JOIN.
Samozrejme, v relačnom modeli existujú riešenia pre prácu s hierarchiami (napríklad pomocou rekurzívnych CTE), ale stále to zostáva obchádzanie. Funkcionalita grafových databáz SQL Server však umožňuje ľahko spracovávať niekoľko úrovní hierarchie. Zjednodušujú sa modely dát aj dotazy, čo vedie k zvýšeniu ich efektivity. Výrazne sa znižuje objem kódu.
Grafové databázy sú expresívny jazyk na reprezentáciu zložitých systémov. Táto technológia sa už pomerne široko využíva v IT priemysle v takých oblastiach, ako sú sociálne siete, antifraudové systémy, analýza IT sietí, sociálne odporúčania, odporúčania na produkty a obsah.
Funkcionalita grafových databáz v SQL Server je vhodná pre scenáre, v ktorých sú dáta silno prepojené a majú jasne definované vzťahy.
Grafový model dát
Graf je množina vrcholov (uzlov, node) a hrán (vzťahov, edge). Vrcholy predstavujú entity a hrany sú vzťahy, v atribútoch ktorých môže byť obsiahnuté informácie.
Grafová databáza modeluje entity vo forme grafu tak, ako je to definované v teórii grafov. Štruktúry dát sú vrcholy a hrany. Atribúty sú vlastnosti vrcholov a hrán. Vzťah je spojenie vrcholov.
Na rozdiel od iných modelov dát, v grafových databázach sú v popredí vzťahy medzi entitami. Preto nie je potrebné vypočítavať vzťahy pomocou vonkajších kľúčov alebo nejakými inými spôsobmi. Môžete vytvárať zložité modely dát, pričom využívate iba abstrakcie vrcholov a hrán.
V súčasnom svete si modelovanie vzťahov vyžaduje čoraz zložitejšie metódy. Pre modelovanie vzťahov SQL Server 2017 ponúka možnosti grafových databáz. Vrcholy a hrany grafu sú reprezentované ako nové typy tabuliek: NODE a EDGE. Na dotazy k grafu sa používa nová funkcia T-SQL s názvom MATCH(). Keďže táto funkcia je zabudovaná v SQL Server 2017, je možné ju používať vo vašich existujúcich databázach bez potreby ich konverzie.
Výhody grafového modelu
V súčasnosti firmy a používatelia požadujú aplikácie, ktoré zvládajú stále väčšie objemy údajov a zároveň očakávajú vysoký výkon a spoľahlivosť. Predstavovanie údajov vo forme grafu ponúka pohodlné nástroje na spracovanie zložitých vzťahov. Tento prístup umožňuje riešiť mnohé problémy a pomáha dosiahnuť výsledky v rámci daného kontextu.
Podľa všetkého v budúcnosti mnoho aplikácií získa výhody z používania grafových databáz.
Modelovanie údajov: od relačného modelu k grafovému
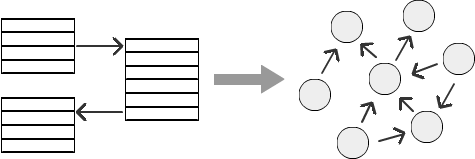
Príklad
Pozrime sa na príklad organizačnej štruktúry s hierarchiou zamestnancov: zamestnanec je podriadený manažérovi, manažér - staršiemu manažérovi a tak ďalej. V závislosti od konkrétnej spoločnosti môže mať táto hierarchia akýkoľvek počet úrovní. Ale so zvyšovaním počtu úrovní je výpočet vzťahov v relačnej databáze čoraz zložitejší. Je dosť obtiažne predstaviť hierarchiu zamestnancov, hierarchiu v marketingu alebo vzťahy v sociálnych sieťach. Pozrime sa, ako môže SQL Graph vyriešiť problém spracovania rôznych úrovní hierarchie.
Pre tento príklad vytvorme jednoduchý model údajov. Vytvoríme tabuľku zamestnancov EMP s identifikátorom EMPNO a stĺpcom MGR, ktorý ukazuje na identifikátor nadriadeného (manažéra) zamestnanca. Všetky informácie o hierarchii sú uložené v tejto tabuľke a môžu byť vyžiadané pomocou stĺpcov. EMPNO a MGR.
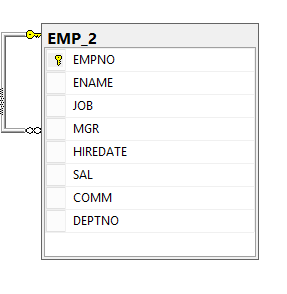
Na nasledujúcej diagramovej schéme je znázornený ten istý model organizačnej štruktúry so štyrmi úrovňami hĺbky v bežnejšej forme. Zamestnanci sú vrcholmi grafu z tabuľky EMP. Entita „zamestnanec“ je prepojená sama so sebou uzlovým vzťahom „podriadený“ (ReportsTo). V termínoch grafov je vzťah hrana (EDGE), ktorá spája uzly (NODE) zamestnancov.
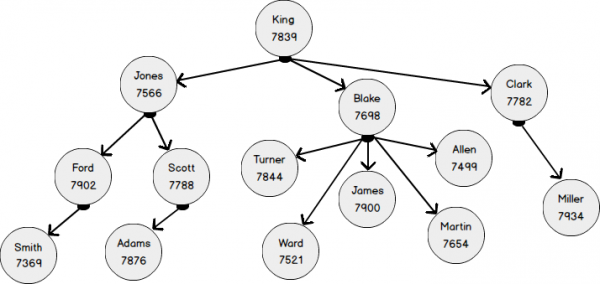
Poďme vytvoriť bežnú tabuľku EMP a pridáme tam hodnoty podľa vyššie uvedenej schémy.
VYTVORIŤ TABUĽKU EMP
(EMPNO INT NOT NULL,
ENAME VARCHAR(20),
JOB VARCHAR(10),
MGR INT,
JOINDATE DATETIME,
SALARY DECIMAL(7, 2),
COMMISIION DECIMAL(7, 2),
DNO INT)

VLOŽIŤ DO EMP HODNOTY
(7369, 'SMITH', 'CLERK', 7902, '02-MAR-1970', 8000, NULL, 2),
(7499, 'ALLEN', 'SALESMAN', 7698, '20-MAR-1971', 1600, 3000, 3),
(7521, 'WARD', 'SALESMAN', 7698, '07-FEB-1983', 1250, 5000, 3),
(7566, 'JONES', 'MANAGER', 7839, '02-JUN-1961', 2975, 50000, 2),
(7654, 'MARTIN', 'SALESMAN', 7698, '28-FEB-1971', 1250, 14000, 3),
(7698, 'BLAKE', 'MANAGER', 7839, '01-JAN-1988', 2850, 12000, 3),
(7782, 'CLARK', 'MANAGER', 7839, '09-APR-1971', 2450, 13000, 1),
(7788, 'SCOTT', 'ANALYST', 7566, '09-DEC-1982', 3000, 1200, 2),
(7839, 'KING', 'PRESIDENT', NULL, '17-JUL-1971', 5000, 1456, 1),
(7844, 'TURNER', 'SALESMAN', 7698, '08-AUG-1971', 1500, 0, 3),
(7876, 'ADAMS', 'CLERK', 7788, '12-MAR-1973', 1100, 0, 2),
(7900, 'JAMES', 'CLERK', 7698, '03-NOV-1971', 950, 0, 3),
(7902, 'FORD', 'ANALYST', 7566, '04-MAR-1961', 3000, 0, 2),
(7934, 'MILLER', 'CLERK', 7782, '21-JAN-1972', 1300, 0, 1)
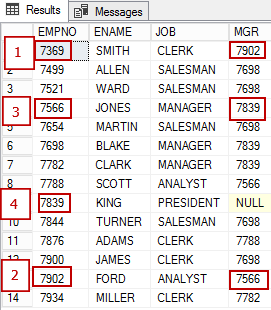
Na nižšie uvedenom obrázku sú zobrazení zamestnanci:
- zamestnanec s EMPNO 7369 podriadený 7902;
- zamestnanec s EMPNO 7902 podriadený 7566
- zamestnanec s EMPNO 7566 podriadený 7839
Poďme sa teraz pozrieť na reprezentáciu tých istých údajov vo forme grafu. Uzol EMPLOYEE má niekoľko atribútov a je spätne prepojený sám so sebou vzťahom 'podriadený' (EmplReportsTo). EmplReportsTo je názov vzťahu.
V tabuľke hrán (EDGE) môžu byť tiež prítomné atribúty.
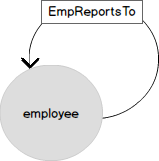
Vytvorme tabuľku uzlov EmpNode
Syntax na vytvorenie uzla je pomerne jednoduchá: k výrazu VYTVORIŤ TABUĽKU sa na koniec pridá 'AS NODE'.
VYTVORIŤ TABUĽKU dbo.EmpNode(
ID Int Identity(1,1),
EMPNO NUMERIC(4) NOT NULL,
ENAME VARCHAR(10),
MGR NUMERIC(4),
DNO INT
) AS NODE;
Teraz transformujeme údaje z bežnej tabuľky do grafovej. Nasledujúci INSERT vkladá údaje z relačnej tabuľky EMP.
VLOŽIŤ DO EmpNode(EMPNO,ENAME,MGR,DNO) vyber empno,ename,MGR,dno z emp 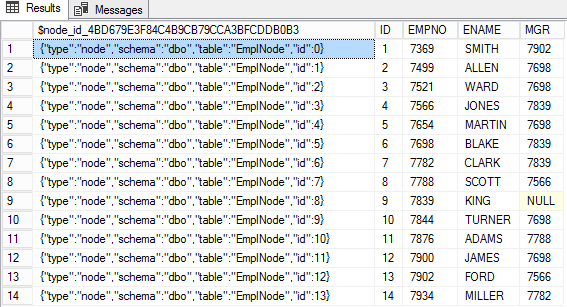
V tabuľke uzlov je v špeciálnom stĺpci $node_id_* uložený identifikátor uzla vo formáte JSON. V ostatných stĺpcoch tejto tabuľky sú umiestnené atribúty uzla.
Vytvárame hrany (EDGE)
Vytvorenie tabuľky hrán sa veľmi podobá vytvoreniu tabuľky uzlov, s výnimkou toho, že sa používa kľúčové slovo 'AS EDGE'.
VYTVORIŤ TABUĽKU empReportsTo(Deptno int) AS EDGE 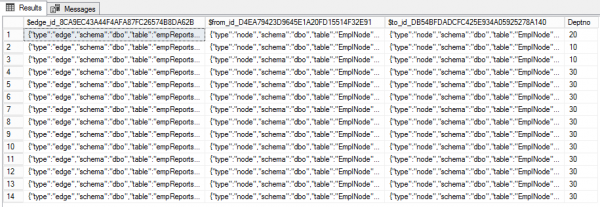
Teraz definujeme vzťahy medzi zamestnancami pomocou stĺpcov EMPNO a MGR. Z diagramu organizačnej štruktúry je dobre vidieť, ako napísať INSERT.
VLOŽTE DO empReportsTo HODNOTY ((SELECT $node_id FROM EmpNode WHERE ID = 1),
   	(SELECT $node_id FROM EmpNode WHERE id = 13),20);
VLOŽTE DO empReportsTo HODNOTY ((SELECT $node_id FROM EmpNode WHERE ID = 2),
   	(SELECT $node_id FROM EmpNode WHERE id = 6),10);
VLOŽTE DO empReportsTo HODNOTY ((SELECT $node_id FROM EmpNode WHERE ID = 3),
   	(SELECT $node_id FROM EmpNode WHERE id = 6),10)
VLOŽTE DO empReportsTo HODNOTY ((SELECT $node_id FROM EmpNode WHERE ID = 4),
   	(SELECT $node_id FROM EmpNode WHERE id = 9),30);
VLOŽTE DO empReportsTo HODNOTY ((SELECT $node_id FROM EmpNode WHERE ID = 5),
   	(SELECT $node_id FROM EmpNode WHERE id = 6),30);
VLOŽTE DO empReportsTo HODNOTY ((SELECT $node_id FROM EmpNode WHERE ID = 6),
   	(SELECT $node_id FROM EmpNode WHERE id = 9),30);
VLOŽTE DO empReportsTo HODNOTY ((SELECT $node_id FROM EmpNode WHERE ID = 7),
   	(SELECT $node_id FROM EmpNode WHERE id = 9),30);
VLOŽTE DO empReportsTo HODNOTY ((SELECT $node_id FROM EmpNode WHERE ID = 8),
   	(SELECT $node_id FROM EmpNode WHERE id = 4),30);
VLOŽTE DO empReportsTo HODNOTY ((SELECT $node_id FROM EmpNode WHERE ID = 9),
   	(SELECT $node_id FROM EmpNode WHERE id = 9),30);
VLOŽTE DO empReportsTo HODNOTY ((SELECT $node_id FROM EmpNode WHERE ID = 10),
   	(SELECT $node_id FROM EmpNode WHERE id = 6),30);
VLOŽTE DO empReportsTo HODNOTY ((SELECT $node_id FROM EmpNode WHERE ID = 11),
   	(SELECT $node_id FROM EmpNode WHERE id = 8),30);
VLOŽTE DO empReportsTo HODNOTY ((SELECT $node_id FROM EmpNode WHERE ID = 12),
   	(SELECT $node_id FROM EmpNode WHERE id = 6),30);
VLOŽTE DO empReportsTo HODNOTY ((SELECT $node_id FROM EmpNode WHERE ID = 13),
   	(SELECT $node_id FROM EmpNode WHERE id = 4),30);
VLOŽTE DO empReportsTo HODNOTY ((SELECT $node_id FROM EmpNode WHERE ID = 14),
   	(SELECT $node_id FROM EmpNode WHERE id = 7),30);
Predvolená tabuľka hrán pozostáva z troch stĺpcov. Prvý, $edge_id — identifikátor hrany vo formáte JSON. Dva ďalšie ($from_id a $to_id) predstavujú spojenie medzi uzlami. Okrem toho môžu mať hrany aj ďalšie vlastnosti. V našom prípade je to Deptno.
Systémové pohľady
V systémovom pohľade sys.tables sa objavili dva nové stĺpce:
- is_edge
- is_node
SELECT t.is_edge,t.is_node,*
FROM sys.tables t
WHERE name like 'emp%' 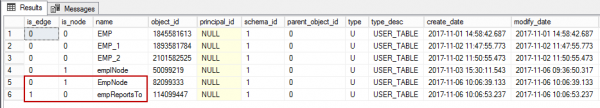
SSMS
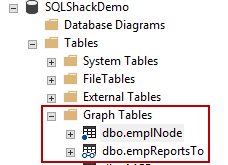
Objekty súvisiace s grafikou sú umiestnené v priečinku Graph Tables. Ikona tabuľky uzlov je označená bodkou, zatiaľčo tabuľky hrán majú dve spojené kruhy (čo trochu pripomína okuliare).
Výraz MATCH
Výraz MATCH je prevzatý z CQL (Cypher Query Language). Je to efektívny spôsob dotazovania na vlastnosti grafu. CQL začína výrazom MATCH.
Syntax
MATCH ()

::=
    { {
                 	{ <-(  )- }
               	| { -(  )-> }

             	}
 	}
 	[ { AND } { (  ) } ]
 	[ ,...n ]

 ::=
    node_table_name | node_alias

 ::=
    edge_table_name | edge_alias
Príklady
Pozrime sa na niekoľko príkladov.
Nižšie uvedený dopyt zobrazuje zamestnancov, ktorí sú podriadení Smithovi a jeho manažerovi.
SELECT
E.EMPNO,E.ENAME,E.MGR,E1.EMPNO,E1.ENAME,E1.MGR
FROM
    empnode e, empnode e1, empReportsTo m
WHERE
    MATCH(e-(m)->e1)
and e.ENAME='SMITH' 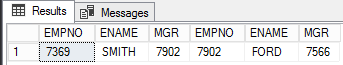
Nasledujúca požiadavka je určená na vyhľadávanie zamestnancov a druhostupňových manažérov pre Smitha. Ak odstránime vetu WHERE, výsledkom budú všetci zamestnanci.
SELECT
E.EMPNO,E.ENAME,E.MGR,E1.EMPNO,E1.ENAME,E1.MGR,E2.EMPNO,e2.ENAME,E2.MGR
FROM
    empnode e, empnode e1, empReportsTo m ,empReportsTo m1, empnode e2
WHERE
    MATCH(e-(m)->e1-(m1)->e2)
and e.ENAME='SMITH' 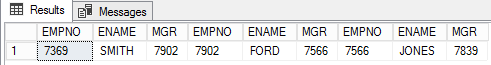
A nakoniec, požiadavka na zamestnancov a tretostupňových manažérov.
SELECT
E.EMPNO,E.ENAME,E.MGR,E1.EMPNO,E1.ENAME,E1.MGR,E2.EMPNO,e2.ENAME,E2.MGR,E3.EMPNO,e3.ENAME,E3.MGR
FROM
    empnode e, empnode e1, empReportsTo m ,empReportsTo m1, empnode e2, empReportsTo M2, empnode e3
WHERE
    MATCH(e-(m)->e1-(m1)->e2-(m2)->e3)
and e.ENAME='SMITH' 
Teraz zmeňme smer, aby sme získali nadriadených Smitha.
SELECT
E.EMPNO,E.ENAME,E.MGR,E1.EMPNO,E1.ENAME,E1.MGR,E2.EMPNO,e2.ENAME,E2.MGR,E3.EMPNO,e3.ENAME,E3.MGR
FROM
    empnode e, empnode e1, empReportsTo m ,empReportsTo m1, empnode e2, empReportsTo M2, empnode e3
WHERE
MATCH(e<-(m)-e1<-(m1)-e2<-(m2)-e3) 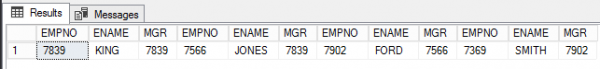
Záver
SQL Server 2017 sa osvedčil ako komplexné podnikové riešenie pre rôzne IT úlohy v podnikaní. Prvá verzia SQL Graph je veľmi sľubná. Napriek niektorým obmedzeniam je už teraz dostatok funkcií na preskúmanie možností grafov.
Funkcia SQL Graph je plne integrovaná do SQL Engine. Ako bolo už spomenuté, v SQL Server 2017 existujú nasledujúce obmedzenia:
Nepodporuje sa polymorfizmus.
- Podporujú sa iba jednosmerné vzťahy.
- Nie je možné aktualizovať stĺpce $from_id a $to_id cez UPDATE.
- Nepodporujú sa tranzitívne uzávierky (transitive closure), ale je možné ich získať pomocou CTE.
- Obmedzená podpora objektov In-Memory OLTP.
- Nepodporujú sa časové tabuľky (System-Versioned Temporal Table), dočasné lokálne a globálne tabuľky.
- Tabuľkové typy a tabuľkové premenné nemôžu byť deklarované ako NODE alebo EDGE.
- Nepodporujú sa dopyty medzi databázami (cross-database queries).
- Nie je priamy spôsob ani žiadny sprievodca (wizard) na konvertovanie bežných tabuliek na grafové.
- Pre zobrazenie grafov nie je GUI, avšak je možné použiť Power BI.
Čítať ďalej:
Zdroj: habr.com
