

VictoriaMetrics — rýchla a škálovateľná DBMS na ukladanie a spracovanie dát vo forme časovej rady (záznam vytvára čas a súbor hodnôt súvisiacich s týmto časom, napríklad získaných prostredníctvom periodického prieskumu stavu senzorov alebo zberu metrík).
Volám sa Kolobaev Pavel. DevOps, SRE, LeroyMerlin, všetko ako kód – to všetko sa týka nás: mňa a ostatných zamestnancov LeroyMerlin.
Existuje cloud postavený na OpenStacku. Tam je malý odkaz na technický radar.
Systém je postavený na hardvéri Kubernetes, ako aj na všetkých sprievodných službách OpenStacku a logovania.
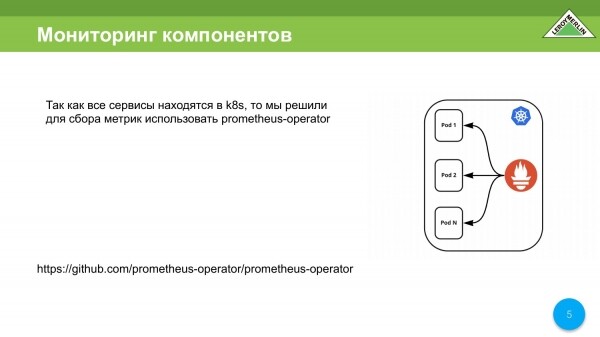
Naša schéma bola takáto počas vývoja. Keď sme to všetko vyvíjali, mali sme operátora Prometheus, ktorý uchovával dáta priamo v klasteri K8s. Automaticky nachádzal potrebné údaje na skenovanie a ukladal ich pod nohy, zjednodušene povedané.
Všetky dáta musíme preniesť mimo klaster Kubernetes, pretože ak sa niečo stane, musíme rozumieť, čo a kde.
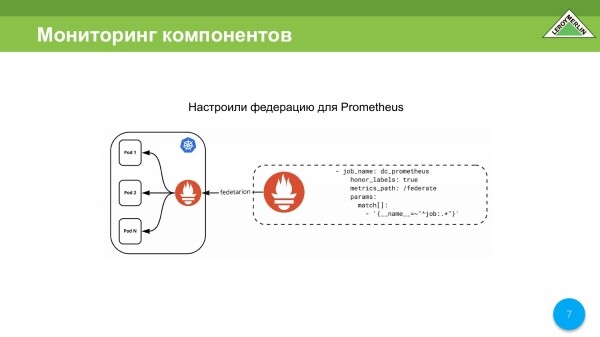
Prvé riešenie – používame federáciu, keď máme externý Prometheus, a keď pristupujeme ku klastrom Kubernetes pomocou mechanizmu federácie.
Ale tu vznikajú malé problémy. V našom prípade problémy začali, keď sme mali 250 000 metrík, a keď ich bolo 400 000, uvedomili sme si, že takto nemôžeme pracovať. Zvýšili sme scrape_timeout na 25 sekúnd.
Prečo sme to museli urobiť? Prometheus začína odpočítavať čas časového limitu od začiatku momentu prieskumu. A nezáleží na tom, že dáta ešte tečú. Ak sa v určenom časovom období nedajú skompilovať dáta a relácia nebude uzavretá cez http, považuje sa relácia za neúspešnú a dáta sa nedostanú do samotného Prometheus.
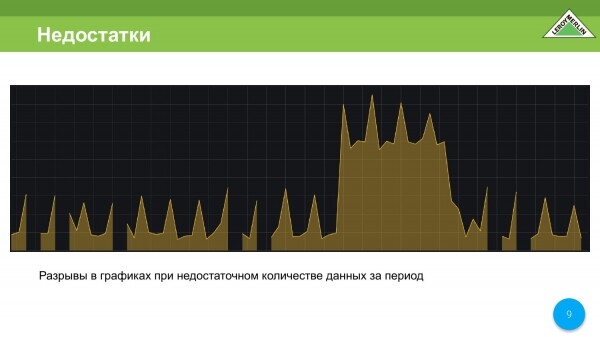
Všetci poznajú grafy, ktoré získavame, keď časť dát chýba. Grafy sú zúbkaté a to nám nevyhovuje.
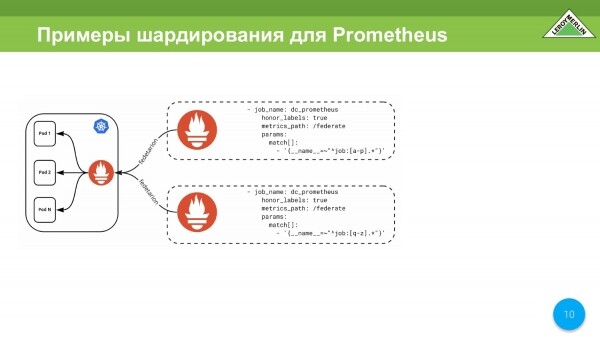
Ďalšou možnosťou je shardovanie na základne dvoch rôznych Prometheus cez ten istý mechanizmus federácie.
Napríklad jednoducho vziať a shardovať ich podľa mena. To sa dá tiež použiť, ale rozhodli sme sa posunúť ďalej.
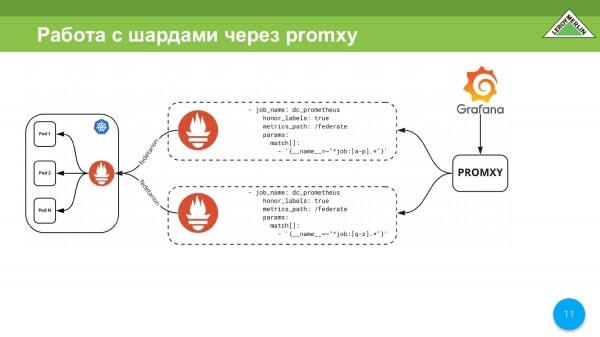
Budeme musieť teraz tieto shard-y nejako spracovať. Môžeme vziať promxy, ktorý sa pozrie do oblasti shardu, a multiplexuje dáta. Funguje s dvoma shardmi ako s jedným vstupným bodom. To sa dá implementovať cez promxy, ale je to zatiaľ príliš zložité.
Prvá možnosť – chceme sa vzdať mechanzmu federation, pretože je veľmi pomalý.
Vývojári Prometheus jasne hovoria: „Chlapi, používajte iné TimescaleDB, pretože nebudeme dlho podporovať uchovávanie metrík“. To nie je ich úloha. 
Na papier si zapisujeme, že naozaj potrebujeme export von, aby sme nemuseli všetko uchovávať na jednom mieste.
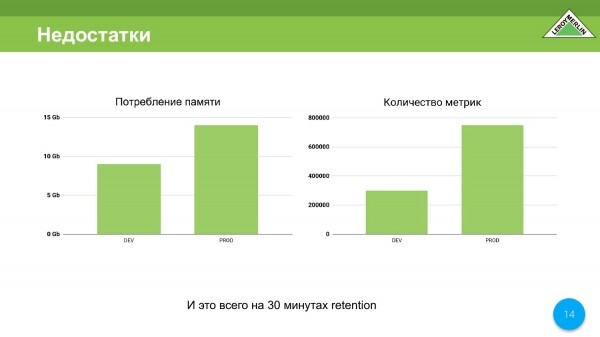
Druhý nedostatok – je to spotreba pamäte. Áno, chápem, že mnohí povedia, že v roku 2020 pár gigabajtov pamäte stojí len pár centov, ale napriek tomu.
Teraz máme dev a prod prostredie. V dev to je okolo 9 gigabajtov na 350 000 metrík. V prod to je niečo vyše 14 gigabajtov na 780 000 metrík. Pri tom je retention time len 30 minút. To je zlé. A teraz vysvetlím prečo.
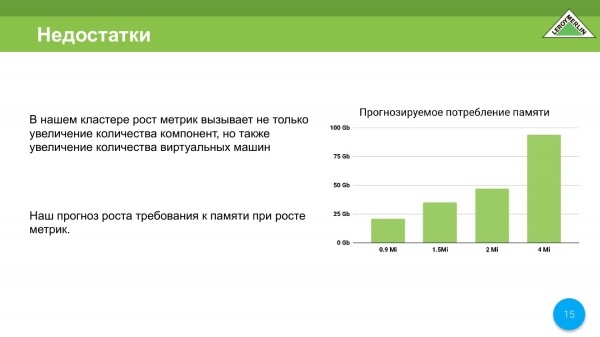
Robíme výpočet, t. j. pri milión a pol metrík, a už sme blízko tomuto číslu, na etape návrhu dostávame 35-37 gigabajtov pamäte. Ale už pri 4 miliónoch metrík je potrebné okolo 90 gigabajtov pamäte. T. j. to bolo vypočítané podľa vzorca, ktorý poskytli vývojári Prometheus. Pozreli sme sa na koreláciu a pochopili sme, že nechceme platiť pár miliónov za server len na monitorovanie.
Naša potreba strojov sa nebude len zvyšovať, ale aj monitorujeme samotné virtuálne stroje. Preto čím viac virtuálnych strojov, tým viac rôznych metrík atď. Bude to špeciálny rast nášho klastra z hľadiska metrík.
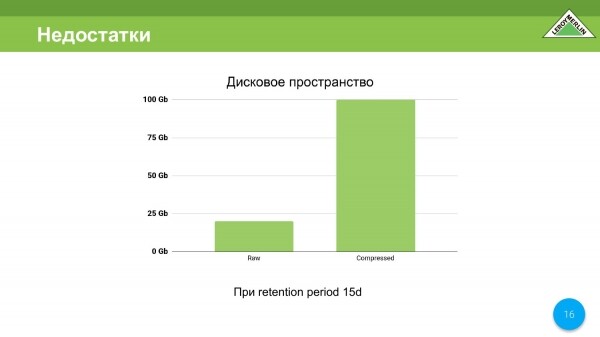
S diskovým priestorom to nie je až tak zlé, ale radi by sme to zlepšili. Za 15 dní sme získali celkom 120 gigabajtov, z ktorých 100 je komprimovaných dát, 20 sú nekomprimované dáta, ale vždy chceme menej.
Podľa toho zapisujeme ďalší bod – je to veľká spotreba zdrojov, ktoré chceme šetriť, pretože nechceme, aby náš klaster monitorovania zjedol viac zdrojov než náš klaster, ktorý spravuje OpenStack.
Existuje ešte jedna nevýhoda Prometheus, ktorú sme si uvedomili, a to je akékoľvek obmedzenie pamäte. S Prometheus je to oveľa horšie, pretože nemá žiadne takéto možnosti. Používať obmedzenie v doku nie je tiež možnosť. Ak by náhodou spadol RAF a mal 20-30 gigabajtov, obnovenie potrvá veľmi dlho.
To je ďalší dôvod, prečo nám Prometheus nevyhovuje, t. j. nie je možné obmedziť spotrebu pamäte.
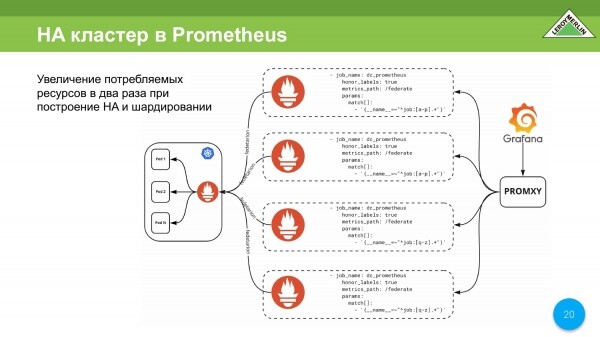
Môžeme prejsť na takúto schému. Táto schéma je potrebná na organizáciu HA klastera. Chceme, aby naše metriky boli vždy a všade dostupné, aj keď spadne server, ktorý tieto metriky uchováva. A preto musíme postaviť takúto schému.
Táto schéma hovorí, že budeme mať duplicitu shardov a tým pádom aj duplicitu nákladov na použité zdroje. Je možné ju takmer horizontálne škálovať, no aj tak bude spotreba zdrojov obrovská.
Odpísali sme si nedostatky v poradí, v akom sme ich identifikovali:
- Je potrebné vyviesť metriky von.
- Veľká spotreba zdrojov.
- Nie je možné obmedziť spotrebu pamäte.
- Zložitá a náročná implementácia HA.
Rozhodli sme sa, že ideme preč od Prometheus ako od úložiska.
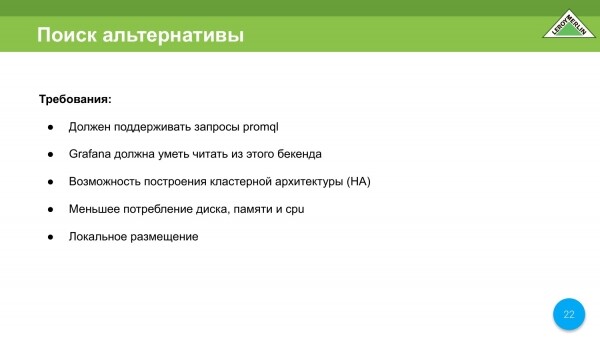
Určili sme si ďalšie požiadavky, ktoré potrebujeme. Tieto sú:
- Podpora promql, pretože už je napísané veľa pod Prometheus: dotazy, upozornenia.
- A máme tu ešte Grafanu, ktorá je rovnakým spôsobom napísaná pod Prometheus ako backend. Nechceme prepisovať dashboardy.
- Chceme postaviť normálnu architektúru HA.
- Chceme znížiť spotrebu akýchkoľvek zdrojov.
- Existuje ešte malý detail. Nemôžeme používať rôzne cloudové systémy zberu metrik. Nevieme, čo sa nám tam uletí do tých metrík. A keďže tam môže odísť čokoľvek, musíme sa obmedziť na lokálne umiestnenie.
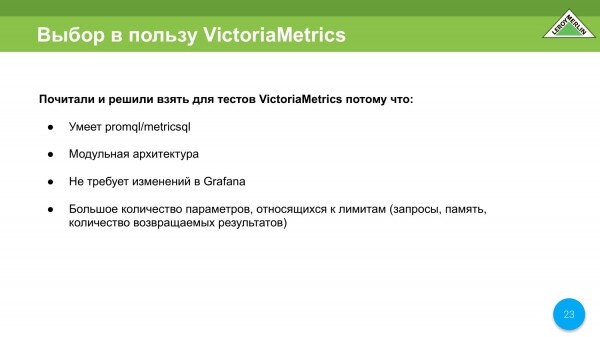
Na výber bol malý rozsah. Zhromaždili sme všetko, čo sme zažili. Pozreli sme sa na stránku Prometheus v sekcii integracie, prečítali sme množstvo článkov a posúdili, čo je vlastne k dispozícii. A pre nás sme si vybrali VictoriaMetrics ako náhradu za Prometheus.
Prečo? Pretože:
- Ovláda promql.
- Má modulárnu architektúru.
- Nevyžaduje zmeny v Grafane.
- A to najdôležitejšie – možno budeme poskytovať úložisko metrik v rámci našej spoločnosti ako službu, preto sa vopred pozeráme na obmedzenia rôzneho druhu, aby používatelia mohli v obmedzenej podobe využiť všetky zdroje klastera, pretože existuje šanca, že bude multitenancy.
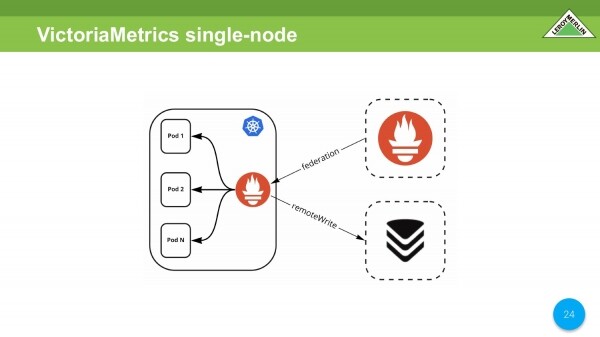
Robíme prvé porovnanie. Berieme ten istý Prometheus vnútri klastera, k nemu sa pripája externý Prometheus. Pridávame cez remoteWrite VictoriaMetrics.
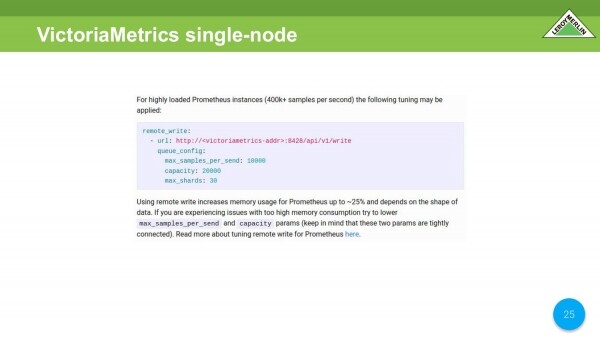
Hneď na začiatok spomeniem, že sme tu zaregistrovali mierny nárast CPU za strany VictoriaMetrics. Na wiki VictoriaMetrics sú uvedené parametre, ktoré fungujú najlepšie. Overili sme ich. Výrazne znížili spotrebu CPU.
V našom prípade sa spotreba pamäte Prometheus, ktorý je v klastri Kubernetes, nezvýšila výrazne.
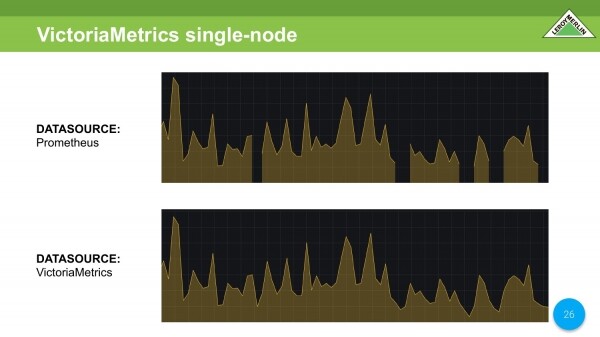
Porovnávame dva zdroje dát tých istých údajov. V Prometheus vidíme všetky chýbajúce údaje. Vo VictoriaMetrics je všetko v poriadku.
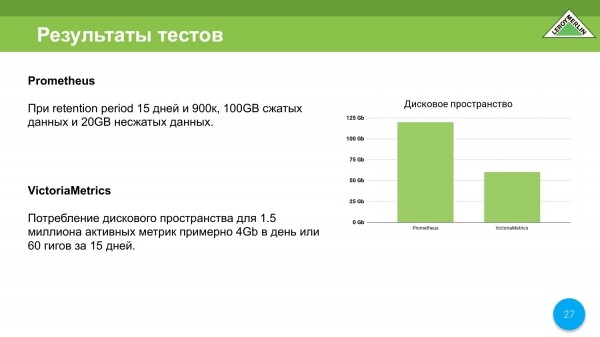
Výsledky testov s diskovým priestorom. V Prometheus sme dostali celkovo 120 gigabajtov. V VictoriaMetrics dostávame už 4 gigabajty za deň. Tam je trochu iný mechanizmus, ako sme zvyknutí vidieť v Prometheus. T. j. údaje sú dosť dobre komprimované za deň, za polhodinu. Sú už dobre stlačené za deň, za polhodinu, aj keď sa ešte budú zlúčiť údaje. Nakoniec sme ušetrili na diskovom priestore.
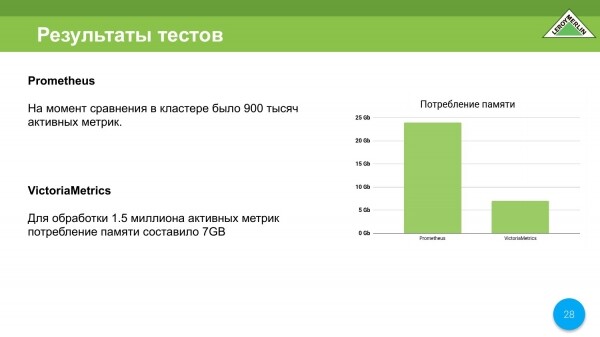
Ešte šetríme na spotrebe pamäťových zdrojov. Naša testovacia inštancia Prometheus bola nasadená na virtuálnom stroji – 8 jadier, 24 gigabajtov. Prometheus spotrebováva prakticky všetko. Spadol kvôli OOM Killer. Pri tom doň prúdilo len 900 000 aktívnych metrík. To je približne 25 000-27 000 metrík za sekundu.
VictoriaMetrics bola spustená na dvojjadrovom virtuálnom stroji s 8 gigabajtmi RAM. Podarilo sa nám dosiahnuť dobré fungovanie VictoriaMetrics úpravou niektorých parametroch na 8-gigabajtovom zariadení. Nakoniec sme sa zmestili do 7 gigabajtov. Získali sme pritom vyššiu rýchlosť prenosu obsahu, teda metrík, než v prípade Prometheus.
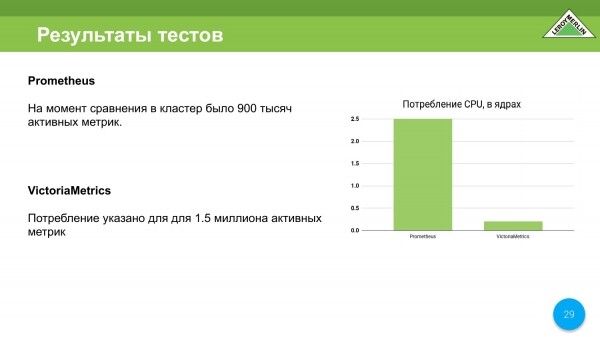
Spotreba CPU sa v porovnaní s Prometheus výrazne zlepšila. Tu Prometheus spotrebováva 2,5 jadra, kým VictoriaMetrics len 0,25 jadra. Na začiatku – 0,5 jadra. Počas zlúčenia sa to môže zvýšiť na jedno jadro, ale to sa stáva veľmi zriedka.
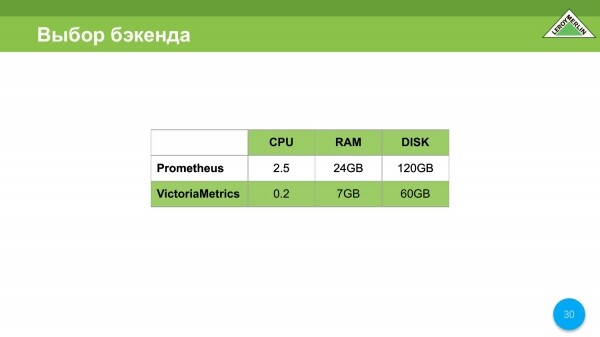
V našom prípade sme sa rozhodli pre VictoriaMetrics z jasných dôvodov, chceli sme ušetriť a podarilo sa nám to.
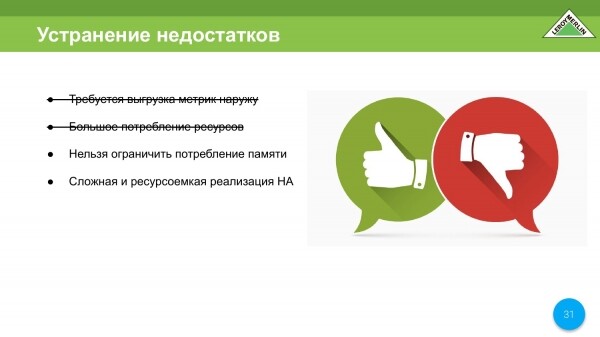
Ihneď vylučujeme dva body – export metrík a vysokú spotrebu zdrojov. Ostáva nám riešiť dva body, ktoré sme si ešte ponechali.
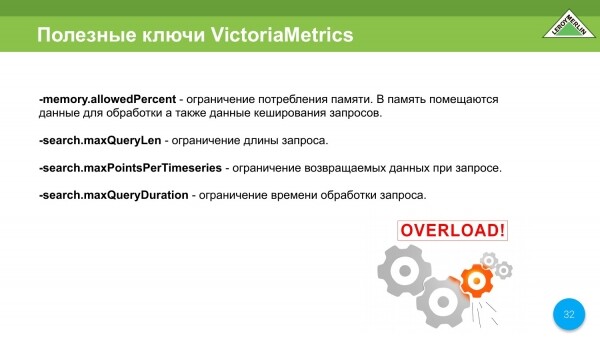
Hneď na začiatok uvediem, že ViktoriaMetrics uvažujeme ako úložisko metrík. Ale keďže chceme s najväčšou pravdepodobnosťou ponúknuť VictoriaMetrics ako úložisko pre celé Leroy, potrebujeme obmedziť tých, ktorí budú tento klaster používať, aby nám ho nezničili.
Existuje skvelá možnosť, ktorá umožňuje obmedziť čas, objem dát a čas vykonania.
A takisto je tu vynikajúca možnosť obmedziť spotrebu pamäte, čím môžeme nájsť ten pravý balans, ktorý nám umožní dosiahnuť normálnu rýchlosť práce a primeranú spotrebu zdrojov.
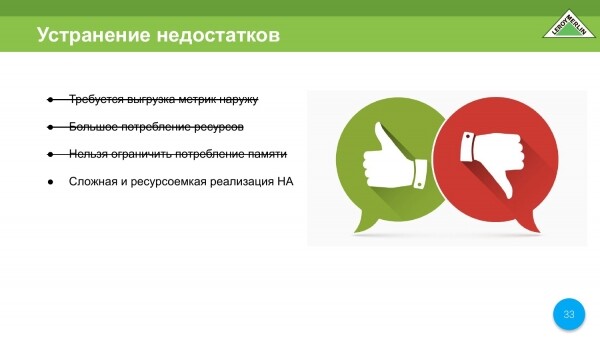
Týmto sme odškrtli ďalší bod, t. j. nemôžeme obmedziť spotrebu pamäte.
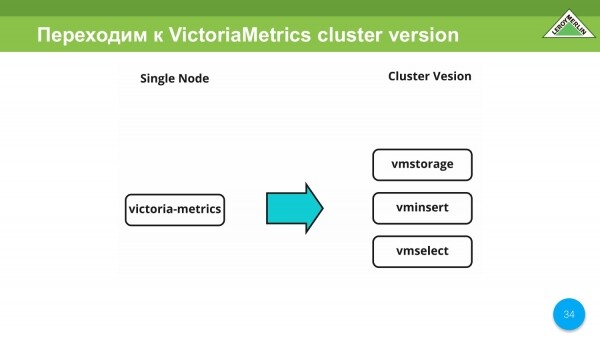
V prvých iteráciách sme testovali VictoriaMetrics Single Node. Potom prechádzame na VictoriaMetrics Cluster Version.
Tu nám otvárajú možnosti distribúcie rôznych služieb vo VictoriaMetrics v závislosti od toho, na čom budú bežať a aké zdroje spotrebúvajú. Je to veľmi flexibilné a pohodlné riešenie. Použili sme to na vlastnej koži.
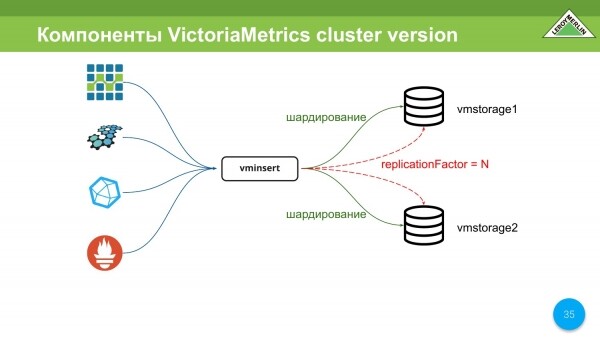
Hlavnými komponentmi VictoriaMetrics Cluster Version sú vmstorage. Tých môže byť N počet. V našom prípade sú zatiaľ dva.
A je tu vminsert. To je proxy server, ktorý nám umožňuje: realizovať shardovanie medzi všetkými storages, o ktorých sme mu povedali, a taktiež umožňuje replikáciu, t. j. budete mať aj shardovanie, aj replikáciu.
Vminsert podporuje protokoly OpenTSDB, Graphite, InfluxDB a remoteWrite od Prometheus.
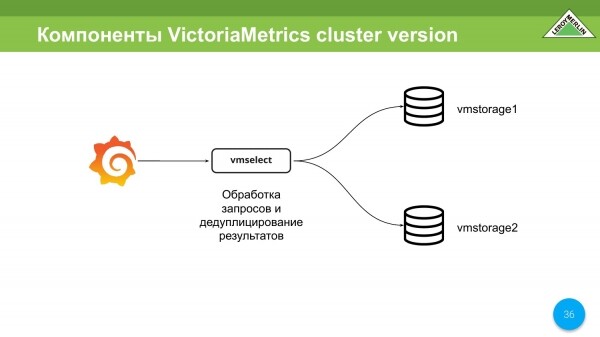
Existuje tiež vmselect. Jeho hlavnou úlohou je ísť do vmstorage, získať od nich dáta, deduplovať tieto dáta a odovzdať ich klientovi.
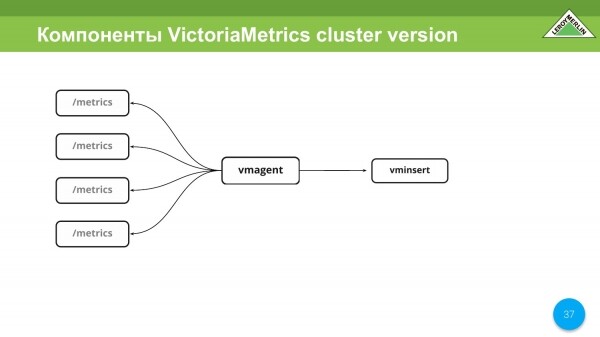
Je tu skvelá vec ako vmagent. Veľmi nám to páči. Umožňuje to konfigurovať presne tak, ako Prometheus, a pritom robiť všetko presne ako Prometheus. T. j. zbiera metriky z rôznych entít, služieb a odosiela ich do vminsert. Potom už všetko závisí od vás.
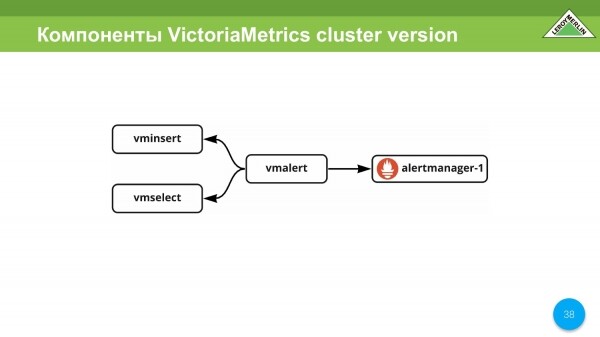
Ďalšia vynikajúca služba je vmalert, ktorá umožňuje ako backend používať VictoriaMetrics, získavať od vminsert a odosielať spracované dáta do vmselect. Spracováva samotné alerty a rules. V prípade alertov dostávame alert cez alertmanager.
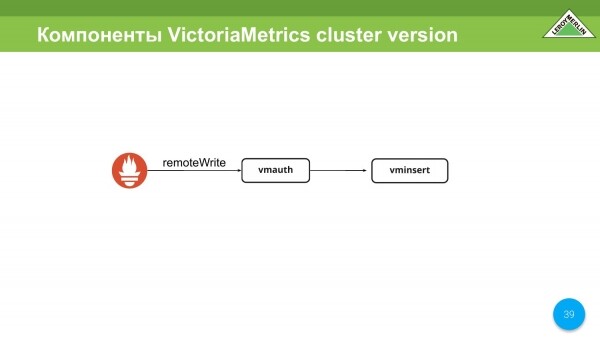
Existuje komponent wmauth. Mohol by sa používať, a možno aj nie (ešte sme sa s tým nerozhodli) ako systém autorizácie pri multitenancy verziách klastrov. Podporuje remoteWrite pre Prometheus a môže autorizovať na základe URL, presnejšie druhej jej časti, kam môžete alebo nemôžete písať.
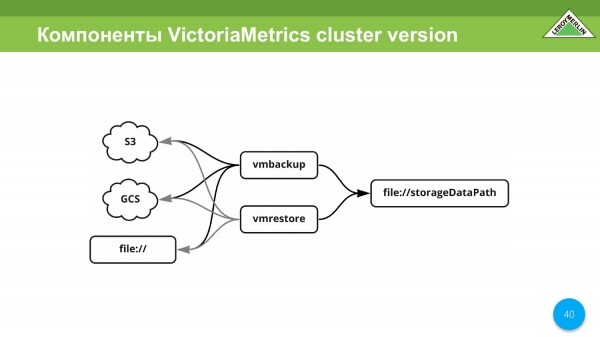
Existuje tiež vmbackup, vmrestore. To je v podstate obnova a zálohovanie všetkých dát. Ovláda S3, GCS, file.
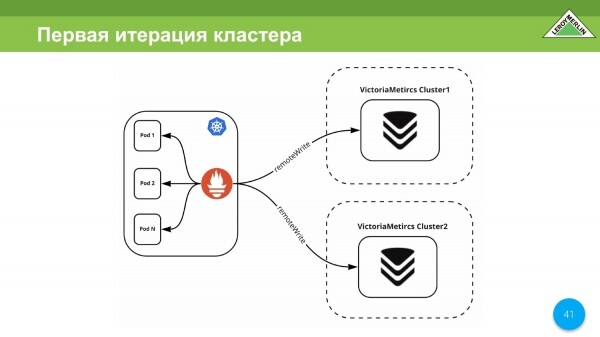
Prvá iterácia nášho klastru bola uskutočnená počas karantény. V tom čase neexistovala replikácia, preto naša iterácia pozostávala z dvoch rôznych a nezávislých klastrov, do ktorých sme cez remoteWrite prijímali údaje.
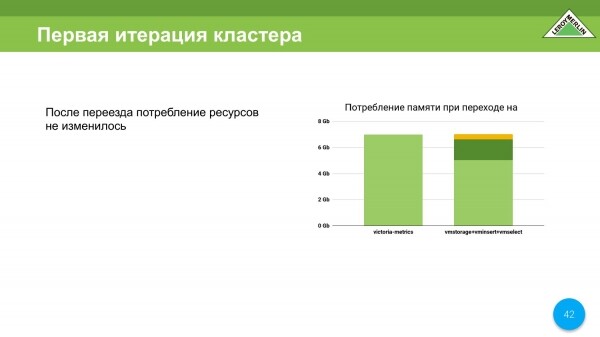
Tu chcem povedať, že keď sme prechádzali z VictoriaMetrics Single Node na VictoriaMetrics Cluster Version, zostali sme v rovnakých spotrebovaných zdrojoch, t.j. hlavné je pamäť. Dalo sa to takto distribuovať naše údaje, t.j. spotreba zdrojov.
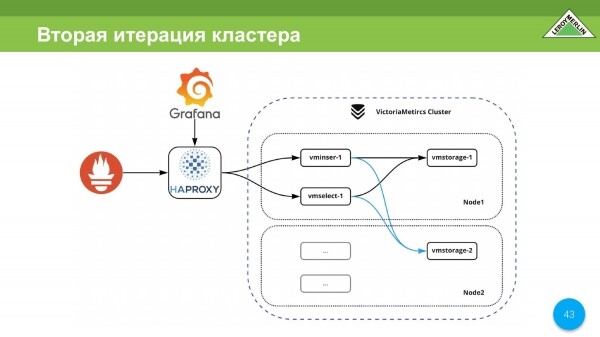
Tu už bola pridaná replikácia. Spojili sme všetko do jedného relatívne veľkého klastru. Všetky údaje máme ako shardované, tak aj replikované.
Celý klaster má N bodov prístupu, t.j. Prometheus môže pridávať údaje cez HAPROXY. Tu máme tento prístupový bod. A cez tento prístupový bod sa dá vstupovať do Grafany.
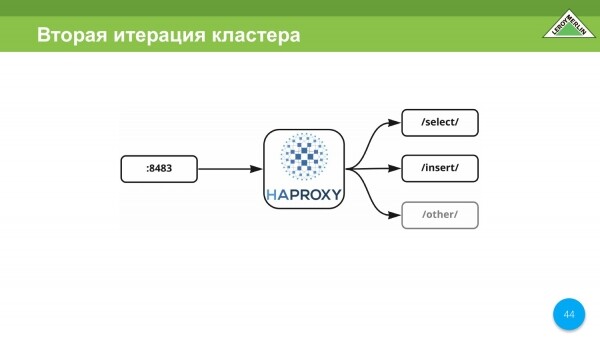
V našom prípade je HAPROXY jediný port, ktorý proxyzuje select, insert a ostatné služby do tohto klastru. V našom prípade nebolo možné vytvoriť jednu adresu, museli sme vytvoriť niekoľko prístupových bodov, pretože samotné virtuálne stroje, na ktorých beží VictoriaMetrics-klaster, sú v rôznych zónach jedného poskytovateľa cloudu, t.j. nie vo vnútri nášho cloudu, ale vonku.
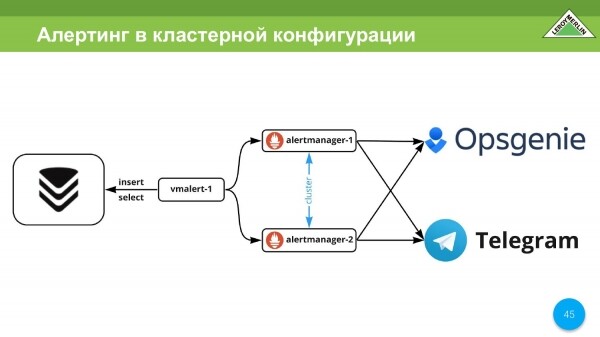
Máme alerting. Používame ho. Používame alertmanager od Prometheus. Ako kanál doručovania alertov využívame Opsgenie a Telegram. V Telegrame sa objavujú upozornenia od dev, možno niečo od prod, ale skôr niečo štatistické, potrebné inžinierom. A Opsgenie – je kritické. Toto sú telefonáty, správa incidentov.
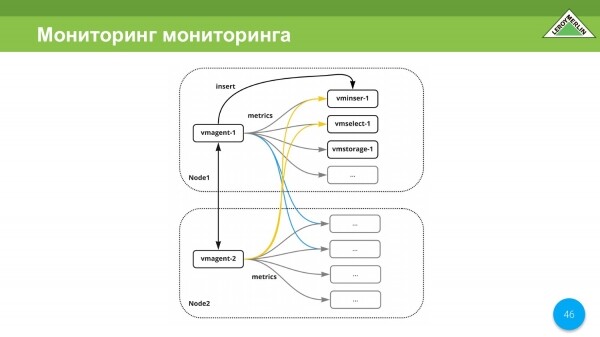
Večný otázka: „Kto monitoruje monitoring?“. V našom prípade monitoring monitoruje sám monitoring, pretože používame vmagent na každom uzle. A pretože naše uzly sú rozmiestnené po rôznych dátových centrách jedného poskytovateľa, v každom dátovom centre máme svoj kanál, sú nezávislé a aj keby prišlo k rozdeleniu mysle, stále dostaneme alerty. Áno, bude ich viac, ale je lepšie dostať viac alertov ako žiadne.
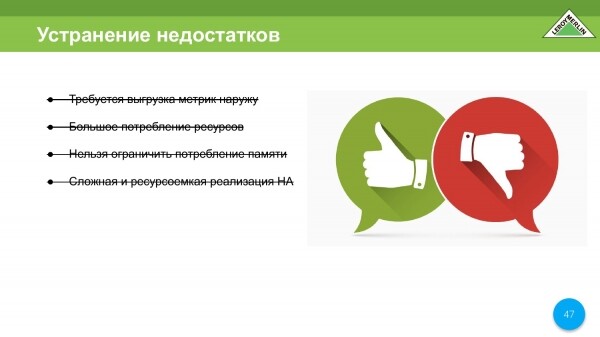
Koniec našej zoznamu s implementáciou HA.
A chcel by som tiež zdôrazniť skúsenosť s komunikáciou s komunitou VictoriaMetrics. Táto skúsenosť bola veľmi pozitívna. Chlapci sú ochotní. Snažia sa pochopiť každý prípad, ktorý sa navrhuje.
Založil som issues na GitHub. Rýchlo boli vyriešené. Existuje ešte pár issues, ktoré nie sú úplne uzavreté, ale už podľa kódu vidím, že práca týmto smerom prebieha.
Hlavná bolesť počas iterácií pre mňa bola v tom, že ak vypnem uzol, prvých 30 sekúnd nemal vminsert pochopenie, že backend neexistuje. To je teraz už vyriešené. A doslova za sekundu alebo dve sa údaje už zbierajú zo všetkých zostávajúcich uzlov a dopyt prestáva čakať na ten chýbajúci uzol.
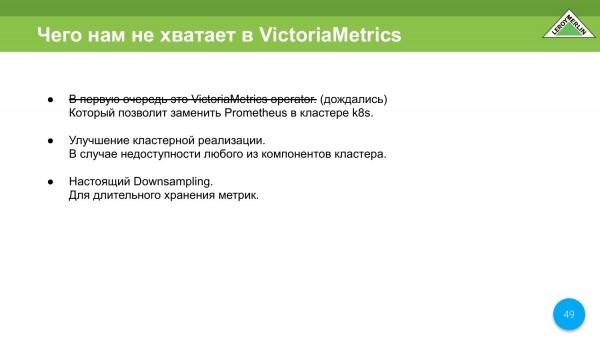
Chceli sme v nejakom momente od VictoriaMetrics, aby to bol VictoriaMetrics operator. Čakali sme naň. Teraz sme v aktívnej fáze budovania obálky nad VictoriaMetrics operator, aby sme získali všetky pravidlá predpočítania a pod. Prometheus, pretože dostatočne aktívne používame pravidlá, ktoré prichádzajú s operátorom Prometheus.
Existujú návrhy na zlepšenie klastrovej implementácie. Vystavil som ich vyššie.
A tiež veľmi túžime po downsamplingu. V našom prípade je downsampling potrebný výhradne na prehľadanie trendov. Hrubo povedané, jedna metrika počas dňa mi stačí. Tieto trendy potrebujeme na rok, tri, päť, desať rokov. A jedna hodnota metriky úplne stačí.
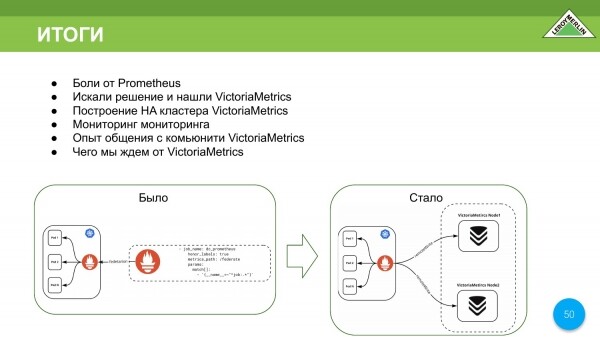
- Pocítili sme bolesť, ako aj niektorí naši kolegovia, pri používaní Prometheus.
- Pre nás sme si vybrali VictoriaMetrics.
- Dobre sa škáluje vertikálne aj horizontálne.
- Môžeme rozložiť rôzne komponenty na rôzny počet uzlov v klastri, obmedziť ich podľa objemu pamäte, pridať pamäť atď.
Budeme používať VictoriaMetrics, pretože sa nám veľmi páčila. Toto bolo a čo sa stalo.
Pár qr kódov na chat VictoriaMetrics, moje kontakty, technický radar LeroyMerlin.
Zdroj: habr.com
