

Dobrý deň.
Rozhodol som sa podeliť o svoj nález — plod úvah, pokusov a omylov.
Vo veľkej miere: toto nie je žiadny nález, samozrejme — všetko toto by malo byť dávno známe tým, ktorí sa zaoberajú aplikovanou štatistickou analýzou dát a optimalizáciou akýchkoľvek systémov, nie nevyhnutne len databázových.
A: áno, vedia o tom, píšu zaujímavé články o svojich výskumoch, (UPD.: v komentároch uviedli veľmi zaujímavý projekt: )
Na druhej strane: na prvý pohľad nevidím široké zmienky o takomto prístupe, na internete, medzi IT odborníkmi, DBA.
Takže, k podstate.
Predpokladajme, že máme úlohu: nastaviť nejaký servisný systém na spracovanie určitej práce.
O tejto práci — je známe: aká je, čím sa meria kvalita tejto práce a aký je kriterium na meranie tejto kvality.
Tiež predpokladajme, že je viac-menej známe, ako presne sa práca vykonáva v (alebo s) týmto servisným systémom.
"Viac-menej" — to znamená, že existuje možnosť pripraviť (alebo niekde získať) nejaký nástroj, utilitu, službu, ktorou je možné syntetizovať a predložiť systému testovú záťaž, dostatočne adekvátnu k tomu, čo bude v produkcii, v dostatočne adekvátnych podmienkach pre prácu v produkcii.
No a predpokladajme, že je známa sada regulovacích parametrov tohto servisného systému, pomocou ktorých je možné nastavovať tento systém, pokiaľ ide o výkonnosť jeho práce.
A, v čom je problém — nie je dostatočné pochopenie tohto servisného systému, také, ktoré umožňuje expertné nastavenie tohto systému pod budúcu záťaž na danej platforme a dosiahnuť potrebnú výkonnosť práce systému.
No. Tak to takmer vždy býva.
Čo tu môžeme urobiť.
Nuž prvé, čo mi napadne: pozrieť sa do dokumentácie k tomuto systému. Pochopiť — aké sú tam prípustné rozsahy na hodnoty regulovacích parametrov. A napríklad, metódou koordinačného zostupu, prispôsobiť hodnoty pre parametre systému v testoch.
T.j. nastaviť systému nejakú konfiguráciu, vo forme konkrétneho súboru hodnôt jeho nastavovacích parametrov.
Predložiť mu testovú záťaž, týmto nástrojom-utilitou, generátorom záťaže.
A sledovať veľkosť — reakciu, alebo metriky kvality výkonu systému.
Druhý myšlienkou môže byť záver, že — to je veľmi dlhé.
T.j.: ak je nastavovacích parametrov — veľa, ak prebehnuté rozsahy ich hodnôt — veľké, ak sa každý jednotlivý záťažový test vykonáva dlhú dobu, potom: áno, to všetko môže trvať neprijateľne dlho.
Takže tu sa dá pochopiť a spomenúť.
Možno zistiť, že v súbore hodnôt nastavovacích parametrov servisného systému — vektor, ako sekvencia nejakých hodnôt.
Každému takému vektoru, pri ostatných rovnakých (v tom, že tento vektor nie je ovplyvnený), zodpovedá celkom určité hodnotenie metriky — ukazovatele kvality výkonu systému, pod testovacou záťažou.
T.j.
Označme vektor konfigurácie systému ako  , kde
 ; Kde
 — počet parametrov konfigurácie systému, koľko ich je, týchto parametrov.
A hodnotenie metriky, ktorá zodpovedá danému  označíme ako
 , takže dostaneme funkciu:

Takže, potom: všetko okamžite upadá do, v mojom prípade: takmer zabudnutých študentských algoritmov na hľadanie extrému funkcie.
Dobre, ale tu vzniká organizačno-praktická otázka: aký presne algoritmus použiť.
- V zmysle — aby som sám menej programoval.
- A aby to fungovalo, t.j. nachádzalo extrém (ak nejaký existuje), aspoň — rýchlejším spôsobom než metódou gradientného zostupu.
Prvý moment naznačuje, že sa treba pozrieť smerom k nejakým prostrediam, v ktorých sú také algoritmy — už implementované, a sú, v nejakej podobe, pripravené na použitie v kóde.
No, ja poznám python a cran-r
Druhý moment naznačuje, že je potrebné prečítať si o samotných algoritmoch, aké existujú, aké majú požiadavky, charakteristiky v práci.
A čo poskytujú, môžu mať užitočné vedľajšie efekty - výsledky, buď priamo, od samotného algoritmu.
Alebo ich možno získať z výsledkov práce algoritmu.
Tu záleží veľa na vstupných podmienkach.
Například ak, z nejakých dôvodov, potrebujete rýchlejšie získať výsledok, potom sa treba pozrieť smerom k algoritmom gradientného zostupu, vybrať si niektorý z nich.
Alebo, ak nie je tak dôležitý čas, napríklad môžete vyskúšať metódy stochastickej optimalizácie, napríklad genetický algoritmus.
Navrhuje sa zvážiť prácu tohto prístupu pri výbere konfigurácie systému, za pomoci genetického algoritmu, na nasledujúcej, povedzme, experimentálnej práci.
Výchozie:
- Nech je, ako servisný systém:
oracle xe 18c - Nech ona - obsluhuje transakčnú činnosť a cieľ: dosiahnuť čo najvyššiu priepustnosť systému na transakcie/s.
- Transakcie - sú veľmi rôzne, z hľadiska charakteru práce s dátami a kontextu práce.
Dohodnime sa, že ide o transakcie, ktoré nezapracovávajú veľké množstvo tabulkových dát.
V tom zmysle, že negenerujú undo-dáta viac ako redo a nepracujú s veľkými percentami riadkov z veľkých tabuliek.
Sú to transakcie, ktoré menia jeden riadok v relatívne veľkej tabuľke, s malým počtom indexov nad touto tabuľkou.
V takom prípade: produktivita systému pri spracovaní transakcií bude, s výhradou, určená kvalitou spracovania databázou redo-dát.
Výhrada - ak hovoríme presne o nastaveniach systému.
Pretože vo všeobecnosti môžu byť napríklad transakčné blokácie medzi SQL reláciami, kvôli dizajnu používateľskej práce s tabulkovými dátami a/alebo modelom tabuliek.
Ktoré samozrejme negatívne ovplyvnia metriky tps a to bude exogénny, voči systému, faktor: no takto bol navrhnutý model tabuliek a práca s dátami, že dochádza k blokádam.
Preto, pre čistotu experimentu, vylúčime tento faktor, nižšie objasním, ako presne.
- Predpokladajme, pre definitívnosť, že 100% predkladaných v systéme SQL príkazov: sú to DML príkazy.
Nech charakteristiky používateľskej práce so systémom: sú rovnaké, v testoch.
A to konkrétne: počet SQL relácií, tabulkové dáta, to, ako s nimi pracujú SQL relácie. - Systém pracuje v
FORCE LOGGING,ARCHIVELOGrežimoch. Flashback databázový režim je vypnutý, na úrovni systému. - Redo logy: sú umiestnené v samostatnom súborovom systéme, na samostatnom "disku";
Celá ostatná časť fyzickej komponenty DB: v inom, samostatnom FS, na samostatnom "disku":
Podrobnejšie o konštrukcii fyzickej komponenty experimentálnej DB
SQL> select status||' '||name from v$controlfile;
 /db/u14/oradata/XE/control01.ctl
SQL> select GROUP#||' '||MEMBER from v$logfile;
1 /db/u02/oradata/XE/redo01_01.log
2 /db/u02/oradata/XE/redo02_01.log
SQL> select FILE_ID||' '||TABLESPACE_NAME||' '||round(BYTES/1024/1024,2)||' '||FILE_NAME as col from dba_data_files;
4 UNDOTBS1 2208 /db/u14/oradata/XE/undotbs1_01.dbf
2 SLOB 128 /db/u14/oradata/XE/slob01.dbf
7 USERS 5 /db/u14/oradata/XE/users01.dbf
1 SYSTEM 860 /db/u14/oradata/XE/system01.dbf
3 SYSAUX 550 /db/u14/oradata/XE/sysaux01.dbf
5 MONITOR 128 /db/u14/oradata/XE/monitor.dbf
SQL> !cat /proc/mounts | egrep "\/db\/u[0-2]"
/dev/vda1 /db/u14 ext4 rw,noatime,nodiratime,data=ordered 0 0
/dev/mapper/vgsys-ora_redo /db/u02 xfs rw,noatime,nodiratime,attr2,nobarrier,inode64,logbsize=256k,noquota 0 0
Pôvodne som chcel použiť na tieto podmienky zaťaženia DBMS transakcie
Má vynikajúcu vlastnosť, citujem autora:
V srdci SLOB je „SLOB metóda“. Cieľom SLOB metódy je testovať platformy
bez kontencie aplikácie. Nemôžete využiť maximálny výkon hardvéru
pomocou aplikačného kódu, ktorý je napríklad obmedzený zamykaním aplikácie alebo dokonca
zdieľaním blokov Oracle Database. To je pravda—existuje administratívny náklad pri zdieľaní dát
v blokoch dát! Ale SLOB—vo svojej predvolenej implementácii—je imúnny voči takémuto obsahu.
Tento výrok: je pravda, že je to tak.
Je pohodlné regulovať úroveň paralelizmu skľ-sesií, to je kľúč -t spustenia nástroja runit.sh zložené z SLOB-u
Reguluje sa percento DML príkazov v počte skľ-iek, ktoré odosiela do DBMS každá skľ-sessia, parameter UPDATE_PCT
Samostatne a veľmi pohodlne: SLOB sám, pred a po zaťažení relácie — pripravuje statspak alebo AWR snímky (čo je predpísané, aby sa pripravovalo).
Avšak ukázalo sa, že SLOB nepodporuje prácu skľ-sesií kratších ako 30 sekúnd.
Preto som najprv naprogramoval svoj, pracovný variant nástroja na zaťaženie, a potom zostal v prevádzke.
Ujasním, o nástroji na zaťaženie — čo robí a ako, pre jasnosť.
V podstate nástroj na zaťaženie vyzerá takto:
Kód pracovníka
function dotx()
{
local v_period="$2"
[ -z "v_period" ] && v_period="0"
source "/home/oracle/testingredotracе/config.conf"

$ORACLE_HOME/bin/sqlplus -S system/${v_system_pwd} << __EOF__
whenever sqlerror exit failure
set verify off
set echo off
set feedback off

define wnum="$1"
define period="$v_period"
set appinfo worker_&&wnum

declare
 v_upto number;
 v_key  number;
 v_tots number;
 v_cts  number;
begin
 select max(col1) into v_upto from system.testtab_&&wnum;
 SELECT (( SYSDATE - DATE '1970-01-01' ) * 86400 ) into v_cts FROM DUAL;
 v_tots := &&period + v_cts;
 while v_cts <= v_tots
 loop
  v_key:=abs(mod(dbms_random.random,v_upto));
  if v_key=0 then
   v_key:=1;
  end if;
  update system.testtab_&&wnum t
  set t.object_name=translate(dbms_random.string('a', 120), 'abcXYZ', '158249')
  where t.col1=v_key
  ;
  commit;
  SELECT (( SYSDATE - DATE '1970-01-01' ) * 86400 ) into v_cts FROM DUAL;
 end loop;
end;
/

exit
__EOF__
}
export -f dotx
Pracovníci sa spúšťajú týmto spôsobom:
Spustenie pracovníkov
echo "starting test, duration: ${TEST_DURATION}" >> "$v_logfile"
for((i=1;i> "$v_logfile"
 dotx "$i" "${TEST_DURATION}" &
done
echo "waiting..." >> "$v_logfile"
wait
A tabuliek pre pracovníkov sa pripravujú takto:
Vytvorenie tabuliek
function createtable() {
source "/home/oracle/testingredotrace/config.conf"
$ORACLE_HOME/bin/sqlplus -S system/${v_system_pwd} << __EOF__
whenever sqlerror continue
set verify off
set echo off
set feedback off

define wnum="$1"
define ts_name="slob"

begin
 execute immediate 'drop table system.testtab_&&wnum';
exception when others then null;
end;
/

create table system.testtab_&&wnum tablespace &&ts_name as
select rownum as col1, t.*
from sys.dba_objects t
where rownum> "$v_logfile"
T.j. pre každého pracovníka (prakticky: samostatná SQL relácia v databáze) sa vytvára samostatná tabuľka, s ktorou pracovník pracuje.
Týmto sa dosahuje absencia transakčných zámkov medzi SQL reláciami pracovníkov.
Každý pracovník robí to isté so svojou tabuľkou, tabuľky sú všetky rovnaké.
Všetci pracovníci vykonávajú prácu počas rovnakého časového úseku.
A to dostatočne dlhého času, aby, napríklad, došlo k log-switchingu, a nie jedenkrát.
No a samozrejme vznikali s tým súvisiace náklady a efekty.
V mojom prípade som nastavoval trvanie práce pracovníkov na 8 minút.
Úryvok zo správy Statspack, s popisom práce databázy pod záťažou.
Databáza    DB Id    Inštancia     Inst Num  Startup Čas   Verzia     RAC
~~~~~~~~ ----------- ------------ -------- --------------- ----------- ---
          2929910313 XE                  1 07-Sep-20 23:12 18.0.0.0.0  NIE

Názov hostiteľa             Platforma                CPU Jadrá Sockets   Pamäť (G)
~~~~ ---------------- ---------------------- ----- ----- ------- ------------
     billing.izhevsk1 Linux x86 64-bit           2     2       1         15.6

Snapshot       Snap Id     Snap Čas      Relácie Curs/Sess Komentár
~~~~~~~~    ---------- ------------------ -------- --------- ------------------
Začiatok Snapshot:       1630 07-Sep-20 23:12:27       55        .7
  Koniec Snapshot:       1631 07-Sep-20 23:20:29       62        .6
   Elapsed:       8.03 (min) Priem. Akt. Relácie:       8.4
   DB čas:      67.31 (min)      DB CPU:      15.01 (min)

Cache Veľkosti            Začiatok        Koniec
~~~~~~~~~~~       ---------- ----------
    Buffer Cache:     1,392M              Štandardná Veľkosť Bloku:         8K
     Zdieľaná Pool:       288M                  Log Buffer:   103,424K

Profil Zatiaženia              Na Sekundu    Na Transakciu    Na Exec    Na Hovor
~~~~~~~~~~~~      ------------------  ----------------- ----------- -----------
      DB čas(s):                8.4                0.0        0.00        0.20
       DB CPU(s):                1.9                0.0        0.00        0.04
       Redo veľkosť:        7,685,765.6              978.4
   Logické prečítania:           60,447.0                7.7
   Zmeny bloku:           47,167.3                6.0
  Fyzické prečítania:                8.3                0.0
 Fyzické zápisy:              253.4                0.0
      Calls používateľa:               42.6                0.0
          Parsovanie:               23.2                0.0
     Ťažké parsovanie:                1.2                0.0
W/A MB spracované:                1.0                0.0
          Logins:                0.5                0.0
        Executions:           15,756.5                2.0
       Rollbacks:                0.0                0.0
    Transakcie:            7,855.1
Vraciame sa k zadaniu laboratórnej práce.
Budeme, pri rovnakých podmienkach, variabilizovať hodnoty nasledujúcich parametrov laboratórnej DB:
- Veľkosť žurnálnych skupín DB. Rozsah hodnôt: [32, 1024] MByte;
- Počet žurnálnych skupín DB. Rozsah hodnôt: [2,32];
log_archive_max_processesrozsah hodnôt: [1,8];commit_loggingsú povolené dve hodnoty:batch|immediate;commit_waitsú povolené dve hodnoty:wait|nowait;log_bufferrozsah hodnôt: [2,128] MByte.log_checkpoint_timeoutrozsah hodnôt: [60,1200] sekúnddb_writer_processesrozsah hodnôt: [1,4]undo_retentionrozsah hodnôt: [30;300] sekúndtransactions_per_rollback_segmentrozsah hodnôt: [1,8]disk_asynch_iosú povolené dve hodnoty:true|false;filesystemio_optionssú povolené nasledujúce hodnoty:none|setall|directIO|asynch;db_block_checkingsú povolené nasledujúce hodnoty:OFF|LOW|MEDIUM|FULL;db_block_checksumsú povolené nasledujúce hodnoty:OFF|TYPICAL|FULL;
Človek s skúsenosťou v správe oracle databáz určite môže povedať, aké hodnoty je potrebné nastaviť z uvedených parametrov a ich povolených hodnôt, aby sa dosiahla vyššia produktivita DB pre prácu s údajmi, ktorá je definovaná aplikačným kódom vyššie.
Ale.
Cieľom laboratórnej práce je ukázať, že optimalizačný algoritmus sám o sebe je relatívne rýchly a presný.
Stačí len nahliadnuť do dokumentácie k nastaviteľnému systému, presne do tej miery, ako je potrebné zistiť, ktoré parametre a v akých rozmedziach zmeniť.
A tiež: nakódovať kód, ktorý bude implementovať prácu s nastaviteľným systémom vybraného optimalizačného algoritmu.
Teda, teraz o kóde.
Pred chvíľou som hovoril o cran-r, t.j.: všetky manipulácie s nastaviteľným systémom sú orchestrálne spracované vo forme R-skriptu.
Vlastne úlohou, analýzou, výberom podľa hodnoty metriky, stavovými vektormi systému je balík GA ()
Balík v tomto prípade nie je veľmi vhodný, v zmysle toho, že očakáva zadanie vektorov (chromozómov, ak hovoríme v terminológii balíka) ako celých čísel s desatinnou časťou.
A môj vektor z hodnotení nastavovacích parametrov pozostáva z 14 veličín — celých čísel a reťazcových hodnôt.
Problém sa samozrejme ľahko obchádza priradením reťazcovým veličinám určitých čísel.
Teda výsledný hlavný kus R-skriptu vyzerá takto:
Volanie GA::ga
cat( "", file=v_logfile, sep="n", append=F)

pSize = 10
elitism_value=1
pmutation_coef=0.8
pcrossover_coef=0.1
iterations=50

gam=GA::ga(type="real-valued", fitness=evaluate,
lower=c(32,2, 1,1,1,2,60,1,30,1,0,0, 0,0), upper=c(1024,32, 8,10,10,128,800,4,300,8,10,40, 40,30),
popSize=pSize,
pcrossover = pcrossover_coef,
pmutation = pmutation_coef,
maxiter=iterations,
run=4,
keepBest=T)
cat( "GA-session is done" , file=v_logfile, sep="n", append=T)
gam@solution
Tu, s pomocou lower a upper atribútov podprogramu ga sa v podstate určuje oblasť vyhľadávacieho priestoru, v rámci ktorého sa bude hľadať taký vektor (alebo vektory), pre ktoré bude dosiahnutá maximálna hodnota fitness funkcie.
Podprogram ga vykonáva vyhľadávanie s maximálnou hodnotou fitness funkcie.
Takže, v tomto prípade, je potrebné, aby fitness funkcia chápala vektor ako súbor hodnôt pre konkrétne parametre DBMS a získavala metriky zo systému.
T.j.: koľko, pri danom nastavení DBMS a tomto zaťažení na DBMS, systém spracováva transakcií za sekundu.
T.j., ak to podrobne rozložíme, je potrebné, aby v rámci fitness funkcie prebiehala takáto komplexná operácia:
- Spracovanie vstupného vektora čísel — prevod na hodnoty pre parametre DBMS.
- Pokús o vytvorenie požadovaného počtu redo-skupín, určenej veľkosti. A táto snaha môže byť neúspešná.
Existujúce v subd žurnálové skupiny, v určitom počte a určitej veľkosti, by mali byť pre čistotu experimentu odstránené. - V prípade úspechu predchádzajúceho bodu: nastavenie hodnotovej bázy konfiguračných parametrov (opäť: môže nastať chyba)
- V prípade úspechu predchádzajúceho bodu: zastavenie subd, spustenie subd, aby nové hodnoty parametrov nadobudli účinnosť. (opäť: môže nastať chyba)
- V prípade úspechu predchádzajúceho bodu: vykonať záťažový test. získať metriky z subd.
- Vrátiť subd do pôvodného stavu, t.j. odstrániť ďalšie žurnálové skupiny, vrátiť do prevádzky pôvodnú konfiguráciu subd.
Kód fitness funkcie
evaluate=function(p_par) {
v_module="evaluate"
v_metric=0
opn=NULL
opn$rg_size=round(p_par[1],digit=0)
opn$rg_count=round(p_par[2],digit=0)
opn$log_archive_max_processes=round(p_par[3],digit=0)
opn$commit_logging="BATCH"
if ( round(p_par[4],digit=0) > 5 ) {
 opn$commit_logging="IMMEDIATE"
}
opn$commit_logging=paste("'", opn$commit_logging, "'",sep="")

opn$commit_wait="WAIT"
if ( round(p_par[5],digit=0) > 5 ) {
 opn$commit_wait="NOWAIT"
}
opn$commit_wait=paste("'", opn$commit_wait, "'",sep="")

opn$log_buffer=paste(round(p_par[6],digit=0),"m",sep="")
opn$log_checkpoint_timeout=round(p_par[7],digit=0)
opn$db_writer_processes=round(p_par[8],digit=0)
opn$undo_retention=round(p_par[9],digit=0)
opn$transactions_per_rollback_segment=round(p_par[10],digit=0)
opn$disk_asynch_io="true"
if ( round(p_par[11],digit=0) > 5 ) {
 opn$disk_asynch_io="false"
}

opn$filesystemio_options="none"
if ( round(p_par[12],digit=0) > 10 && round(p_par[12],digit=0)  20 && round(p_par[12],digit=0)  30 ) {
 opn$filesystemio_options="asynch"
}

opn$db_block_checking="OFF"
if ( round(p_par[13],digit=0) > 10 && round(p_par[13],digit=0)  20 && round(p_par[13],digit=0)  30 ) {
 opn$db_block_checking="FULL"
}

opn$db_block_checksum="OFF"
if ( round(p_par[14],digit=0) > 10 && round(p_par[14],digit=0)  20 ) {
 opn$db_block_checksum="FULL"
}

v_vector=paste(round(p_par[1],digit=0),round(p_par[2],digit=0),round(p_par[3],digit=0),round(p_par[4],digit=0),round(p_par[5],digit=0),round(p_par[6],digit=0),round(p_par[7],digit=0),round(p_par[8],digit=0),round(p_par[9],digit=0),round(p_par[10],digit=0),round(p_par[11],digit=0),round(p_par[12],digit=0),round(p_par[13],digit=0),round(p_par[14],digit=0),sep=";")
cat( paste(v_module," try to evaluate vector: ", v_vector,sep="") , file=v_logfile, sep="n", append=T)

rc=make_additional_rgroups(opn)
if ( rc!=0 ) {
 cat( paste(v_module,"make_additional_rgroups failed",sep="") , file=v_logfile, sep="n", append=T)
 return (0)
}

v_rc=0
rc=set_db_parameter("log_archive_max_processes", opn$log_archive_max_processes)
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("commit_logging", opn$commit_logging )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("commit_wait", opn$commit_wait )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("log_buffer", opn$log_buffer )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("log_checkpoint_timeout", opn$log_checkpoint_timeout )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("db_writer_processes", opn$db_writer_processes )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("undo_retention", opn$undo_retention )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("transactions_per_rollback_segment", opn$transactions_per_rollback_segment )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("disk_asynch_io", opn$disk_asynch_io )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("filesystemio_options", opn$filesystemio_options )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("db_block_checking", opn$db_block_checking )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("db_block_checksum", opn$db_block_checksum )
if ( rc != 0 ) {  v_rc=1 }

if ( rc!=0 ) {
 cat( paste(v_module," can not startup db with that vector of settings",sep="") , file=v_logfile, sep="n", append=T)
 rc=stop_db("immediate")
 rc=create_spfile()
 rc=start_db("")
 rc=remove_additional_rgroups(opn)
 return (0)
}

rc=stop_db("immediate")
rc=start_db("")
if ( rc!=0 ) {
 cat( paste(v_module," can not startup db with that vector of settings",sep="") , file=v_logfile, sep="n", append=T)
 rc=stop_db("abort")
 rc=create_spfile()
 rc=start_db("")
 rc=remove_additional_rgroups(opn)
 return (0)
}

rc=run_test()
v_metric=getmetric()

rc=stop_db("immediate")
rc=create_spfile()
rc=start_db("")
rc=remove_additional_rgroups(opn)

cat( paste("result: ",v_metric," ",v_vector,sep="") , file=v_logfile, sep="n", append=T)
return (v_metric)
}
Teda, všetka práca: sa vykonáva vo funkcii fitness.
ga-podprogram, vykonáva spracovanie vektorov, alebo presnejšie povedané – chromozómov.
V ktorej je pre nás najdôležitejšia: selekcia chromozómov s takými génmi, pri ktorých fitness funkcia vydáva vysoké hodnoty.
To je v podstate proces hľadania optimálneho súboru chromozómov vo vektorovom N-rozmernom priestore hľadania.
Veľmi jasné, podrobné , s príkladmi R-kódu, fungovania genetického algoritmu.
Samostatne zdôrazním dva technické aspekty.
Pomocné volania z funkcie evaluate, napríklad zastavenie-spustenie, nastavenie hodnoty parametra databázy, sa vykonávajú na základe cran-r funkcie system2
S pomocou ktorej: sa volá už nejaký bash skript alebo príkaz.
Napríklad:
set_db_parameter
set_db_parameter=function(p1, p2) {
v_module="set_db_parameter"
v_cmd="/home/oracle/testingredotrace/set_db_parameter.sh"
v_args=paste(p1," ",p2,sep="")

x=system2(v_cmd, args=v_args, stdout=T, stderr=T, wait=T)
if ( length(attributes(x)) > 0 ) {
 cat(paste(v_module," failed with: ",attributes(x)$status," ",v_cmd," ",v_args,sep=""), file=v_logfile, sep="n", append=T)
 return (attributes(x)$status)
}
else {
 cat(paste(v_module," ok: ",v_cmd," ",v_args,sep=""), file=v_logfile, sep="n", append=T)
 return (0)
}
}
Druhý aspekt – riadok evaluate funkcie, s uchovaním konkrétnej hodnoty metriky a jej zodpovedajúceho nastavovacieho vektora, do log súboru:
cat( paste("result: ",v_metric," ",v_vector,sep="") , file=v_logfile, sep="n", append=T)Je to dôležité, pretože z tohto súboru dát, môžeme získať ďalšie informácie o tom, ktorý z komponentov nastavovacieho vektora viac, alebo menej ovplyvňuje hodnotu metriky.
Teda: bude možné vykonať analýzu dôležitosti atribútov.
Takže, čo môže vzniknúť.
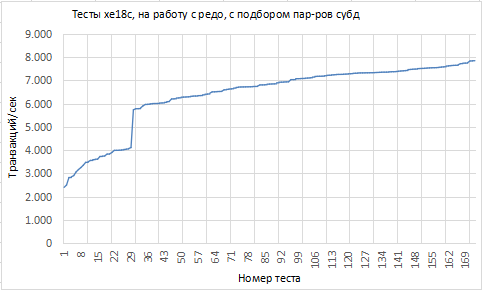
V podobe grafu, ak zoradíme testy podľa rastúcej metriky, obnova je takáto:
Niektoré údaje, zodpovedajúce extrémnym hodnotám metriky:
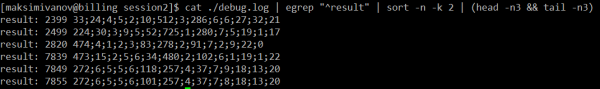
Tu, na snímke s výsledkami, upresním: hodnoty nastavovacieho vektora – sú dané v termínoch kódu fitness funkcie, nie v termínoch zoznamu parametrov / rozsahov hodnôt parametrov, ktorý bol formulovaný vyššie v texte.
No. Je to veľa, alebo málo, ~8k tps: otázka je samostatná.
V rámci laboratórnej práce – táto číslica nie je podstatná, dôležitá je dynamika, ako sa táto hodnota mení.
Dynamika je tu dobrá.
Je očividné, že, aspoň jeden faktor, významne ovplyvňujúci hodnotu metriky, ga-algoritmus, prechádzajúc vektory chromozómov: zasiahlo.
Súdľa podľa dosť živej dynamiky hodnôt krivky — je tu ešte minimálne jeden faktor, ktorý, hoci je významne menší, predsa len ovplyvňuje.
Tu je potrebné attribute-importance analyzovať, aby sme pochopili, ktoré atribúty (nuž, v tomto prípade — komponenty nastavenia vektora) a akým spôsobom ovplyvňujú hodnotu metriky.
A na základe týchto informácií: pochopiť — ktoré faktory boli ovplyvnené zmenami významných atribútov.
Vykonať attribute-importance to môže byť všetkými možnými spôsobmi.
Mne sa na tieto účely páči algoritmus randomForest rovnomenného R balíka ()
randomForest, ako chápem jeho fungovanie vo všeobecnosti a jeho prístup k hodnoteniu významnosti atribútov osobitne, vytvára akýsi model závislosti odpovedajúcej premennej na atribútoch.
V našom prípade je odpovedajúca premenná — metrika získaná zo SÚDB, v záťažových testoch: tps;
A atribúty to sú — komponenty nastavenia vektora.
Takže randomForest hodnotí významnosť každého atribútu modelu dvomi číslami: %IncMSE — ako prítomnosť/absencia daného atribútu v modeli mení kvalitu MSE tohto modelu (Mean Squared Error);
A IncNodePurity — to je číslo, ktoré zobrazuje, akým spôsobom, na základe hodnôt tohto atribútu, je možné rozdeliť dataset s pozorovaniami tak, aby v jednej časti boli dáta s nejakou jednou hodnotou vysvetľovanej metriky, a v druhej s inou hodnotou metriky.
Nuž t.j.: do akej miery je to klasifikačný atribút (najvýraznejšie, rusky hovoriace vysvetlenie k randomforest-u videl ).
Pracovnícko-rolnícky R kód pre spracovanie datasetu s výsledkami záťažových testov:
x=NULL
v_data_file=paste('\/tmp\/data1.dat',sep="")
x=read.table(v_data_file, header = TRUE, sep = ";", dec=",", quote = ""'", stringsAsFactors=FALSE)
colnames(x)=c('metric','rgsize','rgcount','lamp','cmtl','cmtw','lgbffr','lct','dbwrp','undo_retention','tprs','disk_async_io','filesystemio_options','db_block_checking','db_block_checksum')

idxTrain=sample(nrow(x),as.integer(nrow(x)*0.7))
idxNotTrain=which(! 1:nrow(x) %in% idxTrain )
TrainDS=x[idxTrain,]
ValidateDS=x[idxNotTrain,]

library(randomForest)
#mtry=as.integer( sqrt(dim(x)[2]-1) )
rf=randomForest(metric ~ ., data=TrainDS, ntree=40, mtry=3, replace=T, nodesize=2, importance=T, do.trace=10, localImp=F)
ValidateDS$predicted=predict(rf, newdata=ValidateDS[,colnames(ValidateDS)!="metric"], type="response")
sum((ValidateDS$metric-ValidateDS$predicted)^2)
rf$importance
Môžete rovno ručne vybrať hyperparametre algoritmu a, orientujúc sa na kvalitu modelu, vybrať model presnejšie predpovedajúci na validačnom datasete.
Môžete napísať nejakú funkciu pre túto prácu (inak — opäť, na nejakom optimalizačnom algoritme).
Môžete využiť R balík caret, nie je podstatné.
Nakoniec, v tomto prípade dostaneme takýto výsledok pre hodnotenie dôležitosti atribútov:
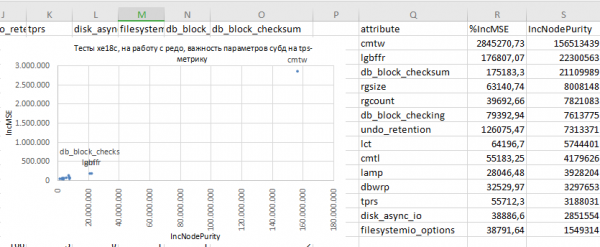
Takže, môžeme prejsť ku globálnym úvahám:
- Ukazuje sa, že v týchto podmienkach testovania bol najvýznamnejší parameter
commit_wait
Technicky určuje režim vykonávania io operácie zápisu redo údajov z log bufferu DB do aktuálnej žurnálovej skupiny: synchronný alebo asynchronný.
Hodnotanowaitpri ktorom dochádza k prakticky vertikálnemu, násobnému nárastu hodnoty metriky tps: to je zapnutie asynkronného módu io v redo skupinách.
Samostatná otázka — treba, alebo netreba to robiť v produkčnej DB. Tu sa obmedzujem len na konštatovanie: je to významný faktor. - Logicky, veľkosť log bufferu DB sa ukazuje ako významný faktor.
Čím menšia je veľkosť log bufferu, tým menšia je jeho vyrovnávacia kapacita, tým častejšie dochádza k jeho preplneniam a/alebo k nemožnosti uvoľniť v ňom voľné miesto pre dávku nových redo údajov.
A znamená to: oneskorenia spojené s alokovaním priestoru v log buffere a/alebo s vypúšťaním redo údajov z neho do redo skupín.
Tieto oneskorenia, samozrejme, by mali ovplyvňovať a ovplyvňujú priepustnosť DB v transakciách. - Parameter
db_block_checksum: nuž, takisto, v podstate, je to jasné — spracovanie transakcií vedie k vytváraniu dirty blokov v vyrovnávacej pamäti DB.
Ktoré, pri zapnutej kontrole checksumov dátových blokov, musí databáza spracovať — vypočítať tieto checksumy z obsahu dátového bloku a porovnať ich s tým, čo je napísané v hlavičke dátového bloku: súhlasí/nesúhlasí.
Takáto práca, opäť, nemôže nepredlžovať spracovanie údajov, nuž a zodpovedajúci parameter a mechanizmus, ktorý tento parameter určuje — sa ukazujú ako významné.
Z tohto dôvodu dodávateľ ponúka v dokumentácii k tomuto parametru rôzne jeho (parametra) hodnoty a zdôrazňuje, že áno, dopad bude, ale rôzne hodnoty, až po "vypnuté" a rôzne dopady, môžete si vybrať.
A globálny záver.
Prístup, v podstate: sa ukazuje ako plne funkčný.
Umožňuje na raných štádiách záťažového testovania určitej servisnej sústavy zvoliť jej (sústavy) optimálnu konfiguráciu pod záťažou bez toho, aby ste sa museli príliš zaoberať špeciálnosťami nastavenia systému pod záťažou.
Ale nezahŕňa to úplne — aspoň na úrovni pochopenia: "regulačných ovládačov" a prípustných rozsahov otáčania týchto ovládačov je potrebné poznať systém.
Ďalej prístup relatívne rýchlo nájde optimálnu konfiguráciu systému.
A na základe testovania je možné získať informácie o povahe vzťahu metriky kvality práce systému a hodnôt nastavení parametrov systému.
To samozrejme prispeje k vzniku tohto hĺbkového pochopenia systému, jeho fungovania, aspoň — pod danou záťažou.
Prakticky to znamená: pomer nákladov na pochopenie nastaviteľného systému a nákladov na prípravu takéhoto testovania práce systému.
Osobitne zdôrazním: v tomto prístupe je kriticky dôležitá adekvátnosť testovania systému vzhľadom na podmienky jeho prevádzky, aké bude mať pri produkčnej prevádzke.
Ďakujem za vašu pozornosť a čas.
Zdroj: habr.com
