

Klasifikácia dát na základe obsahu je otvorená úloha. Tradičné systémy prevencie straty dát (DLP) túto úlohu riešia odobratím odtlačkov príslušných dát a monitorovaním koncových bodov na odber odtlačkov. Zohľadňujúc veľké množstvo neustále sa meniaceho dátového obsahu na Facebooku, tento prístup nie je len neškálovateľný, ale ani neefektívny pri určovaní polohy dát. Tento článok sa zaoberá end-to-end systémom, ktorý bol vybudovaný na detekciu citlivých sémantických typov na Facebooku v rozsahu a automatizáciu zabezpečenia uchovávania dát a kontroly prístupu.
Opísaný prístup je náš prvý end-to-end systém súkromia, ktorý sa snaží riešiť tento problém zahrnutím signálov dát, strojového učenia a tradičných metód odoberania odtlačkov na zobrazenie a klasifikáciu všetkých dát na Facebooku. Opísaný systém je prevádzkovaný v produkčnom prostredí, dosahujúc priemerné skóre F2 0,9+ vo viacerých triedach súkromia pri spracovaní veľkého množstva dátových zdrojov v desiatkach úložísk. Predstavujeme preklad publikácie Facebook na ArXiv o škálovateľnej klasifikácii dát na zabezpečenie bezpečnosti a súkromia na základe strojového učenia.
Úvod
Dnes organizácie zhromažďujú a uchovávajú veľké objemy údajov v rôznych formátoch a na rôznych miestach [1], následne sú údaje sprístupňované na mnohých miestach, niekedy sú niekoľkokrát kopírované alebo ukladané do cache, v dôsledku čoho vzácne a dôverné obchodné informácie sú rozptýlené po mnohých firemných úložiskách údajov. Keď je od organizácie potrebné splniť určité právne alebo regulačné požiadavky, napríklad dodržiavať ustanovenia počas civilného súdneho konania, vzniká potreba zhromaždiť údaje o lokalizácii požadovaných údajov. Keď sa v príkaze o ochrane súkromia uvádza, že organizácia musí maskovať všetky čísla sociálneho zabezpečenia (SSN) pri prenose osobných údajov neoprávneným subjektom, prirodzeným prvým krokom je vyhľadanie všetkých SSN v úložiskách údajov celej organizácie. V takýchto okolnostiach klasifikácia údajov nadobúda rozhodujúci význam [1]. Klasifikačný systém umožní organizáciám automaticky zabezpečiť dodržiavanie zásad ochrany súkromia a bezpečnostných politík, ako je napríklad zapracovanie politiky správy prístupu a uchovávanie údajov. Facebook predstavuje systém vytvorený nami vo Facebooku, ktorý využíva množstvo signálov údajov, škálovateľnú systémovú architektúru a strojové učenie na zistenie citlivých sémantických typov údajov.
Zistenie a klasifikácia údajov je ich vyhľadávanie a označovanie spôsobom, ktorý umožňuje rýchlo a efektívne extrahovať relevantné informácie, ak je to potrebné. Súčasný proces je skôr manuálny a spočíva v štúdiu relevantných zákonov alebo predpisov, určení toho, ktoré typy informácií by mali byť považované za citlivé, a ako sú rôzne úrovne citlivosti, a následne v príslušnom vytváraní tried a politika klasifikácie [1]. Po systéme ochrany pred únikom údajov (DLP) sa snímajú odtlačky údajov a sledujú sa koncové body prúdom nadol na získanie odtlačkov. Pri práci s úložiskom s veľkým množstvom aktív a petabajtmi údajov takýto prístup jednoducho nie je škálovateľný.
Naším cieľom je vybudovať systém klasifikácie dát, ktorý je škálovateľný pre stabilné aj nestabilné používateľské dáta, bez akýchkoľvek dodatočných obmedzení na typ alebo formát dát. Je to odvážny cieľ a prirodzene s ním prichádzajú aj ťažkosti. Každý záznam dát môže mať tisíce znakov.
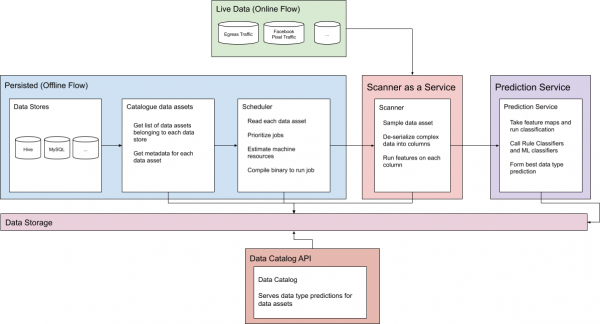
Obrázok 1. Prúdy online a offline predikcie
Preto musíme efektívne reprezentovať dáta pomocou spoločného súboru znakov, ktoré môžu byť neskôr skombinované a ľahko presunuté. Tieto znaky musia nielen zabezpečiť presnú klasifikáciu, ale aj poskytnúť flexibilitu a rozšíriteľnosť pre bezproblémové pridávanie a objavovanie nových typov dát v budúcnosti. Po druhé, musíme pracovať s veľkými autonómnymi tabuľkami. Stabilné dáta môžu byť uložené v tabuľkách s veľkosťou niekoľkých petabajtov. To môže spôsobiť pokles rýchlosti skenovania. Po tretie, musíme dodržiavať prísne SLA klasifikácie pre nestabilné dáta. To núti systém byť vysoko efektívny, rýchly a presný. Nakoniec musíme zabezpečiť klasifikáciu dát s nízkou latenciou pre nestabilné dáta, aby sme vykonávali klasifikáciu v reálnom čase a taktiež pre použitia v online prostredí.
V tomto článku popisujeme, ako sme sa vyrovnávali s uvedenými problémami a predstavujeme rýchly a škálovateľný systém klasifikácie, ktorý klasifikuje položky dát všetkých typov, formátov a zdrojov na základe spoločného súboru znakov. Rozšírili sme systémovú architektúru a vytvorili osobitný model strojového učenia na rýchlu klasifikáciu offline a online dát. Tento článok je usporiadaný nasledovne: v sekcii 2 predstavujeme celkový dizajn systému. V sekcii 3 sa diskutuje o častiach systému strojového učenia. V sekciách 4 a 5 sa hovorí o súvisiacich prácach a naznačuje sa budúci smer práce.
Architektúra
Aby sme sa vyrovnali s problémami stabilných dát a online dát v rozsahu Facebooku, klasifikačný systém má dva samostatné prúdy, ktoré podrobne diskutujeme.
Stabilné dáta
Systém musí najskôr získať informácie o mnohých informačných aktívach Facebooku. Pre každý zdroj sa zhromažďujú základné informácie, ako je centrála spracovania dát, ktorá tieto dáta obsahuje, systém s týmito dátami a aktíva umiestnené v konkrétnom úložisku. Týmto sa vytvára katalóg metadát, ktorý umožňuje systému efektívne získavať dáta bez preťaženia zákazníkov a zdrojov používaných ostatnými inžiniermi.
Tento katalóg metadát poskytuje dôveryhodný zdroj všetkých skenovaných aktív a umožňuje sledovať stav rôznych aktív. S pomocou týchto informácií sa stanovuje priorita plánovania na základe zhromaždených dát a interných informácií zo systému, ako je čas posledného úspešného skenovania aktíva a čas jeho vytvorenia, ako aj minulé požiadavky na pamäť a procesor pre toto aktívum, ak bolo skenované predtým. Potom sa pre každý zdroj dát (ako sa zdroje stávajú dostupnými) spúšťa úloha skenovania daného zdroja.
Každá úloha je skompilovaný binárny súbor, ktorý vykonáva Bernoulliho výber na posledných dostupných dátach pre každé aktívum. Aktívum je rozdelené na jednotlivé stĺpce, kde sa výsledok klasifikácie každého stĺpca spracováva nezávisle. Okrem toho systém skenuje akékoľvek nasýtené dáta v rámci stĺpcov. JSON, polia, kódované štruktúry, URL adresy, sérializované dáta base 64 a mnoho ďalšieho — to všetko je skenované. To môže výrazne zvýšiť čas vykonávania skenovania, keďže jedna tabuľka môže obsahovať tisíce vnorených stĺpcov vo veľkom binárnom objekte. json.
Pre každý riadok, ktorý je vybraný v aktíve dát, systém klasifikácie extrahuje plávajúce a textové objekty zo slávnosti a prepojí každý objekt späť so stĺpcom, z ktorého bol získaný. Výsledkom fázy extrakcie objektov je mapa všetkých objektov pre každý nájdený stĺpec v aktíve dát.
Na čo sú potrebné znaky?
Pojem znakov je kľúčovým momentom. Namiesto znakov float a text môžeme odovzdávať surové vzorky reťazcov, ktoré sú priamo extrahované z každého dátového zdroja. Okrem toho sa modely strojového učenia môžu učiť priamo z každej vzorky, a nie z desiatok výpočtov znakov, ktoré sa iba snažia priblížiť vzorke. Na to existuje niekoľko dôvodov:
- Ochrana súkromia na prvom mieste: najdôležitejšie je, že pojem znakov nám umožňuje uchovávať v pamäti iba tie vzorky, ktoré extrahujeme. To zaručuje, že uchovávame vzorky len na jediný účel a nikdy ich nezaznamenávame vlastnými silami. To je obzvlášť dôležité pre nestabilné dáta, pretože služba musí udržiavať určitý stav klasifikácie, skôr ako poskytne predikciu.
- Pamäť: niektoré vzorky môžu mať dĺžku až niekoľko tisíc znakov. Ukladanie takýchto údajov a ich prenos medzi časťami systému bez potreby spotrebúva veľa dodatočných bajtov. Dva faktory sa môžu spojiť s časom, pričom existuje veľa dátových zdrojov s tisíckami stĺpcov.
- Agregácia znakov: s pomocou znakov sú prostredníctvom ich súboru jasne prezentované výsledky každého skenovania, čo umožňuje systému kombinovať výsledky predchádzajúcich skenovaní toho istého dátového zdroja pohodlným spôsobom. To môže byť užitočné pri agregácii výsledkov skenovania jedného dátového zdroja v niekoľkých spusteniach.
Znaky sa potom posielajú do predikčnej služby, kde používame klasifikáciu na základe pravidiel a strojové učenie na predikciu označení dátového stĺpca. Služba sa spolieha na klasifikátory pravidiel aj na strojové učenie a vyberá najlepšiu predikciu, ktorú dostane z každého objektu predikcie.
Klasifikátory pravidiel sú ručná heuristika, používajú výpočty a koeficienty na normalizáciu objektu v rozsahu od 0 do 100. Akonáhle sa taký počiatočný bod vygeneruje pre každý typ dát a názov stĺpca súvisiaci s týmito dátami, ktorý sa nedostane do žiadnych "zakázaných zoznamov", klasifikátor pravidiel vyberá najvyššie normalizované skóre zo všetkých typov dát.
Vzhľadom na zložitosti klasifikácie vedie výlučne ručná heuristika k nízkej presnosti klasifikácie, najmä pri neštruktúrovaných údajoch. Z tohto dôvodu sme vyvinuli systém strojového učenia na prácu s klasifikáciou neštruktúrovaných údajov, ako je používateľský obsah a adresa. Strojové učenie nám umožnilo začať sa odpútavať od ručnej heuristiky a aplikovať ďalšie signály údajov (napríklad názvy stĺpcov, pôvod údajov), čím sa výrazne zvýšila presnosť detekcie. Neskôr sa podrobne ponoríme do našej architektúry strojového učenia.
Služba predpovedania uchováva výsledky pre každý stĺpec spolu s metadátami týkajúcimi sa času a stavu skenovania. Akíkoľvek príjemcovia a nižšie procesy, ktoré závisia od týchto údajov, si ich môžu prečítať z denne zverejňovaného súboru údajov. Tento súbor agreguje výsledky všetkých týchto úloh skenovania, alebo API v reálnom čase katalógu dát. Zverejnené predpovede sú základom automatického uplatňovania politiky ochrany súkromia a bezpečnosti.
Nakoniec, keď služba predpovedania zaznamená všetky údaje a všetky predpovede sú uložené, naše API katalógu dát môže vracať všetky predpovede typov údajov pre zdroj v reálnom čase. Každý deň systém zverejňuje súbor údajov, ktorý obsahuje všetky najnovšie predpovede pre každý aktívum.
Nestabilné údaje
Hoci je vyššie popísaný proces navrhnutý pre uložené aktíva, nestabilný prenos sa tiež považuje za súčasť údajov organizácie a môže byť dôležitý. Z tohto dôvodu systém poskytuje online API generovania predpovedí klasifikácie v reálnom čase pre akýkoľvek nestabilný prenos. Systém predpovedania v reálnom čase sa široko používa pri klasifikácii odchádzajúceho prenosu, prichádzajúceho prenosu v modeloch strojového učenia a údajov inzerentov.
Tu API prijíma dva základné argumenty: kľúč skupiny a surové údaje, ktoré majú byť predpovedané. Služba vykonáva rovnaké vyhľadávanie objektov, ako je popísané vyššie, a skupinuje objekty spoločne na základe rovnakého kľúča. Tieto znaky sú tiež podporované v uloženej cache pre zotavenie po výpadku. Každému kľúču skupiny služba zaručuje, že pred volaním predpovedacej služby videla dostatočné vzorky podľa procesu popísaného vyššie.
Optimalizácia
Na skenovanie niektorých úložísk používame knižnice a metódy optimalizácie čítania z horúceho úložiska [2] a zaručujeme, že nedochádza k žiadnym poruchám zo strany iných používateľov, ktorí pristupujú k tomu istému úložisku.
Pre extrémne veľké tabuľky (50 + petabajtov), napriek všetkým optimalizáciám a úspore pamäte, systém pracuje na skenovaní a počítaní všetkého skôr, ako sa minie pamäť. Nakoniec sa skenovanie úplne vypočíta v pamäti a neuchováva sa počas skenovania. Ak veľké tabuľky obsahujú tisíce stĺpcov s neštruktúrovanými zhluky údajov, úloha sa môže skončiť neúspešne kvôli nedostatku pamäťových prostriedkov pri vykonávaní predpovedí pre celú tabuľku. To povedie k zníženiu pokrytia. Aby sme sa s týmto vysporiadali, optimalizovali sme systém tak, aby využíval rýchlosť skenovania ako prostredníka v tom, ako dobre systém zvláda aktuálnu záťaž. Používame rýchlosť ako predpovedací mechanizmus na identifikáciu problémov s pamäťou a pri predbežnom výpočte máp objektov. Pri tom používame menej údajov, ako je obvyklé.
Signály údajov
Klasifikačný systém je taký dobrý, ako sú dobré signály z údajov. Tu preskúmame všetky signály používané klasifikačným systémom.
- Na základe obsahu: samozrejme, prvým a najdôležitejším signálom je obsah. Vykonáva sa Bernoulliho výber pre každý aktívny dátový prvok, ktorý skenujeme a extrahujeme znaky z obsahu dát. Mnohé znaky pochádzajú z obsahu. Môže existovať akékoľvek množstvo plávajúcich objektov, ktoré reprezentujú výpočty toho, koľkokrát bol zaznamenaný určitý typ vzoru. Napríklad môžeme mať znaky počtu e-mailov, ktoré boli zaznamenané vo výbere, alebo znaky toho, koľko emodži bolo zaznamenaných vo výbere. Tieto výpočty znakov môžeme normalizovať a agregovať na základe rôznych skenovaní.
- Pôvod dát: dôležitý signál, ktorý môže pomôcť, keď sa obsah zmenil z rodičovskej tabuľky. Bežným príkladom sú hašované dáta. Keď sa dáta v dcérskej tabuľke hašujú, často pochádzajú z rodičovskej tabuľky, kde zostávajú vo voľnom formáte. Údaje o pôvode pomáhajú klasifikovať určité typy dát, keď nie sú len zreteľne čitateľné alebo sú transformované z tabuľky ďalej po toku.
- Poznámky: ďalší kvalitný signál, ktorý pomáha pri identifikácii štruktúrovaných dát. V skutočnosti poznámky a údaje o pôvode môžu pracovať spoločne na šírení atribútov medzi rôznymi aktívami dát. Poznámky pomáhajú identifikovať zdroj neštruktúrovaných dát, zatiaľ čo údaje o pôvode môžu pomôcť sledovať tok týchto dát v celom úložisku.
- Vstrekovanie dát je metóda, pri ktorej sa cielene vkladajú špeciálne, nečítaťeľné znaky do známych zdrojov s známymi typmi dát. Potom, zakaždým, keď skenujeme obsah s rovnakou nečítaťeľnou sekvenciou znakov, môžeme usúdiť, že obsah pochádza z tohto známeho typu dát. Toto je ďalší kvalitný signál dát, podobne ako poznámky. Okrem toho, že detekcia na základe obsahu pomáha odhaliť zadané dáta.
Meranie metrík
Dôležitou súčasťou je prísna metodológia merania metrík. Hlavné metriky iterácie zlepšovania klasifikácie sú presnosť a spätná väzba každej značky, pričom F2 hodnotenie je najdôležitejšie.
Na výpočet týchto ukazovateľov je potrebná nezávislá metodológia označovania aktívnych údajov, ktorá nie je závislá od samotného systému, ale môže sa používať na priame porovnanie s ním. Nižšie popíšeme, ako zhromažďujeme základnú pravdu z Facebooku a využívame ju na školenie nášho klasifikačného systému.
Zber dôveryhodných údajov
Zhromažďujeme dôveryhodné údaje z každého zdroja uvedeného nižšie do jeho vlastnej tabuľky. Každá tabuľka sa zodpovedá za agregáciu najnovších pozorovaných hodnôt z tohto konkrétneho zdroja. Každý zdroj má kontrolu kvality údajov, aby zabezpečil, že pozorované hodnoty pre každý zdroj sú vysoko kvalitné a obsahujú najnovšie označenia typov údajov.
- Konfigurácie platformy protokolovania: určité polia v tabuľkách úľa sa vyplňujú údajmi, ktoré sa týkajú konkrétneho typu. Používanie a šírenie týchto údajov slúži ako spoľahlivý zdroj dôveryhodných údajov.
- Ručné označovanie: vývojári podporujúci systém a externí značkovači sú vyškolení na označovanie stĺpcov. To zvyčajne dobre funguje pre všetky typy údajov v úložisku a môže byť hlavným zdrojom dôveryhodnosti pre niektoré štrukturálne údaje, ako sú údaje správ alebo používateľský obsah.
- Stĺpce z rodičovských tabuliek môžu byť označené alebo anotované ako obsahujúce určité údaje a môžeme tieto údaje sledovať v nižších tabuľkách.
- Výber tokov vykonávania: toky vykonávania na Facebooku nesú údaje určitého typu. Použitím nášho skenera ako servisnej architektúry môžeme vzorkovať toky, ktoré majú známe typy údajov, a posielať ich cez systém. Systém sľubuje, že tieto údaje nebude uchovávať.
- Tabuľky výberu: veľké tabuľky úľa, ktoré sú známe tým, že obsahujú celý súbor údajov, môžu byť tiež používané ako tréningové údaje a posielané cez skener ako servis. To je výborné pre tabuľky s úplným rozsahom typov údajov, takže náhodný výber stĺpca je ekvivalentný výberu celého množstva tohto typu údajov.
- Syntetické údaje: môžeme dokonca využiť knižnice, ktoré generujú údaje na požiadanie. To dobre funguje pre jednoduché, verejne dostupné typy údajov, ako je adresa alebo GPS.
- Správcovia údajov: programy na ochranu osobných údajov zvyčajne využívajú správcov údajov na manuálne priradenie politík k jednotlivým častiam údajov. Slúži to ako veľmi presný zdroj dôveryhodnosti.
Kombinujeme každý hlavný zdroj dôveryhodných údajov do jedného súboru so všetkými týmito údajmi. Najväčšou výzvou dôveryhodnosti je zabezpečiť, aby bola reprezentatívna pre databázu. Inak sa klasifikačné motory môžu pretrénovať. V boji proti tomu sú všetky vyššie uvedené zdroje využívané, aby sa zabezpečil vyvážený prístup pri tréningu modelov alebo výpočte metrik. Okrem toho ľudia označovatelia rovnomerne vyberajú rôzne stĺpce v databáze a príslušne označujú údaje, aby zber dôveryhodných hodnôt zostal nestranný.
Kontinuálna integrácia
Aby sme zabezpečili rýchlu iteráciu a zlepšenie, je dôležité vždy merať výkon systému v reálnom čase. Môžeme merať každé zlepšenie klasifikácie v porovnaní so systémom dnes, takže takticky môžeme zamerať dáta na ďalšie zlepšenia. Tu preskúmame, ako systém uzatvára spätnú väzbu, ktorú zabezpečujú dôveryhodné údaje.
Keď systém plánovania narazí na aktívum, ktoré má štítok z dôveryhodného zdroja, plánujeme dve úlohy. Prvá využíva naše výrobné skenery a tým aj naše výrobné možnosti. Druhá úloha používa skener najnovšej verzie s najnovšími znakmi. Každá úloha zapisuje svoje výstupy do vlastnej tabuľky, označujúc verzie spolu s výsledkami klasifikácie.
Takto porovnávame výsledky klasifikácie verzie kandidáta a produkčného modelu v reálnom čase.
Kým sú datasetové sady porovnávané s atribútmi RC a PROD, zaznamenáva sa množstvo variácií klasifikačného enginu ML prediktívneho servisu. Najnovší vybudovaný model strojového učenia, aktuálny model v produkcii a akékoľvek experimentálne modely. Ten istý prístup nám umožňuje „rozrezať“ rôzne verzie modelu (agnostik našich klasifikátorov pravidiel) a porovnávať metriky v reálnom čase. Takto ľahko zistíme, kedy je experiment s ML pripravený na implementáciu do produkcie.
Každú noc sa RC-atribúty vypočítané pre tento deň odosielajú do vzdelávacieho potrubia ML, kde sa model učí na posledných RC-atribútoch a hodnotí svoju výkonnosť v porovnaní s dôveryhodným datasetom.
Každé ráno model dokončuje tréning a automaticky sa zverejňuje ako experimentálny. Automaticky sa pridáva do zoznamu experimentálnych.
Niektoré výsledky
Viac ako 100 rôznych typov dát je označených s vysokou presnosťou. Dobre štruktúrované typy, ako e-maily a telefónne čísla, sa klasifikujú s hodnotením f2 nad 0,95. Voľné typy dát, ako používateľský obsah a názov, tiež fungujú veľmi dobre, s F2-mi nad 0,85.
Každodenne sa klasifikuje veľké množstvo jednotlivých stĺpcov stabilných a nestabilných dát vo všetkých úložiskách. Viac ako 500 terabajtov sa každodenne skenuje vo viac ako 10 dátových úložiskách. Pokrytie väčšiny z týchto úložísk presahuje 98%.
Postupom času sa klasifikácia stala veľmi efektívnou, keďže úlohy klasifikácie v udržiavanom autonomnom prúde trvajú v priemere 35 sekúnd od skanovania aktíva po vypočítanie predikcií pre každý stĺpec.
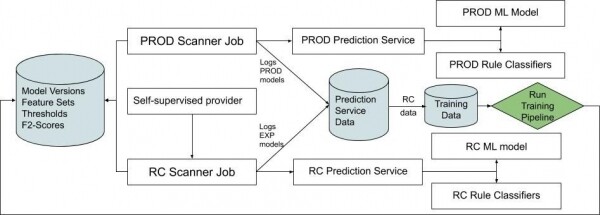
Fig. 2. Schéma popisujúca kontinuálny tok integrácie, aby sme pochopili, ako sa generujú a posielajú RC-objekty do modelu.
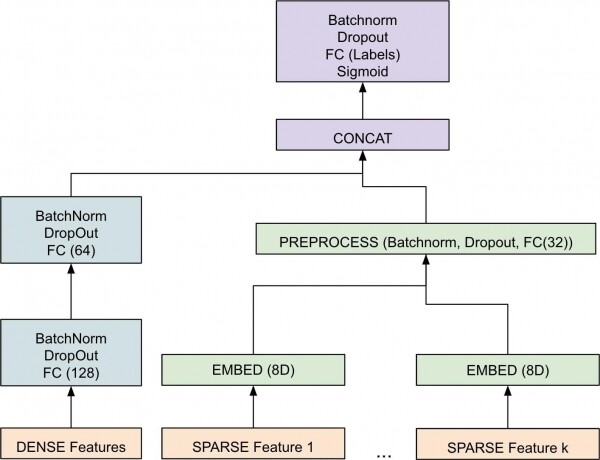
Obrázok 3. Vysokolevelová schéma komponentu strojového učenia.
Komponent systému strojového učenia
V predchádzajúcej sekcii sme sa hlboko ponorili do architektúry celého systému, pričom sme zdôraznili rozsah, optimalizáciu a toky dát v autonómnom a online režime. V tejto sekcii preskúmame prediktívny servis a popíšeme systém strojového učenia, ktorý zabezpečuje fungovanie prediktívnej služby.
S viac ako 100 typmi údajov a niektorými štruktúrovanými obsahmi, ako sú správy a používateľský obsah, vedie používanie výhradne ručnej heuristiky k subparametrickej presnosti klasifikácie, najmä pre neštruktúrované údaje. Z tohto dôvodu sme navrhli aj systém strojového učenia na zvládanie zložitosti neštruktúrovaných údajov. Použitie strojového učenia umožňuje začať sa odkláňať od ručnej heuristiky a pracovať s charakteristikami a dodatočnými signálmi údajov (napríklad menami stĺpcov, pôvodom údajov) na zvýšenie presnosti.
Implementovaný model skúma vektorové reprezentácie [3] nad hustými a riedkymi objektmi oddelene. Potom sú kombinované, aby vytvorili vektor, ktorý prechádza sériou etáp normalizácie dávok [4] a nelinearity, aby sa dosiahol konečný výsledok. Konečný výsledok je plávajúce číslo medzi [0-1] pre každú značku, ktorá označuje pravdepodobnosť, že príklad patrí danému typu citlivosti. Použitie PyTorch pre model nám umožnilo urýchliť proces a umožnilo vývojárom mimo tímu rýchlo meniť a testovať zmeny.
Pri navrhovaní architektúry bolo dôležité modelovať riedke (napríklad textové) a husté (napríklad numerické) objekty oddelene kvôli ich vnútorným rozdielom. Pre konečnú architektúru bolo tiež dôležité vykonať rozloženie parametrov, aby sa našla optimálna hodnota rýchlosti učenia, veľkosti dávky a iných hyperparametrov. Výber optimalizátora bol tiež dôležitým hyperparametrom. Zistili sme, že populárny optimalizátor Adamčasto vedie k preťaženiu, zatiaľ čo model s SGD stabilnejšie. Boli tu ďalšie nuansy, ktoré sme museli zahrnúť priamo do modelu. Napríklad statické pravidlá, ktoré zaručili, že model vytvára deterministickú predpoveď, keď má znak určitú hodnotu. Tieto statické pravidlá sú definované našimi klientmi. Zistili sme, že ich priame zahrnutie do modelu viedlo k vytvoreniu samostatnejšej a spoľahlivejšej architektúry, na rozdiel od realizácie fázy postprocessingu na spracovanie týchto špeciálnych okrajových prípadov. Taktiež si všimnite, že počas trénovania sú tieto pravidlá vypnuté, aby nenarušovali tréningový proces gradientného zostupu.
Problémy
Jedným z problémov bol zber vysokokvalitných spoľahlivých údajov. Model potrebuje spoľahlivosť pre každú triedu, aby sa mohol učiť asociácie medzi objektmi a štítkami. V predchádzajúcej časti sme diskutovali o metódach zberu údajov, ako pre meranie systému, tak aj pre učenie modelov. Analýza ukázala, že také triedy údajov, ako sú čísla kreditných kariet a bankových účtov, nie sú veľmi rozšírené v našom úložisku. To sťažuje zber veľkých objemov spoľahlivých údajov na učenie modelov. Na vyriešenie tohto problému sme vyvinuli procesy na získavanie syntetických spoľahlivých údajov pre tieto triedy. Generujeme také údaje pre citlivé typy, vrátane SSN, čísiel kreditných kariet a IBAN-čísiel, pre ktoré model nemohol predpovedať predtým. Tento prístup umožňuje spracovanie citlivých typov údajov bez rizika ochrany osobných údajov spojeného s ukrývaním skutočných citlivých údajov.
Okrem problémov s dôveryhodnými údajmi existujú otvorené architektonické problémy, na ktorých pracujeme, ako napríklad izolácia zmien a skoré zastavenie. Izolácia zmien je dôležitá pre to, aby pri zavádzaní rôznych zmien do rôznych častí siete mala izolované dopady na konkrétne triedy a neovplyvnila široko celkovú výkonnosť predpovedania. Vylepšenie kritérií skorého zastavenia je tiež kľúčové, aby sme mohli zastaviť tréningový proces v stabilnom bode pre všetky triedy, a nie v bode, kde niektoré triedy pretrénovávajú, zatiaľ čo iné nie.
Dôležitosť znaku
Keď do modelu zavedieme nový znak, chceme vedieť jeho celkový vplyv na model. Tiež chceme zabezpečiť, aby boli predpovede pre ľudí interpretovateľné, aby sme mohli presne pochopiť, aké znaky sa používajú pre každý typ údajov. Na tento účel sme vyvinuli a zaviedli po triedach dôležitosť znakov pre model PyTorch. Upozorňujeme, že to sa líši od celkovej dôležitosti znaku, ktorá sa obyčajne podporuje, pretože nehovorí nám, aké znaky sú dôležité pre konkrétnu triedu. Meriame dôležitosť objektu výpočtom zvýšenia chyby predpovede po premiešaní objektu. Znak je "dôležitý", keď premiešanie jeho hodnôt zvyšuje chybu modelu, pretože v tomto prípade model bol závislý od znaku pri predpovedaní. Znak je "nedôležitý", keď premiešanie jeho hodnôt necháva chybu modelu nezmenenú, pretože v tomto prípade model ho ignoroval [5].
Dôležitosť znaku pre každú triedu umožňuje urobiť model interpretovateľným, aby sme mohli vidieť, na čo sa model zameriava pri predpovedaní etikiet. Napríklad, keď analyzujeme ADDR, zabezpečíme, že priradený znak k adrese, ako je AddressLinesCount, zaujíma vysoké miesto v tabuľke dôležitosti znakov pre každú triedu, aby naša ľudská intuícia dobre zodpovedala tomu, čo sa model naučil.
Hodnotenie
Je dôležité určiť jednotnú metriku úspechu. Vybrali sme F2 — vyváženie medzi odzvaním a presnosťou (nepatrne viac zamerané na odzvanie). Odzvanie je pre prípad použitia ochrany súkromia dôležitejšie ako presnosť, pretože pre tím je nesmierne dôležité nezmeškať žiadne citlivé údaje (pričom zabezpečujeme primeranú presnosť). Skutočné údaje o výkonnosti F2 našich modelov presahujú rámec tohto článku. Napriek tomu, pri starostlivom ladění môžeme dosiahnuť vysoké hodnotenie (0,9+) F2 pre najdôležitejšie citlivé triedy.
Súvisiaca práca
Existuje množstvo algoritmov automatickej klasifikácie štruktúrovaných dokumentov pomocou rôznych metód, ako sú porovnávanie vzorov, vyhľadávanie podobnosti dokumentov a rôzne metódy strojového učenia (bayesovské, rozhodovacie stromy, k-najbližších susedov a mnohé iné) [6]. Akákoľvek z nich môže byť použitá ako súčasť klasifikácie. Problémom je však škálovateľnosť. Prístup k klasifikácii v tomto článku je orientovaný na flexibilitu a výkon. To nám umožňuje podporovať nové triedy v budúcnosti a udržiavať nízku latenciu.
Existuje tiež množstvo prác na odtlačkoch z dát. Napríklad, autori v [7] popísali riešenie, ktoré sa zameriava na problém zachytávania únikov dôverných údajov. Hlavné predpoklad je, že je možné odtlačok z dát porovnať so súborom známych dôverných údajov. Autori v [8] popisujú podobný problém úniku súkromia, ale ich riešenie je založené na konkrétnej architektúre Android a klasifikuje sa iba vtedy, keď činnosti používateľa viedli k odoslaniu osobných informácií alebo keď v základnej aplikácii došlo k úniku používateľských údajov. Situácia je tu trochu odlišná, pretože používateľské údaje môžu byť tiež veľmi neštruktúrované. Preto potrebujeme zložitejšiu techniku než len odtlačok.
Nakoniec, aby sme sa vysporiadali s nedostatkom údajov pre niektoré typy dôverných údajov, sme zaviedli syntetické údaje. Existuje veľké množstvo literatúry o augmentácii údajov, napríklad autori v [9] skúmali úlohu injekcie šumu počas učenia a pozorovali pozitívne výsledky v kontrolovanom učení. Náš prístup k ochrane súkromia sa líši, pretože zavedenie zašumených údajov môže byť kontraproduktívne, a namiesto toho sa zameriavame na vysokokvalitné syntetické údaje.
Záver
V tomto článku predstavujeme systém, ktorý dokáže klasifikovať fragment dát. To nám umožňuje vytvárať systémy na zabezpečenie dodržiavania politík ochrany osobných údajov a bezpečnosti. Ukázali sme, že škálovateľná infraštruktúra, kontinuálna integrácia, strojové učenie a kvalitné dáta o dôveryhodnosti údajov hrajú kľúčovú úlohu v úspechu mnohých našich iniciatív v oblasti ochrany osobných údajov.
Existuje mnoho smerov budúcej práce. Môže zahŕňať zabezpečenie podpory nestruktúrovaných údajov (súborov), klasifikáciu nielen typu údajov, ale aj úrovne citlivosti a používanie samoovládacieho učenia priamo počas vzdelávania generovaním presných syntetických príkladov. Tie, na druhej strane, pomôžu modeli znížiť straty na maximálny rozsah. Budúca práca sa môže tiež zamerať na pracovný proces vyšetrovania, kde prechádzame za rámec detekcie a poskytujeme analýzu príčin rôznych porušení ochrany osobných údajov. To pomôže v takých prípadoch, ako je analýza citlivosti (t.j. či je citlivosť ochrany osobných údajov typu údajov vysoká (napr. IP používateľa) alebo nízka (napr. interné IP Facebooku)).
Bibliografia
- David Ben-David, Tamar Domany a Abigail Tarem. Klasifikácia podnikového dát pomocou technológií semantického webu. V Peter F.Ï Patel-Schneider, Yue Pan, Pascal Hitzler, Peter Mika, Lei Zhang, Jeff Z. Pan, Ian Horrocks a Birte Glimm, redaktori, Semantický web – ISWC 2010, strany 66–81, Berlín, Heidelberg, 2010. Springer Berlín Heidelberg.
- Subramanian Muralidhar, Wyatt Lloyd, Sabyasachi Roy, Cory Hill, Ernest Lin, Weiwen Liu, Satadru Pan, Shiva Shankar, Viswanath Sivakumar, Linpeng Tang a Sanjeev Kumar. f4: Systém teplého BLOB ukladania spoločnosti Facebook. V 11. USENIX sympózium o návrhu a implementácii operačných systémov (OSDI 14), strany 383–398, Broomfield, CO, október 2014. USENIX Associația.
- Tomas Mikolov, Ilya Sutskever, Kai Chen, Greg S Corrado a Jeff Dean. Distribuované reprezentácie slov a fráz a ich kompozicionalita. V C. J. C. Burges, L. Bottou, M. Welling, Z. Ghahramani a K. Q. Weinberger, redaktori, Pokroky v systémoch spracovania neurónových informácií 26, strany 3111–3119. Curran Associates, Inc., 2013.
- Sergey Ioffe a Christian Szegedy. Normalizácia dávok: Urýchlenie tréningu hlbokých sietí znížením vnútorného covariate shift. V Francis Bach a David Blei, redaktori, Zborník 32. medzinárodnej konferencie o strojovom učení, zväzok 37 z Zborníka výskumu strojového učenia, strany 448–456, Lille, Francúzsko, 07–09. júl 2015. PMLR.
- Leo Breiman. Náhodné lesy. Mach. Učenie., 45(1):5–32, október 2001.
- Thair Nu Phyu. Prieskum techník klasifikácie v dolovaní dát.
- X. Shu, D. Yao a E. Bertino. Ochrana soukromí pri detekcii citlivého vystavenia údajov. IEEE Transactions on Information Forensics and Security, 10(5):1092–1103, 2015.
- Zhemin Yang, Min Yang, Yuan Zhang, Guofei Gu, Peng Ning a Xiaoyang Wang. Appintent: Analyzovanie prenosu citlivých údajov v Androide pre detekciu úniku súkromia. strany 1043–1054, 11 2013.
- Qizhe Xie, Zihang Dai, Eduard H. Hovy, Minh-Thang Luong a Quoc V. Le. Nezávislé zvyšovanie dát.
Zistite podrobnosti, ako získať žiadanú profesiu od základov alebo zlepšiť svoje zručnosti a plat, absolvovaním online kurzov SkillFactory:
- (12 mesiacov)
- (12 týždňov)
- (20 týždňov)
- (20 týždňov)
Ďalšie kurzy
- (9 mesiacov)
- (8 mesiacov)
- (9 mesiacov)
- (12 mesiacov)
- (18 mesiacov)
- (12 mesiacov)
- (9 mesiacov)
- (7 mesiacov)
Zdroj: habr.com
