

Vážení čitatelia, prajeme vám dobrý deň!
Úloha vybudovať IT platformy na zhromažďovanie a analýzu údajov skôr či neskôr vzniká v každej spoločnosti, ktorej obchodný model spočíva v intelektovo náročnej poskytovacej službe alebo vo vývoji technicky zložitých produktov. Budovanie analytických platforiem je náročná a časovo náročná úloha. Avšak každú úlohu je možné zjednodušiť. V tomto článku sa chcem podeliť o skúsenosti s využívaním low-code nástrojov, ktoré pomáhajú pri vytváraní analytických riešení. Tieto skúsenosti boli získané pri implementácii niekoľkých projektov v oblasti Big Data Solutions spoločnosti „Neoflex“. Oblasť Big Data Solutions spoločnosti „Neoflex“ sa od roku 2005 zaoberá otázkami budovania úložísk a jazier dát, rieši problémy optimalizácie rýchlosti spracovania informácií a pracuje na metodológii riadenia kvality údajov.
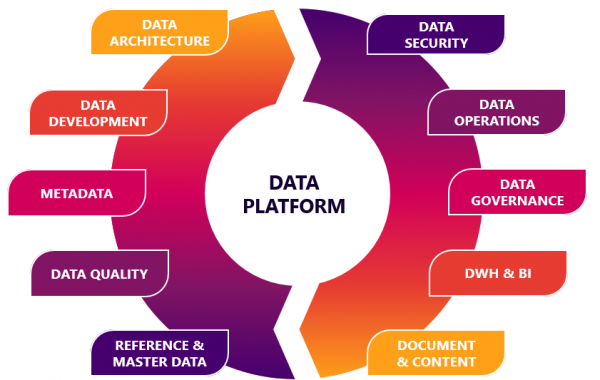
Vyhnúť sa vedomému zhromažďovaniu slabo a/alebo silno štruktúrovaných údajov sa nikomu nepodarí. Možno, ak hovoríme o malej firme. Veď pri škálovaní podnikania sa perspektívny podnikateľ stretne s otázkami o vypracovaní programu vernosti, bude chcieť vykonať analýzu efektívnosti predajných miest, zamyslí sa nad cielenou reklamou a zaujme ho dopyt po sprievodných produktoch. V prvom priblížení sa úloha môže vyriešiť „na kolene“. Ale pri raste podnikania je príchod k analytickej platforme nevyhnutný.
Ale v akom prípade sa úlohy analýzy údajov môžu preklenúť do úloh triedy „Rocket Science“? Možno v momente, keď ide naozaj o veľké dáta.
Pre zjednodušenie úlohy „Rocket Science“ môžete jesť slona po častiach.
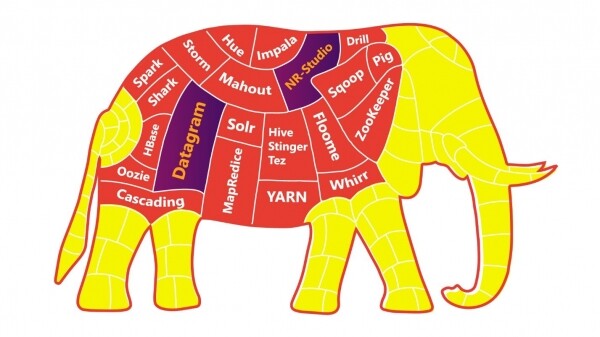
Čím väčšia diskrétnosť a autonómnosť budú mať vaše aplikácie/služby/mikroslužby, tým jednoduchšie pre vás, vašich kolegov a celú firmu bude „zhltniť“ slona.
K tomuto postulátu dospeli prakticky všetci naši klienti, ktorí prestavali krajinu na základe inžinierskych praktík DevOps tímov.
Ale aj pri „oddilenej, slonovej“ diéte máme dobré šance na „preťaženosť“ IT krajiny. V tomto momente je potrebné sa zastaviť, vydať a pozrieť sa smerom k low-code engineering platform.
Mnohí vývojári sa obávajú perspektívy, že sa ocitnú v kariérnom slepiku, keď prejdú od priameho písania kódu k „ťahaniu“ šípok v UI rozhraní low-code systémov. Avšak príchod strojov nespôsobil zánik inžinierov, ale posunul ich prácu na novú úroveň!
Poďme sa pozrieť na to, prečo.
Analýza údajov v oblasti logistiky, telekomunikačného priemyslu, médií, a vo finančnom sektore je vždy spojená s nasledujúcimi otázkami:
- Rýchlosť vykonávania automatizovanej analýzy;
- Možnosť vykonať experimenty bez ovplyvnenia hlavného toku výroby údajov;
- Kvalita pripravených údajov;
- Sledovanie zmien a verzionovanie;
- Data provenance, Data lineage, CDC;
- Rýchlosť dodania nových funkcií do produkčného prostredia;
- A známe: náklady na vývoj a podporu.
To znamená, že inžinieri majú obrovské množstvo high-level úloh, ktorých efektívne vykonanie je možné len tým, že si vyčistia myseľ od úloh low-level vývoja.
Predpoklady pre prechod vývojárov na novú úroveň boli evolúcia a digitalizácia podnikania. Hodnota vývojára sa tiež mení: existuje výrazný nedostatok vývojárov, ktorí sú schopní preniknúť do podstaty konceptov automatizovaného podnikania.
Poďme urobiť analógiu medzi low-level a high-level programovacími jazykmi. Prechod od low-level jazykov k high-level jazykom je prechod od písania „priamych direktív v jazyku železa“ k „direktívam v jazyku ľudí“. To znamená, že pridávame určitú vrstvu abstrakcie. V tomto prípade je prechod na low-code platformy z high-level programovacích jazykov prechod od „direktív v jazyku ľudí“ k „direktívam v jazyku podnikania“. Ak nájdeme vývojárov, ktorých tento fakt zarmúti, potom sú zarmútení možno už od chvíle, kedy sa objavil Java Script, v ktorom sa používajú funkcie na triedenie poľa. A tieto funkcie samozrejme majú pod kapotou programovú implementáciu inými prostriedkami toho istého high-level programovania.
Teda low-code je len ďalšia úroveň abstrakcie.
Praktické skúsenosti s používaním low-code.
Téma low-code je dosť široká, ale teraz by som chcel rozprávať o praktickom využití "malokodových konceptov" na príklade jedného z našich projektov.
Oddelenie Big Data Solutions spoločnosti "Neoflex" sa vo väčšej miere špecializuje na finančný sektor podnikania, budovaním úložísk a jazier dát a automatizovaním rôznych reportov. V tejto oblasti sa použitie low-code už dávno stalo štandardom. Medzi ďalšími low-code nástrojmi môžeme spomenúť prostriedky na organizovanie ETL procesov: Informatica Power Center, IBM Datastage, Pentaho Data Integration. Alebo Oracle Apex, ktorý predstavuje prostredie rýchlej výroby rozhraní na prístup a úpravu dát. Avšak použitie malokodových vývojových nástrojov nie je vždy spojené s budovaním úzko zameraných aplikácií na komerčnej technologickej platforme s jasne vyjadrenou závislosťou od dodávateľa.
S pomocou low-code platforiem je možné aj organizovať orchestráciu dátových tokov, vytvoriť data-science platformy alebo napríklad moduly na kontrolu kvality dát.
Jedným z praktických príkladov skúseností s použitím malokodových vývojových nástrojov je spolupráca "Neoflex" so spoločnosťou Mediascope, jedným z lídrov ruského trhu výskumu médií. Jednou z úloh biznisu tejto spoločnosti je výroba dát, na základe ktorých inzerenti, internetové platformy, televízne kanály, rozhlasové stanice, reklamné agentúry a značky rozhodujú o nákupe reklamy a plánujú svoje marketingové komunikácie.
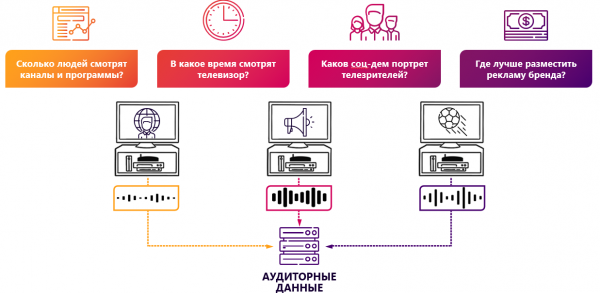
Mediálne výskumy sú technologicky náročná sféra podnikania. Rozpoznávanie videozáznamov, zber dát z prístrojov analyzujúcich sledovanie, meranie aktivity na webových stránkach – to všetko predpokladá, že spoločnosť má veľký IT tím a obrovské skúsenosti s budovaním analytických riešení. No exponenciálny rast množstva informácií, počtu a rozmanitosti zdrojov núti IT priemysel dát neustále napredovať. Najjednoduchším riešením pre škálovanie už existujúcej analytickej platformy Mediascope mohlo byť zvýšenie počtu IT zamestnancov. Ale oveľa efektívnejšie riešenie je urýchliť proces vývoja. Jedným z krokov, ktoré vedú týmto smerom, môže byť použitie low-code platforiem.
Pri spustení projektu mala spoločnosť už funkčné produktové riešenie. Avšak implementácia riešenia na MSSQL nemohla plne spĺňať očakávania pokiaľ ide o škálovateľnosť funkcií pri zachovaní prijateľných nákladov na úpravy.
Úloha, ktorá pred nami stála, bola skutočne ambiciózna – «Neoflex» a Mediascope mali vytvoriť priemyselné riešenie za menej ako rok, pričom očakávaný MVP mal byť pripravený už v prvom kvartáli od dátumu začatia prác.
Ako základ pre vybudovanie novej dátovej platformy založenej na low-code výpočtoch bol zvolený technologický stack Hadoop. Štandardom pre uchovávanie dát sa stal HDFS s využitím formátových súborov parquet. Na prístup k dátam nachádzajúcim sa na platforme bol použitý Hive, v ktorom sú všetky dostupné vitríny prezentované ako externé tabuľky. Na načítanie dát do úložiska boli použité Kafka a Apache NiFi.
Low-code nástroj v tejto koncepcii bol aplikovaný na optimalizáciu najnáročnejšej úlohy pri budovaní analytickej platformy – úlohy výpočtu dát.
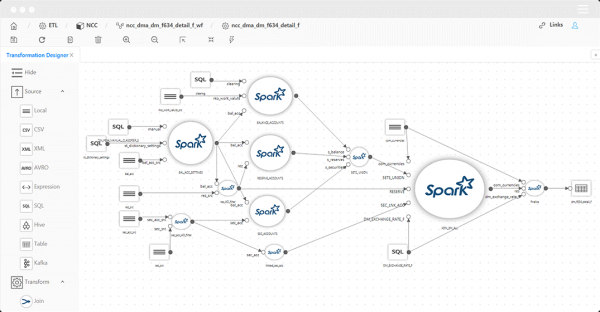
Hlavným mechanizmom pre mapovanie dát bol zvolený low-code nástroj Datagram. Neoflex Datagram je prostriedok na vývoj transformácií a tokov dát.
Použitím tohto nástroja sa môže zaobísť bez ručného písania kódu v Scale. Scala kód sa generuje automaticky pomocou prístupu Model Driven Architecture.
Zjavný prínos takého prístupu – urýchlenie procesu vývoja. Okrem rýchlosti existujú aj ďalšie výhody:
- Prezeranie obsahu a štruktúry zdrojov/prijímateľov;
- Sledovanie pôvodu objektov toku dát až po jednotlivé polia (lineage);
- Čiastočné vykonávanie transformácií s prehľadom medzi výsledkami;
- Prezeranie zdrojového kódu a jeho úprava pred vykonaním;
- Automatická validácia transformácií;
- Automatické nahrávanie dát 1 na 1.
Prahová vstup do low-code riešení na generovanie transformácií je dosť nízky: vývojár musí poznať SQL a mať skúsenosti s ETL nástrojmi. Treba však poznamenať, že code-driven generátory transformácií nie sú ETL nástroje v širokom zmysle tohto slova. Low-code nástroje nemusia mať vlastné prostredie na vykonávanie kódu. To znamená, že vygenerovaný kód bude vykonávaný v prostredí, ktoré existovalo v klastre ešte pred inštaláciou low-code riešenia. A to je, možno, ďalší plus pre low-code. Pretože paralelne s low-code tímom môže fungovať aj "klasický" tím, ktorý implementuje funkčnosť, napríklad v čistom Scala kóde. Zapojenie vylepšení oboch tímov do produkcie bude jednoduché a "bezšvové".
Možno stojí za to ešte spomenúť, že okrem low-code existujú aj no-code riešenia. A v podstate ide o rôzne veci. Low-code v značnej miere umožňuje vývojárovi zasahovať do generovaného kódu. V prípade Datagram je možné prehliadať a upravovať generovaný Scala kód, no-code takúto možnosť nemusí poskytovať. Tento rozdiel je dosť podstatný nielen z hľadiska flexibility riešenia, ale aj z hľadiska pohodlia a motivácie pri práci dátových inžinierov.
Architektúra riešenia
Poďme sa pokúsiť pochopiť, ako low-code nástroj pomáha riešiť úlohu optimalizácie rýchlosti vývoja funkčnosti výpočtu údajov. Najprv sa pozrime na funkčnú architektúru systému. V tomto prípade je príkladom model výroby údajov pre mediálne výskumy.
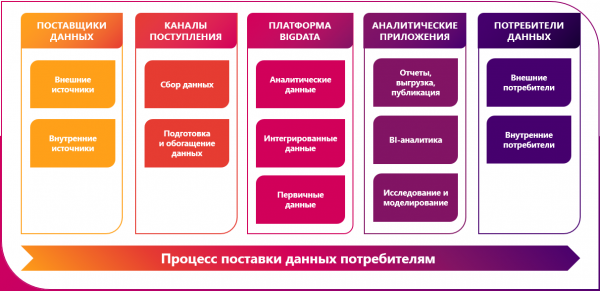
Zdroje údajov sú v našom prípade veľmi rozmanité a rôznorodé:
- Pipletmetre (TV-metre) sú programovo-hardware zariadenia, ktoré sledujú správanie užívateľov na paneli respondentov – kto, kedy a aký kanál sledoval v domácnosti zapojenej do výskumu. Poskytované informácie sú prúdom intervalov sledovania vysielania s priradením k mediálnemu balíku a mediálnemu produktu. Dáta na fáze nahrávania do Data Lake môžu byť obohatené o demografické atribúty, priradenie k geostrátam, časovým pásmam a ďalšími informáciami potrebnými na analýzu televízneho sledovania daného mediálneho produktu. Zrealizované merania môžu byť použité na analýzu alebo plánovanie reklamných kampaní, hodnotenie aktivity a preferencií publika, zostavovanie vysielacej mriežky;
- Dáta môžu prichádzať zo systémov monitorovania streamovacieho televízneho vysielania a merania sledovania obsahu videorozhovorov na internete;
- Meracie nástroje v webovom prostredí, medzi ktorými sú ako site-centric, tak aj user-centric počítadlá. Poskytovateľom dát pre Data Lake môže slúžiť rozšírenie prehliadača research bar a mobilná aplikácia s integrovaným VPN.
- Dáta môžu tiež prichádzať z platforiem, ktoré konsolidujú výsledky vyplnenia online dotazníkov a výsledky realizácie telefonických rozhovorov vo výskumných štúdiách spoločnosti;
- Ďalšie obohatenie jazera dát môže prebiehať prostredníctvom nahrávania informácií z logov partnerských spoločností.
Implementácia as is nahrávania z systémov-zdrojov do primárneho staging surových dát môže byť organizovaná rôznymi spôsobmi. V prípade použitia low-code pre tieto účely je možná automatická generácia skriptov nahrávania na základe metadát. V tomto prípade nie je potrebné prechádzať na úroveň vývoja mappingu zdrojov na cieľ. Pre realizáciu automatického nahrávania je potrebné nadviazať spojenie so zdrojom, po čom sa v nahrávacej rozhraní určí zoznam entít, ktoré sa majú nahrávať. Vytvorenie štruktúry adresárov v HDFS sa uskutoční automaticky a bude zodpovedať štruktúre ukladania dát v systéme-zdroji.
Avšak v kontexte tohto projektu sme sa rozhodli túto funkciu low-code platforiem nevyužiť, pretože spoločnosť Mediascope už samostatne začala pracovať na vytvorení podobného servisu na kombinácii Nifi + Kafka.
Je potrebné hneď na začiatku vyjasniť, že tieto nástroje nie sú vzájomne zameniteľné, ale skôr sa navzájom doplňujú. Nifi a Kafka môžu pracovať ako v priamom (Nifi -> Kafka), tak aj v opačnom (Kafka -> Nifi) spojení. Pre platformu mediálneho výskumu sa využíval prvý variant spojenia.
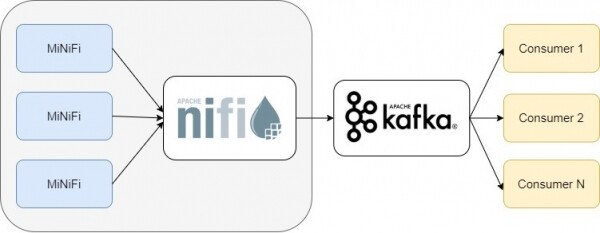
V našom prípade Nifi potreboval spracovávať rôzne typy údajov zo systémov zdrojov a posielať ich brokerovi Kafka. Pri tom bola komunikácia v konkrétnom topiku Kafka realizovaná prostredníctvom Nifi procesorov PublishKafka. Orchestrácia a údržba týchto pipeline-ov sa vykonáva v vizuálnom rozhraní. Nástroj Nifi a využitie spojenia Nifi + Kafka môžeme tiež nazvať low-code prístupom k vývoju, ktorý má nízky vstupný prah do technológií Big Data a urýchľuje proces vývoja aplikácií.
Nasledujúcim krokom v realizácii projektu bolo prispôsobenie k formátu jednotného sémantického vrstvy podrobných údajov. V prípade, že má entita historické atribúty, výpočet sa uskutočňuje v kontexte posudzovanej partition. Ak entita nie je historická, je voliteľne možný buď prepočet celého obsahu objektu, alebo úplný renunciation tohto objektu (v dôsledku absencie zmien). V tomto kroku sa generujú kľúče pre všetky entity. Kľúče sa ukladajú do príslušných master-objektových adresárov Hbase, ktoré obsahujú zhodu medzi kľúčmi v analytickej platforme a kľúčmi zo systémov zdrojov. Konsolidácia atomárnych entít je sprevádzaná obohatením výsledkami predbežných výpočtov analytických údajov. Frameworkom na výpočet údajov bol Spark. Opísaná funkcionalita prispôsobenia údajov k jednému významu bola realizovaná aj na základe mappingov low-code nástroja Datagram.
V cielovej architektúre sa vyžadovalo zabezpečiť SQL prístup k údajom pre biznis používateľov. Pre túto možnosť bol použitý Hive. Registrácia objektov v Hive sa vykonáva automaticky pri aktivácii možnosti „Registr Hive Table“ v low-code nástroji.
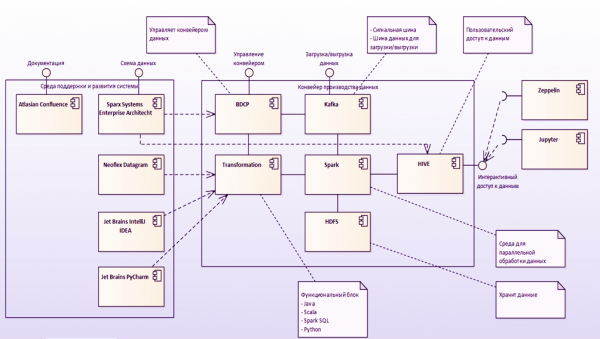
Riadenie toku výpočtu
Datagram má rozhraní na návrh pracovních toků. Spouštění mapování může být realizováno pomocí plánovače Oozie. V rozhraní pro vývojáře pracovních toků je možné vytvářet schémata paralelního, sekvenčního nebo podmíněného provádění transformací dat. Podporována jsou shellové skripty a java programy. Je také možné použit... servera Apache Livy. Apache Livy slouží k spouštění aplikací přímo z vývojového prostředí.
Pokud má společnost již vlastního orchestrátora procesů, je možné využít REST API pro integraci mapování do stávajícího toku. Například máme poměrně úspěšné zkušenosti s integrací mapování v Scala do orchestrátorů napsaných v PLSQL a Kotlin. REST API nízkokódového nástroje zahrnuje operace jako generování spustitelného roku na základě návrhu mapování, volání mapování, volání sekvence mapování a samozřejmě předávání parametrů v URL pro spuštění mapování.
Vedle Oozie je možné organizovat výpočetní tok pomocí Airflow. Asi se nebudu dlouho zdržovat s porovnáváním Oozie a Airflow, jen řeknu, že v kontextu projektu mediálních výzkumů jsme se rozhodli pro Airflow. Hlavními argumenty byly tentokrát mnohem aktivnější komunita, která produkt rozvíjí, a vyspělejší rozhraní + API.
Airflow je také výborný, protože pro popis výpočetních procesů se v něm používá mnoha oblíbený Python. Obecně řečeno, platforem pro správu pracovních procesů s otevřeným zdrojovým kódem není tolik. Spuštění a sledování vykonávání procesů (včetně Ganttových diagramů) jen zvyšuje body v karmě Airflow.
Formát konfiguračního souboru pro spuštění mapování nízkokódového řešení se stal spark-submit. To se stalo z dvou důvodů. Za prvé, spark-submit umožňuje přímo spustit jar soubor z konzole. Za druhé, může obsahovat veškeré potřebné informace pro konfiguraci pracovního toku (což usnadňuje psaní skriptů, které tvoří Dag).
Nejčastějším prvkem pracovního toku Airflow v našem případě se stal SparkSubmitOperator.
SparkSubmitOperator umožňuje spouštět jar soubory — zabalená mapování Datagram s předem vytvořenými vstupními parametry.
Je dôležité spomenúť, že každá úloha Airflow sa vykonáva v samostatnom vlákne a nič nevie o ostatných úlohách. Interakcia medzi úlohami sa preto vykonáva pomocou riadiacich operátorov, ako sú DummyOperator alebo BranchPythonOperator.
Kombinácia použitia low-code riešenia Datagram s universalizáciou konfiguračných súborov (tvorba Dag) viedla k značnému zrýchleniu a zjednodušeniu procesu vývoja dátových predvádzacích prúdov.
Výpočet predvádzacích miest
Snáď najintenzívnejšia fáza v produkcii analytických dát je krok výstavby predvádzacích miest. V kontexte jedného z tokov výpočtu dát výskumnej spoločnosti sa v tejto fáze uskutočňuje prispôsobenie k referenčnej translačnej schéme so zohľadnením časových pásiem, pričom sa viaže na vysielaciu sieť. Rovnako je možná úprava lokálnej vysielacej siete (miestne správy a reklama). Medzi inými úlohami v tejto fáze sa vykonáva rozdelenie intervalov kontinuálneho sledovania mediálnych produktov na základe analýzy intervalov sledovania. Tu sa tiež vykonáva „váženie“ hodnôt sledovania na základe informácií o ich význame (výpočet opravných koeficientov).
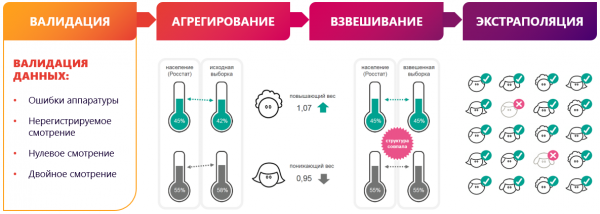
Samostatným krokom prípravy predvádzacích miest je validácia dát. Algoritmus validácie je spojený s aplikáciou niekoľkých matematických science modelov. Avšak použitie low-code platforiem umožňuje rozdeliť zložitý algoritmus na rad jednotlivých vizuálne čitateľných máp. Každá z máp vykonáva úzku úlohu. V dôsledku toho je možná medzi kroková ladenie, logovanie a vizualizácia fáz prípravy dát.
Algoritmus validácie bol rozhodnutý diskrétne rozdeliť na nasledujúce podfázy:
- Vytvorenie regresií závislostí sledovania televíznych sietí v regióne na sledovaní všetkých sietí v regióne za 60 dní.
- Výpočet študentizovaných reziduí (odchýlky skutočných hodnôt od predpovedaných regresnou modelom) pre všetky body regresie a pre vypočítaný deň.
- Výber anomálnych párov región-televízia, kde študentizovaný zostatok vypočítaného dňa prevyšuje normu (stanovenú nastavením operácie).
- Prepočet upraveného študentizovaného zostatku pre anomálne páry región - telekomunikačná sieť pre každého respondenta, ktorý sledoval sieť v regióne s určením príspevku tohto respondenta (veľkosť zmeny študentizovaného zostatku) pri vylúčení sledovania tohto respondenta z výberu.
- Hľadanie kandidátov, ktorých vylúčenie privedie študentizovaný zostatok vypočítaného dňa do normy.
Uvedený príklad je potvrdením hypotézy, že dátový inžinier má v hlave skutočne príliš veľa vecí… A ak je to naozaj "inžinier", nie "kódovač", potom by sa strach z profesionálneho zhoršenia pri používaní low-code nástrojov mal definitívne ustúpiť.
Čo ďalšie môže low-code?
Oblasť použitia low-code nástroja na dávkovú a streamovú analýzu údajov bez potreby ručne písať kód v Scale nekončí.
Použitie low-code pri vývoji datalake-ov sa pre nás už stalo akýmsi štandardom. Pravdepodobne, môžeme povedať, že riešenia na stacku Hadoop opakujú vývoj klasických DWH založených na RDBMS. Nástroje s nízkym kódom na stacku Hadoop môžu riešiť ako úlohy spracovania údajov, tak aj úlohy budovania konečných BI rozhraní. A treba si všimnúť, že pod BI sa môže rozumieť nielen reprezentácia údajov, ale aj ich úprava prostredníctvom obchodných používateľov. Túto funkcionalitu často využívame pri budovaní analytických platforiem pre finančný sektor.
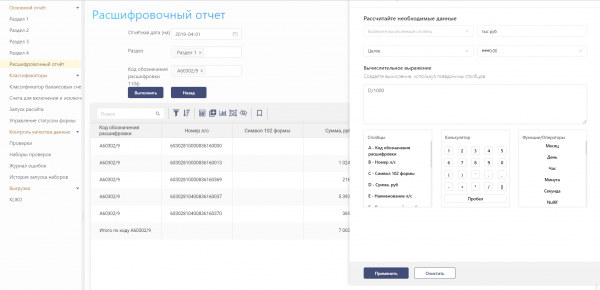
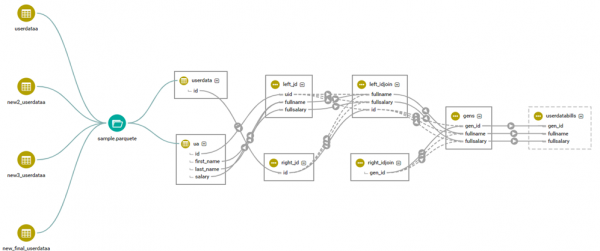
Medzi inými, pomocou low-code a konkrétne Datagram je možné vyriešiť úlohu sledovania pôvodu objektov toku dát s atomickosťou až na jednotlivé polia (lineage). Na tento účel je v low-code nástroji implementované prepojenie s Apache Atlas a Cloudera Navigator. V podstate, vývojár musí registrovať súbor objektov v slovníkoch Atlas a odkazovať na registrované objekty pri vytváraní mapovaní. Mechanizmus sledovania pôvodu dát alebo analýza závislostí objektov šetrí veľké množstvo času pri potrebe vykonania zmien v algoritmoch výpočtu. Napríklad, pri zostavovaní finančnej správy táto funkcia umožňuje pohodlnejšie prežiť obdobie zmien legislatívy. Pretože čím kvalitnejšie si uvedomujeme medziformátovú závislosť v rámci objektov podrobnej vrstvy, tým menej sa stretneme s „nečakanými“ defektmi a znížime množstvo revokov.
Kvalita dát & low-code
Ďalšou úlohou, realizovanou low-code nástrojom na projekte spoločnosti Mediascope, bola úloha triedy Kvalita dát. Osobitosťou realizácie potrubia na kontrolu dát pre projekt výskumnej spoločnosti bol nedostatok vplyvu na funkčnosť a rýchlosť práce hlavného toku výpočtu dát. Na orchestráciu nezávislými tokmi kontroly dát sa používal už známy Apache Airflow. Ako sa každý krok výroby dát pripravil, súbežne prebiehal spustenie oddelenej časti DQ potrubia.
Dobrou praktikou je sledovanie kvality dát od momentu ich vzniku v analytickej platforme. Máme-li informácie o metadátach, môžeme už od momentu, keď informácie vstupujú do primárnej vrstvy, kontrolovať dodržiavanie základných podmienok — not null, constraints, foreign keys. Táto funkcia bola realizovaná na základe automaticky generovaných mapovaní rodiny kvality dát v Datagram. Kódo-generácia v tomto prípade sa taktiež zakladá na metadátach modelu. Na projekte spoločnosti Mediascope prebiehalo prepojenie s metadátami produktu Enterprise Architect.
Vďaka prepojeniu low-code nástroja a Enterprise Architect boli automaticky vygenerované nasledujúce kontroly:
- Kontrola prítomnosti hodnôt „null“ v poliach s modifikátorom „not null“;
- Kontrola prítomnosti duplikátov primárneho kľúča;
- Kontrola vonkajšieho kľúča entity;
- Kontrola jedinečnosti riadku podľa sady polí.
Pre zložitejšie kontroly dostupnosti a dôveryhodnosti dát bol vytvorený mapping so Scala Expression, ktorý prijíma externý Spark SQL kód kontroly, pripravený analytikmi v Zeppelinu.
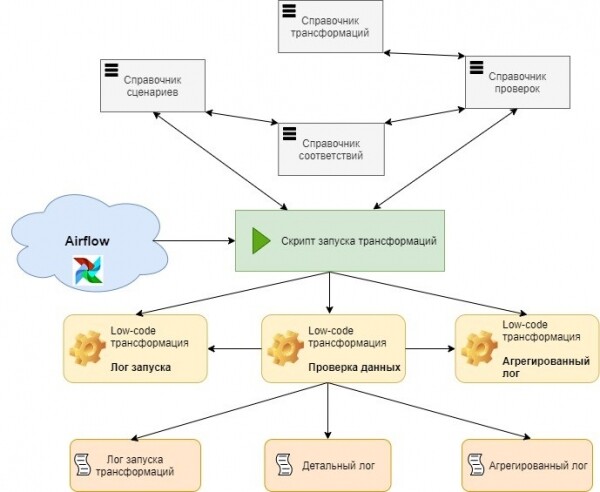
Samozrejme, k autogenerovaniu kontrol treba pristupovať postupne. V rámci opísaného projektu prebehli tieto kroky:
- DQ, realizované v poznámkových blokoch Zeppelin;
- DQ, integrované do mappingu;
- DQ vo forme samostatných masívnych mappingov, obsahujúcich kompletnú sadu kontrol pre konkrétnu entitu;
- Univerzálne parametre DQ-mappingy, ktoré prijímajú informácie o metadátach a obchodných kontrolách.
Snáď najväčšou výhodou vytvorenia služby parametrizovaných kontrol je skrátenie času dodania funkčnosti do produkčného prostredia. Nové kontroly kvality môžu obísť klasický vzor dodávania kódu nepriamo cez vývojové a testovacie prostredia:
- Všetky kontroly metadát sa generujú automaticky pri zmene modelu v EA;
- Kontroly dostupnosti dát (určenie prítomnosti akýchkoľvek dát v danom bode času) môžu byť vygenerované na základe registra, ktorý uchováva očakávaný časový rámec príchodu dávky dát v rozlíšení objektov;
- Obchodné kontroly dôveryhodnosti dát sa vytvárajú analytikmi v notebookoch Zeppelin. Odtiaľ sú priamo smerované do nastavovacích tabuliek modulu DQ v produkčnom prostredí.
Riziká priameho odosielania skriptov na produkciu prakticky neexistujú. Dokonca aj v prípade syntaktickej chyby je maximum, čo nám hrozí, – neuskutočnenie jednej kontroly, keďže tok výpočtu dát a tok spustenia kontrol kvality sú od seba oddelené.
V podstate je služba DQ nepretržite spustená v produkčnom prostredí a je pripravená začať svoju činnosť v momente príchodu novej dávky dát.
Na záver
Výhody nízkokódového prístupu sú jasné. Vývojári nemusia vyvíjať aplikáciu „od základov“. Uvoľnený programátor prichádza s výsledkom rýchlejšie. Rýchlosť, na druhej strane, uvoľňuje dodatočné časové zdroje na riešenie otázok optimalizácie. Preto sa v tomto prípade môže počítať s kvalitnejším a rýchlejším riešením.
Samozrejme, nízkokódové riešenia nie sú všeliek a zázrak sa sám od seba nestane:
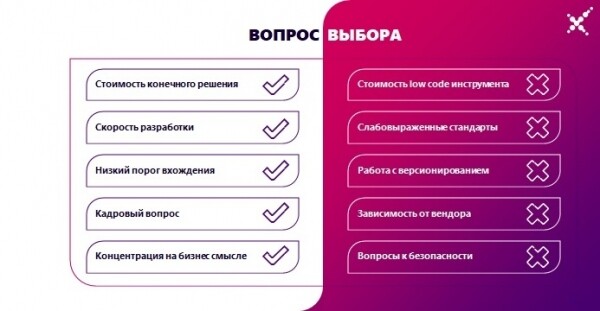
- Prítomnosť nízkokódového priemyslu prechádza fázou „posilnenia“ a zatiaľ neexistujú homogénne priemyselné štandardy;
- Mnohé nízkokódové riešenia nie sú zadarmo a ich získanie by malo byť vedomým krokom, ktorý by sa mal urobiť len pri plnej istote o finančnom prínose z ich použitia;
- Mnohé nízkokódové riešenia nie vždy dobre spolupracujú s GIT / SVN. Alebo sú nepríjemné na používanie v prípade skrytého generovaného kódu;
- Pri rozširovaní architektúry môže byť potrebné upraviť nízkokódové riešenie – čo na druhej strane vyvoláva efekt „závislosti“ od poskytovateľa nízkokódového riešenia.
- Prijateľná úroveň zabezpečenia je možná, ale je veľmi náročná a zložitá na implementáciu motorov nízkokódových systémov. Nízkokódové platformy by sa mali vyberať nie iba na základe hľadania zisku z ich použitia. Pri výbere by sa malo zamyslieť nad funkčnosťou správy prístupu a delegovaním/eskaláciou identifikačných údajov na úroveň celej IT krajiny organizácie.
Ak sú vám všetky nedostatky zvoleného systému známe a prínosy z jeho používania sú napriek tomu prevažne pozitívne, prejdite na nízkokódové riešenie bez obáv. O to viac, že prechod naň je nevyhnutný – rovnako ako každá evolúcia.
Ak jeden vývojár na platforme s nízkym kódom dokončí svoju prácu rýchlejšie ako dvaja vývojári bez nízkého kódu, poskytuje to spoločnosti výhodu vo všetkých ohľadoch. Prahová hodnota vstupu do riešení s nízkym kódom je nižšia ako v prípade "tradičných" technológií, čo má pozitívny vplyv na otázku nedostatku pracovnej sily. Používanie nástrojov s nízkym kódom môže urýchliť spoluprácu medzi funkčnými tímami a rýchlejšie prijímanie rozhodnutí o správnosti zvolenej cesty data-science výskumu. Nízkoúrovňové platformy môžu byť príčinou digitálnej transformácie organizácie, pretože vytvorené riešenia môžu byť chápané aj netechnickými špecialistami (konkrétne obchodnými používateľmi).
Ak máte úzke časové rámce, náročnú obchodnú logiku, nedostatok technologických odborností a potrebujete urýchliť uvedenie na trh, potom je low-code jedným zo spôsobov, ako naplniť vaše potreby.
Nie je možné poprieť význam tradičných vývojových nástrojov, avšak v mnohých prípadoch je použitie riešení s nízkym kódom najlepším spôsobom, ako zvýšiť efektivitu riešenia úloh.
Zdroj: habr.com
