

DataHub s otvoreným zdrojovým kódom: platforma na vyhľadávanie a objavovanie metadát zo spoločnosti LinkedIn
Rýchle vyhľadávanie potrebných údajov je nevyhnutné pre každú spoločnosť, ktorá sa spolieha na veľké množstvo dát pri rozhodovaní na ich základe. To nielenže ovplyvňuje produktivitu používateľov dát (vrátane analytikov, vývojárov strojového učenia, dátových vedcov a inžinierov dát), ale má aj priame následky na konečné produkty, ktoré závisia od kvalitného procesu strojového učenia (ML). Okrem toho tendencia zavádzať alebo vytvárať platformy strojového učenia prirodzene vyvoláva otázku: aká je vaša metóda vnútorného objavovania funkcií, modelov, metrik, dátových súborov atď.
V tomto článku sa podelíme o to, ako sme publikovali zdroj dát pod otvorenou licenciou na našej platforme na vyhľadávanie a objavovanie metadát, počínajúc prvými dňami projektu . LinkedIn prevádzkuje svoju vlastnú verziu DataHub oddelene od verzie s otvoreným zdrojovým kódom. Začneme vysvetlením, prečo potrebujeme dve samostatné vývojové prostredia, po ktorom sa budeme zaoberať prvými prístupmi k používaniu WhereHows s otvoreným kódom a porovnáme našu internú (produkčnú) verziu DataHub s verziou na . Takisto sa podelíme o podrobnosti o našom novom automatizovanom riešení na odosielanie a prijímanie aktualizácií s otvoreným zdrojovým kódom, aby sme synchronizovali obidva repozitáre. Nakoniec poskytneme pokyny, ako začať používať DataHub s otvoreným zdrojovým kódom, a stručne prediskutujeme jeho architektúru.
WhereHows je teraz DataHub!
Tím metadát LinkedIn predtým predstavil (nástupcu WhereHows), platformu na vyhľadávanie a objavovanie metadát LinkedIn a podelil sa o plány na jeho otvorenie. Čoskoro po tomto oznámení sme vydali alfa verziu DataHub a zdieľali ju so spoločnosťou. Odvtedy sme neustále prispievali do repozitára a spolupracovali so zainteresovanými používateľmi na pridávaní najžiadanejších funkcií a riešení problémov. Teraz s radosťou oznamujeme oficiálne vydanie .
Prístupy s otvoreným zdrojovým kódom
WhereHows, pôvodný portál LinkedIn pre vyhľadávanie dát a ich pôvodu, bol spustený ako interný projekt; tím metadát ho otvoril . Odvtedy tím vždy podporoval dve rôzne kódové základne — jednu pre otvorený zdrojový kód a druhú pre interné použitie LinkedIn, keďže nie všetky funkcie produktu navrhnuté pre varianty použitia LinkedIn boli vo všeobecnosti aplikovateľné na širšie publikum. Navyše, WhereHows má niektoré interné závislosti (infrastruktúra, knižnice atď.), ktorých zdrojový kód nie je otvorený. V nasledujúcich rokoch prešiel WhereHows množstvom iterácií a vývojových cyklov, čo spôsobilo, že synchronizácia dvoch kódových základní bola veľkým problémom. Tím metadát sa roky snažil využívať rôzne prístupy na pokusy o synchronizáciu internej a otvorenej vývoja.
Prvý pokus: „Najprv otvorený kód“
Pôvodne sme sa riadili modelom vývoja „najprv otvorený zdrojový kód“, kde hlavný vývoj prebieha v úložisku s otvoreným zdrojovým kódom a zmeny sa implementujú pre interné nasadenie. Problém s týmto prístupom spočíva v tom, že kód je vždy najprv odoslaný na GitHub, skôr ako je úplne skontrolovaný interne. Kým nebudú vykonané zmeny z úložiska s otvoreným zdrojovým kódom a nebude vykonané nové interné nasadenie, neobjavíme žiadne produkčné problémy. V prípade zle vykonaného nasadenia bolo tiež veľmi ťažké určiť vinníka, pretože zmeny boli zavedené v dávkach.
Okrem toho tento model znížil produktivitu tímu pri vývoji nových funkcií, ktoré si vyžadovali rýchle iterácie, pretože všetky zmeny sa museli najprv umiestniť do úložiska s otvoreným zdrojovým kódom a potom preniesť do interného úložiska. Aby sa skrátil čas spracovania, potrebná oprava alebo zmena sa mohla najprv uskutočniť v internom úložisku, ale to sa stalo obrovským problémom, pokiaľ išlo o zlúčenie týchto zmien späť do úložiska s otvoreným zdrojovým kódom, pretože dve úložiská sa dostali mimo synchronizáciu.
Tento model je výrazně jednodušší implementovat pro obecné platformy, knihovny nebo infrastrukturní projekty než pro plně funkční uživatelské webové aplikace. Navíc je tento model ideální pro projekty, které od prvního dne začínají s otevřeným zdrojovým kódem, ale WhereHows bylo vyvíjeno jako plně interní webová aplikace. Bylo opravdu obtížné se zcela abstrahovat od všech vnitřních závislostí, proto jsme museli zachovat interní fork, ale zachování interního forku a vývoj převážně s otevřeným zdrojovým kódem se úplně nepovedl.
Druhý pokus: "Nejprve interně"
** Při druhém pokusu jsme přešli na model vývoje "nejprve interně", v němž probíhá hlavní vývoj uvnitř společnosti a změny jsou pravidelně zaváděny do otevřeného zdrojového kódu. Ačkoli je tento model nejlépe přizpůsoben našemu případu použití, má své problémy. Přímé odesílání všech rozdílů do repozitáře s otevřeným zdrojovým kódem a poté pokus o vyřešení konfliktů sloučení později je možnost, ale zabírá to hodně času. Většina vývojářů se snaží tomu vyhnout při každém přezkoumání kódu. V důsledku toho se to provádí mnohem méně často, po várkách, což tak ztěžuje následné řešení konfliktů sloučení.
Třetí pokus se vydařil!
Dvě zmíněné neúspěšné pokusy vedly k tomu, že repozitář WhereHows na GitHubu zůstal dlouho zastaralý. Tým nadále vylepšoval funkce a architekturu produktu, takže interní verze WhereHows pro LinkedIn se stala mnohem pokročilejší než verze s otevřeným zdrojovým kódem. Měla dokonce nové jméno — DataHub. Na základě předchozích neúspěšných pokusů se tým rozhodl vyvinout škálovatelné dlouhodobé řešení.
Pro jakýkoli nový projekt s otevřeným zdrojovým kódem tým vývojářů otevřeného zdrojového kódu LinkedIn konzultuje a podporuje model vývoje, v němž jsou moduly projektu zcela vyvíjeny s otevřeným zdrojovým kódem. Artefakty s podporou verzí jsou nasazeny do veřejného repozitáře a poté vráceny do interního artefaktu LinkedIn pomocí Dodržiavanie tohto modelu vývoja nie je len výhodné pre tých, ktorí používajú otvorený zdrojový kód, ale tiež vedie k vytváraniu modulárnejšej, rozšíriteľnejšej a pripojiteľnejšej architektúry.
Na dosiahnutie tohto stavu pre zrelú vnútornú aplikáciu, akou je DataHub, bude potrebné značné množstvo času. To tiež vylučuje možnosť otvoreného, plne funkčného implementovania, kým nebudú všetky vnútorné závislosti úplne znejasnené. Preto sme vyvinuli nástroje, ktoré nám pomáhajú prispievať k otvorenému zdrojovému kódu rýchlejšie a oveľa menej bolestne. Toto riešenie je výhodné ako pre tím metadát (vývojár DataHub), tak aj pre komunitu otvoreného zdrojového kódu. V nasledujúcich oddieloch sa bude diskutovať o tomto novom prístupe.
Automatizácia publikácie s otvoreným zdrojovým kódom
Posledný prístup skupiny metadát k DataHubu s otvoreným zdrojovým kódom spočíva vo vývoji nástroja, ktorý automaticky synchronizuje vnútornú kódovú základňu a repozitár s otvoreným zdrojovým kódom. Hlavné funkcie tohto nástroja zahŕňajú:
- Synchronizáciu kódu LinkedIn s / z otvoreného zdrojového kódu, podobne ako .
- Generovanie hlavičky licencie, podobne ako .
- Automatické vytváranie logov commitov z otvoreného zdrojového kódu z vnútorných logov commitov.
- Zabránenie vnútorným zmenám, ktoré porušujú zostavenie otvoreného zdrojového kódu, testovaním závislostí. .
Synchronizácia zdrojového kódu
Na rozdiel od verzie DataHub s otvoreným zdrojovým kódom, ktorá predstavuje jeden repozitár na GitHub, verzia DataHub pre LinkedIn je kombináciou viacerých repozitárov (vo firme nazývaných
multiproducts Obrázok 1: Synchronizácia medzi repozitármi
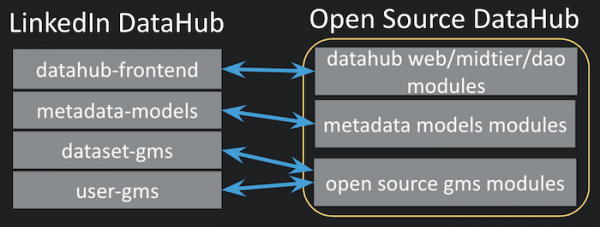
a jedným repozitárom LinkedIn DataHub s otvoreným zdrojovým kódom DataHub s otvoreným zdrojom
Na podporu automatických pracovných procesov zostavovania, odesielania a extrahovania náš nový nástroj automaticky vytvára mapovanie na úrovni súborov, ktoré zodpovedá každému zdrojovému súboru. Na poskytnutie nástrojov je však potrebná počiatočná konfigurácia a užívatelia musia poskytnúť prehľad na vysokej úrovni modulov, ako je uvedené nižšie.
{
  "datahub-dao": [
    "${datahub-frontend}/datahub-dao"
  ],
  "gms/impl": [
    "${dataset-gms}/impl",
    "${user-gms}/impl"
  ],
  "metadata-dao": [
    "${metadata-models}/metadata-dao"
  ],
  "metadata-builders": [
    "${metadata-models}/metadata-builders"
  ]
}
Mapovanie na úrovni modulu je jednoduchý JSON, ktorého kľúče sú cieľovými modulmi v repozitári s otvoreným zdrojovým kódom a hodnoty sú zoznamom zdrojových modulov v repozitároch LinkedIn. Akýkoľvek cieľový modul v repozitári s otvoreným zdrojovým kódom môže byť napájaný akýmkoľvek počtom zdrojových modulov. Na označenie interných názvov repozitárov v zdrojových moduloch sa používa v štýle Bash. Použitím mapovania na úrovni modulu nástroje vytvárajú mapovanie na úrovni súborov prehľadávaním všetkých súborov v súvisiacich adresároch.
{
  "${metadata-models}/metadata-builders/src/main/java/com/linkedin/Foo.java":
"metadata-builders/src/main/java/com/linkedin/Foo.java",
  "${metadata-models}/metadata-builders/src/main/java/com/linkedin/Bar.java":
"metadata-builders/src/main/java/com/linkedin/Bar.java",
  "${metadata-models}/metadata-builders/build.gradle": null,
}
Mapovanie na úrovni súborov sa automaticky vytvára nástrojmi; môže ho však užívateľ tiež aktualizovať ručne. Toto mapovanie predstavuje 1:1 zdrojového súboru LinkedIn so súborom v repozitári s otvoreným zdrojovým kódom. Existuje niekoľko pravidiel súvisiacich s týmto automatickým vytváraním mapovania súborov:
- V prípade viacerých zdrojových modulov pre cieľový modul môže v otvorenom zdroji dôjsť ku konfliktom, ako napríklad k tomu, že rovnaké , existuje viac ako v jednom zdrojovom module. Ako stratégia na riešenie konfliktov naše nástroje predvolene využívajú možnosť 'posledný vyhráva'.
- "null" znamená, že zdrojový súbor nie je súčasťou repozitára s otvoreným zdrojovým kódom.
- Po každom odoslaní do otvoreného zdrojového kódu alebo jeho extrakcii sa toto mapovanie automaticky aktualizuje a vytvorí sa okamžitý snímok. Je to potrebné na určenie prídavkov a odstránení zdrojového kódu po poslednej akcii.
Vytváranie logov zmien
Logy zmien pre zmeny s otvoreným zdrojovým kódom sa tiež automaticky vytvárajú kombinovaním logov zmien vnútorných repozitárov. Nižšie je uvedený príklad logu zmien, aby sa ukázala štruktúra logu zmien vytvoreného naším nástrojom. Zmeňte jasne uvádza, ktoré verzie zdrojových repozitárov sú zabalené v tejto zmene, a poskytuje zhrnutie logu zmien. Skontrolujte tento na reálnom príklade logu zmien vytvoreného naším nástrojom.
metadata-models 29.0.0 -> 30.0.0
    Pridaný aspektový model foo
    Opravený problém bar

dataset-gms 2.3.0 -> 2.3.4
    Pridané rest.li API na obsluhu aspektu foo

MP_VERSION=dataset-gms:2.3.4
MP_VERSION=metadata-models:30.0.0
Testovanie závislostí
LinkedIn má , ktorá pomáha zabezpečiť, aby zmeny vnútorného multi-produktu nenarušili zostavenie závislých multi-produktov. Repozitár DataHub s otvoreným zdrojovým kódom nie je multi-produktovým a nemôže byť priamou závislosťou od žiadneho multi-produktu, ale pomocou multi-produktovej šablóny, ktorá extrahuje otvorený zdrojový kód DataHub, môžeme túto testovaciu infraštruktúru závislostí stále používať. Tým pádom akákoľvek zmena (ktorá môže byť neskôr otvorená) v akomkoľvek z multi-produktov, ktoré napájajú repozitár DataHub s otvoreným zdrojovým kódom, spúšťa udalosť zostavenia v multi-produktovej šablóne. Preto akákoľvek zmena, ktorá neumožňuje zostaviť multi-produktovú šablónu, neprejde testami pred odoslaním zdrojového multi-produktu a vráti sa.
Je to užitočný mechanizmus, ktorý pomáha zabrániť akémukoľvek vnútornému odoslaniu, ktoré narušuje zostavenie s otvoreným zdrojovým kódom, a odhalí ho počas vytvárania odoslania. Bez toho by bolo pomerne ťažké určiť, ktorý vnútorný commit spôsobil zlyhanie zostavenia repozitára s otvoreným zdrojovým kódom, pretože vkladáme balíkové vnútorné zmeny do repozitára DataHub s otvoreným zdrojovým kódom.
Rozdiely medzi otvoreným zdrojovým DataHub a našou výrobnou verziou
Doteraz sme sa zaoberali naším riešením na synchronizáciu dvoch verzií repozitárov DataHub, ale ešte sme neoznačili dôvody, prečo vôbec potrebujeme dva rôzne vývojové prúdy. V tejto časti vymenujeme rozdiely medzi verejnou verziou DataHub a výrobnou verziou na serveroch LinkedIn a vysvetlíme dôvody týchto rozdielov.
Jedným zo zdrojov rozdielov vyplýva z toho, že naša výrobná verzia má závislosti na kóde s ešte neotvoreným zdrojom, ako je LinkedIn’s Offspring (vnútorná infraštruktúra pre správu závislostí LinkedIn). Offspring sa široko používa vo vnútornej kódovej základni, pretože to je preferovaný spôsob správy dynamickej konfigurácie. Ale nie je to s otvoreným zdrojom; preto sme museli nájsť alternatívy s otvoreným zdrojom pre otvorený DataHub.
Sú aj ďalšie dôvody. Ako vytvárame rozšírenia modelu metadát pre potreby LinkedIn, tieto rozšírenia sú zvyčajne veľmi špecifické pre LinkedIn a nemusia sa priamo uplatniť v iných prostrediach. Napríklad máme veľmi špecifické značky pre identifikátory účastníkov a iné typy metadát zhodovania. Takže v súčasnosti sme tieto rozšírenia vylúčili z modelu metadát otvoreného DataHub. Keď budeme spolupracovať s komunitou a porozumieme ich potrebám, budeme pracovať na spoločných verziách týchto rozšírení s otvoreným zdrojom, kde to bude potrebné.
Jednoduchosť použitia a ľahšia prispôsobiteľnosť pre komunitu otvoreného zdroja tiež inšpirovala niektoré rozdiely medzi dvoma verziami DataHub. Rozdiely v infraštruktúre spracovania toku sú dobrým príkladom. Hoci naša vnútorná verzia používa infraštruktúru spravovanej spracovania toku, rozhodli sme sa použiť zabudované (autonómne) spracovanie toku pre otvorenú verziu, pretože to umožňuje vyhnúť sa vytváraniu ďalšej závislosti infraštruktúry.
Ďalším príkladom rozdielu je existencia jedného GMS (Generálne metadata storage) v implementácii s otvoreným kódom, a nie viacerých GMS. GMA (Generálna architektúra metadát) je názov vnútornej architektúry pre DataHub, zatiaľ čo GMS je úložisko metadát v kontexte GMA. GMA je veľmi flexibilná architektúra, ktorá umožňuje distribuovať každú dátovú štruktúru (napríklad súbory dát, používateľov atď.) do vlastného úložiska metadát alebo uchovávať viacero dátových štruktúr v jednom úložisku metadát, kým je registrácia, ktorá obsahuje zobrazenie dátovej štruktúry v GMS, aktualizovaná. Pre zjednodušenie sme si vybrali jeden príklad GMS, ktorý uchováva všetky rôzne dátové štruktúry v DataHub s otvoreným kódom.
Celý zoznam rozdielov medzi dvoma implementáciami je uvedený v tabuľke nižšie.
Funkcie produktu
LinkedIn DataHub
Open Source DataHub
Podporované dátové konštrukty
1) Súbory dát 2) Používatelia 3) Metriky 4) ML funkcie 5) Grafy 6) Dashboardy
1) Súbory dát 2) Používatelia
Podporované zdroje metadát pre súbory dát
1) 2) Couchbase 3) 4) 5) HDFS 6) Hive 7) Kafka 8) MongoDB 9) MySQL 10) Oracle 11) 12) Presto 12) 13) Teradata 13) Vector 14)
Hive Kafka RDBMS
Pub-sub
Confluent Kafka
Spracovanie streamov
Spravované
Vložené (samostatné)
Dependency Injection & Dynamická konfigurácia
LinkedIn Offspring
Nástroje na zostavovanie
Ligradle (interný wrapper Gradle LinkedIn)
CI/CD
CRT (interný CI/CD LinkedIn)
a
Úložiská metadát
Distribuované viaceré GMS: 1) Dataset GMS 2) User GMS 3) Metric GMS 4) Feature GMS 5) Chart/Dashboard GMS
Jednotné GMS pre: 1) Súbory dát 2) Používatelia
Mikroslužby v kontajneroch Docker
uľahčuje nasadenie a distribúciu aplikácií pomocou . Každá časť služby v DataHub s otvoreným kódom, vrátane komponentov infraštruktúry, ako je Kafka, , a , má svoj vlastný obraz Docker. Na orchestráciu kontajnerov Docker sme použili .
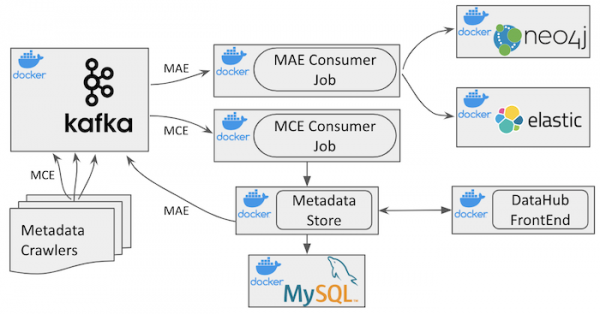
Obrázok 2: Architektúra DataHub *s otvoreným kódom**
Môžete vidieť vysokoúrovňovú architektúru DataHub na obrázku vyššie. Okrem komponentov infraštruktúry má štyri rôzne kontajnery Docker:
datahub-gms: služba úložiska metadát
datahub-frontend: aplikácia , poskytujúca rozhranie DataHub.
datahub-mce-consumer: aplikácia , ktorá používa tok udalostí zmien metadát (MCE) a aktualizuje úložisko metadát.
datahub-mae-consumer: aplikácia , ktorá používa tok udalostí auditu metadát (MAE) a vytvára databázu vyhľadávacieho indexu a grafu.
Dokumentácia k repozitáru s otvoreným zdrojovým kódom a obsahuje podrobnejšie informácie o funkciách rôznych služieb.
CI / CD v DataHub s otvoreným zdrojovým kódom
Repozitár DataHub s otvoreným zdrojovým kódom používa na kontinuálnu integráciu a na kontinuálne nasadzovanie. Obe majú dobrú integráciu s GitHubom a sú jednoduché na nastavenie. Väčšina infraštruktúry s otvoreným zdrojovým kódom, vyvinutej komunitou alebo súkromnými spoločnosťami (napríklad, ), sú vytvorené Docker obrazy, ktoré sú nasadené na Docker Hub na zjednodušenie využitia komunitou. Akýkoľvek Docker obraz nájdený na Docker Hub sa dá jednoducho použiť pomocou príkazu .
Pri každom commite v repozitári s otvoreným zdrojovým kódom DataHub sa všetky Docker obrazy automaticky vytvárajú a nasadzujú na Docker Hub s tagom 'latest'. Ak je na Docker Hub nastavená nejaká , všetky tagy v repozitári s otvoreným zdrojovým kódom sú tiež vydané s príslušnými názvami tagov na Docker Hub.
Používanie DataHub
je veľmi jednoduché a pozostáva z troch jednoduchých krokov:
- Klónujte repozitár s otvoreným zdrojovým kódom a spustite všetky Docker kontajnery pomocou docker-compose pomocou poskytovaného skriptu docker-compose na rýchle spustenie.
- Stiahnite si vzorové dáta, ktoré sú uvedené v repozitári, pomocou nástroja príkazového riadka, ktorý je tiež poskytovaný.
- Prehľadávajte DataHub vo svojom prehliadači.
Aktívne monitorovaný je tiež nastavený na rýchle otázky. Používatelia môžu tiež vytvárať problémy priamo v repozitári GitHub. Najdôležitejšie je, že vítame a oceňujeme všetku spätnú väzbu a návrhy!
Plány do budúcnosti
V súčasnosti je každá infraštruktúra alebo mikroslužba pre DataHub s otvoreným zdrojovým kódom postavená ako Docker kontajner a celý systém je orchestrujeme pomocou . Vzhľadom na popularitu a široké rozšírenie , by sme tiež chceli poskytnúť riešenie založené na Kubernetes v blízkej budúcnosti.
Taktiež plánujeme poskytnúť hotové riešenie pre nasadenie DataHub v verejnej cloudovej službe, ako je , alebo . Vzhľadom na nedávne oznámenie o migrácii LinkedIn na Azure, to bude zodpovedať vnútorným prioritám skupiny metadát.
A nakoniec, ale nie menej dôležité: ďakujeme všetkým prvým používateľom DataHub v komunite s otvoreným zdrojovým kódom, ktorí ocenili alfa verzie DataHub a pomohli nám odhaliť problémy a vylepšiť dokumentáciu.
Zdroj: habr.com
