

Vysoký výkon je jednou z kľúčových požiadaviek pri práci s veľkými dátami. V oblasti správy dátovej záťaže v Sberbank sa zaoberáme spracovaním takmer všetkých transakcií do nášho Cloud Datacentra založeného na Hadoop, a preto sa vysporiadavame s skutočne veľkými tokmi informácií. Samozrejme, neustále hľadáme spôsoby, ako zvýšiť výkon, a teraz chceme rozprávať o tom, ako sa nám podarilo patche RegionServer HBase a HDFS klienta, vďaka čomu sa výrazne zvýšila rýchlosť čítania operácií.
Avšak predtým, ako prejdeme k podstate vylepšení, je potrebné prediskutovať obmedzenia, ktorým sa vo všeobecnosti nedá vyhnúť, ak používate HDD.
Prečo sú HDD a rýchle náhodné prístupy na čítanie nezlučiteľné
Ako je známe, HBase, ako aj mnohé iné databázy, ukladajú dáta po blokoch s veľkosťou niekoľkých desiatok kilobajtov. Predvolene to je okolo 64 kB. Predstavme si teraz, že potrebujeme získať len 100 bajtov a žiadame HBase, aby nám tieto údaje poskytol na základe určitého kľúča. Keďže veľkosť bloku v HFiles je 64 kB, požaduje sa 640-krát viac (na minútu!) ako je potrebné.
Ďalej, keďže dotaz pôjde cez HDFS a jeho mechanizmus ukladania metadata ShortCircuitCache (ktorý umožňuje priamy prístup k súborom), čo vedie k čítaniu už 1 MB z disku. Napriek tomu to možno regulovať parametrom dfs.client.read.shortcircuit.buffer.size a v mnohých prípadoch má zmysel znížiť túto hodnotu, napríklad na 126 kB.
Predpokladajme, že to urobíme, ale okrem toho, keď začneme čítať údaje cez java API pomocou funkcií ako FileChannel.read a žiadame operačný systém, aby prečítal uvedený objem údajov, načíta „pre istotu“ dvakrát viac, t.j. 256 kB v našom prípade. To sa deje, pretože v jave neexistuje jednoduchá možnosť nastaviť flag FADV_RANDOM, ktorý by zabránil takémuto správaniu.
Nakoniec, aby sme dostali našich 100 bajtov, pod kapotou sa prečíta 2600-krát viac. Zdalo by sa – riešenie je jasné, znížme veľkosť bloku na kilobajt, nastavme uvedený flag a získame úžasné zrýchlenie. Ale problém je v tom, že znižovaním veľkosti bloku na polovicu znižujeme aj počet prečítaných bajtov za jednotku času tiež na polovicu.
Určité výhody plynúce z nastavenia príznaku FADV_RANDOM je možné získať, ale iba pri veľkej viacvláknovosti a pri veľkosti bloku od 128 KB, maximálne však pri pár desiatkach percent.
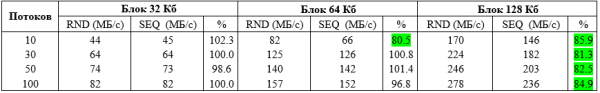
Testy sa vykonávali na 100 súboroch, každý s veľkosťou 1 GB a umiestnených na 10 HDD diskoch.
Počítajme, akú rýchlosť môžeme v takýchto podmienkach očakávať:
Predpokladajme, že čítame z 10 diskov rýchlosťou 280 MB/s, t.j. 3 milióny krát po 100 bajtov. Ale ako vieme, dáta, ktoré potrebujeme, sa objavujú v 2600-krát menej často ako to, čo je prečítané. Takže 3 milióny delíme 2600 a dostaneme 1100 zápisov za sekundu.
Desivé, však? Taká je povaha Random Access prístupu k dátam na HDD - bez ohľadu na veľkosť bloku. Toto je fyzický limit náhodného prístupu a žiadna databáza v takých podmienkach nemôže dosiahnuť viac.
Ako teda databázy dosahujú podstatne vyššie rýchlosti? Aby sme odpovedali na túto otázku, pozrime sa, čo sa deje na nasledujúcom obrázku:
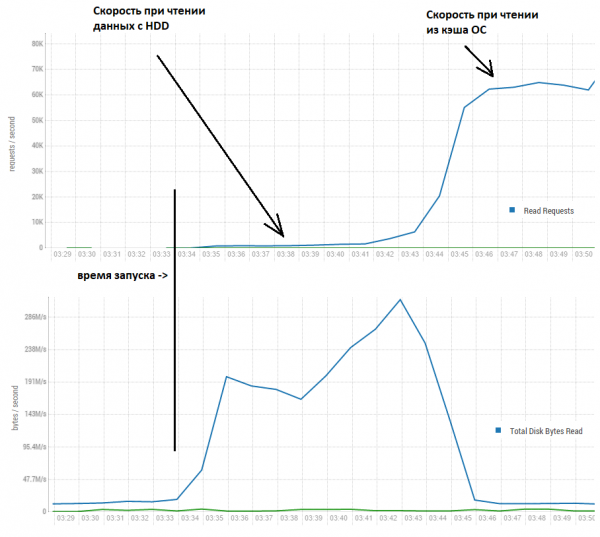
Tu vidíme, že prvé minúty sa rýchlosť skutočne pohybuje okolo tisícky zápisov za sekundu. Avšak neskôr, vďaka tomu, že sa prečíta oveľa viac, než bolo požadované, dáta sa ukladajú do buff/cache operačného systému (Linux) a rýchlosť rastie na prijateľných 60 tisíc za sekundu.
Týmto smerom sa budeme zaoberať iba urýchlením prístupu k tým dátam, ktoré sú v pamäti OS alebo sa nachádzajú v porovnateľných úložiskách s rýchlym prístupom ako SSD/NVMe.
V našom prípade vykonáme testy na konfigurácii 4 serverov, z ktorých každý je vybavený nasledujúcim spôsobom:
CPU: Xeon E5-2680 v4 @ 2.40GHz 64 vlákien.
Pamäť: 730 GB.
java verzia: 1.8.0_111
A tu prichádza kľúčový aspekt - objem dát v tabuľkách, ktoré je potrebné prečítať. Ide o to, že ak čítame dáta z tabuľky, ktorá sa celkom zmestí do cache HBase, tak k prečítaniu z buff/cache operačného systému sa ani nedostaneme. Pretože HBase predvolene vyčleňuje 40% pamäte na štruktúru, ktorá sa nazýva BlockCache. V zásade ide o ConcurrentHashMap, kde kľúčom je názov súboru + offset bloku, a hodnotou sú vlastne dáta na tomto posunutí.
Tým pádom, keď čítanie prebieha iba z tejto štruktúry, , ako by to bolo milión požiadaviek za sekundu. Ale predstavme si, že nemôžeme poskytnúť stovky gigabajtov pamäte len pre potreby databázy, pretože na týchto serveroch beží aj veľa užitočných vecí.
Napríklad v našom prípade objem BlockCache na jednom RS je približne 12 GB. Nasadili sme dva RS na jednu uzol, t.j. pre BlockCache je vyhradených 96 GB na všetkých uzloch. A dát je pritom omnoho viac, povedzme, že to budú 4 tabuľky, po 130 regiónoch, kde sú súbory veľké po 800 MB, stlačené FAST_DIFF, t.j. v súhrne 410 GB (to sú čisté dáta, t.j. bez započítania faktora replikácie).
Týmto spôsobom BlockCache tvori len približne 23% z celkového objemu dát a to je omnoho bližšie k skutočným podmienkam toho, čo sa nazýva BigData. A tu sa začína to najzaujímavejšie — je zrejmé, že čím menej zásahov do cache, tým horšia výkonnosť. Veď v prípade netrafenia bude potrebné vykonať množstvo práce — t.j. spustiť systémové funkcie. Avšak tomuto sa nedá vyhnúť, a preto sa poďme pozrieť na úplne iný aspekt — čo sa deje s dátami vo vnútri cache?
Zjednodušme situáciu a predpokladajme, že máme cache, do ktorej sa zmestí iba 1 objekt. Toto je príklad toho, čo sa stane pri pokuse pracovať s objemom dát trikrát väčším ako je cache, budeme musieť:
1. Vložiť blok 1 do cache
2. Odstrániť blok 1 z cache
3. Vložiť blok 2 do cache
4. Odstrániť blok 2 z cache
5. Vložiť blok 3 do cache
Vykonaných 5 akcií! Avšak túto situáciu nemožno nazvať normálnou, v podstate nútime HBase vykonávať množstvo úplne zbytočnej práce. Neustále číta údaje z cache OS, vkladá ich do BlockCache, len aby ich takmer okamžite zahodil, pretože prišla nová várka dát. Animácia na začiatku príspevku ilustruje podstatu problému — Garbage Collector preťažuje, atmosféra sa otepľuje, malá Greta v ďalekej a horúcej Švédsku je smutná. A my, IT profesionáli, veľmi nemáme radi, keď sú deti smutné, preto začíname premýšľať, čo s tým môžeme urobiť.
A čo ak by sme do cache umiestnili nie všetky bloky, ale len určitý percentuálny podiel z nich, aby sa cache nepreplnila? Poďme najprv jednoducho pridať niekoľko riadkov kódu na začiatok funkcie na vloženie dát do BlockCache:
  public void cacheBlock(BlockCacheKey cacheKey, Cacheable buf, boolean inMemory) {
    if (cacheDataBlockPercent != 100 && buf.getBlockType().isData()) {
      if (cacheKey.getOffset() % 100 >= cacheDataBlockPercent) {
        return;
      }
    }
...
Zmysel spočíva v tom, že offset je poloha bloku v súbore a posledné čísla sú náhodne a rovnomerne rozdelené od 00 do 99. Preto budeme preskakovať iba tie, ktoré sa dostanú do požadovaného rozsahu.
Napríklad nastavíme cacheDataBlockPercent na 20 a pozrieme sa, čo sa stane:
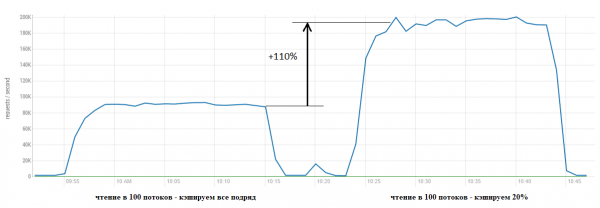
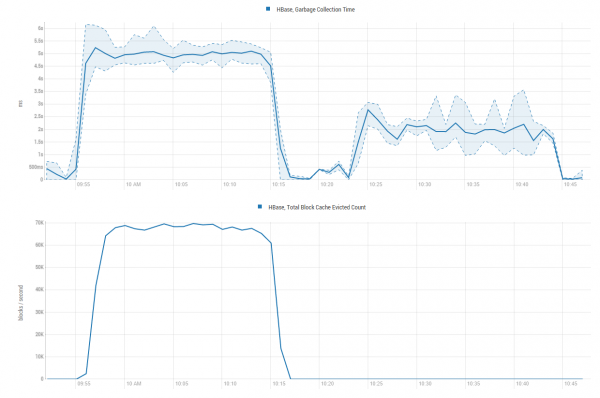
Výsledok je na svete. Na nižšie uvedených grafoch je jasné, z čoho sa také zrýchlenie stalo — šetríme obrovské množstvo zdrojov GC, nezabývame sa sizyfovskou prácou umiestňovania dát do cache, len aby sme ich potom ihneď vyhodili nejakým marťanským psom pod chvost:
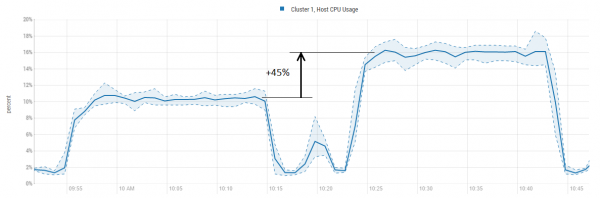
Využitie CPU pritom rastie, ale oveľa menej než výkon:
Tu je tiež potrebné poznamenať, že bloky, ktoré sú uložené v BlockCache, môžu byť rôzne. Väčšina, približne 95%, sú vlastne dáta. A zvyšok sú metadata, ako Bloom filtre alebo LEAF_INDEX a . Týchto dát je málo, ale sú veľmi užitočné, pretože predtým, než sa priamo obrátia na dáta, HBase sa obracia na meta, aby zistila, či má hľadať ďalej a ak áno, tak kde sa presne nachádza zaujímavý blok.
Preto v kóde vidíme podmienku kontrolu buf.getBlockType().isData() a vďaka tejto mete budeme v každom prípade uchovávať v cache.
Teraz zvýšme záťaž a zároveň trochu vyladíme funkciu. V prvom teste sme nastavili percento odrezania na 20 a BlockCache bol mierne nedostatočne zaťažený. Teraz nastavíme 23% a budeme pridávať po 100 vlákien každých 5 minút, aby sme videli, v ktorom momente dochádza k saturácii:
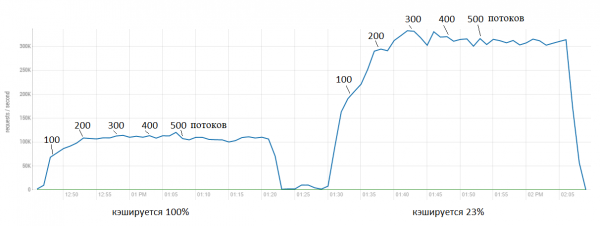
Tu vidíme, že pôvodná verzia sa takmer okamžite dostáva na strop na úrovni okolo 100 tisíc požiadaviek za sekundu. Zatiaľ čo oprava poskytuje zrýchlenie až na 300 tisíc. Pri tom je jasné, že ďalšie zrýchlenie už nie je také „bezplatné“, využitie CPU pritom tiež rastie.
Ale to nie je veľmi elegantné riešenie, pretože vopred nevieme, aké percento blokov je potrebné cachovať, to závisí od profilu záťaže. Preto bol implementovaný mechanizmus automatického prispôsobenia tohto parametra v závislosti od aktivity čítacích operácií.
Na riadenie toho bolo pridaných tri parametre:
hbase.lru.cache.heavy.eviction.count.limit — nastavuje, koľkokrát by sa mal proces uvoľňovania dát z cache spustiť, predtým, než začneme používať optimalizáciu (t.j. preskočiť bloky). Predvolená hodnota je MAX_INT = 2147483647, čo v podstate znamená, že funkcia sa nikdy nezačne aktivovať pri tejto hodnote. Pretože proces uvoľňovania sa spúšťa každých 5 — 10 sekúnd (závisí od zaťaženia) a 2147483647 * 10 / 60 / 60 / 24 / 365 = 680 rokov. Môžeme však nastaviť tento parameter na 0 a prinútiť funkciu pracovať hneď po spustení.
Existuje však aj užitočná stránka tohto parametra. Ak máme zaťaženie, pri ktorom sa neustále striedajú krátkodobé čítania (povedzme cez deň) a dlhodobé (v noci), môžeme nastaviť, aby sa funkcia aktivovala iba pri dlhších operáciách čítania.
Napríklad vieme, že krátkodobé čítania zvyčajne trvajú približne 1 minútu. Nie je potrebné začať vyhadzovať bloky, cache nestihne zastarať, a teda môžeme nastaviť tento parameter na 10. To spôsobí, že optimalizácia sa začne aktivovať iba vtedy, keď začnú dlhodobé aktívne čítania, t.j. po 100 sekundách. Takže ak máme krátkodobé čítanie, všetky bloky sa dostanú do cache a budú dostupné (okrem tých, ktoré budú vyhodené štandardným algoritmom). A keď robíme dlhodobé čítania, funkcia sa aktivuje a dosiahneme omnoho vyšší výkon.
hbase.lru.cache.heavy.eviction.mb.size.limit — nastavuje, ako veľa megabajtov by sme chceli umiestniť do cache (a samozrejme uvoľniť) za 10 sekúnd. Funkcia sa pokúsi dosiahnuť túto hodnotu a udržiavať ju. Zmysel spočíva v tom, ak dávame do cache gigabajty, budeme musieť aj uvoľniť gigabajty, čo, ako sme videli vyššie, je dosť nákladné. Avšak nemali by sme sa pokúšať nastaviť ju príliš nízku, pretože to povedie k predčasnému ukončeniu režimu preskočenia blokov. Pre výkonné servery (približne 20-40 fyzických jadier) je optimálne nastaviť približne 300-400 MB. Pre strednú triedu (~10 jadier) 200-300 MB. Pre slabšie systémy (2-5 jadier) môže byť prijateľné 50-100 MB (na týchto nebolo testované).
Pozrime sa, ako to funguje: povedzme, že sme nastavili hbase.lru.cache.heavy.eviction.mb.size.limit = 500, prebieha nejaká záťaž (čítanie) a potom každých ~10 sekúnd vypočítavame, koľko bajtov bolo uvoľnených pomocou vzorca:
Overhead = Suma uvoľnených bajtov (MB) * 100 / Limit (MB) — 100;
Ak bolo v skutočnosti uvoľnených 2000 MB, potom Overhead bude:
2000 * 100 / 500 — 100 = 300%
Algoritmy sa snažia udržiavať maximálne niekoľko desiatok percent, takže funkcia zníži percento vyrovnávacích blokov, čím sa realizuje mechanizmus automatického ladenia.
Avšak ak záťaž klesla, povedzme, že bolo uvoľnených iba 200 MB a Overhead sa stal negatívnym (takzvané overshooting):
200 * 100 / 500 — 100 = -60%
Funkcia naopak zvýši percento vyrovnávacích blokov, kým Overhead nebude kladný.
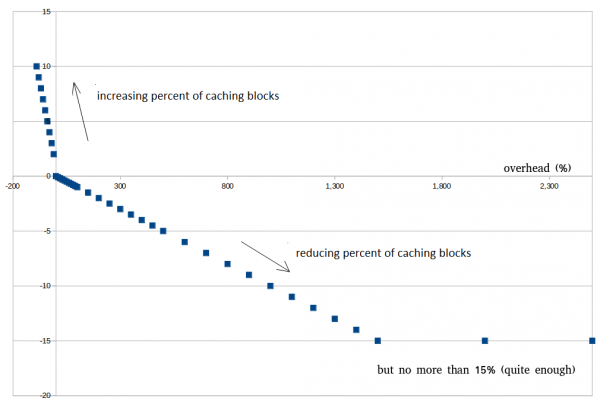
Nižšie bude príklad, ako to vyzerá na reálnych dátach. Nenechajte sa pokúšať dosiahnuť 0%, to je nemožné. Je veľmi dobré, keď je to okolo 30 – 100%, to pomáha vyhnúť sa predčasnému opusteniu optimalizačného režimu pri krátkodobých výkyvoch.
hbase.lru.cache.heavy.eviction.overhead.coefficient — nastavuje, ako rýchlo by sme chceli dosiahnuť výsledok. Ak vieme, že naše čítania sú predovšetkým dlhé a nechceme čakať, môžeme zvýšiť tento koeficient a dosiahnuť vysoký výkon rýchlejšie.
Napríklad, ak sme nastavili tento koeficient = 0.01. To znamená, že Overhead (pozri vyššie) bude vynásobený touto hodnotou na dosiahnutý výsledok a percento vyrovnávacích blokov bude znížené. Povedzme, že Overhead = 300%, a koeficient = 0.01, potom percento vyrovnávacích blokov bude znížené o 3%.
Podobná logika «Backpressure» je implementovaná aj pre negatívne hodnoty Overhead (overshooting). Keďže sú vždy možné krátkodobé kolísania objemu čítaní-uvoľnení, tento mechanizmus pomáha vyhnúť sa predčasnému opusteniu optimalizačného režimu. Backpressure má obrátenú logiku: čím silnejšie je overshooting, tým viac blokov sa vyrovnáva.
Kód implementácie
        LruBlockCache cache = this.cache.get();
        if (cache == null) {
          break;
        }
        freedSumMb += cache.evict() / 1024 / 1024;
        /*
        * Niekedy čítame viac údajov, ako sa zmestí do BlockCache
        * a to je príčinou vysokého počtu evokácií.
        * To zase vedie k ťažkej práci Garbage Collectora.
        * Takže veľa blokov sa umiestni do BlockCache, ale nikdy sa nečíta,
        * pričom míňajú veľa CPU zdrojov.
        * Tu analyzujeme, koľko bajtov bolo oslobodených a rozhodneme
        * či nastal čas na zníženie počtu vytváraných blokov v cache.
        * Pomôže to vyhnúť sa umiestneniu príliš veľkého množstva blokov do BlockCache
        * keď evict() pracuje veľmi aktívne a ušetrí CPU na iné úlohy.
        * Viac podrobností: https://issues.apache.org/jira/browse/HBASE-23887
        */

        // Predovšetkým musíme kontrolovať, ako dlho
        // uplynulo od posledného spustenia evict()
        // To by malo byť takmer rovnaký čas (+/- 10s)
        // pretože dostávame porovnateľné objemy oslobodených bajtov pri každom spustení.
        // 10s, pretože toto je predvolený interval na spustenie evict() (pozri hore this.wait)
        long stopTime = System.currentTimeMillis();
        if ((stopTime - startTime) > 1000 * 10 - 1) {
          // Tu musíme vypočítať, akú situáciu máme.
          // Máme limit "hbase.lru.cache.heavy.eviction.bytes.size.limit"
          // a môžeme vypočítať preťaženie na ňom.
          // Túto informáciu použijeme na rozhodovanie,
          // ako zmeniť percento vytváraných blokov v cache.
          freedDataOverheadPercent =
            (int) (freedSumMb * 100 / cache.heavyEvictionMbSizeLimit) - 100;
          if (freedSumMb > cache.heavyEvictionMbSizeLimit) {
            // Teraz sme v situácii, keď sme nad limitom
            // Ale možno to budeme ignorovať, pretože to čoskoro skončí
            heavyEvictionCount++;
            if (heavyEvictionCount > cache.heavyEvictionCountLimit) {
              // Už to trvá dlho a musíme teraz znížiť množstvo vytváraných blokov
              // Takže tu vypočítame, koľko blokov chceme preskočiť.
              // Závisí to od:
              // 1. Preťaženie - ak je preťaženie veľké, mohli by sme byť agresívnejší
              // pri znížení počtu vytváraných blokov.
              // 2. Ako rýchlo chceme dosiahnuť výsledok. Ak vieme, že naše
              // ťažké čítanie trvá dlho, nechceme čakať a môžeme
              // zvýšiť koeficient a dosiahnuť dobrý výkon celkom rýchlo.
              // Ale ak si nie sme istí, môžeme to robiť pomaly a môže to zabrániť
              // predčasnému ukončeniu tohto režimu. Takže, keď je koeficient
              // vyšší, môžeme dosiahnuť lepší výkon, keď je ťažké čítanie stabilné.
              // Ale keď sa čítanie mení, môžeme sa prispôsobiť a nastaviť
              // koeficient na nižšiu hodnotu.
              int change =
                (int) (freedDataOverheadPercent * cache.heavyEvictionOverheadCoefficient);
              // Ale prax ukazuje, že zníženie o 15% je celkom dostatočné.
              // Nie sme chamtiví (to by mohlo viesť k predčasnému ukončeniu).
              change = Math.min(15, change);
              change = Math.max(0, change); // Myslím, že to sa nikdy nestane, ale kontrolujme to pre istotu
              // Takže tu je kľúčový bod, znižujeme % vytváraných blokov v cache
              cache.cacheDataBlockPercent -= change;
              // Ak ideme príliš hlboko, musíme sa tu zastaviť, 1% by malo byť aj tak.
              cache.cacheDataBlockPercent = Math.max(1, cache.cacheDataBlockPercent);
            }
          } else {
            // Nuž, dostali sme prehnanie.
            // Možno to je len krátkodobá fluktuácia a môžeme ostať v tomto režime.
            // Pomôže to vyhnúť sa predčasnému ukončeniu počas krátkodobých fluktuácií.
            // Ak je prehnanie menšie než 90%, pokúsime sa zvýšiť percento
            // vytváraných blokov a dúfame, že to bude stačiť.
            if (freedSumMb >= cache.heavyEvictionMbSizeLimit * 0.1) {
              // Jednoduchá logika: viac prehnania - viac vytváraných blokov (spätný tlak)
              int change = (int) (-freedDataOverheadPercent * 0.1 + 1);
              cache.cacheDataBlockPercent += change;
              // Ale nemôže to byť viac než 100%, takže skontrolujte to.
              cache.cacheDataBlockPercent = Math.min(100, cache.cacheDataBlockPercent);
            } else {
              // Vyzerá to, že ťažké čítanie sa skončilo.
              // Proste vystúpime z tohto režimu.
              heavyEvictionCount = 0;
              cache.cacheDataBlockPercent = 100;
            }
          }
          LOG.info("BlockCache evicted (MB): {}, overhead (%): {}, " +
            "ťažký evokačný čítač: {}, " +
            "aktuálne percento vytváraných DataBlock (%): {}",
            freedSumMb, freedDataOverheadPercent,
            heavyEvictionCount, cache.cacheDataBlockPercent);

          freedSumMb = 0;
          startTime = stopTime;
       }
Teraz si pozrime celý tento koncept na reálnom príklade. Máme nasledujúci testovací scenár:
- Začíname s vykonávaním Scan (25 vlákien, dávka = 100)
- Po 5 minútach pridávame multi-gets (25 vlákien, dávka = 100)
- Po 5 minútach vypíname multi-gets (opäť ostáva len scan)
Vykonáme dva bežiace testy, najprv hbase.lru.cache.heavy.eviction.count.limit = 10000 (čo v podstate vypína funkciu), a potom nastavíme limit = 0 (čo ju zapína).
V logoch nižšie vidíme, ako sa funkcia aktivuje, resetuje Overshooting na 14-71%. Občas sa záťaž znižuje, čo aktivuje Backpressure a HBase opäť ukladá viac blokov do cache.
Log RegionServer
evicted (MB): 0, ratio 0.0, overhead (%): -100, heavy eviction counter: 0, current caching DataBlock (%): 100
evicted (MB): 0, ratio 0.0, overhead (%): -100, heavy eviction counter: 0, current caching DataBlock (%): 100
evicted (MB): 2170, ratio 1.09, overhead (%): 985, heavy eviction counter: 1, current caching DataBlock (%): 91 < start
evicted (MB): 3763, ratio 1.08, overhead (%): 1781, heavy eviction counter: 2, current caching DataBlock (%): 76
evicted (MB): 3306, ratio 1.07, overhead (%): 1553, heavy eviction counter: 3, current caching DataBlock (%): 61
evicted (MB): 2508, ratio 1.06, overhead (%): 1154, heavy eviction counter: 4, current caching DataBlock (%): 50
evicted (MB): 1824, ratio 1.04, overhead (%): 812, heavy eviction counter: 5, current caching DataBlock (%): 42
evicted (MB): 1482, ratio 1.03, overhead (%): 641, heavy eviction counter: 6, current caching DataBlock (%): 36
evicted (MB): 1140, ratio 1.01, overhead (%): 470, heavy eviction counter: 7, current caching DataBlock (%): 32
evicted (MB): 913, ratio 1.0, overhead (%): 356, heavy eviction counter: 8, current caching DataBlock (%): 29
evicted (MB): 912, ratio 0.89, overhead (%): 356, heavy eviction counter: 9, current caching DataBlock (%): 26
evicted (MB): 684, ratio 0.76, overhead (%): 242, heavy eviction counter: 10, current caching DataBlock (%): 24
evicted (MB): 684, ratio 0.61, overhead (%): 242, heavy eviction counter: 11, current caching DataBlock (%): 22
evicted (MB): 456, ratio 0.51, overhead (%): 128, heavy eviction counter: 12, current caching DataBlock (%): 21
evicted (MB): 456, ratio 0.42, overhead (%): 128, heavy eviction counter: 13, current caching DataBlock (%): 20
evicted (MB): 456, ratio 0.33, overhead (%): 128, heavy eviction counter: 14, current caching DataBlock (%): 19
evicted (MB): 342, ratio 0.33, overhead (%): 71, heavy eviction counter: 15, current caching DataBlock (%): 19
evicted (MB): 342, ratio 0.32, overhead (%): 71, heavy eviction counter: 16, current caching DataBlock (%): 19
evicted (MB): 342, ratio 0.31, overhead (%): 71, heavy eviction counter: 17, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.3, overhead (%): 14, heavy eviction counter: 18, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.29, overhead (%): 14, heavy eviction counter: 19, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.27, overhead (%): 14, heavy eviction counter: 20, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.25, overhead (%): 14, heavy eviction counter: 21, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.24, overhead (%): 14, heavy eviction counter: 22, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.22, overhead (%): 14, heavy eviction counter: 23, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.21, overhead (%): 14, heavy eviction counter: 24, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.2, overhead (%): 14, heavy eviction counter: 25, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.17, overhead (%): 14, heavy eviction counter: 26, current caching DataBlock (%): 19
vyhodené (MB): 456, pomer 0.17, prebytok (%): 128, ťažký odpočítavací počet: 27, aktuálna cache DataBlock (%): 18 < pridané zisky (ale tabuľa rovnaká)
vyhodené (MB): 456, pomer 0.15, prebytok (%): 128, ťažký odpočítavací počet: 28, aktuálna cache DataBlock (%): 17
vyhodené (MB): 342, pomer 0.13, prebytok (%): 71, ťažký odpočítavací počet: 29, aktuálna cache DataBlock (%): 17
vyhodené (MB): 342, pomer 0.11, prebytok (%): 71, ťažký odpočítavací počet: 30, aktuálna cache DataBlock (%): 17
vyhodené (MB): 342, pomer 0.09, prebytok (%): 71, ťažký odpočítavací počet: 31, aktuálna cache DataBlock (%): 17
vyhodené (MB): 228, pomer 0.08, prebytok (%): 14, ťažký odpočítavací počet: 32, aktuálna cache DataBlock (%): 17
vyhodené (MB): 228, pomer 0.07, prebytok (%): 14, ťažký odpočítavací počet: 33, aktuálna cache DataBlock (%): 17
vyhodené (MB): 228, pomer 0.06, prebytok (%): 14, ťažký odpočítavací počet: 34, aktuálna cache DataBlock (%): 17
vyhodené (MB): 228, pomer 0.05, prebytok (%): 14, ťažký odpočítavací počet: 35, aktuálna cache DataBlock (%): 17
vyhodené (MB): 228, pomer 0.05, prebytok (%): 14, ťažký odpočítavací počet: 36, aktuálna cache DataBlock (%): 17
vyhodené (MB): 228, pomer 0.04, prebytok (%): 14, ťažký odpočítavací počet: 37, aktuálna cache DataBlock (%): 17
vyhodené (MB): 109, pomer 0.04, prebytok (%): -46, ťažký odpočítavací počet: 37, aktuálna cache DataBlock (%): 22 < spätný tlak
vyhodené (MB): 798, pomer 0.24, prebytok (%): 299, ťažký odpočítavací počet: 38, aktuálna cache DataBlock (%): 20
vyhodené (MB): 798, pomer 0.29, prebytok (%): 299, ťažký odpočítavací počet: 39, aktuálna cache DataBlock (%): 18
vyhodené (MB): 570, pomer 0.27, prebytok (%): 185, ťažký odpočítavací počet: 40, aktuálna cache DataBlock (%): 17
vyhodené (MB): 456, pomer 0.22, prebytok (%): 128, ťažký odpočítavací počet: 41, aktuálna cache DataBlock (%): 16
vyhodené (MB): 342, pomer 0.16, prebytok (%): 71, ťažký odpočítavací počet: 42, aktuálna cache DataBlock (%): 16
vyhodené (MB): 342, pomer 0.11, prebytok (%): 71, ťažký odpočítavací počet: 43, aktuálna cache DataBlock (%): 16
vyhodené (MB): 228, pomer 0.09, prebytok (%): 14, ťažký odpočítavací počet: 44, aktuálna cache DataBlock (%): 16
vyhodené (MB): 228, pomer 0.07, prebytok (%): 14, ťažký odpočítavací počet: 45, aktuálna cache DataBlock (%): 16
vyhodené (MB): 228, pomer 0.05, prebytok (%): 14, ťažký odpočítavací počet: 46, aktuálna cache DataBlock (%): 16
vyhodené (MB): 222, pomer 0.04, prebytok (%): 11, ťažký odpočítavací počet: 47, aktuálna cache DataBlock (%): 16
vyhodené (MB): 104, pomer 0.03, prebytok (%): -48, ťažký odpočítavací počet: 47, aktuálna cache DataBlock (%): 21 < prerušené zisky
vyhodené (MB): 684, pomer 0.2, prebytok (%): 242, ťažký odpočítavací počet: 48, aktuálna cache DataBlock (%): 19
vyhodené (MB): 570, pomer 0.23, prebytok (%): 185, ťažký odpočítavací počet: 49, aktuálna cache DataBlock (%): 18
vyhodené (MB): 342, pomer 0.22, prebytok (%): 71, ťažký odpočítavací počet: 50, aktuálna cache DataBlock (%): 18
vyhodené (MB): 228, pomer 0.21, prebytok (%): 14, ťažký odpočítavací počet: 51, aktuálna cache DataBlock (%): 18
vyhodené (MB): 228, pomer 0.2, prebytok (%): 14, ťažký odpočítavací počet: 52, aktuálna cache DataBlock (%): 18
vyhodené (MB): 228, pomer 0.18, prebytok (%): 14, ťažký odpočítavací počet: 53, aktuálna cache DataBlock (%): 18
vyhodené (MB): 228, pomer 0.16, prebytok (%): 14, ťažký odpočítavací počet: 54, aktuálna cache DataBlock (%): 18
vyhodené (MB): 228, pomer 0.14, prebytok (%): 14, ťažký odpočítavací počet: 55, aktuálna cache DataBlock (%): 18
vyhodené (MB): 112, pomer 0.14, prebytok (%): -44, ťažký odpočítavací počet: 55, aktuálna cache DataBlock (%): 23 < spätný tlak
vyhodené (MB): 456, pomer 0.26, prebytok (%): 128, ťažký odpočítavací počet: 56, aktuálna cache DataBlock (%): 22
vyhodené (MB): 342, pomer 0.31, prebytok (%): 71, ťažký odpočítavací počet: 57, aktuálna cache DataBlock (%): 22
vysídlené (MB): 342, pomer 0.33, režijné náklady (%): 71, ťažký vysídľovací čítač: 58, aktuálne caching DataBlock (%): 22
vysídlené (MB): 342, pomer 0.33, režijné náklady (%): 71, ťažký vysídľovací čítač: 59, aktuálne caching DataBlock (%): 22
vysídlené (MB): 342, pomer 0.33, režijné náklady (%): 71, ťažký vysídľovací čítač: 60, aktuálne caching DataBlock (%): 22
vysídlené (MB): 342, pomer 0.33, režijné náklady (%): 71, ťažký vysídľovací čítač: 61, aktuálne caching DataBlock (%): 22
vysídlené (MB): 342, pomer 0.33, režijné náklady (%): 71, ťažký vysídľovací čítač: 62, aktuálne caching DataBlock (%): 22
vysídlené (MB): 342, pomer 0.33, režijné náklady (%): 71, ťažký vysídľovací čítač: 63, aktuálne caching DataBlock (%): 22
vysídlené (MB): 342, pomer 0.32, režijné náklady (%): 71, ťažký vysídľovací čítač: 64, aktuálne caching DataBlock (%): 22
vysídlené (MB): 342, pomer 0.33, režijné náklady (%): 71, ťažký vysídľovací čítač: 65, aktuálne caching DataBlock (%): 22
vysídlené (MB): 342, pomer 0.33, režijné náklady (%): 71, ťažký vysídľovací čítač: 66, aktuálne caching DataBlock (%): 22
vysídlené (MB): 342, pomer 0.32, režijné náklady (%): 71, ťažký vysídľovací čítač: 67, aktuálne caching DataBlock (%): 22
vysídlené (MB): 342, pomer 0.33, režijné náklady (%): 71, ťažký vysídľovací čítač: 68, aktuálne caching DataBlock (%): 22
vysídlené (MB): 342, pomer 0.32, režijné náklady (%): 71, ťažký vysídľovací čítač: 69, aktuálne caching DataBlock (%): 22
vysídlené (MB): 342, pomer 0.32, režijné náklady (%): 71, ťažký vysídľovací čítač: 70, aktuálne caching DataBlock (%): 22
vysídlené (MB): 342, pomer 0.33, režijné náklady (%): 71, ťažký vysídľovací čítač: 71, aktuálne caching DataBlock (%): 22
vysídlené (MB): 342, pomer 0.33, režijné náklady (%): 71, ťažký vysídľovací čítač: 72, aktuálne caching DataBlock (%): 22
vysídlené (MB): 342, pomer 0.33, režijné náklady (%): 71, ťažký vysídľovací čítač: 73, aktuálne caching DataBlock (%): 22
vysídlené (MB): 342, pomer 0.33, režijné náklady (%): 71, ťažký vysídľovací čítač: 74, aktuálne caching DataBlock (%): 22
vysídlené (MB): 342, pomer 0.33, režijné náklady (%): 71, ťažký vysídľovací čítač: 75, aktuálne caching DataBlock (%): 22
vysídlené (MB): 342, pomer 0.33, režijné náklady (%): 71, ťažký vysídľovací čítač: 76, aktuálne caching DataBlock (%): 22
vysídlené (MB): 21, pomer 0.33, režijné náklady (%): -90, ťažký vysídľovací čítač: 76, aktuálne caching DataBlock (%): 32
evicted (MB): 0, ratio 0.0, overhead (%): -100, heavy eviction counter: 0, current caching DataBlock (%): 100
evicted (MB): 0, ratio 0.0, overhead (%): -100, heavy eviction counter: 0, current caching DataBlock (%): 100
Skeny boli potrebné na to, aby tento proces ukázali vo forme grafu pomeru medzi dvoma časťami cache — single (kde sa dostanú bloky, ktoré nikto doteraz nevyžadoval) a multi (tu sú uložené "požadované" dáta aspoň raz):
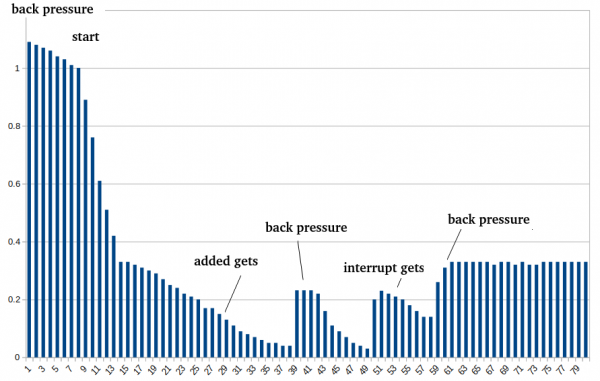
A nakoniec, ako vyzerá prevádzka parametrov vo forme grafu. Na porovnanie bola cache na začiatku úplne vypnutá, potom bol spustený HBase s cachingom a oneskorením začiatku optimalizácie o 5 minút (30 cyklov vysídľovania).
Úplný kód nájdete v Pull Request na github.
Avšak 300 tisíc čítaní za sekundu nie je všetko, čo sa dá na tomto hardvéri v týchto podmienkach vyťažiť. Ide o to, že ak je potrebné pristupovať k údajom cez HDFS, použije sa mechanizmus ShortCircuitCache (ďalej SSC), ktorý umožňuje prístup k údajom priamo, čím sa vyhýba sieťovej interakcii.
Profilovanie ukázalo, že tento mechanizmus, hoci poskytuje veľký prínos, sa tiež v určitých momentoch stáva úzkym hrdlom, pretože takmer všetky ťažké operácie prebiehajú v rámci zamknutia, čo vedie k blokádam väčšinu času.
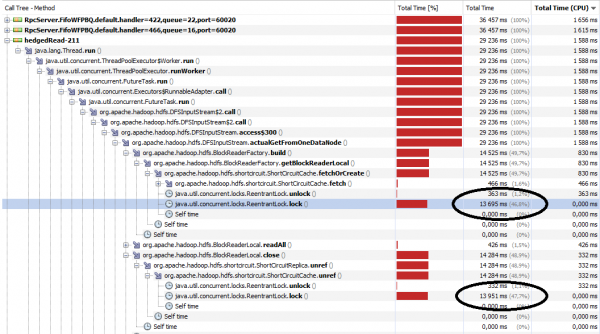
Uvedomili sme si, že problém je možné obísť, ak vytvoríme pole nezávislých SSC:
private final ShortCircuitCache[] shortCircuitCache;
...
shortCircuitCache = new ShortCircuitCache[this.clientShortCircuitNum];
for (int i = 0; i < this.clientShortCircuitNum; i++)
  this.shortCircuitCache[i] = new ShortCircuitCache(…);
A následne s nimi pracovať, pričom vylúčime prekrytia aj podľa poslednej cifry offsetu:
public ShortCircuitCache getShortCircuitCache(long idx) {
    return shortCircuitCache[(int) (idx % clientShortCircuitNum)];
}
Teraz môžeme prejsť na testy. Na to budeme čítať súbory z HDFS pomocou jednoduchého viacvláknového aplikácie. Nastavíme parametre:
conf.set("dfs.client.read.shortcircuit", "true");
conf.set("dfs.client.read.shortcircuit.buffer.size", "65536"); // predvolene = 1 MB a to výrazne spomaľuje čítanie, preto je lepšie prispôsobiť ho reálnym potrebám
conf.set("dfs.client.short.circuit.num", num); // od 1 do 10
A jednoducho čítame súbory:
FSDataInputStream in = fileSystem.open(path);
for (int i = 0; i  900000000)
        position = 0L;
    int res = in.read(position, byteBuffer, 0, 65536);
}
Tento kód sa vykonáva v samostatných vláknach a budeme zvyšovať počet súčasne čítaných súborov (od 10 do 200 — horizontálna os) a počet cache (od 1 do 10 — grafy). Vertikálna os ukazuje urýchlenie, ktoré poskytuje zvýšenie SSC v porovnaní so situáciou, keď je cache len jedna.
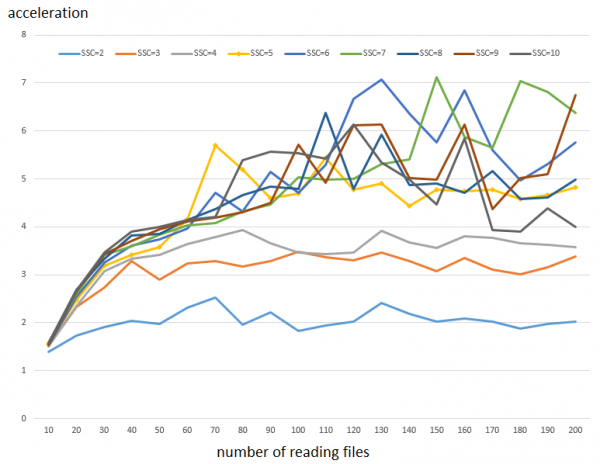
Ako čítať graf: čas vykonania 100 tisíc čítaní blokmi po 64 kB s jedným cache vyžaduje 78 sekúnd. Kým pri 5 cache sa to vykonáva za 16 sekúnd. To znamená, že dochádza k urýchleniu asi 5-násobne. Ako je vidno z grafu, pri malom počte paralelných čítaní efekt nie je veľmi znateľný, začne hrať podstatnú úlohu, keď je čítaní viac než 50. Taktiež je vidieť, že zvyšovanie počtu SSC nad 6 a vyššie poskytuje podstatne menší nárast výkonu.
Poznámka 1: pretože výsledky testovania sú dosť volatilné (pozri nižšie), uskutočnili sa 3 spustenia a získané hodnoty boli priemerné.
Poznámka 2: Nárast výkonu z nastavenia pre náhodný prístup je rovnaký, aj keď samotný prístup je o niečo pomalší.
Je však potrebné objasniť, že na rozdiel od prípadu s HBase toto zrýchlenie nie je vždy bezplatné. Tu viac „odblokovávame“ schopnosti CPU vykonávať prácu, namiesto toho, aby sa zasekával na lokoch.
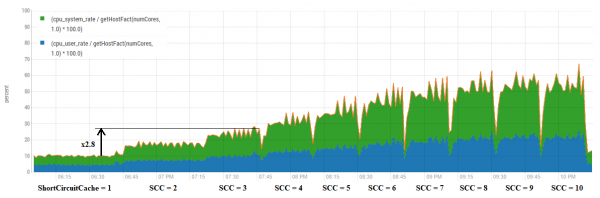
Tu je vidieť, že celkovo zvýšenie počtu cache poskytuje približne proporcionálny rast využitia CPU. Existuje však niekoľko výhodnejších kombinácií.
Napríklad sa pozrime bližšie na nastavenie SSC = 3. Rast výkonu v rozsahu je približne 3,3 krát. Nižšie sú výsledky všetkých troch samostatných spustení.
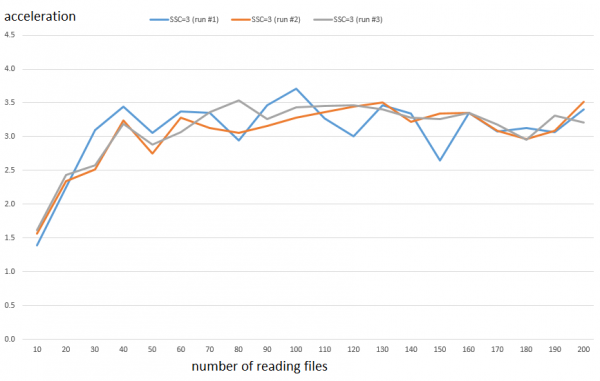
Zatiaľ čo spotreba CPU rastie približne 2,8 krát. Rozdiel nie je veľmi veľký, ale malej Grete to už prinesie radosť a možno si nájde čas na návštevu školy a hodín.
Takto bude mať pozitívny efekt pre akýkoľvek nástroj, ktorý používa hromadný prístup k HDFS (napríklad Spark atď.), za predpokladu, že aplikačný kód je ľahký (t.j. zadržiavanie je presne na strane klienta HDFS) a existujú voľné kapacity CPU. Pre overenie vyskúšajme, aký efekt prinesie súčasné použitie optimalizácie BlockCache a ladenia SSC pri čítaní z HBase.
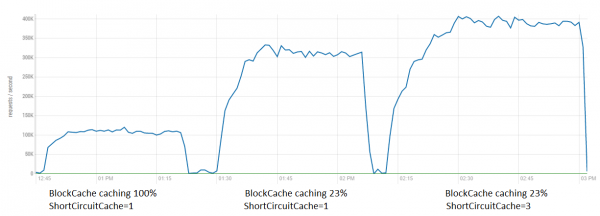
Je vidieť, že v takých podmienkach efekt nie je taký veľký, ako v rafinovaných testoch (čítanie bez akejkoľvek úpravy), avšak vytiahnuť ďalších 80K je tu celkom reálne. Spolu obidve optimalizácie prinášajú zrýchlenie až 4-krát.
Takisto bol k tejto optimalizácii vytvorený PR , ktorý bol zlúčený a táto funkčnosť bude dostupná v nasledujúcich vydaniach.
A nakoniec bolo zaujímavé porovnať výkon čítania podobnej wide-column databázy Cassandra a HBase.
Na tento účel boli spustené inštancie štandardného nástroja na zaťažovanie YCSB z dvoch hostiteľov (celkovo 800 vlákien). Na serverovej strane — po 4 inštancie RegionServer a Cassandra na 4 hostiteľoch (nie na tých, kde sú spustené klienti, aby sa predišlo ich vplyvu). Čítania prebiehali z tabuliek veľkosti:
HBase — 300 GB na HDFS (100 GB čistých dát)
Cassandra — 250 GB (faktor replikácie = 3)
T.j. objem bol približne rovnaký (v HBase o niečo väčší).
Parametre HBase:
dfs.client.short.circuit.num = 5 (optimalizácia klienta HDFS)
hbase.lru.cache.heavy.eviction.count.limit = 30 — to znamená, že oprava začne fungovať po 30 evikciách (~5 minút)
hbase.lru.cache.heavy.eviction.mb.size.limit = 300 — cieľový objem cache a evikcií.
Logy YCSB boli spracované a zhrnuté do grafov Excel:
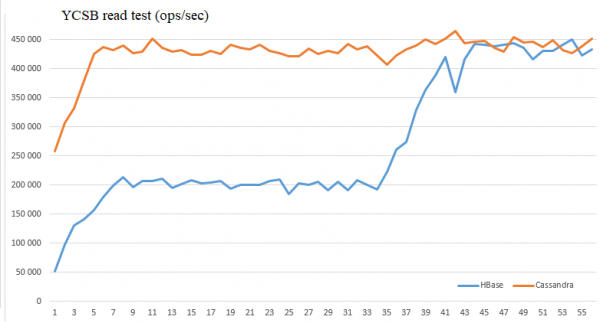
Ako vidno, optimalizácie umožňujú vyrovnať výkon týchto DB v týchto podmienkach a dosiahnuť 450 tisíc čítaní za sekundu.
Dúfame, že táto informácia môže byť niekomu užitočná v priebehu vzrušujúceho boja o výkon.
Zdroj: habr.com
