

Správa je venovaná praktickým otázkam vývoja operátora v Kubernetes, návrhu jeho architektúry a základným princípom fungovania.
V prvej časti správy sa pozrieme na:
- čo je operátor v Kubernetes a na čo je potrebný;
- ako operátor uľahčuje správu zložitých systémov;
- čo operátor môže a čo nemôže.
Ďalej sa posunieme k diskusii o vnútornom usporiadaní operátora. Preskúmame architektúru a fungovanie operátora krok za krokom. Podrobne sa zaoberáme:
- interakciou medzi operátorom a Kubernetes;
- aké funkcie si operátor preberá, a čo deleguje v Kubernetes.
Preskúmame správu shardov a replik DB v Kubernetes.
Ďalej sa budeme zaoberať otázkami ukladania dát:
- ako pracovať s Persistent Storage z pohľadu operátora;
- úskalia použití Local Storage.
V záverečnej časti správy si predstavíme praktické príklady aplikácie s Amazonom alebo Google Cloud Service. Správa je postavená na príklade vývoja a skúsenostiach s prevádzkou operátora pre ClickHouse.
Video:
Volám sa Vladislav Klimenko. Dnes by som chcel hovoriť o našich skúsenostiach s vývojom a prevádzkou operátora, pričom ide o špecializovaného operátora na správu klastrov databáz. Na príklade na správu klustra ClickHouse.
Prečo máme možnosť hovoriť o operátorovi a ClickHouse?
- Zaoberáme sa podporou a rozvojom ClickHouse.
- V súčasnosti sa snažíme postupne prispieť svojím dielom k vývoju ClickHouse. A sme druhí po Yandexe z hľadiska objemu vykonaných zmien v ClickHouse.
- Snažíme sa robiť ďalšie projekty pre ekosystém ClickHouse.
O jednom z takýchto projektov by som chcel hovoriť. Ide o ClickHouse-operator pre Kubernetes.
Vo svojej správe by som chcel načrtnúť dve témy:
- Prvá téma – ako funguje náš operátor na správu databáz ClickHouse v Kubernetes.
- Druhá téma – ako funguje akýkoľvek operátor, t. j. ako interaguje s Kubernetes.
Tieto dve otázky sa budú počas celej mojej správy prekrývať.
Komu by mohlo byť zaujímavé počuť to, čo sa snažím povedať?
- Niekoľko zaujíma zrejme tých, ktorí prevádzkujú operátory.
- Alebo tých, ktorí chcú vytvoriť svoj, aby rozumeli, ako to funguje zvnútra, ako interaguje operátor s Kubernetes a aké úskalia sa môžu objaviť.
Aby sme lepšie porozumeli tomu, o čom budeme dnes diskutovať, bolo by dobré vedieť, ako Kubernetes funguje a mať základné znalosti o cloudových technológiách.
Čo je ClickHouse? Je to stĺpcová databáza zameraná na online spracovanie analytických dotazov. A je to úplne open source.
Dôležité je vedieť len dve veci. Musíme si uvedomiť, že ide o databázu, takže to, čo budem rozprávať, sa bude dať aplikovať takmer na každú databázu. A že Systém riadenia databáz ClickHouse sa veľmi dobre škáluje, poskytuje v podstate lineárnu škálovateľnosť. Preto je stav klastrov pre ClickHouse prirodzený. Najviac nás zaujíma diskusia o tom, ako spravovať klaster ClickHouse v Kubernetes.
Prečo je potrebné ho tam mať? Prečo nemôžeme naďalej prevádzkovať samo? Odpovede sú čiastočne technické, čiastočne organizačné.
- V praxi sa čoraz častejšie stretávame so situáciou, kedy vo veľkých firmách sú už prakticky všetky komponenty v Kubernetes. Databázy zostávajú mimo.
- A čoraz častejšie sa pýtajú: „Môže sa to dostatočne integrovať?“. Veľké firmy sa snažia dosiahnuť maximálnu unifikáciu správy, aby mohli rýchlo spravovať svoje úložiská dát.
- To najmä pomáha, ak potrebujeme maximálnu schopnosť zopakovať to isté na novom mieste, teda maximálnu prenosnosť.
Ako jednoduché alebo zložité je to? Samozrejme, dá sa to robiť manuálne. Ale nie je to až tak jednoduché, pretože sa stretávame so zložitým riadením samotného Kubernetes, pričom sa pridáva aj špecifickosť ClickHouse. A dostaneme agregáciu.
A to všetko spolu poskytuje dosť veľký súbor technológií, ktorými je už dosť ťažké spravovať, pretože Kubernetes prináša svoje každodenné otázky prevádzky, zatiaľ čo ClickHouse prináša svoje otázky dennej prevádzky. Najmä ak máme viacero ClickHouse, a musíme s nimi neustále niečo robiť.
ClickHouse s dynamickou konfiguráciou má dosť veľa otázok, ktoré vytvárajú neustálu záťaž na DevOps:
- Keď chceme niečo zmeniť v ClickHouse, napríklad pridať replikáciu alebo shard, musíme spravovať konfiguráciu.
- Následne je potrebné zmeniť schému údajov, pretože ClickHouse má špecifický spôsob shardovania. Je potrebné rozdeliť schému údajov a usporiadať konfigurácie.
- Je potrebné nastaviť monitorovanie.
- Zber logov pre nové shardy a nové repliky.
- Postarať sa o obnovu.
- A reštart.
Sú to rutinné úlohy, ktoré by sme chceli uľahčiť v prevádzke.
Sám Kubernetes naozaj pomáha v prevádzke, ale pri základných systémových veciach.
Kubernetes dobre uľahčuje a automatizuje také veci ako:
- Obnovu.
- Reštart.
- Správu úložného systému.
To je dobré, to je správny smer, ale úplne nerozumie tomu, ako prevádzkovať databázový klaster.
Chceme viac, chceme, aby celá databáza fungovala v Kubernetes.
Chceli by sme získať niečo ako veľké magické červené tlačidlo, na ktoré stlačíte a rozvinie sa a udržuje sa počas celého životného cyklu klaster s každodennými úlohami, ktoré je potrebné riešiť. Klaster ClickHouse v Kubernetes.
Snažili sme sa vytvoriť také riešenie, ktoré by uľahčilo prácu. Je to ClickHouse-operator pre Kubernetes od spoločnosti Altinity.
Operátor je program, ktorého hlavnou úlohou je spravovať iné programy, teda je to manažér.
Obsahuje šablóny správania. Môžeme to nazvať kodifikované znalosti o predmetovej oblasti.
A jeho hlavná úloha je uľahčiť život DevOps a znížiť mikromanažment, aby on (DevOps) myslel vo vysokých pojmoch, teda aby sa (DevOps) nezaoberal mikromanažmentom, aby nemusel ručne nastavovať všetky detaily.
A práve operátor je robotický asistent, ktorý bojuje s mikrozadaniami a pomáha DevOps.
Načo je potrebný operátor? Osobitne dobre sa ukazuje v dvoch otázkach:
- Keď má špecialista, ktorý sa zaoberá ClickHouse, nedostatok skúseností, ale prevádzku ClickHouse je už potrebné uskutočniť, operátor uľahčuje prevádzku a umožňuje prevádzkovať klaster ClickHouse s dosť zložitou konfiguráciou, pričom nie je potrebné veľmi sa zaoberať detailami o tom, ako to všetko funguje. Stačí mu dať úlohy na vysokej úrovni a to funguje.
- A druhá úloha, v ktorej sa najlepšie prejavuje, je, keď je potrebné automatizovať veľké množstvo typických úloh. Odstráni mikrozáťaž pre systémových administrátorov.
Toto je najviac potrebné buď pre tých, ktorí práve začínajú svoju cestu, alebo pre tých, ktorí sa musia venovať rozsiahlej automatizácii.
V čom sa teda prístup založený na operátoroch líši od iných systémov? Predsa len je tu Helm. Ten tiež pomáha nainštalovať ClickHouse, môžeme nakresliť helm chart, ktoré dokonca nainštalujú celý klaster ClickHouse. Aký je potom rozdiel medzi operátorom a napríklad Helm?
Hlavný fundamentálny rozdiel spočíva v tom, že Helm je správa balíčkov, zatiaľ čo operátor ide ďalej. Zabezpečuje celý životný cyklus. Nielen inštaláciu, ale aj každodenné úlohy, ktoré zahŕňajú škálovanie, shardovanie, t. j. všetko, čo je potrebné vykonávať v priebehu životného cyklu (ak je potrebné, tak aj vymazávanie) – to všetko rieši operátor. Snaží sa automatizovať a spravovať celý životný cyklus softvéru. V tom spočíva jeho fundamentálny rozdiel od ostatných dostupných riešení.
Toto bola úvodná časť, poďme ďalej.
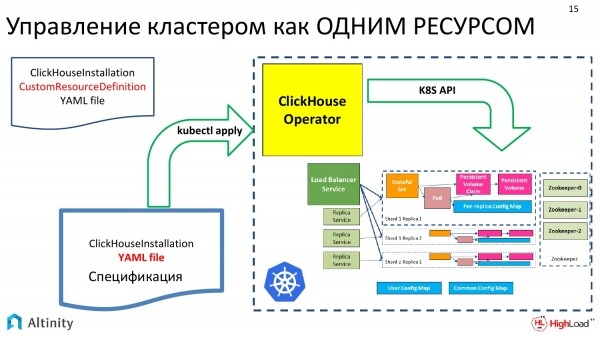
Ako budujeme svoj operátor? Snažíme sa pristupovať k otázke, aby sme spravovali klaster ClickHouse ako jeden zdroj.
Na ľavej strane obrázku máme vstupné dáta. Je to YAML so špecifikáciou klastru, ktorý je klasicky prenášaný cez kubectl do Kubernetes. Tam operátor zachytí dáta, vykoná svoju mágiu. A na výstupe dostaneme takúto schému. Toto je implementácia ClickHouse v Kubernetes.
A ďalej budeme pomaly pozerať, ako presne operátor funguje, aké typické úlohy sa dajú riešiť. Pozrieme sa iba na typické úlohy, pretože máme obmedzený čas. A nebude sa rozprávať o všetkom, čo operátor dokáže vyriešiť.
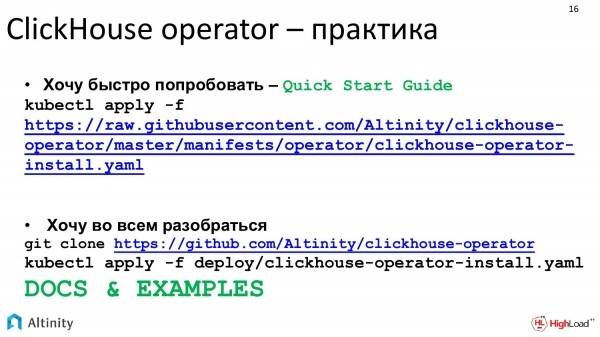
Poďme vychádzať z praxe. Náš projekt je úplne open source, takže si môžete pozrieť na GitHub, ako funguje. A je možné vychádzať z úvah, ak chcete jednoducho spustiť, tak s Quick Start Guide môžete začínať.
Ak sa chcete podrobnejšie zaoberať, snažíme sa udržiavať dokumentáciu v relatívne slušnom stave.
Poďme začať s praktickou úlohou. Prvá úloha, ktorú všetci chceme začať, je spustiť prvý príklad nejakým spôsobom. Ako spustiť ClickHouse pomocou operátora, aj keď veľmi nevieme, ako funguje? Píšeme manifest, pretože všetka komunikácia s k8s je cez manifesty.
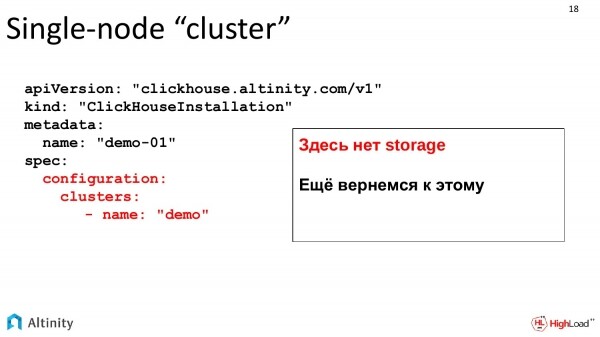
Tu je taký zložitý manifest. To, čo máme zvýraznené červenou, je to, na čom si treba dať pozor. Prosíme operátora, aby vytvoril klaster s názvom demo.
Toto sú zatiaľ základné príklady. Storage ešte nie je popísaný, ale k storage sa vrátime o chvíľu. Zatiaľ budeme pozorovať vývoj klastru v dynamike.
Vytvorili sme tento manifest. Podávame ho nášmu operátorovi. On na tom pracoval, spravil mágiu.
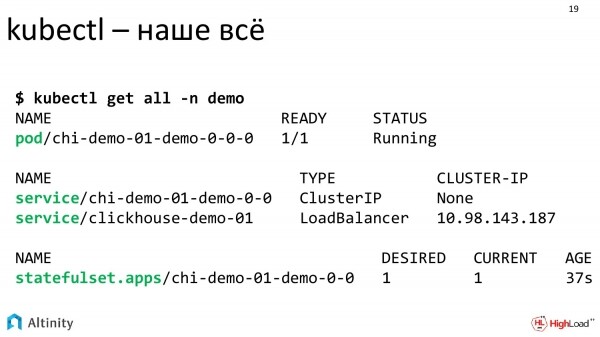
Pozrieme sa do konzoly. Zaujímavé sú tri komponenty – Pod, dva služby a StatefulSet.
Operátor vykonal svoju prácu a môžeme si pozrieť, čo konkrétne vytvoril.
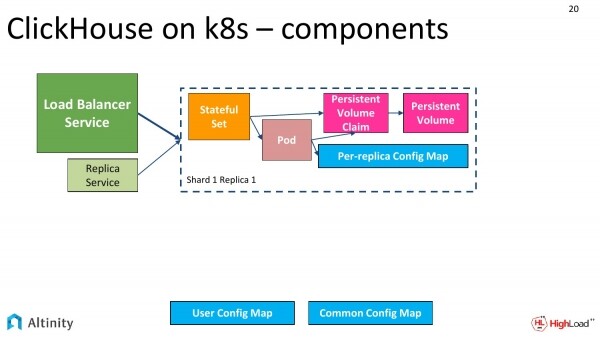
Vytvára približne takúto schému. Máme StatefulSet, Pod, ConfigMap pre každú replikáciu, ConfigMap pre celý klaster. Určite aj služby ako vstupné body do klastru.
Služby sú centrálny Load Balancer Service a môžeme mať aj pre každú replikáciu, pre každý shard.
Takto vyzerá náš základný klaster. Je z jednej jedinej nody.
Ideme ďalej, budeme to zložitovať. Musíme shardovať klaster.
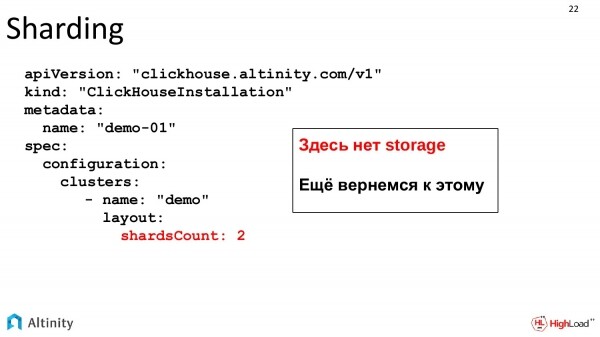
Naše úlohy rastú, začína dynamika. Chceme pridať shard. Sledujeme vývoj. Meníme našu špecifikáciu. Uvádzame, že chceme dva shardy.
Toto je ten istý súbor, ktorý sa dynamicky vyvíja s rastom systému. Storage nie je, storage bude ďalej rozobratý, to je samostatná téma.
Podávame YAML operátorovi a sledujeme, čo sa deje.
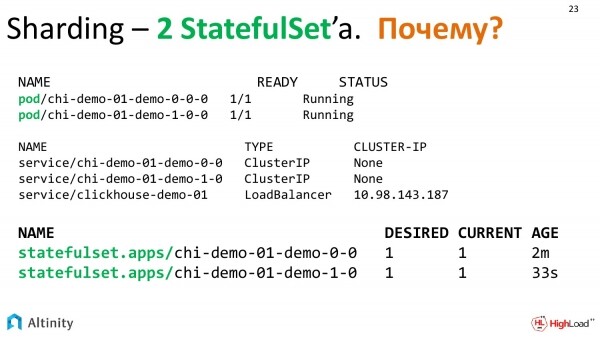
Operátor sa zamyslel a vytvoril nasledujúce entity. Už máme dva Pod, tri služby a, nečakane, 2 StatefulSety. Prečo 2 StatefulSety?
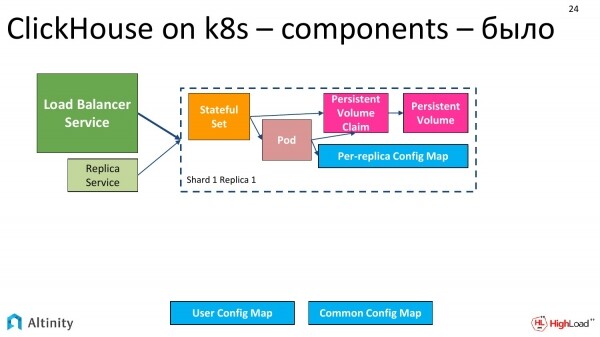
Na schéme to vyzeralo takto – to je naše počiatočné štádium, keď bol iba jeden pod.
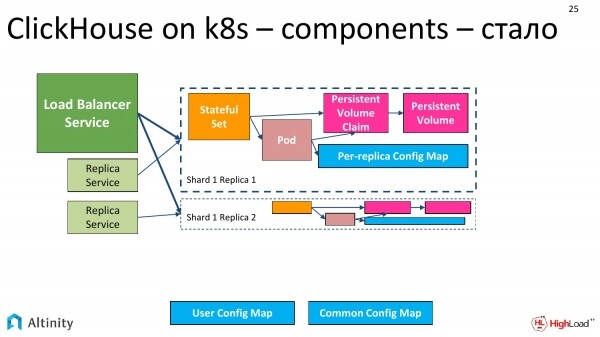
Stalo sa to takto. Zatiaľ je všetko jednoduché, duplicovalo sa to.
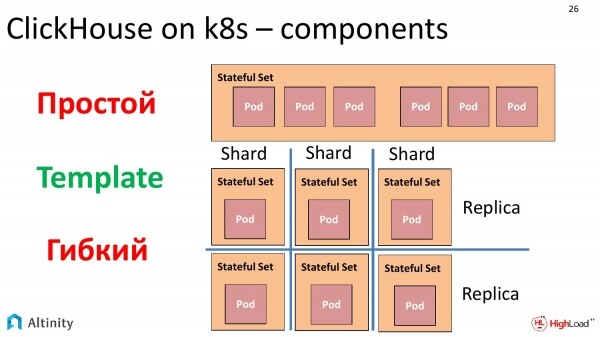
A prečo sa StatefulSet stal dvomi? Tu je potrebné odvrátiť sa a prediskutovať otázku, ako sa v Kubernetes spravujú Pod-y.
Existuje taký objekt pod názvom StatefulSet, ktorý umožňuje vytvoriť súbor Pod-ov z šablóny. Kľúčový faktor je Template. A v jednom StatefulSet je možné spustiť veľa Pod-ov z jedného šablónu. Kľúčovou frázou je tu 'z jedného šablónu veľa Pod-ov'.
A veľkým pokušením bolo celý klaster zrealizovať zabalený do jedného StatefulSet. To bude fungovať, v tom nie sú žiadne problémy. Ale je tu jeden detail. Ak chceme zostaviť heterogénny klaster, t. j. z niekoľkých verzií ClickHouse, začínajú sa objavovať otázky. Áno, StatefulSet môže vykonať rolling update, áno, môžete aplikovať novú verziu, vysvetliť, že je potrebné vyskúšať maximálne toľko uzlov naraz.
Ale ak extrapolujeme úlohu a povieme, že chceme vytvoriť úplne heterogénny klaster a nechceme prejsť zo starej verzie na novú prostredníctvom rolling update, ale jednoducho chceme vytvoriť heterogénny klaster, čo sa týka rôznych verzií ClickHouse, ako aj rôznych storage. Chceme, napríklad, niektoré repliky umiestniť na samostatné disky, na pomalé disky, celkovo chceme úplne postaviť heterogénny klaster. A kvôli tomu, že StatefulSet vytvára z jedného šablónového štandardizovaného riešenia, nie je možné to dosiahnuť.
Po určitom zvažovaní sme sa rozhodli, že to urobíme takto. Každá replika je vo svojom StatefulSet. Toto riešenie má niektoré nedostatky, ale v praxi všetko plne inkapsuluje operátor. A má to množstvo výhod. Môžeme postaviť presne taký klaster, aký chceme, napríklad úplne heterogénny. Preto v klastri, kde máme dva shard-y s jednou replikou, budeme mať 2 StatefulSet-y a 2 Pod-y práve preto, že sme si zvolili tento prístup kvôli predchádzajúcim dôvodom na možnosť postaviť heterogénny klaster.
Vráťme sa k praktickým úlohám. V našom klastri je potrebné nastaviť používateľov, t. j. je potrebné vykonávať nejaké konfigurovanie ClickHouse v Kubernetes. Operátor poskytuje všetky možnosti na to.
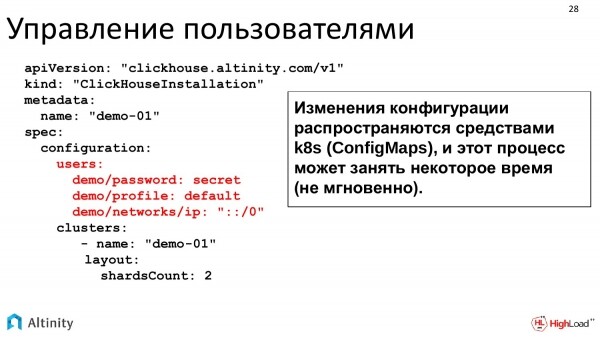
Môžete priamo v YAML napísať to, čo chceme. Všetky konfiguračné možnosti sa priamo mapujú z tohto YAML do konfigurácií ClickHouse, ktoré sa potom rozloží po celom klastri.
Môžete to napísať aj takto. Toto je iba príklad. Heslo môže byť zašifrované. Podporujú sa úplne všetky konfiguračné možnosti ClickHouse. Tu je iba príklad.
Konfigurácia v klastri sa rozširuje ako ConfigMap. V praxi sa aktualizácia ConfigMap neuskutočňuje okamžite, preto ak je klaster veľký, proces posúvania konfigurácie trvá nejaký čas. Ale všetko to je veľmi pohodlné na prevádzku.
Zložíme úlohu. Klaster sa rozvíja. Chceme replikovať dáta. To znamená, že už máme dva shard-y, po jednej replikácii, nastavení používateľov. Rasteme a chceme sa zaoberať replikáciou.
Čo potrebujeme na replikáciu?
Potrebujeme ZooKeeper. V ClickHouse je replikácia postavená s použitím ZooKeeper. ZooKeeper je potrebný na to, aby rôzne repliky ClickHouse mali konsenzus o tom, aké bloky dát sú na ktorom ClickHouse.
Môžeme použiť akýkoľvek ZooKeeper. Ak má podnik externý ZooKeeper, môže sa použiť. Ak nie, môžeme si ho nainštalovať z nášho repozitára. Existuje inštalátor, ktorý to všetko zjednodušuje.
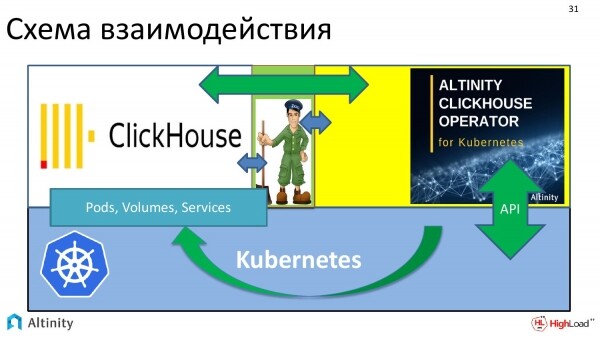
A schéma interakcie celého systému je takáto. Máme Kubernetes ako platformu. Na ňom beží operátor ClickHouse. ZooKeeper som znázornil tu. A operátor interaguje s ClickHouse aj so ZooKeeper. Teda dochádza k interakcii.
A všetko toto je potrebné na to, aby ClickHouse úspešne replikoval dáta v k8s.
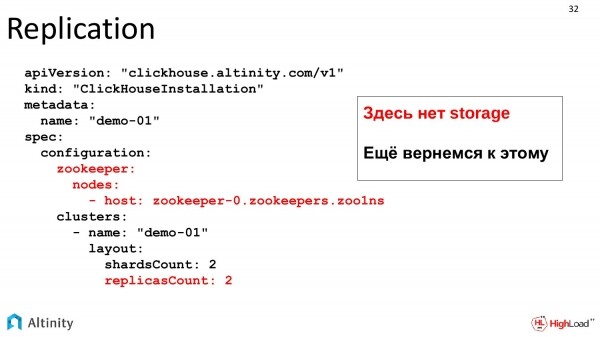
Poďme sa teraz pozrieť na samotnú úlohu, na to, ako bude vyzerať manifest pre replikáciu.
K nášmu manifestu pridávame dve sekcie. Prvá – to, kde získavať ZooKeeper, ktorý môže byť buď vnútri Kubernetes, alebo externý. Je to jednoduchý popis. A objednávame repliky. T. j. chceme dve repliky. Nakoniec by malo byť na výstupe 4 pod-y. O úložisku vieme, vráti sa to neskôr. Úložisko – to je samostatná pieseň.
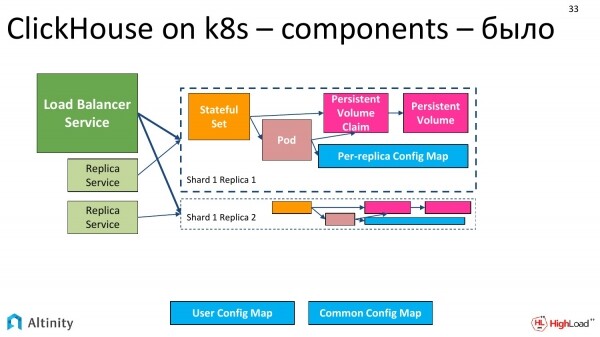
Bolo to takto.
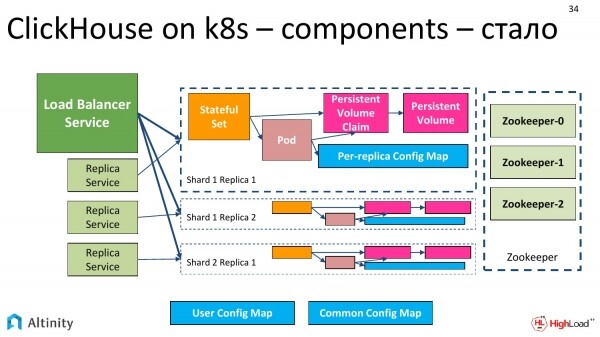
Stáva sa to takto. Pridávajú sa repliky. 4. sa nezmestilo, veríme, že ich môže byť veľa. A po boku sa pridáva ZooKeeper. Schémy sa zložujú.
A nastal čas pridať ďalšiu úlohu. Budeme pridávať trvalé úložisko.
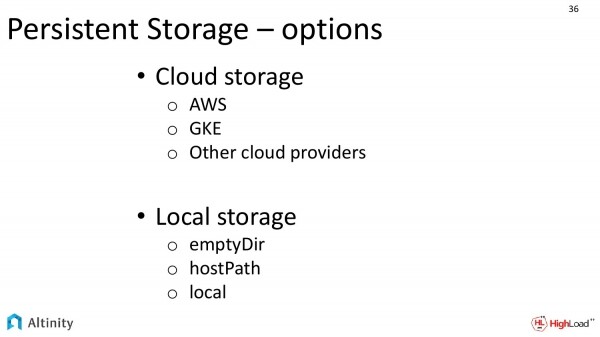 K trvalému úložisku máme rôzne možnosti realizácie.
V prípade, že sa realizujeme v cloudovom poskytovateľovi, ako je Amazon alebo Google, je veľké pokušenie využiť cloudové úložisko. Je to veľmi pohodlné, je to dobré.
A je tu druhá možnosť. To je pre lokálne úložisko, keď máme lokálne disky na každej nódě. Táto možnosť je oveľa zložitejšia na realizáciu, ale je výkonnejšia.
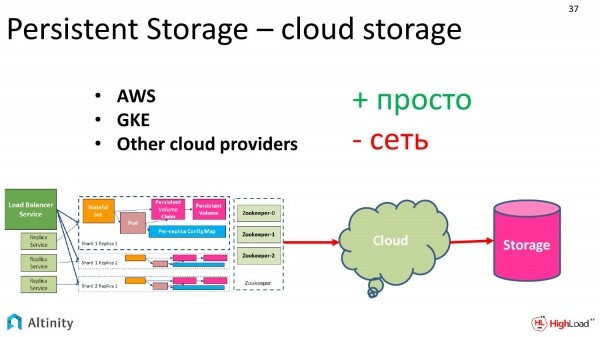
Poďme sa pozrieť, čo máme ohľadom cloudového úložiska.
Existujú výhody. Je to veľmi jednoduché na konfiguráciu. Jednoducho objednávame od cloudového poskytovateľa, aby nám poskytol úložisko takej kapacity, takého typu. Typy sú definované poskytovateľmi samostatne.
Existuje však nevýhoda. Pre niekoho je to problematické, iného by to nemalo veľmi trápiť. Samozrejme, určité výkonnostné úskalia sa tam vyskytnú. Je to veľmi pohodlné na prácu a spoľahlivé, ale môžu sa objaviť potenciálne poklesy výkonnosti.
A keďže sa ClickHouse zameriava práve na výkonnosť, dá sa povedať, že využíva všetko, čo je možné, a preto sa mnohí klienti snažia dosiahnuť maximálnu výkonnosť.
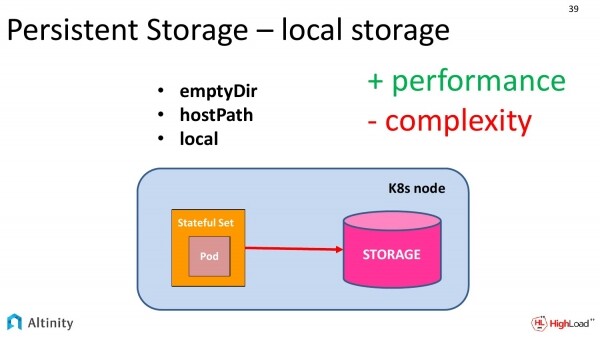
A aby sme dosiahli maximum, potrebujeme lokálne úložisko.
Kubernetes poskytuje tri abstrakcie pre využitie lokálneho úložiska v Kubernetes. Tieto sú:
- EmptyDir
- HostPath.
- Local
Pozrime sa na to, čím sa líšia a čím sú si podobné.
Po prvé, vo všetkých troch prístupoch máme úložisko – sú to lokálne disky, ktoré sa nachádzajú na tej istej fyzickej uzle k8s. Ale medzi nimi existujú určité rozdiely.
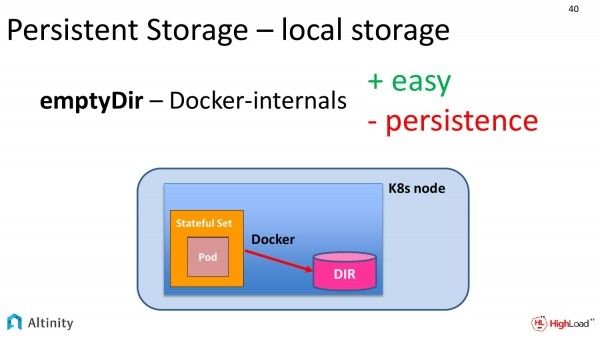
Začneme s najjednoduchším, teda s emptyDir. Čo to vlastne znamená v praxi? Požiadame našu špecifikáciu, aby nám systém kontajnerizácie (často je to Docker) poskytol prístup k priečinku na lokálnom disku.
V praxi Docker niekde vo svojich vlastných cestách vytvára dočasný priečinok, nazýva ho dlhým hashom a poskytuje rozhranie pre prístup k nemu.
Ako to bude fungovať z hľadiska výkonnosti? Fungovať to bude rýchlosťou lokálneho disku, teda máte úplný prístup k svojmu disku.
Ale táto metóda má svoju nevýhodu. Persistentné úložisko v tomto prípade je dosť problematické. Pri prvom pohybe Dockera s kontajnermi sa persistentné údaje stratia. Ak by Kubernetes chcel z nejakého dôvodu premiestniť tento Pod na iný disk, údaje sa stratí.
Tento prístup je dobrý pre testovanie, pretože rýchlosť už ukazuje slušné hodnoty, ale na niečo vážnejšie tento variant nevyhovuje.
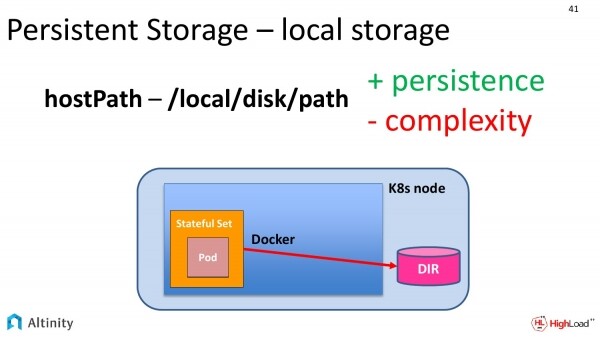
Preto existuje druhý prístup. Tým je hostPath. Ak sa pozrieme na predchádzajúci snímok a tento, uvidíme jediné rozlíšenie. Náš priečinok sa presunul z Dockera priamo na uzol Kubernetes. Tu je to jednoduchšie. Priamo zadávame cestu v lokálnom súborovom systéme, kde chceme uložiť svoje dáta.
Tento spôsob má svoje výhody. Je to už skutočné persistentné úložisko, a to klasické. Údaje budú na disku uložené na určitej adrese.
Existujú aj nevýhody. Je to zložitost správy. Náš Kubernetes môže chcieť presunúť Pod na inú fyzickú uzol. A tu už vstupuje do hry DevOps. Ten musí celej sústave správne vysvetliť, že tieto pod’ y môžeme presúvať iba na také uzly, na ktorých máš na týchto cestách niečo pripojené, a nie viac ako jeden uzol naraz. To je dosť zložité.
Špeciálne na tieto účely sme u nás v operátora vytvorili šablóny, aby sme celú túto zložitosť skryli. A mohli by sme jednoducho povedať: "Chcem, aby som mal jeden instance ClickHouse na každú fyzickú uzol a na takejto ceste."
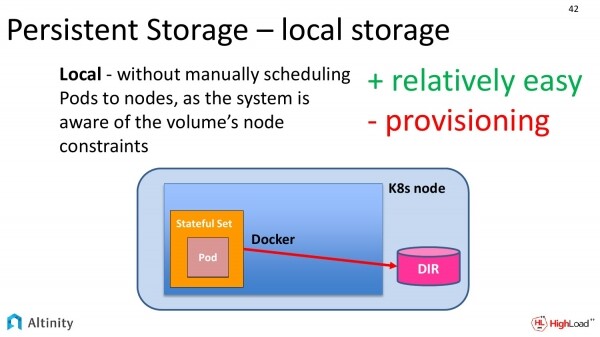
Ale táto potreba je potrebná nielen nám, pretože páni z Kubernetes tiež chápu, že ľudia chcú mať prístup k fyzickým diskom, a preto poskytujú tretí úroveň.
Nazýva sa local. Rozdiel od predchádzajúceho snímku prakticky nie je. Iba predtým sme museli ručne realizovať, že tieto pod’ y nemožno prenášať z uzla na uzol, pretože musia byť pripojené na takejto ceste k lokálnemu fyzickému disku, a teraz sa všetky tieto vedomosti inkapsulujú do samotného Kubernetes. A konfigurácia sa stáva oveľa jednoduchšou.
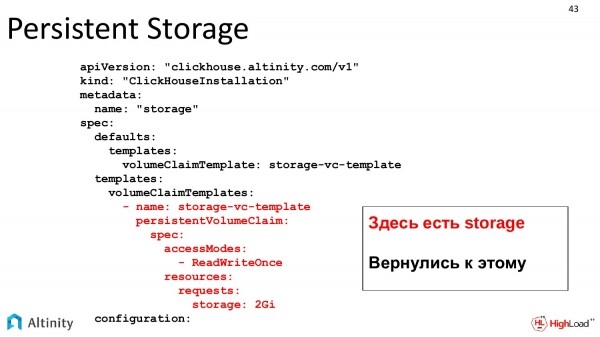
Vráťme sa k našej praktickej úlohe. Vráťme sa k YAML šablóne. Tu máme skutočný storage. Vrátili sme sa k tomu. Definujeme klasickú VolumeClaim šablónu ako v k8s. A popisujeme, aký storage chceme.
Potom k8s požiada o storage. Prideľuje nám ho v StatefulSet. A nakoniec to bude k dispozícii ClickHouse.
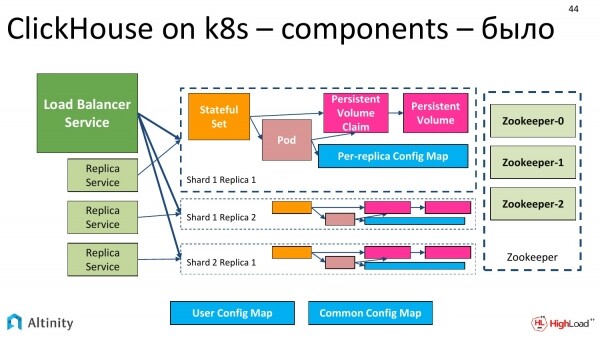
Mali sme takúto schému. Náš Persistent Storage bol červený, čo akoby naznačovalo, že by sa mal realizovať.
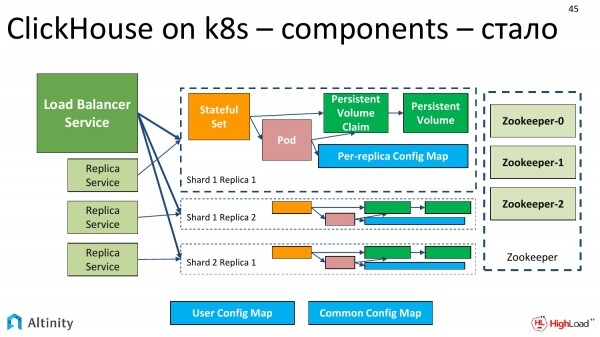
A stáva sa zeleným. Teraz je schéma clustera ClickHouse na k8s úplne finalizovaná. Máme shard, repliky, ZooKeeper, máme skutočný Persistent, ktorý bol implementovaný takým alebo onakým spôsobom. Schéma je už plne funkčná.
Pokračujeme ďalej. Naša klaster sa rozvíja. A Alexej sa snaží a vydáva novú verziu ClickHouse.
Vzniká praktická úloha - otestovať novú verziu ClickHouse na našom klastri. A samozrejme, nechceme ho nasadiť celý, chceme niekde v zadnom rohu nainštalovať novú verziu na jednu replikáciu, a možno nie jednu novú verziu, ale rovno dve, pretože vychádzajú celkom často.
Čo môžeme povedať o tomto?
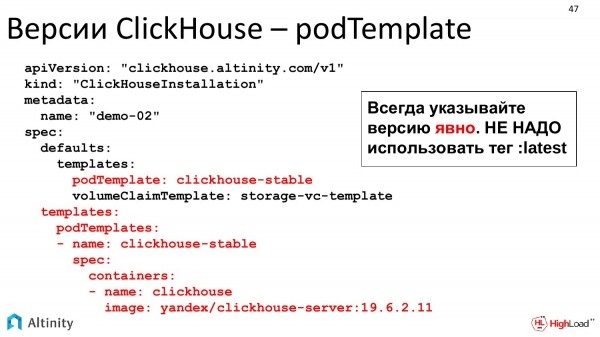
Tu máme presne takúto možnosť. Ide o šablóny podov. Môžeme si ich prispôsobiť, náš operátor úplne umožňuje vytvoriť heterogénny kluster. T.j. konfigurovať, začínajúc od všetkých replík v skupine, končiac s každou osobnou replikou tým, akú verziu chceme pre ClickHouse, akú verziu chceme pre úložisko. Môžeme úplne nakonfigurovať kluster s takou konfiguráciou, akú potrebujeme.
Trošku sa budeme hlbšie zaoberať touto problematikou. Predtým sme hovorili o tom, ako funguje ClickHouse-operator vo vzťahu k špecifikám ClickHouse.
Teraz by som chcel povedať pár slov o tom, ako funguje vlastne akýkoľvek operátor a ako interaguje s K8s.
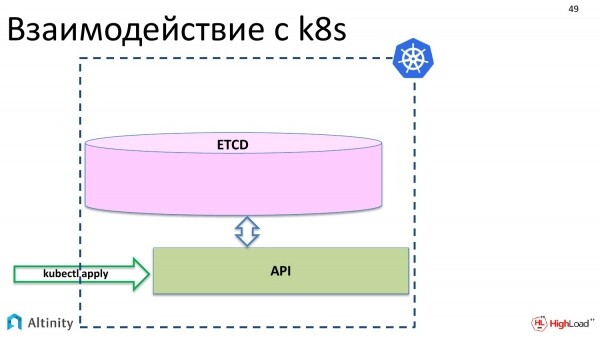
Najprv si pozrime interakciu s K8s. Čo sa deje, keď vykonáme kubectl apply? Naše objekty sa objavia cez API v etcd.
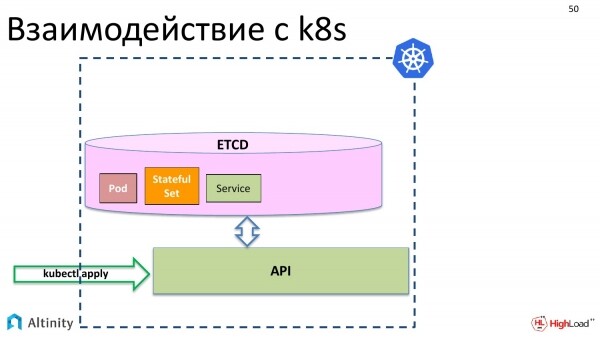
Napríklad základné objekty Kubernetes: pod, StatefulSet, služba a tak ďalej v zozname.
Pri tom sa ešte nič fyzického nedeje. Tieto objekty je potrebné materializovať v klastri.
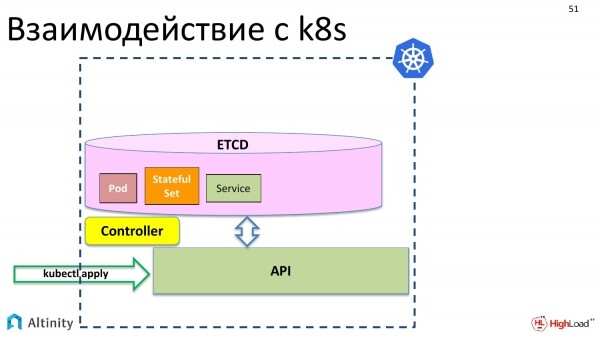
Na to sa objavuje kontrolér. Kontrolér je špeciálna komponenta k8s, ktorá vie materializovať tieto popisy. Vie, ako a čo treba urobiť fyzicky. Vie, ako spustiť kontajnery, čo je potrebné nastaviť, aby server fungoval.
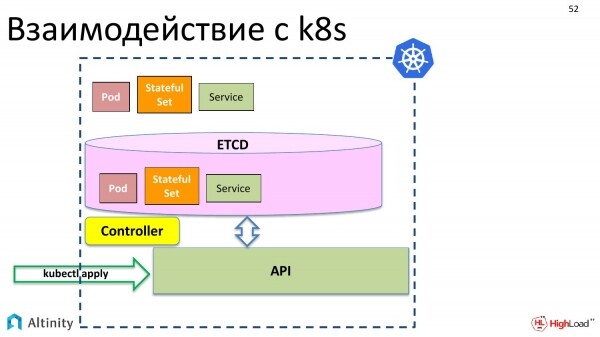
A on materializuje naše objekty v K8s.
Ale chceme operovať nielen s podmi, StatefulSetmi, chceme vytvoriť ClickHouseInstallation, t.j. objekt typu ClickHouse, aby sme s ním mohli operovať ako s celkom. Zatiaľ taká možnosť nie je.
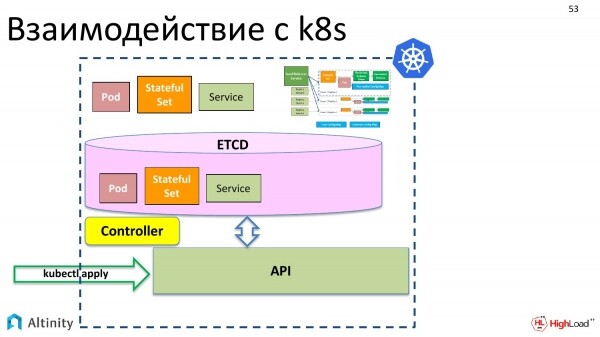
Ale K8s má ďalšiu príjemnú funkciu. Chceme, aby sa nám objavila niekde takáto zložitá entita, ktorá by bola zostavená z podov a StatefulSet nášho klastra.
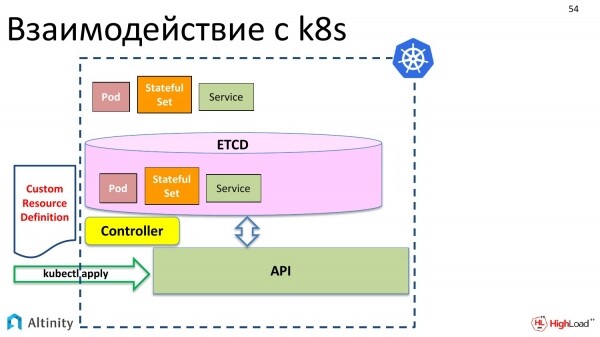
A čo je potrebné urobiť? Po prvé, na scénu vstupuje Custom Resource Definition. Čo to vlastne je? Je to popis pre K8s, že bude mať ešte jeden typ dát, že chceme k podu, StatefulSet pridať vlastný zdroj, ktorý bude zložitý vo vnútri. Je to popis štruktúry dát.
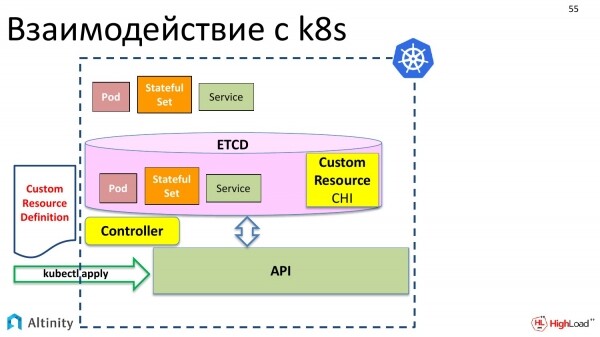
Tento popis tiež posielame cez kubectl apply. Kubernetes ho s radosťou prijal.
A teraz máme v úložisku, pri objekte v etcd možnosť zapísať vlastný zdroj s názvom ClickHouseInstallation.
Ale zatiaľ sa nič ďalej nestane. T.j. ak teraz vytvoríme YAML súbor, ktorý sme posudzovali so záznamom shardov, replik a povieme 'kubectl apply', tak Kubernetes ho prijme, uloží do etcd a povie: 'Skvelé, ale neviem, čo s tým robiť. Ako spravovať ClickHouseInstallation neviem'.
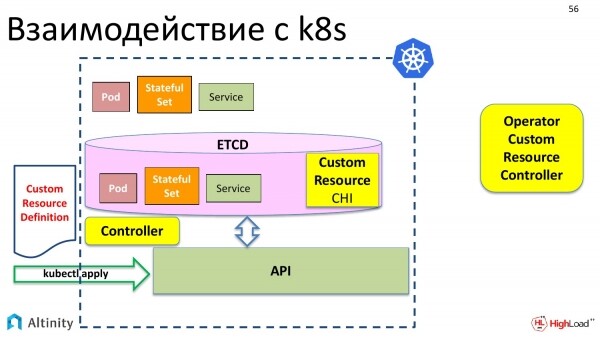
Potrebujeme teda niekoho, kto pomôže Kubernetes spravovať nový typ dát. Naľavo máme štandardný kontrolér Kubernetes, ktorý pracuje s bežnými typmi dát. A napravo by sa mal objaviť vlastný kontrolér, ktorý vie pracovať s vlastnými typmi dát.
A ináč sa nazýva operátor. Špeciálne som ho vyčlenil mimo Kubernetes, pretože môže bežať aj mimo K8s. Najčastejšie samozrejme všetky operátory bežia v Kubernetes, ale nič nebráni tomu, aby bol vonku, preto je tu špeciálne vyčlenený von.
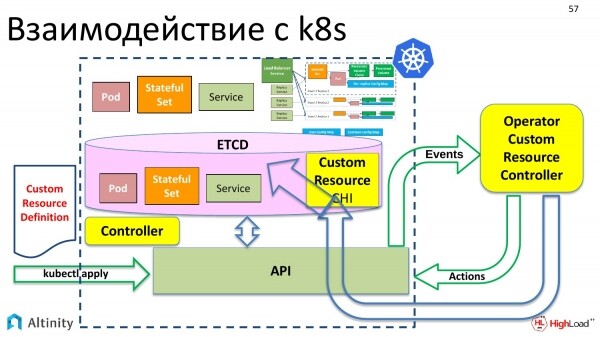
A už vlastný kontrolér, teda operátor, interaguje s Kubernetes cez API. Užíva interakciu s API. A už vie, ako z vlastného zdroja vytvoriť zložitú schému, ktorú chceme vytvoriť. Týmto sa zaoberá operátor.
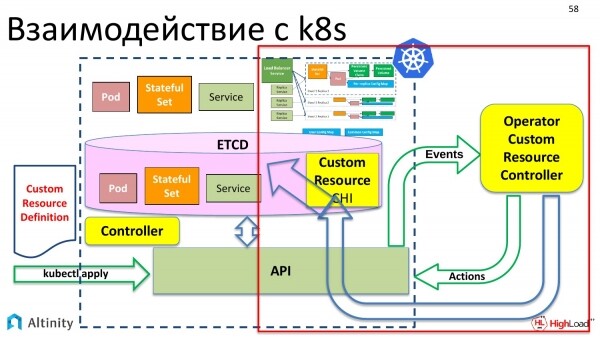
Ako funguje operátor? Pozrime sa na pravú časť, aby sme zistili, ako to robí. Zistíme, ako operátor všetko to materializuje a aké je ďalšie prepojenie s K8s.
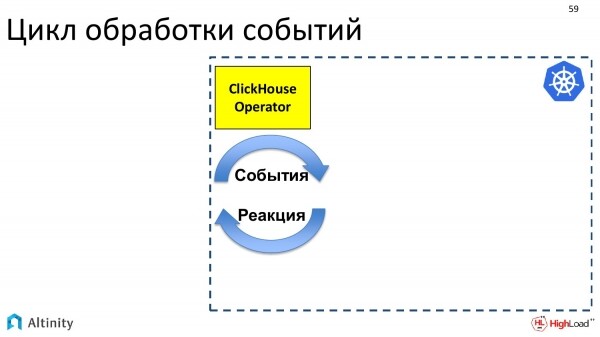
Operátor je program. Je orientovaný na udalosti. Operátor sa pomocou Kubernetes API prihlási na udalosti. V Kubernetes API sú vstupné body, kde sa môžete prihlásiť na udalosti. A ak sa niečo v K8s zmení, Kubernetes posiela udalosti všetkým, ktorí majú záujem, t.j. kto sa prihlásil na tento bod API, ten dostane upozornenia.
Operátor sa prihlasuje na udalosti a musí na ne nejak reagovať. Jeho úlohou je reagovať na vznikajúce udalosti.
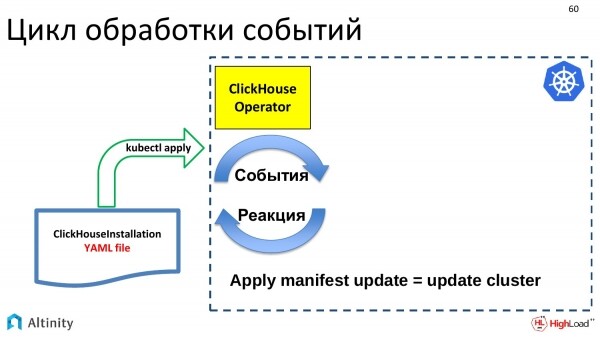
Udalosti sa generujú niektorými aktualizáciami. Prichádza náš YAML súbor s popisom ClickHouseInstallation. Pomocou kubectl apply sa dostal do etcd. Tam nastala udalosť, ktorá sa dostala do ClickHouse-operatora. Operátor dostal tento popis a musí niečo robiť. Ak prišla aktualizácia na objekt ClickHouseInstallation, je potrebné aktualizovať klaster. A úlohou operátora je aktualizovať klaster.
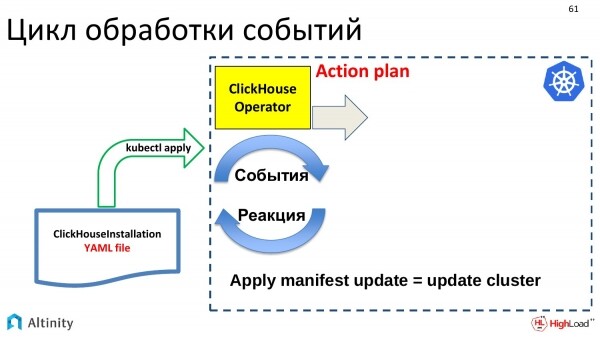
Čo robí? Po prvé, je potrebné zostaviť plán akcií, čo plánujeme urobiť s týmto aktualizáciou. Aktualizácie môžu byť veľmi malé, t.j. malé v YAML vykonaní, ale môžu mať za následok veľmi veľké zmeny v klastre. Preto operátor vytvára plán a potom sa ho drží.
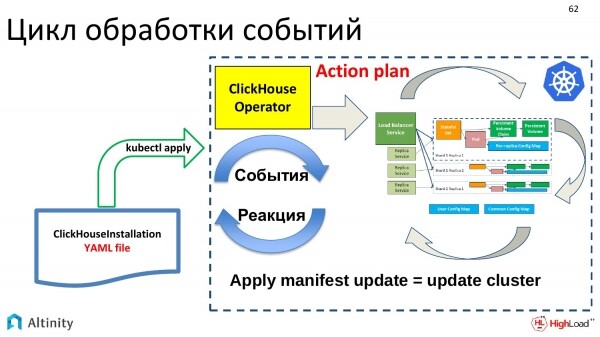
Začína podľa tohto plánu vytvárať túto štruktúru dovnútra, aby materializoval pod'y, služby, t.j. robiť to, čo je jeho hlavnou úlohou. Je to ako budovať klaster ClickHouse v Kubernetes.
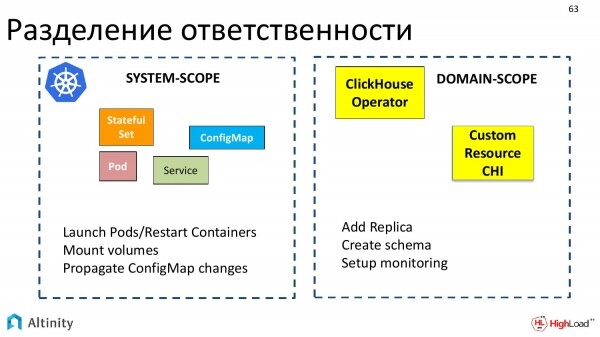
Teraz sa pozrime na takú zaujímavú vec. Je to rozdelenie zodpovednosti medzi Kubernetes a operátorom, t.j. čo robí Kubernetes, čo robí operátor a ako spolu interagujú.
Kubernetes zodpovedá za systémové veci, t.j. za základný súbor objektov, ktorý sa dá interpretovať ako system-scope. Kubernetes vie, ako spustiť pod'y, ako reštartovať kontajnery, ako robiť mount volumes, ako pracovať s ConfigMap, t.j. všetko, čo sa dá nazvať systémom.
Operátori operujú v predmetných oblastiach. Každý operátor je vytvorený pre svoju predmetnú oblasť. My sme vytvorili pre ClickHouse.
A operátor interaguje presne vo výrazoch predmetnej oblasti ako pridať replikáciu, vytvoriť schému, nastaviť monitorovanie. Vzniká takéto rozdelenie.
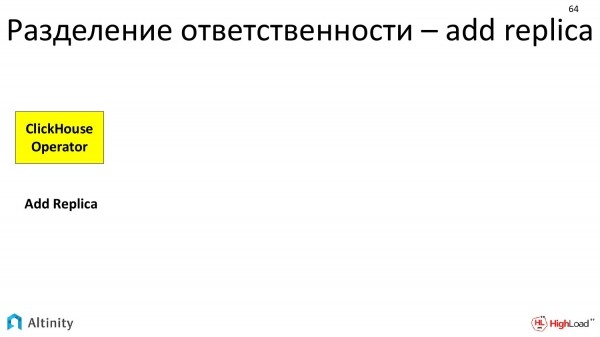
Pozrime sa na praktický príklad, ako toto rozdelenie zodpovednosti prebieha, keď vykonávame akciu pridať replikáciu.
K operátorovi prichádza úloha - pridať replikáciu. Čo operátor robí? Operátor vypočíta, že je potrebné vytvoriť nový StatefulSet, v ktorom treba opísať takéto šablóny, volume claim.
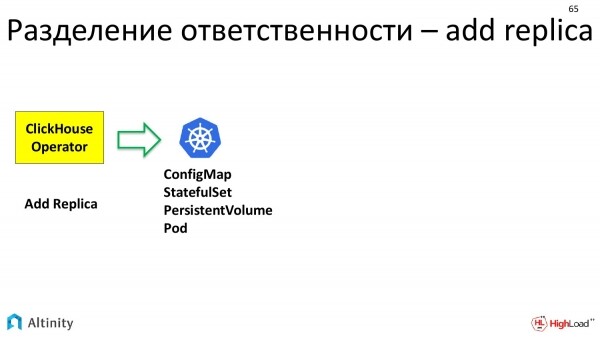
Všetko to pripraví a ďalej to odovzdá do K8s. Hovorí, že potrebuje ConfigMap, StatefulSet, Volume. Kubernetes to spracováva. Materializuje základné jednotky, ktorými operuje.
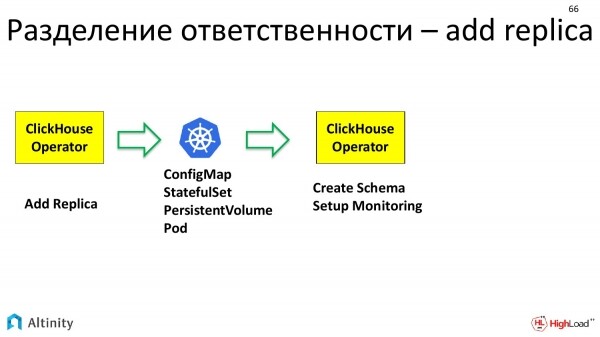
A ďalej sa opäť angažuje ClickHouse-operator. Už má fyzický pod, na ktorom sa dá niečo robiť. A ClickHouse-operator opäť pracuje vo výrazoch predmetnej oblasti. T.j. konkrétne ClickHouse, aby zapol replikáciu v klastri, treba najprv nastaviť schému dát, ktorá v tomto klastri existuje. A po druhé, túto replikáciu treba zapojiť do monitorovania, aby bola dobre sledovateľná. Už to nastavuje operátor.
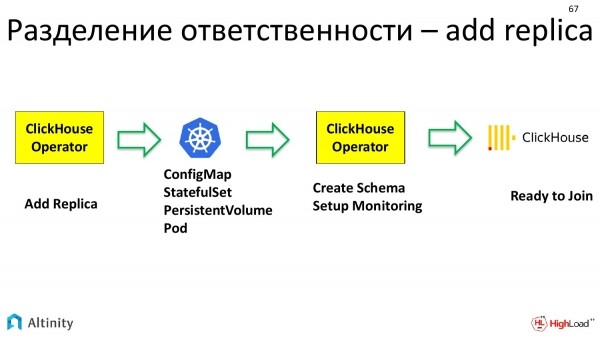
Až potom do procesu vstupuje samotný ClickHouse, teda ďalšia vyššia entita. Toto je už databáza. Má svoj instance, ďalšiu nakonfigurovanú replikáciu, ktorá je pripravená vstúpiť do clustra.
Vytvára sa teda dlhý reťazec vykonávania a rozdelenia zodpovednosti pri pridávaní repliky.
Pokračujeme v našich praktických úlohách. Ak už existuje cluster, môžeme vykonať migráciu konfigurácie.
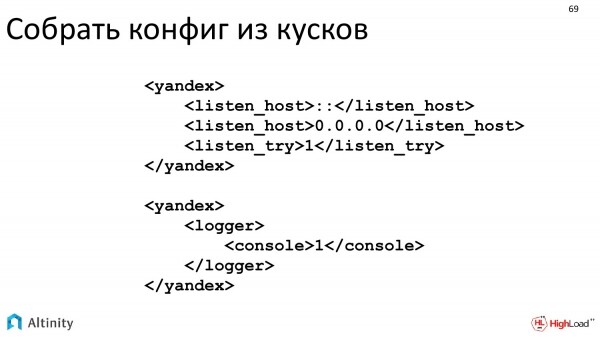
Urobili sme to tak, že do existujúceho xml, ktorému ClickHouse rozumie, môžeme prechádzať bez prekážok.
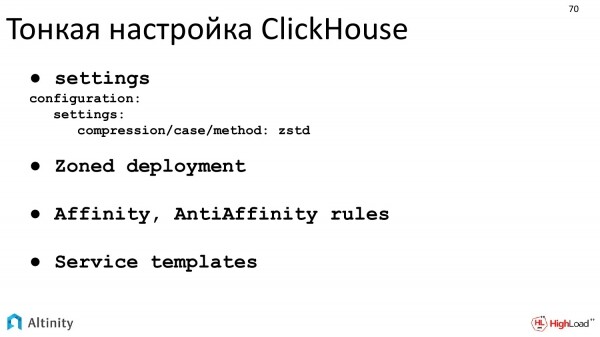
Môžeme vykonať jemné nastavenie ClickHouse. Práve zoned deployment – to je to, o čom som hovoril pri vysvetlení hostPath, lokálneho úložiska. To, ako správne uskutočniť zoned deployment.
Ďalšou praktickou úlohou je monitoring.
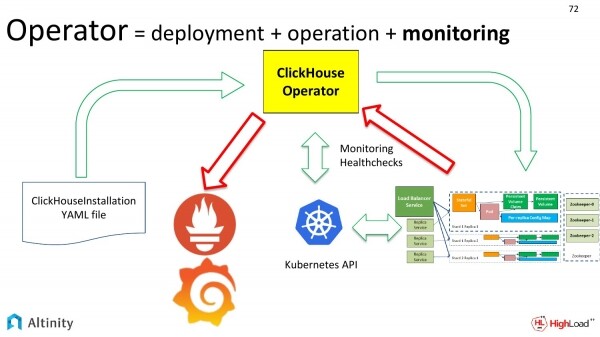
Ak sa náš cluster mení, musíme pravidelne nastavovať monitoring.
Pozrime sa na schému. Zelené šípky sme už preskúmali. Teraz si pozrime červené šípky. To je to, ako chceme monitorovať náš cluster. Ako metriky z clustra ClickHouse prechádzajú do Prometheus a následne do Grafana.
A aký je problém s monitoringom? Prečo je to považované za nejaký úspech? Problém spočíva práve v dynamike. Keď máme jediný statický cluster, môžeme nastaviť monitoring raz a viac sa tým nezaoberať.
Ale ak máme veľa clusterov, alebo sa neustále niečo mení, proces je dynamický. Neustále prekonfigurovanie monitoringu je strata zdrojov a času, teda aj proste len lenivosť. Musí sa to automatizovať. Problém spočíva práve v dynamike procesu. A operátor to veľmi dobre automatizuje.
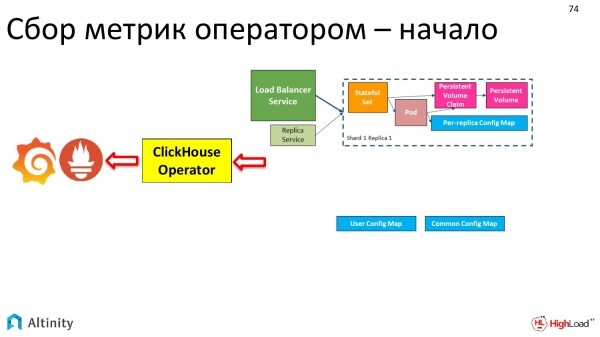
Ako sa náš cluster vyvíjal? Na začiatku bol takýto.
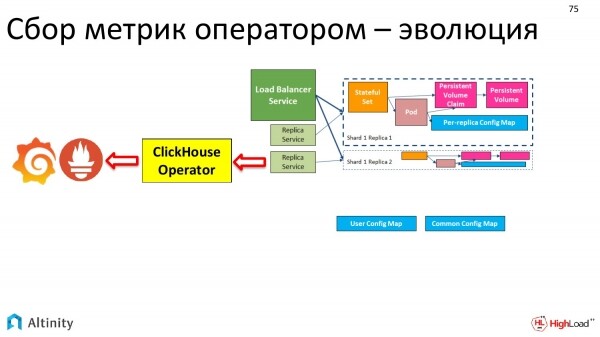
Potom bol takýto.
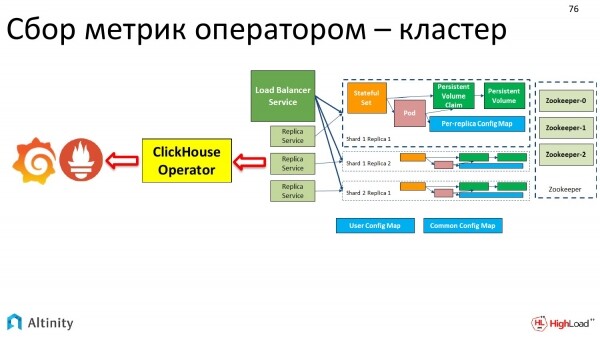
Eventuálne sa stal takýmto.
A monitoring sa automaticky vykonáva operátorom. Jediný bod vstupu.
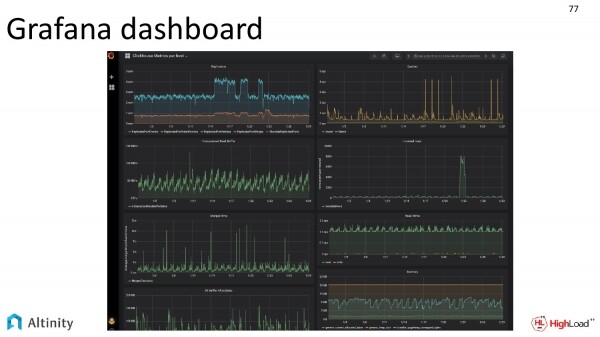
A my sa len na výstupe pozeráme na Grafana dashboard, ako tam vnútorný život nášho clustra prebieha.
Mimochodom, Grafana dashboard sa tiež šíri s naším operátorom priamo v zdrojových kódoch. Môžete sa pripojiť a používať. Tento screenshot mi dali naši DevOps.
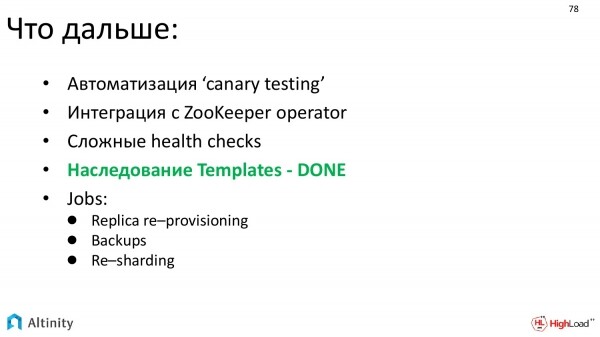
Kam by sme chceli ísť ďalej? Toto:
- Rozvíjať automatizáciu testovania. Hlavnou úlohou je automatizované testovanie nových verzií.
- Taktiež veľmi chceme automatizovať integráciu s ZooKeeperom. Plánujeme sa integrovať aj s ZooKeeper-operatorom. T.j. pre ZooKeeper je napísaný operátor a je logické, aby sa dva operátory začali integrovať za účelom vybudovania pohodlnejšieho riešenia.
- Chceme vykonať zložitejšie kontroly životaschopnosti.
- Zelenou som zvýraznil, že máme na dosah dedičstvo šablón – HOTOVO, t. j. s ďalším vydaním operátora už budeme mať dedičstvo šablón. Je to mocný nástroj, ktorý umožňuje budovať zložité konfigurácie z kúskov.
- A chceme automatizáciu zložitých úloh. Hlavnou z nich je Re-sharding.
Poďme urobiť medzičlánky.
Čo dostávame na výstupe? A stojí za to sa tým zaoberať, alebo nie? Treba vobec skúšať dostať databázu do Kubernetes a aplikovať operátora celkovo a Alitnity-operator v osobitosti.
Na výstupe dostávame:
- Podstatné zjednodušenie a automatizáciu konfigurácie, nasadenia a tiež správy.
- Okamžite zabudovaný monitoring.
- A pripravené na použitie kodifikované šablóny pre zložité situácie. Už nie je potrebné vykonávať úkon ako pridanie repliky manuálne. To robí operátor.
Zostala len posledná otázka. Máme už databázu v Kubernetes, virtualizáciu. Aká je výkonnosť takéhoto riešenia, najmä vzhľadom na to, že ClickHouse je optimalizovaný na výkon?
Odpoveď – všetko je v poriadku! Nebudem to podrobne rozoberať, to je téma samostatnej prednášky.
Ale existuje taký projekt ako TSBS. Aký je jeho hlavný cieľ? Je to test databáz na výkon. Je to pokus porovnať teplé s teplým, mäkké s mäkkým.
Ako to funguje? Generuje sa jeden súbor údajov. Potom sa tento súbor údajov na rovnakom súbore testov prevádzkuje na rôznych databázach. A každá databáza rieši jednu úlohu tak, ako to dokáže. A potom je možné výsledky porovnávať.
Už podporuje množstvo databáz. Vyčlenil som tri hlavné. To sú:
- TimescaleDB.
- InfluxDB.
- ClickHouse.
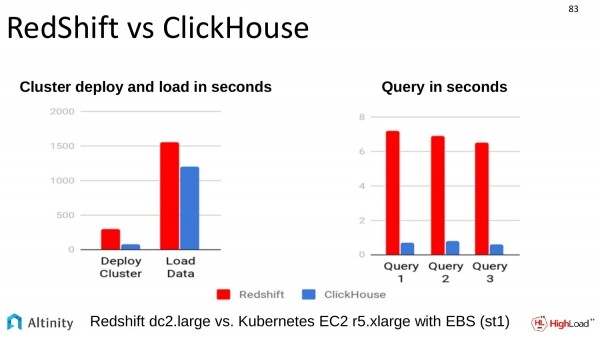
Bolo tiež vykonané porovnanie s iným podobným riešením. Porovnanie s RedShift. Porovnanie sa uskutočnilo na Amazone. ClickHouse taktiež dobre prekonáva všetkých v tejto otázke.
Aké závery môžeme urobiť z toho, čo som povedal?
- DB v Kubernetes je možný. Asi je možné akýkoľvek, ale zdá sa, že je to možné. ClickHouse v Kubernetes určite možno zaviesť silami nášho operátora.
- Operátor pomáha automatizovať procesy a naozaj zjednodušuje život.
- Výkon je normálny.
- A zdá sa, že to môžeme a mali by sme využiť.
Open source – pridajte sa k nám!
Ako som už povedal, operátor je úplne open source produkt, takže by bolo veľmi dobré, keby ho využívalo čo najviac ľudí. Pridajte sa! Čakáme na vás všetkých!
Všetkým ďakujem!
Otázky
Ďakujem za prednášku! Volám sa Anton, som z firmy SEMrush. Zaujíma ma, čo je s logovaním. O monitorovaní sme počuli, ale o logovaní nič, pokiaľ ide o celý klaster. U nás je napríklad spustený klaster na hardvéri. A používame centralizované logovanie, štandardnými prostriedkami zhromažďujeme do spoločného celku. A potom tam vyťahujeme pre nás zaujímavé údaje.
Dobrý otázka, teda logovanie je na zozname úloh. Náš operátor to zatiaľ automatizuje. Ešte sa vyvíja, projekt je ešte dosť mladý. Chápeme potrebu logovania. To je tiež veľmi dôležitá téma. A pravdepodobne je to ne menej dôležité než monitorovanie. Ale prvé v zozname na realizáciu bolo monitorovanie. Logovanie bude. Samozrejme sa snažíme automatizovať všetky aspekty životnosti klastera. Preto odpoveď znie – v súčasnosti to operátor, žiaľ, nevie, ale je to v pláne, budeme to robiť. Ak máte záujem pripojiť sa, tak pull request, prosím.
Dobrý deň! Ďakujem za prednášku! Mám štandardnú otázku týkajúcu sa Persistent Volumes. Keď vytvárame konfiguráciu prostredníctvom tohto operátora, ako operátor určí, na ktorej nód má pripojený nejaký disk, alebo priečinok? Musíme mu vopred vysvetliť, že prosím umiestnite náš ClickHouse práve na tých nódach, na ktorých je disk?
Ako chápem, táto otázka je pokračovaním lokálneho úložiska, najmä jeho časti týkajúcej sa hostPath. Je to ako vysvetliť celej systému, že pod musí byť spustený práve na takejto nód, na ktorú máme fyzicky pripojený disk, ktorý je pripojený na takomto mieste. To je celá sekcia, ktorú som sa dotkol veľmi povrchne, pretože odpoveď je dosť rozsiahla.
Stručne povedané, vyzerá to takto. Samozrejme, musíme pripraviť provisioning týchto objemov. V súčasnosti neexistuje dynamický provisioning pre lokálne úložisko, takže DevOps musia manuálne rozdeliť disky, tieto objemy. A musia vysvetliť Kubernetes provisioning, že budete mať Persistent volumes určitej triedy, ktorá sa nachádza na určitých nodách. Potom bude potrebné vysvetliť Kubernetes, že pod’y, ktoré vyžadujú určitú triedu lokálneho úložiska, by mali byť plánované iba na určité nody pomocou štítkov. Na tento účel v operátore existuje možnosť priradiť určitému štítku a jeden za hostiteľa. A bude sa realizovať, že pod’y budú smerované Kubernetesom na spustenie iba na nodách, ktoré splnia požiadavky, štítky, jednoducho povedané. Administrátori priraďujú štítky, robia provisioning diskov ručne. A potom sa to môže škálovať.
Tretia možnosť lokálneho úložiska pomáha trochu to uľahčiť. Ako som už zdôraznil, ide o dôkladnú prácu na nastavení, ktorá na výstupe pomáha dosiahnuť maximálny výkon.
Mám druhú otázku, ktorá s tým súvisí. Kubernetes bol navrhnutý tak, že nám nezáleží na tom, či stratíme nodu alebo nie. Čo by sme mali robiť v prípade, že stratíme nodu, na ktorej visí shard?
Áno, Kubernetes sa pôvodne nastavil tak, že naše vzťahy s našimi pod’ami sú ako s dobytok, a v tomto prípade každý disk sa stáva niečím ako domácim maznáčikom. Máme problém, že ich nemôžeme len tak vyhodiť. A rozvoj Kubernetes smeruje k tomu, že nie je možné úplne na to filozoficky myslieť ako na plne vyhodené zdroje.
Teraz praktická otázka. Čo robiť, ak ste stratili nodu, na ktorej bol disk? Tu sa už úloha rieši na vyššej úrovni. V prípade ClickHouse máme repliky, ktoré fungujú na vyššej úrovni, teda na úrovni ClickHouse.
Aká je teda situácia? Za to, aby sa nestratili dáta, zodpovedá DevOps. Musí správne nastaviť replikáciu a musí sledovať, aby sa replikácia vykonávala. Replika na úrovni ClickHouse musí mať údaje zdvojené. To nie je úloha, ktorú rieši operátor. A nie je to ani úloha, ktorú rieši samotný Kubernetes. Je to na úrovni ClickHouse.
Čo robiť, ak vám padla železná nód? A zdá sa, že treba nastaviť druhú, správne zprovisionovať disk, aplikovať štítky. A potom spĺňa požiadavky, že Kubernetes na nej môže spustiť inštanciu podu. Kubernetes to spustí. Veď vám chýba počet podov na dané číslo. Prejde cyklom, ktorý som ukazoval. A na najvyššej úrovni ClickHouse pochopí, že nám prišla replikácia, je ešte prázdna a treba začať nalievať na ňu dáta. T.j. tento proces je ešte zle automatizovaný.
Ďakujem za prednášku! Keď sa dejú rôzne nepríjemnosti, operátor spadne a reštartuje sa, a v tom momente prichádzajú udalosti, akým spôsobom to spracovávate?
Čo sa stane, ak operátor spadol a reštartoval sa, áno?
Áno. A v tom momente prišli udalosti.
Úloha, čo robiť v tomto prípade, sa čiastočne delí medzi operátora a Kubernetes. Kubernetes má možnosť prehrať udalosť, ktorá sa stala. Prehrá ju. A úloha operátora je zabezpečiť, aby, keď sa na ňom urobí replay logu udalostí, boli tieto udalosti idempotentné. A aby opakované spustenie tej istej udalosti nerozbilo našu systém. A náš operátor sa s touto úlohou vyrovnáva.
Dobrý deň! Ďakujem za prednášku! Dmitrij Zavyalov, spoločnosť Smedova. Plánuje sa pridať do operátora možnosť nastavenia s haproxy? Zaujíma ma nejaký iný vyvažovač okrem štandardného, aby bol inteligentný a chápal, že tam naozaj ClickHouse.
Hovoríte o Ingress?
Áno, nahradiť Ingress za haproxy. V haproxy môžete uviesť topológiu klastra, kde má repliky.
Zatiaľ sme nad tým nerozmýšľali. Ak to potrebujete a môžete vysvetliť, prečo to potrebujete, dá sa to realizovať, najmä ak by ste chceli prispieť. Radi zvážime túto možnosť. Krátka odpoveď – nie, momentálne takú funkčnosť nemáme. Ďakujem za podnet, pozrieme sa na to. A ak ešte vysvetlíte use case a prečo je to potrebné v praxi, napríklad vytvoríte issues na GitHub, bude to skvelé.
Už je.
Dobre. Sme otvorení akýmikoľvek návrhom. A haproxy sa pridáva do zoznamu úloh. Zoznam úloh rastie, nie zmenšuje sa zatiaľ. Ale to je dobré, to znamená, že produkt má záujem.
Zdroj: habr.com
