

Riadené algoritmické metódy, ako sú neurónové siete, dobyli svet. Ich vývoj je spôsobený niekoľkými faktormi, vrátane dostupnosti lacného a výkonného hardvéru a obrovského množstva údajov. Neurónové siete sú v súčasnosti na čele vo všetkom, čo sa týka „kognitívnych“ úloh, ako je rozpoznávanie obrazov, porozumenie prirodzenému jazyku a podobne. Ale nemali by byť obmedzené len na tieto úlohy. V tomto článku sa hovorí o spôsobe kompresie obrazov pomocou neurónových sietí, a to prostredníctvom reziduálneho učenia. Prezentovaný prístup funguje rýchlejšie a lepšie než štandardné kodeky. Schémy, rovnice a samozrejme tabuľka s testami sú skryté pod katom.
Tento článok je založený na práci. Predpokladá sa, že ste oboznámení s neurónovými sieťami a ich konceptmi konvolúcia a funkcia straty.
Čo je kompresia obrazov a aké sú jej typy?
Kompresia obrazov je proces transformácie obrazu tak, aby zaberalo menej miesta. Jednoduché uloženie obrázkov by zabralo veľa miesta, a preto existujú kodeky, ako je JPEG a PNG, ktoré sú zamerané na zmenšenie veľkosti pôvodného obrazu.
Ako je známe, existujú dva typy kompresie obrazov: bez strát a so stratami. Ako už názov napovedá, pri kompresii bez strát je možné získať údaje pôvodného obrazu, zatiaľ čo pri kompresii so stratami sa niektoré údaje pri kompresii strácajú. Napríklad, JPG sú algoritmy so stratami [pozn. prekl. — hlavne, nezabúdajme ani na bezstratový JPEG], zatiaľ čo PNG je algoritmus bez strát.
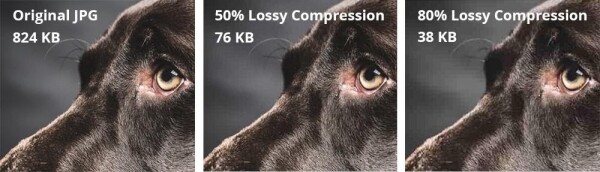
Porovnanie bezstratovej a so stratami kompresie
Všimnite si, že na obrázku vpravo je veľa blokových artefaktov. To je stratena informácia. Susedné pixely podobných farieb sa zlučujú ako jedna oblasť na úsporu miesta, ale pričom sa stratí informácia o skutočných pixeloch. Samozrejme, algoritmy používané vo formátoch JPEG, PNG atď. sú oveľa zložitejšie, ale toto je dobrý intuitívny príklad kompresie s stratami. Bezstratová kompresia je dobrá, no súbory skompresované bez stratenej vôle zaberajú veľa miesta na disku. Existujú efektívnejšie spôsoby kompresie obrázkov bez straty veľkého množstva informácií, ale sú dosť pomalé, a mnohé z nich používajú iteratívne prístupy. To znamená, že sa nedajú spustiť paralelne na viacerých jadrách centrálnych alebo grafických procesorov. Toto obmedzenie robí ich úplne nepraktickými v každodennom používaní.
Vstup konvolučnej neuronovej siete
Ak je potrebné niečo vypočítať a výpočty môžu byť približné, pridajte . Autori použili pomerne štandardnú konvolučnú neurónovú sieť na vylepšenie kompresie obrázkov. Predložená metóda nielenže funguje na rovnakej úrovni ako najlepšie riešenia (ak nie lepšie), ale tiež môže využívať paralelné výpočty, čo vedie k výraznému zvýšeniu rýchlosti. Dôvodom je, že konvolučné neuronové siete (CNN) sú veľmi dobré pri extrakcii priestorových informácií z obrázkov, ktoré sa potom predstavujú v kompaktnejšej forme (napríklad uchovajú sa iba „dôležité“ bity obrázku). Autori chceli využiť túto schopnosť CNN na lepšie reprezentovanie obrázkov.
Architektúra
Autori navrhli dvojitú sieť. Prvá sieť prijíma obrázok a generuje kompaktné zastúpenie (ComCNN). Výstupy tejto siete sú potom spracované štandardným kodekom (napríklad JPEG). Po spracovaní kodekom je obrázok odovzdaný druhej sieti, ktorá „opravi“ obrázok z kodeku v pokuse vrátiť pôvodný obrázok. Autori nazvali túto sieť rekonstrukčnou CNN (RecCNN). Podobne ako GAN, obe siete sa trénujú iteratívne.
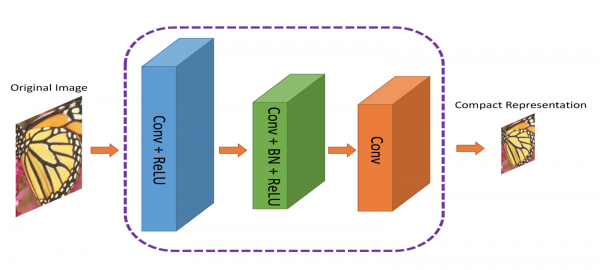
ComCNN Kompaktne zastúpenie je odovzdané štandardnému kodeku
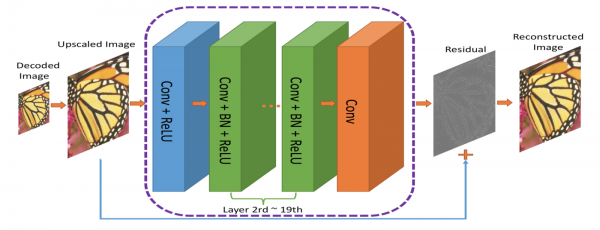
RecCNN. Výstupy ComCNN sa upscale-ujú a odosielajú do RecCNN, ktorá sa pokúsi naučiť zvyšok
Výstupné dáta kodeka sa škálujú s rastom a následne sa prenášajú do RecCNN. RecCNN sa pokúsi generovať obraz, ktorý je čo najviac podobný originálu.
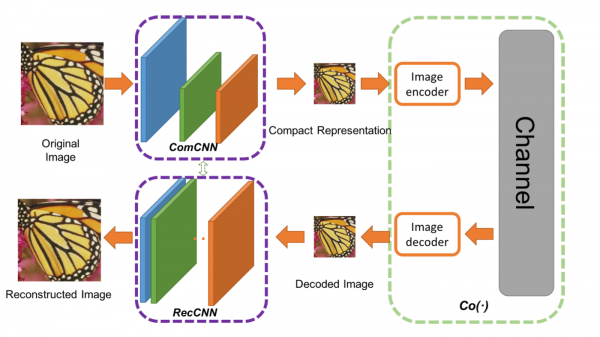
Tento rámec je priesečný a zameraný na kompresiu obrázkov. Co(.) predstavuje algoritmus pre kompresiu obrázkov. Autori použili JPEG, JPEG2000 a BPG.
Čo je reziduálny?
Reziduálny sa môže považovať za krok postspracovania na "vylepšenie" dekódovaného obrazu kodekom. S množstvom "informácií" o svete môže neurónová sieť prijímať kognitívne rozhodnutia o tom, čo opraviť. Táto myšlienka je založená na , o ktorom sa môžete dočítať viac. .
Funkcie straty
Používajú sa dve funkcie straty, pretože máme dve neurónové siete. Prvá z nich, ComCNN, je označená ako L1 a je definovaná takto:
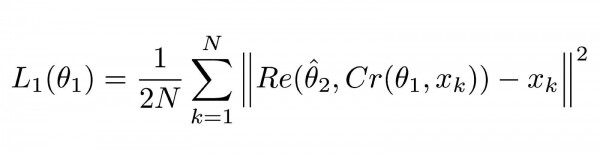
Funkcia straty pre ComCNN
Vysvetlenie
Táto rovnica sa môže zdať zložitá, ale v skutočnosti ide o štandardnú (strednú štvorcovú chybu) MSE. ||² označuje normu vektora, ktorý uzatvárajú.
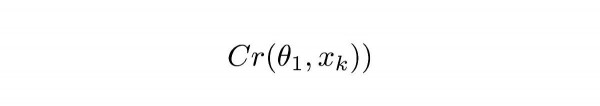
Rovnica 1.1
Cr označuje výstup ComCNN. θ označuje učenlivé parametre ComCNN, XK je vstupný obraz.
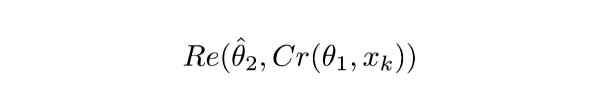
Rovnica 1.2
Re() označuje RecCNN. Táto rovnica jednoducho prenáša hodnotu rovnice 1.1 do RecCNN. θ označuje učenlivé parametre RecCNN (čiarka nad ním znamená, že parametre sú fixné).
Intuitívna definícia
Rovnica 1.0 núti ComCNN upraviť svoje váhy tak, aby po reprodukcii pomocou RecCNN konečný obraz vyzeral čo najviac podobne ako vstupný obraz. Druhá funkcia straty RecCNN je definovaná takto:
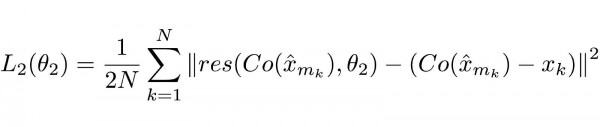
Rovnica 2.0
Vysvetlenie
Opäť môže funkcia vyzerať zložito, ale je to prevažne štandardná funkcia straty neurónovej siete (MSE).
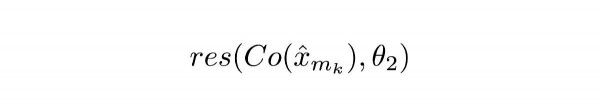
Rovnica 2.1
Co() označuje výstup kodeka, x s čiarkou nad ním znamená výstup ComCNN. θ2 sú učenlivé parametre RecCNN. res() len predstavuje reziduálny výstup RecCNN. Je potrebné poznamenať, že RecCNN sa učí na rozdiele medzi Co() a vstupným obrazom, nie na vstupnom obraze.
Intuitívna definícia
Rovnica 2.0 núti RecCNN upraviť svoje váhy tak, aby výstupy vyzerali čo najviac podobne ako vstupný obraz.
Schéma učenia
Modely sa učia iteratívne, podobne ako Váhy prvej modelu sa fixujú, kým sa váhy druhej modelu aktualizujú, potom sa váhy druhej modelu fixujú, kým sa prvá model učí.
Testy
Autori porovnali svoju metodiku s existujúcimi metódami, vrátane jednoduchých kodekov. Ich metóda funguje lepšie ako ostatné, pričom si udržuje vysokú rýchlosť na príslušnom hardvéri. Okrem toho autori skúšali použiť iba jednu z dvoch sietí a zaznamenali pokles výkonu.
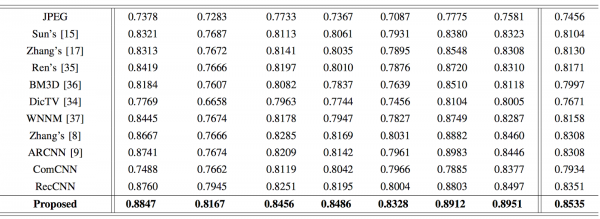
Porovnanie indexu štrukturálnej podobnosti (SSIM). Vyššie hodnoty naznačujú lepšiu podobnosť s originálom. Hrubým písmom je zvýraznený výsledok práce autorov.
Záver
Preskúmali sme nový spôsob aplikácie hlbokého učenia na kompresiu obrázkov, hovorili sme o možnostiach využitia neurónových sietí aj na úlohy okrem "bežných", ako je klasifikácia obrázkov a spracovanie jazyka. Táto metóda nielenže plne vyhovuje moderným požiadavkám, ale umožňuje aj výrazne rýchlejšie spracovanie obrázkov.
Štúdium neurónových sietí sa stalo jednoduchším, pretože sme pre huberčanov vytvorili promo kód HABR, ktorý poskytuje dodatočnú zľavu 10% na zľavu uvedenú na bannery.
Ďalšie kurzy
Odporúčané články
Zdroj: habr.com
