

Ahojte všetci! Volám sa Oleg Sidorenkov, pracujem v spoločnosti DomKlik ako vedúci tímu infraštruktúry. Systém „Kostka“ prevádzkujeme v produkcii už viac ako tri roky a za ten čas sme prežili množstvo zaujímavých momentov. Dnes vám poviem, ako pri správnom prístupe môžeme z „vanilkového“ Kubernetes získať ešte viac výkonu pre váš klaster. Pripravený, pozor, start!
Všetci dobre viete, že Kubernetes je škálovateľný systém s otvoreným zdrojovým kódom na orchestráciu kontajnerov; alebo inak povedané, 5 binárnych súborov, ktoré vykonávajú kúzla, riadiac životný cyklus vašich mikroservisov v serverovom prostredí. Je to tiež dosť flexibilný nástroj, ktorý môžete zostaviť ako LEGO, aby vyhovoval rôznym úlohám.
A vyzerá to, že všetko je v poriadku: hádzajte servery do klastru ako drevo do pece a žiadny problém. Ale ak ste ekologicky zameraní, zamyslíte sa: „Ako môžem udržiavať oheň v peci a zároveň šetriť les?“. Inými slovami, ako nájsť spôsoby na zlepšenie infraštruktúry a zníženie nákladov.
1. Sledujte zdroje tímov a aplikácií
Jedna z najzákladnejších, ale účinných metód je zavedenie requests/limits. Rozdeľte aplikácie do namespaces a namespaces podľa vývojových tímov. Pred nasadením nastavte aplikácii hodnoty pre spotrebu procesorového času, pamäte a efemérneho ukladania.
resources:
   requests:
     memory: 2Gi
     cpu: 250m
   limits:
     memory: 4Gi
     cpu: 500m
Skúsenosti nás naučili, že nemá zmysel nafukovať požiadavky nad limity viac než dvakrát. Objem klastru sa počíta na základe požiadaviek a ak nastavíte aplikáciám rozdiel v zdrojoch, napríklad 5-10 násobne, predstavte si, čo sa stane s vašou uzlom, keď sa naplní podmi a náhle dostane záťaž. Nič dobré. Minimálne spomalenie, v najhoršom prípade sa rozlúčite s pracovníkom a dostanete cyklickú záťaž na ostatné uzly, keď začnú podi prechádzať.
Okrem toho je možné pomocou limitranges môžete pri štarte nastaviť pre kontajner hodnoty zdrojov — minimálne, maximálne a predvolené:
➜  ~ kubectl describe limitranges --namespace ops
Name:       limit-range
Namespace:  ops
Type        Resource           Min   Max   Default Request  Default Limit  Max Limit/Request Ratio
----        --------           ---   ---   ---------------  -------------  -----------------------
Container   cpu                50m   10    100m             100m           2
Container   ephemeral-storage  12Mi  8Gi   128Mi            4Gi            -
Container   memory             64Mi  40Gi  128Mi            128Mi          2
Nezabudnite obmedziť prostriedky namespace, aby jedna skupina nemohla získať všetky prostriedky klastru:
➜  ~ kubectl describe resourcequotas --namespace ops
Name:                   resource-quota
Namespace:              ops
Resource                Used          Hard
--------                ----          ----
limits.cpu              77250m        80
limits.memory           124814367488  150Gi
pods                    31            45
requests.cpu            53850m        80
requests.memory         75613234944   150Gi
services                26            50
services.loadbalancers  0             0
services.nodeports      0             0
Z popisu je zrejmé resourcequotas, ak chce tím ops nasadiť pady, ktoré budú spotrebúvať ďalších 10 cpu, plánovač to nedovolí a vyhlási chybu:
Error creating: pods "nginx-proxy-9967d8d78-nh4fs" is forbidden: exceeded quota: resource-quota, requested: limits.cpu=5,requests.cpu=5, used: limits.cpu=77250m,requests.cpu=53850m, limited: limits.cpu=10,requests.cpu=10Na vyriešenie podobnej úlohy je možné napísať nástroj, napríklad ako , ktorý dokáže uchovávať a zdieľať stav zdrojov tímov.
2. Vyberte optimálne úložisko súborov
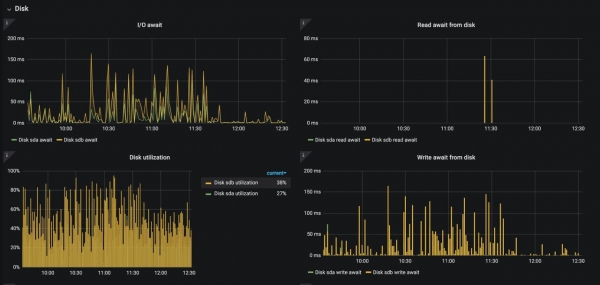
Tu by som chcel načrtnúť tému persistentných objemov a diskových subsystémov worker-nód Kubernetes. Dúfam, že nikto nepoužíva „Kube“ na HDD v produkcii, ale občas je aj bežný SSD už nedostatočný. Stretli sme sa s problémom, že logy preťažovali disk pri operáciách vstupu a výstupu, a tu nie je veľa možností riešenia:
Použiť vysoko výkonné SSD alebo prejsť na NVMe (ak si sami spravujete svoje zariadenia).
Znížiť úroveň logovania.
Vykonávať "inteligentné" vyvažovanie podov, ktoré zaťažujú disk (
podAntiAffinity).
Snímka vyššie ukazuje, čo sa deje pod nginx-ingress-controller s diskom, keď je povolené logovanie access_logs (~12 tisíc záznamov/sec.). Takýto stav môže samozrejme viesť k degradácii všetkých aplikácií na tejto nód.
Čo sa týka PV, žiaľ, nevyskúšal som všetky Trvalé objemy. Použite najlepšiu možnosť, ktorá vyhovuje práve vám. Historicky sa stalo, že malá časť služieb potrebuje RWX objemy, a na tento účel sa už dávno začalo používať NFS úložisko. Je to lacné a… stačí to. Samozrejme, že sme sa s ním naplno zažili ťažkosti — zdravím vás, ale naučili sme sa ho optimalizovať, takže nás to už netrápi. A ak je to možné, prejdite na objektové úložisko S3.
3. Zbierajte optimalizované obrazy
Najlepšie je používať obrazy optimalizované pre kontajnery, aby Kubernetes mohol rýchlejšie ich získavať a efektívnejšie vykonávať.
Optimalizácia znamená, že obrazy:
obsahujú iba jednu aplikáciu alebo vykonávajú iba jednu funkciu;
sú malých rozmerov, pretože veľké obrazy sa ťažšie prenášajú cez sieť;
majú koncové body na kontrolu funkčnosti a pripravenosti, pomocou ktorých Kubernetes môže vykonávať určité akcie v prípade výpadkov;
používajú operačné systémy priateľské ku kontajnerom (ako Alpine alebo CoreOS), ktoré sú odolnejšie voči chybám konfigurácie;
používajú viacstupňové zostavenia, aby ste mohli nasadzovať iba skompilované aplikácie a nie súvisiace zdrojové kódy.
Existuje mnoho nástrojov a služieb, ktoré umožňujú kontrolovať a optimalizovať obrazy naživo. Je dôležité ich vždy udržiavať aktuálne a bezpečne overené. Nakoniec dostanete:
Zníženie sieťovej záťaže na celý klaster.
Zníženie času spustenia kontajnera.
Menší objem celého vášho Docker registry.
4. Používajte DNS cache
Ak hovoríme o vysokých záťažiach, bez ladenia DNS systému klastrov je život dosť zlý. Kedysi dávno vývojári Kubernetes podporovali svoje riešenie kube-dns. To bolo implementované aj u nás, ale táto softvér nebola predmetom optimalizácie a nedosahovala požadovaný výkon, aj keď, zdalo by sa, že úloha je jednoduchá. Následne sa objavil coredns, na ktorý sme prešli a žiadne starosti sme nemali; nakoniec sa stal predvoleným DNS službou v K8s. V istom momente sme dosiahli 40 000 rps na DNS systéme a toto riešenie už tiež nestačilo. Ale, na šťastnú náhodu, vyšiel Nodelocaldns, tiež známy ako node local cache, tiež .
Prečo to používame? V jadre Linuxu je chyba, ktorá pri viacerých požiadavkách prostredníctvom conntrack NAT cez UDP vedie k závode o zápisy do conntrack tabuliek, pričom časť dopravy cez NAT sa stratí (každý prístup cez službu je NAT). Nodelocaldns rieši tento problém eliminovaním NAT a vylepšením pripojenia na TCP k upstreamovým DNS, ako aj lokálnym cachingom DNS požiadaviek na upstreamy (vrátane krátkeho 5-sekundového negatívneho cache).
5. Automaticky horizontálne a vertikálne škálujte pod.
Môžete si s istotou povedať, že všetky vaše mikroslužby sú pripravené na dvoj- až trojnásobný nárast zaťaženia? Ako správne prideľovať zdroje svojim aplikáciám? Držať bežiace niekoľko podov nad pracovnou záťažou sa môže ukázať ako nadbytočné, a ak ich budete držať na hranici, riskujete výpadok v prípade náhleho nárastu prevádzky na službu. Zlatej strednej cesty môže pomôcť dosiahnuť kouzlo násobenia, ako sú a .
VPA umožňuje automaticky zvyšovať requests/limits vašich kontajnerov v pode v závislosti od skutočného využitia. Ako vám môže byť užitočný? Ak máte pod, ktorý z nejakého dôvodu nemôže byť horizontálne škálovaný (čo nie je úplne spoľahlivé), môžete skúsiť zveriť zmenu jeho zdrojov VPA. Jeho výhodou je systém odporúčaní založený na historických a aktuálnych údajoch z metric-server, takže ak nechcete automaticky meniť requests/limits, môžete sledovať odporúčané zdroje pre vaše kontajnery a optimalizovať nastavenia za účelom úspory CPU a pamäte v klastri.
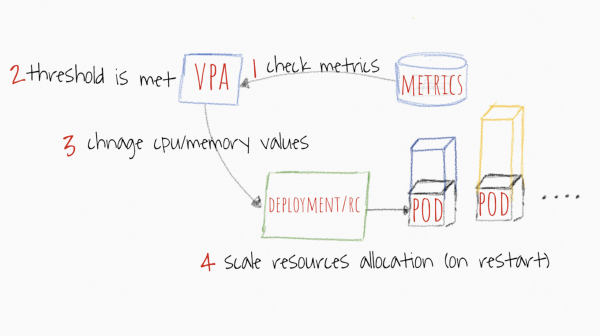 Obrázok prevzatý z https://levelup.gitconnected.com/kubernetes-autoscaling-101-cluster-autoscaler-horizontal-pod-autoscaler-and-vertical-pod-2a441d9ad231
Rozvrhovač v Kubernetes sa vždy zakladá na requests. Akúkoľvek hodnotu tam nastavíte, rozvrhovač hľadá vhodný uzol na základe nej. Hodnoty limits sú potrebné kubletu na pochopenie, kedy obmedziť alebo zabiť pod. A keďže jediným dôležitým parametrom je hodnota requests, VPA bude pracovať s ňou. Kedykoľvek nastavíte vertikálne škálovanie aplikácie, určujete, aké by mali byť requests. A čo sa teda stane s limits? Tento parameter bude tiež proporcionálne škálovaný.
Napríklad, tu sú bežné nastavenia podu:
zdroje:
   požiadavky:
     pamäť: 250Mi
     procesor: 200m
   limity:
     pamäť: 500Mi
     procesor: 350m
Mechanizmus odporúčaní určuje, že vašej aplikácii na normálnu prevádzku je potrebných 300m CPU a 500Mi. Získate takéto nastavenia:
zdroje:
   požiadavky:
     pamäť: 500Mi
     procesor: 300m
   limity:
     pamäť: 1000Mi
     procesor: 525m
Ako bolo spomenuté vyššie, ide o proporcionálne škálovanie na základe pomeru požiadaviek/limitov v manifeste:
CPU: 200m → 300m: pomer 1:1.75;
Pamäť: 250Mi → 500Mi: pomer 1:2.
Čo sa týka HPA, tu je mechanizmus práce transparentnejší. Sú nastavené prahové hodnoty metrík, napríklad procesor a pamäť, a ak priemerná hodnota všetkých replik prekročí prahovú hodnotu, aplikácia sa škáluje o +1 pod až kým hodnoty neklesnú pod prah alebo kým sa nedosiahne maximálny počet replik.
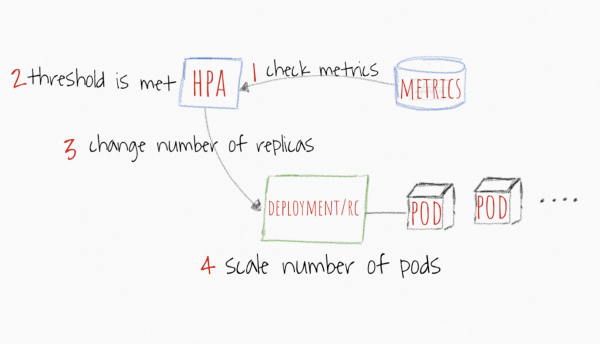 Obrázok prevzatý z https://levelup.gitconnected.com/kubernetes-autoscaling-101-cluster-autoscaler-horizontal-pod-autoscaler-and-vertical-pod-2a441d9ad231
Okrem bežných metrík, ako sú procesor a pamäť, môžete nastaviť prahy na vlastných metrík zo systému Prometheus a pracovať s nimi, ak to považujete za najpresnejšiu definíciu, kedy by ste mali škálovať vašu aplikáciu. Po stabilizácii aplikácie pod zadanú hranicou metriky, HPA začne znižovať počet podov až na minimum replik alebo na stav, kedy bude záťaž vyhovovať zadanému prahu.
6. Nezabúdajte na Node Affinity a Pod Affinity.
Nie všetky uzly sú na rovnakom hardvéri, nie všetkým podom je potrebné vykonávať aplikácie, ktoré vyžadujú intenzívne výpočty. Kubernetes umožňuje nastaviť špecializáciu uzlov a podov pomocou Node Affinity a Pod Affinity.
Ak máte uzly, ktoré sú vhodné na operácie s vysokou intenzitou výpočtov, pre maximálnu efektívnosť je lepšie priradiť aplikácie k príslušným uzlom. Na to použite nodeSelector s označením uzla.
Predpokladajme, že máte dva uzly: jeden s CPUType=HIGHFREQ a s veľkým počtom rýchlych jadier, druhý s MemoryType=HIGHMEMORY veľkým množstvom pamäte a vyššou výkonnosťou. Najjednoduchšie je priradiť nasadenie podu uzlu HIGHFREQ, pridaním do sekcie spec takého selektora:
…
nodeSelector:
	CPUType: HIGHFREQ
Nákladnejší a špecifickejší spôsob, ako to dosiahnuť, je použiť nodeAffinity v poli affinity v sekcii spec. Existujú dve možnosti:
requiredDuringSchedulingIgnoredDuringExecution: prísne nastavenie (plánovač bude nasadzovať pody iba na konkrétnych uzloch (a nikde inde));preferredDuringSchedulingIgnoredDuringExecution: jemné nastavenie (plánovač sa pokúsi nasadiť na konkrétnych nodoch, a ak to nebude možné, pokúsi sa nasadiť na nasledujúcom dostupnom node).
Môžete zadať určitú syntax riadenia značkami uzlov, napríklad, In, NotIn, Exists, DoesNotExist, Gt alebo Lt. Pamätajte však, že zložité metódy v dlhých zoznamoch značiek spomaľujú rozhodovanie v kritických situáciách. Inými slovami, nezložte to.
Ako bolo spomenuté vyššie, Kubernetes umožňuje nastaviť viazanie aktuálnych podov. To znamená, že môžete nastaviť, aby určité pody fungovali spolu s ďalšími podmi v tej istej zóne dostupnosti (aktuálne pre cloudy) alebo nodoch.
V podAffinity polí affinity v sekcii spec sú k dispozícii tie isté polia, čo sa týka nodeAffinity: requiredDuringSchedulingIgnoredDuringExecution a preferredDuringSchedulingIgnoredDuringExecution. Jediný rozdiel je v tom, že matchExpressions pripúta pody k node, na ktorej už beží pod s touto značkou.
Ešte Kubernetes ponúka pole podAntiAffinity, ktoré naopak nepripája pod k node s určitými podmi.
Pokiaľ ide o výrazy nodeAffinity , môžete dať rovnakú radu: snažte sa zachovať jednoduchosť a logiku pravidiel, nesnažte sa preťažiť špecifikáciu podov zložitou sadou pravidiel. Je veľmi jednoduché vytvoriť pravidlo, ktoré nebude zodpovedať podmienkam klastru, čím vytvoríte zbytočné zaťaženie plánovača a znížite celkovú výkonnosť.
7. Taints & Tolerations
Existuje ešte jeden spôsob správy plánovača. Ak máte veľký klaster so stovkami uzlov a tisíckami mikroslužieb, je veľmi ťažké neumožniť určitým podom umiestniť sa na určitých uzloch.
Toto pomáha mechanizmus taints — zakazujúcich pravidiel. Napríklad, v určitých scenároch je možné zakázať určitým uzlom spúšťať u seba pody. Na použitie taint na konkrétnom uzle musíte použiť možnosť taint v kubectl. Zadajte kľúč a hodnotu, a potom taint ako NoSchedule alebo NoExecute:
$ kubectl taint nodes node10 node-role.kubernetes.io/ingress=true:NoScheduleRovnako stojí za zmienku, že mechanizmus taint podporuje tri hlavné efekty: NoSchedule, NoExecute a PreferNoSchedule.
NoScheduleznamená, že pokiaľ v špecifikácii podu nebude zodpovedajúci záznamtolerations, nemôže byť nasadený na node (v tomto príkladenode10).PreferNoSchedule— zjednodušená verziaNoSchedule. V tomto prípade sa plánovač pokúsi nepriraďovať pody, ktoré nemajú zodpovedajúci záznamtolerationsna node, ale to nie je tvrdé obmedzenie. Ak v klastru nebudú zdroje, pody sa začnú nasadzovať na tento uzol.NoExecute— tento efekt spúšťa okamžitú evakuáciu podov, ktoré nemajú zodpovedajúci záznamtolerations.
Zaujímavé je, že toto správanie je možné zrušiť pomocou mechanizmu tolerancií. Je to pohodlné, keď existuje „zakázaný“ uzol a chcete na ňom umiestniť iba infraštruktúrne služby. Ako to dosiahnuť? Povoliť iba tie pody, pre ktoré existuje vhodná tolerancia.
Takto bude vyzerať špecifikácia podu:
spec:
   tolerations:
     - key: "node-role.kubernetes.io\/ingress"
        operator: "Equal"
        value: "true"
        effect: "NoSchedule"
To neznamená, že pri ďalšom redeploy sa pod dostane presne na tento uzol, nie je to mechanizmus Node Affinity a nodeSelector. Ale kombinovaním niekoľkých funkcií môžete dosiahnuť veľmi flexibilné nastavenie plánovača.
8. Nastavte prioritu nasadzovania podov
To, že ste nastavili viazanosť podov na uzly, neznamená, že všetky pody musia byť spracovávané s rovnakou prioritou. Napríklad, môžete chcieť nasadzovať určité pody skôr ako ostatné.
Kubernetes ponúka rôzne spôsoby, ako nastaviť prioritu podov (Pod Priority and Preemption). Nastavenie sa skladá z niekoľkých častí: objektu PriorityClass a opisu poľa priorityClassName v špecifikácii podu. Pozrime sa na príklad:
apiVersion: scheduling.k8s.io\/v1
kind: PriorityClass
metadata:
  name: high-priority
value: 99999
globalDefault: false
description: "Tento priorita triedy by sa mala používať iba pre veľmi dôležité pody"
Vytvárame PriorityClass, nastavujeme mu meno, popis a hodnotu. Čím vyššia value, tým vyššia priorita. Hodnota môže byť akékoľvek 32-bitové celé číslo, menšie alebo rovné 1 000 000 000. Vyššie hodnoty sú rezervované pre kriticky dôležité systémové pody, ktoré zvyčajne nemôžu byť vytlačené. Vytlačenie sa uskutoční iba vtedy, ak nebude mať vysoko priorizovaný pod, kde sa umiestniť, v takom prípade budú evakuované niektoré pody z určitého uzla. Ak je pre vás tento mechanizmus príliš prísny, môžete pridať možnosť preemptionPolicy: Never, a potom nevytláčanie nebude, pod bude stáť prvý v rade a čakať, až plánovač nájde pre neho voľné zdroje.
Ďalej vytvoríme pod, v ktorom uvedieme meno priorityClassName:
apiVersion: v1
kind: Pod
metadata:
  name: static-web
  labels:
    role: myrole
 spec:
  containers:
    - name: web
      image: nginx
      ports:
        - name: web
          containerPort: 80
          protocol: TCP
  priorityClassName: high-priority
Môžete vytvárať neobmedzený počet tried priorít, hoci sa odporúča to nepreháňať (povedzme, obmedziť sa na nízky, stredný a vysoký prioritu).
Takto, v prípade potreby, zvýšite efektivitu nasadenia kritických služieb ako nginx-ingress-controller, coredns a podobne.
9. Optimalizujte ETCD klaster
ETCD môžeme nazvať mozgom celého klastra. Je veľmi dôležité udržiavať túto databázu na vysokej úrovni, pretože od nej závisí rýchlosť operácií v "Kube". Celkom štandardným a zároveň dobrým riešením je mať ETCD klaster na master-node, aby ste mali minimálnu latenciu na kube-apiserver. Ak to nie je možné, umiestnite ETCD čo najbližšie, pričom zabezpečte dobrú prenosovú kapacitu medzi účastníkmi. Taktiež si dávajte pozor na to, koľko nodov z ETCD môže vypadnúť bez poškodenia klastra.
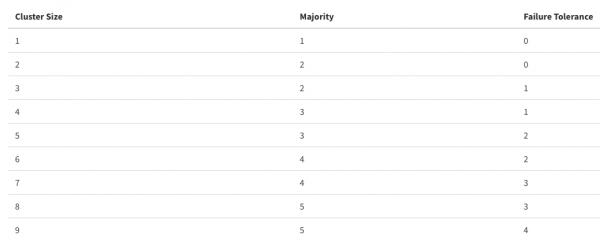
Beriete do úvahy, že nadmerné zvyšovanie počtu účastníkov v klastri môže zvýšiť odolnosť voči výpadkom na úkor výkonu, všetko musí byť v miere.
Pokiaľ ide o nastavenie služby, odporúčaní je málo:
Mať dobrý hardvér na základe veľkosti klastra (môžete si prečítať ).
Upraviť niekoľko parametrov, ak ste rozprestrel klastra medzi pár DC alebo vaša sieť a disky nie sú optimálne (môžete si prečítať ).
Záver
V tomto článku sú uvedené body, ktoré sa naša tím snaží dodržiavať. Nie je to krok za krokom popis ukončenia, ale varianty, ktoré môžu byť užitočné pri optimalizácii nákladov na klaster. Je jasné, že každý klaster je unikátny a riešenia pre nastavenie sa môžu veľmi líšiť, preto by bolo zaujímavé dostať od vás spätnú väzbu: ako sledujete svoj Kubernetes klaster, čím zlepšujete jeho výkon. Podeľte sa o svoje skúsenosti v komentároch, bude zaujímavé ich spoznať.
Zdroj: habr.com
