

Po rokoch používania Kubernetes v produkcii sme nazbierali množstvo zaujímavých príbehov o tom, ako chyby v rôznych systémových komponentoch viedli k nepríjemným a/alebo nepochopiteľným následkom, ktoré ovplyvnili fungovanie kontajnerov a podov. V tomto článku sme pripravili výber niektorých z najbežnejších alebo najzaujímavejších z nich. Aj keď vám nikdy nemusí byť dopriané stretnúť sa s takými situáciami, čítať o podobných krátkych detektívkach — obzvlášť „z prvej ruky“ — je vždy zaujímavé, čo poviete?..
Príbeh 1. Supercronic a zamrznutý Docker
Na jednom z klastrov sme čas od času dostávali „zamrznutý“ Docker, čo narúšalo normálne fungovanie klastru. Pri tom v logoch Dockera sme pozorovali nasledovné
level=error msg="containerd: start init process" error="exit status 2: "runtime/cgo: pthread_create failed: No space left on device
SIGABRT: abort
PC=0x7f31b811a428 m=0

goroutine 0 [idle]:

goroutine 1 [running]:
runtime.systemstack_switch() /usr/local/go/src/runtime/asm_amd64.s:252 fp=0xc420026768 sp=0xc420026760
runtime.main() /usr/local/go/src/runtime/proc.go:127 +0x6c fp=0xc4200267c0 sp=0xc420026768
runtime.goexit() /usr/local/go/src/runtime/asm_amd64.s:2086 +0x1 fp=0xc4200267c8 sp=0xc4200267c0

goroutine 17 [syscall, locked to thread]:
runtime.goexit() /usr/local/go/src/runtime/asm_amd64.s:2086 +0x1

…
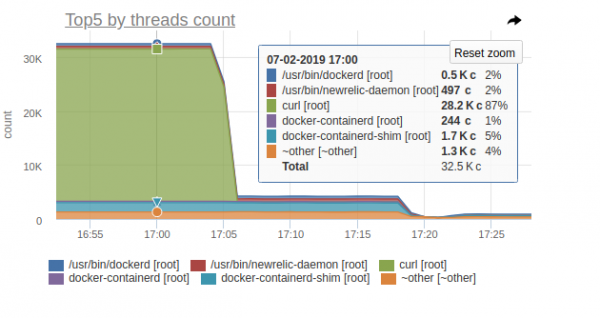
V tejto chybe nás najviac zaujíma správa: pthread_create failed: No space left on device. Rýchle preskúmanie vysvetlilo, že Docker nemôže forkovať proces, čo spôsobovalo občasné „zamrznutie“.
V monitoringu situácia vyzerá takto:
Podobná situácia sa pozoruje aj na iných uzloch:
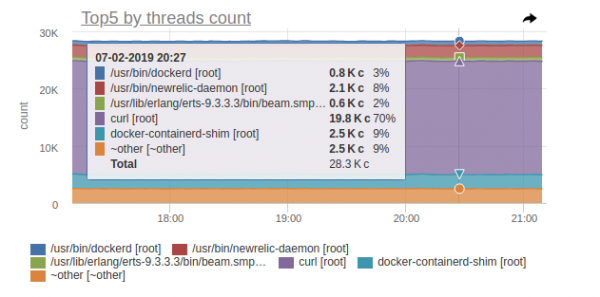
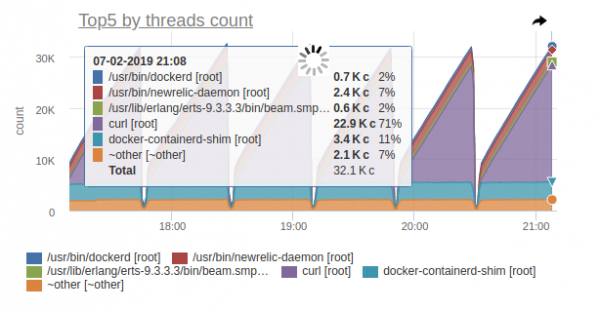
Na týchto uzloch vidíme:
root@kube-node-1 ~ # ps auxfww | grep curl -c
19782
root@kube-node-1 ~ # ps auxfww | grep curl | head
root     16688  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
root     17398  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
root     16852  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
root      9473  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
root      4664  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
root     30571  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
root     24113  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
root     16475  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
root      7176  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
root      1090  0.0  0.0      0     0 ?        Z    Feb06   0:00      |       _ [curl]
Ukázalo sa, že takéto správanie je následkom práce podu s (nástroj na Go, ktorý používame na spúšťanie cronúloh v pode):
 _ docker-containerd-shim 833b60bb9ff4c669bb413b898a5fd142a57a21695e5dc42684235df907825567 /var/run/docker/libcontainerd/833b60bb9ff4c669bb413b898a5fd142a57a21695e5dc42684235df907825567 docker-runc
|   _ /usr/local/bin/supercronic -json /crontabs/cron
|       _ /usr/bin/newrelic-daemon --agent --pidfile /var/run/newrelic-daemon.pid --logfile /dev/stderr --port /run/newrelic.sock --tls --define utilization.detect_aws=true --define utilization.detect_azure=true --define utilization.detect_gcp=true --define utilization.detect_pcf=true --define utilization.detect_docker=true
|       |   _ /usr/bin/newrelic-daemon --agent --pidfile /var/run/newrelic-daemon.pid --logfile /dev/stderr --port /run/newrelic.sock --tls --define utilization.detect_aws=true --define utilization.detect_azure=true --define utilization.detect_gcp=true --define utilization.detect_pcf=true --define utilization.detect_docker=true -no-pidfile
|       _ [newrelic-daemon]
|       _ [curl]
|       _ [curl]
|       _ [curl]
…
Problém je v tom, že keď úloha beží v supercronic, proces, ktorý je ním vytvorený, nemôže správne skončiť, stáva sa .
Poznámka: Presnejšie povedané, procesy sú vytvárané úlohami cron, avšak supercronic nie je init systém a nemôže „adoptovať“ procesy, ktoré vytvorili jeho deti. Pri signáloch SIGHUP alebo SIGTERM sa tieto prenášajú na vytvorené procesy, čím zostávajú dcérske procesy v stave zombíka. Viac o tom si môžete prečítať napríklad v .
Existuje niekoľko spôsobov, ako vyriešiť problémy:
- Ako dočasné obídenie — zvýšiť počet PID v systéme v jeden čas:
/proc/sys/kernel/pid_max (since Linux 2.5.34) This file specifies the value at which PIDs wrap around (i.e., the value in this file is one greater than the maximum PID). PIDs greater than this value are not allo‐ cated; thus, the value in this file also acts as a system-wide limit on the total number of processes and threads. The default value for this file, 32768, results in the same range of PIDs as on earlier kernels - Alebo spustiť úlohy v supercronic nie priamo, ale pomocou rovnakého , ktorý dokáže správne ukončiť procesy a nevyvolávať zombie.
Príbeh 2. „Zombíci“ pri odstraňovaní cgroup
Kubelet začal spotrebovávať veľké množstvo CPU:
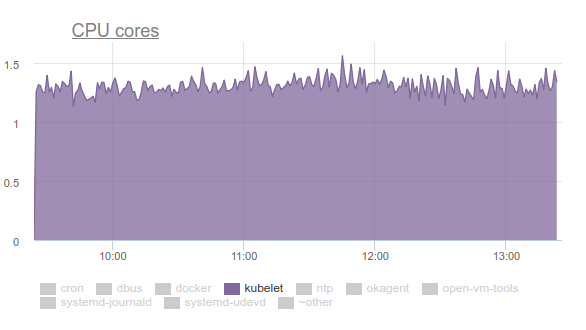
To sa nikomu nepáči, a tak sme sa vyzbrojili a začali sme sa zaoberať problémom. Závery vyšetrovania sa ukázali ako nasledujúce:
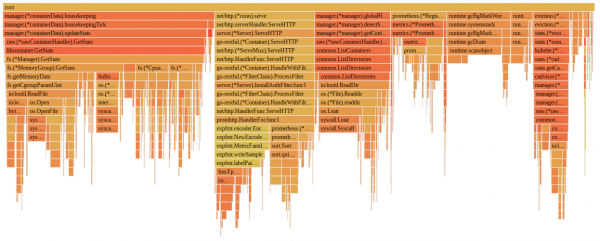
- Kubelet trávi viac ako tretinu procesorového času získavaním údajov o pamäti zo všetkých cgroup:

- V mailingliste vývojárov jadra nájdete . Ak by sme to zhrnuli, podstata spočíva v tom, že rôzne tmpfs súbory a iné podobné veci sa z prostriedkov systému neodstraňujú úplne pri odstraňovaní cgroup — zostávajú takzvané zombíci. Časom sa síce vymažú z page cache, avšak na serveri je veľa pamäte a jadro nevidí dôvod, prečo strácať čas ich odstraňovaním. Preto naďalej pribúdajú. Prečo sa toto vôbec deje? Je to server s cron úlohami, ktorý neustále vytvára nové joby a s nimi — nové pod. Tak sa pre kontajnery vytvárajú nové cgroup, ktoré sa čoskoro odstraňujú.
- Prečo cAdvisor v kubelete spotrebuje toľko času? Je to ľahko viditeľné jednoduchým vykonaním
time cat /sys/fs/cgroup/memory/memory.stat. Ak na zdravom stroji operácia trvá 0,01 sekundy, na problémovom cron02 trvá 1,2 sekundy. Všetko je spôsobené tým, že cAdvisor veľmi pomaly číta údaje zo sysfs a pokúša sa zohľadniť použitú pamäť v zombie cgroups. - Aby sme násilne odstránili zombie, skúsili sme vyčistiť cache, ako odporúčali v LKML:
sync; echo 3 > /proc/sys/vm/drop_caches, — ale jadro sa ukázalo ako zložitejšie a zhaslo stroj.
Čo robiť? Problém sa dá opraviť (, podrobnosti nájdete v ) aktualizovaním jadra Linux na verziu 4.16.
Príbeh 3. Systemd a jeho mount
Opäť kubelet spotrebováva príliš veľa prostriedkov na niektorých uzloch, ale tentoraz — už pamäte:
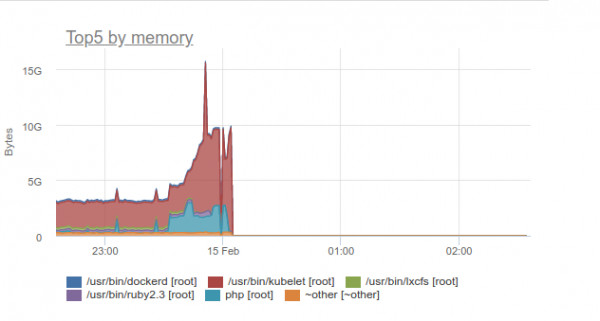
Ukázalo sa, že existuje problém v systemd používanom v Ubuntu 16.04, ktorý vzniká pri správe mountov vytváraných na pripojenie subPath z ConfigMapov alebo secretov. Po ukončení práce podu služba systemd a jej pomocný mount zostávajú v systéme. Postupom času sa ich hromadí obrovské množstvo. Na túto tému existujú dokonca issues:
- ;
- .
… v poslednom z nich sa odkazuje na PR v systemd: (issue v systemd — ).
Problém už nie je v Ubuntu 18.04, ale ak chcete naďalej používať Ubuntu 16.04, môže sa vám hodiť naše riešenie k tomu.
Takže sme vytvorili nasledujúci DaemonSet:
---
apiVersion: extensions/v1beta1
kind: DaemonSet
metadata:
  labels:
    app: systemd-slices-cleaner
  name: systemd-slices-cleaner
  namespace: kube-system
spec:
  updateStrategy:
    type: RollingUpdate
  selector:
    matchLabels:
      app: systemd-slices-cleaner
  template:
    metadata:
      labels:
        app: systemd-slices-cleaner
    spec:
      containers:
      - command:
        - /usr/local/bin/supercronic
        - -json
        - /app/crontab
        Image: private-registry.org/systemd-slices-cleaner/systemd-slices-cleaner:v0.1.0
        imagePullPolicy: Always
        name: systemd-slices-cleaner
        resources: {}
        securityContext:
          privileged: true
        volumeMounts:
        - name: systemd
          mountPath: /run/systemd/private
        - name: docker
          mountPath: /run/docker.sock
        - name: systemd-etc
          mountPath: /etc/systemd
        - name: systemd-run
          mountPath: /run/systemd/system/
        - name: lsb-release
          mountPath: /etc/lsb-release-host
      imagePullSecrets:
      - name: antiopa-registry
      priorityClassName: cluster-low
      tolerations:
      - operator: Exists
      volumes:
      - name: systemd
        hostPath:
          path: /run/systemd/private
      - name: docker
        hostPath:
          path: /run/docker.sock
      - name: systemd-etc
        hostPath:
          path: /etc/systemd
      - name: systemd-run
        hostPath:
          path: /run/systemd/system/
      - name: lsb-release
        hostPath:
          path: /etc/lsb-release
… a v ňom sa používa takýto skript:
#!/bin/bash

# we will work only on xenial
hostrelease="/etc/lsb-release-host"
test -f ${hostrelease} && grep xenial ${hostrelease} > /dev/null || exit 0

# sleeping max 30 minutes to dispense load on kube-nodes
sleep $((RANDOM % 1800))

stoppedCount=0
# counting actual subpath units in systemd
countBefore=$(systemctl list-units | grep subpath | grep "run-" | wc -l)
# let's go check each unit
for unit in $(systemctl list-units | grep subpath | grep "run-" | awk '{print $1}'); do
  # finding description file for unit (to find out docker container, who born this unit)
  DropFile=$(systemctl status ${unit} | grep Drop | awk -F': ' '{print $2}')
  # reading uuid for docker container from description file
  DockerContainerId=$(cat ${DropFile}/50-Description.conf | awk '{print $5}' | cut -d/ -f6)
  # checking container status (running or not)
  checkFlag=$(docker ps | grep -c ${DockerContainerId})
  # if container not running, we will stop unit
  if [[ ${checkFlag} -eq 0 ]]; then
    echo "Stopping unit ${unit}"
    # stoping unit in action
    systemctl stop $unit
    # just counter for logs
    ((stoppedCount++))
    # logging current progress
    echo "Stopped ${stoppedCount} systemd units out of ${countBefore}"
  fi
done
… a spúšťa sa každých 5 minút pomocou už spomenutého supercronic. Jeho Dockerfile vyzerá takto:
FROM ubuntu:16.04
COPY rootfs /
WORKDIR /app
RUN apt-get update &&
    apt-get upgrade -y &&
    apt-get install -y gnupg curl apt-transport-https software-properties-common wget
RUN add-apt-repository "deb [arch=amd64] https://download.docker.com/linux/ubuntu xenial stable" &&
    curl -fsSL https://download.docker.com/linux/ubuntu/gpg | apt-key add - &&
    apt-get update &&
    apt-get install -y docker-ce=17.03.0*
RUN wget https://github.com/aptible/supercronic/releases/download/v0.1.6/supercronic-linux-amd64 -O
    /usr/local/bin/supercronic && chmod +x /usr/local/bin/supercronic
ENTRYPOINT ["/bin/bash", "-c", "/usr/local/bin/supercronic -json /app/crontab"]
Príbeh 4. Konkurenčnosť pri plánovaní podov
Bolo si všimnuté, že: ak máme na uzle umiestnený pod a jeho obraz sa sťahuje veľmi dlho, iný pod, ktorý "narazí" na ten istý uzol, jednoducho nezačne sťahovať obraz nového podu. Namiesto toho čaká, kým sa sťahuje obraz predchádzajúceho podu. V dôsledku toho sa pod, ktorý už bol naplánovaný a ktorého obraz by mohol byť stiahnutý len za minútu, ocitne na dlhší čas v stave containerCreating.
V udalostiach bude zhruba nasledovné:
Normal Pulling 8m kubelet, ip-10-241-44-128.ap-northeast-1.compute.internal pulling image "registry.example.com/infra/openvpn/openvpn:master"Z toho vyplýva, že jediný obraz z pomalého registra môže zablokovať nasadenie na uzol.
Žiaľ, možností na vyriešenie situácie nie je veľa:
- Snažte sa používať svoj Docker Registry priamo v klastri alebo priamo s klastrom (napríklad GitLab Registry, Nexus a pod.);
- Využite takéto utilitky, ako sú .
História 5. Zaseknutie uzlov pri nedostatku pamäte
Počas prevádzky rôznych aplikácií sme sa tiež stretli so situáciou, keď uzol úplne prestal byť dostupný: neodpovedá SSH, všetky monitoračné démony sa odpoja a v logoch potom nič (alebo takmer nič) anomálne nie je.
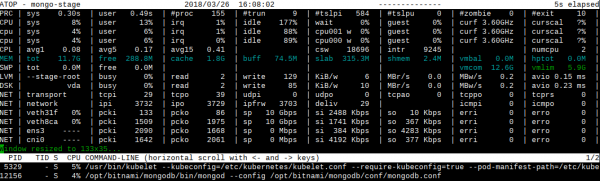
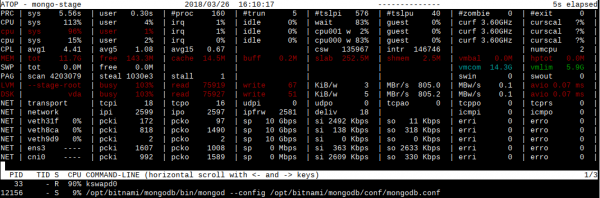
Ukážem to na obrázkoch na príklade jedného uzla, kde fungovala MongoDB.
Takto vyzerá atop do havárie:
A takto — po havárie:
V monitorovaní sa tiež pozoruje prudký skok, pri ktorom uzol prestane byť dostupný:
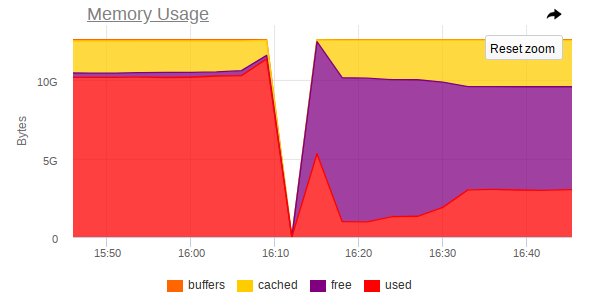
Takto je vidieť z screenshotov, že:
- Operačná pamäť na zariadení sa blíži ku koncu;
- Pozoruje sa prudký skok v spotrebe operačnej pamäte, po ktorom sa okamžite odpojí prístup k celému zariadeniu;
- Na Mongo prichádza veľká úloha, ktorá núti proces DBMS používať viac pamäte a aktívne čítať z disku.
Ukazuje sa, že ak v Linuxe dôjde k vyčerpaniu voľnej pamäte (nastáva memory pressure) a swap nie je, do príchod OOM killer-a môže spôsobiť rovnováhu medzi sťahovaním stránok do page cache a ich zápisom späť na disk. O toto sa stará kswapd, ktorý odvážne uvoľňuje čo najviac stránok pamäte pre následné prerozdelenie.
Žiaľ, pri veľkom zaťažení vstupu/výstupu spolu s malým množstvom voľnej pamäte, kswapd sa stáva fľaškovým hrdlom celého systému, pretože na ňom závisia všetky alokácie (page faults) stránok pamäte v systéme. To môže pokračovať veľmi dlho, ak procesy nechcú viac používať pamäť a zafixujú sa na samom okraji OOM-killer bezdná.
Je oprávnená otázka: prečo OOM killer prichádza tak neskoro? V jeho aktuálnej iterácii je OOM killer veľmi hlúpy: zabije proces len vtedy, keď zlyhá pokus o alokáciu stránky pamäte, t.j. ak page fault prebehne s chybou. To sa dlho nedeje, pretože kswapd odvážne uvoľňuje stránky pamäte, zrušujúc page cache (v podstate celý diskový I/O v systéme) späť na disk. Podrobnejšie, s popisom krokov, potrebných na odstránenie podobných problémov v jadre, si môžete prečítať .
Toto správanie s jadrom Linux 4.6+.
História 6. Pod’y visia v stave Pending
V niektorých klastroch, kde skutočne funguje veľa pod’ov, sme začali pozorovať, že väčšina z nich dlho „visí“ v stave Pending, aj keď samotné Docker kontajnery už bežia na uzloch a môžeme s nimi manuálne pracovať.
Pri tom v describe nie je nič zlé:
  Typ      Dôvod                     Vek                  Z From                    Správa
  ----    ------                     ----                 ----                     -------
  Normálny  Plánované                1m                  default-scheduler        Úspešne priradené sphinx-0 k ss-dev-kub07
  Normálny  ÚspešnéPripojenieObjemu  1m                  attachdetach-controller  Úspešne pripojený objem "pvc-6aaad34f-ad10-11e8-a44c-52540035a73b"
  Normálny  ÚspešnéMontovanieObjemu   1m                  kubelet, ss-dev-kub07    Úspešne nastavené montovanie objemu "sphinx-config"
  Normálny  ÚspešnéMontovanieObjemu   1m                  kubelet, ss-dev-kub07    Úspešne nastavené montovanie objemu "default-token-fzcsf"
  Normálny  ÚspešnéMontovanieObjemu   49s (x2 za 51s)  kubelet, ss-dev-kub07    Úspešne nastavené montovanie objemu "pvc-6aaad34f-ad10-11e8-a44c-52540035a73b"
  Normálny  Stiahnuté                 43s                kubelet, ss-dev-kub07    Obraz kontajnera "registry.example.com/influx/sphinx-exporter/sphinx-indexer:v1" už je prítomný na strojov
  Normálny  Vytvorené                 43s                kubelet, ss-dev-kub07    Kontajner bol vytvorený
  Normálny  Spustené                  43s                kubelet, ss-dev-kub07    Kontajner bol spustený
  Normálny  Stiahnuté                 43s                kubelet, ss-dev-kub07    Obraz kontajnera "registry.example.com/influx/sphinx/sphinx:v1" už je prítomný na strojov
  Normálny  Vytvorené                 42s                kubelet, ss-dev-kub07    Kontajner bol vytvorený
  Normálny  Spustené                  42s                kubelet, ss-dev-kub07    Kontajner bol spustený
Po preskúmaní sme dospeli k názoru, že kubelet jednoducho nestíha zaslať API serveru všetky informácie o stave pod’ov, liveness/readiness testoch.
A po preskúmaní help sme našli nasledujúce parametre:
--kube-api-qps - QPS na použitie pri komunikácii s Kubernetes apiserverom (predvolené 5)
--kube-api-burst  - Burst na použitie pri komunikácii s Kubernetes apiserverom (predvolené 10)
--event-qps - Ak > 0, obmedzuje počet vytvorení udalostí za sekundu na túto hodnotu. Ak 0, neobmedzené. (predvolené 5)
--event-burst - Maximálna veľkosť burzových záznamov udalostí, dočasne umožňuje záznamom udalostí burzovať k tejto veľkosti, pričom stále nepresahujú event-qps. Používa sa iba ak --event-qps > 0 (predvolené 10)
--registry-qps - Ak > 0, obmedzuje QPS priťahovania registru na túto hodnotu.
--registry-burst - Maximálna veľkosť burzových ťahaní, dočasne umožňuje prítahy burzová k tejto veľkosti, pričom stále nepresahujú registry-qps. Používa sa iba ak --registry-qps > 0 (predvolené 10)
Ako vidno, predvolené hodnoty – sú dosť malé, a v 90 % pokrývajú všetky potreby… Avšak v našom prípade to bolo nedostatočné. Preto sme nastavili tieto hodnoty:
--event-qps=30 --event-burst=40 --kube-api-burst=40 --kube-api-qps=30 --registry-qps=30 --registry-burst=40… a reštartovali sme kubelet’y, po čom sme na grafoch prístupu k API serveru videli nasledujúci obraz:
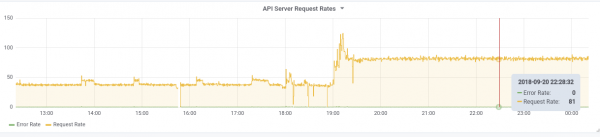
… a áno, všetko začalo letieť!
P.S.
Chcem sa poďakovať mnohým inžinierom našej spoločnosti za pomoc pri zbieraní chýb a príprave článku, a najmä kolegovi z nášho R&D tímu Andrejovi Klimentievovi ().
P.P.S.
Prečítajte si tiež na našom blogu:
- «».
- Cyklus tipov a trikov Kubernetes:
- «»;
- «»;
- «»;
- «».
Zdroj: habr.com
