

Toto je mýtus, dosť rozšírený v oblasti serverového hardvéru. V praxi sú však hyperkonvergované riešenia (keď je všetko v jednom) potrebné na rôzne účely. Historicky sa ukázalo, že prvé architektúry boli vyvinuté spoločnosťami Amazon a Google pre svoje služby. Vtedy bola myšlienka vytvoriť výpočtovú farmu z rovnakých uzlov, kde každý uzol má vlastné disky. Toto všetko bolo spojené programom na systémovú správu (hypervízorom) a rozdelené na virtuálne stroje. Hlavná úloha — minimum úsilia na údržbu jedného uzla a minimum problémov pri škálovaní: jednoducho ste kúpili ďalších tisíc alebo dvoch podobných serverov a pripojili ich vedľa seba. V praxi sú to ojedinelé prípady a omnoho častejšie ide o menší počet uzlov a trochu inú architektúru.
Pozitívum však ostáva rovnaké — neuveriteľná jednoduchosť škálovania a správy. Negatívum — rôzne úlohy rôzne spotrebúvajú zdroje, a niekde môže byť veľa lokálnych diskov, inde málo operačnej pamäte a tak ďalej, t. j. pri rôznych typoch úloh bude klesať využitie zdrojov.
Vychádzalo to tak, že platíte o 10–15% viac za pohodlie nastavenia. To spôsobilo mýtus v nadpise. Dlho sme hľadali, kde by sa technológia dala optimálne aplikovať, a našli sme ju. Ide o to, že Cisco nemalo vlastné úložné systémy, ale chceli zaplniť celý serverový trh. A vytvorili Cisco Hyperflex — riešenie s lokálnymi úložiskami na uzloch.
A z toho nakoniec vzniklo veľmi dobré riešenie pre záložné dátové centrá (Disaster Recovery). Prečo a ako — teraz vám to poviem. A ukážem testy klastru.
Kde je to potrebné
Hyperkonvergencia — to je:
- Prenos diskov do výpočtových uzlov.
- Plnohodnotná integrácia subsystému ukladania dát so subsystémom virtualizácie.
- Prenos/integrácia so sieťovým subsystémom.
Takéto prepojenie umožňuje realizovať množstvo funkcií úložných systémov na úrovni virtualizácie a všetko z jedného ovládacieho okna.
V našej spoločnosti sú veľmi žiadané projekty na navrhovanie záložných dátových centier, a často sa volí práve hyperkonvergované riešenie kvôli množstvu možností replikácie (až po metropolitné klastre) priamo z krabice.
V prípade záložných dátových centier sa zvyčajne hovorí o vzdialenom objekte na mieste na druhej strane mesta alebo dokonca v inom meste. Umožňuje obnoviť kritické systémy v prípade čiastočného alebo úplného zlyhania hlavného dátového centra. Údaje sú tam neustále replikované z produkcie, a táto replikácia môže prebiehať na úrovni aplikácie alebo na úrovni blokového zariadenia (úložné systémy).
Preto teraz poviem o usporiadaní systému a testoch, a potom o niekoľkých scenároch reálneho využitia s údajmi o úsporách.
Testy
Náš exemplár pozostáva zo štyroch serverov, z ktorých každý má 10 SSD diskov s kapacitou 960 GB. Je tam vyhradený disk na cache operácií zápisu a uchovávania servisnej virtuálnej mašiny. Samotné riešenie je štvrtá verzia. Prvá bola otvorene nedokonalá (súd podľa recenzií), druhá bola ešte nedokonalá, tretia už dostatočne stabilná a túto môžeme nazvať vydaním po ukončení beta testovania na širokej verejnosti. Počas testovania som nezaznamenal žiadne problémy, všetko funguje ako hodinky.
Zmeny vo v4Opravených množstvo chýb.
Pôvodne platforma mohla pracovať iba s hypervízorom VMware ESXi a podporovala len malé množstvo uzlov. Proces nasadenia tiež nie vždy končil úspešne, niektoré kroky bolo potrebné reštartovať, boli problémy s aktualizáciou zo starších verzií, údaje v GUI sa nezobrazovali vždy správne (aj keď ani teraz nie som nadšený z zobrazenia grafov výkonnosti), niekedy sa vyskytli problémy na rozhraní s virtualizáciou.
Teraz sú všetky detské choroby opravené, HyperFlex zvláda aj ESXi, aj Hyper-V, navyše je možné:
- Vytvorenie rozšíreného klastru.
- Vytvorenie klastru pre kancelárie bez použitia Fabric Interconnect, od dvoch do štyroch uzlov (kupujeme iba servery).
- Možnosť práce s externými úložnými systémami.
- Podpora kontajnerov a Kubernetes.
- Vytvorenie zón dostupnosti.
- Integrácia s VMware SRM, ak vstavaná funkcia nie je dostatočná.
Architektúra sa výrazne nelíši od riešení hlavných konkurentov, kolo nevymýšľali. Všetko funguje na platforme virtualizácie VMware alebo Hyper-V. Hardvér je umiestnený na serveroch vlastného vývoja Cisco UCS. Sú ľudia, ktorí nenávidia platformu za relatívnu zložitosti počiatočného nastavenia, množstvo tlačidiel, netriviálny systém šablón a závislostí, ale sú aj takí, ktorí prenikli do zenového stavu, prežili myšlienku a už nechcú pracovať s inými servermi.
Budeme sa zaoberať konkrétne riešením pre VMware, pretože riešenie bolo pôvodne vytvorené preň a má väčšiu funkčnosť, Hyper-V bolo dodatočne upravené, aby nezostalo pozadu za konkurentmi a aby splnilo očakávania trhu.
Existuje klaster serverov naplnených diskami. Sú disky na ukladanie údajov (SSD alebo HDD – podľa vášho vkusu a potrieb), existuje jeden SSD disk na vyrovnávanie vyrovnávacej pamäte. Pri zápise údajov na datastore sa údaje ukladajú na vyrovnávacej pamäti (vyhradený SSD disk a RAM služobnej VM). Paralelne sa blok údajov posiela na nody v klastre (počet nodov závisí od faktora replikácie klastre). Po potvrdení zo všetkých nodov o úspešnom zápise sa potvrdenie zápisu posiela hypervízoru a ďalej – do VM. Zápis údajov sa na pozadí deduplikuje, komprimuje a zapisuje na úložné disky. Pri tom sa na úložné disky vždy zapisuje veľký blok a sekvenčne, čo znižuje zaťaženie úložných diskov.
Deduplicitácia a kompresia sú neustále zapnuté a nemožno ich vypnúť. Čítanie údajov prebieha priamo z úložných diskov alebo z pamäte RAM. Ak sa používa hybridná konfigurácia, čítanie sa tiež cacheuje na SSD disku.
Údaje nie sú viazané na aktuálnu polohu virtuálneho stroja a rozdeľujú sa rovnomerne medzi nody. Tento prístup umožňuje rovnomerne zaťažiť všetky disky a sieťové roz interfaces. Zjavný nedostatok je, že nemôžeme maximálne znížiť latenciu čítania, pretože nie je zaručená lokálna dostupnosť údajov. Ale považujem to za zanedbateľnú obetu v porovnaní so získanými výhodami. O to viac latencie v sieti dosiahli také hodnoty, že prakticky neovplyvňujú celkový výsledok.
Za celú logiku fungovania diskového subsystému zodpovedá špeciálna servisná VM Cisco HyperFlex Data Platform controller, ktorá sa vytvára na každom uzle úložiska. V našej konfigurácii bola servisnej VM pridelená osem vCPU a 72 GB RAM, čo nie je málo. Pripomínam, že samotný hostiteľ má k dispozícii 28 fyzických jadier a 512 GB RAM.
Servisná VM má prístup k fyzickým diskom priamo pomocou prenosu SAS-ovzora do VM. Komunikácia s hypervízorom prebieha prostredníctvom špeciálneho modulu IOVisor, ktorý zachytáva operácie vstupu-výstupu, a pomocou agenta, ktorý umožňuje odosielať príkazy do API hypervízora. Agent zodpovedá za prácu s HyperFlex snímkami a klonmi.
V hypervízore sú diskové zdroje pripojené ako NFS- alebo SMB-zdielanie (závisí od typu hypervízora, hádajte, ktorý je kde). A pod kapotou je to distribuovaný súborový systém, ktorý umožňuje pridať funkcie dospelých plnohodnotných SCLD: tenké prideľovanie objemov, kompresiu a deduplikáciu, snímky pomocou technológie Redirect-on-Write, synchronnú/asynchrónnu replikáciu.
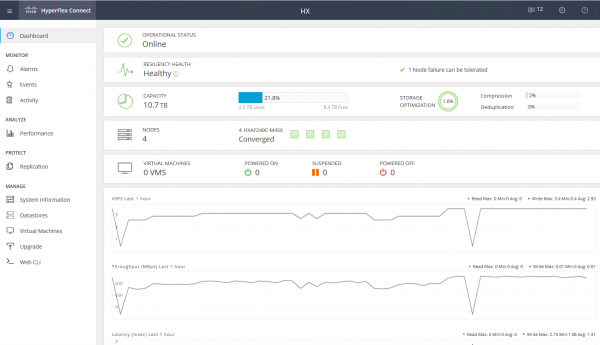
Servisná VM poskytuje prístup k WEB-rozhraniu správy subsystému HyperFlex. Existuje integrácia s vCenter a väčšina každodenných úloh môže byť vykonaná z neho, ale datastory je napríklad pohodlnejšie vytvárať z samostatného webového rozhrania, ak ste už prešli na rýchle HTML5 rozhranie, alebo používať plnohodnotného Flash klienta s plnou integráciou. V servisnej webke si môžete pozrieť výkon a podrobny stav systému.
Existuje aj iný typ uzlov v klastri – výpočtové uzly. Môžu to byť stojanové alebo blade servery bez zabudovaných diskov. Na týchto serveroch môžete spúšťať VM, ktorých dáta sú uložené na serveroch s diskami. Z hľadiska prístupu k dátam nie je rozdiel medzi typmi uzlov, pretože architektúra predpokladá abstrakciu od fyzickej polohy dát. Maximálny pomer výpočtových uzlov a uzlov úložiska je 2:1.
Použitie výpočtových uzlov zvyšuje flexibilitu pri škálovaní zdrojov klastra: nemusíme nevyhnutne dokupovať uzly s diskami, ak máme potrebu iba po CPU/RAM. Navyše môžeme pridať blade košík a získať úsporu na umiestnení serverov v racku.
Ako výsledok máme hyperkonvergentnú platformu s nasledujúcimi funkciami:
- Až 64 uzlov v klastri (až 32 uzlov úložiska).
- Minimálny počet uzlov v klastri je tri (dva pre Edge klaster).
- Mechanizmus redundancie dát: zrkadlenie s faktorom replikácie 2 a 3.
- Metro-klaster.
- Asynchrónna replikácia VM na iný HyperFlex klaster.
- Orchestrácia preklapania VM do vzdialeného dátového centra.
- Nativne snapshoty technológie Redirect-on-Write.
- Až 1 PB užitočného priestoru pri faktore replikácie 3 a bez odpočtu deduplikácie. Faktor replikácie 2 neberieme do úvahy, pretože to nie je možnosť pre vážny predaj.
Ďalšou obrovskou výhodou je jednoduchosť správy a nasadenia. Všetky komplikácie konfigurácie serverov UCS preberá špecializovaná VM pripravená inžiniermi Cisco.
Konfigurácia testovacej stanice:
- 2 x Cisco UCS Fabric Interconnect 6248UP ako riadiaci klaster a sieťové komponenty (48 portov pracujúcich v režime Ethernet 10G/FC 16G).
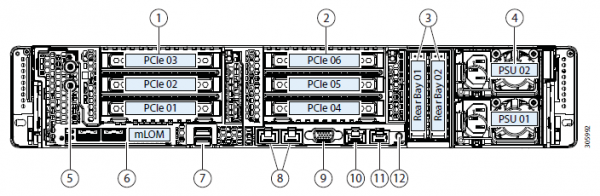
- Štyri servery Cisco UCS HXAF240 M4.
Špecifikácie serverov:
CPU
2 x Intel ® Xeon ® E5-2690 v4
RAM
16 x 32GB DDR4-2400-MHz RDIMM/PC4-19200/dual rank/x4/1.2v
Sieť
UCSC-MLOM-CSC-02 (VIC 1227). 2 porty 10G Ethernet
Storage HBA
Cisco 12G Modular SAS Pass through Controller
Storage Disks
1 x SSD Intel S3520 120 GB, 1 x SSD Samsung MZ-IES800D, 10 x SSD Samsung PM863a 960 GB
Viac možností konfiguráciíOkrem vybraného hardvéru sú aktuálne k dispozícii nasledujúce možnosti:
- HXAF240c M5.
- Jeden alebo dva CPU od Intel Silver 4110 po Intel Platinum I8260Y. K dispozícii je druhá generácia.
- 24 slotov pamäte, moduly od 16 GB RDIMM 2600 po 128 GB LRDIMM 2933.
- Od 6 do 23 diskov pre dáta, jeden cache disk, jeden systémový a jeden boot disk.
Capacity Drives
- HX-SD960G61X-EV 960GB 2.5 Inch Enterprise Value 6G SATA SSD (1X endurance) SAS 960 GB.
- HX-SD38T61X-EV 3.8TB 2.5 inch Enterprise Value 6G SATA SSD (1X endurance) SAS 3.8 TB.
- Caching Drives
- HX-NVMEXPB-I375 375GB 2.5 inch Intel Optane Drive, Extreme Perf & Endurance.
- HX-NVMEHW-H1600* 1.6TB 2.5 inch Ent. Perf. NVMe SSD (3X endurance) NVMe 1.6 TB.
- HX-SD400G12TX-EP 400GB 2.5 inch Ent. Perf. 12G SAS SSD (10X endurance) SAS 400 GB.
- HX-SD800GBENK9** 800GB 2.5 inch Ent. Perf. 12G SAS SED SSD (10X endurance) SAS 800 GB.
- HX-SD16T123X-EP 1.6TB 2.5 inch Enterprise performance 12G SAS SSD (3X endurance).
System / Log Drives
- HX-SD240GM1X-EV 240GB 2.5 inch Enterprise Value 6G SATA SSD (Requires upgrade).
Boot Drives
- HX-M2-240GB 240GB SATA M.2 SSD SATA 240 GB.
Pripojenie k sieti cez 40G, 25G alebo 10G porty Ethernet.
Ako FI môžu byť HX-FI-6332 (40G), HX-FI-6332-16UP (40G), HX-FI-6454 (40G/100G).
Samotný test
Na testovanie diskovej subsystémy som použil HCIBench 2.2.1. Je to bezplatná utilita, ktorá umožňuje automatizovať generovanie záťaže z viacerých virtuálnych strojov. Záťaž je generovaná bežným fio.
Náš klaster pozostáva zo štyroch uzlov, faktor replikácie 3, všetky disky Flash.
Na testovanie som vytvoril štyri dátové sklady a osem virtuálnych strojov. Pri testoch zápisu sa predpokladá scenár, kde cache disk nie je preplnený.
Výsledky testov sú nasledovné:
100 % Čítanie 100 % Náhodné
0 % Čítanie 100% Náhodné
Blok/hĺbka frontu
128
256
512
1024
2048
128
256
512
1024
2048
4K
0,59 ms 213804 IOPS
0,84 ms 303540 IOPS
1,36ms 374348 IOPS
2,47 ms 414116 IOPS
4,86ms 420180 IOPS
2,22 ms 57408 IOPS
3,09 ms 82744 IOPS
5,02 ms 101824 IOPS
8,75 ms 116912 IOPS
17,2 ms 118592 IOPS
8K
0,67 ms 188416 IOPS
0,93 ms 273280 IOPS
1,7 ms 299932 IOPS
2,72 ms 376484 IOPS
5,47 ms 373176 IOPS
3,1 ms 41148 IOPS
4,7 ms 54396 IOPS
7,09 ms 72192 IOPS
12,77 ms 80132 IOPS
16K
0,77 ms 164116 IOPS
1,12 ms 228328 IOPS
1,9 ms 268140 IOPS
3,96 ms 258480 IOPS
3,8 ms 33640 IOPS
6,97 ms 36696 IOPS
11,35 ms 45060 IOPS
32K
1,07 ms 119292 IOPS
1,79 ms 142888 IOPS
3,56 ms 143760 IOPS
7,17 ms 17810 IOPS
11,96 ms 21396 IOPS
64K
1,84 ms 69440 IOPS
3,6 ms 71008 IOPS
7,26 ms 70404 IOPS
11,37 ms 11248 IOPS
Tučné hodnoty označujú miesta, po ktorých už nezaznamenávame zlepšenie výkonu, niekedy vidíme dokonca degradáciu. Je to spôsobené obmedzením v kapacite siete/kontrolórov/ diskov.
- Sekvenčné čítanie 4432 MB/s.
- Sekvenčný zápis 804 MB/s.
- Pri zlyhaní jedného kontroléra (zlyhanie virtuálneho stroja alebo hostiteľa) sa výkon zníži na polovicu.
- Pri zlyhaní disku úložiska sa výkon zníži o 1/3. Obnovovanie disku spotrebuje 5 % zdrojov každého kontroléra.
Pri malom bloku sa dostávame na výkon kontroléra (virtuálny stroj), jeho CPU je zaťažené na 100 %, pri zvýšení bloku sa dostávame na hranicu priepustnosti portov. 10 Gbit/s nestačí na maximálne využitie potenciálu systému AllFlash. Bohužiaľ, testovanie na 40 Gbit/s nie je možné kvôli parametrom poskytnutého demonstračného stánku.
Na základe mojich dojmom z testov a štúdia architektúry, vďaka algoritmu, ktorý rozdeľuje dáta medzi všetkými hostiteľmi, získavame škálovateľný predvídateľný výkon, ale tento aspekt je tiež obmedzením pri čítaní, pretože z lokálnych diskov by sme mohli dosiahnuť ešte viac, tu môže pomôcť výkonnejšia sieť, napríklad sú dostupné FI na 40 Gbit/s.
Jedno disk na vyrovnávaciu pamäť a deduplikáciu môže byť obmedzením, v skutočnosti v tomto stánku môžeme zapisovať na štyri SSD disky. Bolo by vynikajúce mať možnosť zvýšiť počet vyrovnávacích diskov a vidieť rozdiel.
Reálne využitie
Na organizáciu záložného DR centra môžeme využiť dva prístupy (umiestnenie zálohy na vzdialenej lokalite nezohľadňujeme):
- Aktívny-Passívny. Všetky aplikácie sú umiestnené v hlavnom dátovom centre. Replikácia je synchronná alebo asynchronná. V prípade zlyhania hlavného dátového centra je potrebné aktivovať záložné. Toto je možné vykonať manuálne/skriptami/aplikáciami na orchestráciu. Tu dosiahneme RPO, ktorý je porovnateľný s frekvenciou replikácie, a RTO závisí od reakcie a zručností administrátora a kvality spracovania/ladění plánu prepnutia.
- Aktívny-Aktívny. V tomto prípade je prítomná iba synchronná replikácia, dostupnosť dátových centier sa určuje kvórom/arbitrom, ktorý je umiestnený striktne na tretej lokalite. RPO = 0, a RTO môže dosiahnuť 0 (ak to aplikácia umožňuje) alebo zodpovedať času na spracovanie zlyhania uzla v virtualizačnom clustri. Na úrovni virtualizácie sa vytvára rozšírený (Metro) klaster, ktorý vyžaduje Active-Active úložisko.
Obvykle vidíme u klientov už realizovanú architektúru s klasickým úložiskom v hlavnom dátovom centre, preto navrhujeme ďalšie pre replikáciu. Ako som už spomenul, Cisco HyperFlex ponúka asynchronnú replikáciu a vytvorenie rozšíreného virtualizačného clustra. Pri tom nepotrebujeme vyhradené úložisko úrovne Midrange a vyššie s drahými funkciami replikácie a Active-Active prístupu k dátam na dvoch úložiskách.
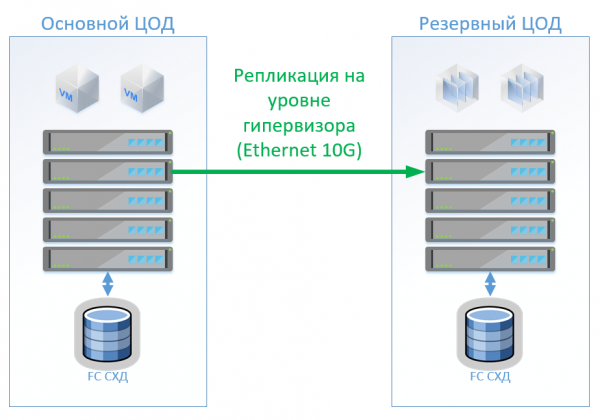
Scenár 1: Máme hlavné a záložné dátové centrá, platforma virtualizácie na VMware vSphere. Všetky produktívne systémy sa nachádzajú v hlavnom dátovom centre, a replikácia virtuálnych strojov prebieha na úrovni hypervízora, čo umožňuje nenechávať VM zapnuté v záložnom dátovom centre. Databázy a špeciálne aplikácie replikujeme vstavanými prostriedkami a udržiavame VM zapnuté. Pri zlyhaní hlavného dátového centra spúšťame systémy v záložnom dátovom centre. Predpokladáme, že máme okolo 100 virtuálnych strojov. Kým funguje hlavné dátové centrum, v záložnom dátovom centre je možné spúšťať testovacie prostredia a ďalšie systémy, ktoré je možné vypnúť v prípade prepnutia hlavného dátového centra. Tiež je možný variant, keď používame obojsmernú replikáciu. Z pohľadu hardvéru nič nezmení.
V prípade klasickej architektúry nainštalujeme do každého dátového centra hybridnú úložnú sústavu s prístupom cez FibreChannel, tieringom, deduplikáciou a kompresiou (ale nie online), 8 serverov na každú lokalitu, po 2 prepínače FibreChannel a Ethernet 10G. Na replikáciu a správu prepinania v klasickej architektúre môžeme použiť nástroje VMware (Replication + SRM) alebo iné externé nástroje, ktoré budú o niečo lacnejšie a niekedy pohodlnejšie.
Na obrázku je znázornená schéma.
V prípade použitia Cisco HyperFlex vzniká nasledujúca architektúra:
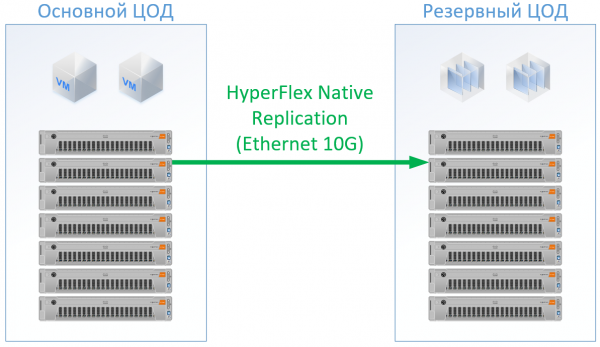
Pre HyperFlex som použil servery s veľkými zdrojmi CPU/RAM, pretože časť zdrojov pôjde na VM kontroléra HyperFlex, a čo sa týka CPU a pamäte, dokonca som trochu prekonfiguroval HyperFlex, aby som sa neprispôsoboval Cisco a zabezpečil zdroje pre ostatné VM. Zato sa môžeme vzdať prepínačov FibreChannel a Ethernet porty pre každý server nebudú potrebné, miestny prenos sa spravuje vnútri FI.
V konečnom dôsledku vznikla nasledujúca konfigurácia pre každé dátové centrum:
Servery
8 x 1U Server (384 GB RAM, 2 x Intel Gold 6132, FC HBA)
8 x HX240C-M5L (512 GB RAM, 2 x Intel Gold 6150, 3,2 GB SSD, 10 x 6 TB NL-SAS)
SÚS
Hybridná úložná sústava s FC Front-End (20TB SSD, 130 TB NL-SAS)
—
LAN
2 x Ethernet prepínač 10G 12 portov
—
SAN
2 x FC prepínač 32/16Gb 24 portov
2 x Cisco UCS FI 6332
Licencie
VMware Ent Plus
Replikácia a/alebo orchestrácia prepínania VM
VMware Ent Plus
Pre HyperFlex som neplánoval licencie softvéru na replikáciu, pretože máme to dostupné hneď.
Pre klasickú architektúru som vybral dodávateľa, ktorý sa preukázal ako kvalitný a cenovo dostupný výrobca. Pre obe varianty som použil štandardnú zľavu pre konkrétne riešenie, na konci som dostal reálne ceny.
Riešenie na Cisco HyperFlex sa ukázalo o 13% lacnejšie.
Scenár 2: vytvorenie dvoch aktívnych dátových centier. V tomto scenári navrhujeme rozšírený klaster na VMware.
Klasická architektúra pozostáva zo serverov virtualizácie, SAN (protokol FC) a dvoch úložných zariadení, ktoré dokážu čítať a zapisovať na tom, čo je medzi nimi rozšírené. Na každom úložnom zariadení plánujeme použiteľnú kapacitu pre lokalitu.
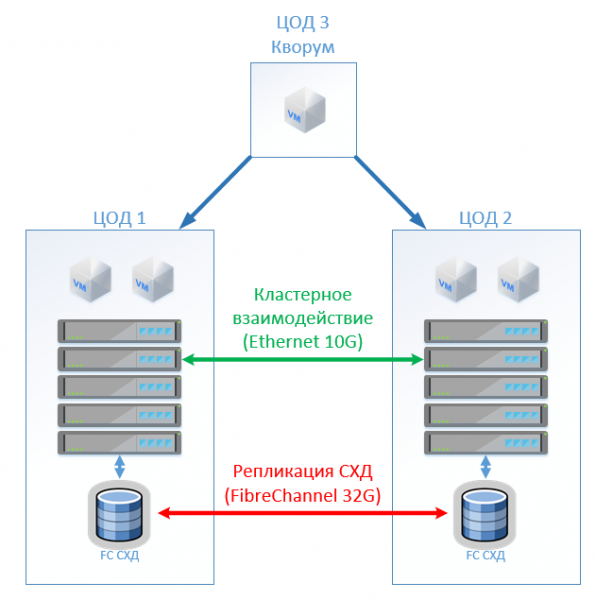
Pri HyperFlex jednoducho vytvoríme Stretch Cluster s rovnakým počtom uzlov na oboch lokalitách. V tomto prípade sa používa faktor replikácie 2+2.
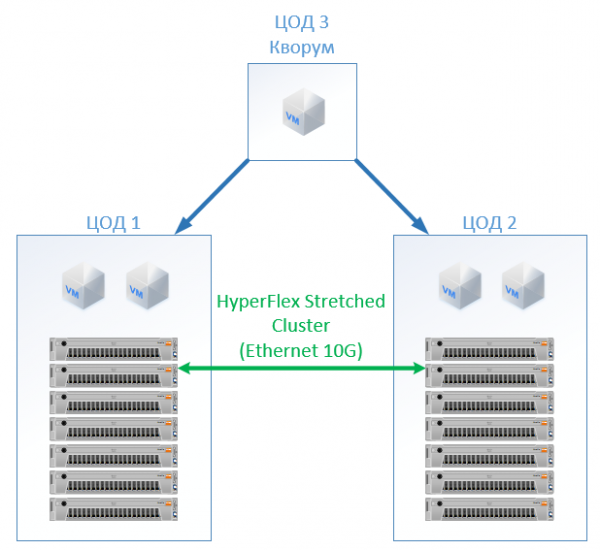
Vznikla nasledujúca konfigurácia:
Klasická architektúra
HyperFlex
Servery
16 x 1U Server (384 GB RAM, 2 x Intel Gold 6132, FC HBA, 2 x 10G NIC)
16 x HX240C-M5L (512 GB RAM, 2 x Intel Gold 6132, 1,6 TB NVMe, 12 x 3,8 TB SSD, VIC 1387)
SÚS
2 x AllFlash úložná sústava (150 TB SSD)
—
LAN
4 x Ethernet prepínač 10G 24 portov
—
SAN
4 x FC prepínač 32/16Gb 24 portov
4 x Cisco UCS FI 6332
Licencie
VMware Ent Plus
VMware Ent Plus
Vo všetkých výpočtoch som nezohľadnil sieťovú infraštruktúru, náklady na DCA atď.: tie budú rovnaké pre klasickú architektúru aj pre riešenie na HyperFlex.
HyperFlex bol drahší o 5 %. Treba poznamenať, že v oblasti CPU/RAM som mal pre Cisco nesúlad, pretože som v konfigurácii vyplnil pamäťové kanály rovnomerne. Náklady sú síce o niečo vyššie, ale nie radikálne, čo jasne naznačuje, že hyperkonvergencia nie je len "hra pre bohatých", ale môže konkurovať štandardnému prístupu k budovaniu DCA. Môže to byť zaujímavé aj pre tých, ktorí už majú servery Cisco UCS a zodpovedajúcu infraštruktúru.
Z výhod získame absenciu nákladov na administráciu SAN a SÚD, online kompresiu a deduplikaáciu, jednotný vstupný bod na podporu (virtualizácia, servery, tie sú zároveň SÚD), úsporu miesta (avšak nie vo všetkých scenároch), zjednodušenie prevádzky.
Pokiaľ ide o podporu, tú získavate od jedného dodávateľa - Cisco. Podľa skúseností s servermi Cisco UCS sa mi páči, na HyperFlex som sa nikdy nemusel obrať, všetko už fungovalo. Inžinieri reagujú rýchlo a dokážu riešiť nielen štandardné problémy, ale aj zložité okrajové prípady. Niekedy sa ich pýtam: "Dá sa to takto spraviť, pripojiť toto?" alebo "Tu som nastavoval niečo a nechce to fungovať. Pomôžte!" - trpezlivo nájdu potrebného sprievodcu a ukážu na správne kroky, nebudú odpovedať: "Riešime len hardvérové problémy."
Odkazy
- Môj e-mail — StGeneralov@croc.ru
Zdroj: habr.com
