

Pred začiatkom kurzu sme pre vás pripravili preklad ďalšieho užitočného materiálu.
Huffmanovo kódovanie je algoritmus pre kompresiu dát, ktorý formuluje základnú myšlienku kompresie súborov. V tomto článku budeme hovoriť o kódovaní pevnej a premennej dĺžky, unikátne dekódovateľných kódoch, prefiksoch a o vytváraní Huffmanovho stromu.
Vieme, že každý znak je uchovávaný ako sekvencia 0 a 1 a zaberá 8 bitov. To sa nazýva kódovanie pevnej dĺžky, pretože každý znak používa rovnaký fixný počet bitov na uloženie.
Predpokladajme, že máme text. Akým spôsobom môžeme skrátiť množstvo miesta potrebného na uloženie jedného znaku?
Základná myšlienka spočíva v kódovaní premennej dĺžky. Môžeme využiť skutočnosť, že niektoré znaky v texte sa vyskytujú častejšie ako iné (), aby sme vyvinuli algoritmus, ktorý predstaví tú istú sekvenciu znakov menším počtom bitov. Pri kódovaní premennej dĺžky priraďujeme znakom variabilný počet bitov na základe frekvencie ich výskytu v danom texte. Nakoniec niektoré znaky môžu zaberať iba 1 bit, iné 2 bity, 3 alebo viac. Problém so kódovaním premennej dĺžky spočíva iba v následnom dekódovaní sekvencie.
Ako dekódovať sekvenciu bitov jednoznačne, ak vieme, aká je?
Zvážme reťazec „aabacdab“. Obsahuje 8 znakov a pri kódovaní pevnej dĺžky by na jeho uloženie bolo potrebných 64 bitov. Všimnime si, že frekvencia znakov „a“, „b“, „c“ a „d“ je 4, 2, 1, 1, resp. Poďme sa pokúsiť reprezentovať „aabacdab“ menším počtom bitov, pričom využijeme fakt, že „a“ sa vyskytuje častejšie ako „b“, a „b“ sa vyskytuje častejšie ako „c“ a „d“. Začneme tak, že kódovanie „a“ využijeme jeden bit, teda 0, „b“ priradíme dvojbitový kód 11 a trojbitové kódy 100 a 011 pridelíme „c“ a „d“.
Týmto dostaneme:
a
0
b
11
c
100
d
011
Takže reťazec „aabacdab“ kódovanie prevedieme ako 00110100011011 (0|0|11|0|100|011|0|11), pričom použijeme vyššie uvedené kódy. Avšak hlavný problém bude pri dekódovaní. Keď sa pokúsime dekódovať reťazec 00110100011011, dostaneme nejednoznačný výsledok, pretože ho môžeme reprezentovať ako:
0|011|0|100|011|0|11    adacdab
0|0|11|0|100|0|11|011   aabacabd
0|011|0|100|0|11|0|11   adacabab
…
a pod.
Aby sme sa vyhli tejto nejednoznačnosti, musíme zabezpečiť, že naše kódovanie spĺňa takéto poňatie ako prefixové pravidlo, čo zase predpokladá, že kódy je možné dekódovať len jedným unikátnym spôsobom. Prefixové pravidlo zaručuje, že žiaden kód nebude prefixom iného. Pod kódom chápeme bity, používané na reprezentáciu konkrétneho symbolu. V uvedenom príklade 0 – to je prefix 011, čo porušuje prefixové pravidlo. Takže, ak naše kódy spĺňajú prefixové pravidlo, je možné jednoznačne vykonať dekódovanie (a naopak).
Pozrime sa znova na uvedený príklad. Tentoraz pridelíme pre symboly „a“, „b“, „c“ a „d“ kódy, ktoré spĺňajú prefixové pravidlo.
a
0
b
10
c
110
d
111
Pri použití takéhoto kódovania bude reťazec „aabacdab“ kódovaný ako 00100100011010 (0|0|10|0|100|011|0|10). A teraz 00100100011010 už budeme schopní jednoznačne dekódovať a vrátiť sa k nášmu pôvodnému reťazcu „aabacdab“.
Huffmanovo kódovanie
Teraz, keď sme pochopili kódovanie premennej dĺžky a prefixové pravidlo, poďme hovoriť o Huffmanovom kódovaní.
Metóda spočíva v vytvorení binárnych stromov. V ňom môže byť uzol buď koncový, alebo vnútorný. Pôvodne sú všetky uzly považované za listy (koncové), ktoré reprezentujú samotný symbol a jeho váhu (t.j. frekvenciu výskytu). Vnútorné uzly obsahujú váhu symbolu a odkazujú na dva uzly-dedičov. Všeobecne sa dohodlo, že bit „0“ reprezentuje sledovanie po ľavej vetve, a „1“ — po pravej. V úplnom strome N listov a N-1 vnútorných uzlov. Odporúča sa, aby sa pri konštrukcii Huffmanovho stromu eliminovali nepoužívané symboly na získanie kódov optimálnej dĺžky.
Na konštrukciu Huffmanovho stromu použijeme prioritnú frontu, kde uzlu s najnižšou frekvenciou bude pridelená najvyššia priorita. Nižšie sú uvedené kroky konštrukcie:
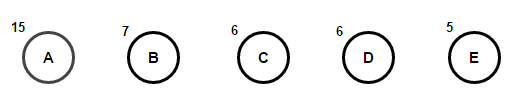
- Vytvorte uzol-list pre každý symbol a pridajte ich do prioritnej fronty.
- Kým je v frontě viac ako jeden list, robte nasledovné:
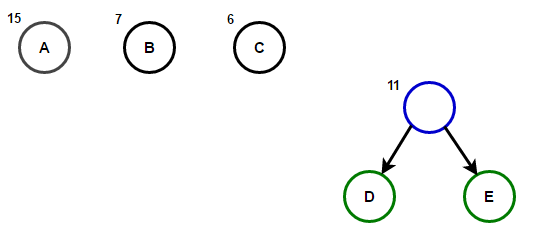
- Odstráňte dva uzly s najvyššou prioritou (s najnižšou frekvenciou) z fronty;
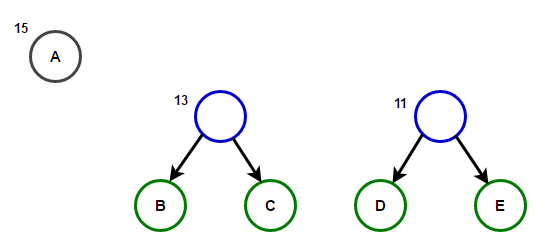
- Vytvorte nový vnútorný uzol, kde budú tieto dva uzly dedičmi, a frekvencia výskytu bude rovná súčtu frekvencií týchto dvoch uzlov.
- Pridajte nový uzol do prioritnej fronty.
- Posledný zostávajúci uzol bude koreňový, čím sa končí konštrukcia stromu.
Predpokladajme, že máme nejaký text, ktorý sa skladá iba z teraz značiek „a“, „b“, „c“, „d“ a „e“, a frekvencie ich výskytu sú 15, 7, 6, 6 a 5. Nižšie nájdete ilustrácie, ktoré odrážajú kroky algoritmu.
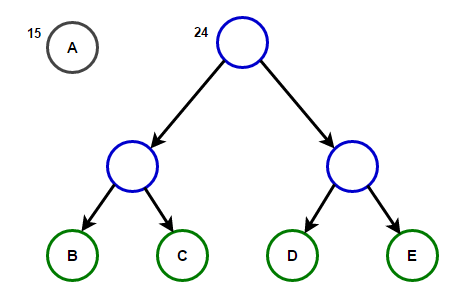
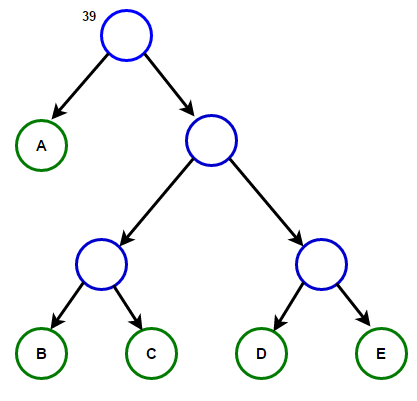
Cesta od koreňa k akémukoľvek koncovému uzlu bude uchovávať optimálny prefixový kód (tiež známy ako Huffmanov kód), ktorý zodpovedá znaku priradenému k tomuto koncovému uzlu.
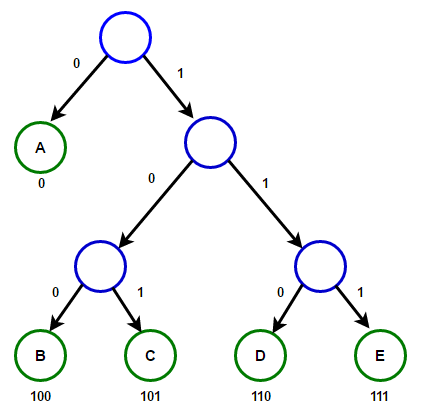
Huffmanovo strom
Nižšie nájdete implementáciu algoritmu kompresie Huffmana v jazykoch C++ a Java:
#include <iostream>
#include <string>
#include <queue>
#include <unordered_map>
using namespace std;

// A Tree node
struct Node
{
	char ch;
	int freq;
	Node *left, *right;
};

// Function to allocate a new tree node
Node* getNode(char ch, int freq, Node* left, Node* right)
{
	Node* node = new Node();

	node->ch = ch;
	node->freq = freq;
	node->left = left;
	node->right = right;

	return node;
}

// Comparison object to be used to order the heap
struct comp
{
	bool operator()(Node* l, Node* r)
	{
		// highest priority item has lowest frequency
		return l->freq > r->freq;
	}
};

// traverse the Huffman Tree and store Huffman Codes
// in a map.
void encode(Node* root, string str,
			unordered_map<char, string> &huffmanCode)
{
	if (root == nullptr)
		return;

	// found a leaf node
	if (!root->left && !root->right) {
		huffmanCode[root->ch] = str;
	}

	encode(root->left, str + "0", huffmanCode);
	encode(root->right, str + "1", huffmanCode);
}

// traverse the Huffman Tree and decode the encoded string
void decode(Node* root, int &index, string str)
{
	if (root == nullptr) {
		return;
	}

	// found a leaf node
	if (!root->left && !root->right)
	{
		cout << root->ch;
		return;
	}

	index++;

	if (str[index] =='0')
		decode(root->left, index, str);
	else
		decode(root->right, index, str);
}

// Builds Huffman Tree and decode given input text
void buildHuffmanTree(string text)
{
	// count frequency of appearance of each character
	// and store it in a map
	unordered_map<char, int> freq;
	for (char ch: text) {
		freq[ch]++;
	}

	// Create a priority queue to store live nodes of
	// Huffman tree;
	priority_queue<Node*, vector<Node*>, comp> pq;

	// Create a leaf node for each character and add it
	// to the priority queue.
	for (auto pair: freq) {
		pq.push(getNode(pair.first, pair.second, nullptr, nullptr));
	}

	// do till there is more than one node in the queue
	while (pq.size() != 1)
	{
		// Remove the two nodes of highest priority
		// (lowest frequency) from the queue
		Node *left = pq.top(); pq.pop();
		Node *right = pq.top();	pq.pop();

		// Create a new internal node with these two nodes
		// as children and with frequency equal to the sum
		// of the two nodes' frequencies. Add the new node
		// to the priority queue.
		int sum = left->freq + right->freq;
		pq.push(getNode(' ', sum, left, right));
	}

	// root stores pointer to root of Huffman Tree
	Node* root = pq.top();

	// traverse the Huffman Tree and store Huffman Codes
	// in a map. Also prints them
	unordered_map<char, string> huffmanCode;
	encode(root, "", huffmanCode);

	cout << "Huffman Codes are :n" << 'n';
	for (auto pair: huffmanCode) {
		cout << pair.first << " " << pair.second << 'n';
	}

	cout << "nOriginal string was :n" << text << 'n';

	// print encoded string
	string str = "";
	for (char ch: text) {
		str += huffmanCode[ch];
	}

	cout << "nEncoded string is :n" << str << 'n';

	// traverse the Huffman Tree again and this time
	// decode the encoded string
	int index = -1;
	cout << "nDecoded string is: n";
	while (index < (int)str.size() - 2) {
		decode(root, index, str);
	}
}

// Huffman coding algorithm
int main()
{
	string text = "Huffman coding is a data compression algorithm.";

	buildHuffmanTree(text);

	return 0;
}
import java.util.HashMap;
import java.util.Map;
import java.util.PriorityQueue;
// Uzol stromu
class Node
{
char ch;
int freq;
Node left = null, right = null;
Node(char ch, int freq)
{
this.ch = ch;
this.freq = freq;
}
public Node(char ch, int freq, Node left, Node right) {
this.ch = ch;
this.freq = freq;
this.left = left;
this.right = right;
}
};
class Huffman
{
// prechádza Huffmanov strom a ukladá Huffmanove kódy
// do mapy.
public static void encode(Node root, String str,
Map huffmanCode)
{
if (root == null)
return;
// našiel sa listový uzol
if (root.left == null && root.right == null) {
huffmanCode.put(root.ch, str);
}
encode(root.left, str + "0", huffmanCode);
encode(root.right, str + "1", huffmanCode);
}
// prechádza Huffmanov strom a dekóduje zakódovaný reťazec
public static int decode(Node root, int index, StringBuilder sb)
{
if (root == null)
return index;
// našiel sa listový uzol
if (root.left == null && root.right == null)
{
System.out.print(root.ch);
return index;
}
index++;
if (sb.charAt(index) == '0')
index = decode(root.left, index, sb);
else
index = decode(root.right, index, sb);
return index;
}
// Vytvára Huffmanov strom a huffmanCode a dekóduje zadaný vstupný text
public static void buildHuffmanTree(String text)
{
// počíta frekvenciu výskytu každého znaku
// a ukladá ju do mapy
Map freq = new HashMap();
for (int i = 0 ; i < text.length(); i++) {
if (!freq.containsKey(text.charAt(i))) {
freq.put(text.charAt(i), 0);
}
freq.put(text.charAt(i), freq.get(text.charAt(i)) + 1);
}
// Vytvorí prioritnú frontu na uloženie živých uzlov Huffmanovho stromu
// Všimnite si, že položka s najvyššou prioritou má najnižšiu frekvenciu
PriorityQueue pq = new PriorityQueue(
(l, r) -> l.freq - r.freq);
// Vytvára listový uzol pre každý znak a pridáva ho
// do prioritnej fronty.
for (Map.Entry entry : freq.entrySet()) {
pq.add(new Node(entry.getKey(), entry.getValue()));
}
// robí až kým v queue nezostane viac ako jeden uzol
while (pq.size() != 1)
{
// Odstráni dva uzly s najvyššou prioritou
// (najnižšia frekvencia) z fronty
Node left = pq.poll();
Node right = pq.poll();
// Vytvára nový interný uzol s týmito dvoma uzlami ako deťmi
// a s frekvenciou rovnou súčtu frekvencií týchto dvoch uzlov.
// Pridáva nový uzol do prioritnej fronty.
int sum = left.freq + right.freq;
pq.add(new Node(' ', sum, left, right));
}
// root uchováva ukazovateľ na korene Huffmanovho stromu
Node root = pq.peek();
// prechádza Huffmanov strom a ukladá Huffmanove kódy do mapy
Map huffmanCode = new HashMap();
encode(root, "", huffmanCode);
// vytlačí Huffmanové kódy
System.out.println("Huffmanove kódy sú :\n");
for (Map.Entry entry : huffmanCode.entrySet()) {
System.out.println(entry.getKey() + " " + entry.getValue());
}
System.out.println("\nPôvodný reťazec bol :\n" + text);
// vytlačí zakódovaný reťazec
StringBuilder sb = new StringBuilder();
for (int i = 0 ; i < text.length(); i++) {
sb.append(huffmanCode.get(text.charAt(i)));
}
System.out.println("\nZakódovaný reťazec je :\n" + sb);
// prechádza Huffmanov strom znova a tentokrát
// dekóduje zakódovaný reťazec
int index = -1;
System.out.println("\nDekódovaný reťazec je: \n");
while (index < sb.length() - 2) {
index = decode(root, index, sb);
}
}
public static void main(String[] args)
{
String text = "Huffmanove kódovanie je algoritmus na kompresiu dát.";
buildHuffmanTree(text);
}
}Poznámka: Pamäť využívaná vstupným reťazcom je 47 * 8 = 376 bitov, zatiaľ čo zakódovaný reťazec zaberá iba 194 bitov, t.j. dáta sa komprimujú približne o 48 %. V programe v C++ vyššie používame triedu string na uloženie zakódovaného reťazca, aby sme program urobili prehľadnejším.
Pretože efektívne dátové štruktúry prioritných front vyžadujú na vloženie O(log(N)) čas, a v úplnom binárnom strome s N listami sa nachádza 2N-1 uzlov, a Huffmanov strom je úplný binárny strom, teda algoritmus funguje za O(Nlog(N)) čas, kde N – počet symbolov.
Zdroje:
Zdroj: habr.com
