

Databáza časových radov (TSDB, time series database) v Prometheus 2 je vynikajúci príklad inžinierskeho riešenia, ktoré ponúka výrazné vylepšenia v porovnaní so skladom v2 v Prometheus 1 z hľadiska rýchlosti zhromažďovania údajov a vykonávania dopytov, efektívnosti využívania zdrojov. Implementovali sme Prometheus 2 v Percona Monitoring and Management (PMM) a mal som možnosť preskúmať výkon Prometheus 2 TSDB. V tomto článku opíšem výsledky týchto pozorovaní.
Priemerné zaťaženie Prometheus
Pre tých, ktorí sú zvyknutí pracovať s databázami pre hlavné použitie, je bežné zaťaženie Prometheus pomerne zaujímavé. Rýchlosť zhromažďovania údajov sa snaží dosiahnuť stabilnú hodnotu: zvyčajne služby, ktoré monitorujete, posielajú približne rovnaké množstvo metrík a infraštruktúra sa mení relatívne pomaly.
Dopyty na informácie môžu pochádzať z rôznych zdrojov. Niektoré z nich, napríklad upozornenia, sa tiež snažia dosiahnuť stabilnú a predvídateľnú hodnotu. Iné, ako napríklad používateľské dopyty, môžu spôsobiť výkyvy, hoci to nie je charakteristické pre väčšinu zaťaženia.
Test zaťaženia
Počas testovania som sa zameral na schopnosť zhromažďovať údaje. Nasadil som Prometheus 2.3.2, skompilovaný s Go 1.10.1 (ako súčasť PMM 1.14) na službe Linode, pomocou tohto skriptu: . Na maximálne realistické generovanie zaťaženia, pomocou tohto som spustil niekoľko MySQL uzlov s reálnym zaťažením (Sysbench TPC-C Test), z ktorých každý emuloval 10 uzlov Linux/MySQL.
Všetky nasledujúce testy sa uskutočnili na serveri Linode s ôsmymi virtuálnymi jadrami a 32 GB RAM, na ktorom beží 20 simulácií zaťaženia monitorovania dvesto inštancií MySQL. Alebo, v terminológii Prometheus, 800 cieľov (targets), 440 zberov (scrapes) za sekundu, 380 tisíc záznamov (samples) za sekundu a 1,7 milióna aktívnych časových radov.
Dizajn
Bežný prístup tradičných databáz, vrátane toho, ktorý používal Prometheus 1.x, spočíva v . Ak je jeho kapacita nedostatočná, aby zvládla zaťaženie, stretnete sa s veľkými oneskoreniami a niektoré dopyty nebudú vykonané. Používanie pamäte v Prometheus 2 je konfigurované pomocou kľúča storage.tsdb.min-block-duration, ktorý určuje, ako dlho budú zápisy uchovávané v pamäti pred ich prepisovaním na disk (predvolene to sú 2 hodiny). Množstvo potrebnej pamäte závisí od počtu časových radov, označení (labels) a intenzity zbierania údajov (scrapes) v súčte s čistým prichádzajúcim tokom. V oblasti diskového priestoru sa Prometheus snaží používať 3 bajty na zápis (sample). Na druhej strane sú požiadavky na pamäť výrazne vyššie.
Aj keď existuje možnosť konfigurovať veľkosť bloku, neodporúča sa nastavovať ju ručne, preto ste nútení poskytnúť Prometheus toľko pamäte, koľko si vyžiada pre vašu záťaž.
Ak nebude dostatok pamäte na podporu prichádzajúceho toku metrických údajov, Prometheus spadne s chybou out of memory alebo sa s ním vysporiada OOM killer.
Pridanie swapu, aby ste oddialili moment pádu, keď Prometheus dôjde pamäť, veľmi nepomáha, pretože používanie tejto funkcie vedie k explozívnemu nárastu spotreby pamäte. Myslím, že je to spôsobené Go, jeho garbage collectorom a tým, ako pracuje so swapom.
Ďalším zaujímavým prístupom je nastaviť prepisovanie head bloku na disk v určitom čase, namiesto toho, aby sa odpočítavalo od času štartu procesu.
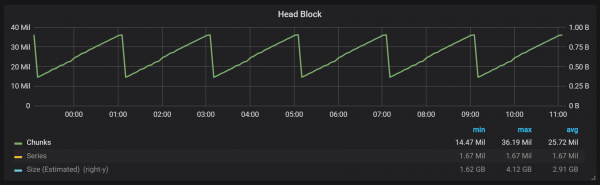
Ako môžete vidieť z grafu, prepisy na disk sa uskutočňujú každé dve hodiny. Ak zmeníte parameter min-block-duration na jednu hodinu, tieto prepisy sa budú uskutočňovať každú hodinu, začínajúc za pol hodiny.
Ak chcete použiť tento a ďalšie grafy vo vašej inštalácii Prometheus, môžete použiť tento . Bol navrhnutý pre PMM, ale s malými úpravami vyhovuje akejkoľvek inštalácii Prometheus.
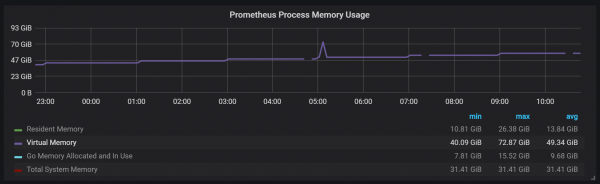
Máme aktívny blok, nazývaný head block, ktorý sa uchováva v pamäti; bloky so staršími údajmi sú dostupné prostredníctvom mmap(). To odstraňuje potrebu samostatne konfigurovať cache, ale tiež to znamená, že musíte nechať dostatok miesta pre cache operačného systému, ak chcete robiť dotazy na údaje staršie ako tie, ktoré zmestí head block.
A navyše to znamená, že spotreba virtuálnej pamäte Prometheus bude vyzerať dosť vysoká, čo netreba považovať za problém.
Ďalším zaujímavým aspektom dizajnu je použitie WAL (write ahead log). Ako je uvedené v dokumentácii k úložisku, Prometheus využíva WAL na zabránenie stratám pri pádoch. Konkrétne mechanizmy zabezpečenia trvanlivosti dát sú bohužiaľ nedostatočne zdokumentované. Verzia Prometheus 2.3.2 zapisuje WAL na disk každých 10 sekúnd, a táto voľba nie je používateľom konfigurovateľná.
Kompakcie (Compactions)
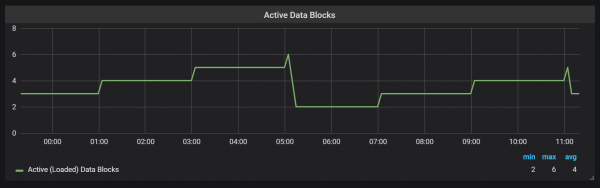
Prometheus TSDB je navrhnutá na základe LSM úložiska (Log Structured Merge — žurnálovo-štruktúrované zlúčenie stromu): hlavičkový blok je pravidelne zapisovaný na disk, zatiaľ čo mechanizmus kompakcie spája niekoľko blokov dohromady, aby sa predišlo skenovaniu príliš veľkého množstva blokov pri dopytoch. Tu je viditeľný počet blokov, ktoré som pozoroval na testovacej sústave po 24 hodinách záťaže.
Ak sa chcete dozvedieť viac o úložisku, môžete preskúmať súbor meta.json, ktorý obsahuje informácie o existujúcich blokoch a o tom, ako sa objavili.
{
       "ulid": "01CPZDPD1D9R019JS87TPV5MPE",
       "minTime": 1536472800000,
       "maxTime": 1536494400000,
       "stats": {
               "numSamples": 8292128378,
               "numSeries": 1673622,
               "numChunks": 69528220
       },
       "compaction": {
               "level": 2,
               "sources": [
                       "01CPYRY9MS465Y5ETM3SXFBV7X",
                       "01CPYZT0WRJ1JB1P0DP80VY5KJ",
                       "01CPZ6NR4Q3PDP3E57HEH760XS"
               ],
               "parents": [
                       {
                               "ulid": "01CPYRY9MS465Y5ETM3SXFBV7X",
                               "minTime": 1536472800000,
                               "maxTime": 1536480000000
                       },
                       {
                               "ulid": "01CPYZT0WRJ1JB1P0DP80VY5KJ",
                               "minTime": 1536480000000,
                               "maxTime": 1536487200000
                       },
                       {
                               "ulid": "01CPZ6NR4Q3PDP3E57HEH760XS",
                               "minTime": 1536487200000,
                               "maxTime": 1536494400000
                       }
               ]
       },
       "version": 1
}
Kompakcie v Prometheovi sú viazané na čas zapisovania hlavičkového bloku na disk. V tomto okamihu môže prebiehať niekoľko takýchto operácií.
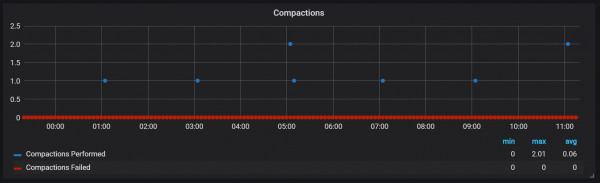
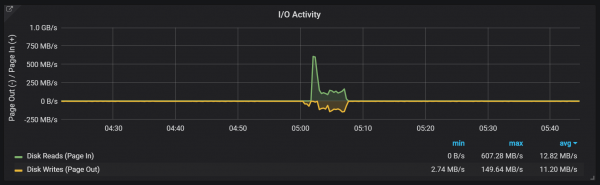
Zjavne, fragmentácia nie je nijako obmedzená a môže spôsobovať veľké výkyvy v diskovom I/O počas vykonávania.
Výkyvy zaťaženia CPU
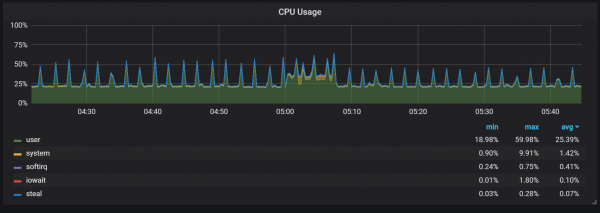
Samozrejme, má to dosť negatívny dopad na rýchlosť systému a predstavuje to vážnu výzvu pre LSM úložiská: ako robiť fragmentáciu, aby sa podporila vysoká rýchlosť požiadaviek a zároveň sa nevytváralo príliš veľké zaťaženie?
Použitie pamäte počas fragmentácie vyzerá tiež dosť zaujímavo.
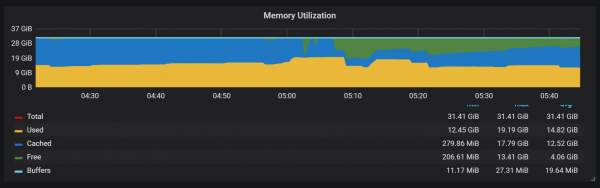
Môžeme vidieť, že po fragmentácii sa väčšina pamäte mení zo stavu Cached na Free: to znamená, že potenciálne cenné informácie boli z nej odstránené. Zaujímavé je, či sa tu používa fadvice() alebo nejaká iná technika minimalizácie, alebo to je spôsobené tým, že cache bola uvoľnená od blokov, ktoré boli zničené pri fragmentácii?
Obnovenie po zlyhaní
Obnova po zlyhaniach zaberá čas, a to je odôvodnené. Pre prichádzajúci prúd milióna záznamov za sekundu som musel čakať asi 25 minút, kým prebehla obnova so zohľadnením SSD disku.
level=info ts=2018-09-13T13:38:14.09650965Z caller=main.go:222 msg="Zahájeno Prometheus" version="(version=2.3.2, branch=v2.3.2, revision=71af5e29e815795e9dd14742ee7725682fa14b7b)"
level=info ts=2018-09-13T13:38:14.096599879Z caller=main.go:223 build_context="(go=go1.10.1, user=Jenkins, date=20180725-08:58:13OURCE)"
level=info ts=2018-09-13T13:38:14.096624109Z caller=main.go:224 host_details="(Linux 4.15.0-32-generic #35-Ubuntu SMP Fri Aug 10 17:58:07 UTC 2018 x86_64 1bee9e9b78cf (none))"
level=info ts=2018-09-13T13:38:14.096641396Z caller=main.go:225 fd_limits="(soft=1048576, hard=1048576)"
level=info ts=2018-09-13T13:38:14.097715256Z caller=web.go:415 component=web msg="Začíná naslouchání pro připojení" address=:9090
level=info ts=2018-09-13T13:38:14.097400393Z caller=main.go:533 msg="Zahájení TSDB ..."
level=info ts=2018-09-13T13:38:14.098718401Z caller=repair.go:39 component=tsdb msg="nalezen zdravý blok" mint=1536530400000 maxt=1536537600000 ulid=01CQ0FW3ME8Q5W2AN5F9CB7R0R
level=info ts=2018-09-13T13:38:14.100315658Z caller=web.go:467 component=web msg="předpona routeru" prefix=\/prometheus
level=info ts=2018-09-13T13:38:14.101793727Z caller=repair.go:39 component=tsdb msg="nalezen zdravý blok" mint=1536732000000 maxt=1536753600000 ulid=01CQ78486TNX5QZTBF049PQHSM
level=info ts=2018-09-13T13:38:14.102267346Z caller=repair.go:39 component=tsdb msg="nalezen zdravý blok" mint=1536537600000 maxt=1536732000000 ulid=01CQ78DE7HSQK0C0F5AZ46YGF0
level=info ts=2018-09-13T13:38:14.102660295Z caller=repair.go:39 component=tsdb msg="nalezen zdravý blok" mint=1536775200000 maxt=1536782400000 ulid=01CQ7SAT4RM21Y0PT5GNSS146Q
level=info ts=2018-09-13T13:38:14.103075885Z caller=repair.go:39 component=tsdb msg="nalezen zdravý blok" mint=1536753600000 maxt=1536775200000 ulid=01CQ7SV8WJ3C2W5S3RTAHC2GHB
level=error ts=2018-09-13T14:05:18.208469169Z caller=wal.go:275 component=tsdb msg="Zjištěna korupce WAL; zkracování" err="neočekávaná CRC32 kontrola d0465484, chtěno 0" file=\/opt\/prometheus\/data\/.prom2-data\/wal\/007357 pos=15504363
level=info ts=2018-09-13T14:05:19.471459777Z caller=main.go:543 msg="TSDB byla spuštěna"
level=info ts=2018-09-13T14:05:19.471604598Z caller=main.go:603 msg="Načítání konfiguračního souboru" filename=\/etc\/prometheus.yml
level=info ts=2018-09-13T14:05:19.499156711Z caller=main.go:629 msg="Dokončeno načítání konfiguračního souboru" filename=\/etc\/prometheus.yml
level=info ts=2018-09-13T14:05:19.499228186Z caller=main.go:502 msg="Server je připraven přijímat webové požadavky."
Hlavním problémem procesu obnovy je vysoká spotřeba paměti. I když server normálně může stabilně fungovat se stejným objemem paměti, při pádu nemusí být schopen se zotavit kvůli OOM. Jediným řešením, které jsem našel, je vypnout sběr dat, restartovat server, umožnit mu obnovit se a poté znovu spustit se zapnutým sběrem.
Zahřívání
Ještě jedno chování, které je třeba mít na paměti během zahřívání, je poměr nízkého výkonu a vysoké spotřeby zdrojů hned po startu. Při některých, ale ne všech startovacích procesech jsem pozoroval výrazné zatížení CPU a paměti.
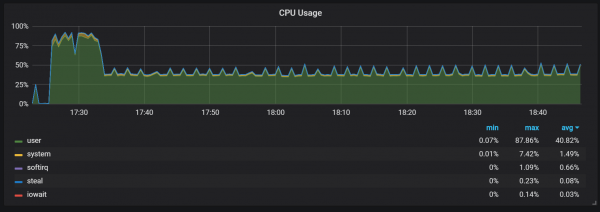
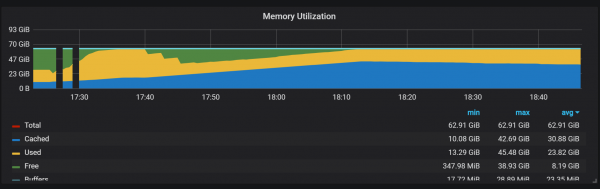
Případné nárůsty v používání paměti naznačují, že Prometheus nemůže na začátku správně nakonfigurovat všechny sběry a část informací může být ztracena.
Nepodarilo sa mi zistiť presné dôvody vysokého zaťaženia CPU a pamäte. Podozrivý som, že to súvisí s vytváraním nových časových radov v head block s vysokou frekvenciou.
Skoky zaťaženia CPU
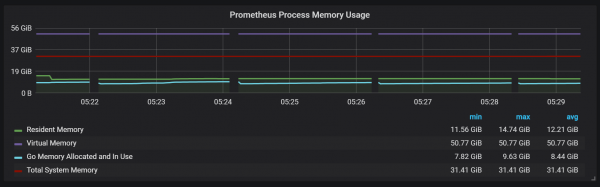
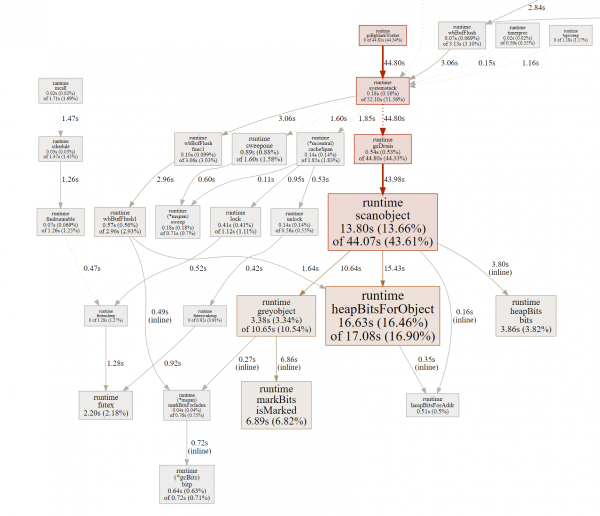
Okrem utesnení, ktoré spôsobujú pomerne vysoké zaťaženie I/O, som si všimol vážne skoky zaťaženia CPU každé dve minúty. Záblesky sú dlhšie pri vysokom prichádzajúcom prúde a zdá sa, že sú spôsobené garbage collectorom Go; aspoň niektoré jadrá sú úplne zaťažené.
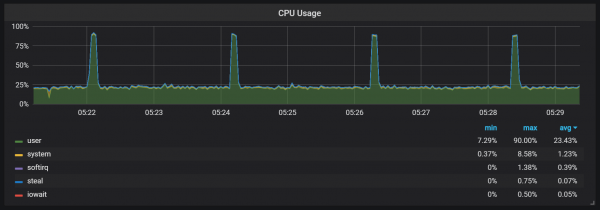
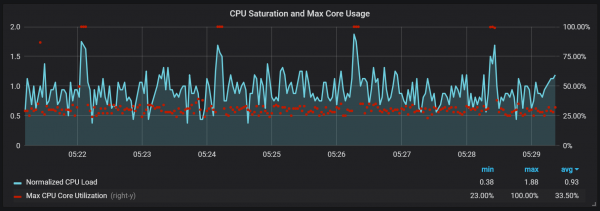
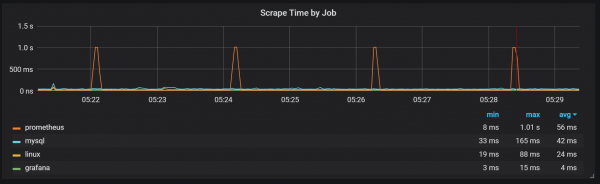
Tieto skoky nie sú vôbec bezvýznamné. Zdá sa, že keď nastanú, interné vstupné body a metriky Prometheus sa stávajú nedostupnými, čo spôsobuje medzery v dátach v tých istých časových obdobiach.
Tiež je možné si všimnúť, že exportér Prometheus sa zadrhne na jednu sekundu.
Môžeme si všimnúť korelácie s garbage collection (GC).
Záver
TSDB v Prometheus 2 funguje rýchlo, je schopná spracovať milióny časových radov a súčasne tisíce zápisov za sekundu, pričom využíva pomerne skromný hardvér. Využitie CPU a diskového I/O je tiež impozantné. Môj príklad zaznamenal až 200 000 metrík za sekundu na jedno použité jadro.
Pri plánovaní rozšírenia je potrebné pamätať na dostatočné objemy pamäte, a táto pamäť musí byť reálna. Objem použitej pamäte, ktorý som pozoroval, bol okolo 5 GB na 100 000 zápisov za sekundu prichádzajúceho prúdu, čo v súčte s vyrovnávacou pamäťou operačného systému predstavovalo približne 8 GB obsadenej pamäte.
Samozrejme, ešte je pred nami veľa práce na zvládnutí skokov CPU a diskového I/O, a to nie je prekvapujúce, vzhľadom na to, ako mladá je TSDB Prometheus 2 v porovnaní s InnoDB, TokuDB, RocksDB, WiredTiger, ale všetky mali podobné problémy na začiatku svojho životného cyklu.
Zdroj: habr.com
