

Ahoj, ja som Dmitrij Logvinenko — Data Engineer oddelenia analytiky skupiny spoločností „Vezet“.
Poviem vám o vynikajúcom nástroji na vývoj ETL procesov — Apache Airflow. Ale Airflow je tak univerzálny a komplexný, že by ste sa na neho mali pozrieť aj vtedy, ak sa nezaujímate o spracovanie dát, ale potrebujete občas spúšťať nejaké procesy a sledovať ich vykonávanie.
A áno, nielen rozprávať, ale aj ukazovať: program obsahuje veľa kódu, snímok obrazovky a odporúčaní.
Čo zvyčajne vidíte, keď googlite slovo Airflow / Wikimedia Commons
Obsah
Úvod
Apache Airflow — je ako Django:
- napísaný v Pythone,
- má skvelé administračné rozhranie,
- neobmedzene rozširujúci,
— len lepší, a je úplne určený na iné ciele, a to konkrétne (ako je napísané pred kódom):
- spúšťanie a monitorovanie úloh na neobmedzenom počte strojov (koľko vám dovolí Celery/Kubernetes a vaša svedomie)
- s dynamickou generáciou workflow z veľmi jednoduchého na písanie a pochopenie Python kódu
- a možnosťou prepojiť vzájomne akékoľvek databázy a API pomocou hotových komponentov aj vlastných pluginov (čo sa robí mimoriadne jednoducho).
My používame Apache Airflow takto:
- zhromažďujeme dáta z rôznych zdrojov (množstvo inštancií SQL Server a PostgreSQL, rôzne API s metrikami aplikácií, dokonca 1C) do DWH a ODS (u nás to sú Vertica a Clickhouse).
- ako pokročilý
cron, ktorý spúšťa procesy konsolidácie dát na ODS a zabezpečuje ich údržbu.
Do nedávna naše potreby pokrýval jeden malý server so 32 jadrami a 50 GB RAM. V Airflow pritom beží:
- náročnejšími 200 dagov (vlastne workflows, do ktorých sme naplnili úlohy),
- v každom v priemere po 70 úloh,
- toto dobro sa spúšťa (tiež v priemere) raz za hodinu.
A o tom, ako sme sa rozširovali, napíšem nižšie, ale teraz si definujme über-úlohu, ktorú budeme riešiť:
Existujú tri zdrojové SQL servery, na každom je 50 databáz - inštancií jedného projektu, teda ich štruktúra je rovnaká (takmer všade, mu-ha-ha), a to znamená, že každá má tabuľku Orders (našťastie tabuľku s takýmto názvom môžeme umiestniť do akéhokoľvek podnikania). Zbierame údaje, pridávame pomocné polia (server-zdroj, databáza-zdroj, identifikátor ETL-úlohy) a naivne ich hodíme do, povedzme, Vertica.
Ideme na to!
Hlavná časť, praktická (a trochu teoretická)
Prečo nám (a vám) to je potrebné
Keď boli stromy veľké a ja som bol jednoduchý SQL-česť v jednom ruském maloobchode, my sme „špagetovali“ ETL procesy aka toky údajov pomocou dvoch dostupných nám prostriedkov:
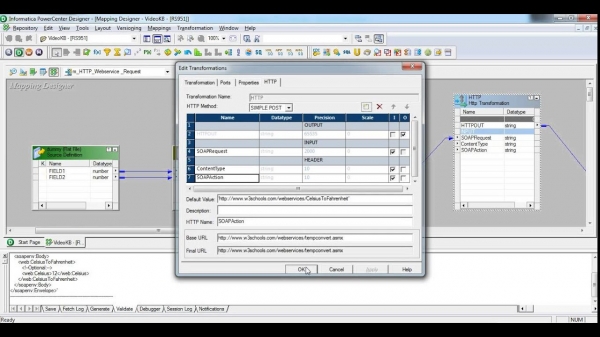
- Informatica Power Center — extrémne rozsiahly systém, mimoriadne výkonný, so svojím hardvérom, vlastným verziovaním. Použil som bohužiaľ 1% jeho možností. Prečo? No, po prvé, toto rozhranie je niekde z nultých rokov psychicky nás tlačilo. Po druhé, táto vec je prispôsobená pre mimoriadne zložitý proces, zapálené opätovné použitie komponentov a iné veľmi-dôležité-podnikové-features. O tom, že stojí ako krídlo Airbus A380/rok, sa radšej nezmienime.
Pozor, screenshot môže mladším ako 30 rokov spôsobiť trochu bolesti.

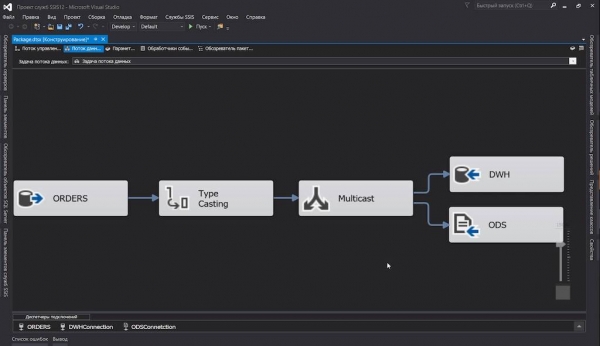
- SQL Server Integration Server — tohto kamaráta sme používali v našich vnútropojazdných tokoch. Veď vlastne: SQL Server už používame, a nevyužiť jeho ETL nástroje by bolo akosi nerozumné. Všetko v ňom je dobré: aj rozhranie je pekné, aj správy o vykonaní... Ale nie za toto máme radi programové produkty, ach nie za toto. Môžeme jeho
dtsx(ktorý predstavuje XML s prehadzujúcimi sa uzlami pri ukladaní) verzionovať, ale aký to má zmysel? A spraviť balík úloh, ktorý prenesie stovky tabuliek z jedného servera na iný? Čo stovky, pri dvadsiatich vám odpadne ukazovák, ktorý klika po myškovom tlačidle. Ale vyzerá to určite viac módne:
Bezpochyby sme hľadali východiská. Až to takmer dospelo k vlastnoručne napísanému generátoru SSIS balíkov...
...a potom ma našla nová práca. A v nej ma zasiahni Apache Airflow.
Keď som zistil, že opisy ETL procesov sú jednoduchý Python kód, len som takmer netancoval od radosti. Takto sa toky údajov dočkali verzionovania a diffovania, a hromadiť tabuľky s rovnakou štruktúrou zo sto databáz do jedného cieľového sa stalo záležitosťou Python kódu na jeden a pol až dva 13” obrazovky.
Zhromažďujeme klaster
Nebuďme deti a nehovoríme o úplne jasných veciach, ako je inštalácia Airflow, vašej zvolenej DB, Celery a iných záležitostí opísaných v dokumentoch.
Aby sme mohli hneď začať s experimentami, načrtl som docker-compose.yml v ktorom:
- Založíme vlastne Airflow: Scheduler, Webserver. Tam bude bežať aj Flower na monitorovanie úloh Celery (pretože už bol zahrnutý v
apache/airflow:1.10.10-python3.7, a my proti tomu nič nemáme); - PostgreSQL, do ktorého Airflow uloží svoje prevádzkové informácie (údaje plánovača, štatistiku vykonávania atď.), zatiaľ čo Celery bude zaznamenávať dokončené úlohy;
- Kľuč-hodnota, ktorý bude slúžiť ako broker úloh pre Celery;
- Celery worker, ktorý sa postará o samotné vykonávanie úloh.
- Do zložky
./dagsbudeme ukladať naše súbory s opismi dagov. Budú sa načítavať za behu, takže nie je potrebné prehadzovať celý stack po každej drobnosti.
Niekde je kód v príkladoch uvedený neúplne (aby sa nezapĺňal text), a niekde bude upravovaný v procese. Celé funkčné príklady kódu si môžete pozrieť v repozitári. .
docker-compose.yml
verzia: '3.4'

x-airflow-config: &airflow-config
  AIRFLOW__CORE__DAGS_FOLDER: /dags
  AIRFLOW__CORE__EXECUTOR: CeleryExecutor
  AIRFLOW__CORE__FERNET_KEY: MJNz36Q8222VOQhBOmBROFrmeSxNOgTCMaVp2_HOtE0=
  AIRFLOW__CORE__HOSTNAME_CALLABLE: airflow.utils.net:get_host_ip_address
  AIRFLOW__CORE__SQL_ALCHEMY_CONN: postgres+psycopg2://airflow:airflow@airflow-db:5432/airflow

  AIRFLOW__CORE__PARALLELISM: 128
  AIRFLOW__CORE__DAG_CONCURRENCY: 16
  AIRFLOW__CORE__MAX_ACTIVE_RUNS_PER_DAG: 4
  AIRFLOW__CORE__LOAD_EXAMPLES: 'False'
  AIRFLOW__CORE__LOAD_DEFAULT_CONNECTIONS: 'False'

  AIRFLOW__EMAIL__DEFAULT_EMAIL_ON_RETRY: 'False'
  AIRFLOW__EMAIL__DEFAULT_EMAIL_ON_FAILURE: 'False'

  AIRFLOW__CELERY__BROKER_URL: redis://broker:6379/0
  AIRFLOW__CELERY__RESULT_BACKEND: db+postgresql://airflow:airflow@airflow-db/airflow

x-airflow-base: &airflow-base
  image: apache/airflow:1.10.10-python3.7
  entrypoint: /bin/bash
  restart: always
  volumes:
    - ./dags:/dags
    - ./requirements.txt:/requirements.txt

services:
  # Redis ako Celery broker
  broker:
    image: redis:6.0.5-alpine

  # DB pre Airflow metadata
  airflow-db:
    image: postgres:10.13-alpine

    environment:
      - POSTGRES_USER=airflow
      - POSTGRES_PASSWORD=airflow
      - POSTGRES_DB=airflow

    volumes:
      - ./db:/var/lib/postgresql/data

  # Hlavný kontajner s Airflow Webserver, Scheduler, Celery Flower
  airflow:
    <<: *airflow-base

    environment:
      <
      -c " sleep 10 &&
           pip install --user -r /requirements.txt &&
           /entrypoint initdb &&
          (/entrypoint webserver &) &&
          (/entrypoint flower &) &&
           /entrypoint scheduler"

    ports:
      # Celery Flower
      - 5555:5555
      # Airflow Webserver
      - 8080:8080

  # Celery worker, bude škálovaný pomocou `--scale=n`
  worker:
    <<: *airflow-base

    environment:
      <
      -c " sleep 10 &&
           pip install --user -r /requirements.txt &&
           /entrypoint worker"

    depends_on:
      - airflow
      - airflow-db
      - broker
Poznámky:
- Pri zostavovaní kompozície som sa vo veľkej miere opieral o známy obraz – určite pozrite. Možno vám v živote viac nič nebude potrebné.
- Všetky nastavenia Airflow sú dostupné nielen cez
airflow.cfg, ale aj prostredníctvom premenných prostredia (vďaka vývojárom), čím som sa bez ostychu využil. - Samozrejme, nie je pripravený na produkciu: zámerne som nenastal heartbeats na kontajnery, nevyšiel sa s bezpečnosťou. Ale minimálne, ktoré je vhodné pre naše experimenty, som zabezpečil.
- Všimnite si, že:
- Priečinok s DAGmi musí byť dostupný ako plánovaču, tak aj pracovníkom.
- To isté platí aj pre všetky externé knižnice — všetky musia byť nainštalované na strojoch s plánovačom a pracovníkmi.
A teraz jednoducho:
$ docker-compose up --scale worker=3Po tom, čo sa všetko spustí, môžete sa pozrieť na webové rozhrania:
- Airflow:
- Flower:
Základné pojmy
Ak ste nič nepochopili z týchto „dagov“, tu je krátky slovník:
- Scheduler — najdôležitejší chlapík v Airflow, ktorý kontroluje, aby roboty pracovali a nie človek: sleduje harmonogram, aktualizuje dagy, spúšťa úlohy.
Vo všeobecnosti mal v starších verziách problémy s pamäťou (nie, nie amnézia, ale úniky) a v konfiguráciách dokonca zostal legátový parameter
run_duration— interval jeho reštartu. Ale teraz je všetko v poriadku. - DAG (tiež „dag“) — „smerovaný acyklický graf“, ale takéto definovanie málokomu niečo povie, a v podstate ide o kontajner na vzájomne komunikujúce úlohy (pozri nižšie) alebo ekvivalent Package v SSIS a Workflow v Informatica.
Okrem dagov môžu existovať aj subdagy, ale pravdepodobne sa k nim nedostaneme.
- DAG Run — inicializovaný dag, ktorému bol priradený jeho
execution_date. Dagruny jedného dagu môžu pokojne pracovať paralelne (ak ste, samozrejme, svoje úlohy urobili idempotentnými). - Operator — to sú kúsky kódu, ktoré sú zodpovedné za vykonanie nejakej konkrétnej akcie. Existujú tri typy operátorov:
- akcia, ako napríklad náš obľúbený
PythonOperator, ktorý dokáže vykonať akýkoľvek (platný) Python kód; - transfer, ktoré presúvajú údaje z miesta na miesto, povedzme,
MsSqlToHiveTransfer; - sensor umožní reagovať alebo oneskoriť ďalšie vykonávanie dagu až do nástupu nejakej udalosti.
HttpSensormôže vyvolať zadaný endpoint, a keď dostane požadovanú odpoveď, spustiť transferGoogleCloudStorageToS3Operator. Zvedavá myseľ sa opýta: „Prečo? Veď opakovania sa dajú robiť priamo v operátore!“ A potom, aby sa nezaplňoval pool úloh visiacimi operátormi. Senzor sa spúšťa, kontroluje a umiera do ďalšieho pokusu.
- akcia, ako napríklad náš obľúbený
- Task — deklarované operátory bez ohľadu na typ a pripojené k dagu sú povýšené na úroveň úlohy.
- Task instance — keď generálny plánovač rozhodol, že úlohy je čas poslať do boja na vykonávateľov-pracovníkov (priamo na mieste, ak používame
LocalExecutoralebo na vzdialenú uzol v prípadeCeleryExecutor), priradí im kontext (t.j. súbor premenných — parametrov vykonávania), rozloží šablóny príkazov alebo požiadaviek a ukladá ich do poolu.
Generujeme úlohy
Najprv označíme celkový plán nášho dagu, a potom sa čoraz viac a viac ponoríme do detailov, pretože používame niektoré netriviálne riešenia.
Takže v najjednoduchšej forme by takýto dag vyzeral takto:
z datetime import timedelta, datetime

z airflow import DAG
z airflow.operators.python_operator import PythonOperator

z commons.datasources import sql_server_ds

dag = DAG('orders',
          schedule_interval=timedelta(hours=6),
          start_date=datetime(2020, 7, 8, 0))

def workflow(**context):
    print(context)

for conn_id, schema in sql_server_ds:
    PythonOperator(
        task_id=schema,
        python_callable=workflow,
        provide_context=True,
        dag=dag)
Pozrime sa na to:
- Najprv importujeme potrebné knižnice a niečo ďalšie;
sql_server_ds— súList[namedtuple[str, str]]s menami pripojení z Airflow Connections a databáz, z ktorých budeme brať našu tabuľku;dag— deklarácia nášho dagu, ktorá musí byť vglobals(), inak ho Airflow nenájde. Dagom je tiež potrebné povedať:- akú má predchádzajúcu dobu
orders— toto meno sa potom zobrazí v webovom rozhraní, - že bude fungovať od polnoci 8. júla,
- a mal by sa spúšťať približne každých 6 hodín (pre šikovných ľudí je tu namiesto
timedelta()dovolenécron-reťazce0 0 0/6 ? * * *, pre menej šikovných — výraz ako@daily);
- akú má predchádzajúcu dobu
workflow()bude vykonávať hlavnú prácu, ale nie teraz. Teraz len vypíšeme náš kontext do logu.- A teraz jednoduchá mágia vytvárania úloh:
- prechádzame našimi zdrojmi;
- inak inicializujeme
PythonOperator, ktorý vykoná našu prázdnu úlohuworkflow(). Nezabudnite uviesť jedinečné (v rámci dagu) meno úlohy a prepojiť samotný dag. Príznakprovide_contextnásledne naša funkcia poskytne ďalšie argumenty, ktoré si opatrne poskladáme pomocou**context.
Zatiaľ to všetko. Čo sme dostali:
- nový dag vo webovom rozhraní,
- približne 150 úloh, ktoré sa budú vykonávať paralelne (ak to povolia nastavenia Airflow, Celery a výkon serverov).
No, takmer dostali.
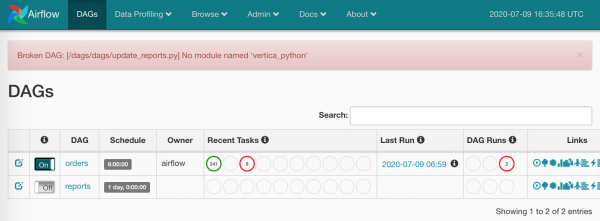
Kto nastaví závislosti?
Aby som to všetko zjednodušil, zakomponoval som do docker-compose.yml spracovania requirements.txt na všetkých uzloch.
Teraz to začína:
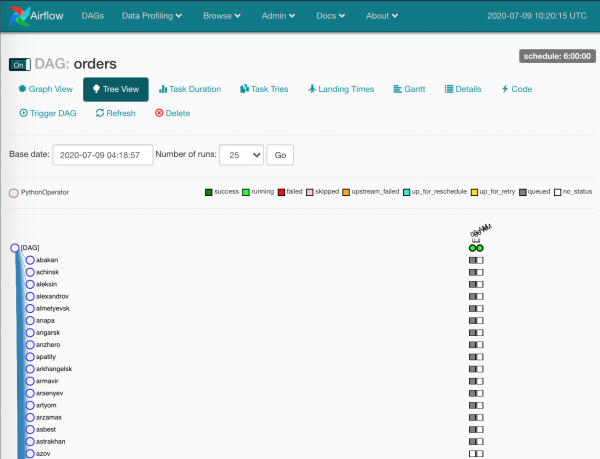
Sivé štvorce — inštancie úloh, spracované plánovačom.
Trochu počkáme, úlohy sa chytajú pracovníci:
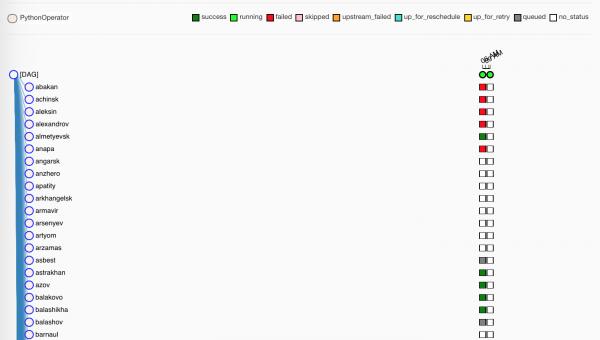
Zelené, samozrejme, — úspešne vykonané. Červené — nie veľmi úspešne.
Mimochodom, na našej produkcii nie je žiadna zložka, ktorá by sa synchronizovala medzi strojmi — všetky dagy sú uložené v
./dagsnašom Gitlabe, a Gitlab CI rozkladá aktualizácie na stroje pri zlúčení dogitZatiaľ čo pracovníci spracovávajú naše prázdne úlohy, spomeňme si na ďalší nástroj, ktorý nám môže niečo zobraziť — Flower.master.
Trochu o Flower
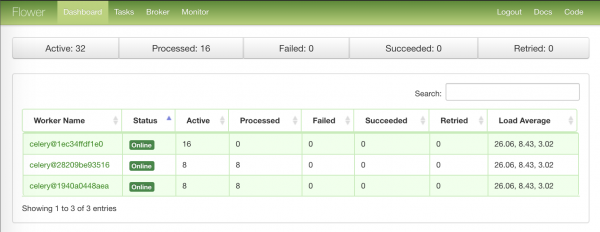
Najprv stránka so súhrnnými informáciami o uzloch-pracovníkoch:
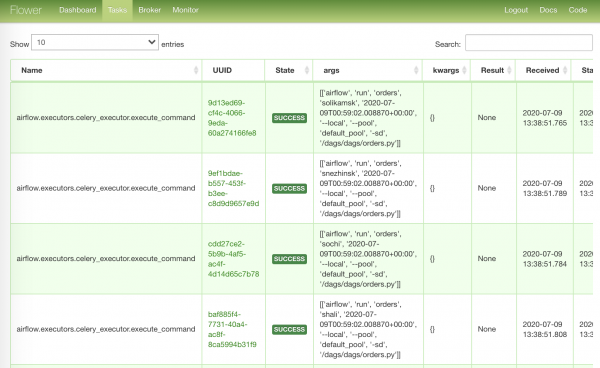
Najnasýtenejšia stránka so úlohami, ktoré sa dostali do spracovania:
Najbohatšia stránka so úlohami, ktoré sa odoslali na spracovanie:
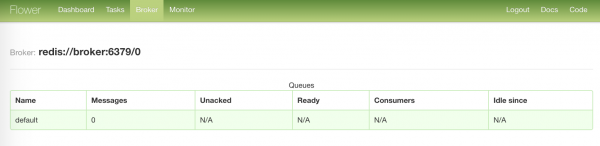
Najnudnejšia stránka so stavom nášho brokera:
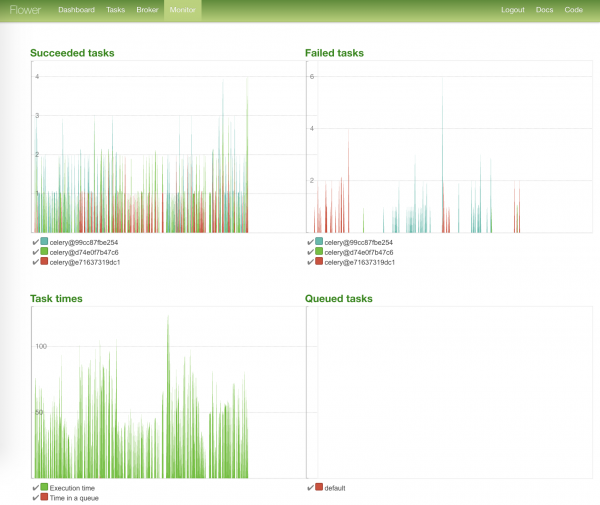
Najživšia stránka — s grafmi stavu úloh a ich časom vykonania:
Dohovoríme nedokončené
Takže všetky úlohy boli vykonané, môžeme odnášať ranených.
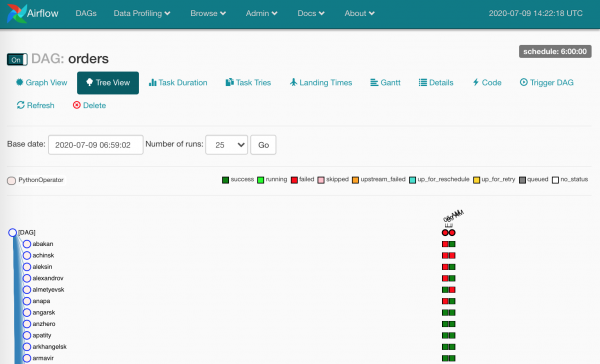
A ranených bolo dosť — z rôznych dôvodov. Pri správnom použití Airflow tieto štvorce naznačujú, že údaje sa určite nedostali.
Treba sa pozrieť do logu a reštartovať zlyhané inštancie úloh.
Kliknutím na akýkoľvek štvorec uvidíme dostupné akcie:
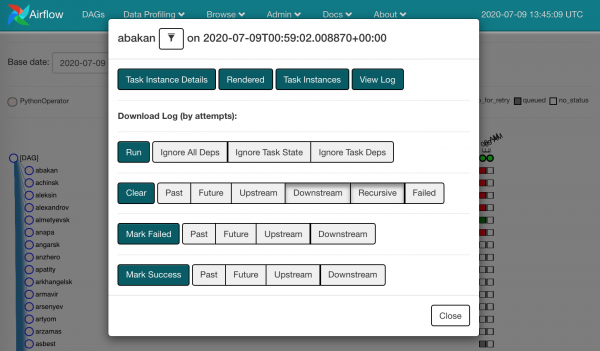
Môžeme vziať a zmazať zlyhanú. To znamená, že zabudneme na to, že sa niečo pokazilo, a tá istá inštancia úlohy pôjde k plánovaču.
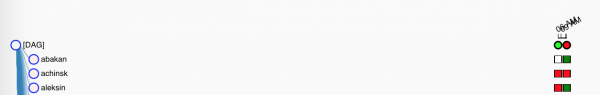
Je jasné, že takto myškou so všetkými červenými štvorcami sa veľmi humanne nezaobchádza — to nie je to, čo od Airflow očakávame. Samozrejme, máme zbraň hromadného ničenia: Prehľad/Úlohy
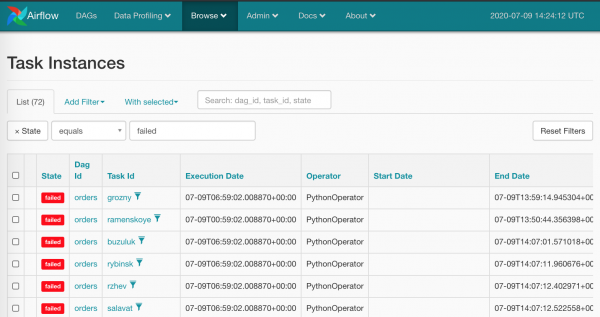
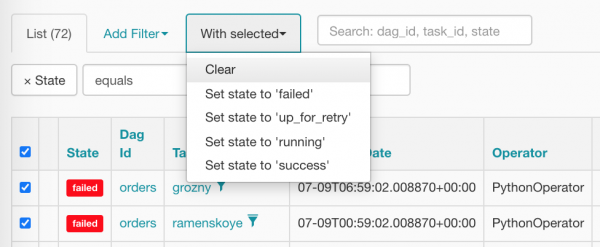
Vyberieme všetko naraz a stlačíme správnu možnosť:
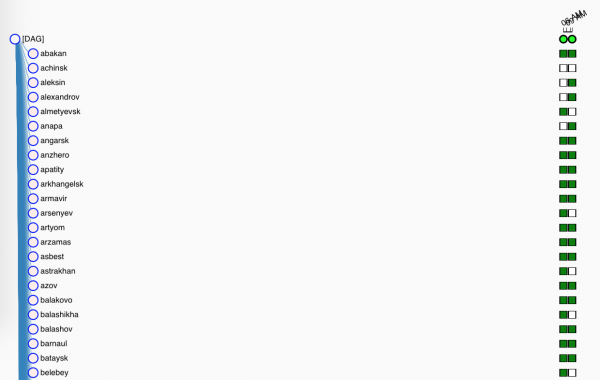
Po vyčistení naše úlohy vyzerajú takto (už sa nevedia dočkať, kedy ich plánovač naplánuje):
Pripojenia, hooky a iné premenné
Je najvyšší čas pozrieť sa na ďalší DAG, update_reports.py:
from collections import namedtuple
from datetime import datetime, timedelta
from textwrap import dedent

from airflow import DAG
from airflow.contrib.operators.vertica_operator import VerticaOperator
from airflow.operators.email_operator import EmailOperator
from airflow.utils.trigger_rule import TriggerRule

from commons.operators import TelegramBotSendMessage

dag = DAG('update_reports',
          start_date=datetime(2020, 6, 7, 6),
          schedule_interval=timedelta(days=1),
          default_args={'retries': 3, 'retry_delay': timedelta(seconds=10)})

Report = namedtuple('Report', 'source target')
reports = [Report(f'{table}_view', table) for table in [
    'reports.city_orders',
    'reports.client_calls',
    'reports.client_rates',
    'reports.daily_orders',
    'reports.order_duration']]

email = EmailOperator(
    task_id='email_success', dag=dag,
    to='{{ var.value.all_the_kings_men }}',
    subject='DWH Reports updated',
    html_content=dedent("""Dobrí páni, správy boli aktualizované"""),
    trigger_rule=TriggerRule.ALL_SUCCESS)

tg = TelegramBotSendMessage(
    task_id='telegram_fail', dag=dag,
    tg_bot_conn_id='tg_main',
    chat_id='{{ var.value.failures_chat }}',
    message=dedent("""
         Natália, zobuď sa, spadli sme {{ dag.dag_id }}
        """),
    trigger_rule=TriggerRule.ONE_FAILED)

for source, target in reports:
    queries = [f"TRUNCATE TABLE {target}",
               f"INSERT INTO {target} SELECT * FROM {source}"]

    report_update = VerticaOperator(
        task_id=target.replace('reports.', ''),
        sql=queries, vertica_conn_id='dwh',
        task_concurrency=1, dag=dag)

    report_update >> [email, tg]
Všetci sme niekedy robili aktualizačný report, však? Toto je ona znova: máme zoznam zdrojov, odkiaľ získať údaje; máme zoznam, kam ich uložiť; nezabudnime informovať, keď sa všetko stalo alebo niečo zlyhalo (no to sa nás netýka, nie).
Poďme sa znova pozrieť na súbor a skontrolovať nové nejasnosti:
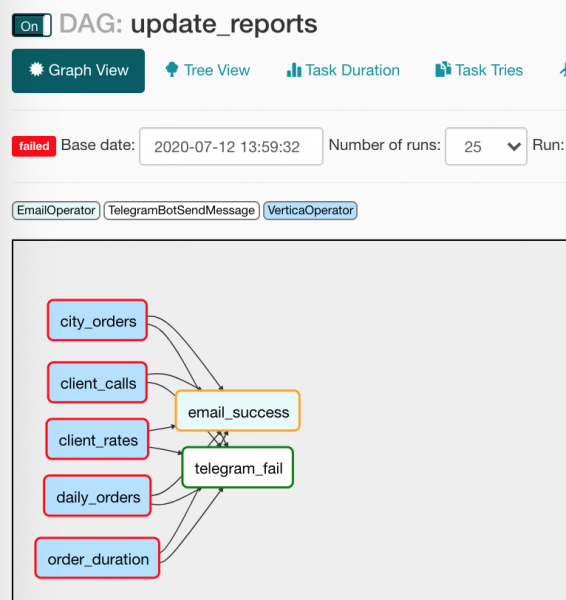
from commons.operators import TelegramBotSendMessage— nič nám nebráni vytvárať svoje operátory, čoho sme využili pri vytváraní malej obálky na odoslanie správ do Rozblokovaného. (O tomto operátore sa ešte porozprávame nižšie);default_args={}— DAG môže rozdávať tie isté argumenty všetkým svojim operátorom;to='{{ var.value.all_the_kings_men }}'— poletonebude tvrdokódované, ale dynamicky generované pomocou Jinja a premennej so zoznamom emailov, ktorú som starostlivo uložil doAdmin/Variables;trigger_rule=TriggerRule.ALL_SUCCESS— podmienka spustenia operátora. V našom prípade správa poletí šéfom iba vtedy, ak všetky závislosti prebehli úspešne;tg_bot_conn_id='tg_main'— argumentyconn_idprijímajú identifikátory pripojení, ktoré vytvárame vAdmin/Connections;trigger_rule=TriggerRule.ONE_FAILED— správy v Telegrame budú odoslané iba v prípade zlyhania úloh;task_concurrency=1— zakazujeme súčasné spustenie viacerých inštancií úlohy jedného úlohy. Inak dostaneme súčasné spustenie viacerýchVerticaOperator(ktoré sledujú jednu tabuľku);report_update >> [email, tg]— všetkoVerticaOperatorsa zíde na odoslanie e-mailu a správy, takto:

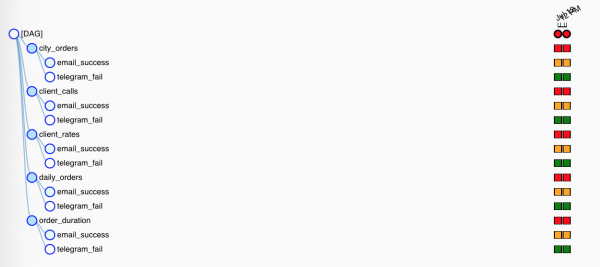
Ale pretože operátory-notifikátory majú rôzne podmienky spustenia, bude fungovať iba jeden. V zobrazení stromu to vyzerá o niečo menej prehľadne:

Poviem pár slov o makrách a ich priateľoch — premenných.
Makrá sú Jinja-placeholdery, ktoré môžu vkladať rôzne užitočné informácie do argumentov operátorov. Napríklad takto:
SELECT
    id,
    payment_dtm,
    payment_type,
    client_id
FROM orders.payments
WHERE
    payment_dtm::DATE = '{{ ds }}'::DATE
{{ ds }} rozvinie sa na obsah premennej kontextu execution_date vo formáte YYYY-MM-DD: 2020-07-14. Najlepšie na tom je, že kontextové premenné sú pripevnené k určitému inštancu úlohy (štvorčeku v zobrazení stromu), a pri reštarte sa placeholdery rozvinú na tie isté hodnoty.
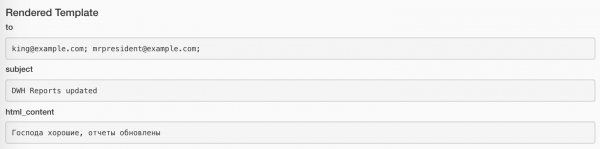
Priradené hodnoty si môžete pozrieť pomocou tlačidla Rendered na každom inštanci úlohy. Takto to vyzerá pre úlohu s odoslaním e-mailu:
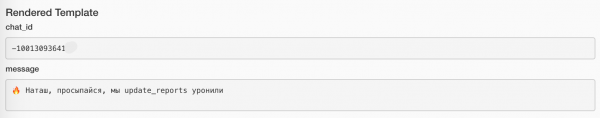
A takto pre úlohu s poslaním správy:
Kompletný zoznam vstavaných makier pre najnovšiu dostupnú verziu je k dispozícii tu:
Navyše pomocou pluginov môžeme vyhlasovať vlastné makrá, ale to už je úplne iný príbeh.
Okrem preddefinovaných vecí môžeme vkladať hodnoty svojich premenných (už som to využil vyššie v kóde). Vytvoríme v Admin/Variables pár vecí:
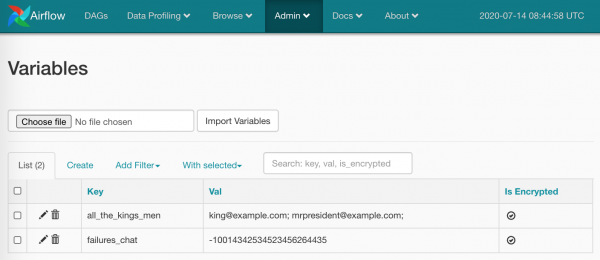
Hotovo, môže sa používať:
TelegramBotSendMessage(chat_id='{{ var.value.failures_chat }}')Hodnota môže byť skalar alebo môže obsahovať JSON. V prípade JSON-u:
bot_config

{
    "bot": {
        "token": 881hskdfASDA16641,
        "name": "Verter"
    },
    "service": "TG"
}
jednoducho použijeme cestu k potrebnému kľúču: {{ var.json.bot_config.bot.token }}.
Poviem doslova jedno slovo a ukážem jeden screenshot o pripojeniach. Tu je to všetko jednoduché: na stránke Admin/Connections vytvoríme pripojenie, uložíme tam naše prihlasovacie údaje/heslá a špecifickejšie parametre. Takto:
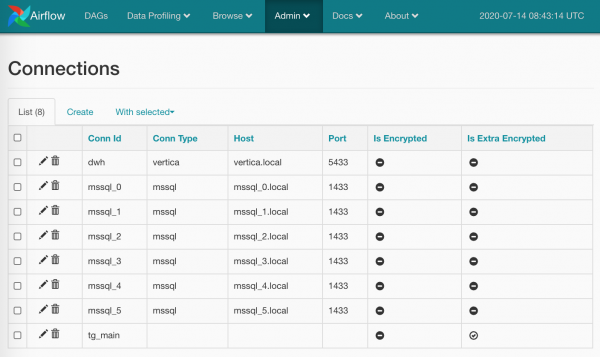
Heslá je možné šifrovať (dôkladnejšie než v predvolenom variante), alebo možno neuvádzať typ pripojenia (ako som to spravil pre tg_main) — ide o to, že zoznam typov je zabudovaný v modeloch Airflow a rozšírenie bez zasahovania do zdrojového kódu nie je možné (ak náhodou niečo nie je v Googli, prosím, opravte ma), ale získať kredity jednoducho podľa názvu nám nič nebráni.
A ešte je možné vytvoriť niekoľko pripojení s rovnakým názvom: v takom prípade metóda BaseHook.get_connection(), ktorá nám sprístupní pripojenia podľa názvu, bude vracať náhodného z niekoľkých rovnakých (bolo by logickejšie použiť Round Robin, ale to necháme na svedomí vývojárov Airflow).
Premenné a pripojenia sú bezpochyby skvelé nástroje, ale je dôležité nestratiť rovnováhu: ktoré časti vašich tokov uchovávate vlastne v kóde a ktorú odovzdávate na uloženie Airflow. Na jednej strane môže byť rýchla zmena hodnoty, napríklad e-mailový box, cez UI pohodlná. Na druhej strane — je to predsa len návrat k myškovému klikaniu, od ktorého sme (ja) chceli uniknúť.
Práca s pripojeniami je jednou z úloh hookov. Vo všeobecnosti sú hooky Airflow bodmi pripojenia k externým službám a knižniciam. Napríklad, JiraHook otvorí pre nás klienta na interakciu s Jira (môžeme s úlohami hýbať sem-tam), a s pomocou SambaHook je možné poslať lokálny súbor na smb-bod.
Rozoberáme vlastný operátor
A už sa dostávame k tomu, aby sme si pozreli, ako je vytvorený TelegramBotSendMessage
Kód commons/operators.py s vlastným operátorom:
z typing import Union

z airflow.operators import BaseOperator

z commons.hooks import TelegramBotHook, TelegramBot

class TelegramBotSendMessage(BaseOperator):
    """Odosielanie správy do chat_id pomocou TelegramBotHook

    Príklad:
        >>> TelegramBotSendMessage(
        ...     task_id='telegram_fail', dag=dag,
        ...     tg_bot_conn_id='tg_bot_default',
        ...     chat_id='{{ var.value.all_the_young_dudes_chat }}',
        ...     message='{{ dag.dag_id }} zlyhal :(',
        ...     trigger_rule=TriggerRule.ONE_FAILED)
    """
    template_fields = ['chat_id', 'message']

    def __init__(self,
                 chat_id: Union[int, str],
                 message: str,
                 tg_bot_conn_id: str = 'tg_bot_default',
                 *args, **kwargs):
        super().__init__(*args, **kwargs)

        self._hook = TelegramBotHook(tg_bot_conn_id)
        self.client: TelegramBot = self._hook.client
        self.chat_id = chat_id
        self.message = message

    def execute(self, context):
        print(f'Odosielam "{self.message}" do chatu {self.chat_id}')
        self.client.send_message(chat_id=self.chat_id,
                                 message=self.message)
Tu, ako aj ostatné v Airflow, je to veľmi jednoduché:
- Dedičstvo od
BaseOperator, ktorý implementuje dosť veľa špecifických vecí pre Airflow (pozrite si to vo voľnom čase) - Vyhlásili sme polia
template_fields, v ktorých Jinja bude hľadať makrá na spracovanie. - Usporiadali sme vhodné argumenty pre
__init__(), nastavili sme predvolené hodnoty tam, kde je to potrebné. - Na inicializáciu predka sme tiež nezabudli.
- Otvorte príslušný hook
TelegramBotHook, získali sme od neho klientský objekt. - Preevidujeme (override) metódu
BaseOperator.execute(), ktorú Airflow spustí, keď nastane čas na spustenie operátora – tam implementujeme hlavnú akciu, nezabúdajúc sa prihlásiť. (Prihlasujeme sa, mimochodom, rovno dostdoutastderr– Airflow to všetko zachytí, pekne zabalí a uloží na správne miesto.)
Pozrime sa, čo máme v commons/hooks.py. Prvá časť súboru, s hookom:
z typing import Union

z airflow.hooks.base_hook import BaseHook
z requests_toolbelt.sessions import BaseUrlSession

class TelegramBotHook(BaseHook):
    """Telegram Bot API hook

    Poznámka: pridajte pripojenie s prázdnym Conn Type a nezabudnite
    vyplniť Extra:

        {"bot_token": "YOuRAwEsomeBOtToKen"}
    """
    def __init__(self,
                 tg_bot_conn_id='tg_bot_default'):
        super().__init__(tg_bot_conn_id)

        self.tg_bot_conn_id = tg_bot_conn_id
        self.tg_bot_token = None
        self.client = None
        self.get_conn()

    def get_conn(self):
        extra = self.get_connection(self.tg_bot_conn_id).extra_dejson
        self.tg_bot_token = extra['bot_token']
        self.client = TelegramBot(self.tg_bot_token)
        return self.client
Ani neviem, čo by sa tu dalo vysvetliť, len zdôrazním dôležité body:
- Dedičstvo, premýšľanie nad argumentmi – v drvivej väčšine prípadov bude len jeden:
conn_id; - Predefinovanie štandardných metód: obmedzil som sa na
get_conn(), v ktorom získavam parametre pripojenia podľa názvu a len vyberám sekciu.extra(toto políčko pro JSON), do kterého jsem (podle svých pokynů!) umístil token Telegram bota:{"bot_token": "YOuRAwEsomeBOtToKen"}. - Vytvářím instanci našeho
TelegramBot, přičemž mu již dávám konkrétní token.
A je to. Klienta lze získat z hooku pomocí TelegramBotHook().clent alebo TelegramBotHook().get_conn().
A druhá část souboru, ve které vytvářím mikroobal pro Telegram REST API, abych nemusel tahat stejný kvůli jedné metodě sendMessage.
class TelegramBot:
    """Obal pro Telegram Bot API

    Příklady:
        >>> TelegramBot('YOuRAwEsomeBOtToKen', '@myprettydebugchat').send_message('Ahoj, zlato')
        >>> TelegramBot('YOuRAwEsomeBOtToKen').send_message('Ahoj, zlato', chat_id=-1762374628374)
    """
    API_ENDPOINT = 'https://api.telegram.org/bot{}/'

    def __init__(self, tg_bot_token: str, chat_id: Union[int, str] = None):
        self._base_url = TelegramBot.API_ENDPOINT.format(tg_bot_token)
        self.session = BaseUrlSession(self._base_url)
        self.chat_id = chat_id

    def send_message(self, message: str, chat_id: Union[int, str] = None):
        method = 'sendMessage'

        payload = {'chat_id': chat_id or self.chat_id,
                   'text': message,
                   'parse_mode': 'MarkdownV2'}

        response = self.session.post(method, data=payload).json()
        if not response.get('ok'):
            raise TelegramBotException(response)

class TelegramBotException(Exception):
    def __init__(self, *args, **kwargs):
        super().__init__((args, kwargs))
Správná cesta je všechno toto spojit:
TelegramBotSendMessage,TelegramBotHook,TelegramBot— do pluginu, uložit do veřejného repozitáře a vydat jako Open Source.
Zatímco jsme to všechno studovali, naše aktualizace zpráv stihly úspěšně naběhnout a poslat mi na kanál zprávu o chybě. Jdu zkontrolovat, co zase není v pořádku…
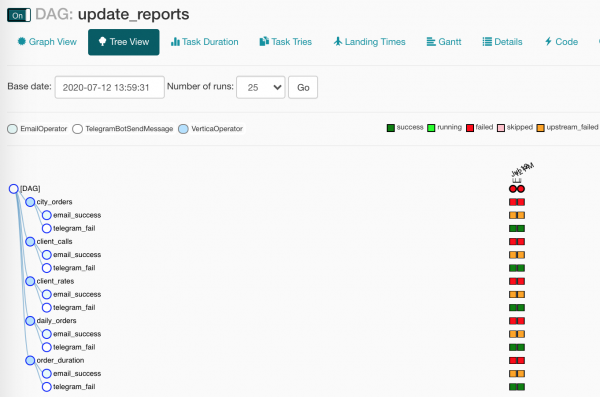
V našem DAGu se něco rozbilo! A to jsme nečekali? Přesně!
Budeš nalievať?
Cítíte, že jsem něco vynechal? Zdá se, že jsem slíbil přenášet data z SQL Serveru do Vertica, a teď jsem se od tématu odchýlil, zlý!
Ten čin byl záměrný, musel jsem vám objasnit nějakou terminologii. Teď můžeme pokračovat.
Naš plán byl takový:
- Vytvořit DAG
- Vygenerovat úkoly
- Podívat se, jak to vypadá hezky
- Přiřazovat nahrávkám čísla sezení
- Získat data z SQL Serveru
- Uložit data do Vertica
- Shromáždit statistiky
Takže, abych to všechno spustil, udělal jsem malé doplnění k našemu docker-compose.yml:
docker-compose.db.yml
verzia: '3.4'

x-mssql-base: &mssql-base
  image: mcr.microsoft.com/mssql/server:2017-CU21-ubuntu-16.04
  restart: always
  environment:
    ACCEPT_EULA: Y
    MSSQL_PID: Express
    SA_PASSWORD: SayThanksToSatiaAt2020
    MSSQL_MEMORY_LIMIT_MB: 1024

services:
  dwh:
    image: jbfavre/vertica:9.2.0-7_ubuntu-16.04

  mssql_0:
    <<: *mssql-base

  mssql_1:
    <<: *mssql-base

  mssql_2:
    <<: *mssql-base

  mssql_init:
    image: mio101/py3-sql-db-client-base
    command: python3 ./mssql_init.py
    depends_on:
      - mssql_0
      - mssql_1
      - mssql_2
    environment:
      SA_PASSWORD: SayThanksToSatiaAt2020
    volumes:
      - ./mssql_init.py:/mssql_init.py
      - ./dags/commons/datasources.py:/commons/datasources.py
Tam zdvíhame:
- Vertica ako host
dwhs najbežnejšími nastaveniami, - tri inštancie SQL Server,
- naplníme databázy v posledných niekoľkými údajmi (určite sa nepozerajte do
mssql_init.py!)
Spúšťame všetko pomocou o niečo zložitejšieho príkazu ako minule:
$ docker-compose -f docker-compose.yml -f docker-compose.db.yml up --scale worker=3Čo vygeneroval náš zázrak náhodného generátora, sa dá získať použitím položky Data Profiling/Ad Hoc Query:
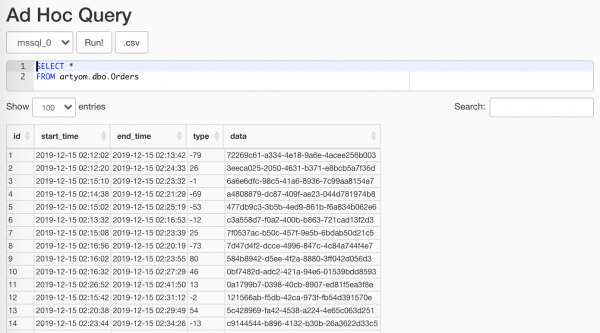
Hlavne to neukazovať analytikom
Podrobne sa nebudem zaoberať ETL-session tam je všetko triviálne: vytvoríme databázu, v nej tabuľku, obalíme všetko manažérom kontextu a teraz urobíme takto:
with Session(task_name) as session:
    print('Load', session.id, 'started')

    # Load workflow
    ...

    session.successful = True
    session.loaded_rows = 15
session.py
z sys import stderr

class Session:
    """ETL pracovná relácia

    Príklad:
        with Session(task_name) as session:
            print(session.id)
            session.successful = True
            session.loaded_rows = 15
            session.comment = 'Dobre vykonané'
    """

    def __init__(self, connection, task_name):
        self.connection = connection
        self.connection.autocommit = True

        self._task_name = task_name
        self._id = None

        self.loaded_rows = None
        self.successful = None
        self.comment = None

    def __enter__(self):
        return self.open()

    def __exit__(self, exc_type, exc_val, exc_tb):
        if any(exc_type, exc_val, exc_tb):
            self.successful = False
            self.comment = f'{exc_type}: {exc_val}n{exc_tb}'
            print(exc_type, exc_val, exc_tb, file=stderr)
        self.close()

    def __repr__(self):
        return (f'')

    @property
    def task_name(self):
        return self._task_name

    @property
    def id(self):
        return self._id

    def _execute(self, query, *args):
        with self.connection.cursor() as cursor:
            cursor.execute(query, args)
            return cursor.fetchone()[0]

    def _create(self):
        query = """
            CREATE TABLE IF NOT EXISTS sessions (
                id          SERIAL       NOT NULL PRIMARY KEY,
                task_name   VARCHAR(200) NOT NULL,

                started     TIMESTAMPTZ  NOT NULL DEFAULT current_timestamp,
                finished    TIMESTAMPTZ           DEFAULT current_timestamp,
                successful  BOOL,

                loaded_rows INT,
                comment     VARCHAR(500)
            );
            """
        self._execute(query)

    def open(self):
        query = """
            INSERT INTO sessions (task_name, finished)
            VALUES (%s, NULL)
            RETURNING id;
            """
        self._id = self._execute(query, self.task_name)
        print(self, 'otvorený')
        return self

    def close(self):
        if not self._id:
            raise SessionClosedError('Relácia nie je otvorená')
        query = """
            UPDATE sessions
            SET
                finished    = DEFAULT,
                successful  = %s,
                loaded_rows = %s,
                comment     = %s
            WHERE
                id = %s
            RETURNING id;
            """
        self._execute(query, self.successful, self.loaded_rows,
                      self.comment, self.id)
        print(self, 'uzavretý',
              ', úspešný: ', self.successful,
              ', Načítané: ', self.loaded_rows,
              ', komentár:', self.comment)

class SessionError(Exception):
    pass

class SessionClosedError(SessionError):
    pass
Prišiel čas získať naše dáta z našich vyše sto tabuliek. Urobíme to pomocou veľmi jednoduchých riadkov:
source_conn = MsSqlHook(mssql_conn_id=src_conn_id, schema=src_schema).get_conn()

query = f"""
    SELECT
        id, start_time, end_time, type, data
    FROM dbo.Orders
    WHERE
        CONVERT(DATE, start_time) = '{dt}'
    """

df = pd.read_sql_query(query, source_conn)- Pomocou hooku získame z Airflow
pymssql-konnect - Do dopytu vložíme obmedzenie vo forme dátumu — funkcia to pridá pomocou šablónovača.
- Podáme náš dopyt
pandas, ktorý pre nás získaDataFrame— ten nám bude neskôr užitočný.
Používam substitúciu
{dt}namiesto parametra dopytu%snie preto, že by som bol zlý Buratino, ale preto, žepandasnedokáže sa vyrovnať spymssqla podsúva to poslednémuparams: Zoznam, hoci ten veľmi chcetuple.
Taktiež si všimnite, že vývojárpymssqlsa rozhodol ďalej ho nepodporovať a je najvyšší čas presťahovať sa napyodbc.
Pozrime sa, čím Airflow naplnil argumenty našich funkcií:
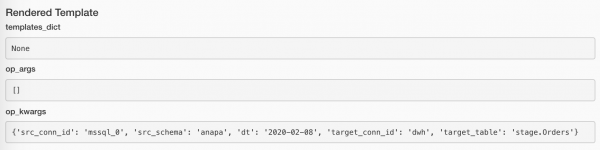
Ak sa žiadne dáta nenašli, nemá zmysel pokračovať. Ale považovať načítanie za úspešné je tiež divné. Ale to nie je chyba. A-a-a, čo robiť?! A tu je riešenie:
if df.empty:
    raise AirflowSkipException('Žiadne riadky na načítanie')
AirflowSkipException povie Airflow, že chyba vlastne nie je, a úlohu preskočíme. V rozhraní nebude zelený ani červený štvorček, ale farba ružová.
Pridáme našim dátam niekoľko stĺpcov:
df['etl_source'] = src_schema
df['etl_id'] = session.id
df['hash_id'] = hash_pandas_object(df[['etl_source', 'id']])
A konkrétne:
- DB, z ktorej sme vzali objednávky,
- Identifikátor našej nahrávacej relácie (bude sa líšiť pre každú úlohu),
- Hash zdroja a identifikátora objednávky — aby sme mali v konečnej databáze (kde sa všetko zhrnie do jednej tabuľky) jedinečný identifikátor objednávky.
Zostáva predposledný krok: nahrať všetko do Vertica. A, ako je to zvláštne, jeden z najefektívnejších spôsobov, ako to urobiť, je cez CSV!
# Export data to CSV buffer
buffer = StringIO()
df.to_csv(buffer,
          index=False, sep='|', na_rep='NUL', quoting=csv.QUOTE_MINIMAL,
          header=False, float_format='%.8f', doublequote=False, escapechar='\')
buffer.seek(0)

# Push CSV
target_conn = VerticaHook(vertica_conn_id=target_conn_id).get_conn()

copy_stmt = f"""
    COPY {target_table}({df.columns.to_list()})
    FROM STDIN
    DELIMITER '|'
    ENCLOSED '"'
    ABORT ON ERROR
    NULL 'NUL'
    """

cursor = target_conn.cursor()
cursor.copy(copy_stmt, buffer)- Vytvoríme špeciálny prijímač
StringIO. pandasvstřícne ukladáme našeDataFramevo formeCSV-riadky.- Otvoríme pripojenie k našej obľúbenej Vertice cez hook.
- A teraz pomocou
copy()pošleme naše dáta priamo do Vertiky!
Z drivera získame, koľko riadkov bolo nahraných, a povieme manažérovi relácie, že všetko je OK:
session.loaded_rows = cursor.rowcount
session.successful = True
A to je všetko.
Na produ máme cieľovú tabuľku vytvorenú ručne. Tu som si dovolil malú automatizáciu:
create_schema_query = f'CREATE SCHEMA IF NOT EXISTS {target_schema};'
create_table_query = f"""
    CREATE TABLE IF NOT EXISTS {target_schema}.{target_table} (
         id         INT,
         start_time TIMESTAMP,
         end_time   TIMESTAMP,
         type       INT,
         data       VARCHAR(32),
         etl_source VARCHAR(200),
         etl_id     INT,
         hash_id    INT PRIMARY KEY
     );"""

create_table = VerticaOperator(
    task_id='create_target',
    sql=[create_schema_query,
         create_table_query],
    vertica_conn_id=target_conn_id,
    task_concurrency=1,
    dag=dag)
S pomocou
VerticaOperator()vytváram schému DB a tabuľku (ak ešte neexistujú, samozrejme). Hlavné je správne nastaviť závislosti:
for conn_id, schema in sql_server_ds:
    load = PythonOperator(
        task_id=schema,
        python_callable=workflow,
        op_kwargs={
            'src_conn_id': conn_id,
            'src_schema': schema,
            'dt': '{{ ds }}',
            'target_conn_id': target_conn_id,
            'target_table': f'{target_schema}.{target_table}'},
        dag=dag)

    create_table >> load
Zhrnieme to
— No vidíš, — povedal myš, — nie je pravda, že teraz
Už si sa presvedčil, že v lese som ja najstrašnejšia šelma?
Julia Donaldson, „Gruffalo“
Myslím, že keby sme s mojimi kolegami usporiadali súťaž: kto rýchlejšie vytvorí a spustí ETL proces od nuly: oni so svojím SSIS a myšou a ja s Airflow… A potom by sme ešte porovnali pohodlie pri údržbe… Uf, myslím, že súhlasíte, že ich vo všetkých aspektoch predbehnem!
Ak trochu vážnejšie, tak Apache Airflow – vďaka opisovaniu procesov ako programového kódu – urobil moju prácu oveľa pohodlnejšou a príjemnejšou.
Jeho neobmedzené rozšírenie: či už pokiaľ ide o pluginy, tak aj predispozícia k škálovateľnosti – vám dáva možnosť aplikovať Airflow v prakticky akejkoľvek oblasti: buď v kompletnom cykle zbierania, prípravy a spracovania údajov, alebo pri spúšťaní rakiet (na Mars, samozrejme).
Záverečná časť, informativná
Zlomy, ktoré sme pre vás zhromaždili
start_date. Áno, to už je lokálny meme. Skrz hlavný argument DAGustart_dateprechádzajú všetky. Stručne povedané, ak sa uvedie vstart_dateaktuálny dátum, a vschedule_interval– jeden deň, tak DAG sa spustí zajtra najskôr.start_date = datetime(2020, 7, 7, 0, 1, 2)A viac žiadne problémy.
S tým je spojená aj ďalšia chyba vykonávania:
Task is missing the start_date parameter, ktorá najčastejšie hovorí o tom, že ste zabudli priradiť k operátorovi DAG.- Všetko na jednom stroji. Áno, a databázy (sám Airflow a naša vrstva), webový server, plánovač a pracovníci. A dokonca to fungovalo. Ale s časom počet úloh na službách rástol, a keď sa PostgreSQL začal odpovedať cez index za 20 ms namiesto 5, vzali sme ho a presunuli.
- LocalExecutor. Áno, používame ho dodnes, a už sme sa dostali na okraj priepasti. LocalExecutor nám doteraz stačil, ale teraz nastal čas rozšíriť sa minimálne o jedného pracovníka, a budeme musieť trochu zapriahnúť, aby sme prešli na CeleryExecutor. A vzhľadom na to, že s ním sa dá pracovať aj na jednom stroji, nič nebráni používať Celery aj na serveri, ktorý „samozrejme nikdy nepôjde do produkcie, sľubujem!“
- Nevyužívanie vstavaných nástrojov:
- Connections na ukladanie autentifikačných údajov služieb,
- SLA Misses na reakciu na úlohy, ktoré neboli vykonané včas,
- XCom na výmenu metadát (povedal som metaúdaje!) medzi úlohami DAGu.
- Zneužívanie e-mailu. Čo k tomu povedať? Bola nastavená upozornenia na všetky opakované pády úloh. Teraz mám vo svojom pracovnom Gmaili viac ako 90k e-mailov od Airflow a webové rozhranie e-mailu odmieta odstraňovať viac ako 100 naraz.
Viac skrytých prekážok:
Prostriedky ešte väčšej automatizácie
Aby sme mohli ešte viac pracovať hlavou a nie rukami, Airflow nám pripravilo toto:
- — stále má status Experimentálne, čo mu však nebráni v prevádzke. Pomocou neho môžete získať nielen informácie o dagoch a úlohách, ale tiež zastaviť/spustiť dag, vytvoriť DAG Run alebo pool.
- — cez príkazový riadok sú dostupné mnohé nástroje, ktoré nie sú len nepríjemné na používanie cez WebUI, ale dokonca vôbec chýbajú. Napríklad:
backfillje potrebný na opätovné spustenie inštancií úloh.
Napríklad, analytici prídu a povedia: „A vy, pán, máte neporiadok v dátach od 1. do 13. januára! Opravujte, opravujte, opravujte!“. A ty tak hups:airflow backfill -s '2020-01-01' -e '2020-01-13' orders- Údržba databázy:
initdb,resetdb,upgradedb,checkdb. run, ktorý umožňuje spustiť jednu inštanciu úlohy, a to bez ohľadu na všetky závislosti. Navyše, môžete ho spustiť cezLocalExecutor, aj keď máte Celery klaster.- Približne to isté robí
test, lenže neukladá do databázy. connectionsumožňuje hromadne vytvárať pripojenia z shellu.
- — dosť hardcore spôsob interakcie, ktorý je určený pre pluginy, a nie pre domácu prácu s ním. Ale kto nás zastaví ísť do
/home/airflow/dags, spustiťipythona začať experimentovať? Môžete napríklad exportovať všetky pripojenia takýmto kódom:from airflow import settings from airflow.models import Connection fields = 'conn_id conn_type host port schema login password extra'.split() session = settings.Session() for conn in session.query(Connection).order_by(Connection.conn_id): d = {field: getattr(conn, field) for field in fields} print(conn.conn_id, '=', d) - Pripojenie k databáze metadát Airflow. Neporúčam do nej zapisovať, ale stiahnuť stavy úloh pre rôzne špecifické metriky je možné oveľa rýchlejšie a jednoduchšie ako cez ktorýkoľvek z API.
Povedzme, že nie všetky naše úlohy sú idempotentné, a môžu občas zlyhať, čo je normálne. Ale niekoľko pádov — to už je podozrivé, a mali by sme to skontrolovať.
Pozor, SQL!
S POSLEDNÝMI_EXECUTIONS TAKTO (
VYBERTE
    task_id,
    dag_id,
    execution_date,
    state,
        row_number()
        OVER (
            PARTITION BY task_id, dag_id
            ORDER BY execution_date DESC) AS rn
Z public.task_instance
KDE
    execution_date > now() - INTERVAL '2' DAY
),
neúspešné AS (
    VYBERTE
        task_id,
        dag_id,
        execution_date,
        state,
        CASE WHEN rn = row_number() OVER (
            PARTITION BY task_id, dag_id
            ORDER BY execution_date DESC)
                 THEN TRUE END AS last_fail_seq
    Z posledných_executions
    KDE
        state IN ('failed', 'up_for_retry')
)
VYBERTE
    task_id,
    dag_id,
    count(last_fail_seq)                       AS unsuccessful,
    count(CASE WHEN last_fail_seq
        AND state = 'failed' THEN 1 END)       AS failed,
    count(CASE WHEN last_fail_seq
        AND state = 'up_for_retry' THEN 1 END) AS up_for_retry
Z neúspešných
GROUP BY
    task_id,
    dag_id
HAVING
    count(last_fail_seq) > 0
Odkazy
No a samozrejme prvých desať odkazov z Googlu obsahuje priečinok Airflow z mojich záložiek.
- — samozrejme, treba začať s oficiálnou dokumentáciou, ale kto už číta návody?
- — aspoň odporúčania od tvorcov si prečítajte.
- — je to len začiatok: užívateľské rozhranie na obrázkoch
- — dobre sú popísané základné pojmy, ak (náhodou!) ste niečo nepochopili u mňa.
- — stručný sprievodca pre nastavenie clústra Airflow.
- — takmer rovnako zaujímavý článok, akurát že viac formalít a menej príkladov.
- — o spolupráci s Celery.
- — o idempotencii úloh, načítavaní podľa ID namiesto dátumu, transformáciách, štruktúre súborov a ďalších zaujímavých veciach.
- — závislosti úloh a Trigger Rule, ktoré som spomenul len okrajovo.
- — ako prekonať niektoré "funguje, ako má" u plánovača, načítať stratené dáta a stanoviť priority úloh.
- — užitočné SQL dotazy na metadáta Airflow.
- — je tam užitočná sekcia o vytvorení vlastného senzora.
- — zaujímavá krátka poznámka o budovaní infraštruktúry na AWS pre Data Science.
- — bežné chyby (keď náhodou niekto predsa len nečíta návody).
- — usmievajte sa, ako ľudia obchádzajú ukladanie hesiel, aj keď by sa dali jednoducho použiť pripojenia.
- — implicit DAG forwarding, context passing in functions, again about dependencies, and also about skipping task executions.
- — o používaní
predvolené argumentyaparamsv šablónach, a tiež o Variables a Connections. - — príbeh o tom, ako sa plánovač pripravuje na Airflow 2.0.
- — trošku zastaraný článok o nasadení nášho klastru v
docker-compose. - — dynamické úlohy pomocou šablón a preposielania kontextu.
- — štandardné a vlastné oznámenia prostredníctvom e-mailu a Slacku.
- — Vetvenie úloh, makrá a XCom.
A odkazy použité v článku:
- — dostupné pre použitie v šablónach.
- — Bežné chyby pri vytváraní DAG-ov.
- —
docker-composepre experimenty, ladenie a nielen to. - — Python obal pre Telegram REST API.
Zdroj: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish