

V roku 2017 sme vyhrali súťaž na vypracovanie transakčného jadra investičného biznisu Alfa-Banku a začali sme pracovať (na HighLoad++ 2018 s prednáškou o jadre investičného biznisu Vladimir Drynkin, vedúci smerovania transakčného jadra investičného biznisu Alfa-Banku). Tento systém mal agregovať údaje o transakciách z rôznych zdrojov v rôznych formátoch, zjednocovať údaje, uchovávať ich a poskytovať k nim prístup.
V procese vývoja systém evolvoval a rozširoval sa funkciami, a v istom momente sme si uvedomili, že sa nám formuje niečo omnoho väčšie než len aplikačný softvér vytvorený na riešenie striktne definovaného okruhu úloh: dostali sme systém na tvorbu distribuovaných aplikácií s trvalým úložiskom. Získaná skúsenosť sa stala základom nového produktu — (TDG).
Chcem sa podeliť o architektúru TDG a o tých rozhodnutiach, ku ktorým sme dospeli počas vývoja, oboznámiť vás so základnými funkciami a ukázať, ako sa náš produkt môže stať základom na tvorbu komplexných riešení.
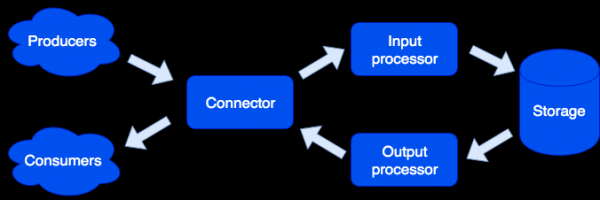
Architektonicky sme systém rozdelili na jednotlivé úlohy, pričom každá z nich je zodpovedná za riešenie určitého okruhu úloh. Jeden spustený prípad aplikácie realizuje jeden alebo niekoľko typov úloh. V klastri môže existovať niekoľko úloh rovnakého typu:
Connector
Connector zodpovedá za spojenie s vonkajším svetom; jeho úlohou je prijať požiadavku, analyzovať ju a ak to bolo úspešné, zaslať údaje na spracovanie do input processoru. Podporujeme formáty HTTP, SOAP, Kafka, FIX. Architektúra umožňuje jednoducho pridávať podporu nových formátov, čoskoro bude dostupná podpora IBM MQ. Ak analýza požiadavky skončila chybou, connector vráti chybu; inak odpovie, že požiadavka bola úspešne spracovaná, aj keď pri jej ďalšom spracovaní došlo k chybe. Toto je urobené úmyselne, aby sa dalo pracovať so systémami, ktoré nevedia opakovať požiadavky — alebo naopak, robia to príliš dôrazne. Aby sme nestratili údaje, používame opravársku frontu: objekt sa najprv dostane do nej a až po úspešnom spracovaní sa z nej odstráni. Administrátor môže dostávať upozornenia na objekty, ktoré zostali v opravárskej fronte, a po odstránení programovej chyby alebo hardvérovej poruchy vykonať opakovaný pokus.
Input processor
Input processor klasifikuje prijaté údaje podľa ich charakteristických znakov a aktivuje vhodné spracovateľské moduly. Spracovateľské moduly sú kód v jazyku Lua, ktorý sa vykonáva v pieskovisku, takže nemôžu ovplyvniť fungovanie systému. V tejto fáze je možné upraviť údaje na požadovaný formát a v prípade potreby spustiť ľubovoľný počet úloh, ktoré môžu implementovať potrebnú logiku. Napríklad v produkte MDM (Master Data Management), postavenom na Tarantool Data Grid, pri pridávaní nového používateľa, aby sme nezpomalili spracovanie požiadavky, vytvorenie zlatého záznamu spúšťame ako samostatnú úlohu. Pieskovisko podporuje požiadavky na čítanie, úpravy a pridávanie údajov a umožňuje vykonanie určitej funkcie na všetkých úrovniach typu storage a agregáciu výsledku (map/reduce).
Spracovateľské moduly môžu byť popísané v súboroch:
sum.lua

local x, y = unpack(...)
return x + y
A potom deklarované v konfigurácii:
functions:
  sum: { __file: sum.lua }
Prečo Lua? Lua je veľmi jednoduchý jazyk. Na základe našich skúseností, po pár hodinách strávených s ním, ľudia začnú písať kód, ktorý rieši ich úlohu. A to nielen profesionálni vývojári, ale napríklad aj analytici. Okrem toho, vďaka jit-kompilačnému mechanizmu, Lua funguje veľmi rýchlo.
Storage
Úložisko uchováva trvalé údaje. Pred uložením údaje prechádzajú validáciou na súlad so schémou údajov. Na popis schémy používame rozšírený formát. . Príklad:
{
    "name": "User",
    "type": "record",
    "logicalType": "Aggregate",
    "fields": [
        { "name": "id", "type": "string"},
        {"name": "first_name", "type": "string"},
        {"name": "last_name", "type": "string"}
    ],
    "indexes": ["id"]
}
Na základe tohto popisu sa automaticky generuje DDL (Data Definition Language) pre SÚDB Taranthul a schéma na prístup k údajom.
Podporuje sa asynchrónna replikácia údajov (plánuje sa pridať synchronná).
Výstupný procesor
Niekedy je potrebné upozorniť externých spotrebiteľov na príchod nových údajov, na to existuje úloha výstupného procesora. Po uložení údajov môžu byť odoslané do príslušného spracovateľa (napríklad, aby sa uviedli do podoby, ktorú spotrebiteľ vyžaduje) — a následne odoslané do konektora na zaslanie. Tu sa tiež používa opravárenská fronta: ak nikto objekt neprijal, správca môže skúsiť znova neskôr.
Škálovanie
Úlohy konektora, vstupného procesora a výstupného procesora nemajú stav, čo nám umožňuje horizontálne škálovanie systému jednoducho pridaním nových inštancií aplikácie s aktivovanou úlohou požadovaného typu. Na horizontálne škálovanie sa používa k organizácii klastrov pomocou virtuálnych vedierok. Po pridaní nového servera sa časť vedierok zo starých serverov v pozadí presúva na nový server; to sa deje transparentne pre používateľov a nemá vplyv na prevádzku celého systému.
Vlastnosti údajov
Objekty môžu byť veľmi veľké a obsahovať ďalšie objekty. Zabezpečujeme atomickosť pridávania a aktualizácie údajov, pričom uchovávame objekt so všetkými závislosťami na jeden virtuálny vedierko. Týmto sa vylúči „rozmazávanie“ objektu po niekoľkých fyzických serveroch.
Podpora verzií: každá aktualizácia objektu vytvára novú verziu, a vždy môžeme urobiť časový rez a pozrieť sa, ako svet vyzeral vtedy. Pre dáta, ktoré nepotrebujú dlhú históriu, môžeme obmedziť počet verzií alebo dokonca ukladať iba jednu - poslednú, teda fakticky vypnúť verziovanie pre určitý typ. Rovnako môžeme obmedziť históriu podľa času: napríklad odstraňovať všetky objekty určitých typov staršie ako 1 rok. Podporovaná je aj archivácia: môžeme exportovať objekty staršie ako stanovený čas, čím uvoľňujeme miesto v klustri.
Úlohy
Medzi zaujímavými funkciami stojí za zmienku možnosť spúšťania úloh podľa rozvrhu, na požiadanie používateľa alebo programovo z pieskoviska:
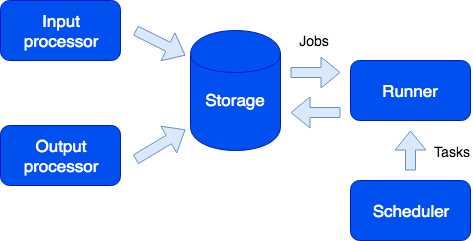
Tu vidíme ďalšiu úlohu - runner. Táto úloha nemá stav, a ak je to potrebné, do klustra môžeme pridať ďalšie inštancie aplikácie s touto úlohou. Zodpovednosť runnera je vykonávanie úloh. Ako bolo spomenuté, z pieskoviska je možné generovať nové úlohy; tieto sa ukladajú do fronty na storage a potom sa vykonávajú na runneri. Tento typ úloh sa nazýva Job. Rovnako máme typ úloh nazývaný Task - sú to úlohy definované používateľom a spúšťané podľa rozvrhu (využíva sa syntax cron) alebo na požiadanie. Na spúšťanie a sledovanie takýchto úloh máme pohodlný správca úloh. Aby bola táto funkčnosť dostupná, je potrebné zapnúť úlohu scheduler; táto úloha má stav, preto sa neskaluje, čo však nie je potrebné; zároveň môže mať replikáciu, ktorá sa aktivuje, ak majster zlyhá.
Logger
Ďalšia úloha sa nazýva logger. Zhromažďuje logy zo všetkých členov klustra a poskytuje rozhranie na ich export a prezeranie cez webové rozhranie.
Služby
Stojí za zmienku, že systém umožňuje ľahko vytvárať služby. V konfiguračnom súbore je možné špecifikovať, aké požiadavky smerovať na používateľom napísaný spracovateľ, ktorý beží v pieskovisku. V tomto spracovateľovi je možné napríklad vykonať nejaký analytický dotaz a vrátiť výsledok.
Služba je popísaná v konfiguračnom súbore:
services:
   sum:
      doc: "sčíta dve čísla"
      function: sum
      return_type: int
      args:
         x: int
         y: int
GraphQL API sa generuje automaticky a služba sa stáva dostupnou na volanie:
dopyt {
   suma(x: 1, y: 2)
}
To povedie k vyvolaniu spracovateľa sum, ktorý vráti výsledok:
3
Profilovanie dopytov a metriky
Na pochopenie fungovania systému a profilovania dopytov sme implementovali podporu protokolu OpenTracing. Systém môže na požiadanie posielať informácie nástrojom, ktoré tento protokol podporujú, ako je Zipkin, čo umožní zistiť, ako sa dopyt vykonával:
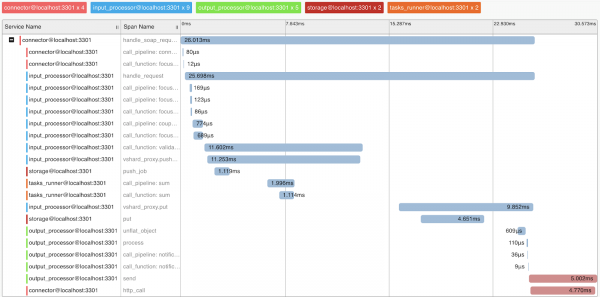
Samozrejme, systém poskytuje interné metriky, ktoré je možné zbierať pomocou Prometheus a vizualizovať pomocou Grafana.
Nasadenie
Tarantool Data Grid môže byť nasadený z RPM balíkov alebo archívu, pomocou nástrojov dodávaných s produktom alebo pomocou Ansible, je tiež podporované Kubernetes ().
Aplikácia realizujúca obchodnú logiku (konfigurácia, spracovatelia) sa nahráva do nasadeného clustera Tarantool Data Grid vo forme archívu prostredníctvom UI alebo pomocou skriptu, cez poskytované API.
Príklady aplikácií
Aké aplikácie je možné vytvoriť pomocou Tarantool Data Grid? V skutočnosti sú väčšina obchodných úloh tak či onak spojené so spracovaním toku údajov, ich uchovávaním a prístupom k nim. Preto, ak máte veľké toky údajov, ktoré je potrebné spoľahlivo uchovávať a mať k nim prístup, náš produkt vám môže ušetriť veľa času na vývoj a sústrediť sa na obchodnú logiku.
Napríklad, chceme zbierať informácie o realitnom trhu, aby sme neskôr mohli mať informácie o najlepších ponukách. V tomto prípade vypredíme nasledujúce úlohy:
- Roboty, ktoré zbierajú informácie z verejných zdrojov — to budú naše zdroje údajov. Túto úlohu môžete vyriešiť pomocou hotových riešení alebo napísaním kódu v akomkoľvek jazyku.
- Ďalej Tarantool Data Grid prijme a uloží údaje. Ak sa formát údajov z rôznych zdrojov líši, môžete napísať kód v jazyku Lua, ktorý vykoná zjednotenie formátu. V etape predspracovania tiež môžete napríklad filtrovať duplicitné ponuky alebo dodatočne aktualizovať v databáze informácie o agentoch, ktorí pôsobia na trhu.
- Teraz už máte škálovateľné riešenie v klastri, ktoré môžete naplniť dátami a robiť dotazy na dáta. Ďalej môžete implementovať novú funkcionalitu, napríklad napísať službu, ktorá vykoná dotaz na dáta a poskytne najvýhodnejšiu ponuku za deň – to si bude vyžadovať niekoľko riadkov v konfiguračnom súbore a trochu kódu v Lua.
Čo ďalej?
Našou prioritou je zvyšovanie pohodlia pri vývoji pomocou . Napríklad, je to IDE so podporou profilovania a ladenia obslužných programov pracujúcich v pieskovisku.
Taktiež venujeme veľkú pozornosť otázkam bezpečnosti. Práve teraz prechádzame certifikáciou FSTEK Ruska, aby sme potvrdili vysokú úroveň bezpečnosti a vyhoveli požiadavkám na certifikáciu softvérových produktov používaných v informačných systémoch osobných údajov a štátnych informačných systémoch.
Zdroj: habr.com
