

Ahoj, volám sa Sergej Jalancev, vyvíjam v Yandex.Cloud. Predtým som riadil vývoj L7 vyvažovača portálu Yandex — kolegovia žartujú, že čímkoľvek sa zaoberám, nakoniec sa z toho stane vyvažovač. Povieme čitateľom Habr, ako správne riadiť záťaž v cloudovej platforme, aký ideálny nástroj na dosiahnutie tohto cieľa vidíme a ako sa posúvame k budovaniu tohto nástroja.
Na začiatok zavedieme niekoľko termínov:
- VIP (Virtual IP) — IP adresa vyvažovača
- Server, backend, inštancia — virtuálny stroj so spustenou aplikáciou
- RIP (Real IP) — IP adresa servera
- Healthcheck — kontrola pripravenosti servera
- Availability Zone, AZ — izolovaná infraštruktúra v dátovom centre
- Región — zoskupenie rôznych AZ
Vyvažovače záťaže plnia tri hlavné úlohy: vykonávajú samotné vyvažovanie, zlepšujú odolnosť služby a uľahčujú jej škálovanie. Odolnosť sa zabezpečuje automatickým riadením prenosu: vyvažovač sleduje stav aplikácie a vylučuje z vyvažovania inštancie, ktoré neprešli kontrolou životnosti. Škálovanie sa zabezpečuje rovnomerným rozdelením záťaže medzi inštancie, ako aj aktualizáciou zoznamu inštancií za behu. Ak vyvažovanie nebude dostatočne rovnomerné, niektoré inštancie dostanú zaťaženie presahujúce ich pracovný limit a služba sa stane menej spoľahlivou.
Vyvažovač záťaže sa často klasifikuje podľa úrovne protokolu z modelu OSI, na ktorom pracuje. Vyvažovač Cloud pracuje na úrovni TCP, čo zodpovedá štvrtému úrovni, L4.
Prejdime na prehľad architektúry vyvažovača Cloud. Postupne zvyšujeme úroveň podrobnosti. Rozdeľujeme komponenty vyvažovača do troch tried. Trieda config plane zodpovedá za interakciu s používateľom a obsahuje cieľový stav systému. Control plane uchováva aktuálny stav systému a spravuje systémy z triedy data plane, ktoré sú zodpovedné priamo za doručenie prenosu od klientov k vašim inštanciám.
Data plane
Prevádzkový traffic prechádza cez nákladné zariadenia nazývané border routre. Na zvýšenie odolnosti voči výpadkom funguje v jednom dátovom centre súčasne viacero takýchto zariadení. Následne traffic prechádza na vyrovnávače záťaže, ktoré pre klientov ohlasujú anycast IP adresu na všetkých AZ cez BGP.
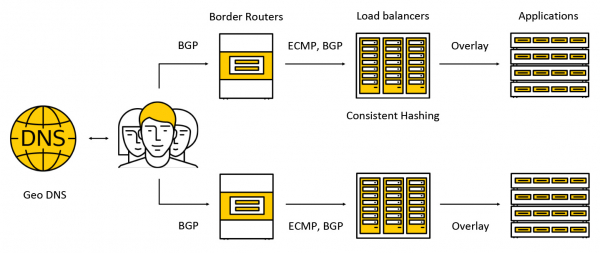
Traffic sa prenáša pomocou ECMP - to je stratégia smerovania, podľa ktorej môže existovať niekoľko rovnako dobrých trás k cieľu (v našom prípade bude cieľom IP adresa) a pakety je možné odosielať cez ktorúkoľvek z nich. Rovnako podporujeme činnosť v niekoľkých zónach dostupnosti podľa nasledujúcej schémy: ohlasujeme adresu v každej zo zón, traffic sa dostane do najbližšej a už von z nej nevyjde. Následne v príspevku podrobne preskúmame, čo sa deje s trafficom.
Config plane
Kľúčovým komponentom config plane je API, cez ktoré sa vykonávajú hlavné operácie s vyrovnávačmi záťaže: vytvorenie, odstránenie, zmena zloženia inštancií, získanie výsledkov healthchecks a pod. Na jednej strane ide o REST API, no na druhej strane, v Cloud-e veľmi často používame framework gRPC, takže "prekladáme" REST do gRPC a ďalej používame iba gRPC. Každá požiadavka vedie k vytvoreniu série asynchrónnych idempotentných úloh, ktoré sa vykonávajú na spoločnom pooli pracovníkov Yandex.Cloud. Úlohy sú písané tak, aby mohli byť kedykoľvek prerušené a potom znovu spustené. To zabezpečuje škálovateľnosť, opakovateľnosť a logovanie operácií.
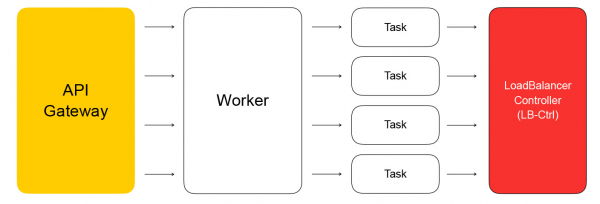
Výsledkom bude, že úloha z API vykoná požiadavku na servisný kontrolér vyrovnávačov záťaže, ktorý je napísaný v Go. Môže pridávať a odstraňovať vyrovnávače záťaže, meniť zloženie backendov a nastavenia.
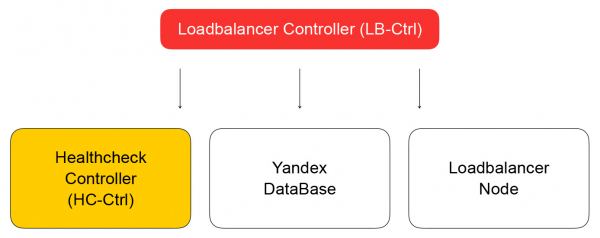
Služba uchováva svoj stav v Yandex Database - distribuovanej spravovanej databáze, ktorú čoskoro budete môcť využívať aj vy. V Yandex.Cloud, ako sme už , platí koncept dog food: ak sami používame svoje služby, naši klienti ich tiež radi používajú. Yandex Database je príkladom realizácie tohto konceptu. Ukladáme v YDB všetky svoje dáta a nemusíme sa starať o údržbu a škálovanie databázy: tieto problémy sú za nás vyriešené, my používame databázu ako službu.
Vraciame sa k ovládaču vyrovnávača zaťaženia. Jeho úlohou je uchovávať informácie o vyrovnávači zaťaženia, odoslať úlohu na kontrolu pripravenosti virtuálnej stroje do healthcheck controller.
Healthcheck controller
Získava požiadavky na zmenu pravidiel kontrol, ukladá ich do YDB, rozdeľuje úlohy medzi healthcheck nodes a agreguje výsledky, ktoré sa potom ukladajú do databázy a odosielajú do loadbalancer controller. Ten na oplátku zasiela požiadavku na zmenu zloženia klastera do data plane na loadbalancer-node, o ktorom sa nižšie zmienim.
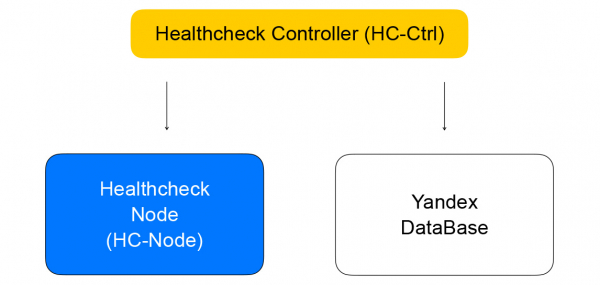
Povedzme si viac o healthchecks. Môžu byť rozdelené do niekoľkých tried. Kontroly majú rôzne kritériá úspechu. TCP kontroly musia úspešne nadviazať spojenie v stanovenom čase. HTTP kontroly vyžadujú úspešné spojenie a prijatie odpovede so status kódom 200.
Kontroly sa tiež líšia podľa triedy akcie — môžu byť aktívne a pasívne. Pasívne kontroly len sledujú, čo sa deje s prenosom, bez toho, aby uskutočňovali akékoľvek špeciálne akcie. To nefunguje dobre na L4, pretože to závisí od logiky protokolov vyššej úrovne: na L4 nie sú žiadne informácie o tom, ako dlho operácia trvala, a či bolo ukončenie spojenia dobré alebo zlé. Aktívne kontroly vyžadujú, aby vyrovnávač zasílal požiadavky na každý inštanciu servera.
Väčšina vyrovnávačov zaťaženia vykonáva kontroly „životnosti“ samostatne. V Oblačnosti sme sa rozhodli oddeliť tieto časti systému na zvýšenie škálovateľnosti. Tento prístup nám umožní zvyšovať počet vyrovnávačov pri zachovaní počtu healthcheck požiadaviek na službu. Kontroly vykonávajú samostatné healthcheck nodes, na ktorých sú shardované a replikované ciele kontrol. Kontroly nemožno vykonávať z jedného hostiteľa, pretože môže zlyhať. Potom nedostaneme stav skontrolovaných inštancií. Kontroly vykonávame z ktoréhokoľvek z inštancií minimálne z troch healthcheck nodes. Ciele kontrol shardujeme medzi nódami pomocou algoritmov konzistentného hashovania.
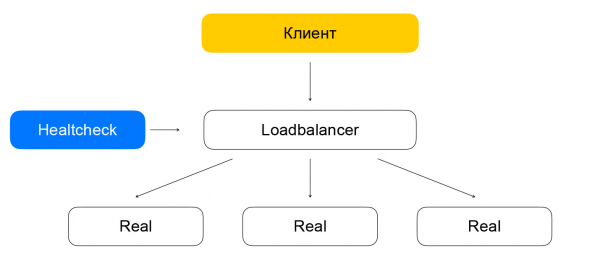
Rozdelenie medzi vyvážením a healthcheckom môže viesť k problémom. Ak healthcheck uzol uskutočňuje požiadavky na inštanciu obchádzajúci vyvažovač (ktorý momentálne nespracováva prenos), vzniká zaujímavá situácia: zdroj sa javí ako živý, ale prenos k nemu nedorazí. Tento problém riešime takto: garantujeme, že healthcheckový prenos ide cez vyvažovače. Inými slovami, schéma presunu paketov s prenosom od klientov a od healthchecks sa líši minimálne: v oboch prípadoch sa pakety dostanú na vyvažovače, ktoré ich doručia k cieľovým zdrojom.
Rozdiel spočíva v tom, že klienti zasielajú požiadavky na VIP, zatiaľ čo healthchecks sa obracajú na každý jednotlivý RIP. Tu vzniká zaujímavý problém: našim používateľom poskytujeme možnosť vytvárať zdroje v šedých IP sieťach. Predstavme si, že existujú dvaja rôzni vlastníci cloudov, ktorí skryli svoje služby za vyvažovačmi. Každý z nich má zdroje v podsieti 10.0.0.1/24, pričom majú rovnaké adresy. Je potrebné ich nejakým spôsobom rozlíšiť, a tu je potrebné sa ponoriť do fungovania virtuálnej siete Yandex.Cloud. Podrobnosti je lepšie zistiť v , teraz je pre nás dôležité, že sieť je viacvrstvová a obsahuje tunely, ktoré je možné rozlíšiť podľa id podsiete.
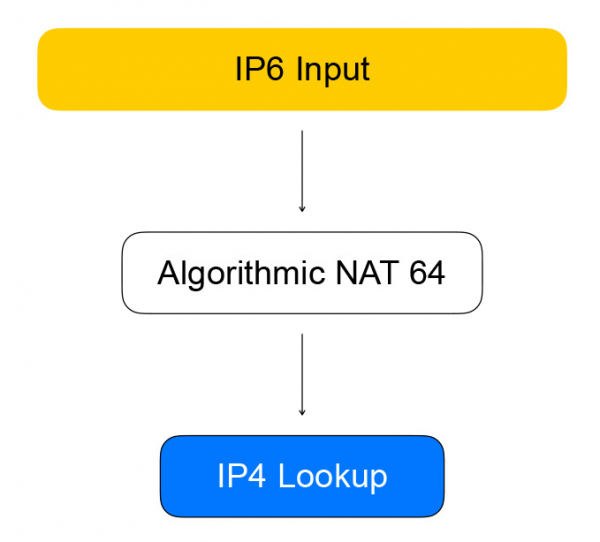
Healthcheck uzly sa obracajú na vyvažovače pomocou takzvaných kvázi-IPv6 adries. Kváziadresa je IPv6 adresa, v ktorej je zakódovaná IPv4 adresa a id podsiete používateľa. Prenos sa dostáva na vyvažovač, ten z nej extrahuje IPv4 adresu zdroja, nahrádza IPv6 za IPv4 a odosiela paket do siete používateľa.
Návratný prenos prebieha rovnako: vyvažovač vidí, že cieľ je šedá sieť z healthcheckers a konvertuje IPv4 na IPv6.
VPP je srdce data plane
Vyvažovač je implementovaný na technológii Vector Packet Processing (VPP) — rámci od Cisco pre spracovanie sieťového prenosu. V našom prípade rámec pracuje nad knižnicou pre správu sieťových zariadení v užívateľskom priestore — Data Plane Development Kit (DPDK). To zaisťuje vysoký výkon spracovania paketov: v jadre prebieha oveľa menej prerušením, nie sú žiadne prepínania kontextov medzi kernel space a user space.
VPP ide ešte ďalej a získa z systému ešte viac výkonu kombinovaním paketov do dávok. Zlepšenie výkonu nastáva vďaka agresívnemu používaniu vyrovnávacích pamätí moderných procesorov. Používajú sa ako vyrovnávacie pamäte dát (pakety sú spracovávané „vektormi“, dáta sú blízko seba), tak aj vyrovnávacie pamäte inštrukcií: v VPP spracovanie paketov prebieha podľa grafu, na uzloch ktorého sa nachádzajú funkcie zabezpečujúce jednu úlohu.
Napríklad spracovanie IP-paketov v VPP prebieha v tomto poradí: najskôr sa v uzle analýzy vykoná parsovanie hlavičiek paketov a potom sú odoslané do uzla, ktorý prenáša pakety ďalej podľa smerovacích tabuliek.
Trochu hardcore. Autori VPP netrpia kompromismi v používaní vyrovnávacích pamätí procesora, preto typický kód spracovania vektorov paketov obsahuje ručnú vektorizáciu: existuje cyklus spracovania, v ktorom sa spracováva situácia typu „máme štyri pakety v rade“, potom to isté pre dva, potom pre jeden. Často sa používajú inštrukcie pre naťahovanie (prefetch), ktoré načítavajú dáta do vyrovnávacích pamätí, aby sa urýchlil prístup k nim v nasledujúcich iteráciách.
n_left_from = frame->n_vectors;
while (n_left_from > 0)
{
    vlib_get_next_frame (vm, node, next_index, to_next, n_left_to_next);

    while (n_left_from >= 4 && n_left_to_next >= 2)
    {
        u32 next0 = SAMPLE_NEXT_INTERFACE_OUTPUT;
        u32 next1 = SAMPLE_NEXT_INTERFACE_OUTPUT;

        {
            vlib_buffer_t *p2, *p3;

            p2 = vlib_get_buffer (vm, from[2]);
            p3 = vlib_get_buffer (vm, from[3]);

            vlib_prefetch_buffer_header (p2, LOAD);
            vlib_prefetch_buffer_header (p3, LOAD);

            CLIB_PREFETCH (p2->data, CLIB_CACHE_LINE_BYTES, STORE);
            CLIB_PREFETCH (p3->data, CLIB_CACHE_LINE_BYTES, STORE);
        }
        vlib_validate_buffer_enqueue_x2 (vm, node, next_index,
                to_next, n_left_to_next,
                bi0, bi1, next0, next1);
    }

    while (n_left_from > 0 && n_left_to_next > 0)
    {

    }

    vlib_put_next_frame (vm, node, next_index, n_left_to_next);
}
Takže Healthchecks sa pripájajú cez IPv6 k VPP, ktorý ich prevádza na IPv4. Týmto sa zaoberá uzol grafu, ktorý nazývame algoritmický NAT. Pre spätný prenos (a prevod z IPv6 na IPv4) existuje rovnaký uzol algoritmického NAT.
Priamy prenos od klientov load balancera prebieha cez uzly grafu, ktoré vykonávajú samotné vyvažovanie.
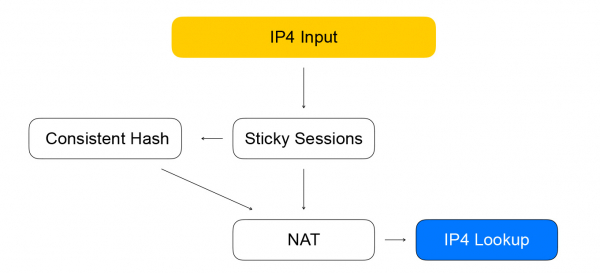
Prvý uzol — sticky sessions. V ňom sa uchováva hash z pre vybudované relácie. 5-tuple obsahuje adresu a port klienta, z ktorého sa prenáša informácia, adresu a porty zdrojov, dostupných na prijímanie prevádzky, ako aj sieťový protokol.
Hashovanie z 5-tuple nám pomáha vykonávať menej výpočtov na nasledujúcom uzle konštantného hashovania, ako aj lepšie spracovávať zmenu zoznamu zdrojov za vyrovnávačom. Keď na vyrovnávač príde paket bez relácie, posiela sa na uzol konštantného hashovania. Tu dochádza k vyváženiu pomocou konštantného hashovania: vyberáme zdroj zo zoznamu dostupných „živých“ zdrojov. Potom sa pakety odosielajú na uzol NAT, ktorý vykoná skutočnú výmenu adresy cieľa a prepočíta kontrolné súčty. Ako vidíte, dodržiavame pravidlá VPP — podobné k podobnému, skupinujeme podobné výpočty pre zvýšenie efektivity CPU cache.
Konštantné hashovanie
Prečo sme si vybrali práve toto a čo to vlastne je? Najprv si pozrime pôvodný problém — výber zdroja zo zoznamu.
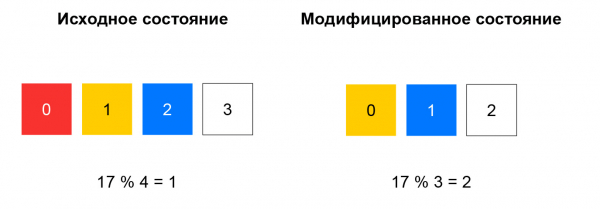
Pri nekonštantnom hashovaní sa počíta hash z prichádzajúceho paketu a zdroj sa vyberá zo zoznamu podľa zvyšku z delenia tohto hashu počtom zdrojov. Pokiaľ zostáva zoznam nezmenený, tento systém funguje dobre: vždy odosielame pakety s rovnakým 5-tuple na ten istý inštanc. Ak napríklad niektorý zdroj prestane odpovedať na healthchecky, pre značnú časť hashov sa výber zmení. Klientovi sa preruší TCP spojenie: paket, ktorý predtým smeroval na inštanc A, môže začať smerovať na inštanc B, ktorý s reláciou pre tento paket nie je oboznámený.
Konštantné hashovanie rieši opísaný problém. Najjednoduchšie je vysvetliť túto koncepciu takto: predstavte si, že máte krúžok, na ktorý rozdeľujete zdroje podľa hashu (napríklad podľa IP:port). Výber zdroja je otočenie kolesa pod uhlom, ktorý je určený hashem z paketu.
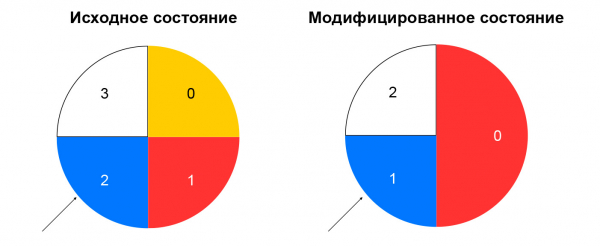
Týmto spôsobom sa minimalizuje presúvať prevádzku pri zmene súpisu zdrojov. Odstránenie zdroja ovplyvní iba tú časť kruhu konštantného hashovania, na ktorej sa nachádzal daný zdroj. Pridanie zdroja tiež mení rozdelenie, ale máme uzol sticky sessions, ktorý umožňuje neprekladať už vytvorené relácie na nové zdroje.
Preskúmali sme, čo sa deje s priamym prenosom medzi vyrovnávacím serverom a prostriedkami. Teraz sa poďme pozrieť na spätný prenos. Ten prebieha rovnakým spôsobom ako prenos kontrol — cez algoritmicky NAT, to znamená cez spätný NAT 44 pre klientsky prenos a cez NAT 46 pre prenos healthchecks. Držíme sa našej schémy: unifikujeme prenos healthchecks a skutočný prenos používateľov.
Loadbalancer-node a komponenty v zostave
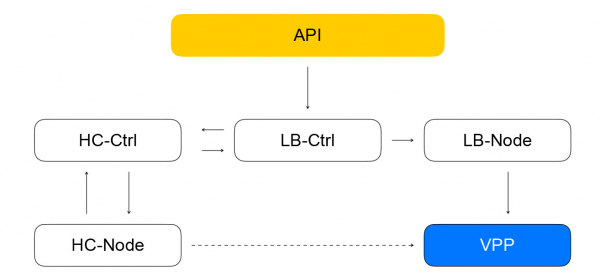
O zložení vyrovnávačov a prostriedkov vo VPP informuje lokálna služba — loadbalancer-node. Ten sa pripája na tok udalostí od loadbalancer-controller, dokáže vytvoriť rozdiel medzi aktuálnym stavom VPP a cieľovým stavom, ktorý dostáva od kontrolóra. Získavame uzavretý systém: udalosti z API prichádzajú na kontrolér vyrovnávača, ktorý zadáva healthcheck-kontrolórovi úlohy na kontroly "živosti" prostriedkov. Ten zase zadáva úlohy do healthcheck-node a agreguje výsledky, ktoré následne posiela späť kontrolórovi vyrovnávačov. Loadbalancer-node sa pripája na udalosti od kontrolóra a mení stav VPP. V takomto systéme každý servis vie len to, čo potrebujú vedieť o susedných servisoch. Počet väzieb je obmedzený a máme možnosť nezávisle prevádzkovať a škálovať rôzne segmenty.
Otázky, ktorým sme sa vyhli
Všetky naše služby v control plane sú napísané v Go a vyznačujú sa dobrou škálovateľnosťou a spoľahlivosťou. V Go existuje množstvo open-source knižníc pre budovanie distribuovaných systémov. Aktívne používame GRPC, všetky komponenty obsahujú open-source implementáciu service discovery — naše služby monitorujú stav fungovania navzájom, môžu dynamicky meniť svoju skladbu a prepojili sme to s GRPC vyrovnávaním. Pre metriky tiež používame open-source riešenie. V data plane sme dosiahli slušný výkon a veľkú rezervu zdrojov: ukázalo sa, že poskladať stánok, na ktorom by sme sa dostali na výkon VPP, a nie na výkon hardvérovej sieťovej karty, nebolo vôbec jednoduché.
Problémy a riešenia
Čo nefungovalo veľmi dobre? V Go je správa pamäte automatická, ale úniky pamäte sa predsa len občas vyskytnú. Najjednoduchší spôsob, ako s nimi naložiť, je spúšťať gorutiny a nezabúdať ich ukončiť. Záver: sledujte spotrebu pamäte Go programov. Často dobrým indikátorom je počet gorutín. V tomto prípade je aj výhoda: v Go je jednoducho možné získať údaje o runtime - o spotrebe pamäte, počte spustených gorutín a mnohých ďalších parametroch.
Okrem toho, Go nemusí byť najlepšou voľbou pre funkčné testy. Sú dosť rozsiahle, a štandardný prístup „spustiť všetko v CI naraz“ pre ne nie je veľmi vhodný. Problém spočíva v tom, že funkčné testy sú náročnejšie na zdroje, objavujú sa reálne timeouty. Z toho dôvodu môžu testy skončiť neúspešne, pretože CPU je obsadené jednotkovými testami. Záver: pokiaľ je to možné, vykonávajte „ťažké“ testy oddelene od jednotkových testov.
Mikroslužobná eventová architektúra je zložitnejšia ako monolit: prehľadávať logy na desiatkach rôznych strojov nie je veľmi pohodlné. Záver: ak vytvárate mikroslužby, hneď začnite premýšľať o trasovaní.
Naše plány
Spustíme interný vyrovnávací server, IPv6 vyrovnávací server, pridáme podporu pre Kubernetes skripty, budeme naďalej shardovať naše služby (momentálne sú shardované iba healthcheck-node a healthcheck-ctrl), pridáme nové healthchecky a taktiež realizujeme inteligentnú agregáciu kontrol. Zvažujeme možnosť, ako spraviť naše služby ešte nezávislejšími – aby si navzájom nekomunikovali priamo, ale prostredníctvom fronty správ. V Cloud sa nedávno objavila služba kompatibilná s SQS. .
Nedávno bol verejne uvoľnený Yandex Load Balancer. Študujte k službe, spravujte vyrovnávacie servery spôsobom, ktorý vám vyhovuje, a zvyšujte odolnosť svojich projektov!
Zdroj: habr.com
