

Tento článok pomôže pochopiť, ako funguje vyvažovanie záťaže v Kubernetes, čo sa deje pri škálovaní dlhodobých spojení a prečo by ste mali zvážiť vyvažovanie na strane klienta, ak používate HTTP/2, gRPC, RSockets, AMQP alebo iné dlhodobé protokoly.
Stručne o tom, ako sa premieta prenos v Kubernetes
Kubernetes poskytuje dve užitočné abstrakcie pre nasadzovanie aplikácií: služby (Services) a nasadenia (Deployments).
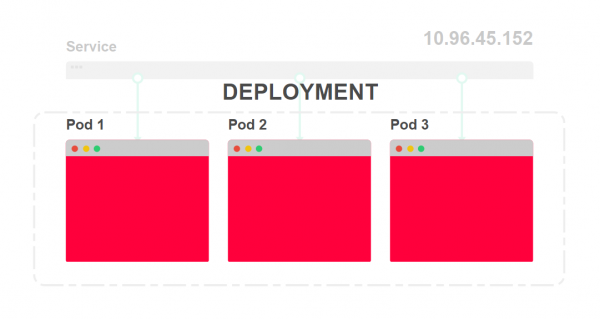
Nasadenia popisujú, ako a koľko kópií vašej aplikácie by malo byť spustených v akomkoľvek okamihu. Každá aplikácia sa nasadzuje ako pod (Pod) a je jej priradená IP adresa.
Služby sú funkčne podobné vyvažovaču záťaže. Služby slúžia na rozdeľovanie prevádzky medzi viaceré pody.
Pozrime sa, ako to vyzerá.
- Na diagrame nižšie vidíte tri inštancie jednej aplikácie a vyvažovač záťaže:

- Vyvažovač záťaže sa nazýva služba (Service), má priradenú IP adresu. Každý prichádzajúci požiadavok je presmerovaný na jeden z podov:

- Scenár nasadenia určuje počet inštancií aplikácie. V zásade sa nemusíte priamo zaoberať nasadením podu:

- Každému podu je priradená vlastná IP adresa:

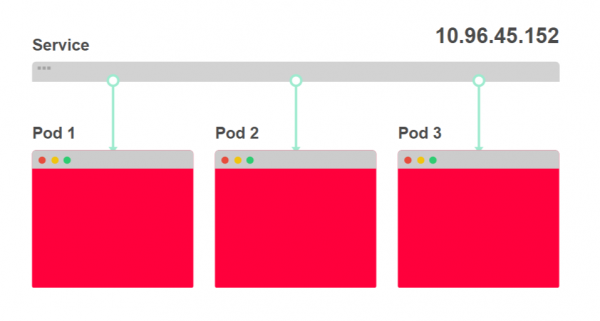
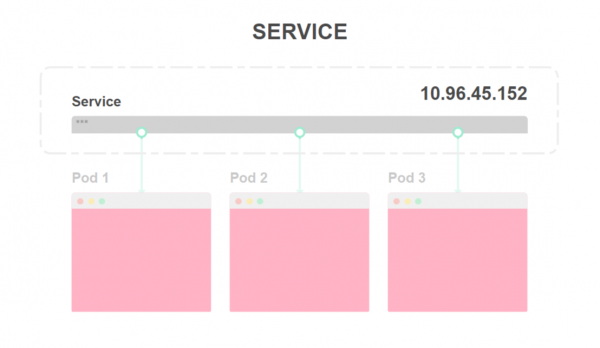
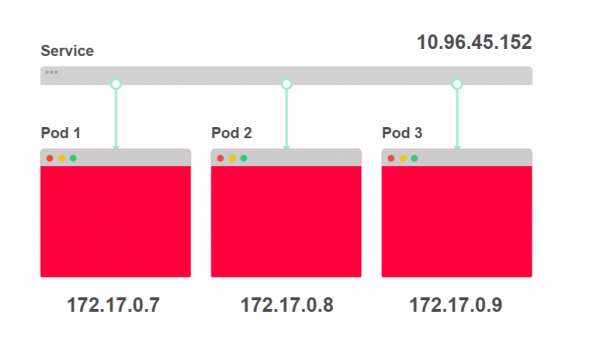
Je užitočné považovať služby za súbor IP adries. Kedykoľvek sa obrátite na službu, jedna z IP adries sa vyberie zo zoznamu a použije sa ako cieľová adresa.
Vyzerá to takto.
- Prichádza požiadavka curl 10.96.45.152 na službu:

- Služba vyberie jednu z troch adries podov ako cieľ:

- Prenos sa presmeruje na konkrétny pod:


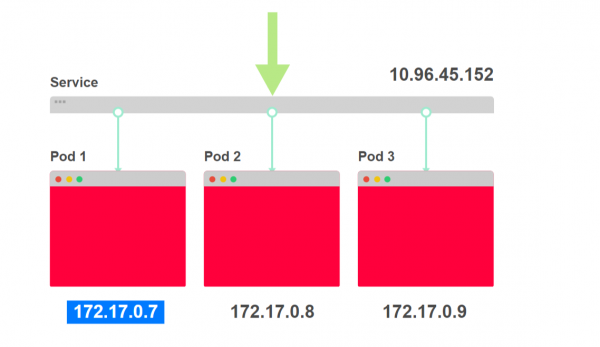
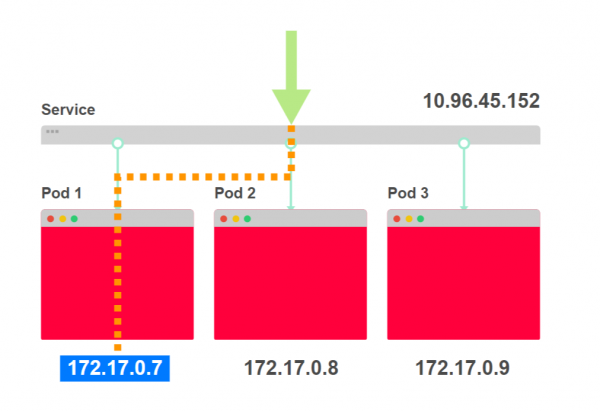
Ak sa vaša aplikácia skladá z frontendu a backendu, budete mať službu aj nasadenie pre každú časť.
Keď frontend vykonáva požiadavku na backend, nemusí vedieť, koľko podov backend spravuje: môže byť jeden, desať alebo sto.
Frontend tiež nevie o adresách podov, ktoré spravujú backend.
Keď frontend vykonáva požiadavku na backend, využíva IP adresu služby backendu, ktorá sa nemení.
Takto to vyzerá.
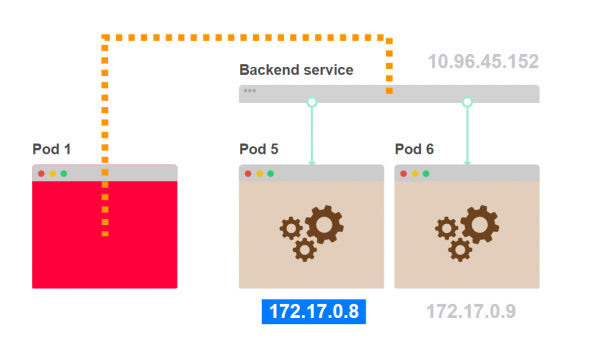
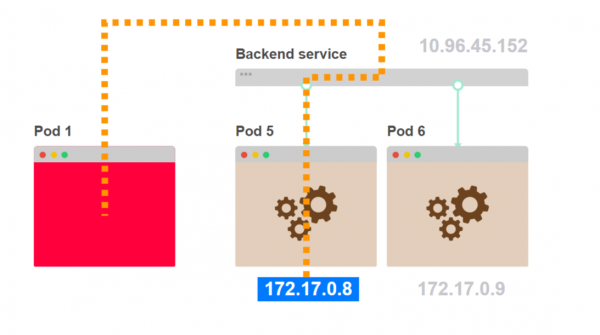
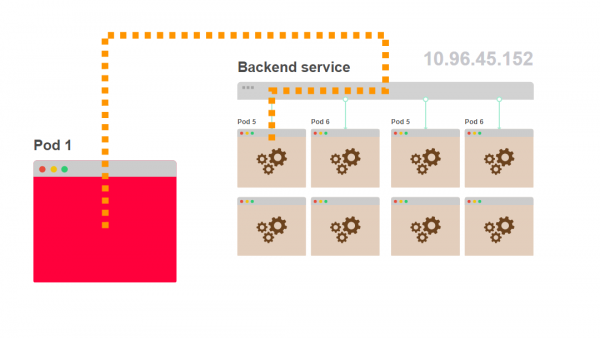
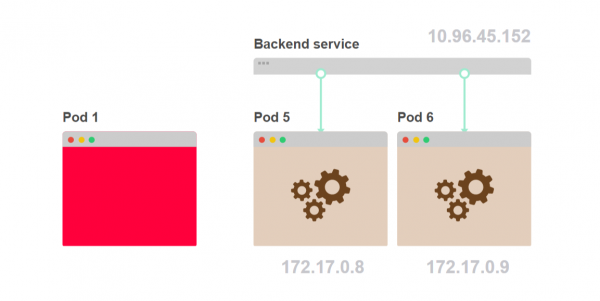
- Pod 1 sa pýta na internú komponentu backendu. Namiesto toho, aby si vybral konkrétny pod backendu, vykonáva požiadavku na službu:

- Služba vyberá jeden z podov backendu ako cieľovú adresu:

- Prevádzka ide z podu 1 na pod 5, ktorý vybrala služba:

- Pod 1 nevie, koľko presne takých podov, ako pod 5, je skrytých za službou:

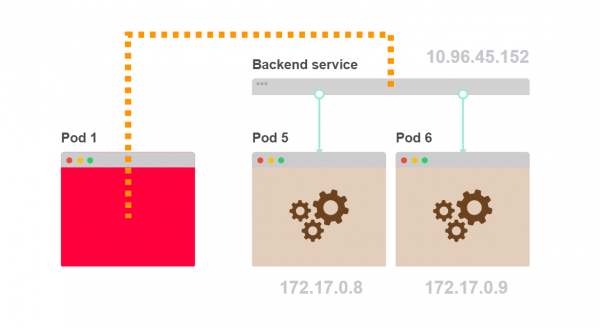
Ale ako presne služba rozdeľuje požiadavky? Vyzerá to, že sa používa round-robin vyvažovanie? Poďme sa na to pozrieť.
Vyvažovanie v službách Kubernetes
Služby Kubernetes neexistujú. Pre službu neexistuje proces, ktorý by mal pridelenú IP adresu a port.
Môžete sa o tom presvedčiť tak, že sa prihlásite na akýkoľvek uzol klastra a spustíte príkaz netstat -ntlp.
Ani nebudete môcť nájsť IP adresu priradenú službe.
IP adresa služby je umiestnená v riadiacej vrstve, v kontroléri a je zapísaná v databáze — etcd. Táto adresa sa používa aj inou komponentou — kube-proxy.
Kube-proxy dostáva zoznam IP adries pre všetky služby a vytvára súbor pravidiel iptables na každom uzle klastra.
Tieto pravidlá hovoria: „Ak vidíme IP adresu služby, treba upraviť cieľovú adresu požiadavky a poslať ju na jeden z podov.“
IP adresa služby sa používa len ako vstupný bod a nie je spravovaná nijakým procesom, ktorý by počúval na tejto IP adrese a porte.
Pozrime sa na to.
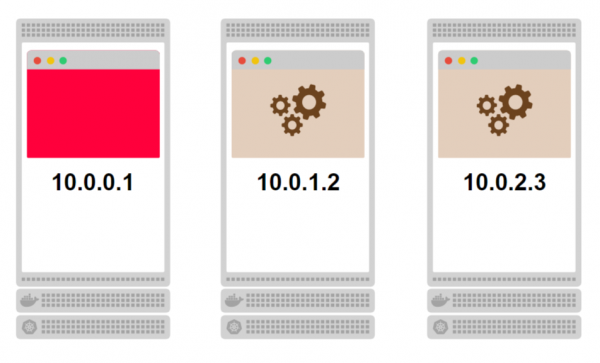
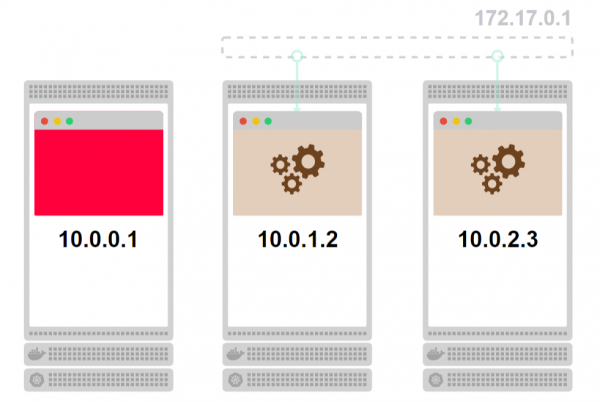
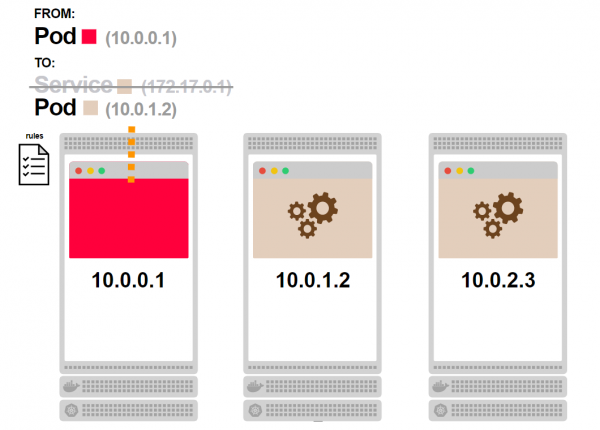
- Zoberme si klaster zložený z troch uzlov. Na každom uzle sú prítomné pod:

- Súvisiace pody, sfarbené béžovo, sú časťou služby. Keďže služba neexistuje ako proces, je zobrazená sivou farbou:

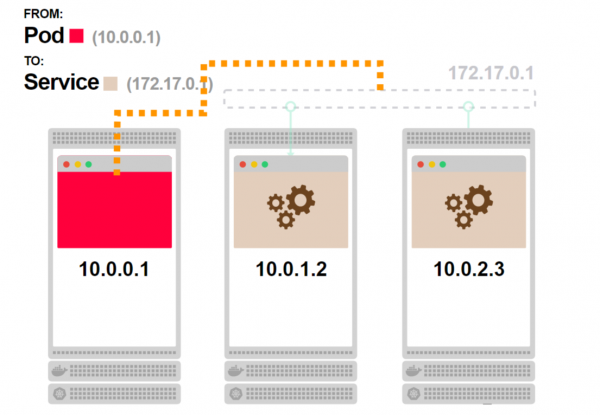
- Prvý pod sa snaží získať službu a mal by sa dostať na jeden z pripojených podov:

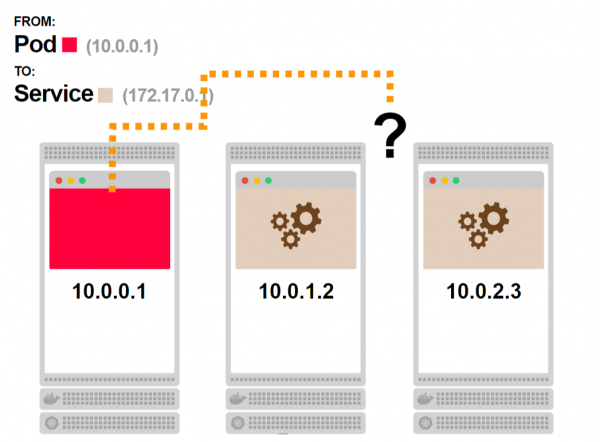
- Ale služba neexistuje, proces nie je. Ako to funguje?

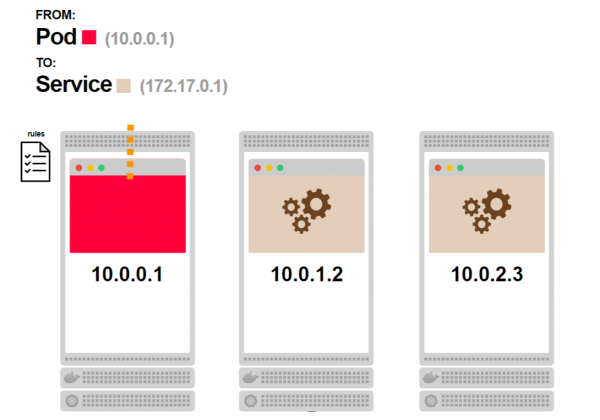
- Predtým, ako požiadavka opustí uzol, prechádza pravidlami iptables:

- Pravidlá iptables vedia, že služba neexistuje, a nahrádzajú jej IP adresu jednou z IP adries podov, ktoré sú s touto službou prepojené:

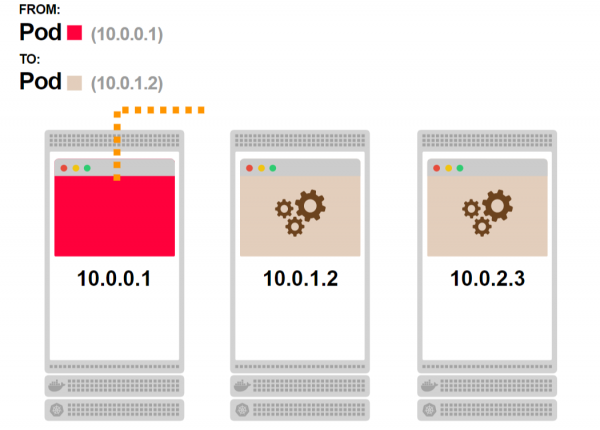
- Požiadavka dostane platnú IP adresu ako cieľovú adresu a je bežne spracovaná:
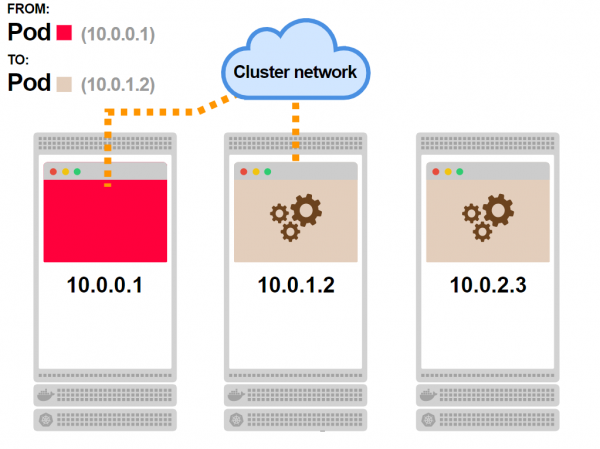
- V závislosti od sieťovej topológie nakoniec požiadavka dorazí na pod:

Sú iptables schopné vyvažovať záťaž?
Nie, iptables sa používajú na filtrovanie a neboli navrhnuté na vyvažovanie.
Avšak existuje možnosť napísať súbor pravidiel, ktoré fungujú ako .
A to je presne to, čo je implementované v Kubernetes.
Ak máte tri pod, kube-proxy napíše nasledujúce pravidlá:
- Vybrať prvý pod s pravdepodobnosťou 33%, inak prejsť na nasledujúce pravidlo.
- Vyberte druhý pod s pravdepodobnosťou 50 %, inak prejdite na ďalšie pravidlo.
- Vyberte tretí pod.
Takýto systém vedie k tomu, že každý pod sa vyberá s pravdepodobnosťou 33 %.
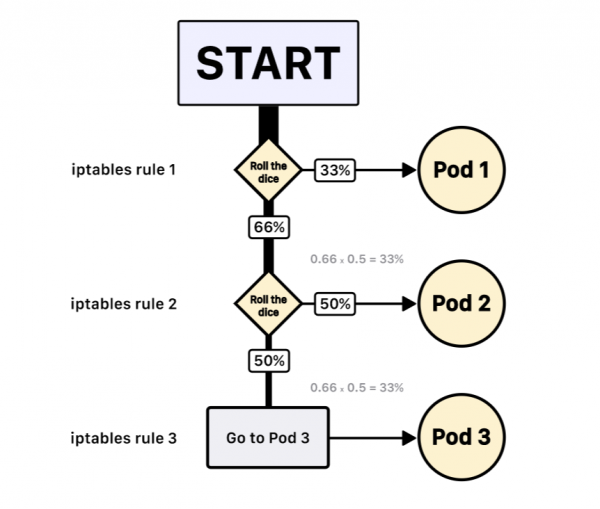
A nie je žiadna záruka, že pod 2 bude vybraný nasledujúci po pode 1.
Poznámka: iptables využíva štatistický modul so náhodným rozdelením. Týmto spôsobom je algoritmus vyvažovania založený na náhodnom výbere.
Teraz, keď rozumiete, ako fungujú služby, pozrime sa na zaujímavejšie scenáre fungovania.
Dlhodobé pripojenia v Kubernetes sa automaticky neskalujú.
Každý HTTP dopyt z frontendu k backendu je obsluhovaný samostatným TCP pripojením, ktoré sa otvára a zatvára.
Ak frontend odošle 100 dopytov za sekundu na backend, otvorí a zatvorí 100 rôznych TCP pripojení.
Čas spracovania dopytu možno skrátiť a znížiť záťaž, ak sa otvorí jedno TCP pripojenie a použije sa pre všetky nasledujúce HTTP dopyty.
V HTTP protokole je zabudovaná možnosť, známa ako HTTP keep-alive, alebo opätovné použitie pripojenia. V tomto prípade sa jedno TCP pripojenie používa na odosielanie a prijímanie mnohých HTTP dopytov a odpovedí:
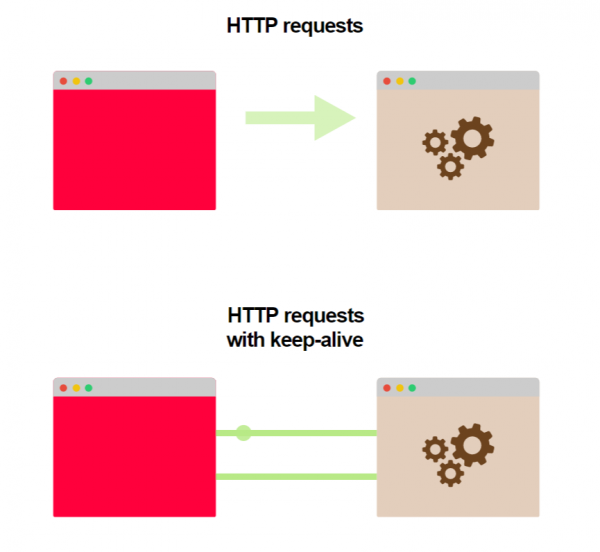
Táto funkcia nie je predvolene zapnutá: server aj klient musia byť správne nakonfigurované.
Samotné nastavenie je jednoduché a dostupné pre väčšinu programovacích jazykov a prostredí.
Tu je niekoľko odkazov na príklady v rôznych jazykoch:
Čo sa stane, ak použijeme keep-alive v službe Kubernetes?
Povedzme, že frontend aj backend podporujú keep-alive.
Máme jednu kópiu frontendu a tri inštancie backendu. Frontend urobí prvý dopyt a otvorí TCP pripojenie k backendu. Dopyt dosiahne službu, jeden z podov backendu je vybraný ako cieľová adresa. Pod backendu odosiela odpoveď a frontend ju prijíma.
Na rozdiel od bežnej situácie, kedy sa po prijatí odpovede TCP pripojenie zatvorí, teraz zostáva otvorené pre nasledujúce HTTP dopyty.
Čo sa stane, ak frontend odošle ďalšie dopyty na backend?
Pre preposielanie týchto dopytov sa použije otvorené TCP pripojenie, všetky dopyty sa dostanú na ten istý pod backendu, na ktorý sa dostal prvý dopyt.
Nemal by iptables preusmerovať traffic?
Nie v tomto prípade.
Keď sa vytvorí TCP spojenie, prechádza cez pravidlá iptables, ktoré vyberajú konkrétny pod backendu, kam sa traffic dostane.
Keďže všetky nasledujúce požiadavky používajú už otvorené TCP spojenie, pravidlá iptables sa už nevyvolávajú.
Pozrime sa, ako to vyzerá.
- Prvý pod posiela požiadavku na službu:

- Už viete, čo sa stane ďalej. Služba neexistuje, ale existujú pravidlá iptables, ktoré spracujú požiadavku:
- Jeden z podov backendu bude vybraný ako cieľová adresa:

- Požiadavka dosiahne pod. V tomto okamihu sa medzi dvoma podmi vytvorí trvalé TCP spojenie:

- Každá nasledujúca požiadavka od prvého podu pôjde cez už vytvorené spojenie:

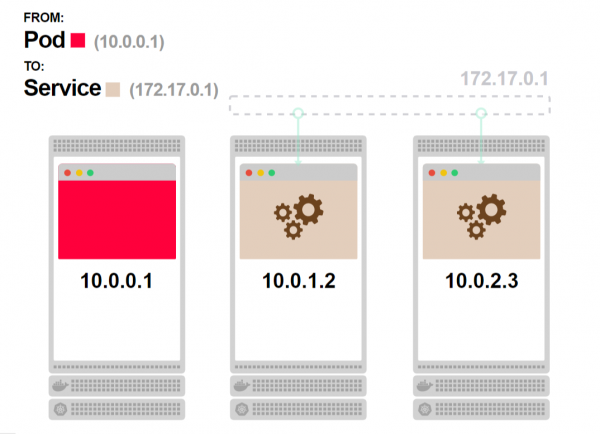
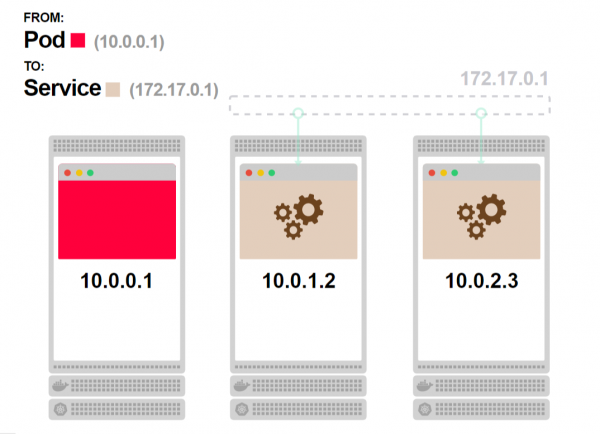
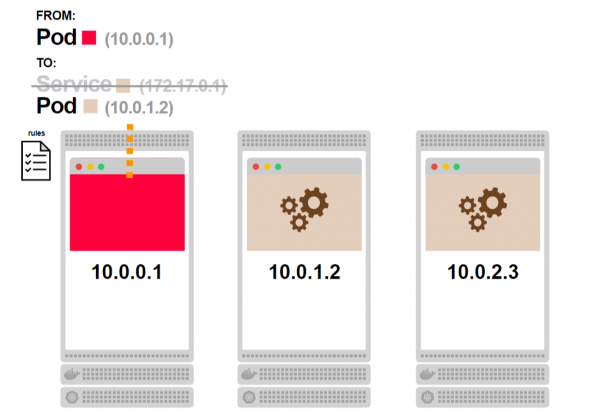
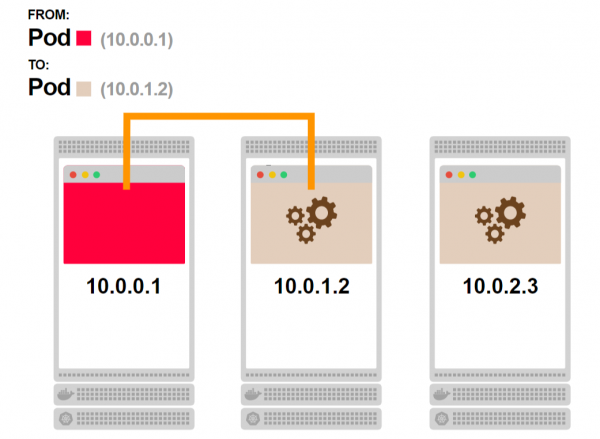
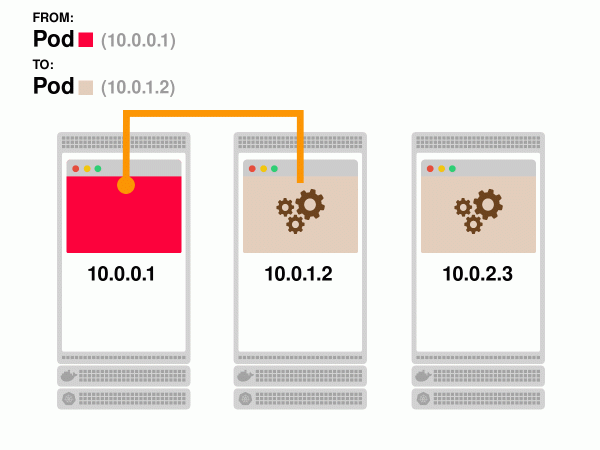
V dôsledku toho ste získali rýchlejšiu odozvu a vyššiu priepustnosť, ale stratili ste možnosť škálovania backendu.
Aj keď máte v backendu dva pod, pri trvalom spojení traffic neustále bude smerovať na jeden z nich.
Môže sa to opraviť?
Keďže Kubernetes nevie, ako vyvažovať trvalé spojenia, táto úloha spočíva na vás.
Služby sú súbor IP adries a portov, ktoré sa nazývajú koncové body.
Vaša aplikácia môže získať zoznam koncových bodov zo služby a rozhodnúť, ako distribuovať požiadavky medzi nimi. Môžete otvoriť trvalé spojenie s každým podom a vyvažovať požiadavky medzi týmito spojeniami pomocou round-robin.
Alebo aplikovať zložitejšie .
Kód na strane klienta, ktorý zodpovedá za vyvažovanie, by mal nasledovať takúto logiku:
- Získať zoznam koncových bodov zo služby.
- Pre každý koncový bod otvoriť trvalé spojenie.
- Keď je potrebné vykonať požiadavku, použiť jedno z otvorených spojení.
- Pravidelne aktualizovať zoznam koncových bodov, vytvárať nové alebo zatvárať staré trvalé spojenia v prípade zmeny zoznamu.
Takto to bude vyzerať.
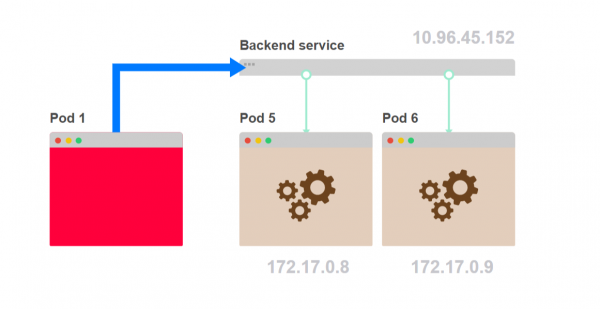
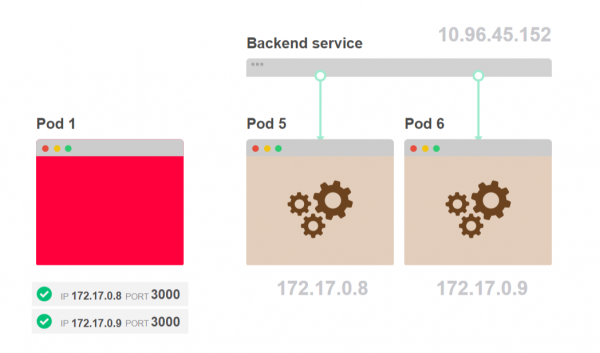
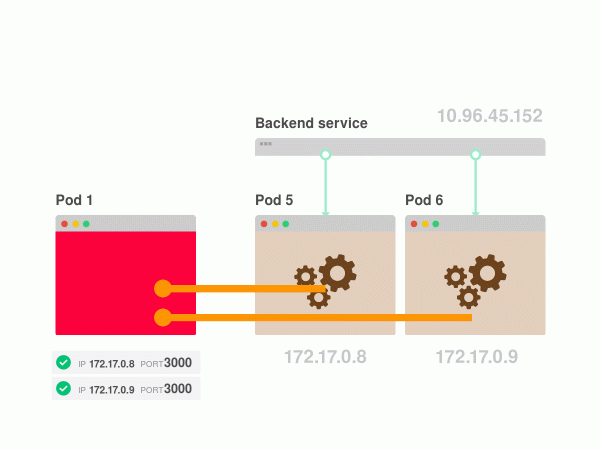
- Namiesto toho, aby prvý pod posielal požiadavku na službu, môžete vyvažovať požiadavky na strane klienta:

- Je potrebné napísať kód, ktorý sa pýta, ktoré podi sú súčasťou služby:

- Akonáhle dostanete zoznam, uložte ho na strane klienta a používajte ho na spojenie s podmi:

- Ste máte zodpovednosť za algoritmus vyrovnávania zaťaženia:
Teraz vzniká otázka: týka sa tento problém len HTTP keep-alive?
Vyrovnávanie zaťaženia na strane klienta
HTTP nie je jediný protokol, ktorý môže používať trvalé TCP pripojenia.
Ak vaša aplikácia používa databázu, TCP pripojenie sa neotvára zakaždým, keď potrebujete vykonať dotaz alebo získať dokument z DB.
Namiesto toho sa otvorí a využíva trvalé TCP pripojenie k databáze.
Ak je vaša databáza nasadená v Kubernetes a prístup sa poskytuje ako služba, narazíte na tie isté problémy, ktoré sú popísané v predchádzajúcej časti.
Jedna replika databázy bude zaťažená viac ako ostatné. Kube-proxy a Kubernetes nepomôžu vyrovnávať pripojenia. Musíte sa postarať o vyrovnávanie požiadaviek na vašu databázu.
V závislosti od toho, ktorú knižnicu používate na pripojenie k DB, môžete mať rôzne možnosti riešenia tohto problému.
Nižšie je uvedený príklad prístupu k databázovému klastru MySQL z Node.js:
var mysql = require('mysql');
var poolCluster = mysql.createPoolCluster();

var endpoints = /* retrieve endpoints from the Service */

for (var [index, endpoint] of endpoints) {
  poolCluster.add(`mysql-replica-${index}`, endpoint);
}

// Make queries to the clustered MySQL database
Existuje množstvo ďalších protokolov, ktoré používajú trvalé TCP pripojenia:
- WebSockety a zabezpečené WebSockety
- HTTP/2
- gRPC
- RSockets
- AMQP
Musíte byť už oboznámení s väčšinou týchto protokolov.
Ale ak sú tieto protokoly tak populárne, prečo neexistuje štandardizované riešenie pre vyrovnávanie? Prečo je potrebné zmeniť logiku klienta? Existuje natívne riešenie Kubernetes?
Kube-proxy a iptables boli vytvorené na to, aby pokryli väčšinu štandardných scenárov použitia pri nasadení v Kubernetes. Je to urobené pre pohodlie.
Ak používate webovú službu, ktorá poskytuje REST API, máte šťastie — v tomto prípade sa nepoužívajú trvalé TCP pripojenia, môžete používať akúkoľvek službu Kubernetes.
Ale akonáhle začnete používať trvalé TCP pripojenia, musíte sa vysporiadať s tým, ako rovnomerne rozložiť zaťaženie na backendy. Kubernetes nemá hotové riešenia na tento účel.
Avšak, samozrejme, existujú možnosti, ktoré môžu pomôcť.
Vyrovnávanie dlhodobých pripojení v Kubernetes
V Kubernetes existujú štyri typy služieb:
- ClusterIP
- NodePort
- LoadBalancer
- Headless
Prvé tri služby fungujú na základe virtuálnej IP adresy, ktorú kube-proxy používa na vytvorenie pravidiel iptables. Základom všetkých služieb je však headless služba.
S headless službou nie je spojená žiadna IP adresa, len poskytuje mechanizmus na získanie zoznamu IP adries a portov spojených s podmi (koncové body).
Všetky služby sú založené na headless službe.
Služba ClusterIP je headless služba s niektorými doplnkami:
- Správa vrstva jej priraďuje IP adresu.
- Kube-proxy vytvára potrebné pravidlá iptables.
Takže môžete ignorovať kube-proxy a priamo použiť zoznam koncových bodov získaných z headless služby na vyvažovanie záťaže vo vašej aplikácii.
Ale ako pridať takúto logiku do všetkých aplikácií nasadených v klastri?
Ak je vaša aplikácia už nasadená, táto úloha sa môže zdať nevykonateľná. Existuje však alternatívna možnosť.
Service Mesh vám pomôže
Určite ste si už všimli, že stratégia vyváženia záťaže na strane klienta je celkom štandardná.
Keď aplikácia štartuje,
- Získava zoznam IP adries zo služby.
- Otvorí a udržiava pool spojení.
- Pravidelne aktualizuje pool, pridáva alebo odstraňuje koncové body.
Akonáhle chce aplikácia vykonať požiadavku,
- Vyberá dostupné spojenie, využívajúc nejakú logiku (napríklad round-robin).
- Vykoná požiadavku.
Tieto kroky fungujú aj pre WebSockets, gRPC a AMQP spojenia.
Môžete túto logiku oddeliť do samostatnej knižnice a použiť ju vo vašich aplikáciách.
Namiesto toho však môžete použiť servisné siete, ako Istio alebo Linkerd.
Service Mesh dopĺňa vašu aplikáciu procesom, ktorý:
- Automaticky vyhľadáva IP adresy služieb.
- Kontroluje spojenia, ako WebSockets a gRPC.
- Vyvažuje požiadavky pomocou správneho protokolu.
Service Mesh pomáha spravovať prevádzku v rámci klastra, ale je dosť náročný na zdroje. Iné možnosti zahŕňajú použitie externých knižníc, ako Netflix Ribbon, alebo programovateľných proxy, ako Envoy.
Čo sa stane, ak ignorujete otázky vyvažovania?
Môžete sa vyhnúť vyvažovaniu záťaže a pritom si nevšimnúť žiadne zmeny. Pozrime sa na niekoľko scenárov fungovania.
Ak máte viac klientov ako serverov, nie je to taký veľký problém.
Povedzme, že existuje päť klientov, ktorí sa pripájajú k dvom serverom. Aj bez vyrovnávania záťaže budú oba servery využité:
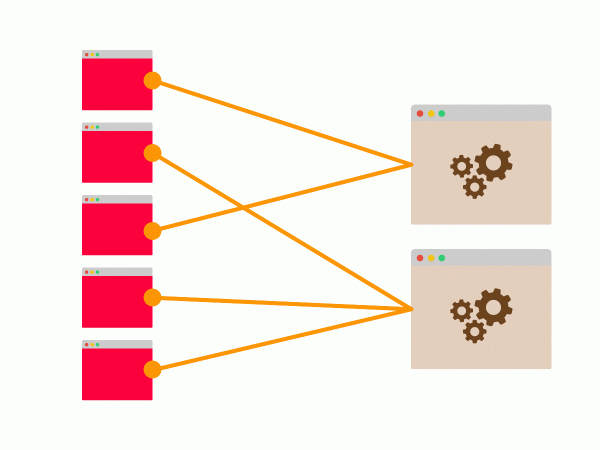
Pripojenia môžu byť rozdelené neúmerne: možno štyria klienti sa pripojili k jednému serveru, ale je veľká šanca, že oba servery budú využité.
Skrátka, problémovejší je opačný scenár.
Ak máte menej klientov a viac serverov, vaše zdroje nemusia byť dostatočne využité a môže vzniknúť potenciálne úzke miesto.
Povedzme, že sú dvaja klienti a päť serverov. V najlepšom prípade budú dva trvalé pripojenia k dvom serverom z piatich.
Ostatné servery budú nevyužité:
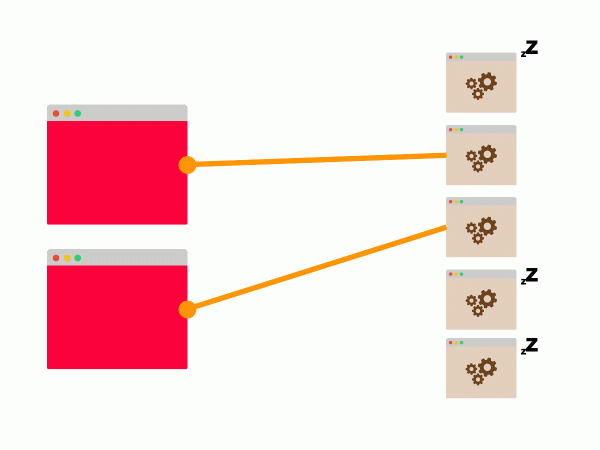
Ak tieto dva servery nemôžu zvládnuť spracovanie požiadaviek klientov, horizontálne škálovanie nepomôže.
Záver
Služby Kubernetes sú navrhnuté tak, aby fungovali vo väčšine štandardných scenárov webových aplikácií.
Avšak, akonáhle začnete pracovať s aplikačnými protokolmi, ktoré využívajú trvalé pripojenia TCP, ako sú databázy, gRPC alebo WebSockets, služby už nie sú vhodné. Kubernetes neposkytuje vnútorné mechanizmy na vyrovnávanie trvalých TCP pripojení.
To znamená, že musíte písať aplikácie s ohľadom na možnosť vyrovnávania na strane klienta.
Preklad pripravila tím .
Čo ďalšie si prečítať na túto tému:
- .
- .
- .
Zdroj: habr.com
