

KDB+, produkt spoločnosti — je široko známa v úzkom kruhu, mimoriadne rýchla stĺpcová databáza, ktorá je určená na ukladanie časových radov a analytických výpočtov na ich základe. Pôvodne bola veľmi populárna v oblasti financí — využíva ju všetkých top 10 investičných bánk a mnohé známe hedge fondy, burzy a ďalšie organizácie. V poslednej dobe sa KX rozhodla rozšíriť svoju zákaznícku základňu a teraz ponúkajú riešenia aj v iných oblastiach, kde je veľké množstvo údajov usporiadaných časovo alebo iným spôsobom — telekomunikácie, bioinformatika, výroba atď. Stali sa tiež partnerom tímu Aston Martin Red Bull Racing vo „Formule 1“, kde pomáhajú zbierať a spracovávať údaje zo senzorov monopostov a analyzovať testy v aerodynamickom tuneli. V tomto článku chcem prerozprávať, aké vlastnosti KDB+ ju robia mimoriadne výkonnou, prečo sú spoločnosti ochotné na ňu vynakladať veľké peniaze a nakoniec, prečo to vlastne nie je databáza.
V tomto článku sa pokúsim prerozprávať, čo KDB+ predstavuje, aké možnosti a obmedzenia má, v čom je jej prínos pre firmy, ktoré chcú spracovávať veľké objemy údajov. Nebudem sa podrobne venovať implementácii KDB+ a detailom jej programovacieho jazyka Q. Obe tieto témy sú veľmi rozsiahle a zaslúžia si samostatné články. Mnoho informácií o týchto témach nájdete na stránke code.kx.com, vrátane knihy o Q — Q For Mortals (pozri odkazy nižšie).
Niektoré termíny
- In-memory databáza. Databáza, ktorá uchováva údaje v RAM, aby urýchlila prístup. Výhody takejto databázy sú jasné, ale nevýhody — možnosť straty údajov, potreba mať veľa pamäte na serveri.
- Stĺpcová databáza. Databáza, v ktorej sú údaje uložené po stĺpcoch, a nie záznam po zázname. Hlavná výhoda takejto databázy spočíva v tom, že údaje z jedného stĺpca sú uložené spoločne na disku a v pamäti, čo výrazne urýchľuje prístup k nim. Nie je potrebné načítať stĺpce, ktoré sa v dotaze nepoužívajú. Hlavný nedostatok — ťažké modifikovať a odstraňovať záznamy.
- Časový rad. Údaje s dátovým alebo časovým typom stĺpca. Zvyčajne je pre takéto údaje dôležité, aby boli usporiadané v čase, aby bolo možné jednoducho určiť, ktorý záznam predchádza alebo nasleduje za aktuálnym, alebo aby sa mohli aplikovať funkcie, ktorých výsledok závisí od poradia záznamov. Klasické databázy sú postavené na úplne inom princípe — na predstavení súboru záznamov ako množiny, kde poradie záznamov nie je v zásade definované.
- Vektor. V kontexte KDB+ — to je zoznam prvkov jedného atomárneho typu, napríklad čísiel. Inými slovami, pole prvkov. Poli, na rozdiel od zoznamov, je možné skladovať kompaktné a spracovávať pomocou vektorových inštrukcií procesora.
Historické pozadie
Spoločnosť KX bola založená v roku 1993 Arthúrom Whitneyom, ktorý predtým pracoval v banke Morgan Stanley na jazyku A+, ktorý je dedičom APL — veľmi originálneho a v svojej dobe populárneho jazyka vo finančnom svete. Samozrejme, v KX Arthur pokračoval v rovnakom duchu a vytvoril vektorovo-funkcionálny jazyk K, riadiac sa myšlienkami radikálneho minimalizmu. Programy v K vyzerajú ako chaotický súbor interpunkčných znakov a špeciálnych symbolov, zmysel znakov a funkcií závisí od kontextu a každá operácia nesie v sebe omnoho viac zmyslu, ako to býva v obvyklých programovacích jazykoch. Vďaka tomu program v K zaberá minimálne miesto — niekoľko riadkov môže nahradiť strany textu zbytočného jazyka ako Java — a predstavuje superkoncentrovanú realizáciu algoritmu.
Funkcia v K, ktorá realizuje väčšiu časť generátora LL1 parsera podľa zadanej gramatiky:
1. pp:{q:{(x;p3(),y)};r:$[-11=@x;$x;11=@x;q[`N;$*x];10=abs@@x;q[`N;x]
2.   ($)~*x;(`P;p3 x 1);(1=#x)&11=@*x;pp[{(1#x;$[2=#x;;,:]1_x)}@*x]
3.      (?)~*x;(`Q;pp[x 1]);(*)~*x;(`M;pp[x 1]);(+)~*x;(`MP;pp[x 1]);(!)~*x;(`Y;p3 x 1)
4.      (2=#x)&(@x 1)in 100 101 107 7 -7h;($[(@x 1)in 100 101 107h;`Ff;`Fi];p3 x 1;pp[*x])
5.      (|)~*x;`S,(pp'1_x);2=#x;`C,{@[@[x;-1+#x;{x,")"}];0;"(",]}({$[".s.C"~4#x;6_-2_x;x]}'pp'x);'`pp];
6.   $[@r;r;($[1<#r;".s.";""],$*r),$[1<#r;"[",(";"/1_r),"]";""]]}
Túto filozofiu extrémnej efektivity s minimom pohybov Arthur zrealizoval aj v KDB+, ktorá sa objavila v roku 2003 (myslím, že teraz je jasné, odkiaľ pochádza písmeno K v názve) a nie je nič iné ako interpretátor štvrtej verzie jazyka K. Na K bola pridaná užívateľsky príjemnejšia verzia K nazvaná Q. V Q je taktiež pridaná podpora špecifického dialektu SQL — QSQL, a do interpretátora — podpora tabuliek ako systémového typu dát, nástroje na prácu s tabuľkami v pamäti a na disku atď.
Tým pádom, z pohľadu používateľa KDB+ — je to len interpretátor jazyka Q s podporou tabuliek a výrazov podobných SQL v štýle LINQ z C#. Toto je najdôležitejšie rozlíšenie KDB+ od iných databáz a jej hlavný konkurenčný výhodu, ktorú často prehliadajú. Nie je to databáza + pomocný jazyk, ale plnohodnotný výkoný programovací jazyk + vstavaná podpora databázových funkcií. Toto rozlíšenie bude hrať rozhodujúcu úlohu pri vymenúvaní všetkých výhod KDB+. Napríklad...
Veľkosť
Podľa súčasných meradiel má KDB+ jednoducho mikroskopickú veľkosť. Je to doslova jeden spustiteľný súbor, ktorý má menej ako megabajt a jeden malý textový súbor s niektorými systémovými funkciami. V skutočnosti — menej ako jeden megabajt a za túto programovací spoločnosť platia desiatky tisíc dolárov ročne za jeden procesor na serveri.
- Taká veľkosť umožňuje KDB+ perfektne fungovať na akomkoľvek železe — od mikro počítača Pi až po servery s terabajtmi pamäte. Na funkcionalitu to nijako neovplyvňuje, navyše, Q sa spúšťa okamžite, čo umožňuje jeho použití aj ako skriptovací jazyk.
- Vďaka takej veľkosti sa interpretátor Q úplne zmestí do cache procesora, čo urýchľuje vykonávanie programov.
- Vďaka takej veľkosti spustiteľného súboru proces Q zaberá zanedbateľné množstvo miesta v pamäti, môžete ich spúšťať stokrát. Zároveň, ak je to potrebné, Q môže manipulovať s desiatkami až stovkami gigabajtov pamäte v rámci jedného procesu.
Univerzálnosť
Q je ideálny pre rôzne úlohy. Proces Q môže slúžiť ako historická databáza a poskytovať rýchly prístup k terabajtom informácií. Napríklad máme desiatky historických databáz, v ktorých sa niektoré dni nekomprimovaných dát pohybujú nad 100 gigabajtov. Napriek tomu sa pri rozumných obmedzeniach dopyt na databázu vykoná za desiatky až stovky milisekúnd. Celkovo máme na používateľské dopyty univerzálny časový limit — 30 sekúnd — a to sa stáva veľmi zriedka.
S tou istou ľahkosťou môže byť Q aj in-memory databázou. Pridávanie nových dát do tabuliek v pamäti prebieha tak rýchlo, že obmedzujúcim faktorom sú dopyty používateľov. Dátové tabuľky sú uložené po stĺpcoch, čo znamená, že každá operácia na stĺpci plne využíva CPU cache. Okrem toho sa v KX snažili implementovať všetky základné operácie, ako sú aritmetické, cez vektorové inštrukcie procesora, čím sa maximalizuje ich rýchlosť. Q môže vykonávať aj úlohy, ktoré nie sú typické pre databázy — napríklad spracovávať streamované dáta a vypočítavať v „reálnom čase“ (s oneskorením od desiatok milisekúnd do niekoľkých sekúnd, v závislosti od úlohy) rôzne agregované funkcie pre finančné nástroje pre rôzne časové intervaly alebo vytvárať model vplyvu uskutočnenej transakcie na trh a vykonávať jeho profilovanie takmer okamžite po jeho uskutočnení. V takýchto úlohách najčastejšie hlavnú časovú latenciu pridáva nie Q, ale potrebná synchronizácia dát z rôznych zdrojov. Vysoká rýchlosť je dosiahnutá tým, že dáta a funkcie, ktoré ich spracovávajú, sú v jednom procese, pričom spracovanie spočíva v vykonávaní niekoľkých QSQL výrazov a joinov, ktoré sa neinterpretuje, ale vykonáva binárny kód.
Nakoniec, na Q je možné písať aj akékoľvek servisné procesy. Napríklad Gateway procesy, ktoré automaticky rozdeľujú dopyty používateľov medzi potrebné databázy a servery. Programátor má úplnú slobodu implementovať akýkoľvek algoritmus pre vyvažovanie, prioritizáciu, odolnosť voči chybám, prístupové práva, kvoty a vlastne čokoľvek, čo chce. Hlavný problém je, že to všetko bude musieť implementovať sám.
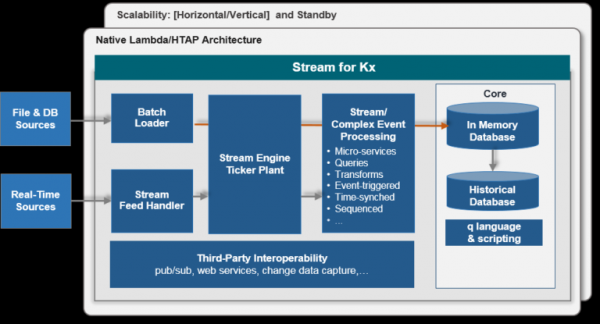
Ako príklad uvediem typy procesov, ktoré máme. Všetky sa aktívne používajú a pracujú spoločne, spájajúc do jedného celku desiatky rôznych databáz, spracovávajúc údaje z viacerých zdrojov a obsluhujúc stovky používateľov a aplikácií.
- Konektory (feedhandler) k zdrojom údajov. Tieto procesy zvyčajne využívajú externé knižnice, ktoré sú načítané v Q. C-interface v Q je mimoriadne jednoduchý a umožňuje bez námahy vytvoriť proxy funkcie pre akúkoľvek C/C++ knižnicu. Q je dosť rýchly na to, aby zvládol napríklad spracovanie toku FIX správ zo všetkých európskych burz súčasne.
- Distribútory údajov (tickerplant), ktoré slúžia ako medzistupeň medzi konektormi a spotrebiteľmi. Zároveň zapisujú prichádzajúce údaje do špeciálneho binárneho logu, zabezpečujúc odolnosť pre spotrebiteľov voči stratám spojenia alebo reštartom.
- In-memory databázy (rdb). Tieto databázy zabezpečujú maximálne rýchly prístup k surovým aktuálnym údajom, uchovávajúc ich v pamäti. Zvyčajne zhromažďujú údaje v tabuľkách počas dňa a v noci ich nulujú.
- Persist databázy (pdb). Tieto databázy zabezpečujú uchovanie údajov za dnešný deň do historickej databázy. Zvyčajne, na rozdiel od rdb, neuchovávajú údaje v pamäti, ale používajú špeciálny diskový cache počas dňa a kopírujú údaje o polnoci do historickej databázy.
- Historické databázy (hdb). Tieto databázy zabezpečujú prístup k údajom za predchádzajúce dni, mesiace a roky. Ich veľkosť (v dňoch) je obmedzená iba veľkosťou pevných diskov. Údaje môžu byť umiestnené kdekoľvek, najmä na rôznych diskoch pre urýchlenie prístupu. Existuje možnosť komprimovať údaje pomocou niekoľkých dostupných algoritmov. Štruktúra databázy je dobre zdokumentovaná a jednoduchá, údaje sú uložené po stĺpcoch v bežných súboroch, takže ich možno spracovávať aj prostriedkami operačného systému.
- Databázy s agregovanými informáciami. Uchovávajú rôzne agregácie, spravidla skupinované podľa názvu nástroja a časového intervalu. In-memory databázy aktualizujú svoj stav pri každej prichádzajúcej správe, zatiaľ čo historické uchovávajú predpočítané údaje pre urýchlenie prístupu k historickým údajom.
- Nakoniec, gateway procesy, spravujúce aplikácie a používateľov. Q umožňuje realizovať plne asynchrónne spracovanie prichádzajúcich správ, ich rozdelenie medzi databázami, kontrolu prístupových práv atď. Chcem zdôrazniť, že správy nie sú obmedzené a často nie sú SQL výrazmi, ako to býva v iných databázach. Častejšie je SQL výraz skrytý v špeciálnej funkcii a konštruuje sa na základe parametrov požadovaných používateľom — vykonáva sa konverzia času, filtrovanie, údaje sa normalizujú (napríklad cena akcií sa upravuje, ak došlo k vyplateniu dividend) atď.
Typická architektúra pre jeden typ údajov:
Rýchlosť
Hoci Q je interpretovaný jazyk, je zároveň vektorovým jazykom. To znamená, že mnoho zabudovaných funkcií, najmä aritmetických, akceptuje argumenty akéhokoľvek tvaru — čísla, vektory, matice, zoznamy, a od programátora sa očakáva, že program vytvorí ako operácie nad poliami. V takomto jazyku, ak sčítať dva vektory s miliónom prvkov, už nezáleží na tom, že jazyk je interpretovaný, sčítanie sa uskutoční superoptimalizovanou binárnou funkciou. Keďže väčšina času v programoch na Q sa venuje operáciám s tabuľkami, ktoré používajú tieto základné vektorové funkcie, výsledkom je veľmi slušná rýchlosť práce, ktorá umožňuje spracovávať obrovské objemy údajov aj v jednom procese. Je to podobné ako matematické knižnice v Pythone — hoci samotný Python je pomerne pomalý jazyk, obsahuje množstvo skvelých knižníc ako numpy, ktoré umožňujú spracovávať číselné údaje rýchlosťou kompilovaného jazyka (mimochodom, numpy je ideologicky blízka Q).
Okrem toho sa KX veľmi dôkladne venovali dizajnu tabuliek a optimalizácii práce s nimi. Po prvé, podporuje niekoľko typov indexov, ktoré sú podporované integrovanými funkciami a môžu byť aplikované nielen na stĺpce tabuliek, ale aj na akékoľvek vektory – agregácie, triedenie, atribút jedinečnosti a špeciálne agregácie pre historické databázy. Index sa aplikuje elementárne a automaticky sa opravuje pri pridávaní prvkov do stĺpca/vektora. Indexy sa rovnako úspešne môžu aplikovať na stĺpce tabuliek ako v pamäti, tak aj na disku. Pri vykonávaní QSQL dotazu sa indexy používajú automaticky, ak je to možné. Po druhé, práca s historickými dátami je realizovaná prostredníctvom mechanizmu mapovania súborov OS (memory map). Veľké tabuľky sa nikdy nenačítavajú do pamäte, namiesto toho sú potrebné stĺpce priamo mapované do pamäte a naozaj sa načíta len tá časť (tu pomáhajú taktiež indexy), ktorá je potrebná. Pre programátora nie je rozdiel, či sú dáta v pamäti alebo nie, mechanizmus práce s mmap je úplne skrytý v útrobách Q.
KDB+ je ne-relačná databáza, tabuľky môžu obsahovať ľubovoľné dáta, pričom poradie riadkov v tabuľke sa nemení pri pridávaní nových prvkov a môže a malo by sa používať pri písaní dotazov. Táto vlastnosť je ostro potrebná pre prácu s časovými radmi (dáta z burzy, telemetria, logy udalostí), pretože ak sú dáta triedené podľa času, používateľ nemusí aplikovať žiadne SQL triky, aby našiel v tabuľke prvý alebo posledný časový riadok alebo N riadkov, určil, ktorý riadok nasleduje za N-tým riadkom atď. Ešte viac sa zjednodušujú JOINy tabuliek, napríklad nájdenie poslednej ponuky pre 16 000 transakcií VOD.L (Vodafone) v tabuľke s 500 miliónmi prvkov trvá na disku asi sekundu a niekoľko milisekúnd v pamäti.
Príklad JOINu podľa času – tabuľka quote je mapovaná do pamäte, preto nie je potrebné uvádzať VOD.L v klauzule where, implicitne sa používajú indexy na stĺpci sym a fakt, že dáta sú triedené podľa času. Takmer všetky JOINy v Q sú obyčajné funkcie, a nie časť select výrazu:
1. aj[`sym`time;select from trade where date=2019.03.26, sym=`VOD.L;select from quote where date=2019.03.26]
Nakoniec treba poznamenať, že inžinieri v KX, vrátane samotného Arthura Whitneyho, sú naozaj posadnutí efektivitou a robia všetko pre to, aby vyžmýkali maximum z štandardných funkcií Q a optimalizovali najčastejšie vzory používania.
Záver
KDB+ je populárna medzi podnikmi predovšetkým vďaka svojej výnimočnej univerzálnosti — funguje rovnako dobre ako in-memory databáza, tak aj ako databáza pre ukladanie terabajtov historických dát a ako platforma pre analýzu dát. Vďaka tomu, že spracovanie dát prebieha priamo v databáze, sa dosahuje vysoká rýchlosť a úspora zdrojov. Plnohodnotný programovací jazyk integrovaný s funkciami databázy umožňuje realizáciu celého stacku potrebných procesov na jednej platforme — od získavania dát po spracovanie používateľských dotazov.
Ďalšie informácie
Nevýhody
Podstatnou nevýhodou KDB+\/Q je vysoký prah vstupu. Jazyk má zvláštnu syntaxu, niektoré funkcie sú silne preťažené (napríklad value má okolo 11 možností využitia). Najdôležitejšie je, že vyžaduje radikálne odlišný prístup k písaniu programov. Vektoriálny jazyk si vyžaduje neustále myslieť v termínoch transformácií polí a všetky cykly realizovať pomocou niekoľkých variantov funkcií map\/reduce (ktoré sa v Q nazývajú adverb), nikdy sa nepokúšať šetriť, nahradením vektorových operácií atomárnymi. Napríklad, na nájdenie indexu N-teho výskytu prvku v poli by sa malo písať:
1. (where element=vector)[N]
aj keď to vyzerá hrozne neefektívne z pohľadu C\/Java (= vytvára boolean vektor, kde where vracia indexy true prvkov v ňom). Avšak takýto zápis robí zmysel výrazu zrozumiteľnejším a používate rýchle vektorové operácie namiesto pomalých atomárnych. Koncepčný rozdiel medzi vektoriálnym jazykom a ostatnými je porovnateľný s rozdielom medzi imperatívnym a funkcionálnym prístupom k programovaniu, na čo je potrebné byť pripravený.
Niektorí používatelia sú tiež nespokojní s QSQL. Je to preto, že len pripomína skutočný SQL. V skutočnosti ide iba o interpretátor SQL-podobných výrazov, ktorý nepodporuje optimalizáciu dopytov. Používateľ si musí sám písať optimálne dopyty, pričom na Q, na čo sa mnohí ukazujú ako nepripravení. Na druhej strane je samozrejme vždy možné napísať optimálny dopyt sám, bez toho aby sme sa spoliehali na čiernu skrinku-optimalizátor.
Ako plus, kniha o Q — Q For Mortals je dostupná zdarma na , kde je tiež sústredených mnoho ďalších užitočných materiálov.
Ďalšou veľkou nevýhodou je cena licencie. Ide o desiatky tisíc dolárov ročne za jeden CPU. Iba veľké firmy si môžu dovoliť takéto výdavky. V poslednej dobe KX zmenila licenčnú politiku na flexibilnejšiu a ponúka možnosť platiť len za čas využívania, alebo prenajať KDB+ v cloudových službách Google a Amazon. KX takisto ponúka na stiahnutie (32-bitová verzia alebo 64-bitová na požiadanie).
Konkurenti
Existuje množstvo špecializovaných databáz založených na podobných princípoch — stĺpcové, in-memory, zamerané na veľmi veľké objemy dát. Problém je v tom, že ide presne o špecializované databázy. Jasný príklad — Clickhouse. Tento databázový systém má veľmi podobný postup ukladania dát na disku a budovania indexu ako KDB+, niektoré dotazy vykonáva rýchlejšie ako KDB+, hoci len nepatrne. Ale aj ako databáza je Clickhouse oveľa špecializovanejší ako KDB+ — webová analytika vs. ľubovoľné časové rady (tento rozdiel je veľmi dôležitý — kvôli nemu napríklad v Clickhouse nie je možné používať poradie záznamov). No hlavne, Clickhouse nemá univerzálnosť KDB+, jazyka, ktorý by umožnil spracovávať dáta priamo v databáze, namiesto toho, aby ich predtým načítal do samostatnej aplikácie, vytváral ľubovoľné SQL výrazy, aplikoval ľubovoľné funkcie v dotaze, vytváral procesy, ktoré nie sú spojené s vykonávaním funkcií historickej databázy. Preto je ťažké porovnávať KDB+ s inými databázami, môžu byť lepšie v určitých scenároch použitia alebo jednoducho lepšie, ak ide o úlohy klasických databáz, ale nepoznám iný tak efektívny a univerzálny nástroj na spracovanie časových dát.
Integrácia s Python
Aby sa zjednodušila práca s KDB+ pre ľudí, ktorí nie sú oboznámení s touto technológiou, spoločnosť KX vytvorila knižnice na úzku integráciu s Python v rámci jedného procesu. Môžete volať akúkoľvek python funkciu z Q a naopak — volať akúkoľvek Q funkciu z Python (v prípade QSQL výrazov). Knižnice konvertujú pri potrebe (pre efektivitu nie vždy) dáta z formátu jedného jazyka do formátu druhého. V dôsledku toho Q a Python existujú v tak tesnom symbiote, že hranice medzi nimi sa rozmazávajú. Výsledkom je, že programátor má na jednej strane plný prístup k množstvu užitočných knižníc Pythonu, na druhej strane dostáva do Pythonu integrovanú rýchlu databázu pre prácu s veľkými dátami, čo je obzvlášť užitočné pre tých, ktorí sa zaoberajú strojovým učením alebo modelovaním.
Práca s Q v Pythone:
1. >>> q()
2. q)trade:([]date:();sym:();qty:())
3. q)
4. >>> q.insert('trade', (date(2006,10,6), 'IBM', 200))
5. k(',0')
6. >>> q.insert('trade', (date(2006,10,6), 'MSFT', 100))
7. k(',1')
Odkazy
Webová stránka spoločnosti —
Web pre vývojárov —
Kniha Q For Mortals (v angličtine) —
Články na tému využitia KDB+/Q od zamestnancov kx —
Zdroj: habr.com
