

Úspešne sme navrhli štruktúru našej databázy PostgreSQL na uchovávanie komunikácie, prešiel rok, používatelia ju aktívne napĺňajú, tu už máme milióny záznamov, a… niečo začalo spomaľovať.
- Časť 2: sekciujeme „naživo“
Ide o to, že s rastom objemu tabuľky rastie aj „hĺbka“ indexov — aj keď logaritmicky. Ale časom to núti server spracovávať pri vykonávaní rovnakých úloh čítania/zápisu o niekoľkokrát viac stránok dát, než na začiatku.
Tu prichádza na pomoc sekcionovanie.
Poznamenám, že nebudeme hovoriť o shardovaní, teda rozdeľovaní dát medzi rôzne databázy alebo servery. Pretože aj keby ste rozdelili dáta na niekoľkých serveroch, nijako sa nezbavíte problému „zväčšovania“ indexov s časom. Je jasné, že ak si môžete dovoliť každý deň zavádzať nový server do prevádzky, vaše problémy už budú ležať v úplne inej oblasti ako konkrétna databáza.
My sa však pozrieme na prístupy, nie na konkrétne skripty na implementáciu sekcionovania „v železe“ — čo a ako by sa malo „rezať na kusy“ a k čomu toto želanie vedie.
Koncept
Ešte raz si stanovíme náš cieľ: chceme zabezpečiť, aby dnes, zajtra a aj o rok zostal počet čítaných dát PostgreSQL pri akejkoľvek operácii čítania/zápisu približne rovnaký.
Pre všetky chronologicky nahromadené dáta (správy, dokumenty, protokoly, archívy, …) je prirodzenou voľbou ako kľúč na sekcionovanie dátum/čas udalosti. V našom prípade takou udalosťou je moment odoslania správy.
Všimnite si, že používatelia takmer vždy pracujú iba s „najnovšími“ takými dátami — čítajú posledné správy, analyzujú posledné protokoly,… Nie, samozrejme, môžu prelistovať aj dozadu v čase, ale robia to veľmi zriedka.
Z týchto obmedzení sa jasne ukazuje, že optimálnym riešením pre správy budú „denné“ sekcie — pretože takmer vždy bude náš používateľ čítať to, čo mu prišlo „dnes“ alebo „včera“.
Ak počas dňa píšeme a čítame prakticky iba v jednej sekcii, poskytuje nám to aj efektívnejšie využitie pamäti a disku — pretože všetky indexy sekcie sa pohodlne vojdú do pamäte, na rozdiel od „veľkých a bulkých“ v celej tabuľke.
step-by-step
Vše, čo bolo doteraz povedané, znie ako jeden veľký zisk. Je to dosiahnuteľné, ale budeme sa musieť veľmi snažiť — pretože rozhodnutie oddeliť jednu z entít vedie k potrebe „rozrezať“ aj súvisiace s ňou.
Správa, jej vlastnosti a projekcie
Keď sme sa rozhodli deliť správy podľa dátumov, je rozumné rozdeliť aj závislé vlastnosti (prílohy, zoznam príjemcov) a taktiež podľa dátumu správy.
Keďže jednou z našich typických úloh je práve prezeranie registrov správ (neprečítané, prichádzajúce, všetky), je logické tiež zapojiť ich do delenia podľa dátumov správ.
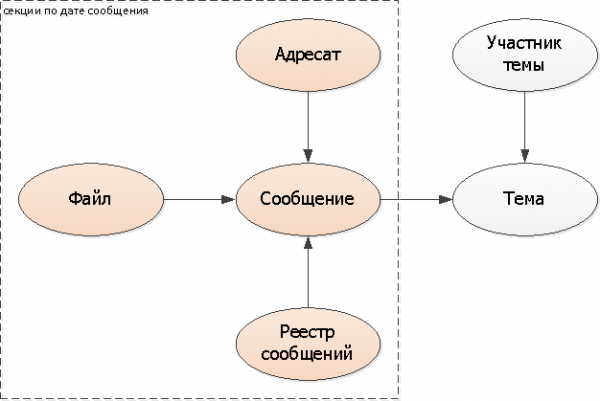
Pridávame kľúč pre delenie (dátum správy) do všetkých tabuliek: príjemcovia, súbor, registre. Do samotnej správy ho nemusíte pridávať, stačí použiť existujúce DátumČas.
Témy
Keďže téma sa vzťahuje na viacero správ, nie je možné ju „pokrájať“ v tej istej štruktúre, musíme sa opierať o niečo iné. V našom prípade je ideálne dátum prvej správy v korešpondencii — teda okamih vytvorenia, samotnej témy.
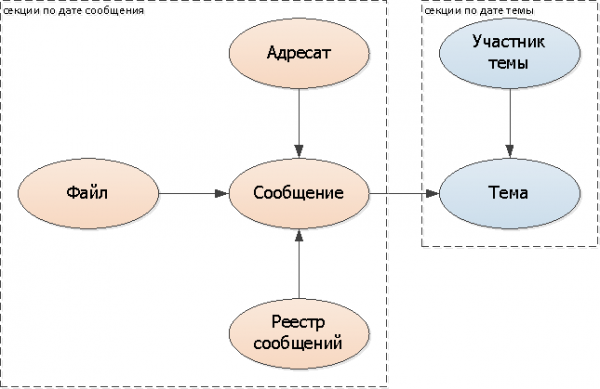
Pridávame kľúč pre delenie (dátum témy) do všetkých tabuliek: téma, účastník.
Ale teraz sa nám objavujú hneď dve problémy:
- v ktorej sekcii hľadať správy podľa témy?
- v ktorej sekcii hľadať tému od správy?
Samozrejme, môžeme pokračovať v hľadaní vo všetkých sekciách, ale to by bolo veľmi smutné a zmarilo by to všetky naše výhody. Preto, aby sme vedeli, kde konkrétne hľadať, vytvoríme logické odkazy/ukazovatele na sekcie:
- do správy pridáme pole s dátumom témy
- k téme pridáme sadu dátumov správ tejto korešpondencie (môže to byť samostatná tabuľka alebo pole dát)
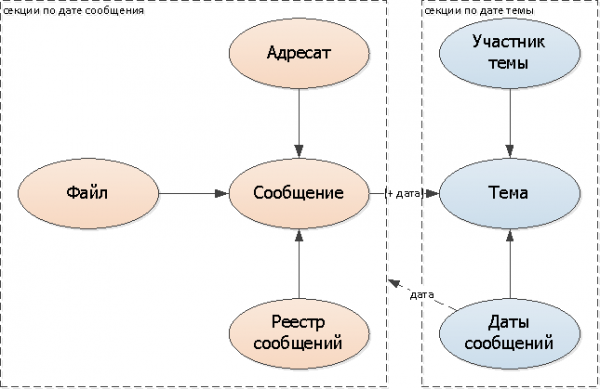
Keďže počet modifikácií zoznamu dátumov správ pre každú jednotlivú korešpondenciu bude malý (veď takmer všetky správy spadajú do 1-2 susedných dní), zastavím sa pri tejto variante.
Celkovo naša štruktúra databázy nadobudla nasledujúcu podobu s ohľadom na delenie:
Tabuľky: RU, pri nechuti k azbuke v názvoch tabuliek/polí je lepšie nepozerať
-- sekcie podľa dátumu správy
CREATE TABLE "Správa_YYYYMMDD"(
  "Správa"
    uuid
      PRIMARY KEY
, "Téma"
    uuid
, "DátumTémy"
    date
, "Autor"
    uuid
, "DátumČasu" -- používame ako dátum
    timestamp
, "Text"
    text
);

CREATE TABLE "Adresát_YYYYMMDD"(
  "DátumSprávy"
    date
, "Správa"
    uuid
, "Osoba"
    uuid
, PRIMARY KEY("Správa", "Osoba")
);

CREATE TABLE "Súbor_YYYYMMDD"(
  "DátumSprávy"
    date
, "Súbor"
    uuid
      PRIMARY KEY
, "Správa"
    uuid
, "BLOB"
    uuid
, "Meno"
    text
);

CREATE TABLE "RegisterSpráv_YYYYMMDD"(
  "DátumSprávy"
    date
, "Majiteľ"
    uuid
, "TypRegistra"
    smallint
, "DátumČasu"
    timestamp
, "Správa"
    uuid
, PRIMARY KEY("Majiteľ", "TypRegistra", "Správa")
);
CREATE INDEX ON "RegisterSpráv_YYYYMMDD"("Majiteľ", "TypRegistra", "DátumČasu" DESC);

-- sekcie podľa dátumu témy
CREATE TABLE "Téma_YYYYMMDD"(
  "DátumTémy"
    date
, "Téma"
    uuid
      PRIMARY KEY
, "Dokument"
    uuid
, "Názov"
    text
);

CREATE TABLE "ÚčastníkTémy_YYYYMMDD"(
  "DátumTémy"
    date
, "Téma"
    uuid
, "Osoba"
    uuid
, PRIMARY KEY("Téma", "Osoba")
);

CREATE TABLE "DátumySprávTémy_YYYYMMDD"(
  "DátumTémy"
    date
, "Téma"
    uuid
      PRIMARY KEY
, "Dátum"
    date
);
Šetríme centík
No, ak nepoužijeme na základe rozdelenia hodnôt poľa (cez spúšťače a dedičstvo alebo PARTITION BY), ale "ručne" na úrovni aplikácie, je možné si všimnúť, že hodnota kľúča sekciovania sa už nachádza v názve samotnej tabuľky.
Preto ak ste tak silne znepokojení objemom uchovávaných dát, môžete sa zbaviť týchto "zbytočných" polí a adresne pristupovať k konkrétnym tabuľkám. Pravda, všetky výbery z viacerých sekcií budete musieť presunúť na stranu aplikácie.
Zdroj: habr.com
