

RabbitMQ – správy broker napísaný v jazyku Erlang, ktorý umožňuje organizovať odolný klaster s plnou replikáciou dát na viacerých uzloch, pričom každý uzol môže obsluhovať požiadavky na čítanie a zápis. S množstvom klastrov Kubernetes v produkcii podporujeme veľké množstvo inštalácií RabbitMQ a stretli sme sa s potrebou migrácie dát z jedného klasteru do druhého bez výpadku.
Táto operácia bola pre nás nevyhnutná minimálne v dvoch prípadoch:
- Prenos údajov z klasteru RabbitMQ, ktorý nie je v Kubernetes, do nového – už "kubernetizovaného" (t.j. fungujúceho v pod'ach K8s) – klasteru.
- Migrácia RabbitMQ v rámci Kubernetes z jedného namespace do druhého (napríklad, ak sú kontúry rozdelené priestorami mien, tak pre prenos infraštruktúry z jedného kontúru do druhého).
Navrhnutý recept v článku je orientovaný na situácie (ale nie je nimi obmedzený), v ktorých existuje starý klaster RabbitMQ (napríklad z 3 uzlov), ktorý je buď už v K8s, alebo na nejakých starých serveroch. S ním pracuje aplikácia umiestnená v Kubernetes (už tam alebo v perspektíve):
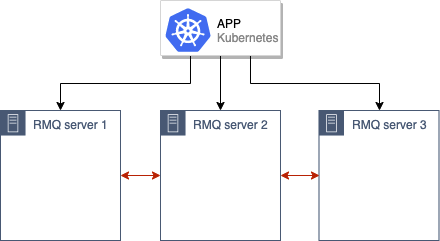
… a pred nami stojí úloha jeho migrácie do nového produkčného prostredia v Kubernetes.
Najprv bude opísaný všeobecný prístup k samotnej migrácii, a až po tom – technické detaily jej realizácie.
Algoritmus migrácie
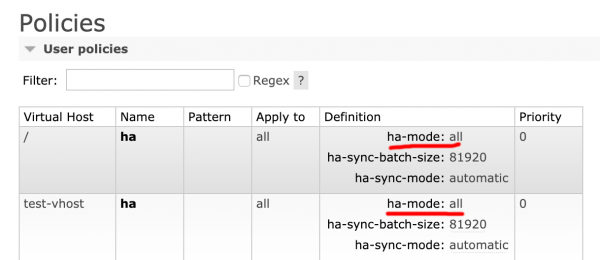
Prvý, predbežný krok pred akýmikoľvek akciami – overenie, či je v starej inštalácii RabbitMQ zapnutý režim vysokej dostupnosti (). Dôvod je zrejmý – predsa nechceme stratiť žiadne údaje. Na vykonanie tejto kontroly môžeme vstúpiť do administrátorskej sekcie RabbitMQ a v karte Admin → Policies sa uistiť, že je nastavená hodnota ha-mode: all:
Ďalším krokom je spustenie nového klasteru RabbitMQ v pod'ach Kubernetes (v našom prípade, napríklad pozostávajúceho z 3 uzlov, ale ich počet môže byť aj iný).
Potom spojíme starý a nový klaster RabbitMQ a získame jediný klaster (zo 6 uzlov):
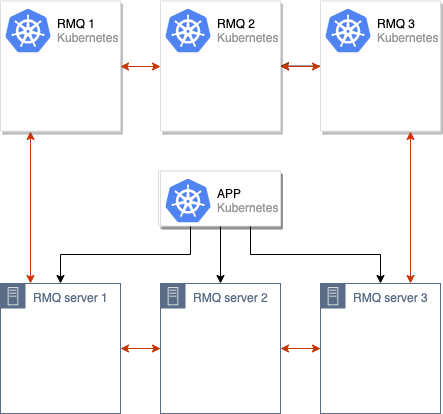
Spúšťa sa proces synchronizácie údajov medzi starými a novými klastrami RabbitMQ. Po tom, čo sa všetky údaje synchronizujú medzi všetkými uzlami v klasteri, môžeme prepnúť aplikáciu na používanie nového klasteru:
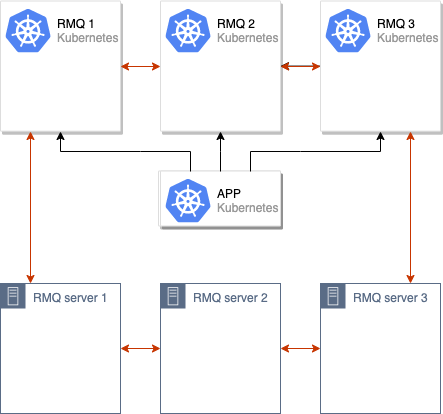
Po týchto operáciách stačí vyradiť staré uzly z RabbitMQ klasteru a presťahovanie môžeme považovať za dokončené:
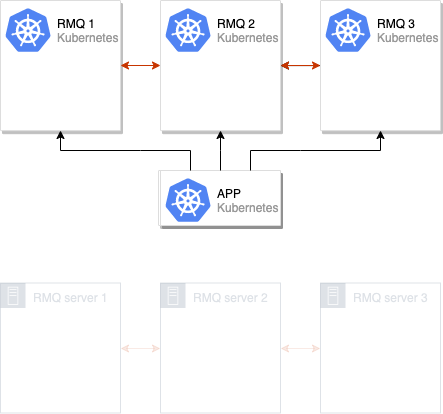
Tento schéma sme opakovane aplikovali v našej produkcii. Pre vlastné pohodlie sme ju však implementovali v rámci špecializovaného systému, ktorý distribuuje typické konfigurácie RMQ na množstvách klastrov Kubernetes (pre tých, ktorí sú zvedaví: hovoríme o , o ktorom sme ). Nižšie budú uvedené samostatne vybrané inštrukcie, ktoré si môže každý aplikovať na svoje inštalácie, aby vyskúšal navrhované riešenie v praxi.
Skúšame v praxi
Požiadavky
Rekvizity sú veľmi jednoduché:
- Kubernetes cluster (vhodný aj minikube);
- Klastre RabbitMQ (môže byť nasadený aj na bare metal, a vytvorený ako bežný klaster v Kubernetes z oficiálneho Helm chartu).
Pre nižšie uvedený príklad som nasadil RMQ v Kubernetes a nazval ho rmq-old.
Príprava testovacieho prostredia
1. Stiahneme Helm chart a trochu ho upravíme:
helm fetch --untar stable/rabbitmq-ha Pre pohodlie nastavíme heslo, ErlangCookie a nastavíme politiku ha-all, aby sa fronty synchronizovali medzi všetkými uzlami klastru RMQ:
rabbitmqPassword: guest
rabbitmqErlangCookie: mae9joopaol7aiVu3eechei2waiGa2we
definitions:
policies: |-
  {
    "name": "ha-all",
    "pattern": ".*",
    "vhost": "\/",
2. Inštalujeme chart:
helm install . --name rmq-old --namespace rmq-old3. Vstúpime do administrácie RabbitMQ, vytvoríme novú frontu a pridáme niekoľko správ. Budú potrebné na to, aby sme sa po migrácii presvedčili, že všetky dáta zostali zachované a nič sa nestratilo:

Testovacie prostredie je pripravené: máme „starý“ RabbitMQ s dátami, ktoré je potrebné preniesť.
Migrácia klastru RabbitMQ
1. Na začiatok nasadíme nový RabbitMQ v druhém namespace s rovnakými ErlangCookie a heslom pre používateľa. Na to vykonáme vyššie popísané operácie, pričom zmeníme posledný príkaz na inštaláciu RMQ na nasledujúci:
helm install . --name rmq-new --namespace rmq-new2. Teraz je potrebné spojiť nový klaster so starým. Za týmto účelom sa prihlásime do každého z pod'ov nového RabbitMQ a vykonáme príkazy:
export OLD_RMQ=rabbit@rmq-old-rabbitmq-ha-0.rmq-old-rabbitmq-ha-discovery.rmq-old.svc.cluster.local &&
  rabbitmqctl stop_app &&
  rabbitmqctl join_cluster $OLD_RMQ &&
  rabbitmqctl start_app
V premennej OLD_RMQ sa nachádza adresa jedného z uzlov starého klastru RMQ.
Tieto príkazy zastavia aktuálny uzol nového klastru RMQ, pripoja ho k starému klastru a opäť spustia.
3. Klaster RMQ zo 6 uzlov je pripravený:
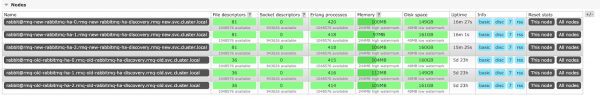
Je potrebné počkať, kým sa správy synchronizujú medzi všetkými uzlami. Nie je ťažké uhádnuť, že čas synchronizácie správ závisí od výkonu hardvéru, na ktorom je cluster nasadený, a od počtu správ. V popisovanom scenári ich je len 10, a preto sa údaje synchronizovali okamžite, ale pri dostatočne veľkom počte správ môže synchronizácia trvať hodiny.
Takže, stav synchronizácie:

Tu +5 znamená, že správy sú už na ešte 5 uzloch (okrem toho, ktorý je uvedený v poli Node). Týmto spôsobom sa synchronizácia úspešne uskutočnila.
4. Ostáva len prepnúť v aplikácii adresu RMQ na nový cluster (konkrétne kroky závisia od technologického rámca, ktorý používate, a ďalších špecifík aplikácie), po čom sa môžete rozlúčiť so starým.
Pre poslednú operáciu (t.j. už po prepnúť aplikáciu na nový cluster) sa prihláste na každý uzol starého clusteru a vykonajte príkazy:
rabbitmqctl stop_app
rabbitmqctl reset
Cluster sa 'zabudol' na staré uzly: starý RMQ môžete odstrániť, čím sa presun dokončí.
Poznámka: Ak používate RMQ so certifikátmi, tak zásadne sa nič nemení — proces migrácie sa uskutoční presne takto.
Zhrnutie
Opísaná schéma je vhodná takmer vo všetkých prípadoch, keď potrebujeme preniesť RabbitMQ alebo jednoducho presťahovať do nového clustra.
V našom prípade nastali problémy len raz, keď sa na RMQ obracalo z mnohých miest a nemali sme možnosť zmeniť adresu RMQ na novú. Vtedy sme spustili nový RMQ v rovnakom namespace s rovnakými značkami, aby sa umiestnil pod existujúce služby a Ingressy, a pri spustení podu sme manipulovali so značkami, odstraňovali ich na začiatku tak, aby na prázdny RMQ nechodili požiadavky, a pridávali ich späť po synchronizácii správ.
Rovnakú stratégiu sme aplikovali pri aktualizácii RabbitMQ na novú verziu so zmenenou konfiguráciou — všetko fungovalo ako hodinky.
P.S.
Ako logické pokračovanie tohto materiálu pripravujeme články o MongoDB (migrácia z hardvérového servera do Kubernetes) a MySQL (ako pripravujeme túto DBMS vo vnútri Kubernetes). Bude publikovaný v najbližších mesiacoch.
P.P.S.
Prečítajte si tiež na našom blogu:
- «»;
- «».
Zdroj: habr.com
