

Úvodné slovo
Tento referát som predniesol v angličtine na konferencii GopherCon Russia 2019 v Moskve a v ruštine na meetupe v Nižnom Novgorode. Hovorí sa v ňom o bitmapovom indexe — menej rozšírenom ako B-tree, ale rovnako zaujímavom. Zdieľam prezentácie na konferencii v angličtine a textovú transkripciu v ruštine.
Preskúmame, ako funguje bitmapový index, kedy je lepší, kedy horší ako iné indexy a v ktorých prípadoch je výrazne rýchlejší ako oni; uvidíme, v ktorých populárnych DBMS už existujú bitmapové indexy; pokúsime sa napísať svoj na Go. A na „dezert“ využijeme existujúce knižnice na vytvorenie našej superrýchlej špecializovanej databázy.
Veľmi dúfam, že moje úsilie bude pre vás užitočné a zaujímavé. Poďme na to!
Úvod

Ahojte všetci! Teraz je šesť hodín večer, všetci sme veľmi unavení. Skvelý čas na to, aby sme hovorili o nudnej teórii indexov databáz, čo poviete? Nebojte sa, tu a tam budem mať pár riadkov zdrojového kódu. 🙂
Bez žartov, táto prezentácia je preplnená informáciami a nemáme veľa času. Takže začnime.
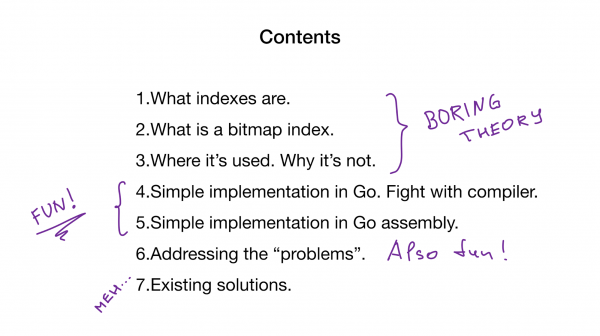
Dnes budem hovoriť o nasledovnom:
- čo sú indexy;
- čo je bitmapový index;
- kde sa používa a kde sa NEMA používa a prečo;
- jednoduchá implementácia na Go a trochu boja s kompilátorom;
- o niečo menej jednoduchá, ale oveľa výkonejšia implementácia na Go assembleri;
- problémy bitmapových indexov;
- existujúce implementácie.
Čo sú teda indexy?
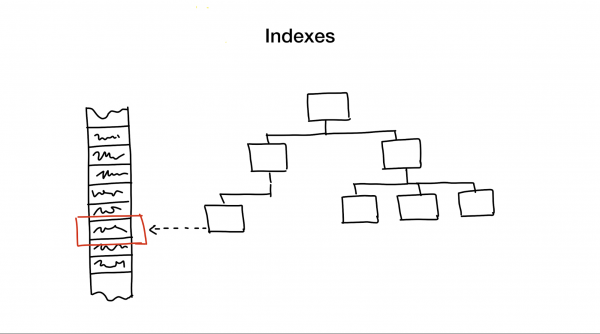
Index je samostatná štruktúra údajov, ktorú uchovávame a aktualizujeme ako doplnok k hlavným údajom. Používa sa na zrýchlenie vyhľadávania. Bez indexov by vyžadovalo vyhľadávanie úplný priechod údajmi (proces nazývaný full scan) a tento proces má lineárnu algoritmickú zložitost. Ale databázy obvykle obsahujú obrovské množstvo údajov a lineárna zložitost je príliš pomalá. Ideálne by sme chceli dosiahnuť logaritmickú alebo konštantnú.
Toto je obrovské zložitá téma, preplnená nuansami a kompromismi, ale po pohľade na desiatky rokov vývoja a výskumu rôznych databáz som pripravený tvrdiť, že existuje len niekoľko široko používaných prístupov k vytváraniu indexov DB.
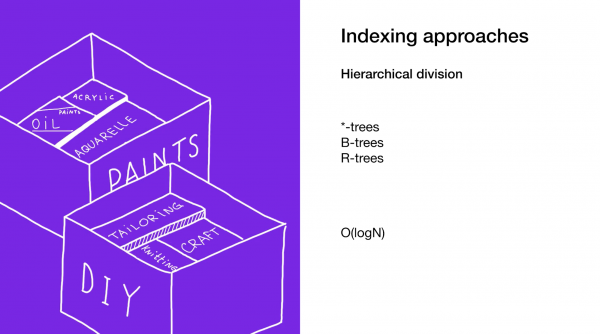
Prvý prístup spočíva v hierarchickom zúžení vyhľadávacej oblasti, rozdelení vyhľadávacej oblasti na menšie časti.
Zvyčajne to robíme pomocou rôznych typov stromov. Príkladom môže byť veľká krabica s materiálmi vo vašej skrini, v ktorej sa nachádzajú menšie krabice s materiálmi rozdelenými podľa rôznych tém. Ak potrebujete materiály, určite ich budete hľadať v krabici s nápisom „Materiály“, nie v tej, na ktorej je napísané „Sušienky“, že?
Druhý prístup spočíva v tom, že okamžite vyčleníme požadovaný prvok alebo skupinu prvkov. Robíme to v hash mapách alebo v reverzných indexoch. Použitie hash máp je veľmi podobné predchádzajúcemu príkladu, len namiesto krabice s krabicami máte vo svojej skrini hromadu malých krabíc s konečnými predmetmi.
Tretí prístup — zbaviť sa potreby vyhľadávania. To robíme pomocou Bloom filtrov alebo cuckoo filtrov. Prvé okamžite poskytnú odpoveď, čím vás zbavujú potreby uskutočňovať vyhľadávanie.
Posledný prístup spočíva v plnom využití všetkých výkonov, ktoré nám moderný hardvér poskytuje. Presne to robíme v bitmapových indexoch. Áno, pri ich použití niekedy musíme prejsť celým indexom, ale robíme to super efektívne.
Ako som už povedal, téma databázových indexov je rozsiahla a plná kompromisov. To znamená, že niekedy môžeme použiť viacero prístupov súčasne: ak potrebujeme ešte viac urýchliť vyhľadávanie alebo ak je potrebné pokryť všetky možné typy vyhľadávania.
Dnes vám poviem o najmenej známych prístupoch z uvedených — o bitmapových indexoch.
Kto som, aby som hovoril o tejto téme?
Pracujem ako tímový líder v Badoo (možno poznáte náš iný produkt — Bumble). Už máme viac ako 400 miliónov používateľov po celom svete a množstvo funkcií, ktoré sa zaoberajú tým, že pre nich vyhľadávajú najlepšie páry. Robíme to pomocou vlastných služieb, ktoré používajú aj bitmapové indexy.
Čo je to teda bitmapový index?
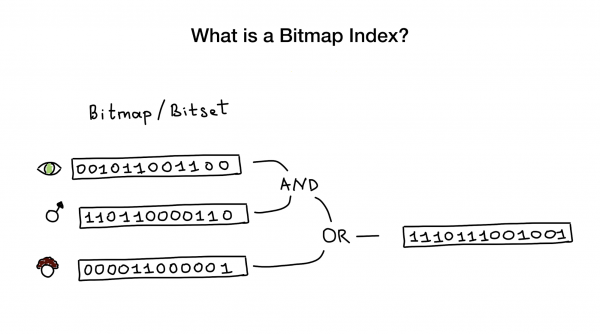
Bitmap indexy, ako naznačuje názov, používajú bitmapy alebo bitové súbory na implementáciu vyhľadávacieho indexu. Z výšky vtáčej perspektívy pozostáva tento index z jedného alebo viacerých takých bitmapov, ktoré predstavujú nejaké entity (napríklad ľudí) a ich vlastnosti alebo parametre (vek, farba očí atď.) a z algoritmu, ktorý používa bitové operácie (AND, OR, NOT) na odpoveď na vyhľadávací dopyt.
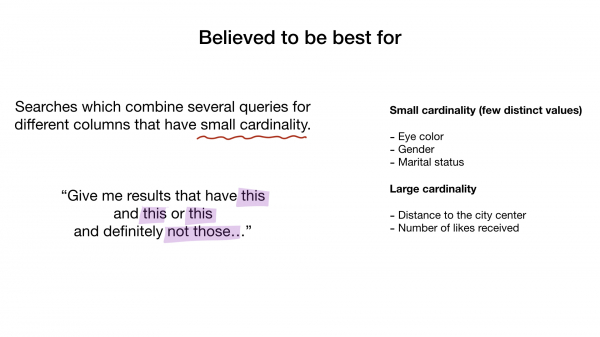
Hovorí sa, že bitmap indexy sú najlepšie a veľmi efektívne pre prípady, kde je vyhľadávanie kombinujúce dopyty na viacerých stĺpcoch s nízkou kardinalitou (predstavte si „farbu očí“ alebo „rodinný stav“ v porovnaní s niečím ako „vzdialenosť od centra mesta“). Ale neskôr ukážem, že fungujú skvele aj v prípade stĺpcov s vysokou kardinalitou.
Pozrime sa na najjednoduchší príklad bitmap indexu.
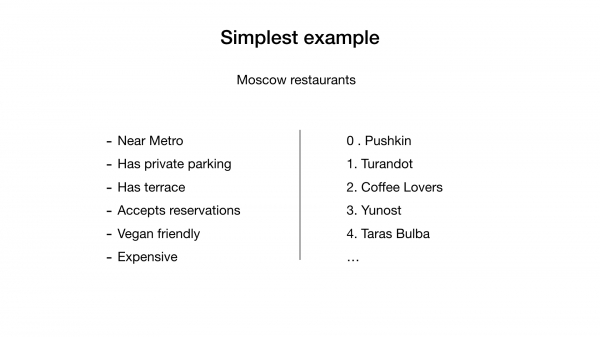
Predstavte si, že máme zoznam moskovských reštaurácií s binárnymi vlastnosťami, ako sú tieto:
- blízko metra (near metro);
- má súkromné parkovanie (has private parking);
- má terasu (has terrace);
- je možné rezervovať stôl (accepts reservations);
- je vhodná pre vegetariánov (vegan friendly);
- drahá (expensive).
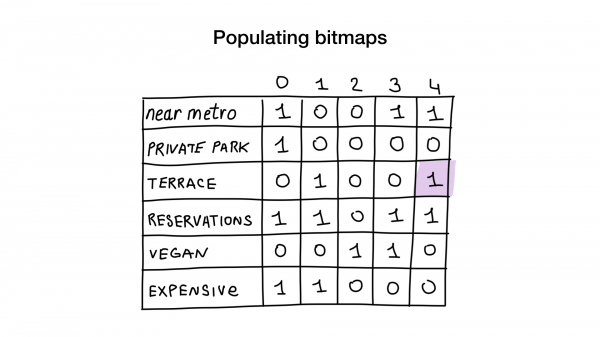
Dajte každému reštaurácii poradové číslo od 0 a vyhraďte pamäť pre 6 bitmapov (jeden pre každú vlastnosť). Potom tieto bitmapy vyplníme v závislosti od toho, či má reštaurácia danú vlastnosť alebo nie. Ak má reštaurácia č. 4 terasu, bit č. 4 v bitmape „má terasu“ bude nastavený na 1 (ak terasa nie je, potom na 0).
Teraz máme najjednoduchší bitmap index, aký si vieme predstaviť, a môžeme ho použiť na odpovedanie na dopyty ako:
- „Zobraz mi reštaurácie, ktoré sú vhodné pre vegetariánov“;
- „Zobraz mi lacné reštaurácie s terasou, kde je možné rezervovať stôl.“
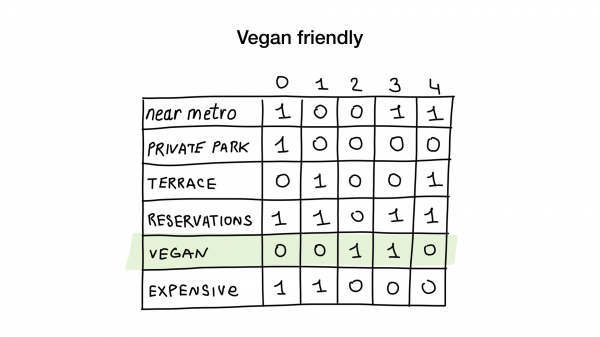
Ako? Pozrime sa. Prvý dopyt je veľmi jednoduchý. Všetko, čo potrebujeme, je vziať bitmapu „vhodné pre vegetariánov“ a premeniť ju na zoznam reštaurácií, ktorých bity sú nastavené.
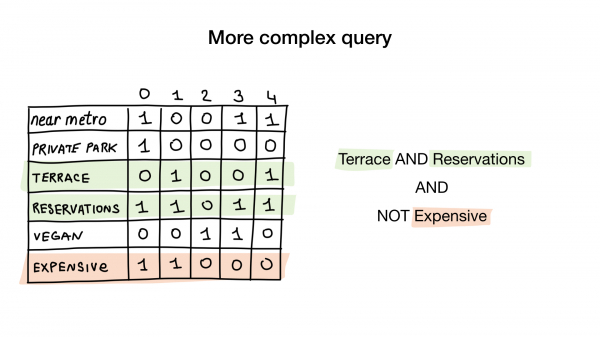
Druhá otázka je trochu zložitejšia. Musíme použiť bitovú operáciu NOT na bitmapu "drahý", aby sme získali zoznam lacných reštaurácií, potom to spojíme s bitmapou "je možné rezervovať stôl" a výsledok spojíme s bitmapou "má terasu". Výsledná bitmapa bude obsahovať zoznam zariadení, ktoré spĺňajú všetky naše kritériá. V tomto prípade je to len reštaurácia "Junost".
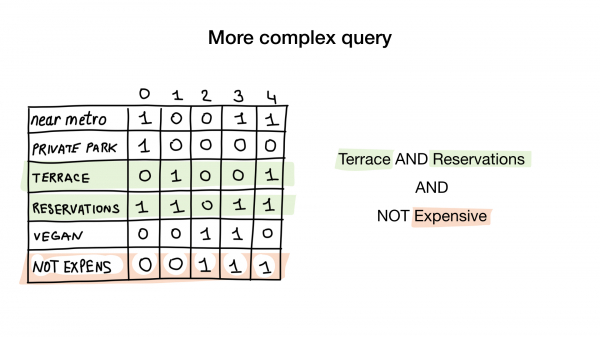
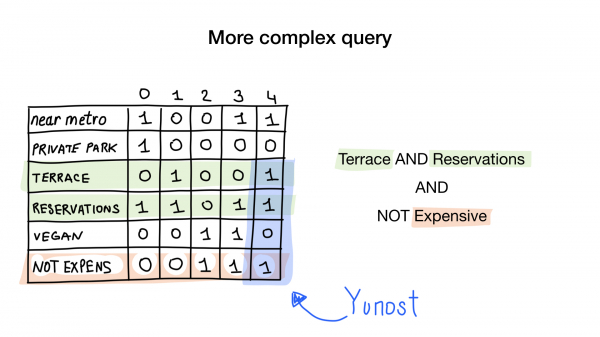
Tu je veľa teórie, ale nebojte sa, čoskoro uvidíme kód.
Kde sa používajú bitmapové indexy?
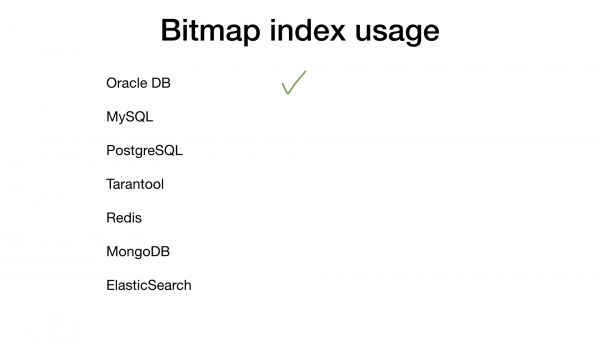
Ak "googlite" bitmapové indexy, 90 % odpovedí bude nejakým spôsobom spojených s Oracle DB. Ale ostatné DBMS tiež určite podporujú takúto skvelú vec, však? Nie úplne.
Prejdime si zoznam hlavných podozrivých.
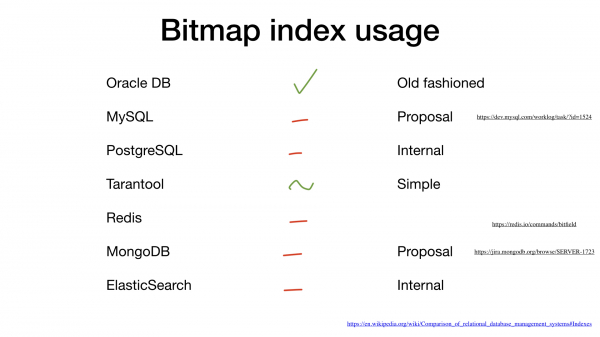
MySQL ešte nepodporuje bitmapové indexy, ale existuje návrh na pridanie tejto možnosti ().
PostgreSQL nepodporuje bitmapové indexy, ale používa jednoduché bitmapy a bitové operácie na kombinovanie výsledkov vyhľadávania podľa niekoľkých iných indexov.
Tarantool má bitset indexy, podporuje jednoduché vyhľadávanie podľa nich.
Redis má jednoduché bitové polia) bez možnosti vyhľadávania podľa nich.
MongoDB ešte nepodporuje bitmapové indexy, ale tiež existuje návrh na pridanie tejto možnosti.
Elasticsearch používa bitmapy vo vnútri.).
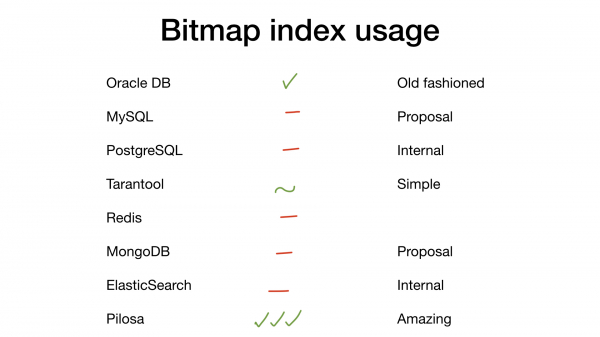
- Ale v našom dome sa objavil nový sused: Pilosa. Toto je nová nerelačná databáza napísaná v Go. Obsahuje len bitmapové indexy a všetko zakladá na nich. O nej si povieme neskôr.
Implementácia v Go.
Ale prečo sú bitmapové indexy tak zriedkavo používané? Predtým, ako odpoviem na túto otázku, by som vám chcel ukázať implementáciu veľmi jednoduchého bitmapového indexu v Go.
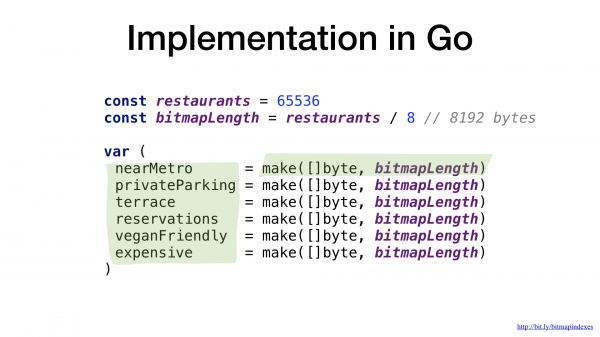
Bitmaps sú v podstate reprezentované jednoducho ako kusy údajov. V Go na to využijeme plátky bajtov.
Máme jednu bitmapu pre jednu reštauračnú charakteristiku a každý bit v bitmape hovorí o tom, či konkrétna reštaurácia má túto vlastnosť alebo nie.
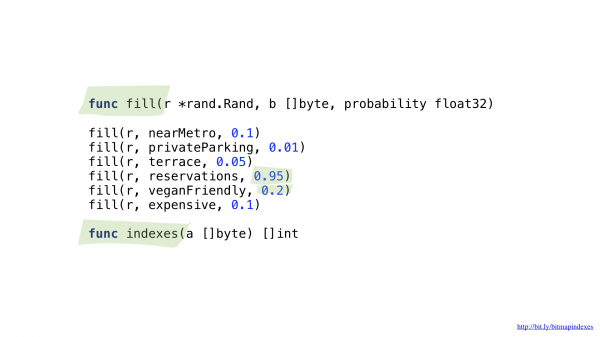
Potrebujeme dve pomocné funkcie. Jedna bude použitá na naplnenie našich bitmapov náhodnými údajmi. Náhodnými, ale s určitými pravdepodobnosťami, že reštaurácia má každú vlastnosť. Napríklad si myslím, že v Moskve je veľmi málo reštaurácií, kde nie je možné rezervovať stôl, a zdá sa mi, že približne 20 % podnikov je vhodných pre vegetariánov.
Druhá funkcia prevedie bitmapu na zoznam reštaurácií.
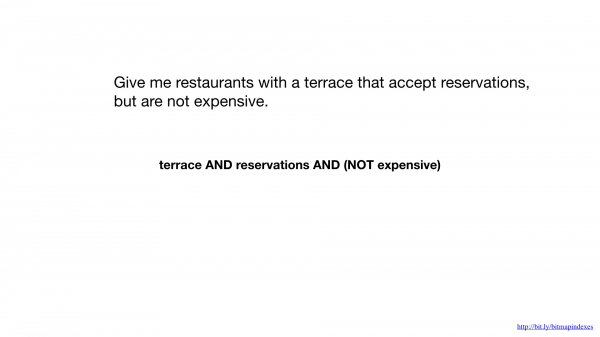
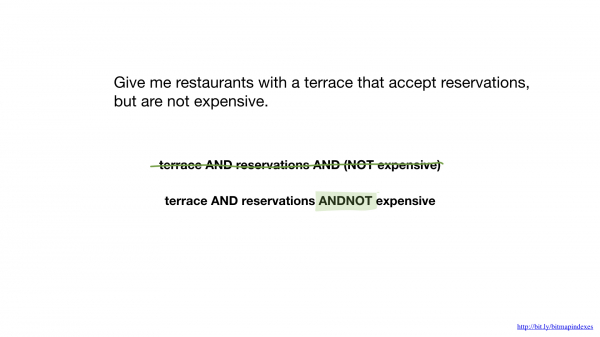
Aby sme mohli odpovedať na dopyt „Zobraz mi lacné reštaurácie, ktoré majú terasu a kde si môžem rezervovať stôl“, budeme potrebovať dve bitové operácie: NOT a AND.
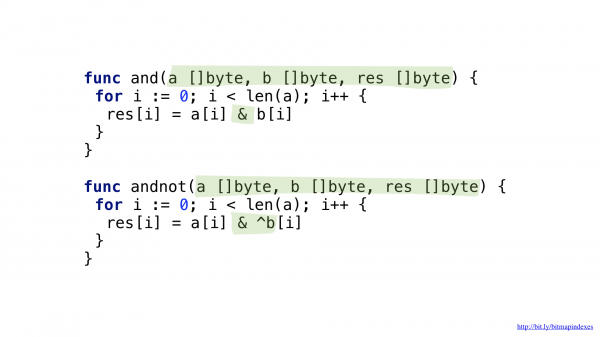
Môžeme trochu zjednodušiť náš kód použitím zložitejšej operácie AND NOT.
Máme funkcie pre každú z týchto operácií. Obidve prechádzajú rezmi, berú zodpovedajúce prvky z každého a kombinujú ich bitovou operáciou a ukladajú výsledok do výsledného rezu.
A teraz môžeme využiť naše bitmapy a funkcie na odpovedanie na vyhľadávací dopyt.
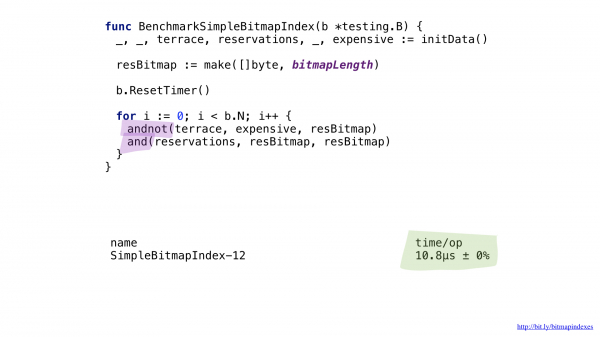
Výkon nie je až taký vysoký, aj keď funkcie sú veľmi jednoduché a dosť sme ušetrili na tom, že sme nevracali nový výsledný rez pri každom volaní funkcie.
Po profilovaní s pprof som si všimol, že kompilátor Go prehliadol jednu veľmi jednoduchú, ale veľmi dôležitú optimalizáciu: inlinovanie funkcií.
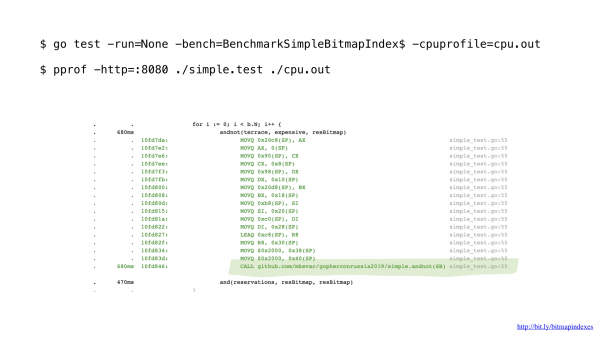
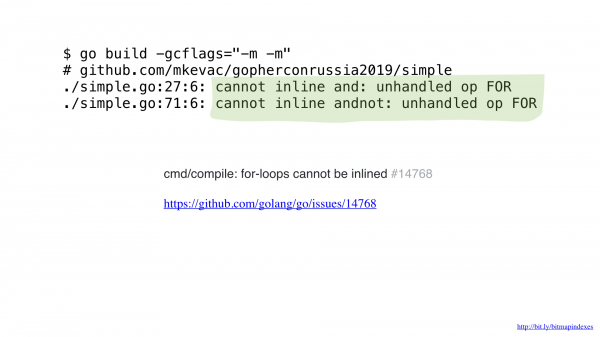
Ide o to, že kompilátor Go sa hrozne bojí cyklov, ktoré prechádzajú rezmi, a kategoricky odmieta inlinovať funkcie, ktoré obsahujú také cykly.
Ale ja sa nebojím a môžem oklamať kompilátor, pričom použijem goto namiesto cyklu, ako v starých dobrých časoch.
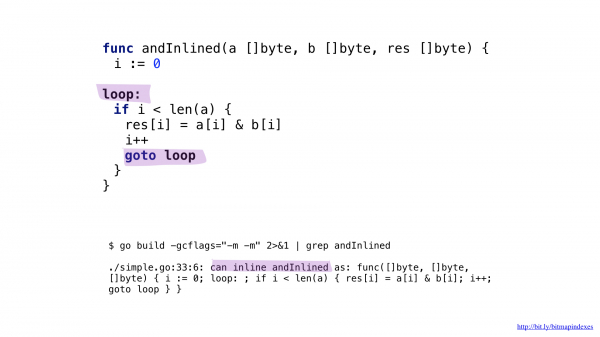
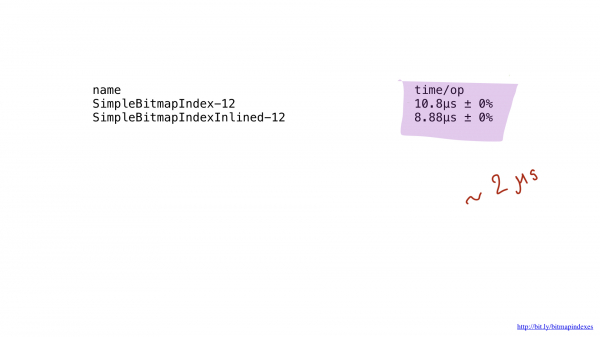
A, ako vidíte, teraz kompilátor s radosťou inlinuje našu funkciu! Nakoniec sa nám podarí ušetriť približne 2 mikrosekundy. Nie je to zlé!
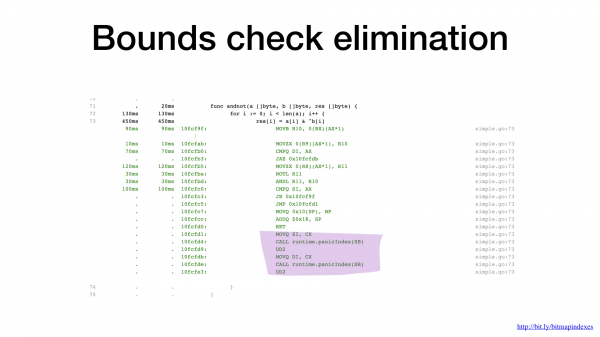
Druhé úzke miesto nie je ťažké vidieť, ak sa pozriete na výstup assemblera. Kompilátor pridal kontrolu na hranice rezu priamo do nášho najrušnejšieho cyklu. Faktom je, že Go je bezpečný jazyk, kompilátor sa obáva, že moje tri argumenty (trí rez) majú rôznu veľkosť. Veď by mohla teoreticky vzniknúť takzvaná chyba pretečenia vyrovnávacej pamäte (buffer overflow).
Upokojme kompilátor ukázaním, že všetky slice majú rovnakú veľkosť. Môžeme to urobiť pridaním jednoduchého overenia na začiatok našej funkcie.
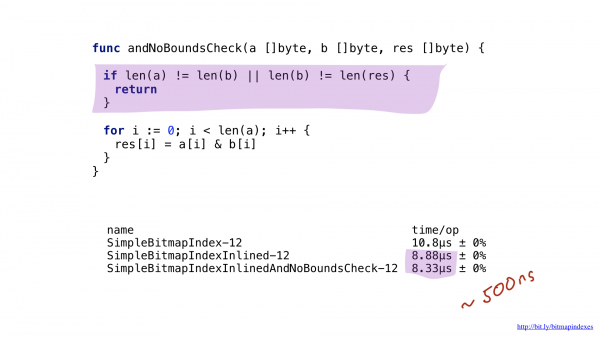
Vedúci to, kompilátor s radosťou prejde overením, a my nakoniec ušetríme ďalších 500 nanosekúnd.
Veľké batch-y
Dobre, podarilo sa nám vytlačiť nejaký výkon z našej jednoduchej implementácie, ale tento výsledok je v skutočnosti oveľa horší, než je možné s aktuálnym hardvérom.
Všetko, čo robíme, sú základné bitové operácie, a naše procesory ich vykonávajú veľmi efektívne. Ale, bohužiaľ, "krmíme" náš procesor veľmi malými kôpkami práce. Naše funkcie vykonávajú operácie po bajtoch. Môžeme veľmi jednoducho upraviť náš kód tak, aby pracoval s 8-bajtovými kôpkami, pomocou slice UInt64.
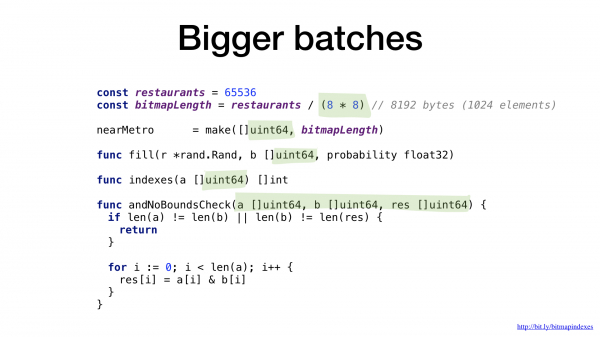
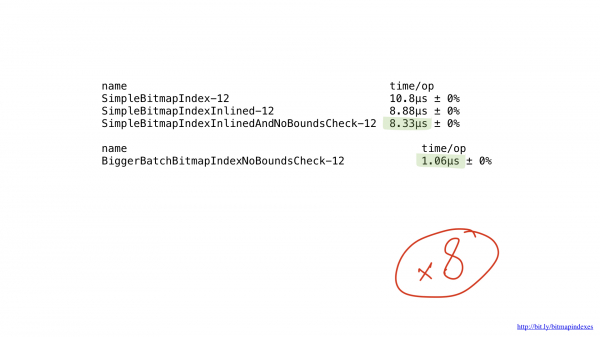
Ako vidíte, táto malá zmena zrýchlila našu aplikáciu osemkrát zvýšením batch-u osemkrát. Zisk je, dá sa povedať, lineárny.
Implementácia v assembleri
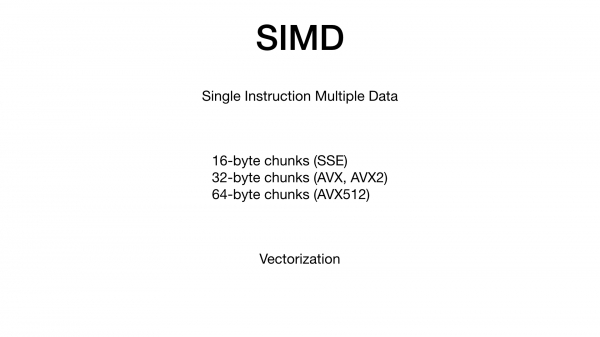
Ale to ešte nie je koniec. Naše procesory môžu pracovať s kúskami po 16, 32 a dokonca 64 bajtoch. Takéto "široké" operácie sa nazývajú single instruction multiple data (SIMD; jedna inštrukcia, veľa údajov), a proces transformácie kódu tak, aby používal takéto operácie, sa nazýva vektorizácia.
Bohužiaľ, Go kompilátor nie je v vektorizácii veľmi dobrý. V súčasnosti je jediný spôsob vektorizácie kódu v Go vziať a vložiť údaje operácie ručne pomocou assemblera Go.
Assembler Go je zvláštny živočích. Určite viete, že assembler je niečo, čo je veľmi viazané na architektúru počítača, pre ktorý píšete, ale v Go to nie je tak. Assembler Go je viac podobný IRL (intermediate representation language) alebo medzičinnému jazyku: je takmer platformovo nezávislý. Rob Pike mal skvelú prednášku na túto tému pred niekoľkými rokmi na GopherCon v Denveri.
Okrem toho Go používa neobvyklý formát Plan 9, ktorý sa líši od uznávaných formátov AT&T a Intel.
Môžeme s istotou povedať, že písanie assemblera Go ručne nie je práve najzábavnejšia činnosť.
Ale našťastie už existujú dve vysokúrovňové nástroje, ktoré nám pomáhajú pri písaní assemblera Go: PeachPy a avo. Obe nástroje generujú Go-assembler z vysokoúrovňového kódu napísaného v Pythone a Go.
Tieto utilitky zjednodušujú také veci, ako je alokácia registrov (výber procesorového registra), písanie cyklov a vo všeobecnosti zjednodušujú proces vstupu do sveta assemblerového programovania v Go.
Budeme používať avo, takže naše programy budú takmer bežnými programami v Go.
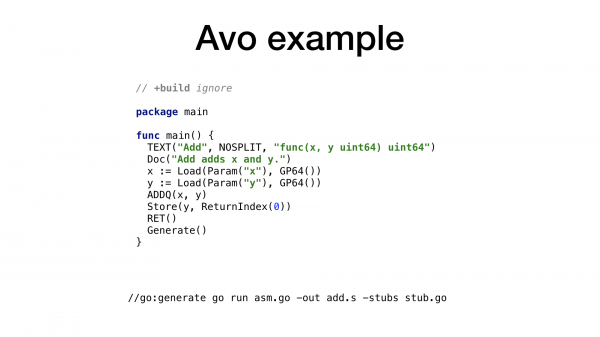
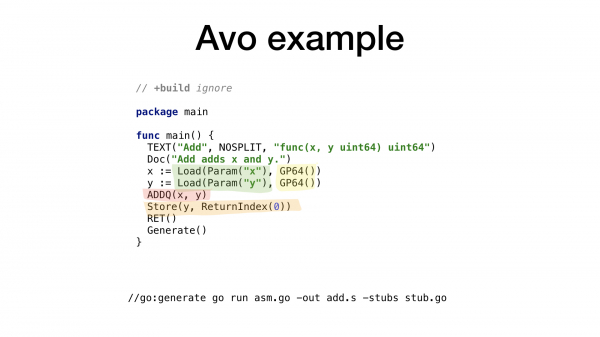
Takto vyzerá najjednoduchší príklad avo-programu. Máme funkciu main(), ktorá v sebe definuje funkciu Add(), ktorej zmyslom je sčítať dve čísla. Nachádzajú sa tu pomocné funkcie na získanie parametrov podľa názvu a na získanie jedného z dostupných a vhodných procesorových registrov. Každej procesorovej operácii zodpovedá príslušná funkcia v avo, ako je vidieť na ADDQ. A nakoniec, vidíme pomocnú funkciu na uloženie výslednej hodnoty.
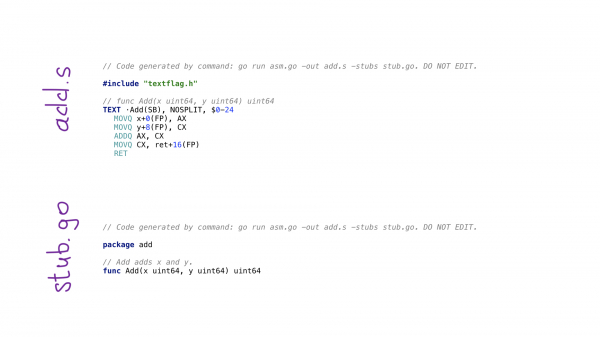
Zavolaním go generate vykonáme program v avo a výsledkom bude generovanie dvoch súborov:
- add.s s výsledným kódom v Go-assembleri;
- stub.go s hlavičkami funkcií na prepojenie dvoch svetov: Go a assemblera.
Teraz, keď sme videli, čo a ako robí avo, pozrime sa na naše funkcie. Implementoval som ako skalárne, tak aj vektorové (SIMD) verzie funkcií.
Najprv sa pozrime na skalárne verzie.
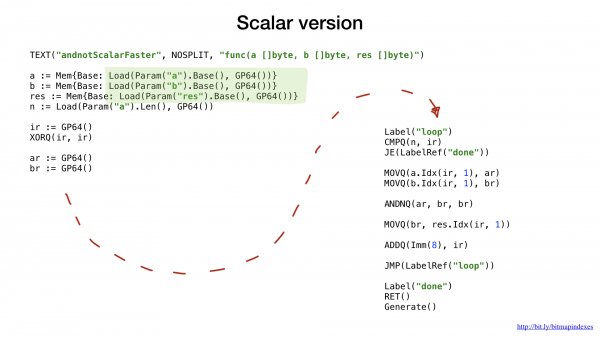
Rovnako ako v predchádzajúcom príklade, požiadame o voľný a správny register všeobecného použitia, nemusíme počítať posuny a veľkosti pre argumenty. Toto všetko avo robí za nás.
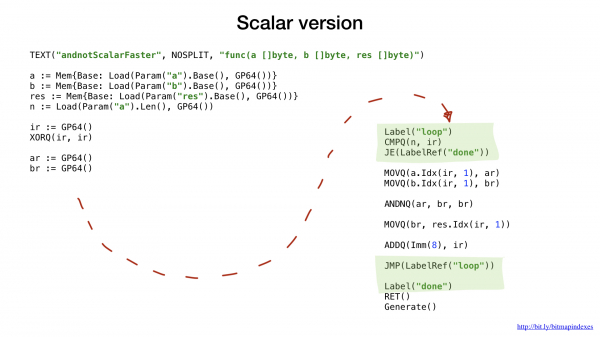
Predtým sme používali značky a goto (alebo skoky) na zrýchlenie a oklamanie kompilátora Go, ale teraz to robíme od začiatku. Problém je v tom, že cykly sú vysokoúrovňový koncept. V assembleri máme len značky a skoky.
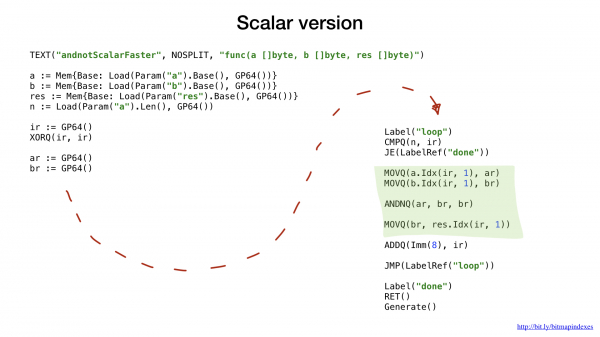
Zostávajúci kód by mal byť už známy a zrozumiteľný. Emulujeme cyklus značkami a skokmi, berieme malú časť údajov z našich dvoch zoznamov, kombinujeme ich bitovou operáciou (AND NOT v tomto prípade) a potom ukladáme výsledok do výsledného zoznamu. Hotovo.
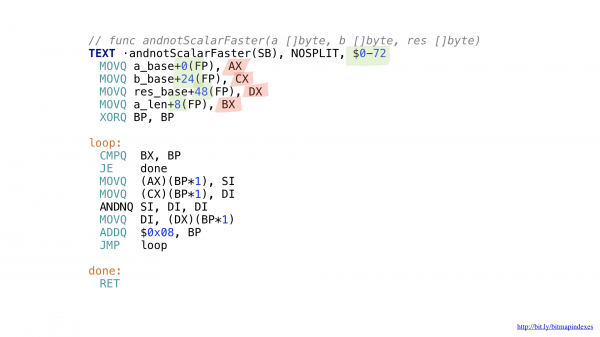
Takto vyzerá konečný kód v assembleri. Nebolo potrebné počítať posuny a veľkosti (vyznačené zelenou), ani sledovať používané registre (vyznačené červenou).
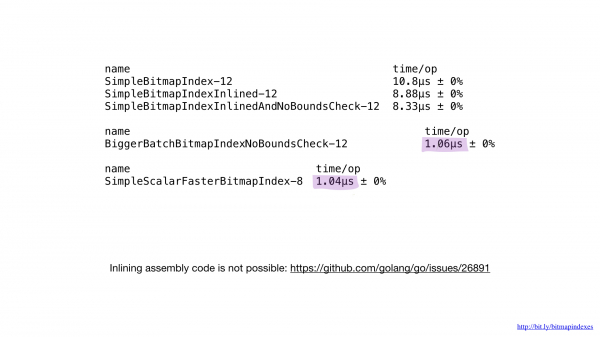
Ak porovnáme výkon implementácie v assembleri s výkonom najlepšej implementácie v Go, zistíme, že sú rovnaké. A to je očakávané. Predsa sme neurobili nič zvláštne — len sme reprodukovali to, čo by robil Go kompilátor.
Bohužiaľ, nemôžeme donútiť kompilátor, aby inlinoval naše funkcie napísané v assembleri. Go kompilátor v súčasnosti túto funkciu nemá, aj keď žiadosť o jej pridanie existuje už dosť dlho.
Presne preto nie je možné získať žiadne výhody z malých funkcií v assembleri. Musíme buď písať veľké funkcie, alebo použiť nový balík math/bits, alebo sa vyhnúť assembleri.
Poďme sa teraz pozrieť na vektorové verzie našich funkcií.
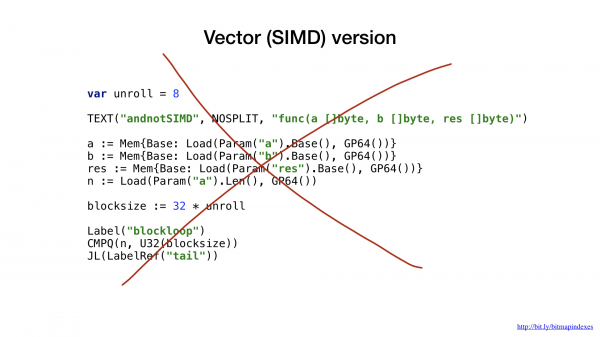
Pre tento príklad som sa rozhodol použiť AVX2, takže budeme využívať operácie pracujúce s 32-bajtovými kusmi. Štruktúra kódu je veľmi podobná skalarnej variante: načítanie parametrov, žiadosť o poskytnutie voľného spoločného registra a pod.
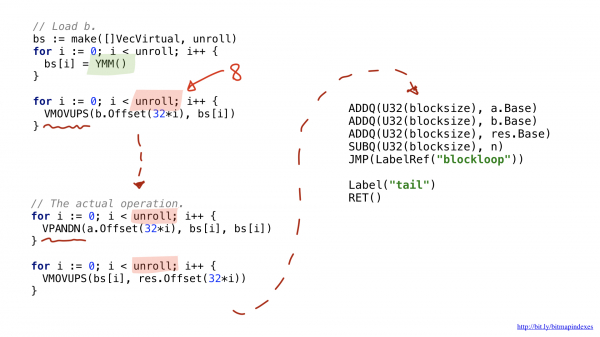
Jednou z noviniek je, že širšie vektorové operácie používajú špeciálne široké registre. V prípade 32-bajtových kusov ide o registre s prefixom Y. Práve preto vidíte funkciu YMM() v kóde. Keby som použil AVX-512 s 64-bitovými kusmi, prefix by bol Z.
Druhá novinka sa týka toho, že som sa rozhodol použiť optimalizáciu zvanú rozvinutie cyklu (loop unrolling), teda urobiť osem operácií cyklu ručne, skôr než sa vrátiť na začiatok cyklu. Táto optimalizácia znižuje počet branchingov (vetvení) v kóde a je obmedzená počtom voľných registrov, ktoré sú k dispozícii.
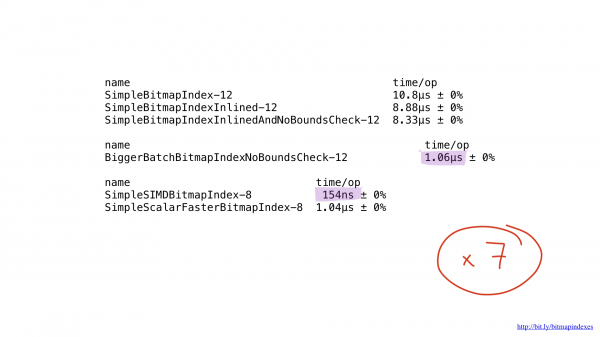
A čo výkon? Je skvelý! Dosiahli sme zrýchlenie približne sedemkrát v porovnaní s najlepším riešením v Go. Impresívne, že?
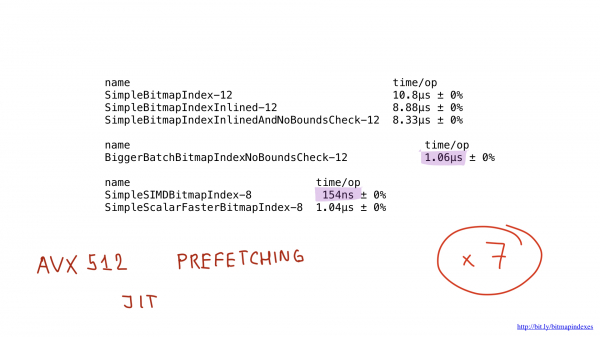
Ale aj túto implementáciu by bolo potenciálne možné urýchliť použitím AVX-512, prefetchingom alebo JIT (just-in-time compiler) pre plánovač požiadaviek. Ale to je už určite téma na samostatnú prezentáciu.
Problémy bitmapových indexov
Teraz, keď sme už preskúmali jednoduchú implementáciu bitmapového indexu v Go a oveľa výkonejšiu v assembleri, poďme konečne hovoriť o tom, prečo sa bitmapové indexy tak zriedka používajú.
Vo starších vedeckých prácach sa spomínajú tri problémy bitmapových indexov, no novšie štúdie a aj ja tvrdíme, že už nie sú aktuálne. Nezaoberať sa každým z týchto problémov do hĺbky, ale povrchne ich preskúmame.
Problém vysokej kardy
Hovorí sa nám, že bitmapové indexy sú vhodné iba pre polia s nízkou kardiálnosťou, teda pre také, ktorých hodnôt je málo (napríklad pohlavie alebo farba očí). Dôvodom je to, že bežné zobrazenie takýchto polí (jeden bit na hodnotu) v prípade vysokej kardiálnosti by zaberalo príliš veľa miesta a navyše by tieto bitmapové indexy boli slaboodenšené (zriedkavé).
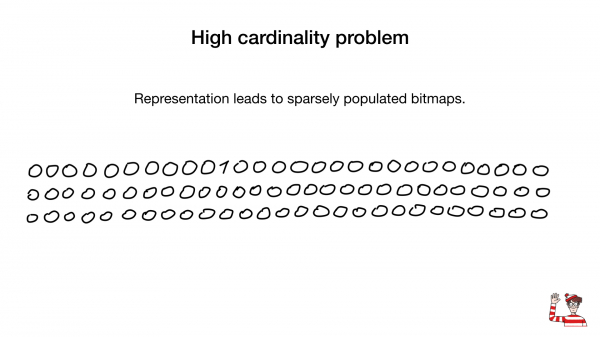
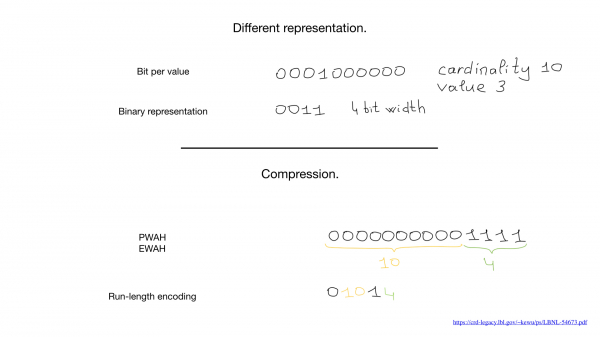
Niekedy môžeme použiť iné zobrazenie, napríklad štandardné, ktoré používame na zobrazenie čísel. Ale práve príchod kompresných algoritmov všetko zmenil. V posledných desaťročiach vedci a výskumníci vymysleli množstvo kompresných algoritmov pre bitmapy. Ich hlavnou výhodou je, že nie je potrebné dekompresovať bitmapy na vykonávanie bitových operácií — môžeme vykonávať bitové operácie priamo na komprimovaných bitmapách.
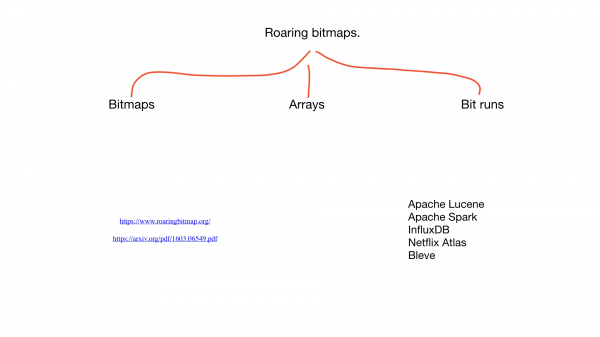
V poslednej dobe sa objavili aj hybridné prístupy, ako napríklad roaring bitmapy. Tieto používajú súčasne tri rôzne zobrazenia bitmapov — samotné bitmapy, polia a takzvané bit runs — a vyvažujú ich, aby maximalizovali výkon a minimalizovali výkon pamäte.
Roaring bitmapy môžete nájsť v najpopulárnejších aplikáciách. Už existuje obrovské množstvo implementácií pre rôzne programovacie jazyky, vrátane viac ako troch implementácií pre Go.
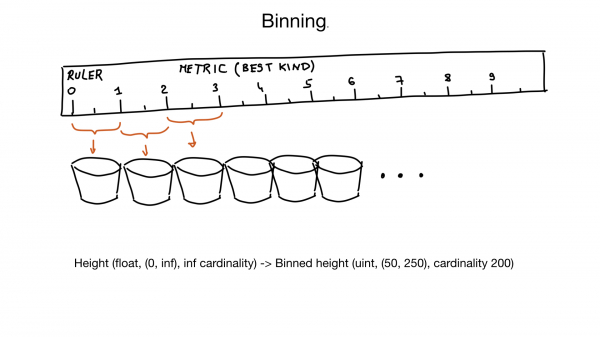
Ďalší prístup, ktorý nám môže pomôcť vysporiadať sa s vysokou kardiálnosťou, sa nazýva skupinovanie (binning). Predstavte si, že máte pole, ktoré reprezentuje výšku človeka. Výška je číslo s plávajúcou desatinnou čiarkou, ale my, ľudia, o nej neuvažujeme týmto spôsobom. Pre nás nie je rozdiel medzi výškou 185,2 cm a 185,3 cm.
Takže môžeme zhromaždiť podobné hodnoty do skupín v rámci 1 cm.
A ak navyše vieme, že veľmi málo ľudí má výšku menej ako 50 cm a viac ako 250 cm, potom môžeme v podstate premeniť pole s nekonečnou kardiálnosťou na pole s kardiálnosťou približne 200 hodnôt.
Samozrejme, ak bude potrebné, môžeme vykonať dodatočnú filtráciu aj po.
Problém s veľkou priepustnosťou
Ďalší problém bitmapových indexov spočíva v tom, že ich aktualizácia môže byť veľmi nákladná.
Databázy musia umožniť aktualizáciu údajov v momente, keď potenciálne stovky ďalších požiadaviek vyhľadávajú tieto údaje. Potrebujeme zámky, aby sme sa vyhli problémom s paralelným prístupom k údajom alebo iným problémom zdieľaného prístupu. A tam, kde je jeden veľký zámok, tam je problém — lock contention, keď sa tento zámok stáva úzkym hrdlom.
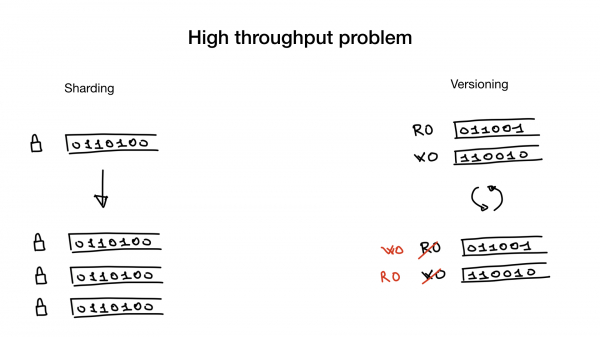
Tento problém sa dá vyriešiť alebo obísť pomocou shardovania alebo využitia verzionovaných indexov.
Shardovanie je jednoduchá a známa vec. Môžete shardovať bitmapový index tak, ako by ste shardovali akékoľvek iné dáta. Namiesto jedného veľkého zámku získate množstvo malých zámkov a tak sa zbavíte lock contention.
Druhým spôsobom, ako tento problém vyriešiť, je použitie verzionovaných indexov. Môžete mať jednu kópiu indexu, ktorú používate na vyhľadávanie alebo čítanie, a jednu – na zápis alebo aktualizáciu. A raz za určitý interval (napríklad každých 100 ms alebo 500 ms) ich duplikujete a meníte miesta. Samozrejme, tento prístup je aplikovateľný len v tých prípadoch, keď vaša aplikácia môže pracovať s trochu zaostávajúcim vyhľadávacím indexom.
Tieto dva prístupy je možné použiť súčasne: môžete mať shardovaný verzionovaný index.
Zložitejšie dotazy
Posledný problém bitmapových indexov spočíva v tom, že, ako nám hovoria, sú nevhodné pre zložitejšie typy dotazov, napríklad pre dotazy „v intervale“.
A skutočne, ak nad tým premýšľate, bitové operácie typu AND, OR a pod. nie sú veľmi vhodné pre dotazy typu „Ukážte mi hotely s cenou izby od 200 do 300 dolárov za noc“.
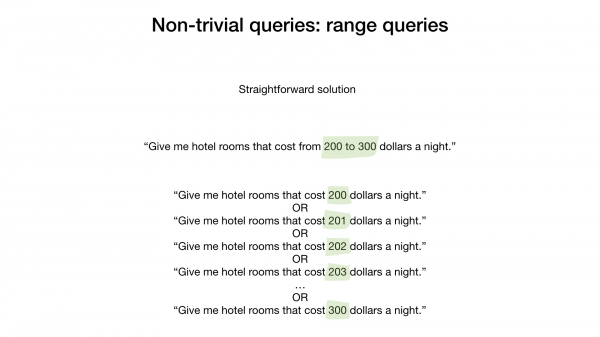
Naivným a veľmi nerozumným riešením by bolo získať výsledky pre každú dolárovú hodnotu a zlúčiť ich pomocou bitovej operácie OR.
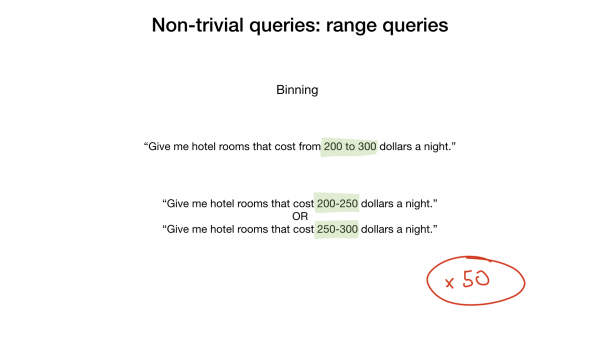
Trochu správnejším riešením by bolo použiť grupovanie. Napríklad do skupín po 50 dolárov. To by urýchlilo náš proces 50-krát.
Problém sa však ľahko rieši použitím prehľadu navrhnutého špeciálne pre tento typ dopytov. V akademických prácach sa nazýva range-encoded bitmaps.
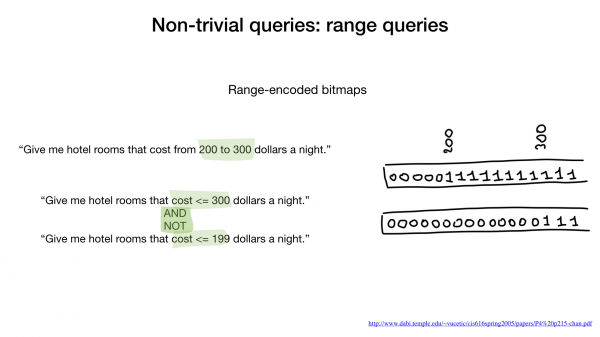
V tomto prehľade neoznačujeme len jeden bit pre určitú hodnotu (napríklad 200), ale označíme túto hodnotu a všetko, čo je nad ňou. 200 a vyššie. To isté platí pre 300: 300 a vyššie. A tak ďalej.
Použitím tohto prehľadu môžeme odpovedať na takýto typ vyhľadávacieho dopytu prechádzajúc indexom len dvakrát. Najprv získame zoznam hotelov, kde cena za noc je menej ako 300 dolárov, a potom ho zbavíme tých, kde cena za noc je nižšia ako 199 dolárov. Hotovo.
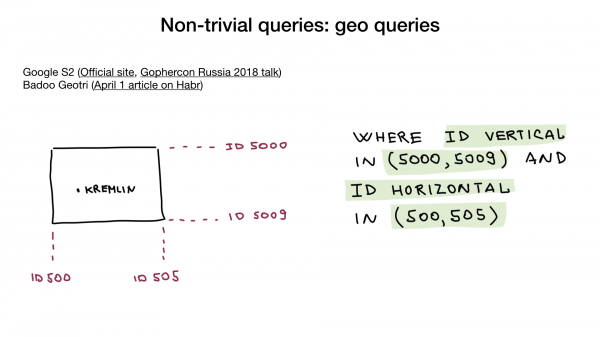
Prekvapí vás, ale aj geografické dopyty sú možné pomocou bitmapových indexov. V trik spočíva v použití geografického prehľadu, ktorý obklopuje vašu koordinátu geometrickou figurou. Napríklad S2 od Google. Figúra musí byť vyjadrená ako tri alebo viac prekrývajúcich sa priamok, ktoré môžeme očíslovať. Takto môžeme premeniť náš geografický dopyt na niekoľko dopytov "podľa intervalov" (podľa týchto očíslovaných čiar).
Hotové riešenia
Dúfam, že som vás aspoň trocha zaujal a máte vo svojom arsenáli ďalší užitočný nástroj. Ak by ste niekedy potrebovali urobiť niečo podobné, budete vedieť, na ktorú stranu sa pozrieť.
Nie všetci však majú čas, trpezlivosť a prostriedky, aby vytvorili bitmapové indexy od základov. Obzvlášť pokročilejšie, s použitím SIMD, napríklad.
Našťastie existuje niekoľko hotových riešení, ktoré vám môžu pomôcť.
Roaring bitmaps
Po prvé, existuje tá známa knižnica roaring bitmaps, o ktorej som už hovoril. Obsahuje všetky potrebné kontajnery a bitové operácie, ktoré potrebujete na vytvorenie plnohodnotného bitmapového indexu.
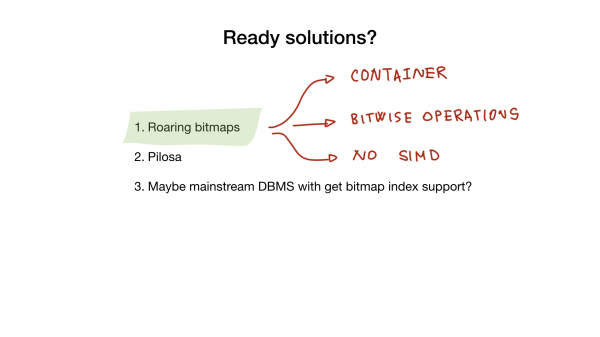
Žiaľ, v súčasnosti žiadna z Go implementácií nepoužíva SIMD, čo znamená, že Go implementácie sú menej výkonné ako implementácie v C, napríklad.
Pilosa
Ďalší produkt, ktorý vám môže pomôcť, je databáza Pilosa, ktorá v podstate obsahuje len bitmapové indexy. Je to relatívne nové riešenie, ale rýchlo si získava srdcia.
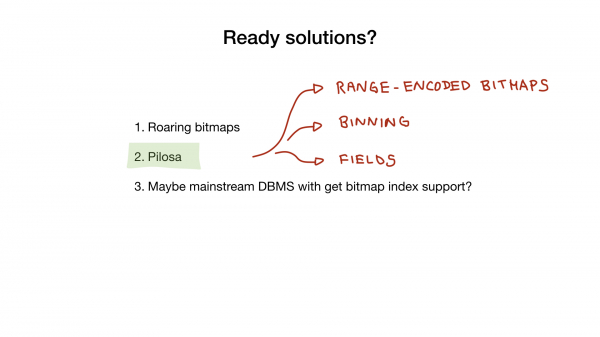
Pilosa používa roaring bitmaps vo svojom vnútri a poskytuje vám možnosť ich používať, zjednodušuje a vysvetľuje všetky veci, o ktorých som hovoril vyššie: skupinovanie, range-encoded bitmaps, pojem poľa atď.
Rýchlo sa pozrime na príklad použitia Pilosa na odpoveď na otázku, ktorú už poznáte.
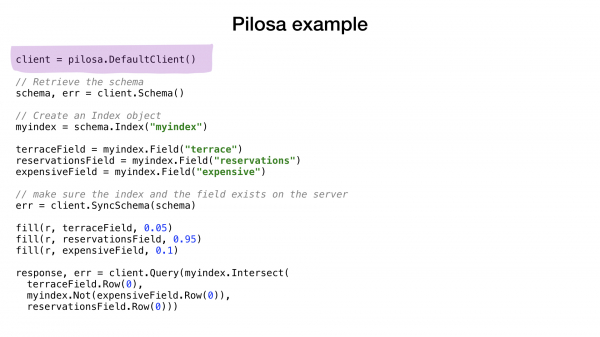
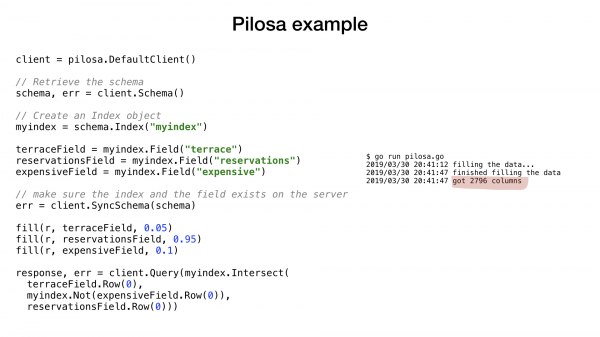
Príklad je veľmi podobný tomu, čo ste videli predtým. Vytvárame klienta k serveru Pilosa, vytvárame index a potrebné polia, následne naplníme naše polia náhodnými údajmi s pravdepodobnosťami a nakoniec vykonávame známu otázku.
Potom používame NOT na pole „expensive“, následne prekrývame výsledok (alebo AND-íme) s poľom „terrace“ a s poľom „reservations“. A nakoniec, dostávame finálny výsledok.
Dúfam, že v dohľadnej budúcnosti sa tento nový typ indexov - bitmapové indexy - objaví aj v databázach ako MySQL a PostgreSQL.
Záver
Ak ste ešte nezaspali, ďakujem. Musel som sa v rýchlosti dotknúť mnohých tém kvôli obmedzenému času, ale dúfam, že prednáška bola užitočná a možno aj motivujúca.
O bitmapových indexoch je dobré vedieť, aj keď ich momentálne nepotrebujete. Nech sú ďalším nástrojom vo vašej výbave.
Preskúmali sme rôzne triky na zvýšenie výkonu pre Go a veci, s ktorými si kompilátor Go zatiaľ nevie veľmi dobre poradiť. Toto je určite užitočné vedieť pre každého programátora v Go.
To je všetko, čo som chcel povedať. Ďakujem!
Zdroj: habr.com
