

Na jeseň 2019 sa v tíme iOS Cloud Mail.ru udialo dlho očakávané podujatie. Hlavnou databázou pre trvalé uchovanie stavu aplikácie sa stala pomerne exotická pre mobilný svet (LMDB). Pod týmto odkazom sa vám ponúka jej podrobný prehľad v štyroch častiach. Najprv sa porozprávame o dôvodoch tak netradičného a ťažkého výberu. Potom prejdeme k preskúmaniu troch pilierov architektúry LMDB: mapované v pamäti súbory, B+-strom, copy-on-write prístup pre realizáciu transakčnosti a multiversionality. Nakoniec, ako čerešnička na torte — praktická časť. V nej preskúmame, ako navrhnúť a realizovať schému databázy s viacerými tabuľkami nad nízkoúrovňovým key-value API vrátane indexovej.
Obsah
3.1.
3.2.
3.3.
4.1.
4.2.
4.3.
1. Motivácia na implementáciu
Niekedy okolo roku 2015 sme sa zaoberali meraním, ako často sa náš aplikácia zasekáva. Nevenovali sme sa tomu len tak. Zvýšili sa nám sťažnosti na to, že niekedy aplikácia prestane reagovať na akcie používateľa: tlačidlá sa nestláčajú, zoznamy sa nescrolujú atď. O mechanike meraní som na AvitoTech, preto tu uvádzam iba poradie čísel.
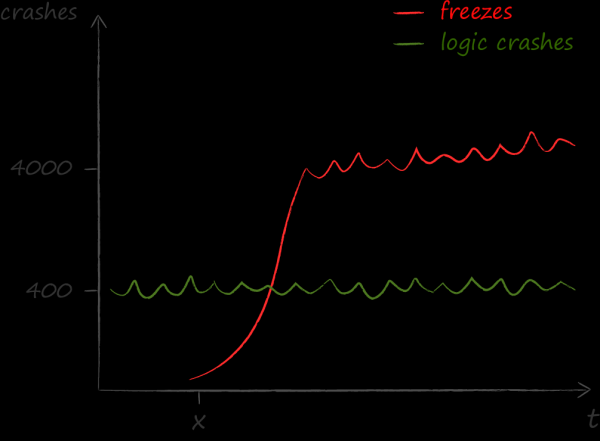
Výsledky meraní sa pre nás stali chladnou sprchou. Ukázalo sa, že problémov spôsobených zasekávaním je omnoho viac ako akýchkoľvek iných. Kým pred uvedomením si tohto faktu bol hlavným technickým ukazovateľom kvality crash free, po ňom sa zameranie na freeze free.
Postavili sme a uskutočnili a analýzu ich príčin, a stanovil sa hlavný nepriateľ — ťažká biznis logika vykonávaná v hlavnom vlákne aplikácie. Prírodzenou reakciou na tento chaos bola silná túžba rozprášiť ju po pracovných vláknach. Na systémové riešenie tejto úlohy sme sa uchýlili k mnohovláknovej architektúre založenej na ľahkých aktéroch. Jej prispôsobeniu pre svet iOS som venoval v kolektívnom Twitteri a . V rámci súčasného rozprávania chcem zdôrazniť tie aspekty riešenia, ktoré ovplyvnili výber databázy.
Aktorová modelová organizácia systému predpokladá, že multithreading sa stáva jej druhou podstatou. Objekty modelu v ňom radi prekračujú hranice vlákien. A robia to prakticky neustále a všade.
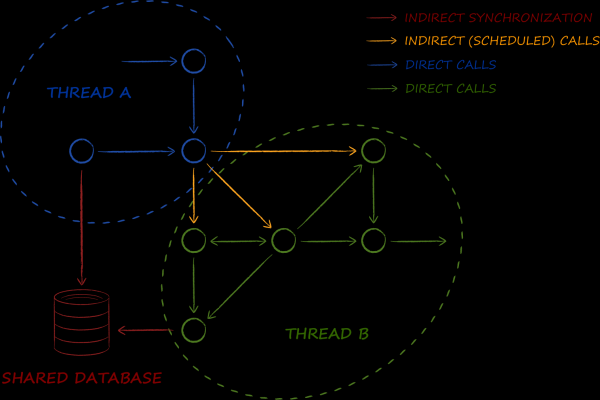
Databáza je jedným z kľúčových komponentov v predloženej schéme. Jej hlavnou úlohou je implementácia makropatternu . Ak sa v podnikateľskom svete s jej pomocou organizuje synchronizácia údajov medzi službami, v prípade aktorovej architektúry sú to údaje medzi vláknami. Takže sme potrebovali takú databázu, práca s ktorou v multithreadovom prostredí nevyvoláva ani minimálne ťažkosti. Konkrétne to znamená, že objekty získané z nej by mali byť aspoň thread-safe a ideálne vôbec nemenné. Ako je známe, posledné môžu byť používané súčasne z viacerých vlákien, a to bez akýchkoľvek zámkov, čo priaznivo ovplyvňuje výkon.
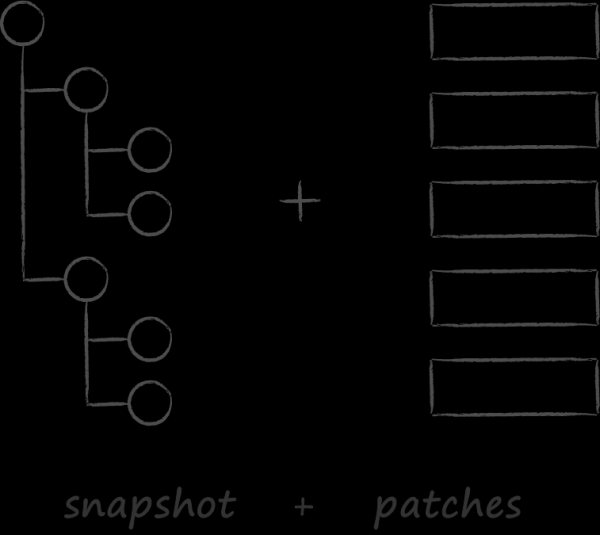 Druhým významným faktorom, ktorý ovplyvnil výber databázy, bolo naše cloudové API. Inšpirovalo sa prístupom k synchronizácii, ktorý prevzal git. Rovnako ako on, sme sa zameriavali na , ktoré pre cloudových klientov vyzerá viac než vhodne. Predpokladalo sa, že budú iba raz sťahovať kompletný stav cloudu a potom synchronizácia v prevažnej väčšine prípadov prebehne prostredníctvom aplikovania zmien. Bohužiaľ, táto možnosť je zatiaľ len v teoretickej rovine, a v praxi sa klienti ešte nenaučili pracovať s patchmi. Na to sú mnohé objektívne dôvody, ktoré, aby sme nezdržovali úvod, ponecháme bokom. V súčasnosti však oveľa väčší záujem predstavujú poučné výsledky lekcie o tom, čo sa deje, keď API povedalo "A", a jeho užívateľ nepovedal "B".
Ak teda predstavíte git, ktorý pri vykonaní príkazu pull namiesto uplatnenia patchov na lokálny snapshot porovnáva jeho úplný stav s úplným serverovým, získate dosť presný pohľad na to, ako prebieha synchronizácia v cloudových klientoch. Nie je ťažké uhádnuť, že na jej realizáciu je potrebné alokovať v pamäti dva DOM-stromy s meta-informáciami o všetkých serverových a lokálnych súboroch. To znamená, že ak používateľ uchováva v cloude 500 tisíc súborov, je potrebné na jeho synchronizáciu recreate a zničiť dva stromy s 1 miliónom uzlov. A každé uzol je agregát, ktorý obsahuje graf podobjektov. V tomto kontexte sa výsledky profilovania ukázali byť očakávané. Zistilo sa, že aj bez zohľadnenia algoritmiky zlúčenia stojí samotný postup vytvárania a následného ničenia obrovského množstva drobných objektov nemalé peniaze. Situáciu komplikuje skutočnosť, že základná operácia synchronizácie je súčasťou mnohých používateľských scenárov. Výsledkom je, že zaznamenávame druhý dôležitý kritérium pri výbere databázy — možnosť realizácie operácií CRUD bez dynamickej alokácie objektov.
Ostatné požiadavky sú viac tradičné a ich zoznam vyzerá nasledovne.
- Prúdová bezpečnosť.
- Multiprocesnosť. Vyplýva z túžby používať rovnaký inštanciu databázy na synchronizáciu stavu nielen medzi vláknami, ale aj medzi hlavným aplikáciou a rozšíreniami iOS.
- Možnosť predstavovať uložené entity vo forme nemenných objektov.
- Absencia dynamických alokácií v rámci operácií CRUD.
- Podpora transakčných základných vlastností : atomickosť, konzistentnosť, izolovanosť a spoľahlivosť.
- Rýchlosť pri najpopulárnejších prípadoch.
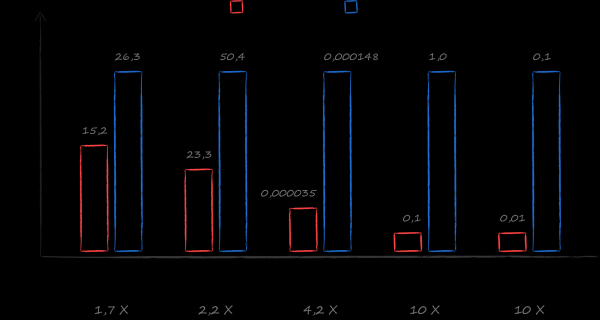
Dobrou voľbou s takýmto súborom požiadaviek bol a ostáva SQLite. Pri skúmaní alternatív sa mi dostala do rúk kniha . Pod jeho vedením bol napísaný benchmark porovnávajúci rýchlosť práce s rôznymi databázami v rámci reálnych cloudových scenárov. Výsledok prekonal najodvážnejšie očakávania. Pri najpopulárnejších prípadoch — zisk kurzora na triedený zoznam všetkých súborov a triedený zoznam všetkých súborov pre zadaný adresár — sa LMDB ukázal byť rýchlejší ako SQLite 10-krát. Výber sa stal jasným.
2. Pozicionovanie LMDB
LMDB je malá knižnica (len 10K riadkov), ktorá implementuje najnižšiu základnú vrstvu databáz — úložisko.
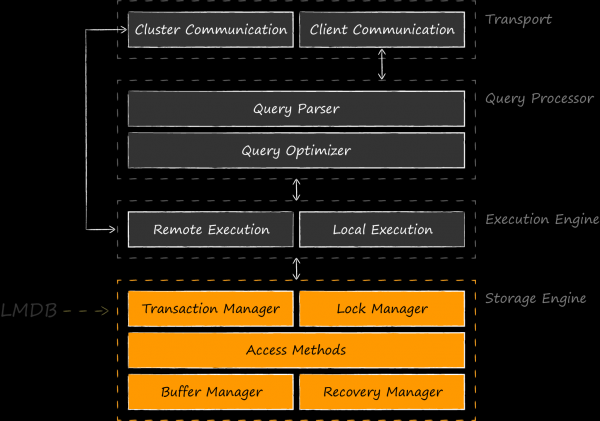
Uvedená schéma ukazuje, že porovnávať LMDB so SQLite, ktoré implementuje aj vyššie úrovne, v podstate nie je korektné, tak ako porovnávať SQLite s Core Data. Spravodlivejšie by bolo uviesť rovnaké úložiskové motory — BerkeleyDB, LevelDB, Sophia, RocksDB a ďalšie. Existujú aj projekty, kde LMDB vystupuje ako komponent storage engine pre SQLite. Prvým takýmto experimentom bol v roku 2012. autor LMDB . sa ukázali byť tak fascinujúce, že jeho iniciatívu prevzali nadšenci OSS a našli svoje pokračovanie v podobe . V januári 2020 autor tohto projektu Den Shearer o ňom na LinuxConfAu.
Hlavné uplatnenie LMDB nachádza ako motor pre aplikačné databázy. Svoj vznik knižnica vďačí vývojárom , ktorí boli veľmi nespokojní s BerkeleyDB ako základom ich projektu. Odrazom od skromnej knižnice , Howard Chu dokázal vytvoriť jednu z najpopulárnejších alternatív súčasnosti. Tomu príbehu a aj vnútornej štruktúre LMDB sa venoval vo svojom veľmi zaujímavom prednáške . Dobrým príkladom dobytia úložiska sa podelil Leonid Jurjev (aka ) z Positive Technologies vo svojej prezentácii na Highload 2015 . V ňom hovorí o LMDB v kontexte podobnej úlohy implementácie ReOpenLDAP, zatiaľ čo porovnávacej kritike sa vystavila už LevelDB. Výsledkom implementácie sa v Positive Technologies dokonca objavil aktívne sa rozvíjajúci fork s veľmi lákavými funkciami, optimalizáciami a .
LMDB sa často používa aj ako úložisko presne tak, ako je. Napríklad prehliadač Mozilla Firefox ho pre rad potrieb, a s verziou 9 sa Xcode pre jeho SQLite na ukladanie indexov.
Motor sa objavil aj vo svete mobilného vývoja. Stopy jeho použitia je možné v iOS kliente pre Telegram. LinkedIn šiel ešte ďalej a vybral si LMDB ako predvolené úložisko pre vlastný rámec cacheovania dát Rocket Data, o čom vo svojom článku v roku 2016.
LMDB úspešne bojuje o miesto na slnku v niku, ktorú zanechal BerkeleyDB po prechode pod kontrolu Oracle. Knižnicu milujú za rýchlosť a spoľahlivosť, aj v porovnaní s podobnými. Ako je známe, zadarmo obed v podstate neexistuje, a je potrebné zdôrazniť trade-off, s ktorým sa budete musieť vysporiadať pri voľbe medzi LMDB a SQLite. Schéma vyššie jasne demonštruje, ako sa dosahuje zvýšená rýchlosť. Po prvé, neplatíme za ďalšie vrstvy abstrakcie nad diskovým úložiskom. Samozrejme, v dobrej architektúre sa bez nich nedá obísť, a nevyhnutne sa objavia v kóde aplikácie, avšak budú oveľa tenšie. Neobsahujú funkcie, ktoré nie sú potrebné konkrétnou aplikáciou, ako napríklad podpora požiadaviek v jazyku SQL. Po druhé, sa otvára možnosť optimálne implementovať mapovanie aplikačných operácií na požiadavky na diskové úložisko. Ak SQLite vychádza z priemerných potrieb priemernej aplikácie, vy ako aplikačný vývojár ste perfektne oboznámení s hlavnými scenármi zaťaženia. Za výkonnejšie riešenie sa bude musieť zaplatiť vyššou cenou ako za vyvinutie pôvodného riešenia, tak aj za jeho následnú podporu.
3. Tri piliere LMDB
Pohľad na LMDB z výšky vtáčieho letun, prišla doba spustiť sa hlbšie. Nasledujúce tri sekcie budú venované skúmaniu hlavných pilierov, na ktorých spočíva architektúra úložiska:
- Zobrazované v pamäti súbory ako mechanizmus práce s diskom a synchronizácie vnútorných štruktúr dát.
- B+-strom ako organizácia štruktúry uložených dát.
- Copy-on-write ako prístup na zabezpečenie ACID vlastností transakcií a multipružnosti.
3.1. Pilier č. 1. Súbory mapované do pamäte
Zobrazované v pamäti súbory sú natoľko dôležitým architektonickým prvkom, že dokonca figuruje v názve úložiska. Otázky cache a synchronizácie prístupu k uloženým informáciám sú úplne a úplne ponechané na ramenách operačného systému. LMDB neobsahuje vnútri seba žiadne cache. Je to vedomé rozhodnutie autora, pretože čítanie údajov priamo z zobrazených súborov umožňuje obísť množstvo obmedzení v implementácii enginu. Nižšie uvádzam rozhodne nie úplný zoznam niektorých z nich.
- Udržiavanie konzistencie údajov v úložisku pri práci s ním z viacerých procesov sa stáva povinnosťou operačného systému. V nasledujúcej sekcii bude táto mechanika podrobne prebraná aj s obrázkami.
- Absencia cache úplne zbavuje LMDB režijných nákladov spojených s dynamickými alokáciami. Čítanie údajov v praxi predstavuje nastavenie ukazovateľa na správnu adresu vo virtuálnej pamäti a nič viac. Znie to ako fantázia, ale v zdrojových kódoch úložiska sú všetky výzvy salloc sústredené v funkcii konfigurácie úložiska.
- Absencia cache znamená aj absenciu zámkov spojených so synchronizáciou k ich prístupu. Čitatelia, ktorých môže súčasne existovať libovolný počet, sa nestretajú na svojej ceste k údajom s ani jedným mutexom. Vďaka tomu má rýchlosť čítania ideálnu lineárnu škálovateľnosť podľa počtu CPU. V LMDB sú synchronizované len modifikujúce operácie. Písač môže byť v každom okamihu iba jeden.
- Minimálne logiky cache a synchronizácie zbavuje kód extrémne zložitých typov chýb spojených s prácou v multithreadovom prostredí. Na konferencii Usenix OSDI 2014 boli dva zaujímavé výskumy databáz: a . Z nich si možno odnášať informácie ako o bezprecedentnej spoľahlivosti LMDB, tak aj o prakticky bezchybnej implementácii ACID vlastností transakcií, ktorá prevyšuje v tej istej SQLite.
- Minimalizmus LMDB umožňuje strojovému zobrazeniu jej kódu úplne sa umiestniť do L1 cache procesora s vyplývajúcimi z toho rýchlostnými charakteristikami.
Žiaľ, v iOS to s pamäťou mapovanými súbormi nie je tak bezproblémové, ako by sme si priali. Aby sme sa mohli uvedenej nedostatky diskutovať vedomejšie, treba si pripomenúť základné princípy implementácie tohto mechanizmu v operačných systémoch.
Základné informácie o pamäťou mapovaných súboroch
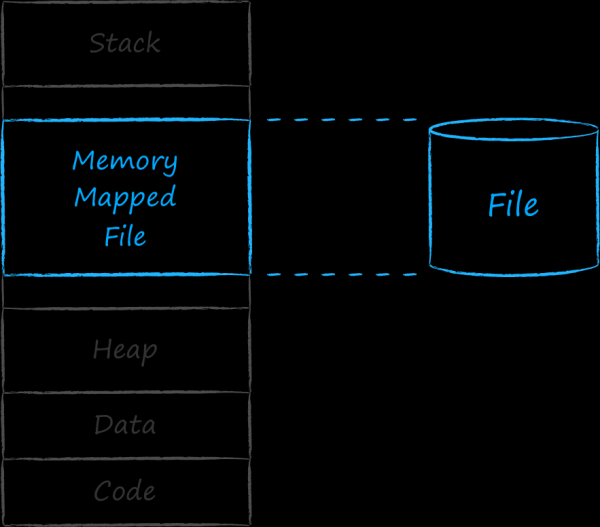 S každou spustiteľnou aplikáciou operačný systém asociuje entitu nazývanú proces. Každému procesu je pridelený neprerušovaný interval adries, v ktorom umiestňuje všetko potrebné na svoju prácu. V najnižších adresách sú umiestnené sekcie s kódom a harcodovanými dátami a prostriedkami. Potom sa nachádza narastajúci blok dynamického adresného priestoru, známy pod názvom heap. Ten obsahuje adresy entít, ktoré sa objavujú počas chodu programu. Na vrchu sa nachádza oblasť pamäte používaná zásobníkom aplikácie. Ten sa rozrastá, potom zmršťuje, inými slovami, jeho veľkosť má tiež dynamickú povahu. Aby sa zásobník a heap navzájom neprekážali, sú rozdelené na rôzne konce adresného priestoru. Medzi dvoma dynamickými sekciami hore a dole je diera. Operačný systém používa adresy v tejto strednej časti na asociáciu s procesom rôznych entít. Konkrétne môže priradiť istému neprerušovanému súboru adries — súbor na disku. Takýto súbor sa nazýva pamäťovo mapovaný.
Pridelený adresný priestor procesu je obrovský. Teoreticky je počet adries obmedzený len veľkosťou ukazovateľa, ktorý je určený bitnosťou systému. Keby mu bola priradená fyzická pamäť v pomere 1:1, prvý proces by zožral všetku operačnú pamäť a o žiadnej multitasking sa nemohlo ani hovoriť.
Avšak zo svojej skúsenosti vieme, že moderné operačné systémy môžu súčasne vykonávať akokoľvek veľa procesov. To je možné vďaka tomu, že im len na papieri pridelia obrovské množstvo pamäti, no v skutočnosti načítavajú do hlavnej fyzickej pamäte iba tú časť, ktorá je aktuálne potrebná. Preto sa pamäť asociovaná s procesom nazýva virtuálna.
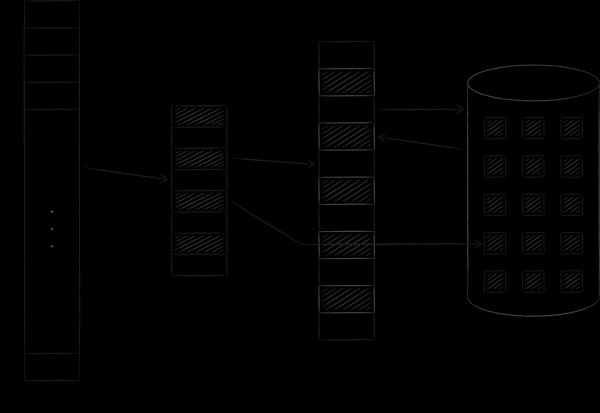
Operačný systém organizuje virtuálnu a fyzickú pamäť vo forme stránok určitej veľkosti. Akonáhle je nejaká stránka virtuálnej pamäte požadovaná, operačný systém ju načíta do fyzickej pamäte a vytvorí medzi nimi zodpovednosť v špeciálnej tabuľke. Ak nie sú k dispozícii voľné sloty, jedna z predtým načítaných stránok je skopírovaná na disk a požadovaná sa umiestni na jej miesto. Tento proces, ku ktorému sa čoskoro vrátime, sa nazýva swapovanie (swapping). Obrázok nižšie ilustruje opísaný proces. Na ňom bola stránka A s adresou 0 načítaná a umiestnená na stránke hlavnej pamäte s adresou 4. Tento fakt sa odrazil v tabuľke zodpovedností v bunky číslo 0.
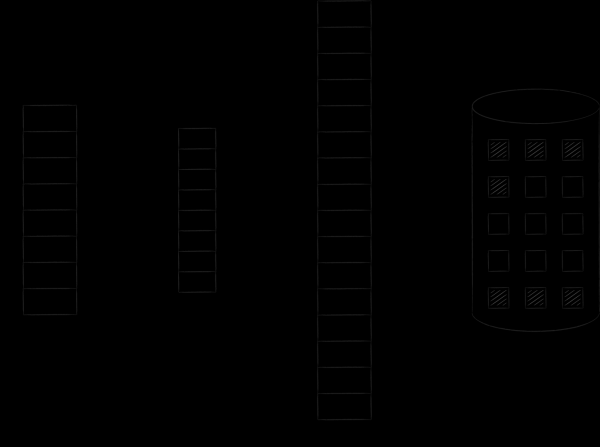
S in-memory zobrazenými súbormi je história presne taká istá. Logicky sú akoby nepretržite a celisto umiestnené vo virtuálnom adresnom priestore. Avšak do fyzickej pamäte sa dostávajú po stránkach a len na požiadanie. Úprava takýchto stránok je synchronizovaná so súborom na disku. Takto je možné vykonávať súborový vstup/výstup, jednoducho manipulovaním s bajtmi v pamäti - všetky zmeny budú automaticky prenesené jadrom operačného systému späť do pôvodného súboru.
Obrázok nižšie demonštruje, ako LMDB synchronizuje svoj stav pri práci s databázou z rôznych procesov. Zmapovaním virtuálnej pamäte rôznych procesov na ten istý súbor, de facto zaväzujeme operačný systém tranzitívne synchronizovať určité bloky ich adresných priestorov, na ktoré LMDB pozerá.
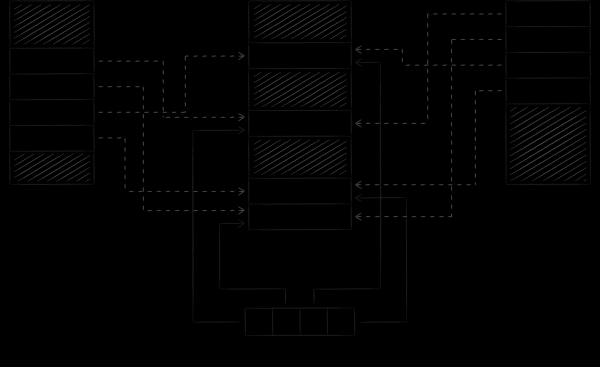
Dôležitý detail spočíva v tom, že LMDB podľa predvolieb modifikuje súbor s dátami cez mechanizmus systémového volania write, pričom samotný súbor zobrazuje v režime iba na čítanie. Tento prístup má dve dôležité dôsledky.
Prvé následky sú spoločné pre všetky operačné systémy. Ich podstata spočíva v pridávaní ochrany proti neúmyselnému poškodeniu databázy nesprávnym kódom. Ako je známe, vykonávacie pokyny procesu môžu slobodne pristupovať k údajom z akejkoľvek časti svojho adresného priestoru. Zároveň, ako sme si práve pripomenuli, zobrazenie súboru v režime read-write znamená, že akýkoľvek pokyn ho môže navyše aj modifikovať. Ak tak urobí omylom, snažiac sa napríklad naozaj prepísať prvok poľa pomocou neexistujúceho indexu, môže táto operácia náhodne zmeniť súbor namapovaný na túto adresu, čo povedie k poškodeniu databázy. Ak je však súbor zobrazený v režime read-only, pokus o zmenu zodpovedajúceho adresného priestoru spôsobí havarijné ukončenie programu so signálom SIGSEGV, a súbor zostane neporušený.
Druhé následky sú už špecifické pre iOS. Ani autor, ani žiadne iné zdroje o ňom explicitne nespomínajú, ale bez neho by bola LMDB neprípustná na fungovanie v tomto mobilnom operačnom systéme. Jeho rozobraniu je venovaná nasledujúca sekcia.
Špecifikácia zobrazených súborov v pamäti v iOS
V roku 2018 na WWDC bola skvelá prednáška . V nej sa uvádza, že v iOS všetky stránky umiestnené v fyzickej pamäti patria do jedného z 3 typov: dirty, compressed a clean.
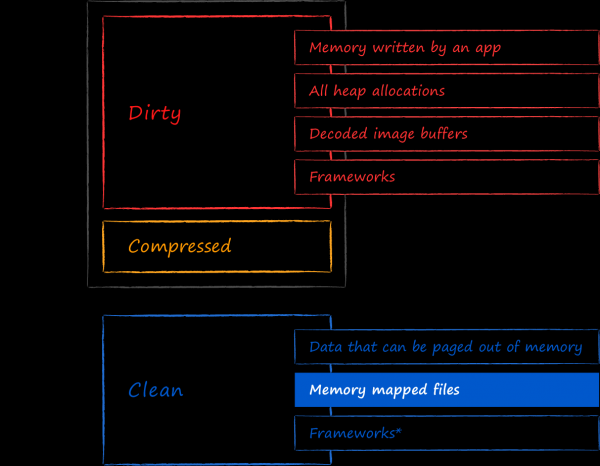
Clean memory je súbor stránok, ktoré môžu byť bezbolestne uvoľnené z fyzickej pamäti. Údaje v nich je možné podľa potreby znovu načítať z ich pôvodných zdrojov. Read-only memory-mapped súbory zapadajú presne do tejto kategórie. iOS sa nebojí kedykoľvek uvoľniť zobrazené na súbor stránky z pamäte, pretože sú zaručene synchronizované so súborom na disku.
V dirty memory sú všetky modifikované stránky, bez ohľadu na to, kde sa pôvodne nachádzali. Konkrétne, tak budú klasifikované aj memory-mapped súbory, ktoré boli zmenené zapisovaním do priradené virtuálnej pamäte. Otvorenie LMDB s vlajkou MDB_WRITEMAP, po vykonaní zmien v nej môžete presvedčiť osobne.
Keď aplikácia začne zaberať príliš veľa fyzickej pamäte, iOS ju podrobuje kompresii dirty stránok. Kombinácia pamäte obsadenej dirty a komprimovanými stránkami predstavuje takzvanú pamäťovú stopu aplikácie. Po dosiahnutí určitého prahového hodnoty sa o proces postará systémový démon OOM killer a nútene ho ukončí. Toto je špecifická vlastnosť iOS v porovnaní s desktopovými operačnými systémami. Na rozdiel od nich znižovanie pamäťovej stopy swapovaním stránok z fyzickej pamäte na disk nie je v iOS predpokladané. O príčinách môžeme len špekulovať. Možno je proces intenzívneho premiestňovania stránok na disk a späť príliš energeticky náročný pre mobilné zariadenia, alebo iOS šetrí zdroje prepisovania buniek na SSD diskoch, alebo možno dizajnérov neuspokojila celková výkonnosť systému, kde sa stále swapuje. Ako to už býva, fakt zostáva faktom.
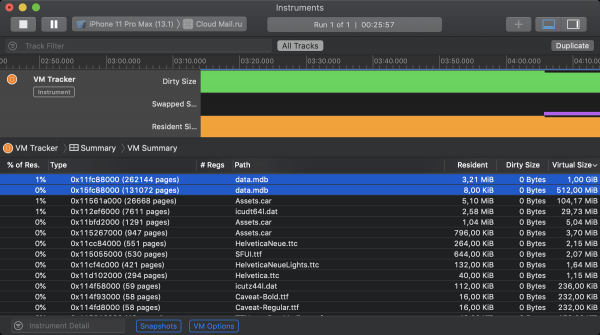
Dobrou správou, o ktorej sme už hovorili, je, že LMDB predvolene nepoužíva mechanizmus mmap na aktualizáciu súborov. Z toho vyplýva, že zobrazené údaje sú klasifikované iOS ako čistá pamäť a neprispievajú k pamätovej stope. O tom sa môžete presvedčiť pomocou nástroja Xcode s názvom VM Tracker. Na obrázku nižšie je zobrazený stav virtuálnej pamäte aplikácie iOS Oblačnosti počas prevádzky. Na začiatku bolo inicializovaných 2 inštancií LMDB. Prvej bolo povolené zobraziť si svoj súbor na 1GiB virtuálnej pamäte, druhej – 512MiB. Napriek tomu, že oboch úložísk zabera určitý objem rezidentnej pamäte, žiadne z nich neprispieva k dirty size.
A teraz prichádzajú zlé správy. Vďaka mechanizmu swapovania v 64-bitových desktopových operačných systémoch môže každý proces zaberať toľko virtuálneho adresného priestoru, koľko umožňuje voľné miesto na pevnom disku pre jeho potenciálny swap. Nahradenie swapovania kompresiou v iOS radikálne znižuje teoretický maximálny limit. Teraz musia všetky žijúce procesy zapadnúť do hlavnej (t.j. operačnej) pamäte a všetky, ktoré sa tam nezmestia, podliehajú nútenému ukončeniu. O tom hovorí aj už spomenutá , tak aj v . Ako následok, iOS prísne obmedzuje veľkosť pamäte dostupnej na alokáciu cez mmap. Tu je Môžete si pozrieť empirické hranice objemov pamäte, ktorú sa podarilo alokovať na rôznych zariadeniach pomocou tohto systémového volania. Na najmodernejších modeloch smartfónov iOS sa podarilo získať 2 gigabajty, a na špičkových verziách iPadu dokonca 4. V praxi sa však spravidla musíme orientovať na najslabšie podporované modely zariadení, kde je situácia veľmi smutná. Horšie je, že ak sa pozriete na stav pamäte aplikácie vo VM Tracker, môžete zistiť, že LMDB nie je jediná, kto žiada o pamäť s mapovaním. Dobrú časť zaberať systémoví alokátory, súbory s prostriedkami, rámce na prácu s obrázkami a iní menší predátori.
Na základe experimentov v Oblačnosti sme dospeli k nasledujúcim kompromisným hodnotám pridelené pamäte LMDB: 384 megabajtov pre 32-bitové zariadenia a 768 pre 64-bitové. Po vyčerpaní tohto objemu začínajú akékoľvek modifikačné operácie končiť s kódom MDB_MAP_FULL. Tieto chyby pozorujeme v našom monitorovaní, ale je ich dostatočne málo na to, aby sme ich v tomto štádiu mohli ignorovať.
Neočividnou príčinou nadmernej spotreby pamäte úložiskom môžu byť dlhodobé transakcie. Na pochopenie, ako sú tieto dva javy prepojené, nám pomôže zváženie zostávajúcich dvoch pilierov LMDB.
3.2. Pilier č. 2. B+-strom
Na emuláciu tabuliek nad key-value úložiskom je potrebné, aby jeho API obsahovalo nasledujúce operácie:
- Vloženie nového prvku.
- Vyhľadanie prvku so zadaným kľúčom.
- Odstránenie prvku.
- Iterovanie po intervaloch kľúčov v poradí ich zoradenia.
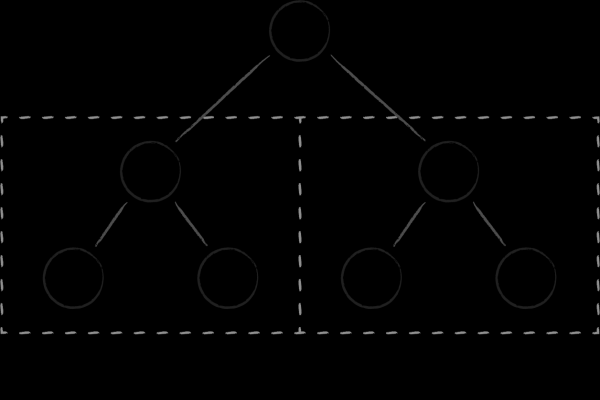 Najjednoduchšou štruktúrou dát, pomocou ktorej je možné jednoducho realizovať všetky štyri operácie, je binárne vyhľadávacie strom. Každý jeho uzol predstavuje kľúč, ktorý delí celé podmnožstvo potomkovských kľúčov na dva podstromy. V ľavom sú zhromaždené tie, ktoré sú menšie ako rodič, a v pravom — tie, ktoré sú väčšie. Získanie usporiadaného množstva kľúčov sa dosiahne pomocou jedného z klasických prechádzok stromom.
Binarne stromy majú dva základné nedostatky, ktoré im bránia byť efektívnymi ako diskové štruktúry údajov. Po prvé, ich úroveň vyváženosti je nep predvídateľná. Existuje značné riziko, že dostanete stromy, v ktorých môže výška rôznych konárov výrazne kolísať, čo významne zhoršuje algoritmickú zložitost vyhľadávania v porovnaní s očakávanou. Po druhé, množstvo krížových odkazov medzi uzlami zbavuje binárne stromy lokalizácie v pamäti. Blízke uzly (z pohľadu vzťahov medzi nimi) sa môžu nachádzať na úplne rôznych stránkach vo virtuálnej pamäti. V dôsledku toho môže byť pre jednoduché prechádzanie niekoľkými susednými uzlami v strome potrebné navštíviť porovnateľný počet stránok. Toto je problém aj vtedy, keď hovoríme o účinnosti binárnych stromov ako in-memory štruktúry údajov, pretože neustála rotácia strániek v cache procesora je nákladná záležitosť. A keď príde na časté načítanie súvisiacich stránok uzlov z disku, situácia sa stáva ešte vážnejšou. .
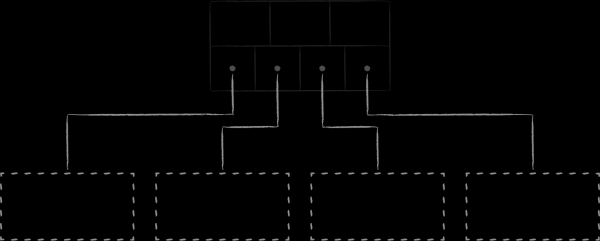 B-stromy, ako evolúcia binárnych stromov, riešia uvedené problémy v predchádzajúcom odstavci. Po prvé, sú samobalansujúce. Po druhé, každý uzol rozdeľuje množstvo dcérskych kľúčov nie na 2, ale na M usporiadaných podmnožín, pričom číslo M môže byť pomerne veľké, rádovo niekoľko sto, ba dokonca tisícov.
Vďaka tomu:
- V každom uzle je veľké množstvo už usporiadaných kľúčov a stromy sú veľmi nízke.
- Strom nadobúda vlastnosť lokalizácie v pamäti, pretože blízke hodnotou kľúče sa prirodzene nachádzajú blízko seba na jednom alebo susedných uzloch.
- Znižuje sa počet prechodných uzlov pri zostupe po strome počas operácie vyhľadávania.
- Znižuje sa počet čítaných cieľových uzlov pri range-žiadosťach, pretože v každom z nich už obsahuje veľké množstvo usporiadaných kľúčov.
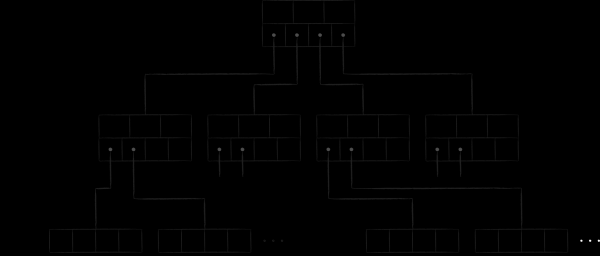
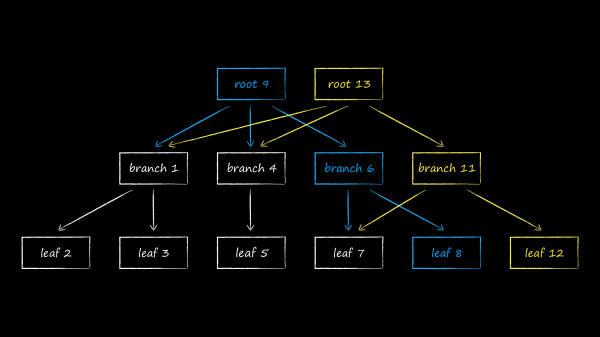
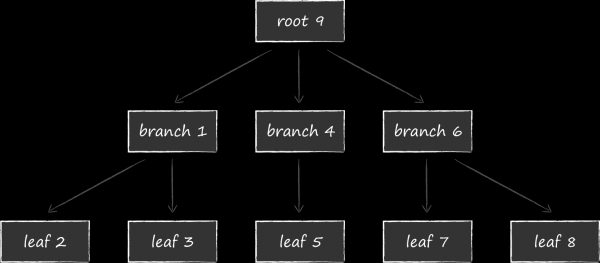
V LMDB sa na ukladanie údajov používa jedna z variácií B-stromu nazývaná B+-strom. Na schéme vyššie sú zobrazené tri typy uzlov, ktoré sa v ňom nachádzajú:
- Na vrchole sa nachádza koreň (root). Ten materializuje niečo iné, ako koncept databázy v rámci úložiska. V rámci jedného inštancie LMDB je možné vytvoriť niekoľko databáz, ktoré si delia mapované virtuálne adresné priestory. Každá z nich začína svojim vlastným koreňom.
- Na najspodnejšej úrovni sa nachádzajú listy (leaf). Práve tie a len tie obsahujú v databáze uložené páry kľúč-hodnota. Mimochodom, v tom spočíva špeciálnosť B+-stromov. Ak bežný B-strom uchováva časti value-v uzloch všetkých úrovní, B+-variácia iba na najnižšej. Po zafixovaní tohto faktu, budeme nazývať podtyp použitého v LMDB stromu jednoducho B-stromom.
- Medzi koreňom a listami sa nachádza 0 a viac technických úrovní s navigačnými (branch) uzlami. Ich úlohou je rozčleniť usporiadanú množinu kľúčov medzi listy.
Fyzicky sú uzly bloky pamäte vopred určenej dĺžky. Ich veľkosť je násobkom veľkosti strán pamäte v operačnom systéme, o ktorých sme sa rozprávali vyššie. Nižšie je zobrazená štruktúra uzla. V hlavičke sa nachádzajú metainformácie, najzjavnejšia z nich pre príklad — je to kontrolná suma. Nasledujú informácie o offsetoch, podľa ktorých sú uložené bunky s údajmi. Ako údaje môžu vystupovať buď kľúče, ak hovoríme o navigačných uzloch, alebo kompletne páry kľúč-hodnota v prípade listov. O štruktúre strán sa dá podrobnejšie prečítať v práci .
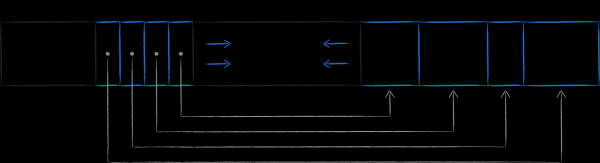
Po oboznámení sa s vnútorným naplnením uzlov-strán sa ďalej B-strom LMDB bude predstaviť zjednodušene v nasledujúcom tvare.
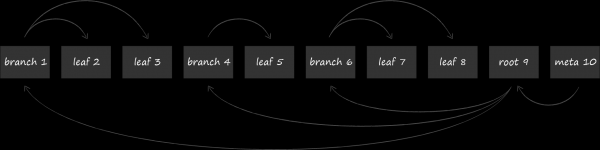
Stránky s uzlami sa postupne nachádzajú na disku. Stránky s vyšším číslom sú umiestnené bližšie ku koncu súboru. Takzvaná meta-stránka (meta page) obsahuje informácie o offsetoch, podľa ktorých je možné nájsť korene všetkých stromov. Pri otvorení súboru LMDB stránka po stránke skenuje súbor od konca k začiatku v hľadání platnej meta-stránky a už cez ňu nachádza existujúce databázy.
Teraz, s pochopením logickej a fyzickej štruktúry organizácie dát, sa môžeme posunúť k tretiemu piliariu LMDB. Práve s jeho pomocou sa všetky modifikácie úložiska uskutočňujú transakčne a izolovane od seba, pričom databáze dodávajú aj vlastnosť viacverziovosti.
3.3. Piliár č. 3. Copy-on-write
Niektoré operácie s B-stromom predpokladajú zavedenie celej série zmien v jeho uzloch. Jedným z príkladov je pridanie nového kľúča do uzla, v ktorom už bola dosiahnutá maximálna kapacita. V takom prípade je potrebné, po prvé, rozdeliť uzol na dva a po druhé, pridať odkázanie na nový odštiepený poduzol v jeho rodičovskom uzle. Tento postup je potenciálne veľmi nebezpečný. Ak sa z nejakých dôvodov (havária, vypnutie napájania atď.) uskutoční len časť zmien zo série, strom zostane v nekonzistentnom stave.
Jedným z tradičných riešení na zabezpečenie databázy proti chybám je pridať vedľa B-stromu dodatočnú diskovú štruktúru dát — log transakcií, známy aj pod menom write-ahead log (WAL). Je to súbor, do ktorého sa prísne pred modifikáciou samotného B-stromu zapisuje predpokladaná operácia. Týmto spôsobom, ak sa počas sebaúdržby zistí poškodenie dát, databáza sa poradí s logom, aby sa dala do poriadku.
LMDB si ako mechanizmus zabezpečenia proti chybám zvolila iný spôsob, a to copy-on-write. Jeho podstatou je, že namiesto aktualizácie dát na existujúcej stránke sa najprv celá skopíruje a všetky modifikácie sa vykonávajú už v kópii.
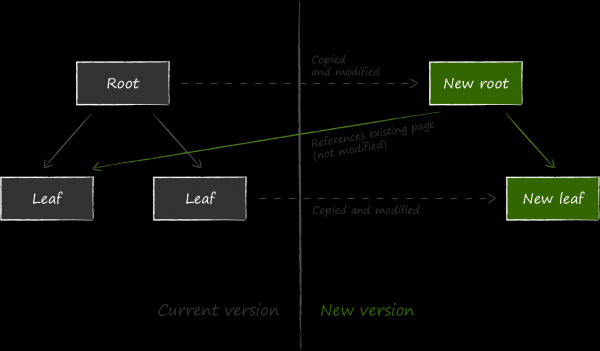
Ďalej, aby boli aktualizované dáta dostupné, je potrebné zmeniť odkaz na aktuálny uzol v rodičovskom uzle vo vzťahu k nemu. Keďže je potrebné ho tiež modifikovať, najprv sa tiež skopíruje. Proces pokračuje rekurzívne až po samotný koreň. Posledné sa menia dáta na meta-stránke.
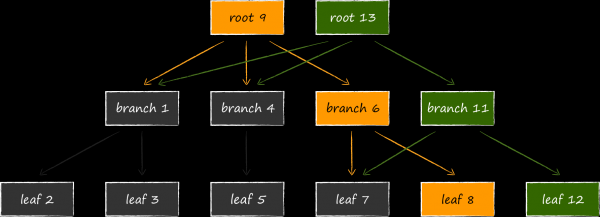
Ak sa počas aktualizácie proces náhodne ukončí, buď sa nevytvorí nová meta-stránka, alebo sa neuloží na disk a jej kontrolná suma bude nesprávna. V oboch prípadoch nové stránky nebudú dostupné a staré ostanú neporušené. Tým sa LMDB zbavuje potreby viesť write ahead log na udržanie konzistencie údajov. De facto štruktúra ukladania údajov na disku, popísaná vyššie, súčasne preberá aj túto funkciu. Absencia transakčného logu v explicitnej forme je jednou z výhod LMDB, ktorá zabezpečuje vysokú rýchlosť čítania údajov.
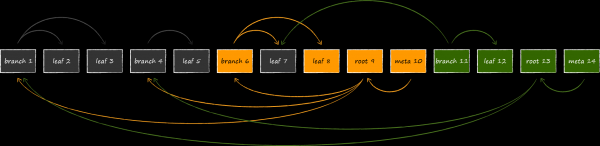
Vytvorená konštrukcia s názvom append-only B-tree prirodzene zabezpečuje izoláciu transakcií a multiverziónnosť. V LMDB je s každou otvorenou transakciou spojený aktuálny koreň stromu. Pokiaľ transakcia nie je dokončená, stránky prislúchajúce k tomuto stromu nebudú nikdy zmenené alebo opätovne použité pre nové verzie údajov. Takto sa môžeš dlhodobo zaoberať presne tým súborom údajov, ktorý bol aktuálny v okamihu otvorenia transakcie, aj keď úložisko v tom čase pokračuje v aktívnych aktualizáciách. V tom spočíva esencia multiverziónnosti, ktorá robí LMDB ideálnym zdrojom údajov pre všetkých nás obľúbeného. UICollectionViewPri otvorení transakcie nie je potrebné zvyšovať memory footprint aplikácie, aby sa rýchlo načítali aktuálne údaje do nejakej in-memory štruktúry, zo strachu, že zostaneme bez možností. Táto vlastnosť výhodne odlišuje LMDB od SQLite, ktorý takúto úplnú izoláciu nemôže ponúknuť. Ak otvoríš v druhom systéme dve transakcie a odstrániš nejaký záznam v rámci jednej z nich, ten istý záznam už nebudeš môcť získať ani v rámci druhej zostávajúcej.
Rubric of this issue is a potentially significantly greater consumption of virtual memory. The slide depicts how the database structure will appear when it is modified simultaneously with 3 open read transactions observing different versions of the database. Since LMDB cannot reuse nodes reachable from roots associated with current transactions, the storage has no choice but to allocate another fourth root in memory and clone the modifiable pages beneath it once again.
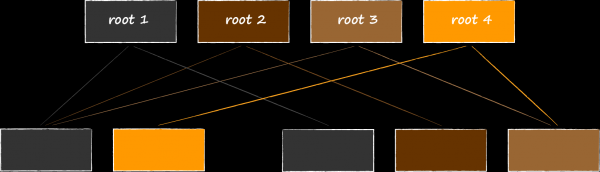
It's worth recalling the section on memory-mapped files here. While the additional consumption of virtual memory shouldn't concern us too much since it doesn't contribute to the application's memory footprint, at the same time, it has been noted that iOS is quite stingy with its allocation. We cannot casually allocate a 1 terabyte region for LMDB as we might on a server or desktop without considering this peculiarity. As much as possible, we should aim to keep the lifespan of transactions as short as we can.
4. Data schema design over key-value API
We will begin the API review by looking at the basic abstractions provided by LMDB: environment and databases, keys and values, transactions and cursors.
Note on code listings
All functions in the public LMDB API return their results as error codes, but in subsequent listings, their checking is omitted for the sake of brevity. In practice, we used our own C++ wrappers , where errors manifest as C++ exceptions.
As the fastest way to integrate LMDB into a project for iOS or macOS, I suggest my CocoaPod .
4.1. Basic abstractions
Environment (environment)
Struktura MDB_env is the repository for LMDB's internal state. The family of functions prefixed with mdb_env allows for configuration of some of its properties. In the simplest case, initializing the engine looks as follows.
mdb_env_create(env);
mdb_env_set_map_size(*env, 1024 * 1024 * 512);
mdb_env_open(*env, path.UTF8String, MDB_NOTLS, 0664);
In the Mail.ru Cloud application, we only changed the default values for two parameters.
Prvý z nich je veľkosť virtuálneho adresného priestoru, na ktorý je zobrazený súbor úložiska. Bohužiaľ, aj na tom istom zariadení sa konkrétna hodnota môže podstatne líšiť od spustenia k spusteniu. Aby sme zohľadnili túto špecifikáciu iOS, maximálny objem úložiska sa dynamicky prispôsobuje. Začínajúc od určitej hodnoty, postupne sa znižuje, kým funkcia mdb_env_open nevráti výsledok odlišný od ENOMEM. V teórii existuje aj opačný prístup - najprv prideliť motoru minimum pamäte a potom, po obdržaní chýb MDB_MAP_FULL, zvyšovať ju. Avšak je to oveľa zložitejšie. Dôvodom je, že procedúra prealokovania pamäte (remap) pomocou funkcie mdb_env_set_map_size neplatí všetky entity (kurzory, transakcie, kľúče a hodnoty), ktoré boli predtým získané od motoru. Zohľadnenie takéhoto zvratu udalostí v kóde spôsobí jeho podstatné skomplikovanie. Ak vám však virtuálna pamäť veľmi záleží, môže to byť dôvod na zváženie vzdialeného forku , ktorý medzi deklarovanými funkciami ponúka „automatické prispôsobenie veľkosti databázy na požiadanie“.
Druhý parameter, ktorého predvolené hodnoty nám nevyhovujú, reguluje mechanizmus zabezpečenia vlákno-bezpečnosti. Bohužiaľ, minimálne v iOS 10 existujú problémy s podporou thread local storage. Z tohoto dôvodu sa v vyššie uvedenom príklade úložisko otvára s príznakom MDB_NOTLS. Okrem toho bolo potrebné aj C++ obal , aby sa vyrezali premenné s týmto atribútom aj v ňom.
Databázy
Databáza predstavuje samostatný inštanc B-stromu, o ktorom sme hovorili predtým. Jej otvorenie prebieha v rámci transakcie, čo sa na prvý pohľad môže zdať trochu divné.
MDB_txn *txn;
MDB_dbi dbi;
mdb_txn_begin(env, NULL, MDB_RDONLY, &txn);
mdb_dbi_open(txn, NULL, MDB_CREATE, &dbi);
mdb_txn_abort(txn);Skutočne, transakcia v LMDB je entitou úložiska, a nie konkrétnej databázy. Takáto koncepcia umožňuje uskutočňovať atomické operácie na entitách nachádzajúcich sa v rôznych databázach. Teoreticky to otvára možnosť modelovania tabuliek vo forme rôznych základní, ale ja som sa v tom čase vybral inou cestou, podrobne opísanou nižšie.
Kľúče a hodnoty
Struktura MDB_val modeluje koncept ako kľúča, tak aj hodnoty. Úložisko nemá ani najmenšieho tušenia o ich semantike. Preň je to, čo je iné — je to len pole bajtov určitej veľkosti. Maximálna veľkosť kľúča je 512 bajtov.
typedef struct MDB_val {
size_t mv_size;
void *mv_data;
} MDB_val;S pomocou komparátora úložisko usporadúva kľúče vzostupne. Ak ho nenahradíte vlastným, použije sa predvolený, ktorý ich triedi po bajtoch v lexikografickom poradí.
Transakcie
Označenie transakcií je podrobne opísané v , preto tu stručne zhrniem ich hlavné vlastnosti:
- Podpora všetkých základných vlastností : atomickosť, konzistencia, izolovanosť a spoľahlivosť. Nemôžem nespomenúť, že v oblasti trvácnosti na macOS a iOS existuje chyba, ktorá bola opravená v MDBX. Podrobnejšie si môžete prečítať v ich .
- Prístup k viacnásobnému prístupu je popísaný schémou "single writer / multiple readers". Písači sa navzájom blokujú, ale neblokujú čitateľov. Čitatelia neblokujú ani písačov, ani seba navzájom.
- Podpora vnorených transakcií.
- Podpora multiverznosti.
Multiverznosť v LMDB je taká dobrá, že ju chcem demonštrovať v akcii. Z kódu nižšie je vidieť, že každá transakcia pracuje presne s tou verziou databázy, ktorá bola aktuálna v čase jej otvorenia, pričom je úplne izolovaná od všetkých následných zmien. Inicializácia úložiska a pridanie doň testovacieho záznamu nie sú ničím zaujímavým, preto sú tieto rituály ponechané pod spoilerom.
Pridanie testovacieho záznamu
MDB_env *env;
MDB_dbi dbi;
MDB_txn *txn;

mdb_env_create(&env);
mdb_env_open(env, ".\/testdb", MDB_NOTLS, 0664);

mdb_txn_begin(env, NULL, 0, &txn);
mdb_dbi_open(txn, NULL, 0, &dbi);
mdb_txn_abort(txn);

char k = 'k';
MDB_val key;
key.mv_size = sizeof(k);
key.mv_data = (void *)&k;

int v = 997;
MDB_val value;
value.mv_size = sizeof(v);
value.mv_data = (void *)&v;

mdb_txn_begin(env, NULL, 0, &txn);
mdb_put(txn, dbi, &key, &value, MDB_NOOVERWRITE);
mdb_txn_commit(txn);
MDB_txn *txn1, *txn2, *txn3;
MDB_val val;
// Otvoríme 2 transakcie, z ktorých každá sleduje
// verziu databázy s jedným záznamom.
mdb_txn_begin(env, NULL, 0, &txn1); // read-write
mdb_txn_begin(env, NULL, MDB_RDONLY, &txn2); // read-only
// V rámci prvej transakcie odstraňujeme z databázy existujúci záznam.
mdb_del(txn1, dbi, &key, NULL);
// Potvrdíme odstránenie.
mdb_txn_commit(txn1);
// Otvoríme tretiu transakciu, ktorá sa pozerá na
// aktuálnu verziu databázy, kde záznam už neexistuje.
mdb_txn_begin(env, NULL, MDB_RDONLY, &txn3);
// Ubezpečíme sa, že záznam s hľadaným kľúčom už neexistuje.
assert(mdb_get(txn3, dbi, &key, &val) == MDB_NOTFOUND);
// Ukončíme transakciu.
mdb_txn_abort(txn3);
// Ubezpečíme sa, že v rámci druhej transakcie, otvorenej v čase
// existencie záznamu v databáze, ho stále možno nájsť podľa kľúča.
assert(mdb_get(txn2, dbi, &key, &val) == MDB_SUCCESS);
// Overíme, že podľa kľúča sme získali nie akýkoľvek odpad, ale platné dáta.
assert(*(int *)val.mv_data == 997);
// Ukončíme transakciu, pracujúcu aj s zastaranou, ale konzistentnou databázou.
mdb_txn_abort(txn2);Voliteľne odporúčam vyskúšať ten istý trik so SQLite a pozrieť, čo z toho vznikne.
Multiverzionizmus prináša veľmi príjemné výhody do života iOS vývojára. S pomocou tejto vlastnosti môžeme ľahko a bez námahy regulovať rýchlosť aktualizácie zdroja údajov (data source) pre obrazovkové formuláre, vychádzajúc z úvah o používateľskom zážitku. Ako príklad vezmeme funkciu aplikácie Cloud Mail.ru, ako automatické načítanie obsahu zo systémovej mediagalerie. Pri dobrom pripojení je klient schopný pridať na server niekoľko fotografií za sekundu. Ak po každom nahraní aktualizujeme UICollectionView mediálny obsah v cloude používateľa, môžeme zabudnúť na 60 fps a plynulé posúvanie počas tohto procesu. Aby sme predišli častým aktualizáciám obrazovky, je potrebné nejako obmedziť rýchlosť zmien údajov na pozadí. UICollectionViewDataSource.
Ak databáza nepodporuje multiverzionalitu a umožňuje pracovať len s aktuálnym stavom, na vytvorenie stabilného snímku údajov v čase je potrebné ho skopírovať do nejakéj in-memory dátovej štruktúry alebo do dočasnej tabuľky. Každý z týchto prístupov je veľmi nákladný. V prípade in-memory úložiska máme náklady na pamäť spojené so skladovaním konštruovaných objektov, ako aj časové náklady súvisiace s nadbytočnými ORM transformáciami. Čo sa týka dočasnej tabuľky, to je ešte nákladnejšie, a má zmysel len v netriviálnych prípadoch.
Multiverzionalita LMDB veľmi elegantne rieši úlohu udržania stabilného zdroja údajov. Stačí jednoducho otvoriť transakciu a voilà — pokiaľ ju neskončíme, súbor údajov máme garantovane zafixovaný. Logika rýchlosti jeho aktualizácie je teraz úplne a plne v rukách prezentačnej vrstvy bez akejkoľvek významnej režie prostriedkov.
Kurzy
Kurzy poskytujú mechanizmus na usporiadané iterovanie cez páry kľúč-hodnota prostredníctvom prechádzania B-stromu. Bez nich by bolo nemožné efektívne modelovať tabuľky v databáze, ktorým sa teraz budeme venovať.
4.2. Modelovanie tabuliek
Vlastnosť usporiadanosti kľúčov umožňuje konštruovať na základných abstrakciách takú vysokú úroveň, ako je tabuľka. Pozrime sa na tento proces na príklade hlavnej tabuľky cloudového klienta, v ktorej je uložená informácia o všetkých súboroch a priečinkoch používateľa.
Schéma tabulky
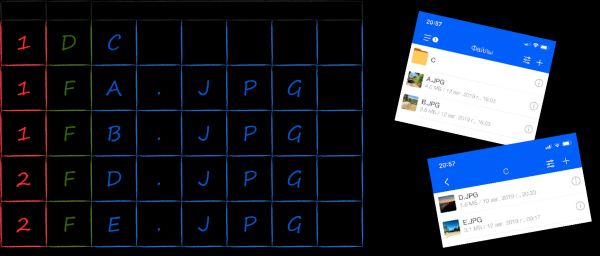
Jedným z častých scenárov, pre ktorý by mala byť štruktúra tabuľky s priečinkami optimalizovaná, je vyžiadanie všetkých prvkov nachádzajúcich sa v zadanom adresári. Dobrou modelou organizácie údajov pre efektívne požiadavky tohto druhu je . Na jeho realizáciu na vrchu key-value úložiska je potrebné triediť kľúče súborov a priečinkov tak, aby sa skupinovali na základe príslušnosti k rodičovskému adresáru. Okrem toho, aby ste zobrazili obsah adresára v tradičnom zobrazení Windows (najprv priečinky, potom súbory, a obe sú triedené podľa abecedy), je potrebné pridať do kľúča príslušné ďalšie polia.
Na obrázku nižšie je znázornené, ako môže vyzerať reprezentácia kľúčov vo forme poľa bajtov, vychádzajúc z nastaveného zadania. Najprv sú umiestnené bajty s identifikátorom rodičovského adresára (červené), potom - s typom (zelené) a nakoniec - s názvom (modré). Po zoradení predvoleným komparátorom LMDB v lexikografickom poradí sú usporiadané požadovaným spôsobom. Sekvenčné prechádzanie kľúčov so spoločným červeným prefixom nám poskytuje hodnoty s nimi súvisiace v tej sekvencii, v akej by mali byť zobrazené v používateľskom rozhraní (vpravo), bez potreby dodatočného postprocessing.
Serializácia kľúčov a hodnôt
Na svete existuje množstvo metód serializácie objektov. Keďže sme nemali žiadne iné požiadavky okrem rýchlosti, pre seba sme si vybrali najrýchlejšiu z možných - dump pamäte, ktorú zaberá inštancia štruktúry jazyka C. Tak, kľúč prvku adresára je možné modelovať nasledujúcou štruktúrou NodeKey.
typedef struct NodeKey {
EntityId parentId;
uint8_t type;
uint8_t nameBuffer[256];
} NodeKey;Pre uloženie NodeKey v úložisku je potrebné v objekte MDB_val pozicionovať ukazovateľ na dáta na adresu začiatku štruktúry a ich veľkosť vypočítať pomocou funkcie sizeof.
MDB_val serialize(NodeKey * const key) {
    return MDB_val {
        .mv_size = sizeof(NodeKey),
        .mv_data = (void *)key
    };
}
V prvej kapitole o kritériách výberu databázy som ako dôležitý faktor výberu spomínal minimalizáciu dynamických alokácií v rámci operácií CRUD. Kód funkcie serialize ukazuje, ako je možné v prípade LMDB ich úplne vyhnúť pri vkladaní nových záznamov do databázy. Prichádzajúce pole bajtov zo servera sa najprv transformuje do zásobníkových štruktúr, a potom sa triviálnym spôsobom dumpujú do úložiska. Vzhľadom na to, že v rámci LMDB tiež nie sú dynamické alokácie, je možné dosiahnuť fantastickú situáciu z hľadiska iOS - na prácu s dátami počas celej cesty od siete po disk využiť len zásobníkovú pamäť!
Usporiadanie kľúčov binárnym komparátorom
Poradie kľúčov je definované špeciálnou funkciou nazývanou komparátor. Keďže engine nevie nič o semantike obsiahnutých bajtov, predvolenému komparátoru nezostáva nič iné, len usporiadať kľúče lexikograficky, pričom sa spolieha na ich bajtové porovnávanie. Použiť ho na triedenie štruktúr je ako holiť sa porciovacím sekerou. Napriek tomu považujem tento spôsob za prijateľný v jednoduchých prípadoch. Alternatíva je opísaná o niečo nižšie, tu však spomeniem pár roztrúsených prekážok na tejto ceste.
Prvá vec, ktorú je potrebné mať na pamäti — je to reprezentácia primitívnych typov dát v pamäti. Na všetkých zariadeniach Apple sa celkové premenné ukladajú vo formáte . To znamená, že najmenej významný bajt bude naľavo, a usporiadať celé čísla pomocou ich bajtového porovnávania nebude možné. Napríklad pokus o to s množinou čísel od 0 do 511 prinesie nasledovný výsledok.
// value (hex dump)
000 (0000)
256 (0001)
001 (0100)
257 (0101)
...
254 (fe00)
510 (fe01)
255 (ff00)
511 (ff01)
Na riešenie tohto problému musia byť celé čísla uložené v kľúči v formáte vhodnom pre bajtového komparátora. Potrebnú konverziu pomôžu zabezpečiť funkcie zo skupiny hton* (konkrétne htons pre dvojbajtové čísla z príkladu).
Formát reprezentácie reťazcov v programovaní je, ako je známe, celá . Ak semantika reťazcov, ako aj kódovanie použité na ich reprezentáciu v pamäti naznačuje, že na znak môže pripadnúť viac ako jeden bajt, je lepšie okamžite sa vzdať myšlienky použitia predvoleného komparátora.
Druhá vec, ktorú treba mať na pamäti — kompilátorom polí štruktúry. Kvôli nim môžu v pamäti medzi políčkami vzniknúť bajty s odpadkovými hodnotami, čo samozrejme narúša bajtové triedenie. Na odstránenie odpadu je potrebné buď vyhlasovať polia v prísne stanovenom poradí, držať na pamäti pravidlá zarovnávania, alebo použiť v deklarácii štruktúry atribút packed.
Usporiadanie kľúčov vonkajším komparátorom
Logika porovnávania kľúčov môže byť pre binárneho komparátora príliš zložitá. Jedným z mnohých dôvodov je prítomnosť technických polí v štruktúrach. Ilustrujem ich vznik na príklade už známeho kľúča pre prvok adresára.
typedef struct NodeKey {
EntityId parentId;
uint8_t type;
uint8_t nameBuffer[256];
} NodeKey;Napriek svojej jednoduchosti vo väčšine prípadov spotrebúva príliš veľa pamäte. Úložisko pre názov zabiera 256 bajtov, aj keď priemerné názvy súborov a priečinkov zriedka presahujú 20-30 znakov.
Jedným zo štandardných spôsobov optimalizácie veľkosti záznamu je jeho „orezanie“ na skutočnú veľkosť. Podstata spočíva v tom, že obsah všetkých polí s premenlivou dĺžkou sa uchováva v buffri na konci štruktúry a ich dĺžky sú uložené v samostatných premenných. V súlade s týmto prístupom sa kľúč NodeKey transformuje nasledujúcim spôsobom.
typedef struct NodeKey {
EntityId parentId;
uint8_t type;
uint8_t nameLength;
uint8_t nameBuffer[256];
} NodeKey;Pri serializácii sa ako veľkosť údajov neudáva sizeof celá štruktúra, ale veľkosť všetkých polí pevnej dĺžky plus veľkosť skutočne použitej časti buffra.
MDB_val serialize(NodeKey * const key) {
    return MDB_val {
        .mv_size = offsetof(NodeKey, nameBuffer) + key->nameLength,
        .mv_data = (void *)key
    };
}
Ako výsledok vykonaného refaktoringu sme dosiahli značnú úsporu priestoru zabraného kľúčmi. Avšak kvôli technickému poľu nameLength, predvolený binárny porovnávač už nie je vhodný na porovnávanie kľúčov. Ak ho nezmeníme na svoj vlastný, dĺžka názvu bude prioritatívnejším faktorom pri triedení ako samotný názov.
LMDB umožňuje priradiť každej databáze svoju vlastnú funkciu porovnávania kľúčov. Robí sa to pomocou funkcie mdb_set_compare prísne pred otvorením. Z očividných dôvodov, počas celej existencie databázy ju nemožno meniť. Ako vstup porovnávač dostane dva kľúče v binárnom formáte a na výstupe vráti výsledok porovnania: menšie (-1), väčšie (1) alebo rovné (0). Pseudokód pre NodeKey vyzerá takto.
int compare(MDB_val * const a, MDB_val * const b) {
NodeKey * const aKey = (NodeKey * const)a->mv_data;
NodeKey * const bKey = (NodeKey * const)b->mv_data;
return // ...
}Pokiaľ majú všetky kľúče v databáze rovnaký typ, bezpodmienečné prevedenie ich bajtového reprezentovania na typ aplikačnej štruktúry kľúča je oprávnené. Existuje však jeden nuans, ktorý bude podrobne zvážený nižšie v pododdiele „Čítanie záznamov“.
Serializácia hodnôt
S kľúčmi uchovávaných záznamov LMDB pracuje veľmi intenzívne. Ich porovnávanie prebieha v rámci akejkoľvek aplikačnej operácie a od rýchlosti komparátora závisí výkonnosť celého riešenia. V ideálnom svete by na porovnávanie kľúčov malo stačiť predvolené binárne porovnanie, avšak ak sa musí použiť vlastný, procedúra deserializácie kľúčov v ňom by mala byť čo najrýchlejšia.
Hodnotou záznamu sa databáza až tak veľmi nezaujíma. Jej premenu z bajtového zobrazenia na objekt zabezpečuje iba vtedy, keď je to pre aplikačný kód už potrebné, napríklad na jeho zobrazenie na obrazovke. Keďže sa to deje pomerne zriedka, požiadavky na rýchlosť tejto procedúry nie sú také kritické, a pri jej implementácii máme oveľa väčšiu slobodu orientovať sa na pohodlnosť. Napríklad pri serializácii metadát o ešte nenahratých súboroch využívame NSKeyedArchiver.
NSData *data = serialize(object);
MDB_val value = {
.mv_size = data.length,
.mv_data = (void *)data.bytes
};Napriek tomu existujú prípady, keď má výkon význam. Napríklad pri ukladaní metainformácií o súborovej štruktúre používateľského cloudu využívame stále ten istý dump pamäte objektov. Zvláštnosťou úlohy pri vytváraní ich serializovaného zobrazenia je skutočnosť, že prvky adresára sú modelované hierarchiou tried.
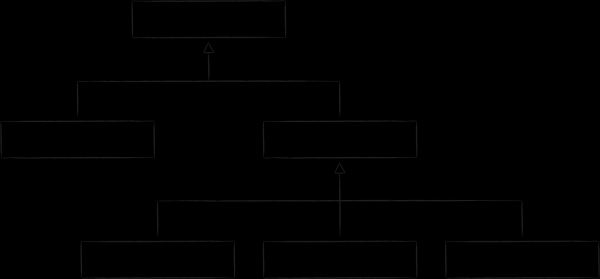
Pre jej implementáciu v jazyku C sa špecifické polia dedičov extrahujú do samostatných štruktúr a ich spojenie s základnou sa určuje cez pole typu union. Aktuálny obsah unionu sa určuje cez technický atribút type.
typedef struct NodeValue {
EntityId localId;
EntityType type;
union {
FileInfo file;
DirectoryInfo directory;
} info;
uint8_t nameLength;
uint8_t nameBuffer[256];
} NodeValue;Pridávanie a aktualizácia záznamov
Serializované kľúče a hodnoty môžu byť pridané do úložiska. Na to sa využíva funkcia mdb_put.
// key и value имеют тип MDB_val
mdb_put(..., &key, &value, MDB_NOOVERWRITE);V etape konfigurácie úložisku môžete povoliť alebo zakázať uchovávanie viacerých záznamov so spoločným kľúčom. Ak je duplikovanie kľúčov zakázané, pri vkladaní záznamu je možné definovať, či je povolené aktualizovať už existujúci záznam alebo nie. Ak k prepisovaniu môže dôjsť len z dôvodu chyby v kóde, môžete sa pred ňou poistiť nastavením príznaku NOOVERWRITE.
Čítanie záznamov
Na čítanie záznamov v LMDB je určená funkcia mdb_get. Ak bol pár kľúč-hodnota predtým predstavený s už vygenerovanými štruktúrami, vyzerá tento proces nasledovne.
NodeValue * const readNode(..., NodeKey * const key) {
MDB_val rawKey = serialize(key);
MDB_val rawValue;
mdb_get(..., &rawKey, &rawValue);
return (NodeValue * const)rawValue.mv_data;
}Predložený úryvok ukazuje, ako serializácia prostredníctvom dumpovania štruktúr umožňuje zbaviť sa dynamických alokácií nielen pri zápise, ale aj pri čítaní údajov. Ukazovateľ získaný z funkcie mdb_get sa pozerá presne na tú adresu virtuálnej pamäte, kde databáza uchováva bajtové zobrazenie objektu. V skutočnosti máme akýsi ORM, ktorý prakticky zadarmo zabezpečuje veľmi vysokú rýchlosť čítania údajov. Pri celej kráse tohto prístupu je potrebné pamätať na niekoľko súvisiacich vlastností.
- Pre readonly transakcie bude ukazovateľ na štruktúru-hodnotu zaručene zostávať platným iba dovtedy, kým transakcia nebude uzavretá. Ako už bolo uvedené, stránky B-stromu, na ktorých sa nachádza objekt, vďaka princípu copy-on-write zostávajú nezmenené, pokiaľ na ne odkazuje aspoň jedna transakcia. Zároveň, akonáhle posledná súvisiaca transakcia končí, môžu byť stránky znovu použité pre nové údaje. Ak je potrebné, aby objekty prežili transakciu, ktorá ich vytvorila, je potrebné ich nakoniec skopírovať.
- Pre readwrite transakciu bude ukazovateľ na získanú štruktúru-hodnotu platný iba do prvej modifikujúcej procedúry (zápis alebo odstránenie údajov).
- Napriek tomu, že štruktúra
NodeValuenie je plnohodnotná, ale orezaná (pozri podkapitolu „Zoradenie kľúčov externým porovnávačom“), cez ukazovateľ je možné bez problémov pristupovať k jej poľom. Hlavné je ho neodzrhnúť! - V žiadnom prípade nemožno modifikovať štruktúru cez získaný ukazovateľ. Všetky zmeny by sa mali vykonávať iba prostredníctvom metódy
mdb_put. Napriek tomu, aj keby ste sa o to snažili, nebude to možné, pretože oblasť pamäte, kde sa táto štruktúra nachádza, je namapovaná v režime readonly. - Remapovanie súboru do adresného priestoru procesu s cieľom, napríklad, zvýšiť maximálnu veľkosť úložiska pomocou funkcie
mdb_env_set_map_sizev plne zanuluje všetky transakcie a s nimi súvisiace entity vôbec a ukazovatele na načítané objekty osobitne.
Nakoniec, ešte jedna vlastnosť je taká zradná, že jej podstatu nemožno jednoducho zriediť do ďalšej položky. V kapitole o B-strome som uviedol schému usporiadania jeho stránok v pamäti. Z nej vyplýva, že adresa začiatku buffera so serializovanými údajmi môže byť úplne ľubovoľná. Kvôli tomu je ukazovateľ na ne, získaný v štruktúre MDB_val a prevedený na ukazovateľ na štruktúru, zvyčajne nevyrovnaný. Na druhej strane architektúry niektorých čipov (v prípade iOS to je armv7) vyžadujú, aby adresa akýchkoľvek údajov bola násobkom veľkosti strojového slova alebo inými slovami, bitnosti systému (pre armv7 — je to 32 bitov). Inými slovami, operácia ako *(int *foo)0x800002 na nich sa považuje za útek a vedie k rozsudku EXC_ARM_DA_ALIGN. Tak tragickému osudu sa možno vyhnúť dvoma spôsobmi.
Prvý spočíva v predchádzajúcom kopírovaní údajov do vopred vyrovnanej štruktúry. Napríklad, na vlastnom porovnávači to bude vyzerať takto.
int compare(MDB_val * const a, MDB_val * const b) {
    NodeKey aKey, bKey;
    memcpy(&aKey, a->mv_data, a->mv_size);
    memcpy(&bKey, b->mv_data, b->mv_size);
    return // ...
}
Alternatívny postup — vopred informovať kompilátor, že štruktúry s kľúčom a hodnotou môžu byť nevyrovnané pomocou atribútu aligned(1). Na ARM možno dosiahnuť rovnakého efektu a pomocou atribútu packed. Keďže navyše prispieva k optimalizácii miesta, ktoré štruktúra zaberá, tento spôsob mi pripadá výhodnejší, aj keď to zvyšuje náklady na prístup k údajom.
typedef struct __attribute__((packed)) NodeKey {
    uint8_t parentId;
    uint8_t type;
    uint8_t nameLength;
    uint8_t nameBuffer[256];
} NodeKey;
Range-žiadosti
Na iterovanie po skupine záznamov v LMDB je k dispozícii abstrakcia kurzora. O tom, ako s ním pracovať, sa budeme rozprávať na príklade známej tabuľky s metadátami používateľského cloudu.
V rámci zobrazenia zoznamu súborov v adresári je potrebné nájsť všetky kľúče, s ktorými sú asociované jeho podriadené súbory a priečinky. V predchádzajúcich podsekciách sme zoradili kľúče NodeKey tak, aby boli najprv usporiadané podľa identifikátora rodičovského adresára. Týmto spôsobom sa technicky úloha získania obsahu priečinka zredukuje na nastavenie kurzora na hornú hranicu skupiny kľúčov so zadaným prefixom a následné iterovanie k dolnej hranici.
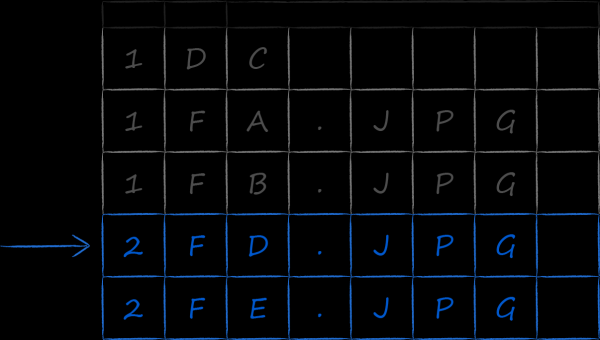
Hornú hranicu je možné nájsť "priamo" sekvenčným vyhľadávaním. K tomu sa kurzor nastaví na začiatok celého zoznamu kľúčov v databáze a potom sa zvyšuje, kým sa pod ním neobjaví kľúč s identifikátorom rodičovského adresára. Tento prístup má dva zrejmé nedostatky:
- Lineárna zložitosť vyhľadávania, hoci je známe, že v stromoch, a zvlášť v B-stromoch, je možné to vykonať za logaritmický čas.
- Náhodne sa načítajú z disku do hlavnej pamäte všetky stránky predchádzajúce hľadanému, čo je mimoriadne nákladné.
Našťastie obsahuje API LMDB efektívny spôsob začínajúcej pozície kurzora. Na tento účel je potrebné vytvoriť taký kľúč, ktorého hodnota bude zjavne menšia alebo rovná kľúču nachádzajúcemu sa na hornej hranici intervalu. Napríklad v súvislosti so zoznamom na obrázku vyššie môžeme vytvoriť taký kľúč, v ktorom pole parentId bude rovné 2, a všetky ostatné budú vyplnené nulami. Taký čiastočne vyplnený kľúč sa podáva na vstup funkcie mdb_cursor_get s uvedením operácie MDB_SET_RANGE.
NodeKey upperBoundSearchKey = {
.parentId = 2,
.type = 0,
.nameLength = 0
};
MDB_val value, key = serialize(upperBoundSearchKey);
MDB_cursor *cursor;
mdb_cursor_open(..., &cursor);
mdb_cursor_get(cursor, &key, &value, MDB_SET_RANGE);Ak je horná hranica skupiny kľúčov nájdená, potom sa naďalej iterujeme po nej, kým sa buď nestretneme s iným kľúčom parentId, alebo kľúče vôbec neskončia.
do {
rc = mdb_cursor_get(cursor, &key, &value, MDB_NEXT);
// spracovanie...
} while (MDB_NOTFOUND != rc && // kontrola konca tabuľky
IsTargetKey(key)); // kontrola konca skupiny kľúčovČo je pozitívne, v rámci iterovania pomocou mdb_cursor_get získavame nielen kľúč, ale aj hodnotu. Ak je potrebné na splnenie podmienok výberu skontrolovať aj polia z value-časti záznamu, sú úplne dostupné bez dodatočných námah.
4.3. Modelovanie vzťahov medzi tabuľkami
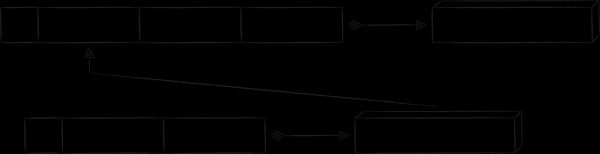
K súčasnému okamihu sme sa dokázali zaoberať všetkými aspektmi návrhu a práce s jednou tabuľkovou databázou. Dalo by sa povedať, že tabuľka je súbor usporiadaných záznamov pozostávajúcich z rovnakých párov kľúč-hodnota. Ak zobrazíme kľúč vo forme obdĺžnika a s ním súvisiacu hodnotu vo forme kvádra, dostaneme vizuálny diagram databázy.

Avšak v reálnom živote sa zriedka podarí obísť s takým malým úsilím. Často je v databáze potrebné, po prvé, mať niekoľko tabuliek, a po druhé, vykonávať v nich výbery v poradí odlišnom od primárneho kľúča. Témam ich vytvárania a vzájomného prepojenia sa venuje táto posledná sekcia.
Indexové tabuľky
V cloudovej aplikácii sa nachádza sekcia „Galéria“. V nej sa zobrazuje mediálny obsah z celého cloudu, usporiadaný podľa dátumu. Na optimálnu realizáciu takejto výberu je vedľa hlavnej tabuľky potrebné založiť ešte jednu s novým typom kľúčov. V týchto tabuľkách bude obsahované pole s dátumom vytvorenia súboru, ktoré bude slúžiť ako primárne kritérium triedenia. Keďže nové kľúče odkazujú na tie isté dáta ako kľúče v hlavnej tabuľke, nazývajú sa indexové. Na obrázku nižšie sú vyznačené oranžovou farbou.
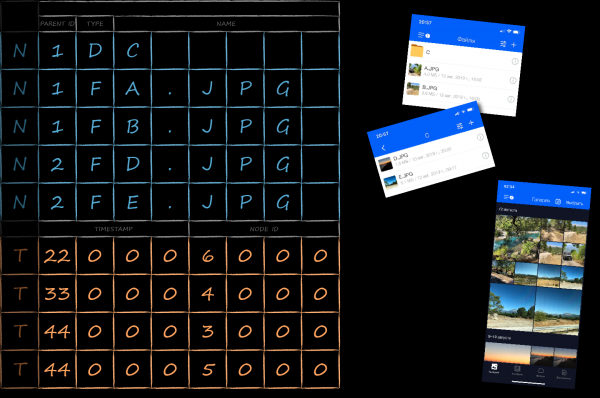
Aby sme v rámci jednej databázy oddelili kľúče rôznych tabuliek, všetkým im bolo pridané ďalšie technické pole tableId. Urobením ho najprioritnejším pre triedenie dosiahneme zoskupenie kľúčov najprv podľa tabuliek a už v rámci tabuliek — podľa svojich pravidiel.
Indexový kľúč odkazuje na tie isté dáta ako primárny. Priame vyjadrenie tohto vlastnosti cez asociáciu s kópiou value-časti primárneho kľúča nie je optimálne hneď z niekoľkých aspektov:
- Z hľadiska obsadeného miesta, vzhľadom na to, že metadata môžu byť veľmi bohaté.
- Z hľadiska výkonu, pretože pri aktualizácii metadát bude musieť uzol vykonávať prepísanie na dvoch kľúčoch.
- Z hľadiska podpory kódu, ak zabudneme aktualizovať údaje pri jednom z kľúčov, dostaneme ťažko zachytiteľnú chybu nekonzistencie údajov v úložisku.
Ďalej sa pozrieme na to, ako odstrániť tieto nedostatky.
Organizácia vzťahov medzi tabuľkami
Na prepojenie indexovej tabuľky s hlavnou sa dobre hodí vzor „kľúč ako hodnota“. Ako názov naznačuje, ako value-časť indexového záznamu slúži kópia hodnoty primárneho kľúča. Tento prístup eliminuje všetky uvedené nedostatky spojené s uchovávaním kópie value-časti primárneho záznamu. Jediná daň — na získanie hodnoty pomocou indexového kľúča je potrebné urobiť 2 dotazy do databázy namiesto jedného. Schématicky získaná schéma databázy vyzerá nasledovne.
Ešte jedným vzorom organizácie vzťahu medzi tabuľkami je „nadbytočný kľúč“. Jeho podstata spočíva v pridaní dodatočných atribútov do kľúča, ktoré nie sú potrebné na triedenie, ale na obnovenie súvisiaceho kľúča. V aplikácii Oblačná Mail.ru existujú konkrétne príklady jeho využitia, avšak aby sa predišlo hlbokému ponoreniu do kontextu špecifických iOS rámcov, uvediem vymyslený, ale o to lepší príklad.
V mobilných klientoch cloudu existuje stránka, kde sú zobrazené všetky súbory a priečinky, ktorým používateľ poskytol prístup iným ľuďom. Keďže takýchto súborov je relatívne málo a rozličné súvisiace informácie o verejnosti je mnoho (komu bol poskytnutý prístup, s akými právami a pod.), nebolo by racionalizované zaťažovať nimi value-časť záznamu v hlavnej tabuľke. Avšak ak by sa malo chcieť zobraziť tieto súbory offline, je potrebné ich niekde uchovávať. Prírodným riešením tohto problému je vytvorenie samostatnej tabuľky. Na schéme nižšie má jej kľúč predponu „P“ a zástupný symbol „propname“ môže byť nahradený konkrétnejšou hodnotou „verejné info“.
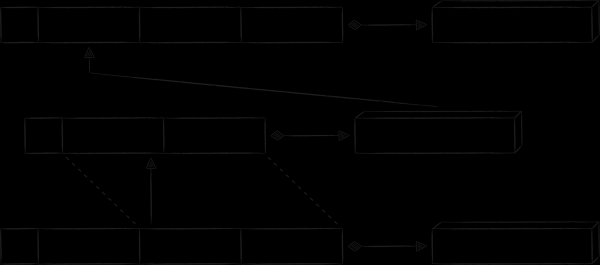
Všetky unikátne metaúdaje, pre ktoré bola vytvorená nová tabuľka, sa prenášajú do value-časti záznamu. Zároveň nie je vhodné duplikovať údaje o súboroch a priečinkoch, ktoré už sú uložené v hlavnej tabuľke. Namiesto toho sa do kľúča „P“ pridávajú nadbytočné údaje vo forme polí „node ID“ a „timestamp“. Vďaka nim je možné konštruovať indexový kľúč, pomocou ktorého získame primárny kľúč, a nakoniec tak získame metadata uzla.
Záver
Záverom hodnotíme implementáciu LMDB pozitívne. Po jeho nasadení sa množstvo zablokovaní aplikácie znížilo o 30%.
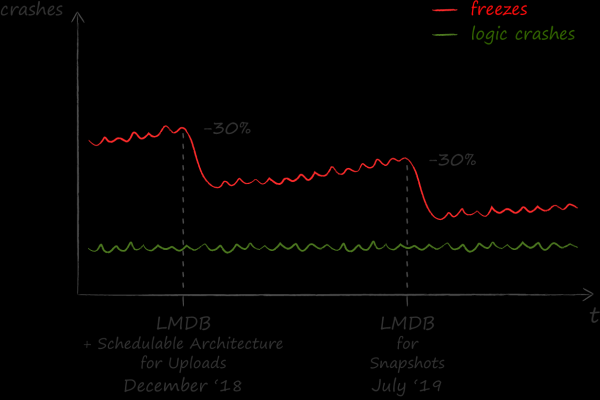
Výsledky vykonanej práce našli odozvu aj mimo tímu iOS. V súčasnosti jedna z hlavných sekcií „Súbory“ v aplikácii pre Android takisto prešla na používanie LMDB, a ďalšie časti sú na ceste. Jazyk C, v ktorom je implementované key-value úložisko, bol dobrým prínosom pre vytvorenie aplikatívneho obalu okolo neho multiplatformne v jazyku C++. Na bezproblémové prepojenie vzniknutej C++ knižnice s platformovým kódom na Objective-C a Kotlin bol použitý kódujúci generátor od Dropboxu, ale to je už úplne iný príbeh.
Zdroj: habr.com
