

Často majú ľudia, ktorí vstupujú do oblasti Data Science, nereálne predstavy o tom, čo ich čaká. Mnohí si myslia, že teraz budú skvele programovať neurónové siete, vytvárať hlasového asistenta ako Iron Man alebo porážať všetkých na finančných trhoch.
Ale práca Data vedeckého pracovníka je založená na údajoch a jedným z najdôležitejších a časovo náročných momentov je spracovanie údajov pred ich predložením do neurónovej siete alebo analýzou určitým spôsobom.
V tomto článku náš tím opíše, ako možno ľahko a rýchlo spracovať údaje s krok za krokom návodom a kódom. Snažili sme sa, aby bol kód dosť flexibilný a mohol byť použitý pre rôzne súbory dát.
Mnohí profesionáli možno v tomto článku nenájdu nič mimoriadne, ale začiatočníci si môžu odnesieť niečo nové a každý, kto už dlho sníva o tom, aby si vytvoril samostatný notebook na rýchle a štruktúrované spracovanie údajov, môže skopírovať kód a prispôsobiť ho podľa seba, alebo
Dostali sme dataset. Čo robiť ďalej?
Takže, štandard: musíme pochopiť, s čím máme do činenia, celkový obraz. Na to použijeme pandas na určenie rôznych typov údajov.
import pandas as pd # importujeme pandas
import numpy as np  # importujeme numpy
df = pd.read_csv("AB_NYC_2019.csv") # čítame dataset a zapisujeme do premennej df
df.head(3) # pozeráme na prvé 3 riadky, aby sme pochopili, ako vyzerajú hodnoty 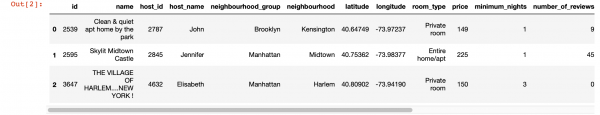
df.info() # Ukazujeme informácie o stĺpcoch 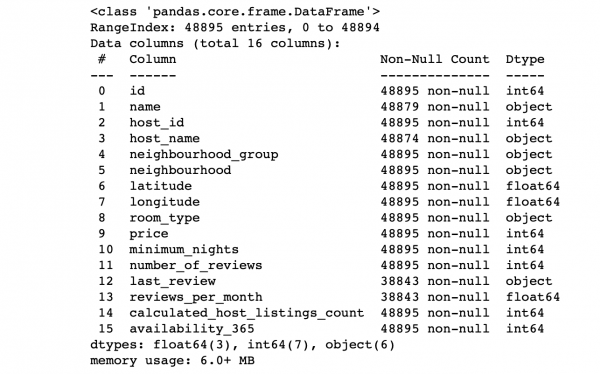
Pozeráme na hodnoty stĺpcov:
- Je počet riadkov v každom stĺpci v súlade s celkovým počtom riadkov?
- Aká je podstata údajov v jednotlivých stĺpcoch?
- Ktorý stĺpec chceme nastaviť ako cieľový, aby sme na ňom robili predpovede?
Odpovede na tieto otázky umožnia analyzovať dataset a načrtnúť plán najbližších krokov.
Takisto, na hlbší pohľad na hodnoty v každom stĺpci môžeme využiť funkciu pandas describe(). Avšak nevýhoda tejto funkcie spočíva v tom, že neposkytuje informácie o stĺpcoch so stringovými hodnotami. S tými sa vysporiadame neskôr.
df.describe() 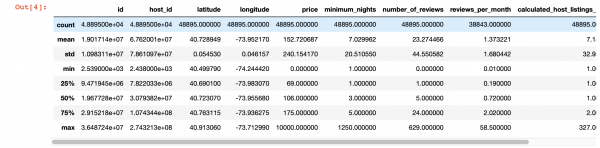
Kúzelná vizualizácia
Pozrime sa na to, kde nám úplne chýbajú hodnoty:
import seaborn as sns
sns.heatmap(df.isnull(), yticklabels=False, cbar=False, cmap='viridis') 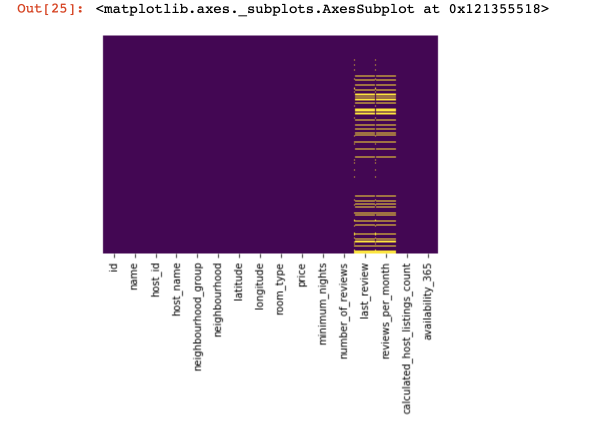
Toto bol malý pohľad zhora, teraz prejdeme k zaujímavejším veciam.
Skúsime nájsť a ak je to možné, odstrániť stĺpce, v ktorých je len jedno hodnotenie vo všetkých riadkoch (nebudú mať žiaden vplyv na výsledok):
df = df[[c for c
        in list(df)
        if len(df[c].unique()) > 1]] #Prepisujeme dataset, pričom zostávajú len tie stĺpce, v ktorých je viac ako jedna unikátna hodnota
Teraz sa chránime a zabezpečujeme úspech nášho projektu pred duplicitnými riadkami (riadkami, ktoré obsahujú rovnaké informácie v rovnakom poradí ako už existujúci riadok):
df.drop_duplicates(inplace=True) #Robíme to, ak to považujeme za potrebné.
                                 #V niektorých projektoch odstrániť takéto dáta na začiatku nemusíme.
Rozdeľujeme dataset na dva: jeden s kvalitnými hodnotami a druhý - s kvantitativnými
Tu je potrebné urobiť malé upresnenie: ak sa riadky s chýbajúcimi údajmi v kvalitných a kvantitatívnych dátach výrazne nezhodujú, budeme musieť rozhodnúť, čím obetujeme - všetkými riadkami s chýbajúcimi údajmi, len ich časťou alebo určitými stĺpcami. Ak sa riadky zhodujú, máme plné právo rozdeliť dataset na dva. V opačnom prípade budeme musieť najprv vyriešiť riadky, v ktorých sa nezhodujú chýbajúce údaje v kvalitných a kvantitatívnych, a až potom rozdeliť dataset na dva.
df_numerical = df.select_dtypes(include=[np.number])
df_categorical = df.select_dtypes(exclude=[np.number])
Robíme to, aby sme si uľahčili spracovanie týchto dvoch rôznych typov dát - neskôr zistíme, ako to zjednodušuje náš život.
Pracujeme s kvantitatívnymi údajmi
Prvé, čo by sme mali urobiť - zistiť, či v kvantitatívnych dátach nie sú "špehujúce stĺpce". Tieto stĺpce nazývame takto, pretože predstierajú, že sú kvantitatívne údaje, ale fungujú ako kvalitné.
Ako ich môžeme identifikovať? Samozrejme, všetko závisí od povahy dát, ktoré analyzujete, ale väčšinou takéto stĺpce môžu mať málo unikátnych údajov (okolo 3-10 unikátnych hodnôt).
print(df_numerical.nunique())Potom, čo určíme špehujúce stĺpce, presunieme ich z kvantitatívnych dát do kvalitných:
spy_columns = df_numerical[['stĺpec1', 'stĺpec2', 'stĺpec3']]#vyberieme špehovské stĺpce a zapíšeme ich do samostatného dataframe
df_numerical.drop(labels=['stĺpec1', 'stĺpec2', 'stĺpec3'], axis=1, inplace = True)#vystrihneme tieto stĺpce z kvantitatívnych údajov
df_categorical.insert(1, 'stĺpec1', spy_columns['stĺpec1']) #pridáme prvý špehovský stĺpec do kvalitatívnych údajov
df_categorical.insert(1, 'stĺpec2', spy_columns['stĺpec2']) #pridáme druhý špehovský stĺpec do kvalitatívnych údajov
df_categorical.insert(1, 'stĺpec3', spy_columns['stĺpec3']) #pridáme tretí špehovský stĺpec do kvalitatívnych údajov
Konečne sme úplne oddelili kvantitatívne údaje od kvalitatívnych a teraz s nimi môžeme poriadne pracovať. Prvé — mali by sme pochopiť, kde máme prázdne hodnoty (NaN, a v niektorých prípadoch aj 0 budú považované za prázdne hodnoty).
for i in df_numerical.columns:
    print(i, df[i][df[i]==0].count())
V tejto fáze je dôležité pochopiť, v ktorých stĺpcoch nuly môžu znamenať chýbajúce hodnoty: súvisí to s tým, ako boli údaje zhromažďované? Alebo môže to byť spojené s hodnotami údajov? Na tieto otázky treba odpovedať v každom jednotlivom prípade.
Ak sme sa predsa len rozhodli, že údaje môžu chýbať tam, kde sú nuly, mali by sme nuly nahradiť NaN, aby sme s týmito chýbajúcimi údajmi mohli neskôr ľahšie pracovať:
df_numerical[["stĺpec 1", "stĺpec 2"]] = df_numerical[["stĺpec 1", "stĺpec 2"]].replace(0, nan)Teraz sa pozrieme, kde máme chýbajúce údaje:
sns.heatmap(df_numerical.isnull(),yticklabels=False,cbar=False,cmap='viridis') # Môžeme tiež použiť df_numerical.info() 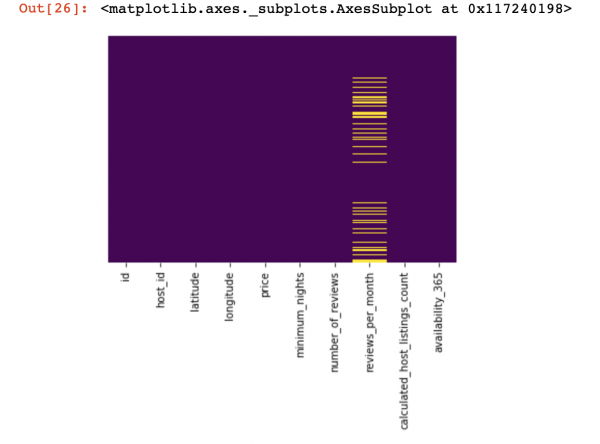
Tu by mali byť žltou farbou označené tie hodnoty v stĺpcoch, ktoré chýbajú. A to najzaujímavejšie začína teraz — ako sa správať k týmto hodnotám? Odstrániť riadky s týmito hodnotami alebo stĺpce? Alebo zaplniť tieto prázdne hodnoty nejakými inými?
Tu je približný plán, ktorý Vám môže pomôcť rozhodnúť, čo sa v zásade dá urobiť s prázdnymi hodnotami:
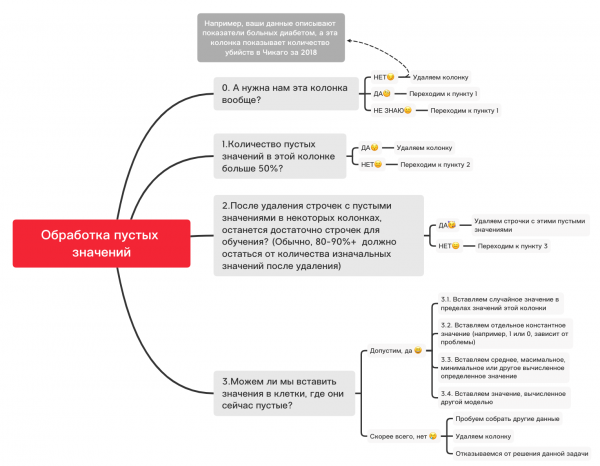
0. Odstránime nepotrebné stĺpce
df_numerical.drop(labels=["stĺpec1","stĺpec2"], axis=1, inplace=True)1. Počet prázdnych hodnôt v tomto stĺpci je viac ako 50%?
print(df_numerical.isnull().sum() / df_numerical.shape[0] * 100)df_numerical.drop(labels=["stĺpec1","stĺpec2"], axis=1, inplace=True)#Odstraňujeme, ak má nejaký stĺpec viac ako 50 prázdnych hodnôt2. Odstraňujeme riadky s prázdnymi hodnotami
df_numerical.dropna(inplace=True)#Odstránime riadky s prázdnymi hodnotami, ak zostane dostatok údajov na učenie3.1. Vloženie náhodnej hodnoty
import random #importujeme random
df_numerical["stĺpec"].fillna(lambda x: random.choice(df[df[column] != np.nan]["stĺpec"]), inplace=True) #vložíme náhodné hodnoty do prázdnych buniek tabuľky
3.2. Vloženie konštantnej hodnoty
from sklearn.impute import SimpleImputer #importujeme SimpleImputer, ktorý pomôže vložiť hodnoty
imputer = SimpleImputer(strategy='constant', fill_value="") #vložíme určenú hodnotu pomocou SimpleImputer
df_numerical[["nový_stĺpec1",'nový_stĺpec2','nový_stĺpec3']] = imputer.fit_transform(df_numerical[['stĺpec1', 'stĺpec2', 'stĺpec3']]) #Aplikujeme to na našu tabuľku
df_numerical.drop(labels = ["stĺpec1","stĺpec2","stĺpec3"], axis = 1, inplace = True) #Odstránime stĺpce so starými hodnotami
3.3. Vloženie priemernej alebo najčastejšej hodnoty
from sklearn.impute import SimpleImputer #importujeme SimpleImputer, ktorý pomôže vložiť hodnoty
imputer = SimpleImputer(strategy='mean', missing_values = np.nan) #namiesto mean môžeme použiť aj most_frequent
df_numerical[["nový_stĺpec1",'nový_stĺpec2','nový_stĺpec3']] = imputer.fit_transform(df_numerical[['stĺpec1', 'stĺpec2', 'stĺpec3']]) #Aplikujeme to na našu tabuľku
df_numerical.drop(labels = ["stĺpec1","stĺpec2","stĺpec3"], axis = 1, inplace = True) #Odstránime stĺpce so starými hodnotami
3.4. Vloženie hodnoty vypočítanej iným modelom
Niekedy je možné hodnoty vypočítať pomocou regresných modelov, pričom môžeme použiť modely z knižnice sklearn alebo iných podobných knižníc. Naša tím sa venovať samostatnému článku o tom, ako to možno uskutočniť v blízkej budúcnosti.
A, zatiaľ čo sa rozprávanie o kvantitatívnych údajoch preruší, pretože existuje množstvo ďalších aspektov o tom, ako najlepšie robiť prípravu dát a predspracovanie pre rôzne úlohy, a základné veci pre kvantitatívne údaje boli zohľadnené v tomto článku, a teraz je čas vrátiť sa k kvalitatívnym údajom, ktoré sme pred niekoľkými krokmi oddelili od kvantitatívnych. Môžete upravovať tento notebook podľa vlastných predstáv, prispôsobujúc ho rôznym úlohám, aby príprava dát prebiehala veľmi rýchlo!
Kvalitatívne údaje
Najmä na kvalitné údaje sa používa metóda One-hot-encoding, aby sa naformátovali z reťazca (alebo objektu) na číslo. Predtým, ako prejdeme na túto časť, využijeme schému a kód vyššie, aby sme si poradili s prázdnymi hodnotami.
df_categorical.nunique()sns.heatmap(df_categorical.isnull(), yticklabels=False, cbar=False, cmap='viridis') 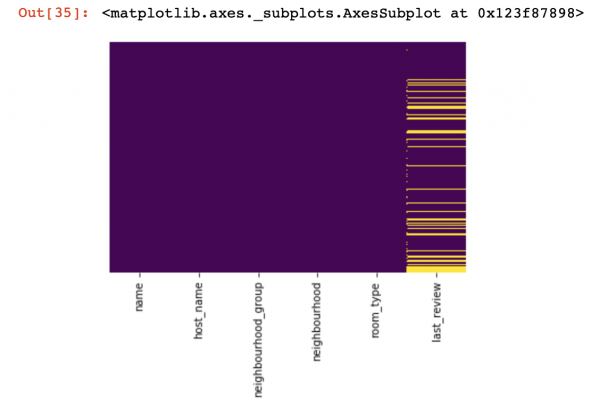
0. Odstránime nepotrebné stĺpce
df_categorical.drop(labels=["stĺpec1", "stĺpec2"], axis=1, inplace=True)1. Počet prázdnych hodnôt v tomto stĺpci je viac ako 50%?
print(df_categorical.isnull().sum() / df_numerical.shape[0] * 100)df_categorical.drop(labels=["stĺpec1", "stĺpec2"], axis=1, inplace=True) # Odstránime, ak nejaký stĺpec
# má viac ako 50% prázdnych hodnôt2. Odstraňujeme riadky s prázdnymi hodnotami
df_categorical.dropna(inplace=True) # Odstránime riadky s prázdnymi hodnotami,
                                   # ak zostane dostatok údajov na učenie
3.1. Vloženie náhodnej hodnoty
import random
df_categorical["stĺpec"].fillna(lambda x: random.choice(df[df[column] != np.nan]["stĺpec"]), inplace=True)
3.2. Vloženie konštantnej hodnoty
from sklearn.impute import SimpleImputer
imputer = SimpleImputer(strategy='constant', fill_value="")
df_categorical[["nový_stĺpec1", 'nový_stĺpec2', 'nový_stĺpec3']] = imputer.fit_transform(df_categorical[['stĺpec1', 'stĺpec2', 'stĺpec3']])
df_categorical.drop(labels=["stĺpec1", "stĺpec2", "stĺpec3"], axis=1, inplace=True)
Takže sme sa konečne poradili s prázdnymi hodnotami v kvalitných údajoch. Teraz je čas vykonať one-hot-encoding pre hodnoty, ktoré máte vo svojej databáze. Táto metóda sa veľmi často používa na to, aby váš algoritmus mohol trénovať so zohľadnením kvalitných údajov.
def encode_and_bind(original_dataframe, feature_to_encode):
    dummies = pd.get_dummies(original_dataframe[[feature_to_encode]])
    res = pd.concat([original_dataframe, dummies], axis=1)
    res = res.drop([feature_to_encode], axis=1)
    return(res)
features_to_encode = ["stĺpec1", "stĺpec2", "stĺpec3"]
for feature in features_to_encode:
df_categorical = encode_and_bind(df_categorical, feature)Takže sme konečne dokončili spracovanie kvalitných a kvantitatívnych údajov osobitne — čas ich skombinovať späť
new_df = pd.concat([df_numerical, df_categorical], axis=1)Po tom, čo sme spojili datasety do jedného, môžeme nakoniec využiť transformáciu údajov pomocou MinMaxScaler z knižnice sklearn. To urobí naše hodnoty v rozsahu od 0 do 1, čo pomôže pri trénovaní modelu v budúcnosti.
from sklearn.preprocessing import MinMaxScaler
min_max_scaler = MinMaxScaler()
new_df = min_max_scaler.fit_transform(new_df)
Tieto údaje sú teraz pripravené na všetko — na neurónové siete, štandardné algoritmy ML a pod!
V tomto článku sme nezohľadnili prácu s údajmi týkajúcimi sa časových radov, pretože na takéto údaje by sa mali používať trochu iné techniky spracovania v závislosti od vašej úlohy. V budúcnosti sa náš tím tejto téme venuje v samostatnom článku a dúfame, že môže priniesť do vášho života niečo zaujímavé, nové a užitočné, rovnako ako tento článok.
Zdroj: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish