

Capacity Tier (alebo ako ho nazývame u nás vo vime — kaptir) sa objavil už za čias Veeam Backup and Replication 9.5 Update 4 pod menom Archive Tier. Myšlienka, ktorá za ním stojí, je umožniť presun podpory, ktoré vypadli z takzvaného operačného okna obnovy, do objektových úložísk. To pomáhalo uvoľniť miesto na disku tým používateľom, ktorí ho mali málo. Táto možnosť sa nazýva Move Mode.
Na vykonanie tohto jednoduchého (ako sa zdá) úkonu stačilo splniť dve podmienky: všetky body presúvaného zálohovania museli byť mimo vyššie uvedeného operačného okna obnovy, ktoré je zadané výslovne v UI. A druhá: reťazec musí byť v takzvanom „pečatnom stave“ (sealed backup chain alebo Inactive Backup Chain). To znamená, že v priebehu času v tejto reťazi nedochádza k zmenám.
Ale vo VBR v10 sa koncept doplnil o nové funkcie — objavil sa Copy Mode, Sealed Mode a vec so zložitým názvom Immutability.
O týchto fascinujúcich veciach budeme dnes hovoriť. Najprv o tom, ako to fungovalo vo VBR9.5u4, a potom o zmenách v desiatej verzii.
A nech ma zbavia kritici čistého jazyka, ale príliš veľa termínov nemožno preložiť.
Takže tu bude množstvo anglicizmov.
A veľa gifiek.
A obrázkov.
- Bez akýchkoľvek ľutovaní. Autor článku.
Ako bolo
Takže začnime analýzou operačného okna obnovy a sealed backup (alebo ako sa nazývajú v dokumentácii Inactive Backup Chain). Bez ich porozumenia nemôžeme vysvetliť ďalej.
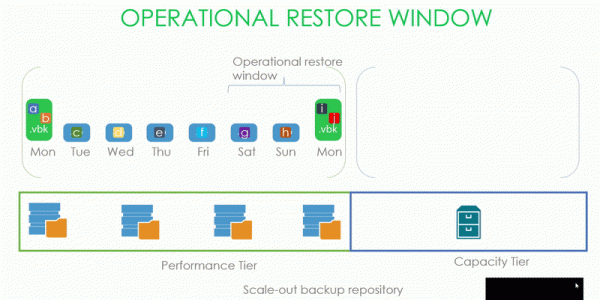
Ako vidíme na obrázku, máme nejaký zálohovací reťazec s blokmi údajov, ktorý sa nachádza na Performance tier SOBR repositára, ku ktorému je pripojený Capacity Tier. Naše okno operačnej zálohy trvá tri dni.
V súlade s tým, víkendový .vbk uzatvára predchádzajúci reťazec, ktorého okno je nastavené na tri dni. A tak môžeme bez obáv začať presúvať do kapacity tier všetko, čo je staršie ako tieto tri dni.
Ale čo presne sa rozumelo pod sealed reťazcom a čo sa mohlo poslať do kapacity tier v update 4?
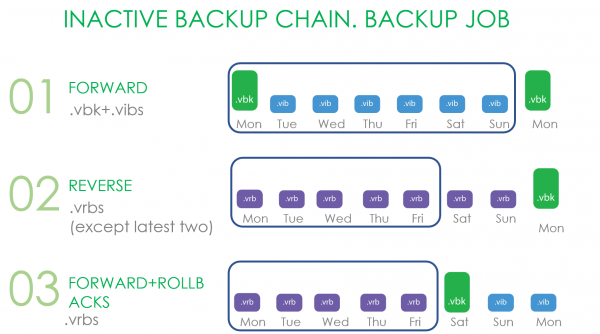
Pre Forward Incremental je znakom pečatenia reťazca vytvorenie novej plnej zálohy. A nezáleží na tom, ako sa táto plná záloha vytvára: berú sa do úvahy syntetické a aktívne plné zálohy.
V prípade Reverse sú to všetky súbory, ktoré sa nedostávajú do operačného okna.
V prípade Forward increment s rollbackmi ide o všetky rollbacky a .vbk, ak na performance extent existuje ďalší .vbk.
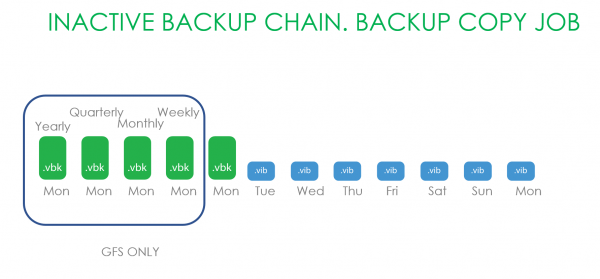
Teraz sa pozrime na možnosť práce s reťazcami Backup Copy. Tu sa odosielali len tie, ktoré spadali pod GFS retention. Pretože všetko, čo sa nachádza v novších reťazcoch backup copy, môže byť rôznym spôsobom upravené.
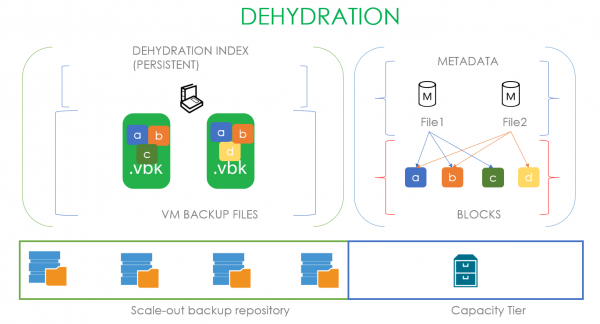
Teraz nahliadnime pod kapotu. Tam prebieha proces nazývaný dehydratácia — ponechanie prázdnych backupných súborov na extent a presúvanie blokov z týchto súborov do kapacity tier. Na optimalizáciu tohto procesu sa používa takzvaný index dehydratácie, ktorý umožňuje nekopírovať bloky, ktoré už boli skopírované do kapacity tier.
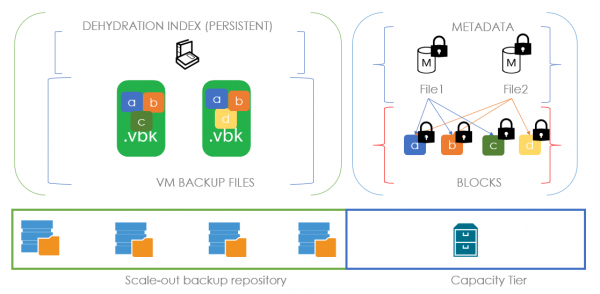
Pozrime sa, ako to vyzerá na príklade: predpokladajme, že máme .vbk, ktorý vyšiel z operačného okna a patrí uzamknutému reťazcu. To znamená, že máme úplné právo presunúť ho do kapacity tier. V momente presunu sa vytvorí súbor metadát v kapacite tier a bloky presúvaného súboru. V súbore metadát na úrovni odkazov je popísané, z akých blokov sa náš súbor skladá. V prípade na obrázku náš prvý súbor pozostáva z blokov a, b, c a v metadátach sú umiestnené odkazy na tieto bloky. Keď sa objaví druhý .vbk súbor, pripravený na presun a pozostávajúci z blokov a, b a d, analyzujeme index dehydratácie a chápeme, že presúvať treba len blok d. A jeho súbor metadát bude obsahovať odkazy na dva predchádzajúce bloky a jeden nový.
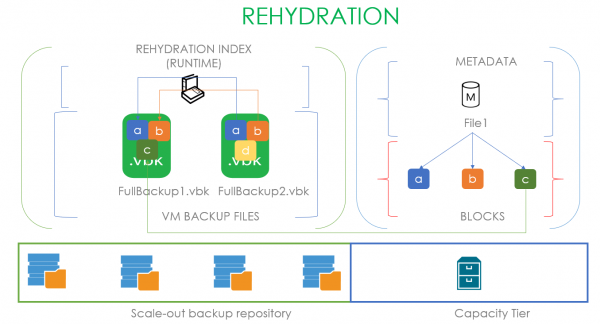
Zodpovedajúco, proces spätného naplnenia týchto prázdnych miest dátami sa nazýva rehydratácia. Tu sa už používa svoj index rehydratácie, ktorý sa opiera o najstarší .vbk súbor na lokálnom performance extent. To znamená, že ak chce používateľ vrátiť súbor z kapacity tier, najprv vytvoríme index blokov najstaršieho kompletného backupu a presúvame z kapacity tier len chýbajúce bloky. V prípade, ktorý je znázornený na obrázku, aby sme rehydratovali FullBackup1.vbk podľa indexu rehydratácie, chýba nám len blok C, ktorý si berieme z kapacity tier. Ak ako kapacitu tier vystupuje cloudový objektový storage, umožňuje to ušetriť obrovské peniaze.
Môže sa zdať, že táto technológia je identická s tou, ktorá sa používa v WAN akcelerátoroch, ale to je len zdanie. V akcelerátoroch je deduplikácia globálna, zatiaľ čo tu sa používa lokálna v rámci každého súboru podľa určitého offsetu. To je spôsobené rozdielom v riešených úlohách: tu musíme kopírovať veľké súbory plných záloh a podľa našich štúdií, aj keď medzi nimi prejde dlhý čas, takýto algoritmus deduplikácie poskytuje lepšie výsledky.
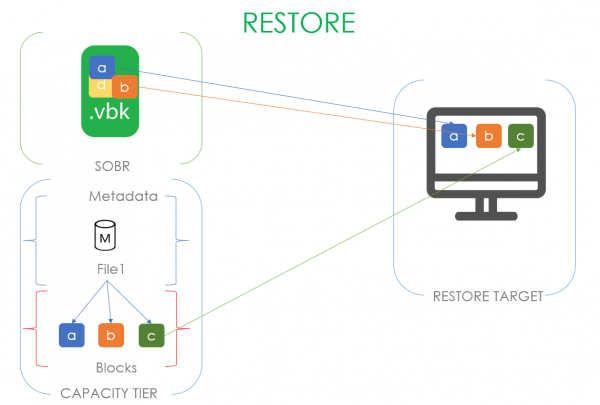
Ale viac indexov bohu indexov! Existuje ešte aj index na obnovenie údajov! Keď spustíme obnovenie stroja umiestneného v kapacitnom tire, čítame iba unikátne bloky údajov, ktoré nie sú v výkonovom tire.
Ako sa ukazuje
Na tomto sa s úvodnou časťou všetko končí. Je pomerne podrobná, ale, ako bolo uvedené vyššie, bez týchto podrobností nie je možné vysvetliť, ako fungujú nové funkcie. Preto sa bez zbytočných predslovov presuňme k prvej.
Režim kopírovania
Z veľkej časti je založený na existujúcich technológiach, avšak nesie so sebou úplne odlišnú logiku používania.
Cieľom tohto režimu je zabezpečiť, aby všetky údaje umiestnené na lokálnom extentu mali kópiu v kapacitnom tire.
Ak porovnáme režimy Move a Copy, vyjde to takto:
- Presúvať možno iba uzavreté reťazce. V prípade režimu kopírovania sa odvezie úplne všetko, nezávisle od toho, čo sa deje v záložnej úlohe.
- Presunutie nastane, keď súbory prekročia hranice okna operatívnej zálohy, zatiaľ čo kopírovanie sa aktivuje okamžite, hneď ako sa objaví záložný súbor.
- Sledovanie nových údajov na kopírovanie prebieha neustále, zatiaľ čo presúvanie sa spúšťalo raz za 4 hodiny.
Pri zvažovaní nového režimu navrhujem ísť od jednoduchých príkladov k zložitým.
V najzákladnejšom prípade sa jednoducho objavujú nové súbory s inkrementmi a my ich jednoducho kopírujeme do kapacitného tire. Bez ohľadu na to, aký režim sa používa v záložnej úlohe, bez ohľadu na to, či patrí k uzavretej časti reťazca alebo nie, bez ohľadu na to, či vypršalo naše operatívne okno. Jednoducho sme vzali a skopírovali.
Процесс, стоящий за этим — это по-прежнему дегидрация в том виде, как было описано выше. В копи режиме она также следит, чтобы мы не копировали блоки, которые уже есть на нашем сторадже. Единственное отличие — это если в мув режиме мы заменяли реальные файлы файлами пустышками, то здесь мы их никак не трогаем и оставляем всё как есть. В остальном это ровно такой же индекс дегидрации, который тщательно старается экономить ваши деньги и время.
Возникает вопрос — если посмотреть в UI, то там есть возможность выбрать обе опции одновременно. Как будет работать такой совмещённый режим?
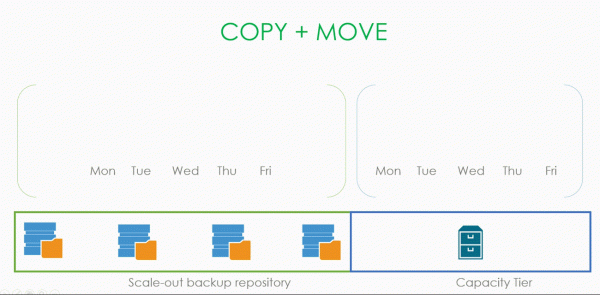
Poďme sa na to pozrieť.
Начало стандартное: создаётся файл бекапа и сразу копируется. К нему создаётся инкремент и тоже копируется. Так происходит до момента, когда мы понимаем, что файлы вышли из нашего операционного окна и появилась запечатанная цепочка. В этот момент мы выполняем операцию дегидрации и замещаем эти файлы пустышками. Само собой, повторно на капасити тир ничего не копируем.
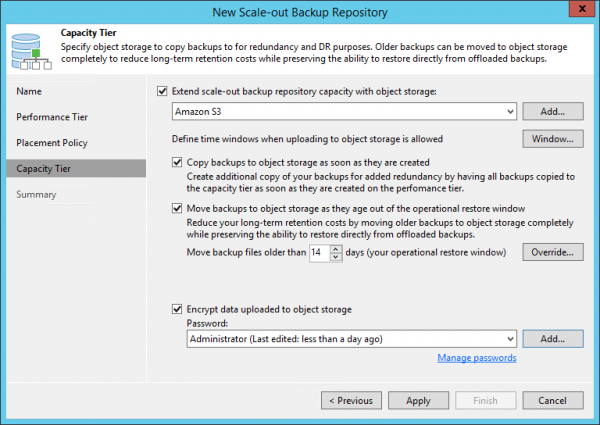
За всю эту увлекательную логику отвечает всего лишь одна галочка в интерфейсе: Copy backups to object storage as soon as they are created.
А зачем нам этот Copy режим?
Даже лучше перефразировать вопрос так — от каких рисков мы защищаемся с его помощью? Какую проблему он помогает нам решать?
Ответ очевиден: конечно же, это восстановление данных. Если у нас на обжект сторадже есть полная копия локальных данных, то неважно, что случится с нашим продом, мы всегда можем восстановить данные с файлов, расположенных в условном амазоне.
Поэтому давайте пройдёмся по возможным сценариям, от наиболее простого к более сложным.
Самая простая напасть, которая может свалиться на наши головы — это недоступность одного из файлов в бекапной цепочке.
Более печальная история — у нас сломался один из экстентов нашего SOBR репозитория.
Ещё хуже становится, когда весь SOBR репозиторий стал недоступен, но работает капасити тир.
И совсем всё плохо — это когда умирает бекапный сервер и твоё первое желание — попробовать добежать до канадской границы за десять минут.
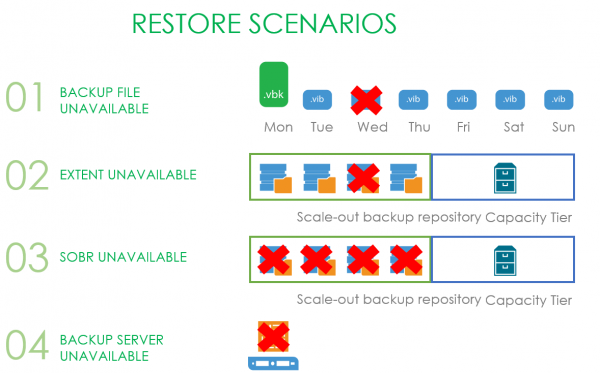
А теперь давайте разберём каждую ситуацию отдельно.
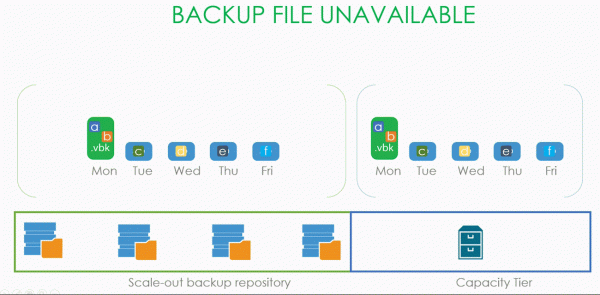
Keď stratíme jeden (a aj niekoľko) záložných súborov, stačí spustiť proces preskenujúci repozitár a stratený súbor bude nahradený prázdnym súborom. A pomocou procesu rehydratácie (o ktorom sme hovorili na začiatku článku) si používateľ môže stiahnuť dáta z kapacitného úložiska do miestneho úložiska.
Teraz je situácia zložitejšia. Predpokladajme, že našu SOBR tvoria dva extenzory, ktoré pracujú v režime výkonu, a teda naše .vbk a .vib sú rozložené po nich dosť nerovnomerne. A v nejakom okamihu jeden z extenzorov prestane fungovať a používateľ potrebuje urgentne obnoviť stroj, ktorého časť dát leží práve na tomto extenzore.
Používateľ spustí sprievodcu obnovou, vyberie bod, na ktorý chce obnoviť, a sprievodca počas práce zistí, že všetky potrebné dáta na obnovu nemá lokálne, a preto ich treba stiahnuť z kapacitného úložiska. Pri tom bloky, ktoré zostali na miestnom úložisku, sa sťahovať z cloudu nebudú. Nech žije restore index (áno, o ňom sme tiež hovorili na začiatku článku).
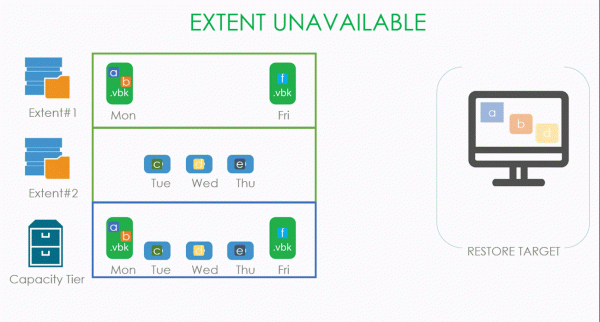
Podtyp tohto prípadu je, keď je celý SOBR repozitár nedostupný. V takom prípade nemáme čo kopírovať z miestnych úložísk, a všetky bloky sa stiahnu z cloudu.
A najzaujímavejšia situácia je, keď zomrie zálohovací server. Tu sú dve možnosti: admin bol šikovný a robil konfiguračné zálohy, a admin sám sebe zlý Buratino a nerobil konfiguračnú zálohu.
V prvom prípade mu bude stačiť jednoducho niekde spustiť čistú inštaláciu VBR a obnoviť jeho databázu zo zálohy štandardnými prostriedkami. Na konci tohto procesu sa všetko vráti do normálu. Alebo sa obnoví podľa jedného z vyššie uvedených scenárov.
Ak však administrátor alebo sám sebe nepriateľ, alebo aj záloha konfigurácie postihla mýtická neúspěch, ani v takomto prípade ho nenecháme napospas osudu. Pre tento prípad sme zaviedli novú procedúru, ktorá sa volá Import Object Storage. Umožňuje obísť proces manuálneho obnovenia SOBR úložiska a jeho pripojenia k kapacite, a namiesto toho jednoducho pridať objektové úložisko do rozhrania Vima a spustiť procedúru Import Storage Repository. Jediné, čo môže stáť medzi vami a vašimi zálohami, je požiadavka zadať heslo, ak boli vaše zálohy šifrované.
Na tomto sme o móde Copy Mode a prechádzame k
Sealed Mode
Hlavná myšlienka je taká, že na vybranom rozsahu SOBR úložiska sa nemôžu objavovať nové zálohy. Do verzie 10 sme mali iba Maintenance Mode, ktorý úplne zakazoval akúkoľvek činnosť s úložiskom. Akýsi hardcore režim vypnutia úložiska, kde bola dostupná len tlačidlo Evacuate, ktorá raz prevážala zálohy na iný rozsah.
A Sealed Mode je akási „jemná“ alternatíva: zakazujeme vytváranie nových záloh a postupne odstraňujeme staré podľa zvoleného retenčného obdobia, ale počas procesu nestrácame možnosť obnovovať sa z uchovávaných bodov. Veľmi užitočná vec, keď sa nám buď končí životnosť zariadenia a je potrebné ho vymeniť, alebo ho jednoducho treba uvoľniť pre niečo dôležitejšie, a niet kam všetko raz preniesť. Alebo ho nemožno odstrániť.
Princíp činnosti je teda pomerne jednoduchý: je potrebné zakázať všetky operácie zápisu (objavovanie nových dát), pričom si ponechávanie čítania (obnovenia) a mazania (retenčného obdobia).
Obe režimy je možné používať súčasne, ale treba mať na pamäti, že údržba má vyššiu prioritu.
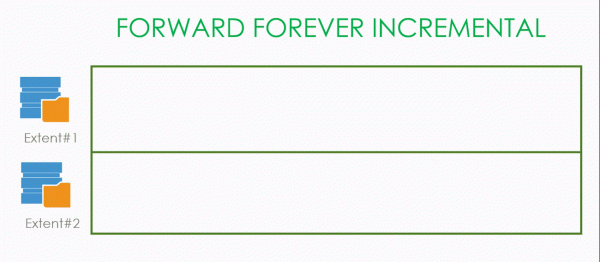
Ako príklad si vezmime SOBR, ktorý sa skladá z dvoch rozsahov. Predpokladajme, že prvé štyri dni sme vytvárali zálohy v režime Forward Forever Incremental, a potom sme rozsah uzavreli. To vedie k tomu, že iniciujeme vytvorenie nového aktívneho plného na druhom dostupnom rozsahu. Ak je náš retenčný čas štyri, potom keď celý reťazec umiestnený na uzavretom rozsahu presiahne jeho hranice, môže byť s čistým svedomím odstránený.
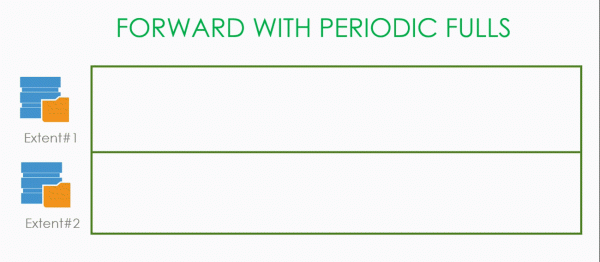
Existujú situácie, keď sa odstránenie uskutoční skôr. Napríklad, ide o Forward incremental s periodickými full backupmi. Ak sa počas prvých dvoch dní vytvorili full backupy a vo štvrtok sa rozhodneme uzavrieť repozitár, tak v piatok, keď sa vytvorí nový full backup, súbor z pondelka bude odstránený, pretože k tomuto bodu nie sú žiadne závislosti. A samotný bod nie je závislý na nikom. Potom čakáme, kým sa vytvorí štyri body na dostupnom extente a odstránime zostávajúce tri, ktoré nemôžu byť odstránené nezávisle jedno od druhého.
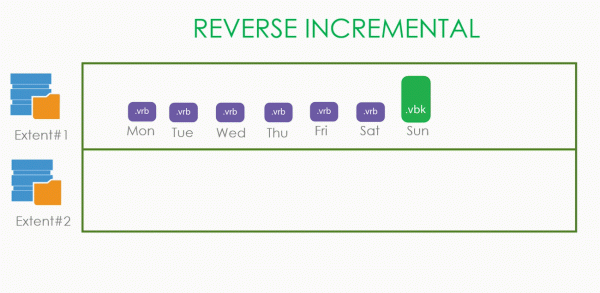
S Reverse Incremental je to jednoduchšie. V ňom najstaršie body nie sú na nič závislé a môžu byť v pokoji odstránené. Preto, akonáhle je vytvorený nový .vbk na novom extente, staré .vrb budú postupne odstraňované.
Mimochodom, prečo každý raz vytvárame nový .vbk: ak by sa nevytváral, ale pokračovalo by sa v starej reťazci inkrementov, starý .vbk by visel nekonečne dlho v akomkoľvek režime, čo by bránilo jeho odstráneniu. Preto sa rozhodlo, že akonáhle je extente uzavreté, vytvárame full backup na voľnom extente.
Zložitejšie je to s capacity tier.
Skôr skontrolujme copy mode. Predpokladajme, že sme štyri dni aktívne vytvárali backupy a potom bol capacity tier uzavretý. Nič neodstraňujeme, ale trpezlivo držíme retention, po čom odstránime údaje z capacity tier.
Približne to isté sa deje pri move mode — čakaním na retention, odstránime staré v lokálnom úložisku a údaje uložené v object storage.
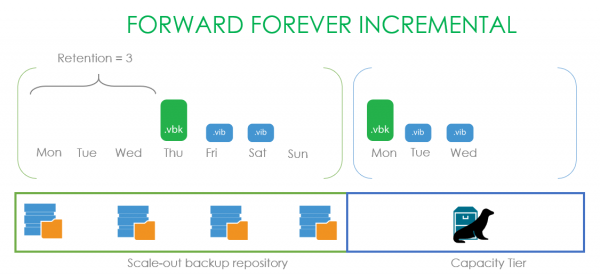
Zaujímavý príklad s Forever forward incremental. Nastavíme retention na tri body a začneme v pondelok robiť backupy, ktoré sa spoľahlivo kopírujú do cloudu. Po uzavretí úložiska sa backupy naďalej vytvárajú, dodržiavajúc tri body, ale údaje uložené v capacity tier zostávajú závislé a nemôžu byť odstránené. Preto čakáme na štvrtok, keď náš .vbk prekročí rámce retention, a až potom pokojne odstránime celú uloženú reťaz.
A malá poznámka: všetky príklady sú ukázané s jedným strojom. Ak máte vo backup-e viacero, retention sa bude líšiť v závislosti od toho, či bol vykonaný Active Full alebo nie.
Na tom, v podstate, je všetko. Takže prejdeme k najhardcore funkcii —
Immutability
Ako pri predchádzajúcich bodoch, prvé, o čom hovoríme, je problém, ktorý táto funkcia rieši. Akonáhle uvoľníme naše zálohy na uchovávanie, vzniká silná chuť zabezpečiť ich ochranu, teda fyzicky zabrániť ich odstráneniu a akýmkoľvek úpravám počas stanoveného retentionu. To zahŕňa aj správcov, aj pod ich root účtami. To umožňuje chrániť ich pred náhodným alebo úmyselným poškodením. Tí, ktorí pracujú s AWS, mohli naraziť na podobnú funkciu nazvanú Object Lock.
Teraz sa pozrime na režim v obecných slovách a potom sa prehĺbime do detailov. V našom príklade bude Immutability zapnuté pre náš kapacitu s retentionom štyri dni. A v zálohe je zapnutý režim Copy.
Immutability nijako neinteraguje s celkovým retentionom. Napríklad, nepridáva dodatočné body alebo niečo také. Počas štyroch dní nemôže osoba odstrániť súbory záloh. Ak sa v pondelok vykoná záloha, súbor sa dá odstrániť až v piatok.
Všetky predtým vysvetlené koncepty dehydratácie, indexov a metadát fungujú presne tak istým spôsobom. Ale s jednou podmienkou — blok sa vystavuje nielen pre dáta, ale aj pre metadáta. To sa robí pre prípad, že záludný útočník sa rozhodne vymazať našu databázu metadát, a aby bloky s dátami sa nezmenili na bezcennú binárnu kašu.
A teraz nastal skvelý moment na vysvetlenie našej technológie generovania blokov. Alebo block generation. Na to si predstavíme situáciu, ktorá k jej vzniku viedla.
Zoberme si časovú os s šiestimi dňami a zdola budeme zaznamenávať čas očakávaného vypršania immutability. V prvý deň vytvoríme súbor, ktorý pozostáva z bloku a a jeho metadát. Ak je immutability nastavené na tri dni, logicky by sa dalo predpokladať, že štvrtý deň budú dáta odomknuté a odstránené. Na druhý deň pridáme nový file2, pozostávajúci z bloku b s rovnakými nastaveniami. Blok a by mal byť stále odstránený na štvrtý deň. Ale na tretí deň sa stane niečo hrozné — vytvorí sa súbor File3, ktorý obsahuje nový blok d a odkaz na starý blok a. To znamená, že pre blok a by mal byť jeho flag immutability resetovaný na nový časový rámec, ktorý sa posúva na šiesty deň. A tu nastáva problém — v reálnych zálohe týchto blokov vzniká obrovské množstvo. A aby sme im predĺžili obdobie immutability, musíme zakaždým uskutočniť obrovské množstvo požiadaviek. A v skutočnosti by to bol takmer nekonečný denný proces, pretože s veľkou pravdepodobnosťou pri každom kopírovaní budeme nachádzať veľké balíky deduplikovaných blokov. A čo znamená veľké množstvo požiadaviek od poskytovateľov object storage? Presne! Obrovský účet na konci mesiaca.
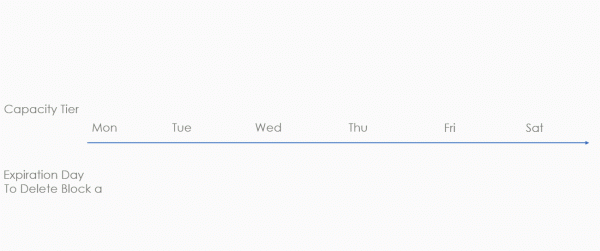
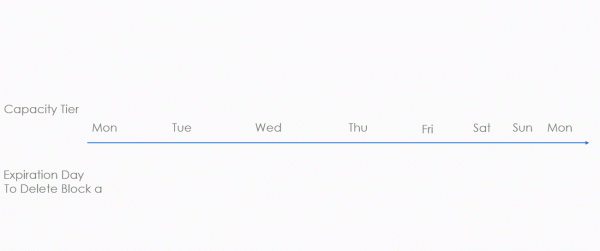
A aby sme neúčtovali za slobodné peniaze svojim obľúbeným klientom, bol vymyslený mechanizmus block generation. Toto je dodatočné obdobie, ktoré pridávame k stanovenému obdobiu immutability. V nižšie uvedenom príklade toto obdobie trvá dva dni. Ale to je len na príklad. V skutočnosti tam používajú svoju vlastnú formulu, ktorá dáva približne desať ďalších dní pri mesačnom locku.
Pokračujme s rovnakou situáciou, ale už s generovaním blokov. V prvý deň vytvárame file1 z bloku a a metadát. Sčítame obdobie generácií a immutability — to znamená, že možnosť odstrániť súbor bude na šiesty deň. Ak v druhý deň vytvoríme File2, ktorý bude obsahovať blok b a odkaz na blok a, predpokladaný dátum odstránenia sa nezmení. Ten ostáva na šiesty deň. Snažíme sa týmto spôsobom šetriť peniaze na počte požiadaviek. Jediná situácia, kedy môže byť termín posunutý, je, ak vypršalo obdobie generácie. Teda, ak na tretí deň nový File3 bude obsahovať odkaz na blok a, tak sa pridá generácia 2, pretože Gen1 už vypršalo. Očakávaný dátum odstránenia bloku a sa presunie na ôsmy deň. To nám umožňuje dramaticky znížiť počet požiadaviek na predĺženie životnosti deduplikovaných blokov, čo šetrí veľa peňazí klientom.
Samotná technológia je dostupná používateľom S3 a S3-kompatibilného hardvéru, ktorého výrobcovia zaručujú, že ich implementácia sa nelíši od amazonovej. Odtiaľ pramení odpoveď na legitímnu otázku, prečo nie je podporovaný Azure — majú podobnú funkciu, ale funguje na úrovni kontajnerov, nie jednotlivých objektov. Mimochodom, v samotnom Amazone existuje objekt lock v dvoch režimoch: compliance a governance. V druhom prípade zostáva možnosť, aby najväčší admin nad adminmi a root nad rootmi, napriek objekt locku, predsa len odstránil dáta. V prípade compliance je všetko pripevnené klincami a zálohy nemôže odstrániť nikto. Ani admini z Amazonu (podľa ich oficiálnych vyhlásení). My podporujeme práve tento režim.
A tradične, trochu užitočných odkazov:
- O vo všetkých podrobnostiach.
- Všetky informácie o v najlepšej podobe
- O v detailoch
Zdroj: habr.com
