

Dnes existuje množstvo kurzov Data Science a už dávno je známe, že najviac peňazí v Data Science možno zarobiť práve predajom kurzov zameraných na Data Science (prečo kopať, keď môžete predávať lopaty?). Hlavným nedostatkom týchto kurzov je, že nemajú nič spoločné so skutočnou prácou: nikto vám nedá čisté, spracované dáta v potrebnom formáte. A keď vyjdete z kurzov a začnete riešiť skutočný problém, objaví sa veľa nuáns.
Preto začíname sériu článkov „Čo sa môže pokaziť pri Data Science“, založených na skutočných udalostiach, ktoré sa stali mne, mojim priateľom a kolegom. Budeme rozoberať na reálnych príkladoch typické úlohy v Data Science: ako to naozaj prebieha. Dnes začneme úlohou zberu dát.
A prvé, o čo sa ľudia pri práci so skutočnými dátami zakopnú, je samotný zber týchto relevantných dát. Kľúčový posolstvo tohto článku:
Systémovo podceňujeme čas, zdroje a úsilie potrebné na zber, čistenie a prípravu dát.
A najdôležitejšie, prediskutujeme, čo robiť, aby sme tomu predišli.
Podľa rôznych odhadov, čistenie, transformácia, spracovanie dát, inžiniering funkcií atď. zaberajú 80-90 % času, kým analýza 10-20 %, pričom takmer celý výukový materiál sa sústreďuje výhradne na analýzu.
Poďme si rozobrať jednoduchú analytickú úlohu v troch variantoch a uvidíme, aké môžu byť „znepokojujúce okolnosti“.
A opäť ako príklad, zvážime podobné variácie úlohy zberu dát a porovnania komunít pre:
- Dve subredditové komunity Reddit
- Dve sekcie Habr
- Dve skupiny na Odnoklassniki
Podmienečný prístup v teórii
Otvoríte stránku a prečítate si príklady, ak je to zrozumiteľné, vyhraďte si niekoľko hodín na čítanie, niekoľko hodín na kód podľa príkladov a ladenie. Pridať niekoľko hodín na zber. Pridať niekoľko hodín pre rezervu (násobiť dvoma a pridať N hodín).
Kľúčový moment: časový odhad je založený na predpokladoch a domnienkach o tom, koľko to bude trvať.
Začať analýzu času je potrebné s hodnotením nasledujúcich parametrov pre podmienečnú úlohu, opísanú vyššie:
- Aká je veľkosť dát a koľko sa ich musí fyzicky zbierať (*pozri nižšie*).
- Aký čas trvá zber jednej položky a koľko treba čakať, než sa dá získať druhá.
- Zaviesť písanie kódu, ktorý uchováva stav a začína reštart, keď (a nie ak) všetko zlyhá.
- Zistiť, či potrebujeme autorizáciu a zohľadniť čas potrebný na získanie prístupu cez API.
- Zohľadniť počet chýb ako funkciu zložitosti dát – posúdiť na základe konkrétnej úlohy: štruktúra, koľko transformácií, čo a ako extrahujeme.
- Zohľadniť chyby siete a problémy s netradičným správaním projektu.
- Posúdiť, či sú potrebné funkcie v dokumentácii, a ak nie, tak ako a koľko potrebujeme na workaround.
Najdôležitejšie je, že na posúdenie času – skutočne musíte stráviť čas a úsilie na „prieskum terénu“ – len tak bude vaše plánovanie adekvátne. Preto, nech vás akokoľvek tlačia povedať „koľko času treba na zber dát“ – vyžiadajte si čas na predbežnú analýzu a odôvodnite to tým, aké sa budú časové odhady líšiť v závislosti od skutočných parametrov úlohy.
A teraz predvedieme konkrétne príklady, kde sa takéto parametre budú meniť.
Kľúčový bod: posúdenie je založené na analýze kľúčových faktorov, ktoré ovplyvňujú objem a zložitost práce.
Posúdenie založené na domnienkach – to je dobrý prístup, keď sú funkčné prvky dostatočne malé a nie je veľa faktorov, ktoré môžu významne ovplyvniť štruktúru úlohy. Ale v prípade niektorých úloh Data Science je týchto faktorov veľmi veľa a takýto prístup sa stáva neadekvátnym.
Porovnanie komunít Reddit
Začneme s najjednoduchším prípadom (ako sa ukáže neskôr). V skutočnosti, ak máme byť úprimní, ide o takmer ideálny prípad; skontrolujeme náš checklist zložitosti:
- Existuje upravené, jasne označené a zdokumentované API.
- Veľmi jednoducho a hlavne automaticky sa získa token.
- Existuje – s množstvom príkladov.
- Komunita, ktorá sa zaoberá analýzou a zbieraním dát na Reddite (až po youtube videá vysvetľujúce, ako používať python wrapper) .
- Potrebné metódy pravdepodobne existujú v API. Okrem toho, kód vyzerá kompaktne a čisto, nižšie je príklad funkcie, ktorá zbiera komentáre k príspevku.
def get_comments(submission_id):
    reddit = Reddit(check_for_updates=False, user_agent=AGENT)
    submission = reddit.submission(id=submission_id)
    more_comments = submission.comments.replace_more()
    if more_comments:
        skipped_comments = sum(x.count for x in more_comments)
        logger.debug('Skipped %d MoreComments (%d comments)',
                     len(more_comments), skipped_comments)
    return submission.comments.list()
Prevzaté z výberu užitočných nástrojov na zabalenie.
Aj keď tu máme najlepší možný scenár, je potrebné zvážiť niekoľko dôležitých faktorov z reálneho života:
- Limity API — sme nútení získať údaje v dávkach (pauzy medzi požiadavkami atď.).
- Čas zberu — pre úplnú analýzu a porovnanie treba uviesť dostatočný čas, len aby spider prešiel subreddit.
- Bot musí bežať na serveri — nemôžete ho jednoducho spustiť na laptope, dať do batohu a ísť na záležitosti. Z tohto dôvodu som všetko spustil na VPS. S promo kódom habrahabr10 môžete ušetriť ďalších 10 % z ceny.
- Fyzická nedostupnosť niektorých údajov (sú viditeľné pre administrátorov alebo sú príliš ťažko získateľné) — to treba zohľadniť, nie všetky údaje je možné získať v rozumnom čase.
- Chyby práce sieťou: práca so sieťou je bolesť.
- Toto sú živé reálne údaje — nie sú úplne čisté.
Samozrejme, je potrebné zohľadniť uvedené nuansy vo vývoji. Konkrétne hodiny/deń sú závislé na skúsenostiach s vývojom alebo s podobnými úlohami, napriek tomu vidíme, že úloha je čisto inžinierska a nevyžaduje ďalšie pohyby na jej riešenie — všetko sa dá veľmi dobre oceniť, naplánovať a vykonať.
Porovnanie sekcií Habr
Prejdime k zaujímavejšiemu a netradičnému prípadu porovnania prúdov a/alebo sekcií Habr.
Skontrolujeme náš checklist zložitosti — tu, aby sme pochopili každý bod, bude potrebné trochu sa v úlohe pohrať a experimentovať.
- Najprv si myslíte, že existuje API, ale nie je. Áno, áno, Habr má API, ale len nie je prístupné pre používateľov (alebo možno vôbec nefunguje).
- Potom jednoducho začnete spracovávať html — „import requests“, čo by sa mohlo pokaziť?
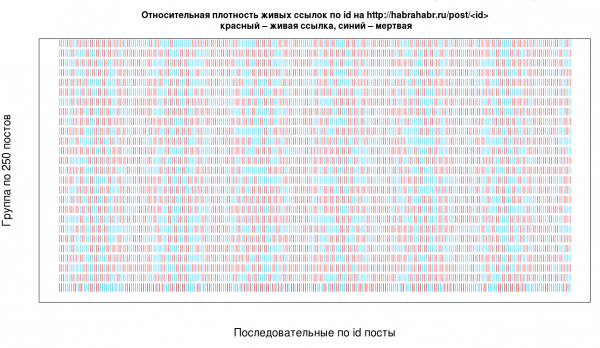
- A ako vlastne spracovávať? Najjednoduchší a často používaný prístup je iterovať podľa ID, čo potrebujeme poznamenať, že nie je najefektívnejší a budete musieť spracovať rôzne prípady — napríklad hustota reálnych ID medzi všetkými existujúcimi.

Prevzaté z článok. - Nepripravené dáta zabalené v HTML na sieti sú problémom. Napríklad, chcete zozbierať a uložiť hodnotenie článku: vytiahli ste score z HTML a rozhodli ste sa ho uložiť ako číslo na ďalšie spracovanie:
1) int(score) vyhodí chybu: pretože na Habré je mínus, ako v riadku "–5" — to je krátka pomlčka, nie znamienko mínus (prekvapujúce, že?), preto v určitom okamihu bola potrebná obnova parsera s takýmto hrozným fixom.
try:
      score_txt = post.find(class_="score").text.replace(u"–","-").replace(u"+","+")
      score = int(score_txt)
      if check_date(date):
        post_score += score
Dátumy, plusy a mínusy nemusia vôbec existovať (ako vidíme vyššie vo funkcii check_date a to sa stalo).
2) Neescapované špeciálne znaky — prídu, musíte byť pripravení.
3) Štruktúra sa mení v závislosti od typu príspevku.
4) Staré príspevky môžu mať **podivnú štruktúru**.
- V podstate spracovanie chýb a toho, čo môže alebo nemôže nastať, musíte spracovať a nie je možné presne predpovedať, čo sa stane zle a aká môže byť štruktúra a čo kde môže zlyhať — budete musieť len skúšať a zohľadniť chyby, ktoré parser vyhodí.
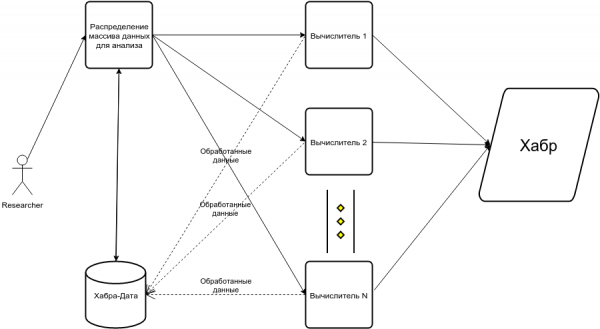
- Potom si uvedomíte, že potrebujete parsovať vo viacerých vláknach, inak parsovanie v jednom vlákne zaberie 30+ hodín (to je čistý čas vykonania už funkčného jednovláknového parsera, ktorý spí a nie je pod žiadnymi banmi). V článku to v určitom okamihu viedlo k podobnej schéme:
Takže checklist zložitosti:
- Práca so sieťou a parsovanie HTML s iteráciou a prehľadávaním podľa ID.
- Dokumenty sú heterogénne.
- Mnoho miest, kde môže kód ľahko zlyhať.
- Je potrebné písať || kód.
- Chýba potrebná dokumentácia, príklady kódu a\/alebo komunita.
Podmienečné ohodnotenie času na túto úlohu bude 3-5 krát vyššie, než na zber dát z Redditu.
Porovnanie skupín Odnoklassniki
Prejdeme k technicky najzaujímavejšiemu prípadu z tých, ktoré sú popísané. Pre mňa bol zaujímavý práve tým, že na prvý pohľad vyzerá pomerne triviálne, ale vôbec také nie je — akonáhle do neho šťuknete palicou.
Začneme naším checklistom zložitosti a uvedomíme si, že mnohé z nich sa ukážu byť oveľa zložitejšie, než sa na prvý pohľad zdajú:
- API je, ale takmer úplne chýbajú potrebné funkcie.
- Na určité funkcie je potrebné žiadať o prístup cez e-mail, teda vydanie prístupu nie je okamžité.
- Je to hrozne zdokumentované (začneme tým, že sa všade miešajú ruské a anglické pojmy, pričom úplne nekonzistentne — niekedy si musíte len hádať, čo od vás niekde chcú) a, navyše, nie je vhodné designovo na získanie údajov, napríklad, .
- Vyžaduje dokumentáciu o sedení, ale v skutočnosti ju nepoužíva — a niet žiadneho spôsobu, ako pochopiť všetky nuansy režimov API, okrem toho, že sa len na niečo kliká a dúfa, že niečo bude fungovať.
- Chýbajú príklady a komunita, jediný bod podpory pri zbere informácií — malý v Pythone (bez veľkého množstva príkladov použitia).
- Najúspešnejšia možnosť sa zdá byť Selenium, pretože mnohé potrebné údaje sú zamknuté.
1) To znamená, že sa vykonáva autorizácia cez fiktívneho používateľa (a manuálnu registráciu).2) Avšak so Selenom niet žiadnych záruk správnej a opakovateľnej funkcie (aspoň v prípade ok.ru určite).
3) Stránka Ok.ru obsahuje chyby JavaScriptu a niekedy sa správa zvláštne a nekonzistentne.
4) Je potrebné venovať sa paginácii, načítavaniu prvkov atď…
5) Chyby API, ktoré wrapper vracia, bude potrebné ošetrovať nepriamo, napríklad takto (kus experimentálneho kódu):
def get_comments(args, context, discussions):
    pause = 1
    if args.extract_comments:
        all_comments = set()
#makes sense to keep track of already processed discussions
        for discussion in tqdm(discussions):
            try:
                comments = get_comments_from_discussion_via_api(context, discussion)
            except odnoklassniki.api.OdnoklassnikiError as e:
                if "NOT_FOUND" in str(e):
                    comments = set()
                else:
                    print(e)
                    bp()
                    pass
            all_comments |= comments
            time.sleep(pause)
        return all_comments
Moja obľúbená chyba bola:
OdnoklassnikiError("Error(code: 'None', description: 'HTTP error', method: 'discussions.getComments', params: …)")6) Nakoniec sa kombinácia Selenium + API javí ako najrozumnejšia alternatíva.
- Je potrebné uchovať stav a reštartovať systém, spracovať množstvo chýb, vrátane nekonzistentného správania stránky — pričom tieto chyby je dosť ťažké si predstaviť (ak profesionálne nepíšete parsery, samozrejme).
Podmienené hodnotenie času pre túto úlohu bude 3-5 krát vyššie ako pri zbere dát z Habra. Napriek tomu, že v prípade Habra používame priamy prístup s parsovaním HTML, a v prípade OK môžeme na kritických miestach pracovať s API.
Zhrnutie
Ako by ste od vás nežiadajú o odhad termínov „na mieste“ (predsa dnes plánujeme!) objemného modulu pipeplánu na spracovanie dát, čas vykonania sa takmer nikdy nedá ani kvalitne odhadnúť bez analýzy parametrov úlohy.
Ak sa pozrieme na to trochu filozoficky, stratégie hodnotenia v agile sú vhodné pre inžinierske úlohy, ale s experimentálnejšími a v niektorých ohľadoch „tvorivými“ a výskumnými úlohami, t.j. menej predvídateľnými, vznikajú ťažkosti, ako v príkladoch, ktoré sme tu prebrali.
Samozrejme, zber údajov je len jasným ilustratívnym príkladom — zvyčajne sa táto úloha zdá byť neuveriteľne jednoduchá a technicky nenáročná, a práve v detailoch sa tu najčastejšie skrýva diabol. A práve na tejto úlohe sa dá ukázať celý rozsah možných variantov toho, čo môže ísť zle a ako veľmi môže práca meškať.
Ak sa na charakteristiky úlohy pozrieme z rýchleho pohľadu bez ďalších experimentov, Reddit a OK vyzerajú podobne: existuje API, python wrapper, ale na podstate je rozdiel obrovský. Ak hodnotíme podľa týchto parametrov, parser Habra vyzerá zložitejšie ako OK — a v praxi je to úplne naopak a presne to sa dá zistiť prostredníctvom jednoduchých experimentov na analýzu parametrov úlohy.
Z môjho pohľadu je najefektívnejším prístupom približný odhad času, ktorý potrebujete na samotnú predbežnú analýzu a jednoduché prvé experimenty, čítanie dokumentácie — to vám umožní poskytnúť presný odhad pre celú prácu. V termínoch populárnej metodológie agile — žiadam, aby mi bol založený tiket na "odhady parametrov úlohy", na základe ktorého môžem poskytnúť odhad toho, čo je možné vykonať v rámci "sprintu" a poskytnúť presnejší odhad pre každú úlohu.
Preto sa najefektívnejší argument zdá byť ten, ktorý by ukázal „netechnickému“ špecialistovi, ako veľmi sa bude variabilita času a zdrojov líšiť v závislosti od parametrov, ktoré ešte treba ohodnotiť.
Zdroj: habr.com
