

Prístup IaC (Infrastructure as Code) sa skladá nielen z kódu, ktorý je uložený v repozitári, ale aj z ľudí a procesov, ktoré tento kód obklopujú. Dá sa opätovne využiť prístupy z vývoja softvéru pri správe a popise infraštruktúry? Nebude na škodu mať na pamäti túto myšlienku, keď budete čítať článok.
Toto je prepis mojej na .
Prezentácie a videá
- Suchý beh 2019-04-24
Infraštruktúra ako bash história
Predpokladajme, že prichádzate na nový projekt a niekto vám povie: „máme Infrastructure as Code“. V skutočnosti sa ukáže, Infraštruktúra ako bash história alebo napríklad Dokumentácia ako bash história. Toto je celkom reálna situácia, napríklad takýto prípad popisoval Denis Lysenko vo svojej prednáške , rozprával, ako z bash histórie získali usporiadanú infraštruktúru na projekte.
Pri určitej snahe by sa dalo povedať, že Infraštruktúra ako bash história to je ako kód:
- reprodukovateľnosť: môžete vziať bash históriu, vykonať príkazy odtiaľ a možno, mimochodom, dostanete funkčnú konfiguráciu ako výstup.
- verzionovanie: viete, kto prišiel a čo robil, opäť nie je fakt, že vás to privedie k funkčnej konfigurácii na výstup.
- história: história toho, kto a čo urobil. Lenže jej nebudete môcť využiť, ak stratíte server.
Čo robiť?
Infrastructure as Code
Aj taký zvláštny prípad, ako Infraštruktúra ako bash história sa dá natiahnuť k Infrastructure as Code, ale keď sa pokúsime urobiť niečo zložitejšie ako starý dobrý LAMPový server, dostaneme sa k tomu, že tento kód bude nutné nejako modifikovať, upravovať, dopĺňať. Ďalej by sme sa radi pozreli na paralely medzi Infrastructure as Code a vývojom softvéru.
D.R.Y.
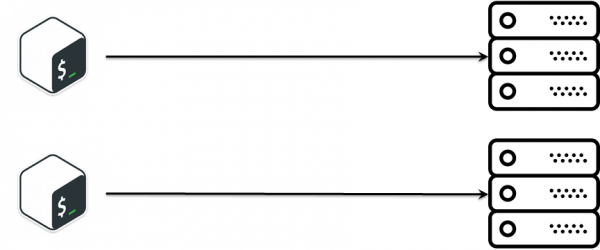
Na projekte vývoja Skladových systémov bola podúloha : vydávame nový release - je potrebné ho rozložiť na ďalšie testovanie. Úloha je mimoriadne jednoduchá:
- sem sa prihlás a vykonaj príkaz.
- tam skopíruj súbor.
- tu uprav konfiguráciu.
- tam spusti službu
- …
- PROFIT!
Pre popísanú logiku je viac než dosť bash, najmä v počiatočných fázach projektu, keď sa len spúšťa. Je to , ale časom vznikajú požiadavky na rozšírenie niečoho podobného, no trochu odlišného. Prvé, čo napadne, je: copy-paste. A už máme dva veľmi podobné skripty, ktoré robia takmer to isté. Časom sa počet skriptov zvýšil a stretli sme sa s tým, že existuje určitá obchodná logika nasadenia inštalácie, ktorú je potrebné synchronizovať medzi rôznymi skriptami, čo je pomerne zložité.
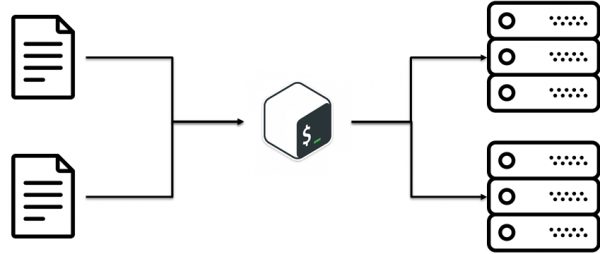
Ukazuje sa, že existuje taká prax D.R.Y. (Do not Repeat Yourself). Myšlienka spočíva v opätovnom použití existujúceho kódu. Znie to jednoducho, ale k tomu sme sa nedostali hneď. V našom prípade to bola banálna myšlienka: oddeliť konfigurácie od skriptov. T.j. obchodná logika ako sa nasadzuje inštalácia oddelene, konfigurácie oddelene.
S.O.L.I.D. pre CFM
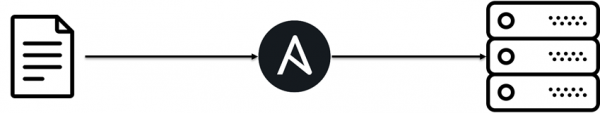
Časom projekt rástol a sa stalo objavenie Ansible. Hlavným dôvodom jeho vzniku je existencia odbornosti v tíme a to, že bash nie je určený na zložitú logiku. Ansible sa tiež stal obsahovať zložitú logiku. Aby sa zložitá logika nepretransformovala na chaos, v oblasti vývoja softvéru existujú zásady organizácie kódu. S.O.L.I.D. Rovnako napríklad Grigory Petrov vo svojej prednáške „Prečo má IT-človek osobný brand“ sa dotkol otázky, že človek, je taký, že je mu jednoduchšie manipulovať s nejakými spoločenskými entitami, v oblasti vývoja softvéru sú to objekty. Ak spojíme tieto dve myšlienky a budeme ich naďalej rozvíjať, môžeme si všimnúť, že aj v opise infraštruktúry sa dajú použité S.O.L.I.D. aby bolo v budúcnosti jednoduchšie udržiavať a modifikovať túto logiku.
Princíp jednotkovej zodpovednosti
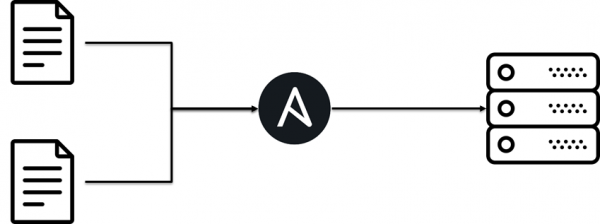
Každá trieda plní iba jednu úlohu.
Nesmiete miešať kód a robiť monolitné božské cestovinové monštrá. Infrastruktúra by mala pozostávať z jednoduchých kociek. Ukazuje sa, že ak rozdelíte Ansible playbook na malé časti, čítaj Ansible role, je ich jednoduchšie udržiavať.
Princíp otvorenosti/zatvorenia
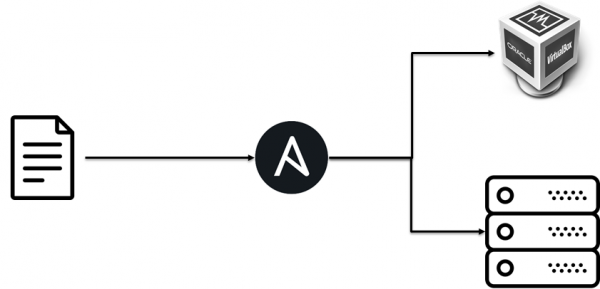
Princíp otvorenosti/zatvorenia.
- Otvoria sa na rozšírenie: znamená, že správanie entity môže byť rozšírené vytvorením nových typov entít.
- Zatvorené pre zmeny: v dôsledku rozšírenia správania entity, by nemali byť vykonané žiadne zmeny v kóde, ktorý tieto entity používa.
Pôvodne sme nasadili testovaciu infraštruktúru na virtuálnych strojoch, ale pretože obchodná logika nasadenia bola oddelená od implementácie, bez problémov sme pridali nasadenie na bare metal.
Liskov princíp substitúcie
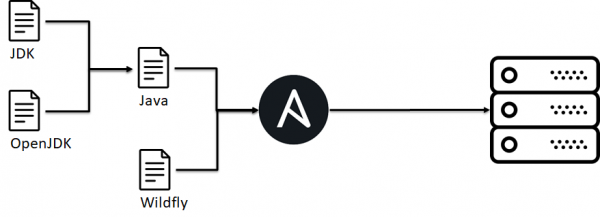
Princíp substitúcie Barbary Liskov. objekty v programe by mali byť nahraditeľné inštanciami ich podtypov bez zmeny správnosti v vykonávaní programu
Ak sa pozrieme širšie, nie je to špecifikácia konkrétneho projektu, kde sa to dá aplikovať S.O.L.I.D., hovorí to vo všeobecnosti o CFM, napríklad, na inom projekte je potrebné nasadiť krabicovú Java aplikáciu nad rôznymi Java, aplikačnými servermi, databázami, OS a podobne. Na tomto príklade budem ďalej zvažovať ďalšie princípy S.O.L.I.D.
V našom prípade existuje v rámci infraštruktúrneho tímu dohoda, že ak nainštalujeme rolu imbjava alebo oraclejava, máme binárny spustiteľný súbor java. Je to potrebné, pretože nadriadené role závisia od tohto správania, očakávajú prítomnosť java. Zároveň nám to umožňuje nahradiť jednu implementáciu/verziu java inou bez zmeny logiky nasadenia aplikácie.
Problém je, že v Ansible nemožno implementovať takéto, takže v rámci tímu sa objavujú nejaké dohody.
Princíp segregácie rozhrania
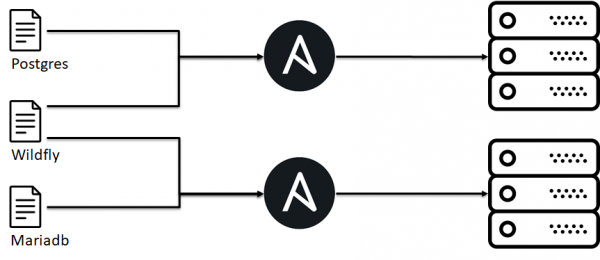
Princíp rozdelenia rozhrania "viac rozhraní, špeciálne navrhnutých pre zákazníkov, je lepšie ako jedno rozhranie všeobecného účelu."
Pôvodne sme sa snažili skomprimovať všetku variabilitu nasadenia aplikácie do jedného Ansible playbooku, ale bolo ťažké to udržiavať, a prístup, keď máme špecifikované rozhranie navonok (klient očakáva port 443), umožňuje nám zostaviť infraštruktúru z jednotlivých komponentov pre konkrétnu implementáciu.
Princíp inverzie závislostí
Princíp inverzie závislostí. Moduly vyšších úrovní by nemali závisieť od modulov nižších úrovní. Obe úrovne modulov by mali závisieť od abstrakcií. Abstrakcie by nemali závisieť od detailov. Detaily by mali závisieť od abstrakcií.
Príklad bude založený na antipatróne.
- U jedného z klientov sme mali súkromnú cloudovú infraštruktúru.
- V rámci cloudu sme objednávali virtuálne stroje.
- Ale vzhľadom na zvláštnosti cloudu bolo nasadenie aplikácie viazané na to, na aký hypervízor sa VM dostala.
T.j. vysoká úroveň logiky nasadenia aplikácie a závislostí sa prenášala na nižšie úrovne hypervízora, čo spôsobovalo problémy pri opätovnom použití tejto logiky. Nerob to tak.
Interakcia
Infrastruktúra ako kód nie je len o kóde, ale aj o vzťahoch medzi kódom a človekom, o interakciách medzi vývojármi infraštruktúry.
Bus factor
Predpokladajme, že vo vašom projekte je Vaša. Všetko vie o vašej infraštruktúre. Čo sa stane, ak Vaša náhle zmizne? To je celkom reálna situácia, pretože ho môže zraziť autobus. Niekedy sa to stáva. Ak sa to stane a vedomosti o kóde, jeho štruktúre, ako funguje, prístupoch a heslách nie sú rozdelené v tíme, môžete čeliť radom nepríjemných situácií. Aby sa minimalizovali tieto riziká a vedomosti sa prerozdelili v rámci tímu, je možné využiť rôzne prístupy.
Pair Devopsing
Není to ako , že admini pili pivo, menili heslá, a analógia párového programovania. T.j. dvaja inžinieri sedia za jedným počítačom, za jednu klávesnicu a začínajú spoločne nastaviť vašu infraštruktúru: nastavovať server, písať Ansible rolu atď. Znie to pekne, ale u nás to nefungovalo. Ale súkromné prípady tejto praxe fungovali. Prišiel nový zamestnanec, jeho mentor spolu s ním vezme skutočnú úlohu, pracuje - predáva vedomosti.
Ďalší súkromný prípad je incident call. Počas problému sa zíde skupina strážcov a zainteresovaných, určí sa jeden moderátor, ktorý zdieľa svoju obrazovku a oznamuje svoje myšlienky. Ostatní účastníci sledujú myšlienky moderátora, nahlédnu do trikov z konzoly, kontrolujú, čo v logu nezabudol. Takýto prístup fungoval skôr než nie.
Code Review
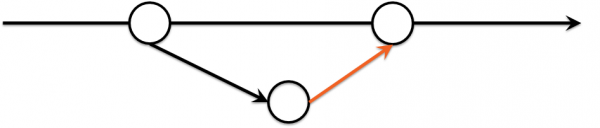
Subjektívne, efektívne šírenie vedomostí o infraštruktúre a o tom, ako je usporiadaná, prebiehalo prostredníctvom code review:
- Infrastruktúra je opísaná kódom v repozitári.
- Zmeny sa dejú v samostatnej vetve.
- Pri merge requeste je možné vidieť deltu zmien infraštruktúry.
Zaujímavosťou bolo, že revízori boli vyberaní po poradí, podľa rozvrhu, t.j. s určitou pravdepodobnosťou sa dostanete do novej časti infraštruktúry.
Code Style
S postupom času sa začali objavovať nezhody počas revízií, pretože revízori mali svoj štýl a rotácie revízorov ich spájali s rôznymi štýlmi: 2 medzery alebo 4, camelCase alebo snake_case. Implementovať to sa podarilo až neskôr.
- Prvotná myšlienka bola odporučiť používať linter, predsa len, inžinieri sú všetci šikovní. Ale rôzne editory a operačné systémy to neulahčuje.
- To sa vyvinulo do bota, ktorý na každý problémový commit písal do Slacku a prikladal výstup z lintera. Avšak v mnohých prípadoch sa našli dôležitejšie záležitosti a kód ostával neopravný.
Green Build Master
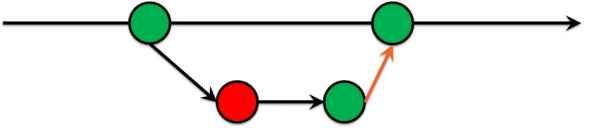
Čas plynie a prišli sme k tomu, že do hlavnej vetvy nemôžeme púšťať commity, ktoré neprešli určitými testami. Vytvorili sme Green Build Master, ktorý sa už dávno praktizuje vo vývoji softvéru:
- Vývoj prebieha v oddelenej vetve.
- Na tejto vetve sa vykonávajú testy.
- Ak testy neprejdu, kód sa nedostane do hlavnej vetvy.
Prijatie tohto rozhodnutia bolo veľmi bolestivé, pretože vyvolalo množstvo sporov, ale stálo to za to, pretože na revízie začali prichádzať požiadavky na zlúčenie bez rozdielov v štýle a s časom sa počet problémových miest znížil.
IaC Testing
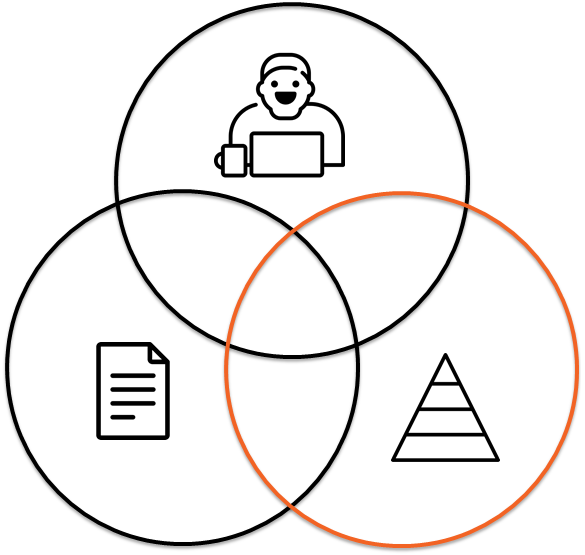
Okrem kontroly štýlu je možné použiť aj iné veci, napríklad overiť, že vaša infraštruktúra sa skutočne dá nasadiť. Alebo overiť, že zmeny v infraštruktúre nespôsobia stratu peňazí. Prečo je to potrebné? Otázka je zložitá a filozofická, lepšie odpovedať príbehom, že bol akýsi auto-scaler na PowerShell, ktorý nekontroloval okrajové podmienky => vytvorilo sa viac VM, než bolo potrebné => klient minú viac peňazí než plánoval. Nie je to nič príjemné, ale túto chybu by bolo možné zachytiť oveľa skôr.
Môže sa pýtať, prečo robiť zložitú infraštruktúru ešte zložitejšou? Testy pre infraštruktúru, rovnako ako pre kód, nie sú o zjednodušení, ale o vedomí, ako vaša infraštruktúra má fungovať.
IaC Testing Pyramid
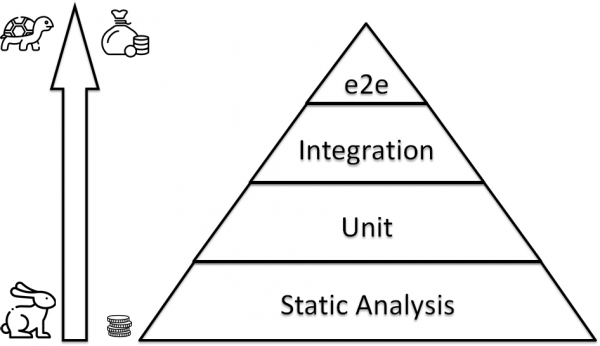
IaC Testing: Static Analysis
Ak okamžite nasadíte celú infraštruktúru a skontrolujete, že funguje, môže sa ukázať, že to zaberie veľa času a vyžaduje si to množstvo zdrojov. Preto by malo byť niečo rýchle, čo pokrýva množstvo primitivít.
Bash je zložitý
Pozrime sa na banálny príklad. Vybrať všetky súbory v aktuálnom adresári a skopírovať ich na iné miesto. Prvé, čo mi napadne:
for i in * ; do
    cp $i /some/path/$i.bak
done
A čo ak je v názve súboru medzera? Nuž dobre, sme predsa múdri, vieme používať úvodzovky:
for i in * ; do cp "$i" "/some/path/$i.bak" ; doneSkvelé? Nie! Čo ak v adresári nie je nič, t.j. globovanie nefunguje.
find . -type f -exec mv -v {} dst/{}.bak ;Teraz sme skvelí? Nie… Zabudli sme, že v názve súboru môže byť n.
touch x
mv x "$(printf "foonbar")"
find . -type f -print0 | xargs -0 mv -t /path/to/target-dir
Nástroje statickej analýzy
Problém z predchádzajúceho kroku by sa dal odchytiť, keď sme zabudli na úvodzovky, na to existuje množstvo prostriedkov , je ich veľa a pravdepodobne nájdete linter pre svoju IDE, ktorý vyhovuje vášmu stacku.
Jazyk
Nástroj
bash
Ruby
python
ansible
IaC Testing: Jednotkové testy
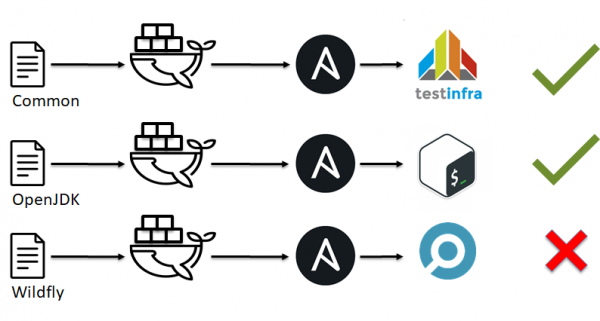
Ako sme sa presvedčili z predchádzajúceho príkladu, lintery nie sú všemocné a nemôžu odhaliť všetky problémové miesta. Na tento účel, podobne ako pri testovaní v softvérovom vývoji, môžeme spomenúť jednotkové testy. Hneď sa vybavia , , , . Ale čo robiť s ansible, chef, saltstack a podobne?
Na začiatku sme hovorili o S.O.L.I.D. a o tom, že naša infraštruktúra by mala pozostávať z malých kociek. Teraz prišiel ich čas.
- Infraštruktúra je rozdelená na malé kocky, napríklad Ansible role.
- Nasadzuje sa nejaké prostredie, či už ide o docker alebo VM.
- Na toto testovacie prostredie aplikujeme našu Ansible rolu.
- Kontrolujeme, či všetko fungovalo podľa našich očakávaní (spúšťame testy).
- Rozhodujeme, či je to v poriadku alebo nie.
IaC Testing: Nástroje na jednotkové testovanie
Otázka, čo sú to testy pre CFM? Môžete len spustiť skript alebo použiť hotové riešenia na tento účel:
CFM
Nástroj
Ansible
Chef
Chef
saltstack
Príklad pre testinfra, kontrolujeme, že používatelia test1, test2 existujú a sú v skupine sshusers:
def test_default_users(host):
    users = ['test1', 'test2']
    for login in users:
        assert host.user(login).exists
        assert 'sshusers' in host.user(login).groups
Čo si vybrať? Otázka je zložitá a jednoznačná nie je, tu je príklad zmien v projektoch na github za roky 2018-2019:
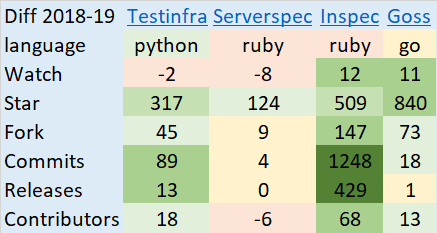
IaC Testing frameworks
Vzniká otázka, ako to všetko dať dohromady a spustiť? Môžete pri dostatočnom počte inžinierov. Alebo môžete vziať hotové riešenia, aj keď ich nie je veľa:
CFM
Nástroj
Ansible
Chef
Terraform
Príklad zmien v projektoch na github za roky 2018-2019:
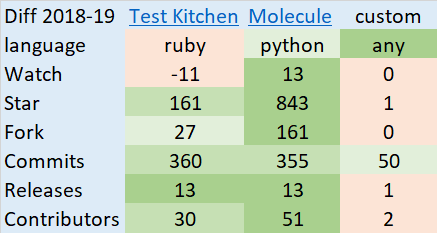
Molecule vs. Testkitchen
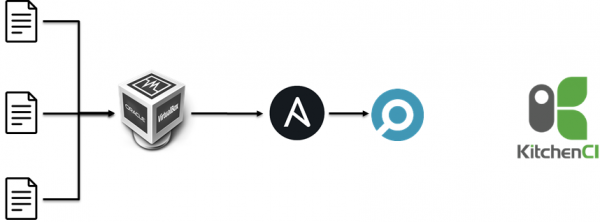
Pôvodne sme :
- Vytvoriť VM v Parallels.
- Aplikovať Ansible roly.
- Spustiť inspec.
Pre 25-35 rolí to trvalo 40-70 minút, čo bolo dlhé.
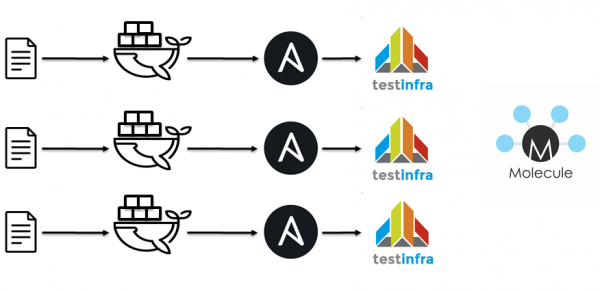
Ďalším krokom bol prechod na Jenkins / Docker / Ansible / Molecule. Ideologicky je to to isté.
- Prelintovať playbooky.
- Prelintovať roly.
- Spustiť kontajner.
- Aplikovať Ansible roly.
- Spustiť testinfra.
- Skontrolovať idempotentnosť.
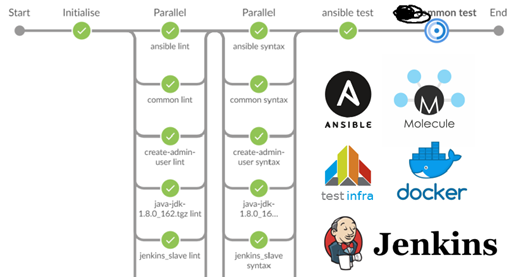
Linting pre 40 rolí a testy pre desiatku trvali asi 15 minút.
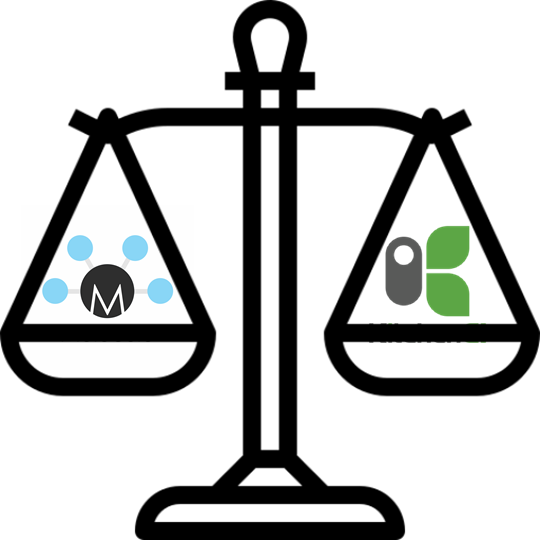
Čo si vybrať závisí od mnohých faktorov, ako je použitý stack, odborné zručnosti v tíme atď. Tu si každý sám rozhoduje, ako uzavrieť otázku Unit testovania.
IaC Testing: Integrácie testy
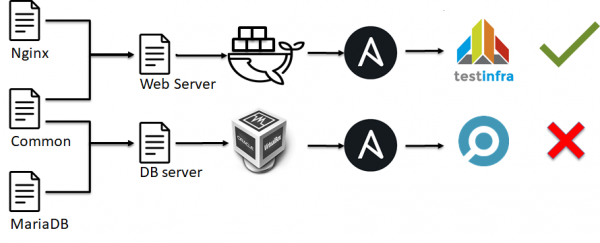
Na ďalšej úrovni pyramídy testovania infraštruktúry sa objavujú integračné testy. Sú podobné Unit testom:
- Infraštruktúra sa rozdeľuje na malé bloky, napríklad Ansible roly.
- Nasadzuje sa nejaké prostredie, či už ide o docker alebo VM.
- Na toto testovacie prostredie sa aplikuje množstvo Ansible rolí.
- Kontrolujeme, že všetko fungovalo, ako očakávame (spúšťame testy).
- Rozhodujeme, či je to v poriadku alebo nie.
Povedané jednoducho, nekontrolujeme funkčnosť jednotlivého prvku systému ako v unit testoch, kontrolujeme, ako je server nakonfigurovaný ako celok.
IaC Testing: End to End testy
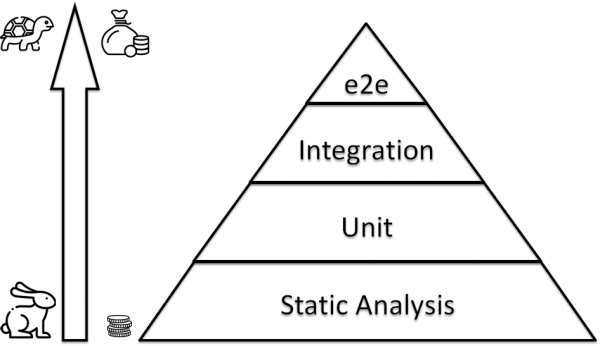
Na vrchole pyramídy nás vítajú End to End testy. Teda nekontrolujeme funkčnosť jednotlivého servera, jednotlivého skriptu, jedného bloku našej infraštruktúry. Kontrolujeme, že množstvo serverov, ktoré sú prepojené, funguje, ako očakávame. Bohužiaľ, nevidel som hotové krabicové riešenia, asi preto, že infraštruktúra je často unikátna a ťažko ju šablonizovať a vytvoriť rámec pre jej testovanie. Ako výsledok každý vytvára svoje vlastné riešenia. Dopyt je, ale odpovede niet. Preto poviem, čo existuje, aby som iných povzbudil na rozumné myšlienky alebo aby ma niekto postrčil, že všetko už bolo dávno vymyslené.
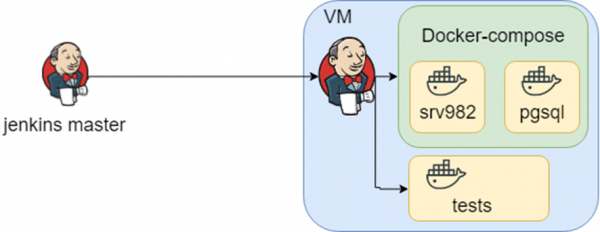
Projekt s bohatou históriou. Používa sa vo veľkých organizáciách a pravdepodobne sa každý z vás s ním nepriamo stretol. Aplikácia podporuje množstvo databáz, integrácií a podobne. Znalosť o tom, ako môže infraštruktúra vyzerať, to sú mnohé docker-compose súbory, a znalosť toho, aké testy spúšťať v akých prostrediach - to je jenkins.
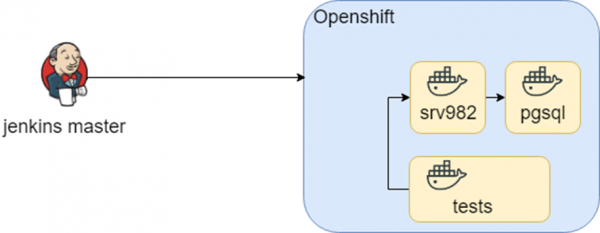
Tento systém dosť dlho fungoval, kým v rámci sme to neskúsili preniesť do Openshift. Kontajnery zostali rovnaké, ale prostredie spustenia sa zmenilo (ahoj D.R.Y. znova).
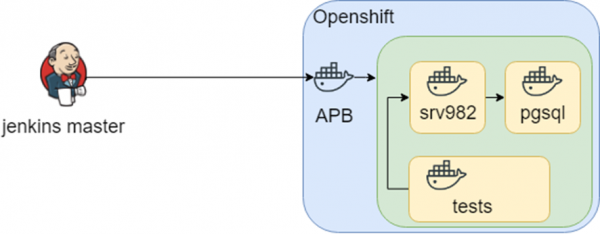
Výskum sa posunul ďalej a v openshift sa našla funkcia APB (Ansible Playbook Bundle), ktorá umožňuje zabaliť do kontajnera vedomosť o tom, ako nasadiť infraštruktúru. T.j. existuje reprodukovateľný, testovateľný bod vedomosti o tom, ako nasadiť infraštruktúru.
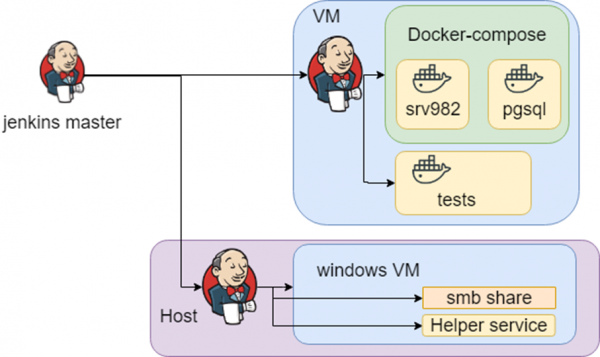
Všetko to znelo dobre, kým sme nenarazili na heterogénnu infraštruktúru: na testy potrebujeme Windows. Nakoniec vedomosť o tom, kde a ako nasadiť a otestovať, zostáva v jenkins.
Záver
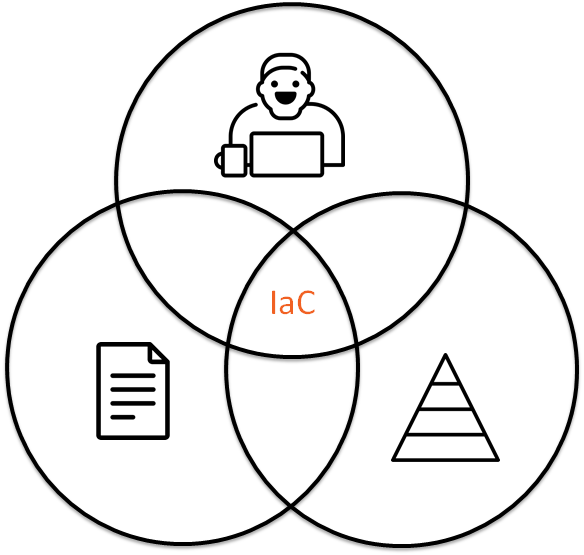
Infraštruktúra ako kód je
- Kód v repozitári.
- Interakcia medzi ľuďmi.
- Testovanie infraštruktúry.
odkazy
- Suchý beh 2019-04-24
- &
Zdroj: habr.com
