

V tomto príspevku by sme chceli zdieľať zaujímavý spôsob, ako sa vysporiadať s konfiguráciou distribuovaného systému.
Konfigurácia je priamo reprezentovaná v jazyku Scala bezpečným spôsobom. V príspevku je podrobne popísaná príkladná implementácia. Diskutujeme o rôznych aspektoch návrhu, vrátane vplyvu na celkový vývojový proces.
()
Introduction
Výstavba robustných distribuovaných systémov vyžaduje použitie správnej a koherentnej konfigurácie na všetkých uzloch. Typickým riešením je používanie textového popisu nasadenia (terraform, ansible alebo niečo podobné) a automaticky generovaných konfiguračných súborov (často - určených pre každý uzol/úlohu). Rovnako by sme chceli používať rovnaké protokoly a rovnaké verzie na všetkých komunikujúcich uzloch (inak by sme sa stretli s problémami s nekompatibilitou). Vo svete JVM to znamená, že aspoň knižnica na správu správ by mala byť v rovnakých verziách na všetkých komunikujúcich uzloch.
Čo s testovaním systému? Samozrejme, mali by sme mať jednotkové testy pre všetky komponenty pred prechodom na integračné testy. Aby sme mohli extrapolovať výsledky testov na runtime, mali by sme sa ubezpečiť, že verzie všetkých knižníc sú identické v oboch prostrediach runtime a testovania.
Pri vykonávaní integračných testov je často oveľa jednoduchšie mať rovnaký classpath na všetkých uzloch. Musíme sa len uistiť, že rovnaký classpath sa používa pri nasadení. (Je možné použiť rôzne classpathy na rôznych uzloch, ale je ťažšie túto konfiguráciu reprezentovať a správne ju nasadiť.) Takže, aby sme si veci uľahčili, budeme brať do úvahy len identické classpathy na všetkých uzloch.
Konfigurácia má tendenciu vyvíjať sa spolu so softvérom. Zvyčajne používame verzie na identifikáciu rôznych
fáz vývoja softvéru. Zdá sa rozumné zahrnúť konfiguráciu pod riadenie verzií a identifikovať rôzne konfigurácie s niektorými štítkami. Ak existuje len jedna konfigurácia v produkcii, môžeme použiť jedinú verziu ako identifikátor. Niekedy môžeme mať viacero produkčných prostredí. A pre každé prostredie môžeme potrebovať samostatnú vetvu konfigurácie. Takže konfigurácie môžu byť označené štítkom vetvy a verziou na jedinečné identifikovanie rôznych konfigurácií. Každý štítok vetvy a verzia zodpovedajú jedinej kombinácii distribuovaných uzlov, portov, externých zdrojov, verzií knižníc classpath na každom uzle. Tu budeme pokrývať len jednu vetvu a identifikovať konfigurácie trojkombinovanou desatinnou verziou (1.2.3), rovnakým spôsobom ako ostatné artefakty.
V moderných prostrediach sa konfiguračné súbory už nezmenia manuálne. Zvyčajne generujeme
konfiguračné súbory počas nasadenia a následne. Takže by sa dalo opýtať, prečo stále používame textový formát pre konfiguračné súbory? Udržateľnou možnosťou je umiestniť konfiguráciu do kompilovacej jednotky a ťažiť z validácie konfigurácie počas kompilácie.
V tomto príspevku preskúmame myšlienku uchovávania konfigurácie v skompilovanom artefakte.
Kompilovateľná konfigurácia
V tejto časti prediskutujeme príklad statickej konfigurácie. Dve jednoduché služby - echo služba a klient echo služby sú nakonfigurované a implementované. Potom sú instancované dva rôzne distribuované systémy s oboma službami. Jeden je určený pre konfiguráciu jedného uzla a druhý pre konfiguráciu dvoch uzlov.
Typický distribuovaný systém pozostáva z niekoľkých uzlov. Uzly môžu byť identifikované pomocou nejakého typu:
sealed trait NodeId
case object Backend extends NodeId
case object Frontend extends NodeId
alebo jednoducho
case class NodeId(hostName: String)alebo dokonca
object Singleton
type NodeId = Singleton.type
Tieto uzly vykonávajú rôzne úlohy, prevádzkujú niektoré služby a mali by byť schopné komunikovať s inými uzlami prostredníctvom TCP/HTTP spojení.
Pre TCP spojenie je potrebné minimálne číslo portu. Rovnako by sme sa mali uistiť, že klient a server komunikujú rovnakým protokolom. Aby sme modelovali spojenie medzi uzlami, deklarujme nasledujúcu triedu:
case class TcpEndPoint[Protocol](node: NodeId, port: Port[Protocol])kde Port je len Int v rámci povoleného rozsahu:
type PortNumber = Refined[Int, Closed[_0, W.`65535`.T]]Zjemnené typy
Pozri knižnicu. Skrátka, umožňuje pridať obmedzenia kompilácie k iným typom. V tomto prípade Int je povolené iba mať hodnoty s 16-bitovým rozlíšením, ktoré môžu predstavovať číslo portu. Nie je potrebné používať túto knižnicu na tento prístup k konfigurácii. Jednoducho sa zdá, že veľmi dobre zapadá.
Pre HTTP (REST) môžeme tiež potrebovať cestu k službe:
type UrlPathPrefix = Refined[String, MatchesRegex[W.`"[a-zA-Z_0-9\/]*"`.T]]
case class PortWithPrefix[Protocol](portNumber: PortNumber, pathPrefix: UrlPathPrefix)
Phantom typ
Aby sme mohli identifikovať protokol počas kompilácie, používame funkciu Scaly na deklarovanie typového argumentu Protokol ktorý nie je použitý v triede. Je to takzvaný phantom typ. V čase spustenia zriedkakedy potrebujeme inštanciu identifikátora protokolu, preto ho neuchovávame. Počas kompilácie tento phantom typ poskytuje dodatočnú typovú bezpečnosť. Nemôžeme prechádzať port s nesprávnym protokolom.
Jedným z najpoužívanejších protokolov je REST API s serializáciou Json:
sealed trait JsonHttpRestProtocol[RequestMessage, ResponseMessage]kde RequestMessage je základný typ správ, ktoré môže klient poslať serveru a ResponseMessage je odpoveď od servera. Samozrejme, môžeme vytvoriť aj iné popisy protokolov, ktoré špecifikujú komunikačný protokol s požadovanou presnosťou.
Na účely tohto príspevku použijeme jednoduchšiu verziu protokolu:
sealed trait SimpleHttpGetRest[RequestMessage, ResponseMessage]V tomto protokole je správa požiadavky pripojená k url a správa odpovede sa vráti ako jednoduchý reťazec.
Konfigurácia služby by mohla byť opísaná menom služby, zbierkou portov a niektorými závislosťami. Existuje niekoľko možných spôsobov, ako reprezentovať všetky tieto prvky v Scale (napríklad, HList, algebrické dátové typy). Na účely tohto príspevku použijeme Cake Pattern a reprezentujeme kombinovateľné časti (moduly) ako traits. (Cake Pattern nie je povinnosťou pre tento kompilovateľný prístup k konfigurácii. Je to len jedna možná implementácia myšlienky.)
Závislosti by mohli byť reprezentované pomocou Cake Pattern ako koncové body iných uzlov:
  type EchoProtocol[A] = SimpleHttpGetRest[A, A]

  trait EchoConfig[A] extends ServiceConfig {
    def portNumber: PortNumber = 8081
    def echoPort: PortWithPrefix[EchoProtocol[A]] = PortWithPrefix[EchoProtocol[A]](portNumber, "echo")
    def echoService: HttpSimpleGetEndPoint[NodeId, EchoProtocol[A]] = providedSimpleService(echoPort)
  }
Echo služba potrebuje iba nakonfigurovaný port. A vyhlasujeme, že tento port podporuje protokol echo. Všimnite si, že momentálne nemusíme špecifikovať konkrétny port, pretože traity umožňujú deklarácie abstraktných metód. Ak použijeme abstraktné metódy, kompilátor bude vyžadovať implementáciu v konfigurácii. Tu sme poskytli implementáciu (8081) a bude sa používať ako predvolená hodnota, ak ju v konkrétnej konfigurácii vynecháme.
Môžeme deklarovať závislosť v konfigurácii klienta echo služby:
  trait EchoClientConfig[A] {
    def testMessage: String = "test"
    def pollInterval: FiniteDuration
    def echoServiceDependency: HttpSimpleGetEndPoint[_, EchoProtocol[A]]
  }
Závislosť má rovnaký typ ako echoService. Konkrétne vyžaduje rovnaký protokol. Preto si môžeme byť istí, že ak spojíme tieto dve závislosti, budú fungovať správne.
Implementácia služieb
Služba potrebuje funkciu na spustenie a elegantné vypnutie. (Možnosť zatvorenia služby je kritická pre testovanie.) Opäť existuje niekoľko možností, ako špecifikovať takúto funkciu pre danú konfiguráciu (napríklad, mohli by sme použiť typové triedy). Pre tento príspevok opäť použijeme Cake Pattern. Môžeme reprezentovať službu pomocou cats.Resource ktorý už poskytuje ohraničenie a uvoľnenie prostriedkov. Aby sme získali zdroj, mali by sme poskytnúť konfiguráciu a nejaký kontext behu. Takže funkcia na spustenie služby by mohla vyzerať nasledovne:
  type ResourceReader[F[_], Config, A] = Reader[Config, Resource[F, A]]

  trait ServiceImpl[F[_]] {
    type Config
    def resource(
      implicit
      resolver: AddressResolver[F],
      timer: Timer[F],
      contextShift: ContextShift[F],
      ec: ExecutionContext,
      applicative: Applicative[F]
    ): ResourceReader[F, Config, Unit]
  }
kde
Konfigurácia— typ konfigurácie, ktorá je potrebná pre tento štartér službyAddressResolver— objekt behu, ktorý má schopnosť získať skutočné adresy iných uzlov (čítajte ďalej pre podrobnosti).
ostatné typy pochádzajú z cats:
F[_]— typ efektu (v najjednoduchšom prípadeF[A]by mohol byť len() => A. V tomto príspevku použijemecats.IO.)Reader[A,B]— je viac-menej synonymom pre funkciuA => Bcats.Resource— má spôsoby na získanie a uvoľnenieTimer— umožňuje spať/merať časContextShift— analógExecutionContextApplicative— obal funkcií v efekte (takmer monáda) (možno to nakoniec nahradíme niečím iným)
Pomocou tohoto rozhrania môžeme implementovať niekoľko služieb. Napríklad službu, ktorá nič nerobí:
  trait ZeroServiceImpl[F[_]] extends ServiceImpl[F] {
    type Config  Resource.pure[F, Unit](()))
  }
(Pozri pre ďalšie implementácie služieb — ,
a .)
Uzol je jediný objekt, ktorý vykonáva niekoľko služieb (spustenie reťazca zdrojov je umožnené pomocou Cake Pattern):
object SingleNodeImpl extends ZeroServiceImpl[IO]
  with EchoServiceService
  with EchoClientService
  with FiniteDurationLifecycleServiceImpl
{
  type Config = EchoConfig[String] with EchoClientConfig[String] with FiniteDurationLifecycleConfig
}
Všimnite si, že v uzle špecifikujeme presný typ konfigurácie, ktorý je potrebný pre tento uzol. Kompilátor nám nedovolí zostaviť objekt (Cake) s nedostatočným typom, pretože každá služba trait deklaruje obmedzenie na Konfigurácia typ. Taktiež nebudeme schopní spustiť uzol bez poskytnutia kompletné konfigurácie.
Riešenie adresy uzla
Aby sme nadviazali pripojenie, potrebujeme skutočnú adresu hostiteľa pre každý uzol. Môže byť známa neskôr ako iné časti konfigurácie. Preto potrebujeme spôsob, ako poskytnúť mapovanie medzi id uzla a jeho aktuálnou adresou. Toto mapovanie je funkcia:
case class NodeAddress[NodeId](host: Uri.Host)
trait AddressResolver[F[_]] {
  def resolve[NodeId](nodeId: NodeId): F[NodeAddress[NodeId]]
}
Existuje niekoľko možných spôsobov, ako implementovať takúto funkciu.
- Ak poznáme skutočné adresy pred nasadením, počas inštancovania hostiteľov uzlov, môžeme vygenerovať kód v Scala so skutočnými adresami a následne spustiť zostavenie (ktoré vykonáva kontroly pri kompilácii a následne vykonáva integračné testy). V tomto prípade je naša mapovacia funkcia známa staticky a môže byť zjednodušená na niečo ako
Map[NodeId, NodeAddress]. - Niekedy získavame skutočné adresy až neskôr, keď je uzol skutočne spustený, alebo nemáme adresy uzlov, ktoré ešte neboli spustené. V takom prípade môžeme mať objavovaciu službu, ktorá sa spustí pred všetkými ostatnými uzlami a každý uzol môže oznámiť svoju adresu v tejto službe a prihlásiť sa na závislosti.
- Ak môžeme upraviť
/etc/hosts, môžeme použiť vopred definované názvy hostiteľov (akomy-project-main-nodeaecho-backend) a jednoducho priradiť toto meno k adrese ip pri nasadení.
V tomto príspevku tieto prípady podrobnejšie neriešime. V skutočnosti vo našom jednoduchom príklade budú mať všetky uzly rovnakú IP adresu — 127.0.0.1.
V tomto príspevku zvážime dva rozloženia distribuovaného systému:
- Rozloženie jedného uzla, kde sú všetky služby umiestnené na jednom uzle.
- Rozloženie dvoch uzlov, kde sú služba a klient na rôznych uzloch.
Konfigurácia pre je nasledovná:
Konfigurácia jedného uzla
object SingleNodeConfig extends EchoConfig[String]
  with EchoClientConfig[String] with FiniteDurationLifecycleConfig
{
  case object Singleton \/\/ identifikátor jediného uzla
  \/\/ konfigurácia servera
  type NodeId = Singleton.type
  def nodeId = Singleton

  \/** Typovo bezpečná špecifikácia portu služby. *\/
  override def portNumber: PortNumber = 8088

  \/\/ konfigurácia klienta

  \/** Použijeme službu poskytnutú tým istým hostiteľom. *\/
  def echoServiceDependency = echoService

  override def testMessage: UrlPathElement = "hello"

  def pollInterval: FiniteDuration = 1.second

  \/\/ konfigurácia ovládača životného cyklu
  def lifetime: FiniteDuration = 10500.milliseconds \/\/ ďalších 0,5 sekundy, aby sa uskutočnilo 10 požiadaviek, nie 9.
}
Tu vytvárame jednu konfiguráciu, ktorá rozširuje jak serverovú, tak aj klientskú konfiguráciu. Taktiež konfiguruje riadiace zariadenie životného cyklu, ktoré normálne ukončí klienta a server po tom, ako uplynie lifetime interval.
Tento istý súbor implementácií služieb a konfigurácií sa môže použiť na vytvorenie rozloženia systému so spravovaním dvoch samostatných uzlov. Stačí vytvoriť s príslušnými službami:
Konfigurácia dvoch uzlov
  object NodeServerConfig extends EchoConfig[String] with SigTermLifecycleConfig
  {
    type NodeId = NodeIdImpl

    def nodeId = NodeServer

    override def portNumber: PortNumber = 8080
  }

  object NodeClientConfig extends EchoClientConfig[String] with FiniteDurationLifecycleConfig
  {
    \/\/ NB! špecifikácia závislosti
    def echoServiceDependency = NodeServerConfig.echoService

    def pollInterval: FiniteDuration = 1.second

    def lifetime: FiniteDuration = 10500.milliseconds \/\/ ďalších 0.5 sekundy, aby sa uskutočnilo 10 požiadaviek, nie 9.

    def testMessage: String = "dolly"
  }
Pozrite sa, ako špecifikujeme závislosť. Zmienime sa o službe, ktorú poskytuje druhý uzol, ako o závislosti súčasného uzla. Typ závislosti je overený, pretože obsahuje fantómový typ, ktorý popisuje protokol. A v runtime budeme mať správne id uzla. To je jeden z dôležitých aspektov navrhnutého prístupového konfigurácie. Poskytuje nám možnosť nastaviť port iba raz a zabezpečiť, aby sme odkazovali na správny port.
Implementácia dvoch uzlov
Pre túto konfiguráciu používame presne tie isté implementácie služieb. Žiadne zmeny vôbec. Avšak, vytvárame dve rôzne implementácie uzlov, ktoré obsahujú rôzny súbor služieb:
  object TwoJvmNodeServerImpl extends ZeroServiceImpl[IO] with EchoServiceService with SigIntLifecycleServiceImpl {
    type Config = EchoConfig[String] with SigTermLifecycleConfig
  }

  object TwoJvmNodeClientImpl extends ZeroServiceImpl[IO] with EchoClientService with FiniteDurationLifecycleServiceImpl {
    type Config = EchoClientConfig[String] with FiniteDurationLifecycleConfig
  }
Prvý uzol implementuje server a potrebuje iba serverovú konfiguráciu. Druhý uzol implementuje klienta a potrebuje iný úsek konfigurácie. Obe uzly vyžadujú nejakú špecifikáciu životnosti. Na účely tohto príspevku bude mať služba uzla nekonečnú životnosť, ktorá by mohla byť ukončená pomocou SIGTERM, zatiaľ čo echo klient sa ukončí po nastavenom konečnom trvaní. Pozrite sa na pre podrobnosti.
Celkovo vývojový proces
Pozrime sa, ako tento prístup mení spôsob, akým pracujeme s konfiguráciou.
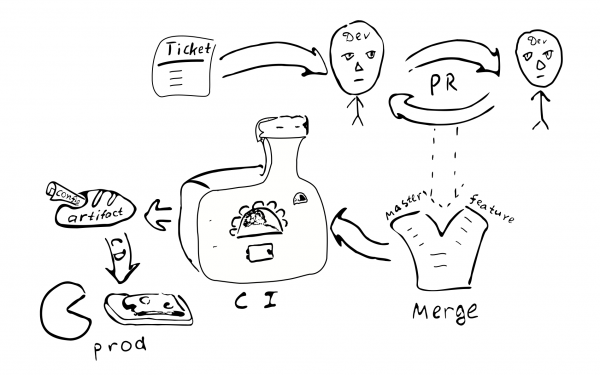
Konfigurácia ako kód bude skompilovaná a vytvorí artefakt. Zdá sa rozumné oddeliť artefakt konfigurácie od iných kódových artefaktov. Často môžeme mať množstvo konfigurácií na rovnakom kódovom základe. A samozrejme, môžeme mať viac verzií rôznych konfigurácií. V konfigurácii môžeme vybrať konkrétne verzie knižníc a tieto zostanú konštantné vždy, keď nasadíme túto konfiguráciu.
Zmena konfigurácie sa stáva zmenou kódu. Takže by mala byť pokrytá rovnakým procesom zaručovania kvality:
Ticket -> PR -> revízia -> zlúčenie -> kontinuálna integrácia -> kontinuálne nasadenie
Existujú nasledujúce dôsledky prístupu:
- Konfigurácia je konzistentná pre konkrétny systémový inštanciu. Zdá sa, že nie je možné mať nesprávne spojenie medzi uzlami.
- Nie je jednoduché zmeniť konfiguráciu len na jednom uzle. Zdá sa, že nie je rozumné prihlasovať sa a meniť niektoré textové súbory. Tak sa stáva, že drift konfigurácie je menej pravdepodobný.
- Malé zmeny v konfigurácii nie sú ľahko uskutočniteľné.
- Väčšina zmien v konfigurácii bude nasledovať rovnaký vývojový proces a prejde určitým preskúmaním.
Potrebujeme samostatný repozitár pre produkčnú konfiguráciu? Produkčná konfigurácia môže obsahovať citlivé informácie, ktoré by sme chceli uchovať mimo dosahu mnohých ľudí. Tak by stálo za to uchovať samostatný repozitár s obmedzeným prístupom, ktorý bude obsahovať produkčnú konfiguráciu. Môžeme rozdeliť konfiguráciu na dve časti - jednu, ktorá obsahuje väčšinu otvorených parametrov produkcie a druhú, ktorá obsahuje tajnú časť konfigurácie. To by umožnilo prístup väčšine vývojárov k väčšine parametrov, zatiaľ čo by prístup k naozaj citlivým veciam bol obmedzený. Je to ľahké vykonať pomocou medzičlánkov so štandardnými hodnotami parametrov.
Variácie
Pozrime sa na výhody a nevýhody navrhovaného prístupu v porovnaní s inými technikami správy konfigurácie.
Najprv uvedieme niekoľko alternatív k rôznym aspektom navrhovaného spôsobu zaobchádzania s konfiguráciou:
- Textový súbor na cieľovom stroji.
- Centralizované úložisko kľúč-hodnota (ako
etcd/zookeeper). - Podprocesové komponenty, ktoré sa môžu znovu konfigurovať/reštartovať bez reštartu procesu.
- Konfigurácia mimo artefakt a verziovania.
Textový súbor poskytuje určitú flexibilitu pokiaľ ide o ad-hoc opravy. Administrátor systému sa môže prihlásiť na cieľový uzol, vykonať zmenu a jednoducho reštartovať službu. To nemusí byť ideálne pre väčšie systémy. Žiadne stopy nezostávajú po zmene. Zmena nie je preskúmaná iným očkom. Môže byť ťažké zistiť, čo zmenu spôsobilo. Nebola testovaná. Z pohľadu distribuovaného systému môže administrátor jednoducho zabudnúť aktualizovať konfiguráciu v jednom z ostatných uzlov.
(Mimochodom, ak sa nakoniec objaví potreba začať používať textové konfiguračné súbory, budeme musieť len pridať parser + validator, ktorý by mohol produkovať rovnaký Konfigurácia typ a to by stačilo na to, aby sme začali používať textové konfigurácie. To tiež ukazuje, že zložitost konfigurácie na kompilacnej úrovni je trochu menšia ako zložitost textových konfigurácií, pretože v textovej verzii potrebujeme nejaký dodatočný kód.)
Centralizované úložisko kľúč-hodnota je dobrý mechanizmus na distribúciu meta parametrov aplikácie. Tu musíme premýšľať o tom, čo považujeme za hodnoty konfigurácie a čo sú len údaje. S ohľadom na funkciu C => A => B zvyčajne nazývame málo sa meniacimi hodnotami C «konfigurácia», zatiaľ čo často menené údaje A — len vstupné údaje. Konfigurácia by mala byť poskytnutá funkcii skôr ako údaje. A. S ohľadom na túto myšlienku môžeme povedať, že očakávaná frekvencia zmien môže byť použitá na odlíšenie konfiguračných údajov od len údajov. Taktiež údaje zvyčajne pochádzajú z jedného zdroja (užívateľ) a konfigurácia pochádza z iného zdroja (administrátor). Zaobchádzanie s parametrami, ktoré sa môžu zmeniť po inicializácii procesu, vedie k zvýšeniu zložitosti aplikácie. Pre takéto parametre budeme musieť zabezpečiť ich mechanizmus dodávky, analýzu a validáciu, zaoberať sa nesprávnymi hodnotami. Preto, aby sme znížili zložitost programu, je lepšie znížiť počet parametrov, ktoré sa môžu zmeniť za behu (alebo ich dokonca úplne eliminovať).
Z pohľadu tohto príspevku by sme mali rozlíšiť medzi statickými a dynamickými parametrami. Ak logika služby vyžaduje zriedkavú výmenu niektorých parametrov v priebehu prevádzky, môžeme ich nazvať dynamickými parametrami. Inak sú to statické a môžu sa konfigurovať pomocou navrhnutého prístupu. Pre dynamickú rekonfiguráciu by mohli byť potrebné iné prístupy. Napríklad, časti systému môžu byť reštartované s novými konfiguračnými parametrami podobne ako pri reštartovaní samostatných procesov distribuovaného systému.
(Môj skromný názor je vyhnúť sa rekonfigurácii za behu, pretože zvyšuje zložitost systému.
Môže byť jednoduchšie spoľahnúť sa na podporu operačného systému pri reštartovaní procesov. Hoci to nemusí byť vždy možné.)
Jedným dôležitým aspektom používania statickej konfigurácie, ktorý niekedy spôsobuje, že ľudia zvažujú dynamickú konfiguráciu (bez iných dôvodov), je doba prevádzky služby počas aktualizácie konfigurácie. Naozaj, ak musíme vykonať zmeny v statickej konfigurácii, musíme reštartovať systém, aby sa nové hodnoty stali účinnými. Požiadavky na dobu prestoja sa líšia pre rôzne systémy, takže to nemusí byť také kritické. Ak je to kritické, musíme plánovať vopred akékoľvek reštarty systému. Napríklad môžeme implementovať . V tomto scenári, kedykoľvek potrebujeme reštartovať systém, spustíme novú inštanciu systému paralelne, potom prepneme ELB na ňu, pričom necháme starý systém dokončiť obsluhu existujúcich pripojení.
Čo sa týka umiestnenia konfigurácie vo verziovom artefakte alebo vonku? Udržanie konfigurácie v artefakte vo väčšine prípadov znamená, že táto konfigurácia prešla rovnakým procesom zabezpečenia kvality ako ostatné artefakty. Takže si môžeme byť istí, že konfigurácia je kvalitná a dôveryhodná. Naopak, konfigurácia v samostatnom súbore znamená, že neexistujú žiadne stopy o tom, kto a prečo zmenil tento súbor. Je to dôležité? Veríme, že pre väčšinu produkčných systémov je lepšie mať stabilnú a vysokokvalitnú konfiguráciu.
Verzia artefaktu umožňuje zistiť, kedy bola vytvorená, aké hodnoty obsahuje, aké funkcie sú zapnuté/vypnuté, kto bol zodpovedný za každú zmenu v konfigurácii. Môže to vyžadovať určité úsilie na udržanie konfigurácie v artefakte a je to rozhodnutie dizajnu.
Výhody a nevýhody
Tu by sme chceli zvýrazniť niektoré výhody a prediskutovať nevýhody navrhnutého prístupu.
Výhody
Vlastnosti kompilovateľnej konfigurácie úplného distribuovaného systému:
- Statická kontrola konfigurácie. To dáva vysokú mieru istoty, že konfigurácia je správna vzhľadom na typové obmedzenia.
- Bohatý jazyk konfigurácie. Typicky sú iné prístupy k konfigurácii obmedzené na maximálne substitúciu premenných.
Použitím Scalá môže človek využiť širokú škálu jazykových funkcií na zlepšenie konfigurácie. Napríklad, môžeme použiť traits na poskytovanie predvolených hodnôt, objekty na nastavenie rôznej oblasti platnosti, môžeme sa odkazovať navaldefinované iba raz v vonkajšej oblasti (DRY). Je možné použiť doslovné sekvencie, alebo inštancie určitých tried (Seq,Mapa, atď.). - DSL. Scala má slušnú podporu pre autorov DSL. Tieto funkcie možno využiť na vytvorenie konfiguračného jazyka, ktorý je pohodlnejší a priateľskejší k používateľom, takže konečná konfigurácia je aspoň čitateľná pre doménových používateľov.
- Integrita a koherencia naprieč uzlami. Jednou z výhod mať konfiguráciu pre celý distribuovaný systém na jednom mieste je, že všetky hodnoty sú definované presne raz a potom sa znovu používajú vo všetkých miestach, kde ich potrebujeme. Taktiež typovo bezpečné deklarácie portov zabezpečujú, že v všetkých možných správnych konfiguráciách budú uzly systému hovoriť rovnakým jazykom. Existujú explicitné závislosti medzi uzlami, čo sťažuje zabudnúť poskytovať niektoré služby.
- Vysoká kvalita zmien. Celkový prístup prechádzať zmeny konfigurácie normálnym procesom PR stanovuje vysoké štandardy kvality aj v konfigurácii.
- Simultánne zmeny konfigurácie. Kedykoľvek vykonáme nejaké zmeny v konfigurácii, automatické nasadenie zabezpečuje, že všetky uzly sú aktualizované.
- Zjednodušenie aplikácie. Aplikácia nemusí analyzovať a overovať konfiguráciu a zaobchádzať s nesprávnymi hodnotami konfigurácie. To zjednodušuje celkovú aplikáciu. (Niektoré zvýšenie zložitosti je v samotnej konfigurácii, ale je to vedomý obchodný úmysel smerom k bezpečnosti.) Je to dosť jednoduché vrátiť sa k bežnej konfigurácii - stačí pridať chýbajúce časti. Začínať s prekompilovanou konfiguráciou je jednoduchšie a implementáciu dodatočných častí možno odložiť na neskoršie obdobie.
- Verziovaná konfigurácia. Vzhľadom na to, že zmeny konfigurácie nasledujú rovnaký vývojový proces, získavame artefakt s jedinečnou verziou. To nám umožňuje vrátiť konfiguráciu späť, ak je to potrebné. Dokonca môžeme nasadiť konfiguráciu, ktorá bola použitá pred rokom, a bude fungovať presne tak, ako predtým. Stabilná konfigurácia zlepšuje predvídateľnosť a spoľahlivosť distribuovaného systému. Konfigurácia je fixná v čase prekladu a nemôže byť ľahko manipulovaná na produkčnom systéme.
- Modularita. Navrhnutý rámec je modulárny a moduly môžu byť kombinované rôznymi spôsobmi na
podporu rôznych konfigurácií (nastavení/rozložení). Konkrétne je možné mať malé rozloženie na jednom uzle a veľké rozloženie na viacerých uzloch. Je rozumné mať viaceré produkčné rozloženia. - Testovanie. Na účely testovania možno implementovať falošnú službu a použiť ju ako závislosť bezpečným spôsobom. Môže sa súčasne udržiavať niekoľko rôznych testovacích rozložení s rôznymi časťami nahradenými falošnými službami.
- Integrácia testovania. Niekedy je v distribuovaných systémoch ťažké spustiť integračné testy. Použitím opísaného prístupu k bezpečnej konfigurácii kompletného distribuovaného systému môžeme spustiť všetky distribuované časti na jednom serveri kontrolovateľným spôsobom. Je jednoduché emulovať situáciu
keď sa jedna zo služieb stane nedostupnou.
Nevýhody
Prístup s prekompilovanou konfiguráciou sa líši od 'normálnej' konfigurácie a nemusí vyhovovať všetkým potrebám. Tu sú niektoré nevýhody prekompilovanej konfigurácie:
- Statická konfigurácia. Môže sa nehodí pre všetky aplikácie. V niektorých prípadoch je potrebné rýchlo opraviť konfiguráciu v produkcii obchádzajúc všetky bezpečnostné opatrenia. Tento prístup to sťažuje. Po vykonaní akýchkoľvek zmien v konfigurácii je potrebná kompilácia a opätovné nasadenie. Je to súčasne vlastnosť aj záťaž.
- Generovanie konfigurácie. Keď je konfigurácia generovaná nejakým automatizačným nástrojom, tento prístup vyžaduje následnú kompiláciu (ktorá môže zase zlyhať). Môže byť potrebné dodatočné úsilie na integráciu tohto ďalšieho kroku do systému zostavenia.
- Nástroje. Dnes je v použitie množstvo nástrojov, ktoré sa spoliehajú na textové konfigurácie. Niektoré z nich
nebudú použiteľné, keď je konfigurácia skompilovaná. - Je potrebný posun v myslení. Vývojári a DevOps sú oboznámení s textovými konfiguračnými súbormi. Myšlienka kompilovania konfigurácie im môže pripadať zvláštna.
- Pred zavedením kompilovateľnej konfigurácie je potrebný proces vývoja softvéru vysokej kvality.
Existujú niektoré obmedzenia implementovaného príkladu:
- Ak poskytneme dodatočnú konfiguráciu, ktorá nie je požiadavkou implementácie uzla, kompilátor nám nepomôže odhaliť chýbajúcu implementáciu. To by sa dalo vyriešiť použitím
HListalebo ADTs (case classes) na konfiguráciu uzlov namiesto traits a Cake Pattern. - Musíme poskytnúť nejaký základný kód v konfiguračnom súbore: (
package,import,objectdeklarácie;
override def's pre parametre, ktoré majú predvolené hodnoty). To by sa dalo čiastočne riešiť použitím DSL. - V tomto príspevku sa nezaoberáme dynamickou rekonfiguráciou klastrov podobných uzlov.
Záver
V tomto príspevku sme diskutovali o myšlienke priamo zastúpiť konfiguráciu v zdrojovom kóde spôsobom, ktorý zabezpečuje typovú bezpečnosť. Tento prístup by sa mohol využiť v mnohých aplikáciách ako náhrada za konfigurácie založené na xml alebo iných textových formátoch. Napriek tomu, že náš príklad bol implementovaný v jazyku Scala, mohol by byť rovnako preložený do iných kompilovateľných jazykov (ako Kotlin, C#, Swift atď.). Tento prístup by sa mohol vyskúšať v novom projekte a v prípade, že by sa nehodil, prejsť na staromódny spôsob.
Samozrejme, kompilovateľná konfigurácia si vyžaduje vysokokvalitný proces vývoja. Na oplátku sľubuje poskytnúť rovnako vysokokvalitnú robustnú konfiguráciu.
Tento prístup by sa dal rozšíriť rôznymi spôsobmi:
- Môžu sa použiť makrá na vykonávanie validácie konfigurácie a zlyhanie pri kompilácii v prípade akýchkoľvek zlyhaní obchodnej logiky.
- Možno implementovať DSL na reprezentáciu konfigurácie spôsobom, ktorý je priateľský k používateľom v danom obore.
- Dynamické spravovanie zdrojov s automatickými úpravami konfigurácie. Napríklad, keď upravujeme počet uzlov v klastri, môžeme chcieť (1) aby uzly získali mierne pozmenenú konfiguráciu; (2) aby správa klastra dostala nové informácie o uzloch.
Ďakujem
Chcel by som poďakovať Andrejovi Saksonovovi, Pavlovi Popovovi a Antonovi Nehaevovi za inšpiratívne pripomienky k návrhu tohto príspevku, ktoré mi pomohli urobiť ho jasnejším.
Zdroj: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish