

Povedzme si, prečo sú CI nástroje a CI úplne o niečom inom.
Aký problém má CI vyriešiť, odkiaľ vznikla myšlienka, aké sú posledné dôkazy, že to funguje, ako zistiť, či máte skutočnú prax a nie len nainštalovaný Jenkins.
Myšlienka urobiť prezentáciu o Continous Integration sa objavila už pred rokom, keď som chodil na pohovory a hľadal prácu. Rozprával som sa s 10-15 spoločnosťami a len jedna dokázala zrozumiteľne vysvetliť, čo je to CI a ako pochopili, že to nemajú. Ostatní rozprávali nezrozumiteľné hlúposti o Jenkinsi 🙂 No máme Jenkins, robí zostavy, CI! V prezentácii sa budem snažiť vysvetliť, čo vlastne Continuous Integration naozaj je a prečo má Jenkins a podobné nástroje s tým len slabý vzťah.
A čo zvyčajne napadne, keď sa povie CI? Väčšine ľudí napadne Jenkins, Gitlab CI, Travis a podobne.
Aj keď vyhľadáme, tieto nástroje nám vyhodí.
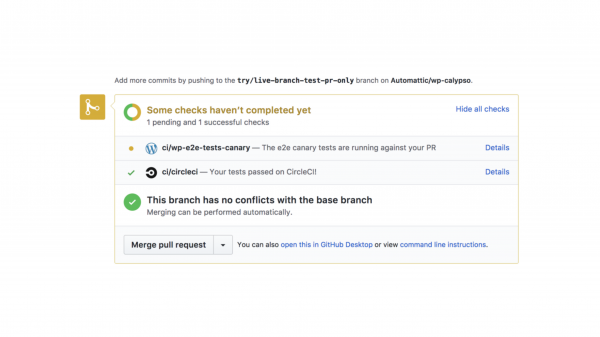
Ak sa spýtate známych, tak hneď po vymenovaní nástrojov vám povedia, že CI znamená, keď sa v Pull Request na commit robí zostava a spúšťajú sa testy.
Continuous Integration nie je o nástrojoch, ani o zostavách s testami vo vetve! Continuous Integration je prax veľmi častého integrácie nového kódu a na jej uplatnenie nie je vôbec nutné fandiť Jenkinsom, GitLabom a podobne.
Predtým, ako si povieme, ako vyzerá plnohodnotné CI, sa najprv ponoríme do kontextu ľudí, ktorí to vymysleli, a prežijeme tú bolesť, ktorú sa snažili vyriešiť.
A riešili tú bolesť spolupráce v tíme!
Pozrime sa na príkladoch, s akými ťažkosťami sa stretávajú vývojári pri tímovom vývoji. Máme projekt, master vetvu v gite a dvoch vývojárov.
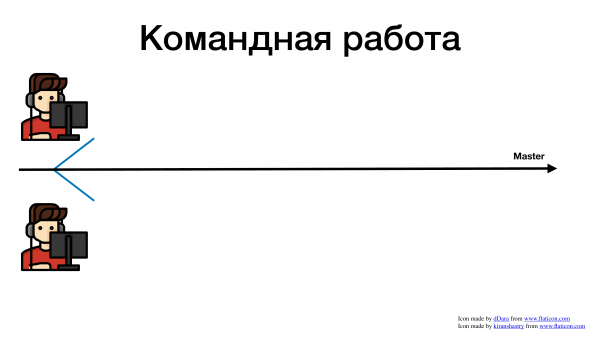
A pustili sa do práce tak, ako sú všetci zvyknutí. Zobrali úlohu v Jire, vytvorili feature branch, píšu kód.
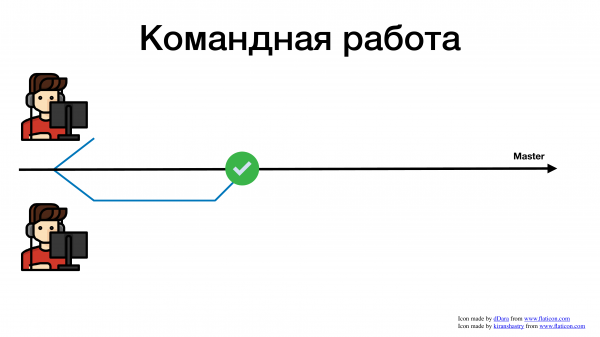
Jeden dokončil funkciu skôr a zlúčil do mastera.
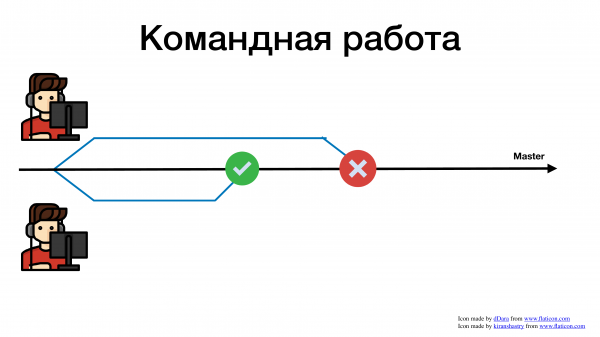
Druhému to trvalo dlhšie, zlúčil neskôr a dostal konflikt. Teraz, namiesto toho, aby písal potrebné poslové funkcie, stráca vývojár svoj čas a sily na riešenie konfliktov.
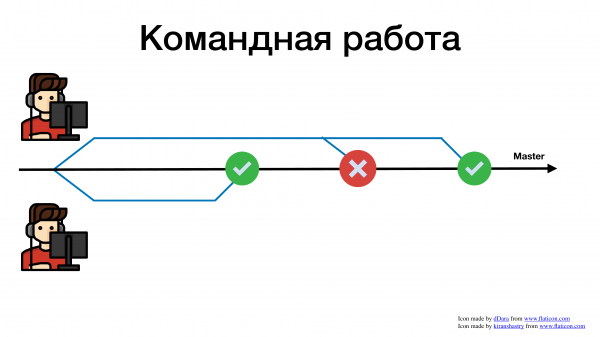
Čím ťažšie je skombinovať svoju funkciu s hlavným repozitárom, tým viac času tomu venujeme. A to je ešte dosť jednoduchý príklad. Je to príklad, kde sú len dvaja vývojári. Predstavte si, ak je ich 10, 15 alebo dokonca 100, ktorí píšu do jedného repozitára. Zbláznili by ste sa z tých konfliktov, ktoré by ste museli riešiť.
Existuje trochu iný prípad. Máme hlavnú vetvu a niekoľko vývojárov, ktorí niečo robia.
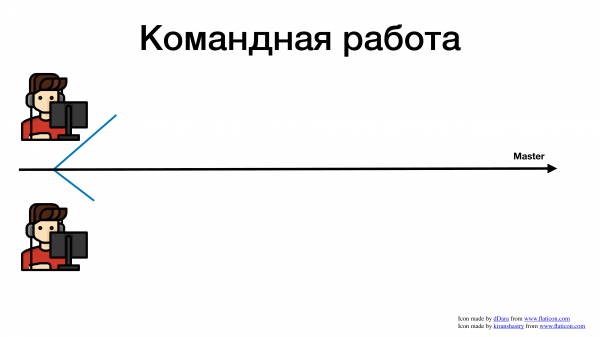
Vytvorili si každý svoj vlastný branch.
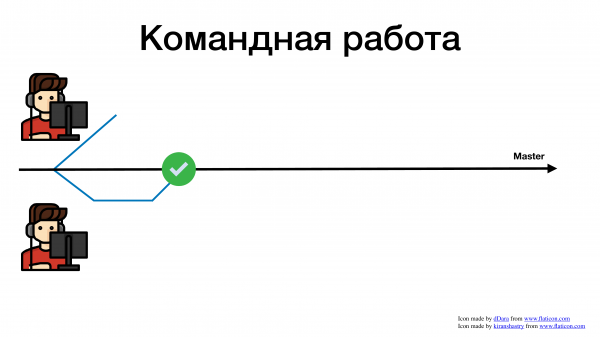
Jeden sa zlúčil, všetko je v poriadku, úlohu odovzdal.
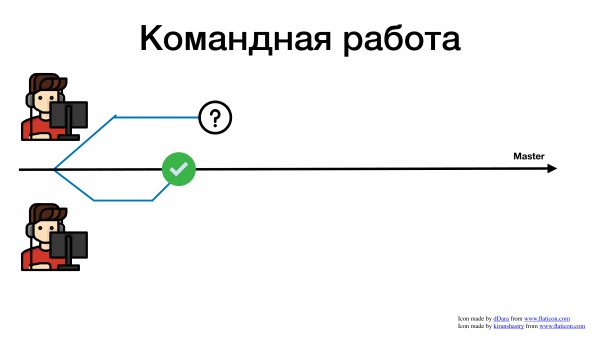
Druhý vývojár medzitým tiež odovzdal svoju úlohu. Predpokladajme, že ju dal na revíziu. Mnohé spoločnosti majú prax – revízie. Z jednej strany je to dobrá a užitočná prax, z druhej strany nás to v mnohom spomaľuje. Nezabúdajme na to, ale tu je skvelý príklad, kam môže viesť problematická história s revíziou. Odovzdali ste pull request na revíziu. Vývojárovi už nie je nič iné na práci. Čo začne robiť? Začne brať iné úlohy.
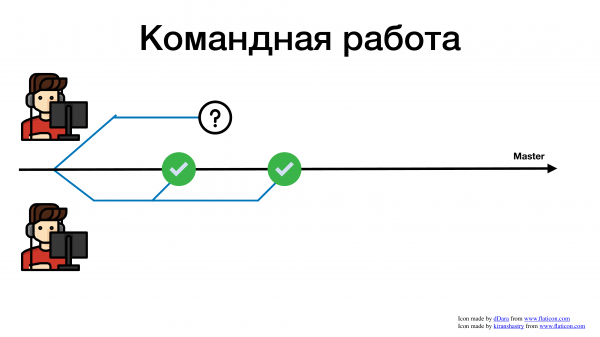
Medzičasom druhý vývojár niečo ďalšie spravil.
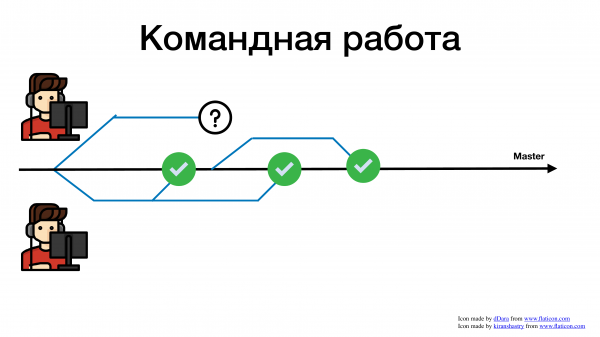
Prvý splnil tretiu úlohu.
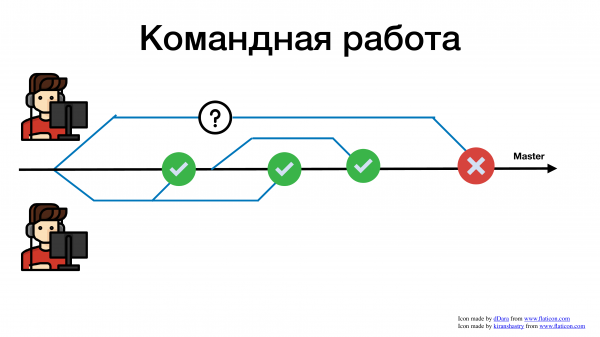
A po nejakom čase, keď bola jeho revízia otestovaná, sa pokúša zlúčiť. A čo sa deje? Narazí na obrovské množstvo konfliktov. Prečo? Pretože kým jeho pull request visel na revízii, v kóde už došlo k mnohým zmenám.
Okrem problémov s konfliktmi existujú aj problémy s komunikáciou. Kým vaša vetva visí na revízii, kým čaká, kým dlhšie pracujete na funkcii, prestávate sledovať, čo sa v kódovej základni vášho servisu mení. Možno to, čo teraz snažíte vyriešiť, už bolo vyriešené včera a môžete sa znovu použiť nejaké metódy. Ale to nevidíte, pretože neustále pracujete so zastaranou vetvou. A táto zastaraná vetva vždy vedie k tomu, že budete musieť riešiť mergenie konfliktov.
Zdá sa, že ak pracujeme v tíme, t. j. nie je to len jedna osoba, ktorá sa hrabe v repozitári, ale 5-10 ľudí, tým dlhšie nepridávame svoj kód do hlavného repozitára, tým viac trpíme, pretože nakoniec budeme musieť niečo zlúčiť. A čím viac máme konfliktov a čím staršiu verziu používame, tým viac problémov máme.
Robiť niečo spoločne je bolestivé! Vždy si navzájom prekážame.
Na túto problematiku sa upozornilo pred viac ako 20 rokmi. Prvé zmienky o praxi Continuous Integration som našiel v extrémnom programovaní.
Extrémne programovanie je prvý agile framework. Stránka sa objavila v roku 96. A bola myšlienka využiť nejaké praktiky programovania, plánovania a iné, aby bola vývojová činnosť čo najflexibilnejšia a aby sme mohli rýchlejšie reagovať na zmeny a požiadavky našich klientov. A pred 24 rokmi začali čeliť tomu, že ak niečo robíte veľmi dlho a oddelene, míňate na to viac času, pretože zažívate konflikty.
Teraz si podrobne rozoberieme spojenie „Continuous Integration“. Ak by sme preložili doslovne, dostaneme nepretržitú integráciu. Ale ako veľmi je nepretržitá, nie je veľmi jasné, je skutočne dosť prerušená. Ale koľko je integrácia, to tiež nie je príliš zrejmé.
A preto vám teraz prinášam citáty z extrémneho programovania. A obidve slová si rozoberieme osobitne.
Integrácia — Ako som už povedal, usilujeme sa o to, aby každý inžinier pracoval s najaktuálnejšou verziou kódu, aby svoj kód pridával čo najčastejšie do spoločnej vetvy, aby to boli malé vetvy. Pretože ak sú veľké, môžeme sa ľahko zaseknúť na týždeň kvôli problémom s zlúčením. Obzvlášť ak máme dlhý vývojový cyklus typu waterfall, kde sa vývojár odíde na mesiac programovať nejakú obrovskú funkciu. A na etape integrácie sa zasekne veľmi dlho.
Integrácia – to je, keď vezmeme našu vetvu a integrujeme ju s hlavným, zlúčime ju. Existuje ultimátny variant, kedy transbase developer, kde sa snažíme o to, aby sme písali priamo do hlavného bez akýchkoľvek zbytočných vetiev.
Celkovo, integrácia – to je vziať svoj kód a dotiahnuť ho do hlavného.
Čo sa tu myslí pod pojmom „continuous“, čo sa nazýva kontinuity? Prax predpokladá, že vývojár sa snaží integrovať svoj kód čo najskôr. To je jeho cieľ pri plnení akejkoľvek úlohy – zabezpečiť, aby sa jeho kód objavil v hlavnej vetve čo najrýchlejšie. V ideálnom svete by to robili každých pár hodín. T. j. vezmeš malú úlohu, zlúčiš ju do hlavnej vetvy. Všetko je skvelé. To je to, čo by si mal dosiahnuť. A je potrebné to robiť nepretržite. Hneď ako niečo urobíš, okamžite to posúvaš do hlavnej vetvy.
A vývojár, ktorý niečo robí, je zodpovedný za to, čo urobil, aby to fungovalo a nič nezlomilo. Tu sa zvyčajne objavuje problém s testami. Chceme spustiť nejaké testy na našom commite, na našom zlúčení, aby sme si overili, že to funguje. A tu vám môže pomôcť Jenkins.
Ale s praxou: poďme robiť zmeny malé, poďme, aby úlohy boli malé, a poďme sa pokúsiť úlohu urobiť a hneď ju zlúčiť do hlavnej vetvy – tu vám žiadne Jenkins nepomôžu. Pretože Jenkins vám pomôže len spustiť testy.
Môžete sa zaobísť aj bez nich. To vám nijako nezabrání. Pretože cieľ praxe je zlúčiť sa čo najčastejšie, aby ste nemíňali obrovské množstvo času na nejaké konflikty v budúcnosti.
Predstavme si, že máme rok 2020 bez internetu. A pracujeme lokálne. Nemáme Jenkins. To je v poriadku. Stále môžete zobrať a urobiť lokálnu vetvu. Napísali ste nejaký kód. Urobili ste úlohu za 3-4 hodiniek. Prepli ste na hlavnú vetvu, urobili git pull, zlúčili ste svoju vetvu. Hotovo. Ak to robíte často – gratulujem, máte Continuous Integration!
Aké sú v modernom svete dôkazy o tom, že to stojí za to? Pretože celkovo je to náročné. Ak to skúsite takto robiť, zistíte, že budete musieť venovať viac času plánovaniu, budete musieť viac času venovať dekompozícii úloh. Pretože ak budete robiť man…, tak sa nebudete môcť rýchlo zlúčiť a dostanete sa do ťažkostí. Vaša prax už nebude.
A to bude drahé. Začať pracovať na Continuous Integration od zajtra nebude možné. Všetci sa budete veľmi dlho zvykať, veľmi dlho sa budete učiť rozdeľovať úlohy, veľmi dlho sa budete učiť prepracovávať praktiku revízie, ak ju máte. Pretože naším cieľom je, aby to bolo zlúčené dnes. A ak vykonávate revíziu počas troch dní, máte problémy a Continuous Integration sa vám nedarí.
Ale máme nejaké aktuálne dôkazy práve teraz, ktoré nám hovoria, že investovať do tejto praxe má zmysel?
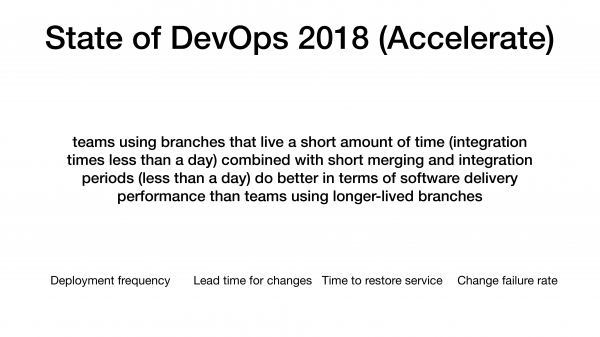
Prvá vec, ktorá mi napadla – to je State of DevOps. Je to výskum, ktorý chlapci robia už 7 rokov. Momentálne to robia ako nezávislá organizácia, ale pod Google.
A ich výskum z roku 2018 ukázal koreláciu medzi spoločnosťami, ktoré sa snažia používať krátkodobé vetvy, ktoré sa integrujú rýchlo a často, a majú oveľa lepšie ukazovatele výkonu IT.
Aké sú to ukazovatele? To sú štyri metriky, ktoré zbierajú zo všetkých spoločností vo svojich prieskumoch: frekvencia nasadenia, čas na zmeny, čas na obnovenie služby, miera zlyhania zmien.
A predovšetkým existuje táto korelácia, vieme, že spoločnosti, ktoré sa často zlúčujú, majú tieto metriky výrazne lepšie. A robia rozdelenie spoločností do niekoľkých kategórií: sú to pomalé spoločnosti, ktoré produkujú niečo pomaly, stredne výkonné, vysoce výkonné a elita. Elita – to je Netflix, Amazon, ktorí sú super rýchli, robia všetko rýchlo, pekne a kvalitne.
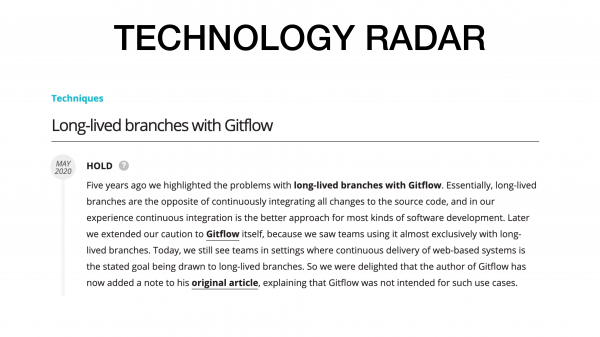
Druhá vec, ktorá sa stala len pred mesiacom. V Technology Radar sa objavil skvelý článok o Gitflow. Gitflow sa líši od ostatných tým, že jeho vetvy žijú dlho. Existujú release vetvy, ktoré žijú dlho, a feature vetvy, ktoré tiež žijú dlho. Táto prax v Technology Radar bola umiestnená do HOLD. Prečo? Pretože sa ľudia stretávajú s bolesťou integrácie.
Ak ti vetva žije veľmi dlho, zasekne sa, zhorší sa, začíname tráviť viac času na to, aby sme do nej priniesli akúkoľvek zmenu.
Nedávno autor Gitflow povedal, že ak sa zameriavate na kontinuálnu integráciu a snažíte sa vydávať aktualizácie čo najčastejšie, potom Gitflow nie je dobrým nápadom. V článku ďalej uviedol, že ak máte backend, kde sa tomu môžete prispôsobiť, Gitflow je pre vás zbytočný, pretože vás spomalí a spôsobí problémy s integráciou.
To však neznamená, že Gitflow je zlý a nemali by ste ho používať. Je to pre iné situácie. Napríklad, keď potrebujete podporovať viacero verzií služby alebo aplikácie, t.j. tam, kde potrebujete zabezpečiť podporu po dlhší čas.
Avšak, ak sa porozprávate s ľuďmi, ktorí takéto služby podporujú, počujete veľa sťažností o tom, že verzia bola 3.2, ktorá bola pred 4 mesiacmi, a nemenila sa kvôli tomu, že tento fix nebol aplikovaný a teraz, aby ho mohli implementovať, musia urobiť množstvo zmien. A tak sa znovu zasekli a teraz sa týždeň snažia zmergovať nejakú novú funkciu.
Ako správne poznamenal Alexander Kovaljov v chate, korelácia nie je rovná príčinno-následkovej súvislosti. To je pravda. T.j. neexistuje priamy vzťah, že ak máte kontinuálnu integráciu, všetky metriky budú skvelé. Nie. Ale existuje pozitívna korelácia, že ak platí jedno, pravdepodobne to platí aj pre druhé. Nie je to fakt, ale pravdepodobne. To je len korelácia.
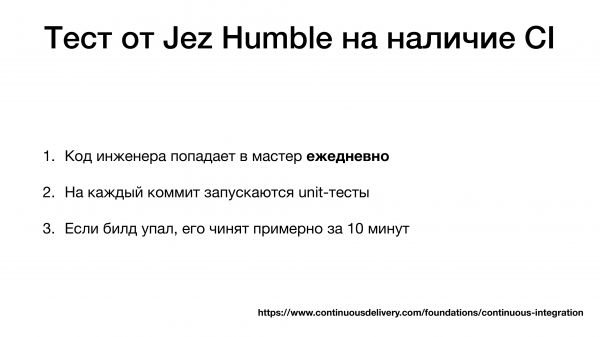
Zdá sa, že už niečo robíme, zdá sa, že sa už merge-ujeme, ale ako zistiť, že kontinuálna integrácia naozaj existuje a že sa dostatočne často merge-ujeme?
Jez Humble je autorom Handbook, Accelerate, webu Continuous Delivery a knihy 'Continuous Delivery'. Navrhuje takýto test:
- Kód inžiniera sa dostáva do hlavnej vetvy každý deň.
- Na každý commit spúšťate unit testy.
- Build v hlavnej vetve zlyhal, opravený bol asi za 10 minút.
Navrhuje používať tento test, aby ste mali istotu, že prax skutočne existuje.
Posledný bod považujem za trochu sporný. T. j. ak dokážete opraviť problém za 10 minút, znamená to, že máte Continuous Integration, čo znie trochu zvláštne, ale má to svoje opodstatnenie. Prečo? Pretože ak sa často mergenete, znamená to, že zmeny sú malé. Ak by malá zmena spôsobila rozpad build-u mastera, môžete rýchlo nájsť problém, pretože zmena je malá. Napríklad ste spravili malý merge, kde sa zmenilo 20-30 riadkov. A preto môžete rýchlo zistiť, aký bol problém, pretože zmeny sú drobné, máte veľmi malú oblasť na vyhľadanie chyby.
A aj keď sa nám po releasovaní rozpadne prod, ak máme prax Continuous Integration, je nám oveľa ľahšie konať, pretože zmeny sú malé. Áno, to ovplyvní plánovanie. Bude to bolestivé. A asi najťažšie na tejto praxi je zvyknúť si rozdeľovať úlohy, t. j. ako spraviť niečo za pár hodín a prejsť revíziou, ak nejakú máte. Revízia je osobitná bolesť.
Unit testy sú len pomocník, ktorý vám pomáha pochopiť, či vaša integrácia prebehla úspešne, či sa nič neporušilo. Podľa môjho názoru to nie je úplne povinný bod, pretože zmysel praxe nie je v tom.
Toto je krátke o Continuous Integration. To je všetko, čo táto prax zahŕňa. Som pripravený na otázky.
Stručne ešte raz zhrniem:
- Continuous Integration nie je Jenkins, nie je to Gitlab.
- Nie je to nástroj, je to prax o tom, že čo najčastejšie mergeneme náš kód do mastera.
- Robíme to preto, aby sme sa vyhli obrovským problémom, ktoré vznikajú s mergovaním v budúcnosti, t. j. prežívame malú bolesť teraz, aby sme v budúcnosti nezažili veľkú. V tom je celý zmysel.
- Na strane prebieha komunikácia cez kód, ale to veľmi zriedka vidím, ale na to je to tiež zamýšľané.
Otázky
Čo robiť s nedekomponovanými úlohami?
Dekomponovať. Aký je problém? Môžete uviesť príklad, že úloha sa nedekomponuje?
Sú také úlohy, ktoré nemožno dekomponovať od slova „úplne“, napríklad tie, ktoré si vyžadujú veľmi hlbokú odbornú znalosť a ktoré sa reálne dajú riešiť niekoľko mesiacov, aby dosiahli nejaký prijateľný výsledok.
Ak som ťa správne pochopil, existuje nejaká veľká a zložitá úloha, ktorej výsledok uvidíme až o mesiac?
Áno, je to pravda. Áno, výsledok sa bude dať posúdiť najskôr o mesiac.
Dobre. V podstate to nie je problém. Prečo? Pretože v tomto prípade, keď hovoríme o vetvách, nehovoríme o vetve s funkciou. Funkcie môžu byť veľké a zložité. Môžu zasahovať do mnohých komponentov. A možno ich nemôžeme spraviť úplne v jednej vetve. To je normálne. Musíme to len rozdeliť. Ak funkcia nie je úplne pripravená, neznamená to, že nejaké jej časti kódu nemôžeme zlúčiť. Pridal si napríklad migráciu a vo vnútri funkcie sú nejaké fázy. Máš napríklad fázu – urobiť migráciu, pridať novú metódu. A tieto veci už môžeš zlúčiť denne.
Dobre. Aký má teda zmysel?
Aký je zmysel zlúčiť malé veci denne?
Áno.
Ak ti niečo pokazili, hneď to vidíš. Máš malý kúsok, ktorý niečo pokazil, a je jednoduchšie to opraviť. Zmysel je v tom, že zlúčiť malý kúsok teraz je omnoho jednoduchšie, než zlúčiť niečo veľké o niekoľko týždňov. A tretí zmysel je, že iní inžinieri budú pracovať s už aktuálnou verziou kódu. Uvidia, že tu sa pridali nejaké migrácie, a tu sa objavila nejaká metóda, ktorú možno tiež budú chcieť použiť. Všetci budú vidieť, čo sa deje v tvojom kóde. Práve kvôli týmto trom veciam sa táto prax robí.
Ďakujem, otázka je uzavretá!
(Oleg Soroka) Môžem pridať? Povedal si to správne, ale chcem pridať iba jednu vetu.
Tak.
Pri Continuous Integration sa kód zlúči do hlavnej vetvy nie vtedy, keď je funkcia úplne hotová, ale vtedy, keď prestane byť build rozbitý. A môžete odvážne commitovať do mastera koľkokrát chcete denne. Druhý aspekt – ak z nejakého dôvodu nemôžete rozdeliť mesačnú úlohu aspoň na úlohy po tri dni, nemlčím o troch hodinách, znamená to, že máte obrovský problém. A fakt, že nemáte Continuous Integration, je najmenej z týchto problémov. Znamená to, že máte problémy s architektúrou a inžinierske praktiky sú na nule. Pretože aj ak ide o výskum, aj tak to treba spracovať vo forme hypotéz alebo cyklu.
Hovorili sme o 4 metrikách, ktoré oddeľujú úspešné spoločnosti od tých zaostávajúcich. Je však potrebné dosiahnuť týchto 4 metrik. Ak vám priemerná úloha trvá mesiac, zameral by som sa najskôr na túto metriku. Znížil by som ju najprv na 3 dni. A až potom začal uvažovať o Continuous.
Správne som ťa pochopil, že si myslíš, že investovať do inžinierskych praktík, keď ti akákoľvek úloha trvá mesiac, ešte nemá zmysel?
Máš Continuous Integration. A tam je téma, že za 10 minút buď opravíš chybu, alebo vrátiš späť. Predstav si, že si to nasadil. A máš aj continuous deployment, nasadil si to na prod a až potom si si všimol, že niečo nešlo ako malo. A teraz to musíš vrátiť späť, ale už sa ti uskutočnila migrácia databázy. Už máš schému databázy novej verzie, navyše sa už vytvoril nejaký záložný systém, do ktorého sa zapísali dáta.
Akú alternatívu máš? Ak sa vraciaš späť kódom, už nemôže fungovať s touto aktualizovanou databázou.
Databáza sa posúva len dopredu, áno.
U ľudí, ktorí majú slabé inžinierske praktiky, pravdepodobne nikdy nečítali ani hrubú knihu o ... čo robiť so zálohami? Ak sa obnovíš zo zálohy, tak znamená, že strácaš dáta, ktoré sa počas tejto doby nazbierali. Napríklad, pracovali ste tri hodiny s novou verziou databázy, už sa tam registrovali používatelia. Ak sa vrátiš k starej zálohe, pretože so novou verziou schéma nefunguje, tak týchto používateľov si stratil. A sú nespokojní, sťažujú sa.
Aby ste ovládli všetky praktiky podporujúce Continuous Integration a Continuous Delivery, nestačí sa naučiť len písať... Po prvé, môže ich byť veľmi veľa, čo by bolo nepraktické. Navyše existuje množstvo ďalších praktík, ako sú Scientific. Existuje praktika, ktorú popularizoval GitHub, keď sa súčasne vykonáva starý aj nový kód. Keď robíte nedokončenú funkciu, ktorá môže vrátiť nejakú hodnotu: buď ako funkcia, alebo ako Rest API. Vykonávate nový kód aj starý kód a porovnávate rozdiel medzi nimi. A ak existuje rozdiel, logujete túto udalosť. Takto viete, že vaša nová funkcia je pripravená na nasadenie nad starú, ak v určitom období neexistovali rozdiely medzi týmito dvoma.
Takých praktík sú stovky. Navrhol by som začať s transbase development. Nie je to 100 % na Continuous Integration, ale praktiky sú rovnaké, jedno bez druhého zle funguje.
Spomenul si transbase development ako príklad, kde sa dajú pozerať praktiky, alebo navrhuješ ľuďom začať používať transbase development?
Pozrieť, pretože ich nemôžu použiť. Aby ich mohli používať, musia si veľa prečítať. A keď má človek otázku: 'Čo robiť s funkciou, ktorá trvá mesiac', znamená to, že nečítali o transbase development. A ani by som zatiaľ neodporúčal. Odporučil by som sa sústrediť výlučne na tému, ako správne architektonicky rozdeliť veľké úlohy na menšie. O tom je podstata dekompozície.
Dekompozícia je jedným z nástrojov architektov. Najprv robíme analýzu, potom dekompozíciu, potom syntézu a potom integráciu. A takto nám všetko do seba zapadá. A pred Continuous Integration treba ešte dorásť cez dekompozíciu. Otázky vznikajú v prvej fáze, a už hovoríme o štvrtej fáze, teda čím častejšie robiť integráciu, tym lepšie. Ešte je príliš skoro na to, je lepšie najprv rozrezať svoj monolit.
Je potrebujete nakresliť niekoľko šípok a štvrcov na nejakú schému. Nemôžete povedať, že teraz ukážem architektonickú schému novej aplikácie a zobraziť jeden štvorec, v ktorom je zelené tlačidlo na aplikáciu. V každom prípade bude viac štvrcov a šípok. Na akejkoľvek schéme, ktorú som videl, ich bolo viac ako jeden. A dekompozícia sa už robí aj na úrovni grafického zobrazenia. Preto môžu byť štvrcy nezávislé. Ak nie, mám veľké otázky na architekta.
Je tu otázka z chatu: „Ak je revízia povinná a trvá dlhšie, niekde jeden deň a viac?“.
Máte problémy s praktikou. Revízia by nemala trvať jeden deň a viac. To je rovnaký príbeh ako k predchádzajúcej otázke, len o niečo jemnejší. Ak revízia trvá deň, znamená to, že pravdepodobne ide o revíziu veľmi veľkej zmeny. To znamená, že by sa mala robiť menšia. V transbase development, ktorý Oleg odporučil, je taká história nazývaná kontinuálna revízia. Jej idea spočíva v tom, že úmyselne robíme tak malé pull requesty, pretože sa snažíme zlúčiť neustále a po malých častiach. A preto pull request mení jednu abstrakciu alebo 10 riadkov. Vďaka tomu revízia trvá pár minút.
Ak revízia trvá deň a viac, niečo nie je v poriadku. Po prvé, možno máte nejaké problémy s architektúrou. Alebo ide o veľký kus kódu, napríklad o 1 000 riadkov. Alebo máte tak zložitú architektúru, že ju osoba nemôže pochopiť. To je problém z inej strany, ale ten sa tiež bude musieť vyriešiť. Možno nie je potrebná žiadna revízia. Nad týmto by ste mali tiež uvažovať. Revízia je tá vec, ktorá vás brzdí. Prináša svoje výhody vo všeobecnosti, ale musíte pochopiť, prečo to robíte. Je to pre vás spôsob, ako rýchlo odovzdať informácie, je to pre vás spôsob, ako nastaviť nejaké štandardy, alebo čo? Prečo to potrebujete? Pretože revíziu treba robiť buď veľmi rýchlo, alebo ju úplne zrušiť. Je to ako transbase development – veľmi pekný príbeh, ale len pre zrelých chlapcov.
Pokiaľ ide o 4 metriky, odporučil by som ich sledovať, aby ste pochopili, k čomu to vedie. Pozrite sa na čísla, pozrite sa na obrázok, aké to všetko zlé.
(Dmitrij) Som ochotný sa s tebou o tom porozprávať. Čísla a metriky sú super, prax je super. Ale treba pochopiť, či to podnikaniu pomôže. Existujú podniky, ktorým nie je potrebná taká rýchlosť zmien. Poznám firmy, kde nemožno uskutočňovať zmeny každých 15 minút. A nie preto, že by boli zlé. To je ich životný cyklus. A na to, aby ste mohli robiť vlastnosti branches, vlastnosti toggle, potrebujete hlboké znalosti.
Je to zložité. Ak by ste chceli prečítať históriu o vlastnosti toggle podrobnejšie, určite odporúčam. . A je tu skvelý článok od Martina Fowlerea o vlastnostiach toggle: aké typy existujú, životné cykly a podobne. Vlastnosť toggle je zložitá.
A predsa si neodpovedal na otázku: "Je Jenkins potrebný alebo nie?"
Jenkins naozaj nie je potrebný v žiadnom prípade. Ak sa seriózne zamyslím, nástroje ako Jenkins a Gitlab vám uľahčia prácu. Uvidíte, či sa zostava podarila alebo nie. Môžu vám pomôcť, ale neprinesú vám prax. Môžu vám iba ukázať, že to bolo v poriadku – O.K., nie O.K. A to ešte len v prípade, že píšete testy, pretože ak nemáte testy, je to takmer bezvýznamné. Preto je potrebný, pre pohodlnosť, ale celkovo môžete žiť aj bez neho, veľa nestratíte.
T. j. ak máte prax, tak to znamená, že ho nepotrebujete?
Správne. Odporúčam test Jez Humble. Mám k poslednému bodu dvojitý vzťah. Ale vo všeobecnosti, ak máte tri veci, stále sa zlúčujete, spúšťate testy na commity v masteri, rýchlo opravujete build v masteri, tak možná nepotrebujete nič viac.
Kým čakáme na otázky od účastníkov, mám otázku. Teraz sme hovorili o produktovom kóde. Ale používal si aj na infraštruktúrny kód? Je to ten istý kód, má tie isté princípy a rovnaký životný cyklus, alebo sú tam iné životné cykly a princípy? Zvyčajne, keď všetci hovoria o kontinuálnej integrácii a vývoji, zabúdajú, že existuje aj infraštruktúrny kód. A v poslednej dobe ho pribúda a treba tam priniesť všetky tieto pravidlá?
Nie je to len o tom, že by malo, určite to bude skvelé, pretože to určite zjednoduší život. Hneď ako pracujeme s kódom, nie so skriptami na bash, máme normálny kód.
Stop-stop, skript na bash je tiež kód. Netrhaj moju starú lásku.
Dobre, nebudem ti šliapať po spomienkach. Mám k bashu osobný odpor. Rozpadá sa nekorektne a strašidelne neustále. A je to často nepredvídateľné, preto ho veľmi nemám rád. Ale dobre, predpokladajme, že máš kód v bash. Možno sa v tom naozaj nevyznám a existujú tam normálne testovacie rámce. Proste nie som v téme. A dosahujeme tie isté výhody.
Akonáhle pracujeme s infraštruktúrou ako s kódom, dostávame všetky tie isté problémy ako vývojári. Pred niekoľkými mesiacmi som sa stretol so situáciou, kedy mi kolega poslal pull request na 1 000 riadkov v bashe. A ty si zasekneš na revízii na 4 hodiny. Problémy sú tie isté. Stále je to kód. A stále je to spolupráca. Zasekávame sa s pull requestami a máme rovnaké merge konflikty toho istého bash, napríklad.
Teraz sledujem celú túto vec na maximálne krásnom programovaní infraštruktúry. Práve som zaviedol do infraštruktúry Pulumi. Je to programovanie v čistej forme. Je to tam ešte atraktívnejšie, pretože mám všetky možnosti programovacieho jazyka, t.j. s rovnakými ifmi som na doskách vytvoril krásne toggly a všetko je v poriadku. T.j. moja zmena je už v masteri. Už ju všetci vidia. Ostatní inžinieri o nej vedia. Už to malo na niečo vplyv. Ale pritom to nebolo zapnuté pre všetku infraštruktúru. Zaplo sa to napríklad pre moje testovacie prostredia. Takže odpovedajúc na tvoju otázku ešte raz, je to potrebné. Uľahčuje nám to život ako inžinierom, ktorí pracujú s kódom.
Má niekto ďalšie otázky?
Mám otázku. Chcem pokračovať diskusiu s Olegom. V zásade si myslím, že máš pravdu, že ak ti úloha trvá mesiac, máš problém s architektúrou, máš problém s analýzou, dekompozíciou, plánovaním atď. Ale mám taký pocit, že ak sa začneš snažiť žiť podľa Continuous Integration, začneš opraviť bolesti s plánovaním, pretože s tým sa už nikde inde nevyhneš.
(Oleg) Áno, je to tak. Po náročnosti je táto prax porovnateľná s akoukoľvek inou vážnou praxou, ktorá mení kultúru. Najťažšie pri prekonávaní sú zvyky, najmä zlé návyky. A ak na implementáciu tejto praxe potrebujete zásadnú zmenu návykov okolí: vývojárov, vedenia, produkčných manažérov, čakajú vás prekvapenia.
Aké môžu byť prekvapenia? Predpokladajme, že ste sa rozhodli častejšie vykonávať integráciu. A na integrácii máte naviazané nejaké ďalšie veci, predpokladajme, že artefakty. A vo vašej spoločnosti napríklad platí politika, že každý artefakt musí byť nejakým spôsobom zaznamenaný v systéme skladovania artefaktov. A to si vyžaduje určitý čas. Človek musí zaškrtnúť, že ako release manažér schválil tento artefakt na pripravenosť na nasadenie do produkcie. Ak to trvá 5-10-15 minút, ale zároveň robíte nasadenie raz týždenne, tak raz týždenne stratiť pol hodiny – to je malá daň.
Ak robíte Continuous Integration 10-krát za deň, určite potrebujete 10-krát vynásobiť tých 30 minút. A to presahuje počet pracovného času tohto release manažéra. Jednoducho sa unaví to robiť. Existujú neustále náklady na niektoré praxí. A všetko.
A potrebujete buď zrušiť toto pravidlo, aby ste sa už nezapodievali takými nezmyslami, t.j. manuálne nepriraďujete stupeň k tomu, čo je k niečomu. Úplne sa spoliehate na nejakú automatizovanú sadu testov pripravenosti.
A ak potrebujete potvrdenie od niekoho, aby hlavný schválil, a nevstupujete do produkcie bez toho, že Vám povedal, že to povolil, a tak ďalej – celé toto bláznovstvo stojí na ceste praxiam. Pretože ak existujú nejaké aktivity spojené s daňou, všetko sa tisíckrát zväčší. Preto bude posun často vnímaný nie všetkými s radosťou. Pretože zvyky ľudí sa ťažko opravujú.
Keď človek robí zvyčajnú prácu, robí to takmer bez premýšľania. Jej kognitívna záťaž je rovná nule. Jednoducho sa pustí do hotového, v hlave má už checklist, robil to tisíc ráz. A akonáhle prídeš a povieš mu: „Zrušme túto prax a od pondelka zavedieme novú,“ pre neho sa to stane obrovskou kognitívnou záťažou. Navyše je to náročné pre všetkých naraz.
Preto je najjednoduchšie, pravda, túto nádheru si nemôže každý dovoliť, ale ja to vždy robím presne takto. Ak sa spúšťa nový projekt, zvyčajne sa do tohto projektu natlačia všetky neskúšané praktiky. Kým je projekt mladý, veľmi neriskujeme. Prod ešte nie je, nemáme čo pokaziť. Preto je to možné použiť ako tréning. Takýto prístup funguje. Ale nie všetky spoločnosti majú možnosť často spúšťať také projekty. Hoci je to tiež trochu zvláštne, pretože teraz prebieha digitalizácia, všetci by mali spúšťať experimenty, aby dobehli konkurenciu.
Tu narazíš na to, že najprv musíš mať pochopenie toho, čo chceš robiť. Svet nie je dokonalý, ani prod nie je dokonalý.
Áno, tieto veci sú prepojené.
Aj podniky nemajú vždy jasno v tom, že musia ísť presne tam.
Existuje situácia, v ktorej nie sú možné žiadne zmeny. Je to situácia, keď je na tím vyvíjaný tlak. Tím je už dosť vyčerpaný. Nemá žiadny čas na experimenty. Od rána do večera vyvíjajú funkcie. A vedeniu stále nestačia existujúce funkcie. Požiadavky rastú. V takej situácii nie sú možné žiadne zmeny. Tím môže len povedať, že zajtra budeme robiť rovnako ako včera, len potrebujeme urobiť o niečo viac funkcií. Žiadne prechody na žiadne praktiky v tomto zmysle nie sú možné. Je to klasická situácia, keď nie je čas na brúsenie sekery, treba rúbať stromy, preto sa rúbe tupou sekerou. Tu niet jednoduchých rád.
(Dmitrij) Prečítam objasnenie z chatu: „Ale je potrebné veľké pokrytie testami na rôznych úrovniach. Koľko času sa venuje testom? Akosi je to drahé, zaberá to veľa času“.
(Oleg) Toto je klasický mýtus. Testov by malo byť dostatok na to, aby ste mali istotu. Kontinuálna integrácia nie je niečo, čo začínate až po 100 % testoch. Kontinuálna integrácia znižuje vašu kognitívnu záťaž tým, že každá z vyjadrených zmien je tak očividná, že pochopíte, či niečo rozbije alebo nie, aj bez testov. Rýchlo si to môžete overiť v hlave, pretože sú to drobné zmeny. Aj keď máte len manuálnych testerov, je to pre nich jednoduchšie. Urobili ste nasadenie a povedali: „Pozri, nič sa nerozbilo?“. Oni skontrolovali a povedali: „Nie, nič sa nerozbilo.“ Pretože tester vie, na čo sa má pozrieť. Vaša jedna zmena je spojená s jedným fragmentom kódu. A to sa prejavuje konkrétnym správaním.
Toto si, samozrejme, trošku prehnal.
(Dmitrij) Tu sa s tebou nezhodnem. Existuje prax – vývoj cez testovanie, ktorá ťa od toho presne ochráni.
(Oleg) Ešte som sa k tomu nedostal. Prvá ilúzia je, že musíte napísať práve 100 % testov, alebo sa kontinuálnou integráciou nemáte vôbec zaoberať. To nie je pravda. Ide o dve paralelné praktiky. A tie priamo nesúvisia. Vaše pokrytie testami by malo byť optimálne. Optimálne znamená, že ste si istí, že kvalita vášho kódu po commite vám umožňuje s istotou stlačiť tlačidlo „Deploy“ v piatok večer aj v podnapitom stave. Ako to dosiahnete? Prostredníctvom revízií, cez pokrytie, cez dobrý monitoring.
Dobrý monitoring sa nijako nelíši od testov. Ak spúšťate testy raz na preprodukcii, skontrolujú všetky vaše používateľské scenáre a to je všetko. Ale ak ich spúšťate v neustálem cykle, potom toto je váš rozšírený systém monitorovania, ktorý neustále testuje – padlo to alebo nie. V tomto prípade je rozdiel len v jednorazovosti alebo opakovanosti. Veľmi dobrý súbor testov …, ktoré sú spúšťané do nekonečna, je monitoring. A správny monitoring by mal byť taký.
A preto, ako presne dosiahnete ten stav, keď v piatok večer nasadíte a odídete domov, je iná otázka. Možno ste jednoducho nebojácny blázon.
Poďme sa na chvíľu vrátiť k Continuous Integration. Trochu sme sa odklonili do inej zložitej praktiky.
A druhá ilúzia je, že MVP, hovorí sa, že treba robiť rýchlo, preto sú testy úplne zbytočné. Nie je to celkom pravda. Ide o to, že keď píšete user story pre MVP, môžete ju vyvíjať buď na oko, t.j. počuli ste, že existuje nejaká user story a okamžite ste sa pustili do kódovania, alebo pracovať podľa TDD. A podľa TDD, ako ukazuje prax, to netrvá dlhšie, to znamená, že testy sú vedľajším produktom. Prax TDD nespočíva v testovaní. Napriek názvu Test Driven Development, vôbec nejde o testy. Ide skôr o architektonický prístup. Je to prístup, ako písať presne to, čo potrebujete, a nepísať to, čo nepotrebujete. Táto prax je zameraná na ďalšiu iteráciu vášho myšlenia v kontexte vytvárania architektúry aplikácie.
Preto sa týchto ilúzií tak ľahko nezbavíte. MVP a testy si navzájom neodporujú. Skôr naopak, ak robíte MVP podľa praxe TDD, urobíte to lepšie a rýchlejšie, ako keby ste to robili bez praxe, len na oko.
To je veľmi nejasná a zložitá myšlienka. Keď počujete, že teraz budem písať ešte testy a pritom niečo urobím rýchlejšie, znie to absolútne neprirodzene.
(Dmitrij) Mnohí, keď hovoria o MVP, len sa im nechce písať niečo normálne. A to sú predsa len rôzne veci. Netreba z MVP robiť nejakú zlú vec, ktorá nefunguje.
Áno, máš pravdu.
A potom náhle MVP v produkcii.
Navždy.
A TDD znie veľmi nezvykle, keď počujete, že píšete testy a predsa robíte viac práce. Znie to veľmi zvláštne, ale v skutočnosti to takto prebieha rýchlejšie a efektívnejšie. Keď píšete test, už v hlave premýšľate o tom, aký kód a ako bude volaný, ako aj aké správanie od neho očakávame. Nepovedali ste len, že ste napísali nejakú funkciu a tá niečo robí. Najprv ste si povzdychli, aké podmienky má, akým spôsobom bude volaná. Toto pokrývate testami a z toho chápete, ako budú vyzerať rozhrania vo vašom kóde. To veľmi silno ovplyvňuje architektúru. Váš kód sa automaticky stáva modulárnejším, lebo najprv sa snažíte pochopiť, ako ho budete testovať, a až potom ho napíšete.
S TDD som mi to vyšlo tak, že v určitom momente som si na Ruby najal mentora, keď som ešte bol programátorom na Ruby. A on hovorí: „Poď, budeme robiť podľa TDD.“ A ja si myslím: „Fíha, ešte niečo ďalšie písať.“ A dohodli sme sa, že počas dvoch týždňov budem písať celý funkčný kód na Pythone podľa TDD. Po dvoch týždňoch som zistil, že späť už nechcem. Počas dvoch týždňov, kedy som sa to snažil aplikovať všade, som pochopil, ako veľmi mi to uľahčilo aj len premýšľanie. Ale nie je to zrejmé, preto všetkým odporúčam, že ak máte pocit, že TDD je zložitá, zdĺhavá a nadbytočná, skúste sa toho držať len dva týždne. Mne stačili na to dva.
(Dmitrij) Môžeme túto myšlienku rozvinúť z pohľadu prevádzky infraštruktúry. Predtým, ako niečo nové spustíme, robíme monitoring a až potom spúšťame. V tomto prípade sa náš monitoring stáva normálnym testovaním. A existuje vývoj cez monitoring. Ale takmer všetci hovoria, že je to zdĺhavé, mám leniví, urobil som dočasný náčrt. Ak sme urobili poriadny monitoring, chápeme stav systému CI. A v systéme CI je veľa monitorovania. Chápeme stav systému, vieme, čo je vnútri. A počas vývoja práve vytvárame systém, aby dosiahol požadovaný stav.
Tieto praktiky sú už dlho známe. O tom sme hovorili pred asi 4 rokmi. Ale za 4 roky sa prakticky nič nezmenilo.
Ale na tejto note navrhujem oficiálnu diskusiu ukončiť.
Video (vložené ako mediálny prvok, ale prečo to nefunguje):
Zdroj: habr.com
