

Na akých princípoch je postavený dokonalý Dátový Sklad?
Zameranie na obchodnú hodnotu a analytiku bez boilerplate kódu. Správa DWH ako kódovej základne: verzionovanie, recenzia, automatizované testovanie a CI. Modularita, rozšíriteľnosť, otvorený zdrojový kód a komunita. Priateľská používateľská dokumentácia a vizualizácia závislostí (Data Lineage).
O všetkom tomto podrobnejšie a o úlohe DBT v ekosystéme Big Data & Analytics — vitajte pod kat.
Ahojte všetci
Na spojení je Artemij Kozyr. Už viac ako 5 rokov pracujem s dátovými skladmi, zaoberám sa budovaním ETL/ELT, ako aj analytikou a vizualizáciou dát. V súčasnosti pracujem v , učím na OTUS v kurze , a dnes sa chcem s vami podeliť o článok, ktorý som napísal pred spustením nového cyklu na kurz.
Krátky prehľad
Rámec DBT — to všetko o písmene T v akronyme ELT (Extract — Transform — Load).
S príchodom takých výkonných a škálovateľných analytických databáz ako BigQuery, Redshift, Snowflake, vymizol akýkoľvek zmysel robiť transformácie mimo Dátového Skladu.
DBT nevyťahuje dáta zo zdrojov, ale poskytuje obrovské možnosti na prácu s údajmi, ktoré sú už načítané v Sklade (v Internal alebo External Storage).
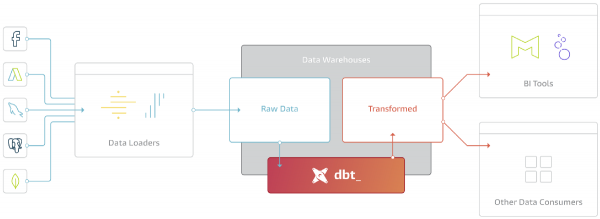
Hlavným účelom DBT je vziať kód, skompilovať ho do SQL, vykonať príkazy v správnom poradí v Sklade.
Štruktúra projektu DBT
Projekt pozostáva z dvoch typov adresárov a súborov:
- Model (.sql) — jednotka transformácie vyjadrená SELECT dotazom
- Konfiguračný súbor (.yml) — parametre, nastavenia, testy, dokumentácia
Na základnej úrovni sa práca organizuje týmto spôsobom:
- Používateľ pripravuje kód modelov v ktoromkoľvek obľúbenom IDE
- Pomocou CLI sa spúšťa vykonanie modelov, DBT kompiluje kód modelov do SQL
- Skompilovaný SQL kód sa vykonáva v Sklade v zadanom poradí (graf)
Takto môže vyzerať spustenie z CLI:
Všetko je SELECT
To je killer-funkcia rámca Data Build Tool. Inými slovami, DBT abstrahuje všetok kód súvisiaci s materializáciou vašich dotazov v Sklade (variácie príkazov CREATE, INSERT, UPDATE, DELETE ALTER, GRANT, …).
Každý model predpokladá napísanie jedného SELECT dotazu, ktorý definuje výslednú dátovú sadu.
Logika transformácií môže byť viacúrovňová a konsolidovať údaje z niekoľkých iných modelov. Príklad modelu, ktorý vytvorí vitrínu objednávok (f_orders):
{% set payment_methods = ['credit_card', 'coupon', 'bank_transfer', 'gift_card'] %}

with orders as (

   select * from {{ ref('stg_orders') }}

),

order_payments as (

   select * from {{ ref('order_payments') }}

),

final as (

   select
       orders.order_id,
       orders.customer_id,
       orders.order_date,
       orders.status,
       {% for payment_method in payment_methods -%}
       order_payments.{{payment_method}}_amount,
       {% endfor -%}
       order_payments.total_amount as amount
   from orders
       left join order_payments using (order_id)

)

select * from final
Čo zaujímavé tu môžeme vidieť?
Po prvé: Použité CTE (Common Table Expressions) — na organizáciu a pochopenie kódu, ktorý obsahuje veľa transformácií a obchodnej logiky
Po druhé: Kód modelu — je to zmiešanina SQL a jazyka (templovací jazyk).
V príklade je použitý cyklus for na vytvorenie súm pre každú metódu platby uvedenú vo výraze set. Tiež sa používa funkcia ref — možnosť odkazovať vnútri kódu na iné modely:
- Počas kompilácie ref bude pretransformovaný na cieľový ukazovateľ na tabuľku alebo pohľad v Úložisku
- ref umožňuje vytvoriť graf závislostí modelov
Presne to pridáva do DBT takmer neobmedzené možnosti. Najčastejšie používané z nich sú:
- If / else statements — podmienečné príkazy
- For loops — cykly
- Variables — premenné
- Macro — vytváranie makier
Materializácia: Table, View, Incremental
Stratégia materializácie — prístup, podľa ktorého bude výsledný súbor údajov modelu uložený v Úložisku.
V základnom pohľade je to:
- Table — fyzická tabuľka v Úložisku
- View — pohľad, virtuálna tabuľka v Úložisku
Existujú aj zložitejšie stratégie materializácie:
- Incremental — inkrementálne načítanie (veľkých faktových tabuliek); nové riadky sú pridávané, zmenené — aktualizované, odstránené — odstraňované
- Ephemeral — model sa priamo nematerializuje, ale zúčastňuje sa ako CTE v iných modeloch
- Akékoľvek iné stratégie, ktoré môžete pridať samostatne
Okrem stratégií materializácie sa otvárajú možnosti pre optimalizáciu pre konkrétne Úložiská, napríklad:
- Snowflake: Transient tables, Merge behavior, Table clustering, Copying grants, Secure viewsRedshift: Distkey, Sortkey (interleaved, compound), Late Binding Views
- BigQuery: Table partitioning & clustering, Merge behavior, KMS Encryption, Labels & TagsSpark
- BigQuery:Table partitioning & clustering, Merge behavior, KMS Encryption, Labels & Tags.
- Spark: Formát súboru (parquet, csv, json, orc, delta), partition_by, clustered_by, buckets, incremental_strategy
V súčasnosti sú podporované nasledujúce úložiská:
- Postgres
- BigQuery: Table partitioning & clustering, Merge behavior, KMS Encryption, Labels & Tags
- BigQuery:
- Snowflake: Transient tables, Merge behavior, Table clustering, Copying grants, Secure views
- Presto (časť)
- Spark (časť)
- Microsoft SQL Server (komunitný adaptér)
Poďme vylepšiť náš model:
- Spravme jeho naplnenie inkrementálnym (Incremental)
- Pridajme kľúče segmentácie a triedenia pre Redshift
-- Konfigurácia modelu:
-- Inkrementálne naplnenie, jedinečný kľúč pre aktualizáciu záznamov (unique_key)
-- Kľúč segmentácie (dist), kľúč triedenia (sort)
{{
  config(
       materialized='incremental',
       unique_key='order_id',
       dist="customer_id",
       sort="order_date"
   )
}}

{% set payment_methods = ['credit_card', 'coupon', 'bank_transfer', 'gift_card'] %}

with orders as (

   select * from {{ ref('stg_orders') }}
   where 1=1
   {% if is_incremental() -%}
       -- Tento filter bude aplikovaný iba pre inkrementálny spustenie
       and order_date >= (select max(order_date) from {{ this }})
   {%- endif %}

),

order_payments as (

   select * from {{ ref('order_payments') }}

),

final as (

   select
       orders.order_id,
       orders.customer_id,
       orders.order_date,
       orders.status,
       {% for payment_method in payment_methods -%}
       order_payments.{{payment_method}}_amount,
       {% endfor -%}
       order_payments.total_amount as amount
   from orders
       left join order_payments using (order_id)

)

select * from final
Graf závislostí modelov
Takisto známy ako strom závislostí. Tiež DAG (Directed Acyclic Graph — Orientovaný Acyklický Graf).
DBT vytvára graf na základe konfigurácie všetkých modelov projektu, a konkrétnejšie odkazov ref() vo vnútri modelov na iné modely. Prítomnosť grafu umožňuje vykonať nasledujúce úkony:
- Spustenie modelov v správnom poradí
- Paralelizácia vytvárania vitrín
- Spustenie ľubovoľného podgrafu
Príklad vizualizácie grafu:
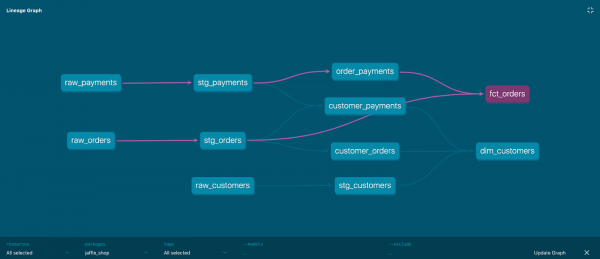
Každý uzol grafu je model, hrany grafu sú definované výrazom ref.
Kvalita údajov a Dokumentácia
Okrem vytvárania samotných modelov, DBT umožňuje testovať niekoľko predpokladov (assertions) o výslednom dátovom súbore, ako napríklad:
- Not Null
- Unique
- Reference Integrity — referenčná integrita (napríklad, customer_id v tabuľke orders zodpovedá id v tabuľke customers)
- Zodpovednosť zoznamu povolených hodnôt
Možnosť pridania vlastných testov (custom data tests), ako napríklad, % odchýlky tržieb vzhľadom na ukazovatele predtým dňa, týždňa, mesiaca. Akýkoľvek predpoklad formulovaný vo forme SQL dotazu môže byť testom.
Takto je možné odhaľovať v vitrínach úložiska neželané odchýlky a chyby v údajoch.
Pokiaľ ide o dokumentáciu, DBT poskytuje mechanizmy na pridávanie, verzionovanie a šírenie metadát a komentárov na úrovni modelov a dokonca aj atribútov.
Takto vyzerá pridávanie testov a dokumentácie na úrovni konfiguračného súboru:
 - name: fct_orders
   description: Tento stôl obsahuje základné informácie o objednávkach, ako aj niektoré odvodené fakty na základe platieb
   columns:
     - name: order_id
       tests:
         - unique # kontrola unikátnosti hodnôt
         - not_null # kontrola na prítomnosť null
       description: Toto je unikátne identifikačné číslo pre objednávku
     - name: customer_id
       description: Cudzí kľúč na tabuľku zákazníkov
       tests:
         - not_null
         - relationships: # kontrola referenčnej integrity
             to: ref('dim_customers')
             field: customer_id
     - name: order_date
       description: Dátum (UTC), keď bola objednávka vytvorená
     - name: status
       description: '{{ doc("orders_status") }}'
       tests:
         - accepted_values: # kontrola na prijateľné hodnoty
             values: ['placed', 'shipped', 'completed', 'return_pending', 'returned']
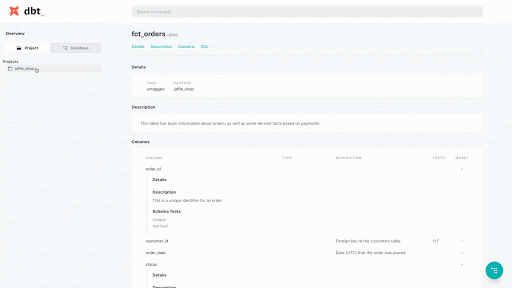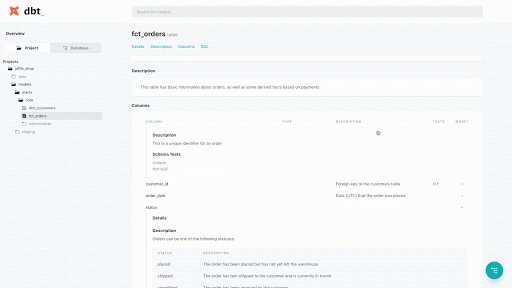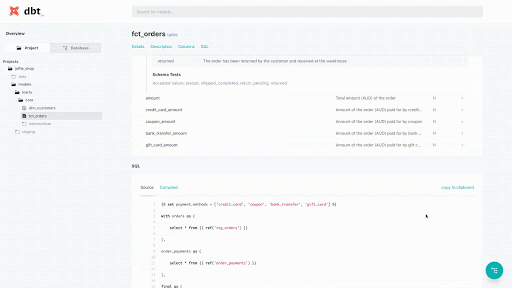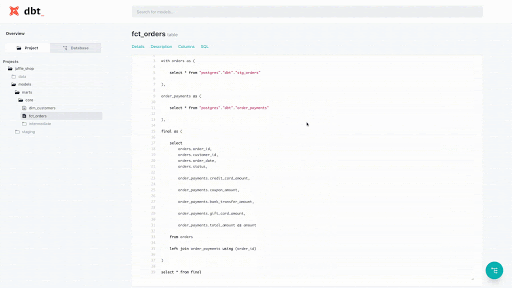
A takto vyzerá táto dokumentácia už na vygenerovanej webovej stránke:
Makrá a Moduly
Účel DBT nie je len stať sa súborom SQL skriptov, ale poskytnúť používateľom mocné a bohaté nástroje na vytváranie vlastných transformácií a zdieľanie týchto modulov.
Makrá sú súbory konštrukcií a výrazov, ktoré môžu byť volané ako funkcie vo vnútri modelov. Makrá umožňujú znovu použiť SQL medzi modelmi a projektmi podľa inžinierskeho princípu DRY (Nerobte si starosti s opakovaním).
Príklad makra:
{% macro rename_category(column_name) %}
case
 when {{ column_name }} ilike  '%osx%' then 'osx'
 when {{ column_name }} ilike  '%android%' then 'android'
 when {{ column_name }} ilike  '%ios%' then 'ios'
 else 'other'
end as renamed_product
{% endmacro %}
A jeho použitie:
{% set column_name = 'product' %}
select
 product,
 {{ rename_category(column_name) }} -- volanie makra
from my_table
DBT prichádza s manažérom balíkov (packages), ktorý umožňuje používateľom publikovať a znovu používať jednotlivé moduly a makrá.
To znamená možnosť načítať a používať takéto knižnice ako:
- : práca s dátumami/časom, surrogátne kľúče, schémové testy, pivot/unpivot a ďalšie
- Hotové šablóny pre také služby ako a
- Knižnice pre určité dátové sklady, napríklad
- — Modul na logovanie prác DBT
S kompletným zoznamom balíkov sa môžete oboznámiť na .
Ešte viac možností
Tu opíšem niekoľko ďalších zaujímavých funkcií a implementácií, ktoré ja a tím používame na budovanie Úložiska Dát v .
Rozdelenie prostredí DEVELOPER — TEST — PRODUKCIA
Aj v rámci jedného klastrového DWH (v rámci rôznych schém). Napríklad pomocou nasledujúceho výrazu:
with source as (

   select * from {{ source('salesforce', 'users') }}
   where 1=1
   {%- if target.name in ['dev', 'test', 'ci'] -%}
       where timestamp >= dateadd(day, -3, current_date)
   {%- endif -%}

)
Tento kód doslovne hovorí: pre prostredia dev, test, ci vezmi údaje len za posledné 3 dni a nie viac. To znamená, že beh v týchto prostrediach bude oveľa rýchlejší a bude vyžadovať menej zdrojov. Pri spustení v prostredí produkcia filter podmienka bude ignorovaná.
Materializácia s alternatívnym kódovaním stĺpcov
Redshift je stĺpcová DBMS, ktorá umožňuje nastaviť algoritmy kompresie údajov pre každý jednotlivý stĺpec. Výber optimálnych algoritmov môže znížiť obsadený priestor na disku o 20-50%.
Makro vykoná príkaz ANALYZE COMPRESSION, vytvorí novú tabuľku s odporúčanými algoritmami kódovania stĺpcov, uvedenými kľúčmi segmentácie (dist_key) a triedenia (sort_key), presunie ich do nej a, ak je to potrebné, odstráni starú kópiu.
Podpis makra:
{{ compress_table(schema, table,
                 drop_backup=False,
                 comprows=none|Integer,
                 sort_style=none|compound|interleaved,
                 sort_keys=none|List,
                 dist_style=none|all|even,
                 dist_key=none|String) }}
Logovanie spustení modelov
Na každé vykonanie modelu sa dajú pridať háčiky (hooks), ktoré sa vykonajú pred spustením alebo hneď po skončení vytvorenia modelu:
   pre-háčik: "{{ logging.log_model_start_event() }}"
   post-háčik: "{{ logging.log_model_end_event() }}"
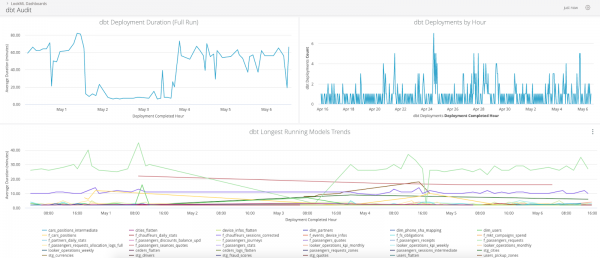
Modul logovania umožní zaznamenávať všetky potrebné metadata do samostatnej tabuľky, na základe ktorej sa potom môžu vykonávať audity a analýzy problémových miest (bottlenecks).
Takto vyzerá dashboard na základe údajov logovania v Looker:
Automatizácia údržby Úložiska
Ak používate nejaké rozšírenia funkčnosti používaného Úložiska, ako napríklad UDF (User Defined Functions), tak verzionovanie týchto funkcií, správa prístupov a automatizované vydávanie nových verzií je veľmi pohodlné uskutočňovať v DBT.
Na vypočítavanie hash hodnôt, domén e-mailových adries a dekódovanie bitových súm (bitmask) používame UDF v Pythone.
Príklad makra, ktoré vytvára UDF v akomkoľvek prostredí (dev, test, prod):
{% macro create_udf() -%}

 {% set sql %}
 CREATE OR REPLACE FUNCTION {{ target.schema }}.f_sha256(mes "varchar")
 RETURNS varchar
 LANGUAGE plpythonu
 STABLE
 AS $$
 import hashlib
 return hashlib.sha256(mes).hexdigest()
 $$
 ;
 {% endset %}

 {% set table = run_query(sql) %}

{%- endmacro %}
V Wheely používame Amazon Redshift, ktorý je založený na PostgreSQL. Pre Redshift je dôležité pravidelne zbierať štatistiky o tabuľkách a uvoľňovať miesto na disku – príkazy ANALYZE a VACUUM, príslušne.
Na tento účel sa každú noc vykonávajú príkazy z makra redshift_maintenance:
{% macro redshift_maintenance() %}

 {% set vacuumable_tables=run_query(vacuumable_tables_sql) %}

 {% for row in vacuumable_tables %}
 {% set message_prefix=loop.index ~ " of " ~ loop.length %}

 {%- set relation_to_vacuum = adapter.get_relation(
 database=row['table_database'],
 schema=row['table_schema'],
 identifier=row['table_name']
 ) -%}
 {% do run_query("commit") %}

 {% if relation_to_vacuum %}
 {% set start=modules.datetime.datetime.now() %}
 {{ dbt_utils.log_info(message_prefix ~ " Vacuuming " ~ relation_to_vacuum) }}
 {% do run_query("VACUUM " ~ relation_to_vacuum ~ " BOOST") %}
 {{ dbt_utils.log_info(message_prefix ~ " Analyzing " ~ relation_to_vacuum) }}
 {% do run_query("ANALYZE " ~ relation_to_vacuum) %}
 {% set end=modules.datetime.datetime.now() %}
 {% set total_seconds = (end - start).total_seconds() | round(2)  %}
 {{ dbt_utils.log_info(message_prefix ~ " Finished " ~ relation_to_vacuum ~ " in " ~ total_seconds ~ "s") }}
 {% else %}
 {{ dbt_utils.log_info(message_prefix ~ ' Skipping relation "' ~ row.values() | join ('"."') ~ '" as it does not exist') }}
 {% endif %}

 {% endfor %}

{% endmacro %}
DBT Cloud
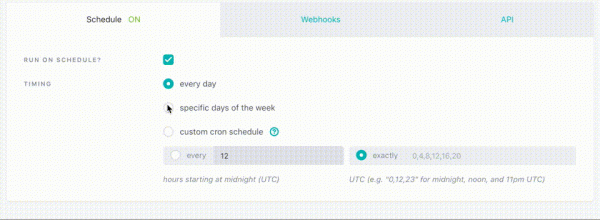
Existuje možnosť využívať DBT ako službu (Managed Service). V balení:
- Web IDE pre vývoj projektov a modelov
- Konfigurácia úloh a nastavenie plánovania
- Jednoduchý a pohodlný prístup k logom
- Webová stránka s dokumentáciou vášho projektu
- Pripojenie CI (Continuous Integration)
Záver
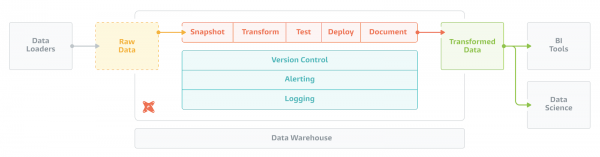
Príprava a konzumácia DWH sa stáva rovnako príjemnou a prospešnou ako pitie smoothie. DBT sa skladá z Jinja, používateľských rozšírení (modulov), kompilátora, enginu (executor) a správcu balíkov. Spojením týchto prvkov získavate plnohodnotné pracovné prostredie pre vaše DWH. Dnes sa sotva nájde lepší spôsob správy transformácií v rámci DWH.
Presvedčenia, ktorými sa riadili vývojári DBT, sa formulujú takto:
- Kód a nie GUI je najlepšou abstrakciou na vyjadrenie zložitej analytickej logiky.
- Práca s dátami by mala prijať najlepšie praktiky vývoja softvéru (Software Engineering).
- Najdôležitejšia infraštruktúra práce s dátami by mala byť kontrolovaná komunitou používateľov ako softvér s otvoreným zdrojovým kódom.
- Nie len analytické nástroje, ale aj kód sa čoraz viac stáva majetkom komunity Open Source.
Tieto základné presvedčenia viedli k vzniku produktu, ktorý dnes používajú viac než 850 spoločností, a tvorí základ mnohých zaujímavých rozšírení, ktoré budú vytvorené v budúcnosti.
Pre tých, ktorí majú záujem, existuje videonahrávka otvorenej hodiny, ktorú som viedol pred niekoľkými mesiacmi v rámci otvorenej hodiny v OTUS — .
Okrem DBT a Úložísk Dát, v rámci kurzu Data Engineer na platforme OTUS, vediem s kolegami prednášky o niekoľkých ďalších aktuálnych a moderných témach:
- Architektonické koncepty aplikácií Veľkých Dát.
- Praxe so Spark a Spark Streaming.
- Štúdium spôsobov a nástrojov načítania zdrojov dát.
- Budovanie analytických vitrín v DWH.
- Koncepty NoSQL: HBase, Cassandra, ElasticSearch.
- Zásady organizácie monitorovania a orchestrácie.
- Finálny Projekt: zhŕňame všetky zručnosti pod mentorstvom.
Odkazy:
- — Oficiálna dokumentácia.
- — Prehľadový článok jedného z autorov DBT.
- — YouTube, Záznam otvorenej hodiny OTUS.
- — Najbližšia otvorená hodina 15. mája 2020.
- — OTUS.
- — Pohľad do budúcnosti práce s dátami a analytikou.
- — Evolúcia analytiky a vplyv Open Source.
- — Zásady budovania CI s použitím DBT.
- — Prax, Krok za krokom inštrukcie na samostatnú prácu.
- — Github, kód vzdelávacieho projektu
Zdroj: habr.com
