

SQL, čo môže byť jednoduchšie? Každý z nás môže napísať jednoduchý dotaz — zadáme select, vymenúvame potrebné stĺpce, potom z, názov tabuľky, trochu podmienok v kde a všetko — už máme užitočné dáta v našich rukách, pričom (takmer) nezáleží na tom, aký DBMS sa nachádza pod kapotom (alebo to možno ani nie je A začneme s
ORM. predpetrovskom Rusku. .
Zástancovia ORM tradične oceňujú rýchlosť a jednoduchosť vývoja, nezávislosť od DBMS a čistotu kódu. Pre mnohých z nás kód práce s DB (a často aj samotná DB)
vyzerá zvyčajne približne takto…
@Entity @Table(name = "stock", catalog = "maindb", uniqueConstraints = { @UniqueConstraint(columnNames = "STOCK_NAME"), @UniqueConstraint(columnNames = "STOCK_CODE") }) public class Stock implements java.io.Serializable {@Id @GeneratedValue(strategy = IDENTITY) @Column(name = "STOCK_ID", unique = true, nullable = false) public Integer getStockId() { return this.stockId; } ...
Model je obohatený inteligentnými anotáciami a niekde za kulisami vznešený ORM generuje a vykonáva tony akého si SQL kódu. Mimochodom, vývojári sa všetkými silami snažia obklopiť svoju DB kilometrami abstrakcií, čo naznačuje určitú"SQL nenávisť." .
A čo ak by sme skombinovali to najlepšie z oboch svetov? Ako je to urobené v úžasnom nástroji s povzbudzujúcim názvom
Yesql. . Приведу пару строк из общей концепции в моем вольном переводе, а более подробно с ней можно познакомиться .
Clojure je skvelý jazyk na vytváranie DSL, ale SQL je už sám o sebe skvelým DSL a my nepotrebujeme ďalší. S-výrazy sú nádherné, ale tu nepridávajú nič nové. Nakoniec dostávame zátvorky len kvôli zátvorkám. Nesúhlasíte? Potom si počkajte, kým abstrakcia nad DB začne uniknúť, a vy začnete bojovať s funkciou. (raw-sql)
A čo robiť? Nechajme SQL obyčajným SQL — jeden súbor na jeden dotaz:
-- name: users-by-country
select *
  from users
 where country_code = :country_code
… a potom si prečítajte tento súbor a premeňte ho na obyčajnú Clojure funkciu:
(defqueries "some/where/users_by_country.sql"
   {:connection db-spec})

;;; Funkcia s názvom `users-by-country` bola vytvorená.
;;; Použime ju:
(users-by-country {:country_code "GB"})
;=> ({:name "Kris" :country_code "GB" ...} ...)
Dodržiavaním princípu "SQL samostatne, Clojure samostatne" získate:
- Žiadne syntaktické prekvapenia. Vaša databáza (ako každá iná) nie je na 100 % v súlade so SQL štandardom — ale pre Yesql to nie je dôležité. Nikdy nebudete tráviť čas lovením funkcií so syntaxou ekvivalentnou SQL. Nikdy sa nebudete musieť vracať k funkcii (raw-sql "some (‘funky’ :: SYNTAX)")).
- Najlepšia podpora editora. Váš editor už má skvelú podporu pre SQL. Zachovaním SQL ako SQL ho môžete jednoducho používať.
- Kompatibilita pre tím. Vaši DBA môžu čítať a písať SQL, ktoré používate vo svojom Clojure projekte.
- Jednoduchšia konfigurácia výkonu. Potrebujete vytvoriť plán pre problematický dotaz? Nie je to problém, keď je váš dotaz obyčajným SQL.
- Opätovné použitie dotazov. Presuňte tieto isté SQL súbory do iných projektov, pretože to je len starý dobrý SQL — jednoducho ho zdieľajte.
Podľa mňa je myšlienka veľmi skvelá a zároveň veľmi jednoduchá, vďaka čomu projekt získal množstvo v rôznych jazykoch. A my sa ďalej pokúsime aplikovať podobnú filozofiu oddelenia SQL kódu od všetkého ostatného ďaleko za hranice ORM.
IDE & DB-řídicí nástroje
Začneme s jednoduchou každodennou úlohou. Často sa musíme pozerať na nejaké objekty v DB, napríklad nájsť tabuľku v schéme a preskúmať jej štruktúru (aké stĺpce, kľúče, indexy, obmedzenia a iné sa používajú). Od akejkoľvek grafickej IDE alebo aspoň základného DB-managera očakávame predovšetkým tieto schopnosti. Aby sa to robilo rýchlo a nemuseli sme čakať pol hodiny, kým sa objaví okno s potrebnými informáciami (najmä pri pomalom pripojení k vzdialenej DB), a aby získané informácie boli čerstvé a aktuálne, nie staré uložené dáta. Čím zložitejšia a väčšia je DB a čím viac ich je, tým ťažšie to je realizovať.
Ale zvyčajne hodím myš nabok a jednoducho píšem kód. Predpokladajme, že je potrebné zistiť, aké tabuľky (a s akými vlastnosťami) sú obsiahnuté v schéme "HR". Vo väčšine DBMS, potrebný výsledok môžeme dosiahnuť takýmto jednoduchým dopytom z information_schema:
select table_name
     , ...
  from information_schema.tables
 where schema = 'HR'
Obsah takýchto tabuliek referenčných údajov sa pri prechode medzi databázami líši v závislosti od schopností každého DBMS. Napríklad pre MySQL môžeme z tej istej tabuľky získať špecifické parametre pre tento DBMS:
select table_name
     , storage_engine -- Použitý "motor" ("MyISAM", "InnoDB" atď.)
     , row_format     -- Formát riadku ("Fixed", "Dynamic" atď.)
     , ...
  from information_schema.tables
 where schema = 'HR'
Oracle nemá information_schema, ale má , a nevznikajú s tým veľké problémy:
select table_name
     , pct_free       -- Minimálne voľné miesto v bloku údajov (%)
     , pct_used       -- Minimálne použité miesto v bloku údajov (%)
     , last_analyzed  -- Dátum posledného zhromaždenia štatistiky
     , ...
  from all_tables
 where owner = 'HR'
Nie je výnimkou ani ClickHouse:
select name
     , engine -- Použitý "motor" ("MergeTree", "Dictionary" atď.)
     , ...
  from system.tables
 where database = 'HR'
Niečo podobné je možné urobiť aj v Cassandre (kde sú column families namiesto tabuliek a keyspaces namiesto schém):
select columnfamily_name
     , compaction_strategy_class  -- Stratégia zberu odpadu
     , gc_grace_seconds           -- Doba života odpadu
     , ...
  from system.schema_columnfamilies
 where keyspace_name = 'HR'
Pre väčšinu ostatných databáz je tiež možné vymyslieť podobné dopyty (aj v Mongo je , ktorá obsahuje informácie o všetkých kolekciách v systéme).
Samozrejme, týmto spôsobom môžete získať informácie nielen o tabuľkách, ale aj o akomkoľvek objekte. Občas sa dobrí ľudia delia o takéto kódy pre rôzne DB, ako napríklad v sérii článkov na habre "Funkcie na dokumentovanie databáz PostgreSQL" (, , ). Samozrejme, mať všetky tieto davy dotazov v hlave a neustále ich písať je "také si" potěšenie, preto v mojej obľúbenej IDE/editore mám vopred pripravenú sadu snippetov pre často používané dotazy, a ostáva len zadávať mená objektov do šablóny.
Nakoniec je taký spôsob navigácie a vyhľadávania objektov oveľa flexibilnejší, šetrí veľa času a umožňuje získať presne tie informácie a v tej forme, v akej sú v súčasnosti potrebné (ako je popísané v príspevku ).
Operácie s objektmi
Po tom, čo sme našli a preskúmali potrebné objekty, je čas s nimi urobiť niečo užitočné. Samozrejme, bez toho, aby sme zdvihli prsty od klávesnice.
Nie je tajomstvom, že jednoduché odstránenie tabuľky bude vyzerať rovnako takmer vo všetkých DB:
drop table hr.personsAle s vytváraním tabuľky je to už zaujímavejšie. Prakticky každá SODB (vrátane mnohých NoSQL) vie v jednom či druhom formáte "create table", a hlavná časť sa bude len ťažko líšiť (meno, zoznam stĺpcov, typy dát), ale ostatné detaily sa môžu radikálne líšiť a závisia od vnútornej štruktúry a schopností konkrétnej SODB. Môj obľúbený príklad — v dokumentácii Oracle zabírajú iba jednoduché BNF pre syntax "create table" . Iné SODB majú skromnejšie možnosti, ale každá z nich má aj množstvo zaujímavých a unikátnych funkcií na vytváranie tabuliek (, , , ). Ťažko povedať, či nejaký grafický "wizard" z ďalšej IDE (najmä univerzálnej) dokáže úplne pokryť všetky tieto schopnosti, a ak aj áno, bude to pohľad pre slabé nervy. V rovnakom čase správne a včas napísaný príkaz create table umožní bez problémov využiť všetky z nich, zabezpečiť ukladanie a prístup k vašim údajom spoľahlivý, optimálny a maximálne pohodlný.
V mnohých databázových systémoch existujú špecifické typy objektov, ktoré chýbajú v iných systémoch. Môžeme vykonávať operácie nielen s objektmi databázy, ale aj so samotným databázovým systémom, ako napríklad "ukončiť" proces, uvoľniť určitú časť pamäte, zapnúť trasovanie, prepnúť do režimu "iba na čítanie" a mnoho ďalšieho.
A teraz si trochu nakreslíme.
Jednou z najbežnejších úloh je vytvoriť diagram s objektmi databázy, aby sme na peknom obrázku videli objekty a vzťahy medzi nimi. To dokáže v podstate akýkoľvek grafický IDE, jednotlivé príkazové nástroje, špecializované grafické nástroje a modeléry. Tieto nástroje vám niečo nakreslia "tak, ako vedia", pričom mierne ovplyvniť tento proces možno len pomocou niekoľkých parametrov v konfiguračnom súbore alebo zaškrtávacích políčok v rozhraní.
Avšak tento problém možno vyriešiť oveľa jednoducho, flexibilnejšie a elegantnejšie, a samozrejme pomocou kódu. Na vytváranie diagramov akejkoľvek zložitosti máme hneď niekoľko špecializovaných značkovacích jazykov (DOT, GraphML a pod.), pričom k nim existuje množstvo aplikácií (GraphViz, PlantUML, Mermaid), ktoré dokážu čítať takéto pokyny a vizualizovať ich v rôznych formátoch. A informácie o objektoch a vzťahoch medzi nimi už vieme, ako získať.
Uvedieme malý príklad toho, ako by to mohlo vyzerať s použitím PlantUML a (vľavo SQL dotaz, ktorý vygeneruje potrebný príkaz pre PlantUML, a vpravo výsledok):
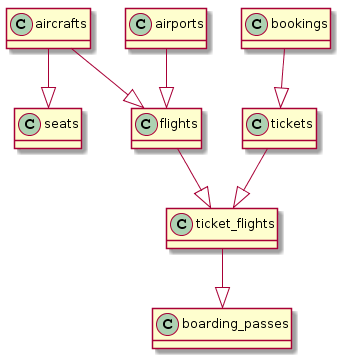
select '@startuml'||chr(10)||'hide methods'||chr(10)||'hide stereotypes' union all
select distinct ccu.table_name || ' --|> ' ||
       tc.table_name as val
  from table_constraints as tc
  join key_column_usage as kcu
    on tc.constraint_name = kcu.constraint_name
  join constraint_column_usage as ccu
    on ccu.constraint_name = tc.constraint_name
 where tc.constraint_type = 'FOREIGN KEY'
   and tc.table_name ~ '.*' union all
select '@enduml'
Ak sa trochu snažíme, môžeme na základe získať niečo silne podobné skutočnej ER diagrame:
SQL dotaz je o čosi zložitejší.
-- Hlavička
select '@startuml
!define Table(name,desc) class name as "desc" << (T,#FFAAAA) >>
!define primary_key(x) <b>x</b>
!define unique(x) <color:green>x</color>
!define not_null(x) <u>x</u>
hide methods
hide stereotypes'
union all
-- Tabuľky
select format('Table(%s, "%s n informácie o %s") {'||chr(10), table_name, table_name, table_name) ||
(select string_agg(column_name || ' ' || upper(udt_name), chr(10))
from information_schema.columns
where table_schema = 'public'
and table_name = t.table_name) || chr(10) || '}'
from information_schema.tables t
where table_schema = 'public'
union all
-- Vzťahy medzi tabuľkami
select distinct ccu.table_name || ' "1" --> "0..N" ' || tc.table_name || format(' : "A %s môže mať mnoho %s"', ccu.table_name, tc.table_name)
from information_schema.table_constraints as tc
join information_schema.key_column_usage as kcu on tc.constraint_name = kcu.constraint_name
join information_schema.constraint_column_usage as ccu on ccu.constraint_name = tc.constraint_name
where tc.constraint_type = 'FOREIGN KEY'
and ccu.constraint_schema = 'public'
and tc.table_name ~ '.*'
union all
-- Pätka
select '@enduml' 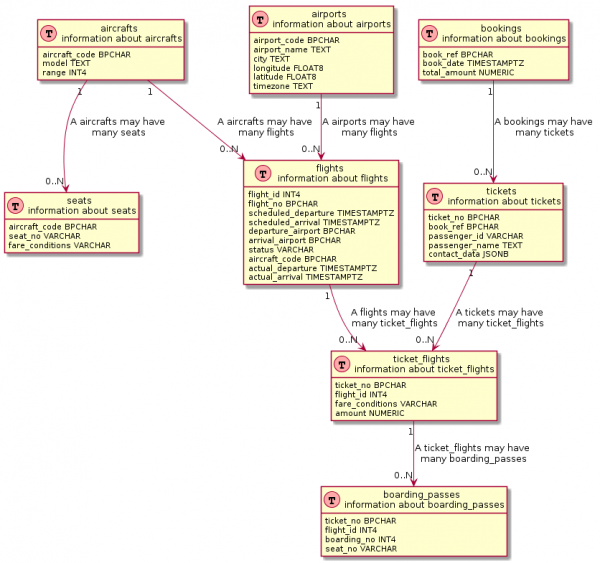
Ak si pozorne všimneme, mnoho vizualizačných nástrojov tiež pod kapotou používa podobné dotazy. Pravda však je, že tieto dotazy sú zvyčajne hlboko , nieto ešte o ich modifikácii.
Metódy a monitorovanie
Prejdeme k tradične zložitnej téme — monitorovanie výkonu databáz. Spomínam si na malý pravdivý príbeh, ktorý mi rozprával "jeden môj priateľ". Na jednom projekte žil nejaký mocný DBA, a málokto z vývojárov ho osobne poznal, ba ani ho niekedy videl na vlastné oči (napriek tomu, že pracoil, podľa povestí, kdesi v blízkej budove). V hodine "X", keď produkčný systém veľkého maloobchodníka opäť začínal "zle fungovať", mlčky posielal snímky obrazovky grafov z Oracle Enterprise Managera, na ktorých starostlivo zvýrazňoval kritické miesta červeným zvýrazňovačom pre "jasnosť" (to, mierne povedané, málo pomáhalo). A takto podľa tejto "fotografickej" snímky bolo potrebné liečiť. Avšak prístup k cennému (v oboch zmysloch tohto slova) Enterprise Manageru nikto nemal, pretože systém je zložitý a drahý, nech "vývojári na niečo nenarazia a všetko nepokazia". Preto vývojári "empiricky" nachádzali miesto a príčinu spomalenia a vydávali patch. Ak hrozné písmeno od DBA neprišlo opäť v najbližšom čase, všetci si s úľavou vydýchli a vrátili sa k svojim aktuálnym úlohám (až do nového Listu).
Ale proces monitorovania môže vyzerať veselšie a priateľskejšie, a čo je najdôležitejšie — prístupne a transparentne pre všetkých. Aspoň jeho základná časť, ako doplnok k hlavným monitorovacím systémom (ktoré sú nepochybne užitočné a v mnohých prípadoch nenahraditeľné). Akákoľvek SGBD je ochotná a úplne bezplatne zdieľať informácie o svojom aktuálnom stave a výkone. V samej "krvavej" Oracle DB možno prakticky akékoľvek informácie o výkone získať zo systémových pohľadov, počnúc procesmi a reláciami a končiac stavom vyrovnávacej pamäte (napríklad, , sekcia "Monitorovanie"). V PostgreSQL je tiež celá plejáda systémových pohľadov na , najmä také nezameniteľné v každodennom živote každého DBA, ako sú , , . V MySQL je na tento účel vyhradená dokonca samostatná schéma . A v Mongo je zabudovaný zhromažďuje údaje o výkone do systémovej kolekcie .
T. o., ozbrojený nejakým zberačom metrík (Telegraf, Metricbeat, Collectd), ktorý dokáže vykonávať vlastné sql dotazy, skladom týchto metrík (InfluxDB, Elasticsearch, Timescaledb) a vizualizátorom (Grafana, Kibana), sa dá získať pomerne ľahký a flexibilný systém monitorovania, ktorý bude úzko integrovaný s inými všeobecnými metrikami (získanými napríklad zo servera aplikácií, od OS a pod.). Ako je napríklad to, čo robí pgwatch2, kde sa používa kombinácia InfluxDB + Grafana a súbor dotazov na systémové zobrazenia, ku ktorým sa dajú .
Spolu
A to je len približný zoznam toho, čo môžeme urobiť s našou DB pomocou obyčajného SQL kódu. Som si istý, že môžeme nájsť ešte množstvo ďalších aplikácií, napíšte v komentároch. A o tom, ako (a predovšetkým prečo) to všetko automatizovať a zakomponovať do svojho CI/CD pipeline, si povieme nabudúce.
Zdroj: habr.com
