

Ako backend vývojár vie, že SQL dopyt bude dobre fungovať v produkcii? V veľkých alebo rýchlo rastúcich spoločnostiach prístup k produkcii nemá každý. A aj s prístupom možno nie všetky dopyty možno bezbolestne overiť, a vytvorenie kópie databázy často trvá hodiny. Aby sme tieto problémy vyriešili, vytvorili sme umelého DBA - Joea. Už bol úspešne implementovaný v niekoľkých spoločnostiach a pomáha mnohým vývojárom.
Video:
Ahojte! Volám sa Anatolij Stanšler. Pracujem v spoločnosti . Zaoberáme sa tým, že urýchľujeme proces vývoja tým, že odbúravať oneskorenia spôsobené prácou s Postgresom pre vývojárov, DBA a QA.
Máme skvelých klientov a dnes bude časť prednášky venovaná prípadom, ktoré sme zaznamenali pri práci s nimi. Povediem o tom, ako sme im pomohli vyriešiť pomerne závažné problémy.
Keď vedieme vývoj a robíme zložité zaťažené migrácie, kladieme si otázku: „Poletí táto migrácia?“. Využívame review, máme vedomosti od skúsenejších kolegov, DBA expertov. A oni môžu povedať – poletí alebo nepoletí.
Ale možno by bolo lepšie, keby sme to mohli sami otestovať na plnohodnotných kópiách. A dnes presne o tom budeme hovoriť, aké sú súčasné prístupy k testovaniu a ako to možno robiť lepšie a s akými nástrojmi. Taktiež sa porozprávame, aké výhody a nevýhody majú tieto prístupy a čo môžeme v tomto zlepšiť.
Kto niekedy robil indexy alebo iné zmeny priamo na produkcii? Celkom dosť. A koľkým to spôsobilo stratu dát alebo výpadky? Vtedy poznáte túto bolesť. Chvalabohu, zálohy existujú.
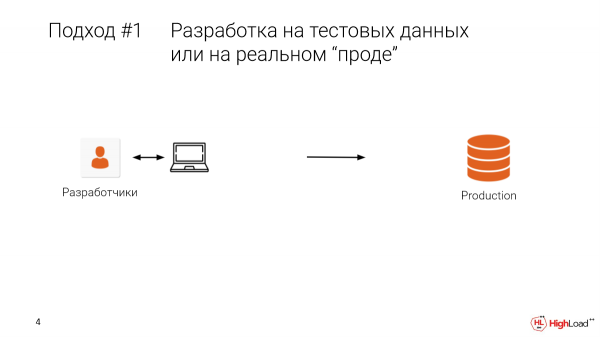
Prvý prístup – to je testovanie v produkcii. Alebo keď vývojár sedí na lokálnej mašine, má testovacie údaje, je tam nejaký obmedzený výber. A vydáme to na produkciu, a dostaneme takúto situáciu.
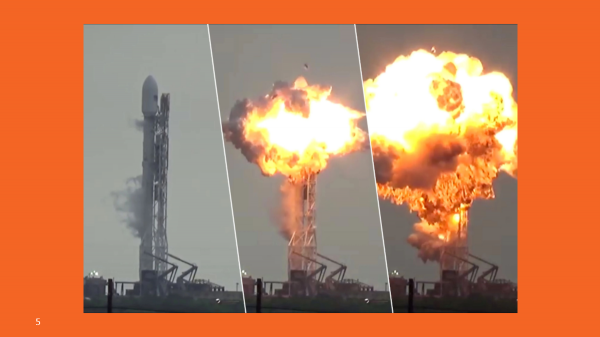
Je to bolestivé, je to drahé. Asi to tak lepšie nerobiť.
A ako to spraviť lepšie?
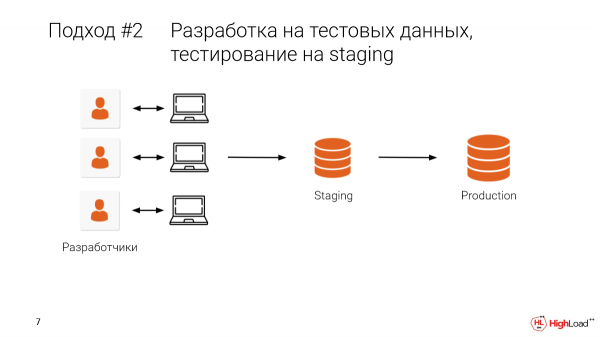
Poďme vziať staging a vyčleniť tam nejakú časť produkcie. Alebo v lepšom prípade zoberieme skutočnú produkciu, všetky údaje. A potom, čo sme to lokálne vyvinuli, budeme ďalej overovať aj na stagingu.
To nám umožní odstrániť časť chýb, t. j. nedopustiť ich na produkcii.
Aké sú problémy?
- Problém je, že tento staging zdieľame s kolegami. A veľmi často sa stáva, že vykonáte nejakú zmenu, bum – a žiadne údaje nie sú, práca je zbytočná. Staging bol viac ako niekoľko terabytov. A musíme dlho čakať, kým sa znova spustí. A rozhodujeme sa to doriešiť zajtra. Všetko, máme vývoj pozastavený.
- A samozrejme, máme tam veľa kolegov, veľa tímov. A treba to ručne koordinovať. A to je nepríjemné.
A stojí za to povedať, že máme iba jednu šancu, jeden výstrel, ak chceme vykonať nejaké zmeny v databáze, dotknúť sa údajov, zmeniť štruktúru. A ak sa niečo pokazilo, ak v migrácii bola chyba, tak sa už rýchlo nevrátime späť.
Je to lepšie ako predchádzajúci prístup, ale stále je tu veľká pravdepodobnosť, že nejaká chyba prejde do produkcie.
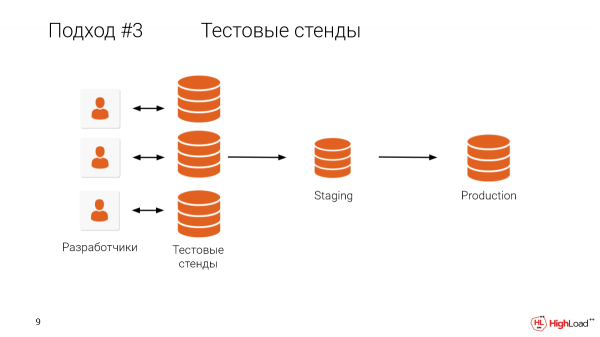
Čo nám bráni dať každému vývojárovi testovací stánok, plnohodnotnú kópiu? Myslím, že je jasné, čo bráni.
Kto má databázu väčšiu ako terabajt? Viac ako polovica sály.
A je jasné, že udržiavať stroje pre každého vývojára, keď je taká veľká produkcia, je veľmi drahé, a navyše aj časovo náročné.
Máme klientov, ktorí pochopili, že je veľmi dôležité testovať všetky zmeny na plnohodnotných kópiách, ale ich databáza je pod terabajt a nemajú zdroje na to, aby pre každého vývojára udržali testovací stánok. Preto musia sťahovať dumpy na svoje lokálne zariadenia a testovať takto. To trvá veľa času.
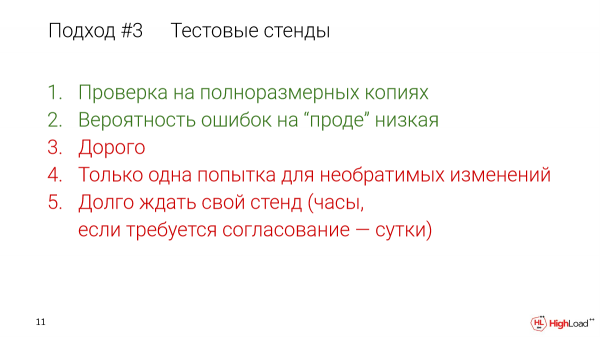
Aj keď to robíte v rámci infraštruktúry, stiahnuť jeden terabajt údajov za hodinu – to je už veľmi dobré. Ale používajú logické dumpy, sťahujú lokálne z cloudu. Pre nich je rýchlosť asi 200 gigabajtov za hodinu. A ešte potrebujú čas na to, aby sa rozvinuli z logického dumpu, nainštalovali indexy a pod.
Ale tento prístup používajú, pretože to umožňuje udržiavať produkciu spoľahlivou.
Čo môžeme urobiť? Poďme spraviť tak, aby testovacie stánky boli lacné a dáme každému vývojárovi jeho vlastný testovací stánok.
A to je možné.
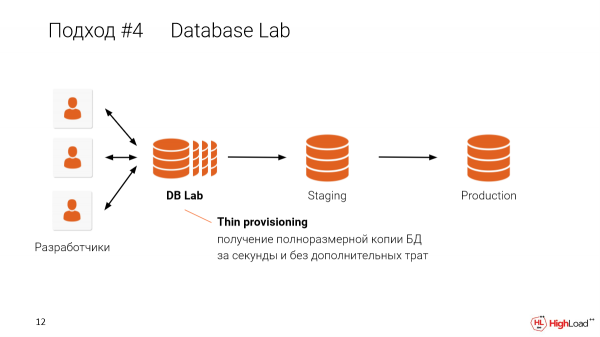
A v tomto prístupe, keď robíme tenké klony pre každého vývojára, môžeme to zdieľať na jednom stroji. Napríklad, ak máte štyri terabajty databázy a chcete ju poskytnúť 10 vývojárom, nemusíte mať 10 x štyri terabajty databáz. Stačí vám jeden stroj na vytváranie tenkých izolovaných kópií pre každého vývojára, využívajúc jeden stroj. Ako to funguje, vysvetlím o chvíľu.
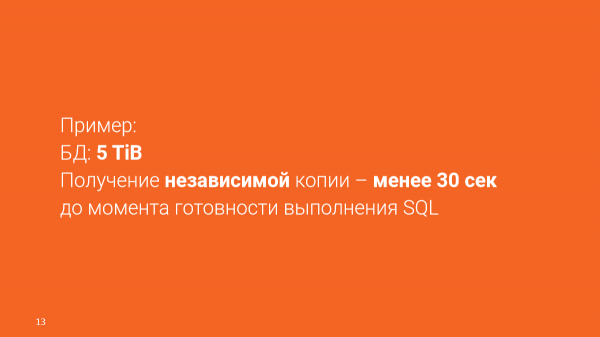
Skutočný príklad:
DB – 4,5 terabajta.
Nezávislé kópie môžeme získať za 30 sekúnd.
Nemusíte čakať na testovací stojan a závisieť od jeho veľkosti. Môžete ho získať za sekundy. Bude to úplne izolované prostredie, ktoré však zdieľa údaje medzi sebou.
To je úžasné. Tu hovoríme o mágií a paralelnom vesmíre.
V našom prípade to funguje pomocou systému OpenZFS.
OpenZFS je copy-on-write súborový systém, ktorý natívne podporuje snapshoty a klony. Je spoľahlivý a škálovateľný. Spravovať ho je veľmi jednoduché. Doslova ho môžete nasadiť v dvoch príkazoch.
Existujú aj iné možnosti:
LVM,
Úložné systémy (napríklad Pure Storage).
Database Lab, o ktorom hovorím, je modulárny. Môže byť realizovaný pri použití takýchto možností. Ale zatiaľ sa sústreďujeme na OpenZFS, pretože s LVM sme mali problémy.
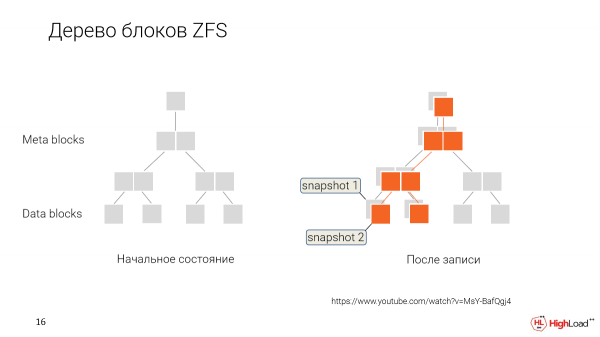
Ako to funguje? Namiesto toho, aby sme každý raz prepisovali údaje, keď ich meníme, jednoducho ich uchovávame a označujeme, že tieto nové údaje sa vzťahujú na nový okamih, nový snapshot.
A keď sa chceme vrátiť späť alebo vytvoriť nový klon z nejakej staršej verzie, jednoducho povedzme: „OK, dajte nám tieto bloky údajov, ktoré sú takto označené“.
A tento používateľ bude pracovať s týmto súborom údajov. Postupne ich bude meniť a robiť svoje snapshoty.
A my budeme mať rozvetvenie. Každý vývojár v našom prípade bude mať možnosť mať svoj vlastný klon, ktorý upravuje, a údaje, ktoré sú spoločné, budú zdieľané medzi všetkými.
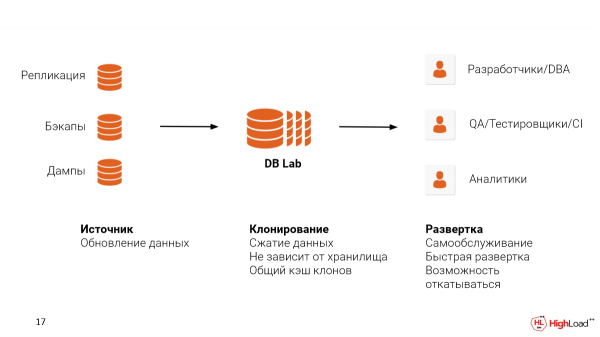
Na to, aby ste u seba nasadili taký systém, musíte riešiť dva problémy:
Prvý – to je zdroj dát, odkiaľ ich budete získavať. Môžete nastaviť replikáciu z produkcie. Môžete použiť už zálohy, ktoré máte nastavené, dúfam. WAL-E, WAL-G alebo Barman. A dokonca aj ak používate nejaké cloudové riešenie, ako je RDS alebo Cloud SQL, môžete využiť logické dumpy. Ale aj tak vám odporúčame používať zálohy, pretože pri takomto prístupe si uchováte aj fyzickú štruktúru súborov, čo umožní byť bližšie k tým metrikám, ktoré by ste videli na produkcii, aby ste zachytili problémy, ktoré existujú.
Druhý – to je miesto, kde chcete hosťovať Database Lab. Môže to byť Cloud, môže to byť On-premise. Tu je dôležité povedať, že ZFS podporuje kompresiu dát. A robí to dostatočne dobre.
Predstavte si, že každý taký klon, v závislosti od operácií, ktoré vykonávame s databázou, bude narastať nejaký dev. Pre tento dev bude tiež potrebné miesto. Ale vďaka tomu, že sme získali databázu s veľkosťou 4,5 terabajtu, ZFS ju stlačí na 3,5 terabajtu. V závislosti od nastavení to možno variabilne prispôsobovať. A pre dev nám zostane ešte miesto.
Takýto systém sa dá použiť pre rôzne prípady.
Sú to vývojári, DBA na testovanie dotazov, na optimalizáciu.
Toto možno využiť v QA testovaní na overenie konkrétnej migrácie predtým, ako to nasadíme do produkcie. A môžeme tiež vytvárať špeciálne prostredie pre QA s reálnymi dátami, kde môžu testovať novú funkcionalitu. A to zabere sekundy namiesto čakania hodín, alebo možno aj dní v iných prípadoch, kde sa tenké kópie nepoužívajú.
A ešte jeden samostatný prípad. Ak spoločnosť nemá nastavený analytický systém, môžeme vyčleniť tenký klon produktovej databázy a poskytnúť ho pod dlhé dotazy alebo pod špeciálne indexy, ktoré môžu byť použité v analytike.
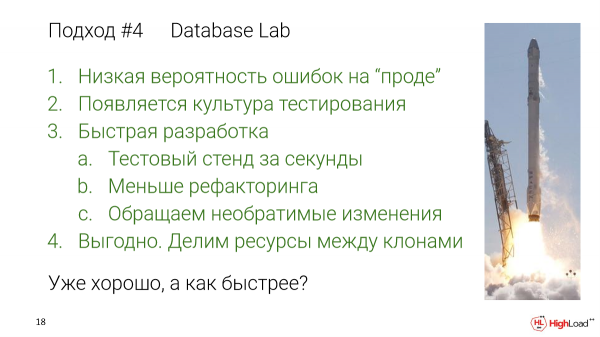
S takýmto prístupom:
Nízka pravdepodobnosť chýb na „prod“, pretože sme všetky zmeny otestovali na plných údajoch.
Vzniká nám kultúra testovania, pretože teraz nie je potrebné hodiny čakať na vlastný stand.
A nie je prekážka, niet čakania medzi testovaniami. Môžete naozaj ísť a overiť. A tak to bude lepšie, lebo urýchlime vývoj.
Bude menej refaktoringu. Menej chýb sa dostane do produkcie. My ich menej refaktorujeme neskôr.
Môžeme vrátiť nevratné zmeny. To nie je v štandardných prístupoch.
- Je to výhodné, pretože delíme zdroje testovacích prostredí.
Už je to dobré, ale čo ďalšie by sa dalo urýchliť?
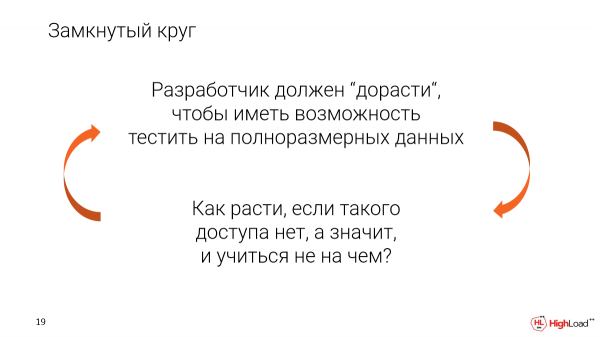
Vďaka takému systému môžeme výrazne znížiť prah vstupu do takého testovania.
Momentálne existuje uzavretý kruh, kde sa vývojár, aby získal prístup k reálnym plnohodnotným údajom, musí stať odborníkom. Musia mu dôverovať s takým prístupom.
Ale ako rásť, ak to nie je možné? A čo ak máš k dispozícii len veľmi malú sadu testovacích údajov? Potom nebude možné získať reálne skúsenosti.
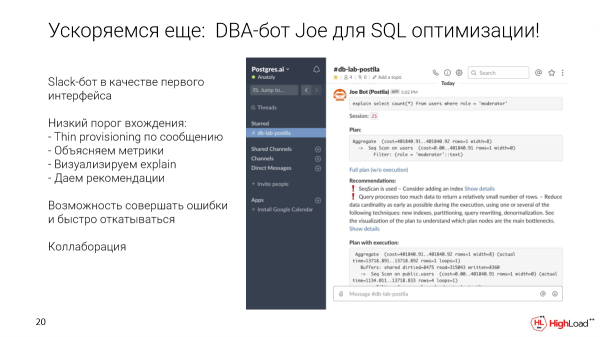
Ako vyjsť z tohto kruhu? Ako prvé rozhranie, ktoré je pohodlné pre vývojárov akejkoľvek úrovne, sme si vybrali Slack-bota. Ale to môže byť akékoľvek iné rozhranie.
Čo to umožňuje? Môžeš vziať konkrétny dotaz a poslať ho do špeciálneho kanála pre databázu. Automaticky rozvineme tenký klon za sekundy. Spustíme tento dotaz. Zbierame metriky a odporúčania. Ukážeme vizualizáciu. A potom tento klon zostane, aby sa tento dotaz mohol nejako optimalizovať, pridať indexy atď.
A tiež nám Slack poskytuje možnosti pre spoluprácu z krabice. Keďže ide jednoducho o kanál, môžeš tam priamo v téme začať diskutovať o takomto dotaze, označiť svojich kolegov, DBA, ktorí sú vnútri firmy.
Ale samozrejme, sú aj problémy. Keďže ide o reálny svet a používame server, na ktorom hostíme naraz veľa klonov, musíme znižovať množstvo pamäte a procesorového výkonu, ktoré sú klonom k dispozícii.
Ale aby tieto testy boli realistické, treba nejako vyriešiť tento problém.
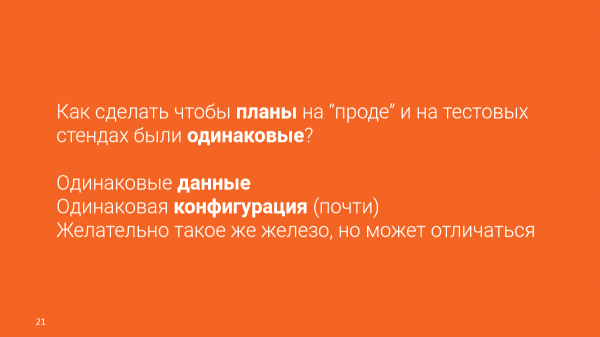
Je jasné, že dôležitým aspektom sú rovnaké údaje. Ale to už máme. A chceme dosiahnuť rovnakú konfiguráciu. A takú prakticky rovnakú konfiguráciu môžeme poskytnúť.
Bolo by skvelé mať rovnaký hardvér ako na produkcii, ale môže sa líšiť.
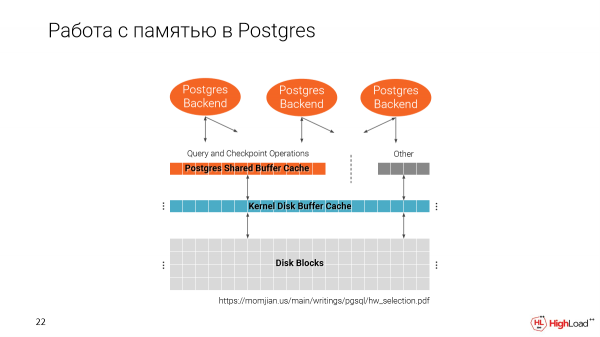
Pripomeňme si, ako Postgres pracuje s pamäťou. Máme dva cache. Jeden od súborového systému a druhý vlastný Postgres, t. j. Shared Buffer Cache.
Je dôležité poznamenať, že Shared Buffer Cache sa alokuje pri štarte Postgres v závislosti od toho, akú veľkosť nastavíte v konfigurácii.
A druhá cache využíva všetok dostupný priestor.
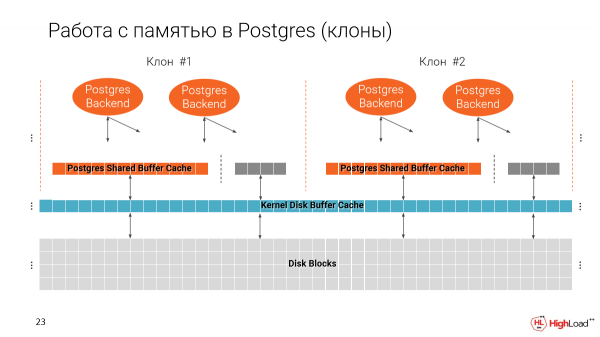
A keď robíme niekoľko klonov na jednom stroji, postupne zapĺňame pamäť. A ideálne by mal byť Shared Buffer Cache 25 % z celkového objemu pamäte, ktorý je na stroji dostupný.
A vychádza to tak, že ak nebudeme tento parameter meniť, môžeme na jednom stroji spustiť iba 4 instance, teda 4 také tenké klony. A to je samozrejme zlé, pretože ich chceme mať oveľa viac.
Ale na druhej strane, Buffer Cache sa používa na vykonávanie dotazov, pre indexy, teda plán závisí od toho, akú veľkosť máme cache. A ak tento parameter jednoducho zmenšíme, plány sa môžu výrazne zmeniť.
Napríklad, ak máme na prod veľkú cache, Postgres bude preferovať používať index. A ak nie, tak potom bude SeqScan. A aký by mal zmysel, keby sa tieto plány nelíšili?
Ale tu prichádzame k takému riešeniu, že plán v Postgres v skutočnosti nezávisí od konkrétnej veľkosti, ktorú zadáme do Shared Buffer, ale závisí od effective_cache_size.
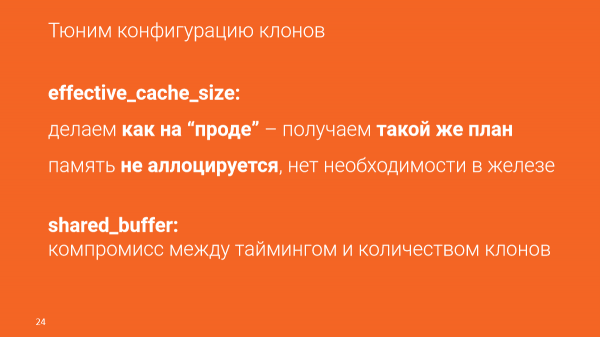
Effective_cache_size je predpokladaný objem cache, ktorý máme k dispozícii, teda v súčte Buffer Cache a cache súborového systému. To je nastavené v konfigurácii. A táto pamäť nie je alokovaná.
A vďaka tomuto parametru môžeme akoby podvádzať Postgres, hovoriac, že v skutočnosti máme veľa dát, aj keď ich nemáme. A tak budú plány úplne zhodné s produkciou.
Ale to môže ovplyvniť časovanie. A optimalizujeme dotazy podľa časovania, ale dôležité je, že časovanie závisí od mnohých faktorov:
Závisí od zaťaženia, ktoré aktuálne existuje na prod.
Závisí od charakteristík samotného stroja.
A to je nepriame parametre, ale v skutočnosti môžeme optimalizovať presne podľa množstva dát, ktoré tento dotaz prečíta, aby sme získali výsledok.
A ak chcete, aby načasovanie bolo blízke tomu, čo uvidíme v produkcii, musíme zobrať čo najpodobnejšie hardvérové vybavenie a možno aj viac, aby sa všetky kópie zmestili. Ale toto je kompromis, teda dostanete rovnaké plány, uvidíte, koľko dát prečíta konkrétna požiadavka a budete si môcť urobiť záver – táto požiadavka je dobrá (alebo migrácia) alebo zlá, treba ju ešte optimalizovať.
Pozrime sa, ako konkrétne prebieha optimalizácia s Joeom.
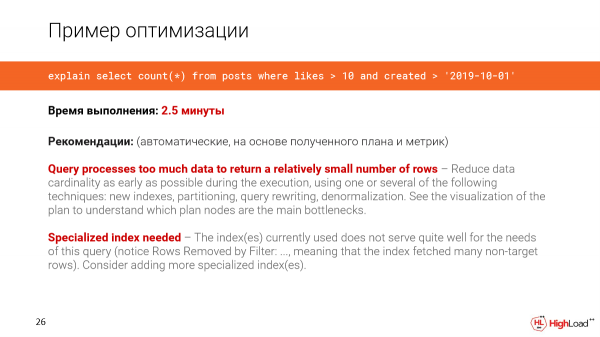
Zoberme si požiadavku z reálneho systému. V tomto prípade je databáza – 1 terabajt. A chceme spočítať počet čerstvých príspevkov, ktoré získali viac ako 10 lajkov.
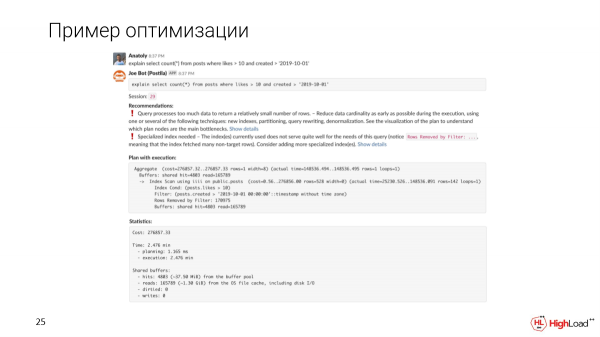
Napíšeme správu do kanála, pre nás sa rozvinie kópia. A uvidíme, že takáto požiadavka bude spracovaná za 2,5 minúty. To je prvé, čo si všimneme.
Joe nám ukáže automatické odporúčania založené na pláne a metrikách.
Uvidíme, že požiadavka spracováva príliš veľa dát na to, aby získala relatívne malé množstvo riadkov. A potrebujeme nejaký špecializovaný index, pretože sme si všimli, že v požiadavke je príliš veľa filtrovaných riadkov.
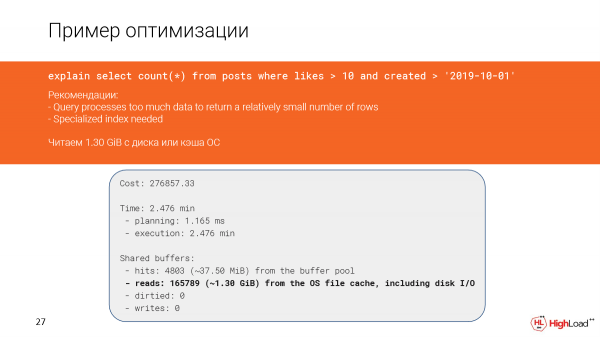
Pozrime sa podrobnejšie, čo sa stalo. Naozaj vidíme, že sme prečítali takmer 1,5 gigabajtu dát z diskového cache alebo dokonca z disku. A to nie je dobré, pretože sme dostali len 142 riadkov.
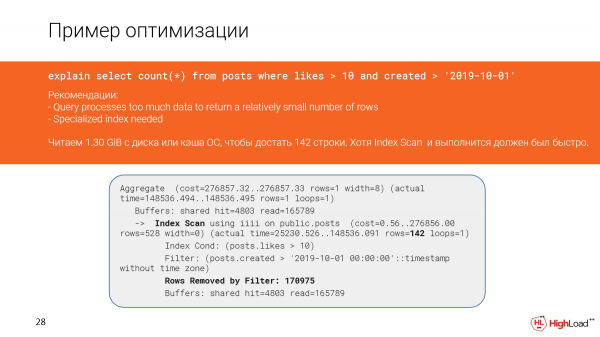
A zdalo by sa, že tu máme index scan a malo to rýchlo spracovať, ale keďže sme filtrovali príliš veľa riadkov (museli sme ich počítať), požiadavka bola spracovaná pomaly.
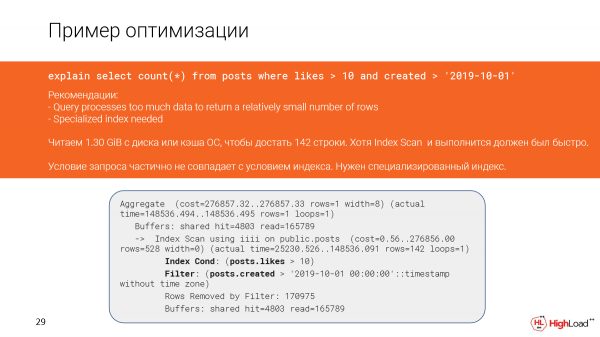
A to sa stalo v pláne preto, že podmienky v požiadavke a podmienky v indexe sa čiastočne nezhodovali.
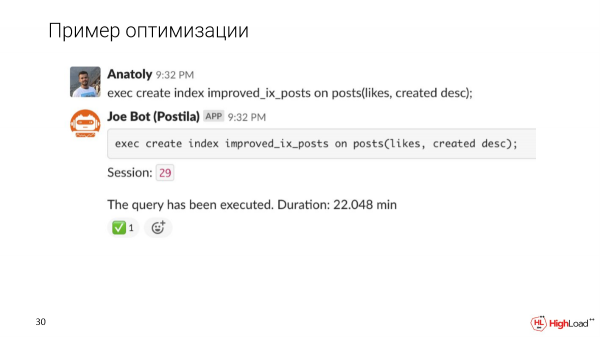
Skúsme urobiť index presnejší a pozrime sa, ako sa zmení výkon požiadavky po tomto.
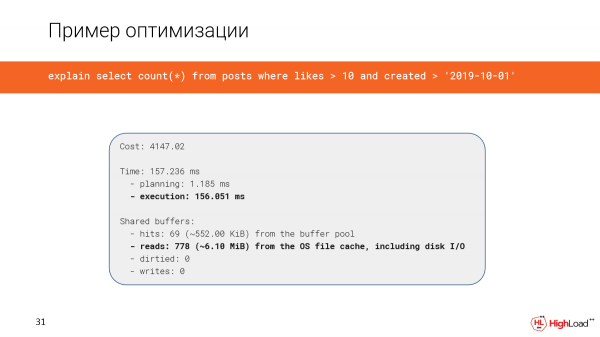
Vytvorenie indexu trvalo pomerne dlhú dobu, ale teraz kontrolujeme požiadavku a vidíme, že čas sa namiesto 2,5 minút znížil na len 156 milisekúnd, čo je dosť dobré. A čítame len 6 megabajtov dát.
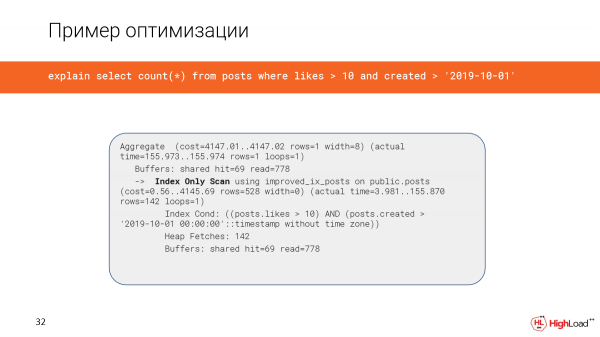
A teraz používame index only scan.
Ďalšia dôležitá vec je, že chceme plán predstaviť nejakým zrozumiteľnejším spôsobom. U nás sme implementovali vizualizáciu pomocou Flame Graphs.
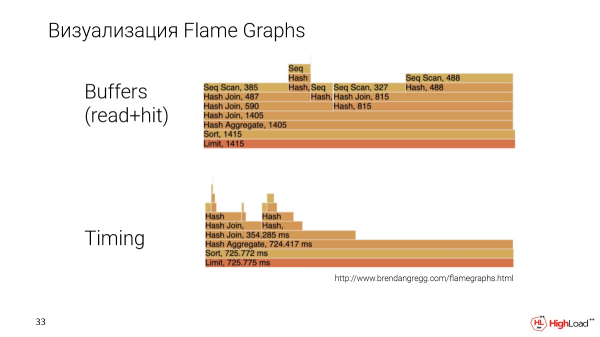
Toto je iná požiadavka, bohatšia. A Flame Graphs vytvárame na základe dvoch parametrov: množstvo dát, ktoré konkrétny uzol v pláne čítal, a časovanie, teda čas vykonávania uzla.
Tu môžeme porovnávať konkrétne uzly navzájom. Bude jasné, ktorý z nich zaberá viac alebo menej, čo je zvyčajne ťažké robiť pri iných spôsoboch vizualizácie.
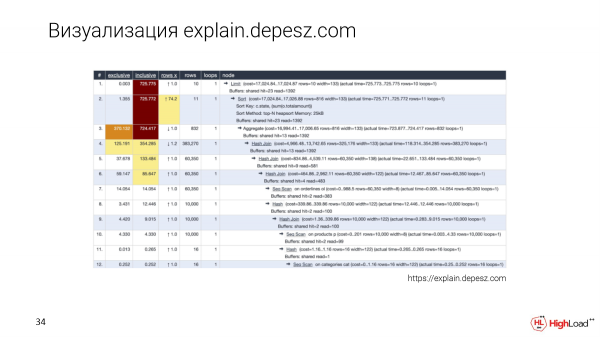
Samozrejme, všetci poznajú explain.depesz.com. Dobrou funkciou tejto vizualizácie je, že uchovávame textový plán a tiež vystavujeme niektoré hlavné parametre do tabuľky, aby sme ich mohli triediť.
A vývojári, ktorí sa ešte do tejto témy hlboko nezapojili, tiež využívajú explain.depesz.com, pretože je pre nich jednoduchšie pochopiť, ktoré metriky sú dôležité a ktoré nie.
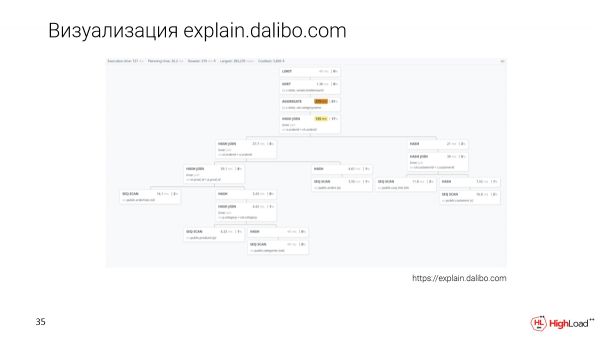
Existuje nový prístup k vizualizácii – explain.dalibo.com. Vytvárajú stromovú vizualizáciu, ale tu je veľmi ťažké porovnať uzly medzi sebou. Je dobré pochopiť štruktúru, avšak ak bude veľký dotaz, bude potrebné scrollovať sem a tam, ale je to tiež varianta.
Spolupráca
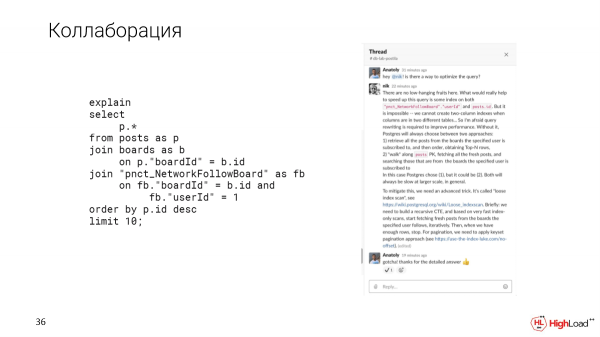
A ako už som povedal, Slack nám poskytuje príležitosť na spoluprácu. Napríklad, ak narazíme na zložitý dotaz, ktorý nevieme, ako optimalizovať, môžeme v thread na Slacku tento problém objasniť so svojimi kolegami.
Myslíme si, že je dôležité testovať na plnohodnotných údajoch. Na tento účel sme vytvorili nástroj Update Database Lab, ktorý je dostupný v open source. Môžete tiež použiť bota Joe. Môžete si ho zobrať hneď teraz a implementovať ho u seba. Všetky príručky sú tam dostupné.
Je dôležité tiež poznamenať, že samotné riešenie nie je nijak revolučné, pretože existuje Delphix, ale to je enterprise riešenie. Je úplne uzavreté, stojí veľmi veľa. My sa špecializujeme na Postgres. Tieto produkty sú všetky open source. Pridajte sa k nám!
Týmto končím. Ďakujem!
Otázky
Dobrý deň! Ďakujem za prednášku! Veľmi zaujímavé, najmä pre mňa, pretože som pred nejakým časom riešil dosť podobnú úlohu. A preto mám celý rad otázok. Dúfam, že aspoň niektoré z nich položím.
Zaujímalo by ma, ako si počítate miesto pre toto prostredie? Technológia predpokladá, že za určitých okolností môžu vaše klony narásť na maximálnu veľkosť. Zjednodušene povedané, ak máte desaťterabajtovú databázu a 10 klonov, je ľahké simulovať situáciu, kedy každý klon bude obsahovať 10 unikátnych údajov. Ako si počítate toto miesto, t. j. tú deltu, o ktorej ste hovorili, v ktorej budú tieto klony žiť?
Dobrý otázka. Tu je dôležité pozerať sa na konkrétne klony. A ak sa nejaká klon príliš zmení a začne rásť, môžeme najprv upozorniť používateľa na to, alebo okamžite tento klon zastaviť, aby sa nám nestala situácia zlyhania.
Áno, mám doplňujúcu otázku. T. j. ako zabezpečujete životný cyklus týchto modulov? Pre nás je to problém a celá samostatná téma. Ako to prebieha?
Každý klon má nejaký ttl. V podstate máme pevný ttl.
Aký, ak to nie je tajné?
1 hodina, t. j. idle – 1 hodina. Ak sa nepoužíva, tak ho zrušíme. Ale tu nie je žiadne prekvapenie, pretože klon môžeme spustiť za sekundy. A ak ho znova potrebujeme, tak – prosím.
Zaujíma ma aj výber technológií, pretože my napríklad paralelne používame niekoľko metód z rôznych dôvodov. Prečo práve ZFS? Prečo ste nepoužili LVM? Spomenuli ste, že s LVM boli problémy. Aké problémy to boli? Podľa mňa je najoptimálnejšia verzia so SÚB, z hľadiska výkonu.
Aký je hlavný problém so ZFS? V tom, že musíte spúšťať na jednom hoste, t. j. všetky inštancie budú žiť v rámci jedného operačného systému. A v prípade SÚB môžete pripojiť rôzne vybavenie. A úzkym miestom sú len tie bloky, ktoré sú na SÚB. A zaujíma ma práve otázka výberu technológií. Prečo nie LVM?
O LVM môžeme konkrétne diskutovať na meetupe. O SÚB – je to jednoducho drahé. Systém ZFS môžeme implementovať kdekoľvek. Môžete si ho nainštalovať na svojom počítači. Môžete si jednoducho stiahnuť repozitár a nainštalovať ho. ZFS sa dá spustiť prakticky všade, ak hovoríme o Linuxe. T. j. dostávame veľmi flexibilné riešenie. A samotný ZFS ponúka už z krabice veľmi veľa. Môžete tam nahrávať neobmedzené množstvo dát, pripojiť veľké množstvo diskov, sú tam snapshoty. A, ako som už povedal, je to jednoducho administratívne. T. j. zdá sa, že je veľmi príjemný na používanie. Je overený, má veľa rokov. Má veľmi veľkú komunitu, ktorá rastie. ZFS je veľmi spoľahlivé riešenie.
Nikolaj Samochvalov: Môžem ešte komentovať? Volám sa Nikolaj, spolupracujem s Anatolim. Súhlasím, že SÚB je skvelé. A niektorí naši zákazníci majú Pure Storage atď.
Anatolij správne poznamenal, že sa sústreďujeme na modulárnosť. Do budúcnosti môžeme realizovať jedno rozhranie – vytvoriť snapshot, vytvoriť klon, zničiť klon. To všetko je jednoduché. A úložný systém je skvelý, ak ho máme.
Ale ZFS je dostupný pre všetkých. Už je dosť DelPhix, majú 300 klientov. Z nich vo fortune 100 – 50 klientov, t. j. zacielujú na NASA a podobne. Je načase, aby bola táto technológia dostupná pre všetkých. A preto máme open source Core. Máme časť rozhrania, ktorá nie je open source. To je platforma, ktorú ukážeme. Ale chceme, aby to bolo dostupné každému. Chceme urobiť revolúciu, aby všetci testeri prestali hádať na notebookoch. Musíme písať SELECT a okamžite vidieť, že je pomalý. Dosť čakať, kým nám DBA o tom povie. Toto je hlavný cieľ. A myslím, že sa k tomu dostaneme všetci. A túto vec robíme, aby to mali všetci. Preto ZFS, pretože bude dostupný všade. Ďakujeme komunite za riešenie problémov a za to, že tam je open source licencia a podobne.
Dobrý deň! Ďakujem za prednášku! Volám sa Maxim. Riešili sme také isté problémy. U seba na to máme riešenie. Ako delíte zdroje medzi týmito klonmi? Každý klon môže v každom okamihu robiť svoje: jeden testuje jedno, druhý iné, niekto má stavaný index, niekto vykonáva náročný job. A ak môžeme rozdeliť CPU, ako delíte IO?
A druhá otázka týkajúca sa odlišnosti prostredí. Predpokladajme, že tu mám ZFS a všetko je skvelé, ale klient na produkte nemá ZFS, ale napríklad ext4. Ako v tom prípade?
Otázky sú veľmi dobré. Trochu som spomenul tento problém s delením zdrojov. A riešenie je nasledovné. Predstavte si, že testujete na stagingu. Môže sa stať, že niekto dá jednu záťaž, niekto inú. A nakoniec vidíte nejasné metriky. Taký istý problém môže byť aj na produkte. Keď chcete skontrolovať nejaký dopyt a vidíte, že s ním je nejaký problém – pomaly sa spracováva, v skutočnosti problém nebol v dopyte, ale v tom, že je nejaká paralelná záťaž.
A preto je dôležité sústrediť sa na to, aký bude plán, aké kroky v pláne podnikneme a koľko dát na to vyberieme. To, že budú disky, povedzme, zaťažené niečím, konkrétne ovplyvní načasovanie. Ale môžeme posúdiť, aký je tento dopyt náročný podľa množstva dát. Nie je tak dôležité, že súčasne s ním bude niečo iné, čo je potrebné vykonať.
Mám dve otázky. Toto je naozaj skvelá vec. Stalo sa niekedy, že dáta na produkcii sú kriticky dôležité, napríklad čísla kreditných kariet? Existuje už niečo hotové, alebo je to samostatná úloha? A druhá otázka – máme niečo podobné pre MySQL?
Pokiaľ ide o dáta. Budeme vykonávať obfuskovanie, kým to ešte nerobíme. Ale ak nastavujete presne Joe, ak neposkytujete prístup vývojárom, tak prístup k údajom nie je. Prečo? Pretože Joe nezobrazuje dáta. Zobrazuje len metriky, plány a všetko. Bolo to zámerne urobené, pretože – to je jedna z požiadaviek nášho klienta. Chceli mať možnosť optimalizovať, ale zároveň neposkytovať prístup každému.
Pokiaľ ide o MySQL. Tento systém sa dá použiť na čokoľvek, čo uchováva stav na disku. A keďže sa zaoberáme Postgresom, momentálne prioritne robíme kompletnú automatizáciu pre Postgres. Chceme automatizovať získavanie dát z backupu. Správne konfigurujeme Postgres. Vieme, ako urobiť, aby plány súhlasili atď.
Ale keďže je systém rozšíriteľný, bude sa tiež môcť použiť pre MySQL. A takéto príklady existujú. Podobná vec existuje u Yandexu, ale nikde ju nezverejňujú. Používajú ju vo vnútri Yandex.Metriky. A tam ide práve o históriu MySQL. Ale technológie sú rovnaké, ZFS.
Ďakujem za prezentáciu! Mám tiež pár otázok. Spomenuli ste, že klonovanie sa dá použiť na analýzu, napríklad na vytváranie ďalších indexov. Môžete o tom povedať trochu podrobnejšie, ako to funguje?
A hneď sa spýtam na otázku týkajúcu sa rovnakosti stánkov a rovnakosti plánov. Plán závisí aj od štatistiky zozbieranej Postgresom. Ako túto problémovú situáciu riešite?
V oblasti analýzy konkrétnych prípadov nemáme ešte žiadne dáta, pretože sme ich doteraz nepoužívali, ale taká možnosť existuje. Ak hovoríme o indexoch, predstavte si, že sa vykonáva dopyt na tabuľke s hundrou miliónov záznamov a na stĺpci, ktorý zvyčajne nie je v prevádzke indexovaný. A chceme počítať určité dáta. Ak tento dopyt spustíme na produkte, existuje možnosť, že na produkte dôjde k výpadku, pretože dopyt tam potrvá minútu.
Dobre, urobme tenký klon, ktorý nebude hrozné na niekoľko minút zastaviť. A aby sme komfortnejšie mohli analyzovať údaje, pridáme indexy na stĺpce, ktoré nás zaujímajú.
Bude sa index vytvárať každý raz?
Môžeme to urobiť tak, že sa dotkneme údajov, spravíme snímky a potom sa z tejto snímky obnovíme a spustíme nové dopyty. T. j. môžeme to urobiť tak, že dokážeme vytvárať nové klony už s nastavenými indexmi.
Čo sa týka otázky o štatistike, ak sa obnovujeme z zálohy, ak robíme replikáciu, štatistika bude presne rovnaká. Pretože budeme mať úplnú fyzickú štruktúru údajov, t. j. dáta ako také so všetkými metrikami štatistiky prinesieme tiež.
Tu je iný problém. Ak používate cloudové riešenie, tam sú dostupné iba logické dumpy, pretože Google a Amazon nedovolia získať fyzickú kópiu. Tam vznikne taký problém.
Ďakujem za správu. Tu zazneli dve dobré otázky o MySQL a o rozdelení zdrojov. V podstate sa však všetko znižuje na to, že ide o tému nie konkrétnych DBMS, ale celkovo o súborový systém. A podľa toho by sa aj otázky rozdelenia zdrojov mali riešiť odtiaľ, nemali by sme to brať na konci, že ide o Postgres, ale v súborovom systéme, v serveri, v instance.
Môj otázka je trochu iná. Je bližšie k vrstveniu databázy, kde je niekoľko vrstiev. Napríklad sme nastavili aktualizáciu desaťterabajtového obrazu, prebieha replikácia. A konkrétne toto riešenie používame pre databázy. Replikácia prebieha, dôjde k aktualizácii údajov. Tu sú súbežne zamestnaní 100 zamestnanci, ktorí neustále spúšťajú tieto rôzne snímky. Čo robiť? Ako zabezpečiť, aby nedošlo k konfliktu, že spustili jedno a potom sa súborový systém zmenil a všetky tieto snímky zlyhali?
Nebudú jazdiť, pretože takto funguje ZFS. Môžeme uchovávať samostatne v jednom vlákne zmeny súborového systému, ktoré prichádzajú cez replikáciu. A na starých verziách dát uchovávať klony, ktoré používajú vývojári. A to nám funguje, s tým je všetko v poriadku.
Vyzerá to tak, že aktualizácia sa bude uskutočňovať ako dodatočná vrstva a všetky nové snímky budú vychádzať z tejto vrstvy, nie?
Z predchádzajúcich vrstiev, ktoré vznikli z predchádzajúcich replikácií.
Predchádzajúce vrstvy zmiznú, ale budú odkazovať na starú vrstvu, zatiaľ čo nové obrazy vezmú z poslednej vrstvy, ktorá bola získaná pri aktualizácii?
V zásade áno.
Potom budeme mať veľa vrstiev. A časom ich budeme musieť zlučovať?
Áno, presne. Existuje určité okno. Uchovávame týždenné snímky. To závisí od toho, aký máte zdroj. Ak máte kapacitu uchovávať veľa dát, môžete uchovávať snímky dlhodobo. Ony sa samé neodstránia. Žiadna korupcia dát nebude. Ak sa nám zdá, že sú snímky zastarané, tj. to závisí od politiky vo firme, môžeme ich jednoducho vymazať a uvoľniť miesto.
Dobrý deň, ďakujem za prezentáciu! K otázke Joea. Povedali ste, že zákazník nechcel dať prístup všetkým k dátam. Stricto sensu, ak má človek výsledok Explain Analyze, môže si dáta prezerať.
Presne tak. Napríklad môžeme napísať: „SELECT FROM WHERE email = niekto“. Tj. neuvidíme samotné dáta, ale môžeme sa pozrieť na nejaké nepriamé znaky. To treba chápať. Ale na druhej strane, všetko je to viditeľné. Máme audit logov, máme kontrolu iných kolegov, ktorí tiež vidia, čím sa zaoberajú vývojári. A ak sa niekto pokúsi takto konať, bezpečnostná služba k nim príde a bude sa tým zaoberať.
Dobrý deň! Ďakujem za prezentáciu! Mám krátku otázku. Ak sa v spoločnosti Slack nepoužíva, existuje k tomu nejaká väzba, alebo môžeme pre vývojárov nasadiť inštancie, aby sa pripojili k testovacej aplikácii databáz?
Momentálne je k dispozícii iba integrácia so Slackom, t.j. nie je prítomný žiadny iný messenger, ale veľmi by sme chceli podporiť aj ďalšie messengery. Čo môžete urobiť? Môžete si nasadiť DB Lab bez Joea, pracovať prostredníctvom REST API alebo pomocou našej platformy a vytvárať klony a pripojiť sa pomocou PSQL. Ale toto môžete vykonať, ak ste pripravení dať svojim vývojárom prístup k údajom, pretože tu už nebude žiadne rozhranie.
Túto vrstvu nepotrebujem, ale potrebujem túto možnosť.
Takže – áno, to je možné.
Zdroj: habr.com
