

Ahojte všetci! Volám sa Pavel Agaletcký. Pracujem ako tímový líder v tíme, ktorý vyvíja doručovaciu systém Lamoda. V roku 2018 som vystúpil na konferencii HighLoad++, a dnes chcem predstaviť prepis svojej prezentácie.
Moja téma sa venuje skúsenostiam našej spoločnosti pri nasadení systémov a služieb do rôznych prostredí. Začneme od našich pravekých čias, keď sme nasadzovali všetky systémy na obyčajné virtuálne servery, končiac postupným prechodom od Nomad po nasadenie do Kubernetes. Povieme si, prečo sme to urobili a aké problémy sme mali v procese.

Nasadenie aplikácií na VM
Začneme tým, že pred 3 rokmi všetky systémy a služby spoločnosti boli nasadzované na obyčajné virtuálne servery. Technicky to bolo usporiadané tak, že celý kód našich systémov ležal a bol zostavovaný pomocou automatizovanej zostavy, s pomocou jenkins. Pomocou Ansible sa rozkladali z nášho systému kontroly verzií na virtuálne servery. Pri tom každá systém, ktorý sme mali v našej spoločnosti, bol nasadený minimálne na 2 serveroch: jeden z nich bol head, druhý bol tail. Tieto dva systémy boli vo všetkých svojich nastaveniach, výkonnosti, konfigurácii a iných parametroch úplne identické. Rozdiel medzi nimi bol len v tom, že head prijímal používateľský traffic, zatiaľ čo tail nikdy neprijímal traffic používateľov.
Na čo to bolo urobené?
Keď sme nasadzovali nové verzie našej aplikácie, chceli sme zabezpečiť možnosť bezproblémového nasadenia, teda bez viditeľných následkov pre používateľov. Dosahovalo sa to tým, že ďalšia zostavená verzia sa pomocou Ansible nasadzovala na tail. Tam mohli ľudia, ktorí sa zaoberali nasadením, skontrolovať a uistiť sa, že všetko je v poriadku: všetky metriky, sekcie a aplikácie fungujú; spúšťajú sa potrebné skripty. Až potom, čo sa uistili, že všetko je v poriadku, sa traffic prepol. Ten začal prichádzať na server, ktorý do tej doby bol tail. A ten, ktorý do tej doby bol head, zostal bez používateľského trafficu, pričom mal predchádzajúcu verziu našej aplikácie.
Pre užívateľov to bolo bezproblémové. Pretože preklik je okamžitý, keďže ide iba o prehodnotenie vyvažovača. Je veľmi jednoduché vrátiť sa na predchádzajúcu verziu jednoducho prehodnotením vyvažovača späť. Taktiež sme sa mohli uistiť o schopnosti aplikácie na produkcii ešte predtým, ako na ňu pôjde užívateľský traffic, čo bolo dosť pohodlné.
Aké sme videli v celom tomto výhody?
- Predovšetkým, je to dosť jednoduché fungovanie. Všetkým je jasné, ako funguje takáto schéma nasadenia, pretože väčšina ľudí niekedy nasadila na bežné virtuálne servery.
- Je to dosť spoľahlivé, pretože technológia nasadenia je jednoduchá, overená tisíckami spoločností. Milióny serverov sa nasadzujú práve takto. Je ťažké niečo pokaziť.
- A nakoniec, mohli sme získať atomárne nasadenia. Nasadenia, ktoré sa pre užívateľov uskutočňujú okamžite, bez viditeľnej fázy prechodu medzi starou a novou verziou.
Ale v tom všetkom sme tiež videli niekoľko nevýhod:
- Okrem produkčného prostredia, vývojového prostredia, existujú aj ďalšie prostredia. Napríklad, qa a preprodukcia. V tom čase sme mali veľa serverov a približne 60 služieb. Z tohto dôvodu sme museli pre každú službu udržiavať aktuálnu verziu virtuálneho stroja. A ak chcete aktualizovať knižnice alebo nainštalovať nové závislosti, musíte to urobiť vo všetkých prostrediach. Tiež bolo potrebné synchronizovať čas, kedy plánujete nasadiť novú verziu vašej aplikácie, s časom, kedy devops vykoná potrebné nastavenia prostredia. V takom prípade je ľahké sa dostať do situácie, kedy sa naše prostredie bude mierne líšiť vo všetkých prostrediach po sebe. Napríklad, v QA prostredí budú iné verzie knižníc ako v produkcii, čo povedie k problémom.
- Zložitosť pri aktualizácii závislostí vašej aplikácie. To nezávisí od vás, ale od iného tímu. A konkrétne, od tímu devops, ktorý spravuje servery. Musíte im nastaviť príslušnú úlohu a poskytnúť popis toho, čo chcete urobiť.
- V tom čase sme sa tiež chceli zbaviť našich veľkých monolitov a rozdeliť ich na menšie služby, pretože sme vedeli, že ich bude stále viac a viac. V tom čase sme už mali viac ako 100 takýchto služieb. Pre každú novú službu bolo potrebné vytvoriť samostatnú virtuálnu mašinu, ktorú bolo tiež nutné spravovať a nasadzovať. Okrem toho potrebujeme nie jednu, ale aspoň dve mašiny. K tomu všetkému potrebujeme aj testovaciu (QA) prostredie. To spôsobuje problémy a robí vytváranie a spustenie nových systémov pre vás oveľa komplexnejším, nákladnejším a zdĺhavejším procesom.
Preto sme sa rozhodli, že bude pohodlnejšie prejsť od nasadzovania bežných virtuálnych strojov k nasadenie našich aplikácií v kontajneri Docker. Pri používaní Docker potrebujeme systém, ktorý dokáže spustiť aplikáciu v klastri, pretože jednoducho nezvládnete len tak spustiť kontajner. Zvyčajne chcete sledovať počet spustených kontajnerov, aby sa automaticky spúšťali. Z tohto dôvodu sme potrebovali vybrať systém na správu.
Dlho sme uvažovali, ktorú z nich si zobrať. Problém bol v tom, že v tom čase bol náš nasadzovací stack na bežné virtuálne servery zastaraný, pretože sme tam mali nie najnovšie verzie operačných systémov. V určitom momente sme tam mali dokonca FreeBSD, čo bolo ťažké podporovať. Uvedomovali sme si, že musíme čo najskôr migrovať na Docker. Naši DevOps si prezreli svoju existujúcu prax s rôznymi riešeniami a vybrali systém ako Nomad.
Prechod na Nomad
Nomad je produkt spoločnosti „HashiCorp“. Taktiež sú známi svojimi ďalšími riešeniami:
„Consul“ — je nástroj na objavovanie služieb.
„Terraform“ — systém na správu serverov, ktorý vám umožňuje nastaviť ich prostredníctvom konfigurácie, známej ako infrastructure-as-a-code.
„Vagrant“ umožňuje vám nasadzovať virtuálne stroje lokálne alebo v cloude pomocou definovaných konfiguračných súborov.
Nomad v tom čase vyzeral ako dostatočne jednoduché riešenie, na ktoré je možné rýchlo prejsť bez zmeny celej infraštruktúry. Okrem toho je aj dosť ľahko ovládateľný. Preto sme ho vybrali ako systém na správu našich kontajnerov.
Čo potrebujete na to, aby ste vôbec mohli nasadiť váš systém do Nomad?
- Predovšetkým potrebujete docker image vašej aplikácie. Je potrebné ju zostaviť a umiestniť do úložiska obrazov docker. V našom prípade je to artifactory — systém, ktorý umožňuje ukladať rôzne artefakty rôzneho typu. Ukladá archívy, docker obrazy, RHP balíky, NPM balíky a tak ďalej.
- Tiež je potrebné konfiguračný súbor, ktorý povie Nomadovi, čo, kam a v akom množstve chcete nasadiť.
Keď hovoríme o Nomade, ako formát informačného súboru používa jazyk HCL, čo je skratka pre HashiCorp Configuration Language. Je to nadmnožina jazyka YAML, ktorá vám umožňuje popísať vašu službu pojmami Nomadu.
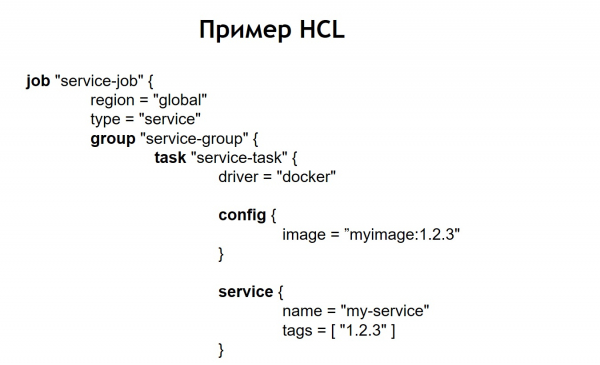
Umožňuje vám povedať, koľko kontajnerov chcete nasadiť, z ktorých obrázkov im poslať rôzne parametre pri nasadení. Takto podávate tento súbor Nomadu, ktorý spúšťa kontajnery v produkcii podľa neho.
V našom prípade sme si uvedomili, že písanie absolútne identických HCL súborov pre každú službu by nebolo veľmi pohodlné, pretože služieb je veľa a občas ich chcete aktualizovať. Môže sa stať, že jedna služba nie je nasadená v jednom exemplári, ale v rôznych. Napríklad jeden z našich systémov v produkcii má viac ako 100 inštancií v prevádzke. Spúšťajú sa z tých istých obrazov, ale líšia sa konfiguráciou a konfiguračnými súbormi.
Preto sme sa rozhodli, že bude pohodlné uchovávať všetky naše konfiguračné súbory pre nasadenie v jednom spoločnom repozitári. Takto sa stali prehľadnými: bolo ich ľahké udržiavať a mohli sme vidieť, aké systémy máme. V prípade potreby nie je tiež ťažké niečo aktualizovať alebo zmeniť. Pridať nový systém tiež nebude problém — stačí jednoducho vytvoriť konfiguračný súbor v novej priečinke. Vnútri nej sú súbory: service.hcl, ktorý obsahuje popis našej služby, a niektoré env súbory, ktoré umožňujú túto službu, keď je nasadená do produkcie, nakonfigurovať.
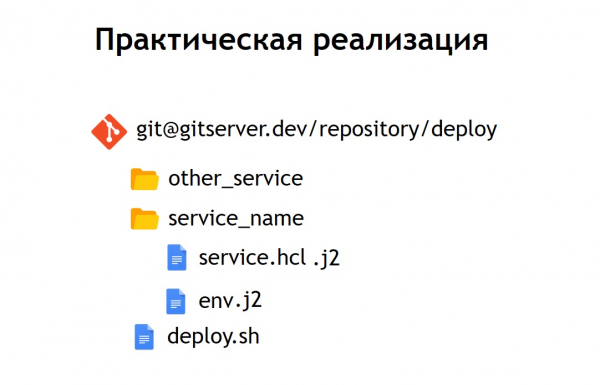
Avšak niektoré naše systémy sú nasadené v produkcii nie v jednom exemplári, ale v niekoľkých naraz. Preto sme sa rozhodli, že bude pre nás pohodlné uchovávať niečie konfigurácie v čistej forme, ale ich šablónovú podobu. A ako jazyk šablonizácie sme vybrali jinja 2. V takom formáte uchovávame nielen konfigurácie samotnej služby, ale aj env-súbory, ktoré sú pre ňu potrebné.
Okrem toho sme do repozitára umiestnili spoločný skript pre všetky projekty, ktorý umožňuje spustiť a nasadiť vašu službu do produkcie, do požadovaného prostredia a ciela. V prípade, že sme náš HCL-konfig premenili na šablónu, tak ten HCL-súbor, ktorý predtým bol obyčajným konfigom Nomad, v tomto prípade vyzerá trochu inak.
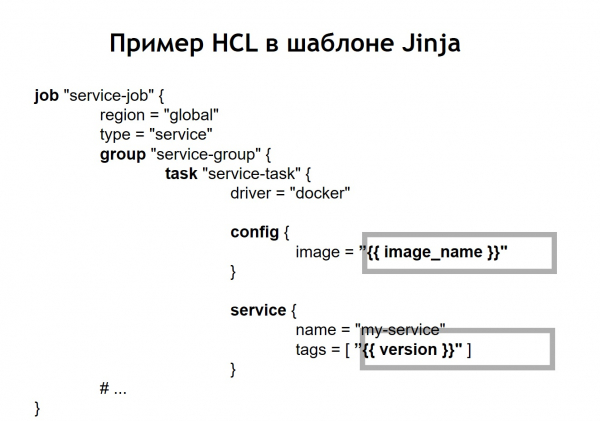
To znamená, že sme nahradili niektoré premenné miesta konfigu vložením premenných, ktoré sa berú z env-súborov alebo z iných zdrojov. Okrem toho sme získali možnosť dynamicky generovať HCL-súbory, to znamená, že môžeme aplikovať nielen obyčajné vkladanie premenných. Keďže jinja podporuje cykly a podmienky, môžeme brať do úvahy aj konfiguračné súbory, ktoré sa menia v závislosti od toho, kam presne nasadzujete svoje aplikácie.
Napríklad, ak chcete nasadiť svoju službu do preprodukcie a do produkcie. Predpokladajme, že v preprodukcii nechcete spúšťať cron-skripty, ale jednoducho chcete vidieť službu na samostatnej doméne, aby ste sa uistili, že funguje. Pre každého, kto nasádza službu, je proces veľmi jednoduchý a transparentný. Stačí spustiť súbor deploy.sh, uviesť, ktorú službu chcete nasadiť a do ktorého cieľa. Napríklad, ak chcete nasadiť nejaký systém do Ruska, Bieloruska alebo Kazachstanu. Na to stačí jednoducho zmeniť jeden z parametrov a správny konfiguračný súbor sa zostaví.
Keď je služba Nomad už nasadená vo vašom klastri, vyzerá to nasledovne.
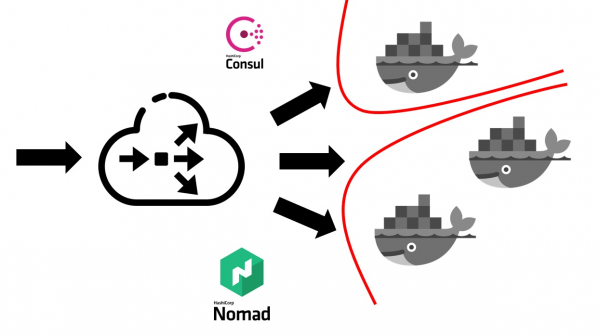
Na začiatok potrebujete nejaký vyvažovač zvonka, ktorý bude prijímať celý používateľský prenos. Bude pracovať spolu s Consul a zisťovať od neho, kde, na ktorej node, podľa akého IP adresu sa nachádza konkrétna služba, ktorá zodpovedá danému doménovému menu. Služby v Consul sa objavujú priamo z Nomad. Keďže ide o produkty tej istej spoločnosti, sú medzi sebou dobre prepojené. Dalo by sa povedať, že Nomad má z boxu schopnosť registrovať všetky spustené služby v ňom priamo v Consul.
Keď váš externý vyvažovač zaťaženia zistí, do ktorej služby má poslať prevádzku, prepošle ju do príslušného kontajnera alebo niekoľkých kontajnerov, ktoré zodpovedajú vašej aplikácii. Samozrejme, pri tom treba myslieť aj na bezpečnosť. Aj keď sa všetky služby spúšťajú na tých istých virtuálnych strojoch v kontajneroch, zvyčajne treba zakázať voľný prístup z ktorejkoľvek služby k akejkoľvek inej. To sme dosiahli pomocou segmentácie. Každá služba bola spustená vo svojej virtuálnej sieti, na ktorej boli nastavené pravidlá smerovania a pravidlá povoľovania/zakazovania prístupových práv k iným systémom a službám. Tieto služby mohli byť buď v rámci tohto klastera, alebo mimo neho. Napríklad, ak chcete zakázať službe pripojiť sa k určitej databáze, môžete to urobiť prostredníctvom segmentácie na úrovni siete. To znamená, že ani chybne sa nemôžete náhodou pripojiť z testovacieho prostredia k vašej produkčnej databáze.
Koľko nás stálo prechod z hľadiska ľudských zdrojov?
Prechod celej spoločnosti na Nomad trval približne 5-6 mesiacov. Prechádzali sme po službách, ale v dosť rýchlom tempe. Každý tím musel vytvoriť svoje vlastné kontajnerové služby.
Prijali sme taký prístup, že každý tím zodpovedá za docker imidže svojich systémov samostatne. DevOps poskytujú spoločnú infraštruktúru potrebnú na nasadenie, teda podporu samotného klastera, podporu CI systému a tak ďalej. V tom čase u nás viac ako 60 systémov prešlo na Nomad, čo vytvorilo okolo 2000 kontajnerov.
DevOps zodpovedá za spoločnú infraštruktúru všetkého, čo súvisí s nasadením a servermi. A každý tím vývoja zase zodpovedá za realizáciu kontajnerov pod svoj konkrétny systém, pretože len tím vie, čo vlastne potrebuje v tom či onom kontajneri.
Dôvody odmietnutia Nomad
Aké výhody sme získali prechodom na nasadenie pomocou Nomad a docker?
- Integrujeme Grafanu s Omnibus poskytli sme rovnaké podmienky pre všetky prostredia. Vo vývoji, QA prostredí, predprodukčnom a produkčnom prostredí sa používajú tieto isté obrazy kontajnerov so všetkými rovnakými závislosťami. Tým pádom máte takmer nulovú šancu, že do produkcie sa dostane niečo, čo ste predtým netestovali lokálne alebo v testovacom prostredí.
- Tiež sme zistili, že je dostatočne ľahké pridať novú službu. Akékoľvek nové systémy z pohľadu nasadenia sa spúšťajú veľmi jednoducho. Stačí ísť do repozitára, kde sa uchovávajú konfigurácie, pridať tam ďalšiu konfiguráciu pre váš systém a máte všetko pripravené. Môžete nasadiť váš systém do produkcie bez dodatočných snáh od devops.
- Všechna konfiguračné súbory v jednom spoločnom repozitári sa ukázali ako prehľadné. V tom momente, keď sme nasadzovali naše systémy pomocou virtuálne servery., sme používali Ansible, v ktorom boli konfigurácie uložené v rovnakom repozitári. Avšak pre väčšinu vývojárov bolo s týmto trochu zložitejšie pracovať. Tu sa objem konfigurácií a kódu, ktorý musíte pridať, aby ste nasadili službu, výrazne znížil. Navyše je pre devops veľmi jednoduché ho opraviť alebo zmeniť. V prípade prechodov, napríklad na novej verzii Nomad, môžu hromadne aktualizovať všetky operačné súbory, ktoré sú uložené na rovnakom mieste.
Ale stretli sme sa aj s niekoľkými nevýhodami:
Ukázalo sa, že sme nedokázali dosiahnuť bezproblémovosť nasadení v prípade Nomad. Pri nasadzovaní kontajnerov z rôznych podmienok mohlo nastať, že bol spustený a Nomad ho považoval za pripravený na prijatie prevádzky. To sa stalo ešte predtým, ako sa aplikácia vnútri stihla spustiť. Z tohto dôvodu systém na krátky čas začínal generovať chyby 500, pretože prevádzka začala prichádzať na kontajner, ktorý ešte nebol pripravený ju prijať.
Stretli sme sa s niektorými chybami. Najvýraznejšou chybou je, že Nomad nie je veľmi dobre prispôsobený pre veľké klastre, ak máte mnoho systémov a kontajnerov. Keď sa rozhodnete uviesť do údržby jeden zo serverov, ktorý je súčasťou klastru Nomad, existuje pomerne veľká pravdepodobnosť, že sa klaster nebude cítiť dobre a rozpadne sa. Niektoré kontajnery môžu napríklad spadnúť a neznovu sa spustiť — to vás následne veľmi draho vyjde, ak sú všetky vaše systémy v produkcii práve v klastre spravovanom Nomadom.
Preto sme sa rozhodli zvážiť, kam sa pohnúť ďalej. V tom čase sme omnoho lepšie chápali, čo chceme dosiahnuť. A to konkrétne: chceme spoľahlivosť, o niečo viac funkcií, než ponúka Nomad, a vyzretejší, stabilnejší systém.
V tomto smere sme sa rozhodli pre Kubernetes ako pre najpopulárnejšiu platformu na spúšťanie klastrov. Najmä vzhľadom na to, že veľkosť a počet našich kontajnerov bol dosť veľký. Pre tieto účely sa Kubernetes ukázal ako najvhodnejší systém zo všetkých, ktoré sme mohli preskúmať.
Prechod na Kubernetes
Trochu poviem o tom, aké sú základné pojmy Kubernetes a čím sa líšia od Nomadu.
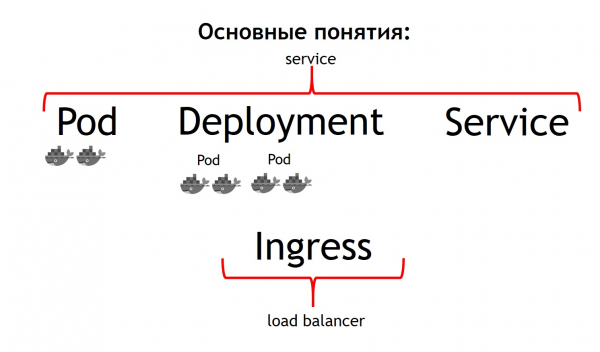
Na prvom mieste je najzákladnejším pojmom v Kubernetes pojem pod. Pod — je to skupina jedného alebo viacerých kontajnerov, ktoré sa vždy spúšťajú spolu. A fungujú akoby vždy priamo na jednom virtuálnom stroji. Sú dostupné navzájom na IP adrese 127.0.0.1 na rôznych portoch.
Predpokladajme, že máte PHP aplikáciu, ktorá sa skladá z nginx a php-fpm – klasický schematický model. Skôr či neskôr budete chcieť, aby kontajnery nginx aj php-fpm boli vždy spolu. Kubernetes to umožňuje dosiahnuť tým, že ich popíšete ako jeden spoločný pod. Práve to sme nedokázali dosiahnuť pomocou Nomadu.
Druhým pojmom je deployment. Pod je totiž efemérna záležitosť, spúšťa sa a zmizne. Či už chcete najprv zastaviť všetky vaše predchádzajúce kontajnery a potom spustiť nové verzie, alebo ich chcete uvádzať postupne – práve za tento proces je zodpovedný pojem deployment. Ten popisuje, ako nasadzujete svoje pod-y, v akom množstve a ako ich aktualizovať.
Tretím pojmom je service. Váš service je fakticky váš systém, ktorý prijíma určitý traffic a potom ho smeruje na jeden alebo viac podov, ktoré zodpovedajú vášmu service. Tým pádom umožňuje určiť, že všetok prichádzajúci traffic pre takýto service s takýmto menom by mal byť poslaný na konkrétne tieto pod. A zároveň zabezpečuje vyrovnávanie trafficu. To znamená, že môžete spustiť dva pody vášho aplikácie a celý prichádzajúci traffic sa bude rovnomerne vyrovnávať medzi podmi patriacimi k tomuto service.
A štvrtý hlavný koncept — Ingress. Je to service, ktorý sa spúšťa v klastri Kubernetes. Vykonáva funkciu externého vyrovnávača záťaže, ktorý preberá všetky požiadavky. Vďaka API Kubernetes Ingress môže určiť, kam by sa mali tieto požiadavky poslať. A robí to veľmi flexibilne. Môžete povedať, že všetky požiadavky na tento host a takýto URL posielame na tento service. A tieto požiadavky, ktoré prichádzajú na tento host a na iný URL, posielame na iný service.
Najcool začo, kto vyvíja aplikáciu — je to, že môžete všetko spravovať samostatne. Nastavením konfigurácie Ingress môžete všetok traffic prichádzajúci na takýto API posielať na samostatné kontajnery, napísané napríklad na Go. A tento traffic, prichádzajúci na ten istý doménový názov, ale na iný URL, posielať na kontajnery, napísané v PHP, kde je veľa logiky, ale nie sú až tak rýchle.
Ak porovnáme všetky tieto pojmy s Nomad, môžeme povedať, že prvé tri pojmy — to všetko spolu tvorí Service. A posledný pojem v Nomade chýba. Ako jeho ekvivalent sme používali externý vyrovnávač: môže to byť haproxy, nginx, nginx+ a tak ďalej. V prípade kubu nemusíte zavádzať toto dodatočné pojem osobitne. Avšak, ak sa pozrieme na Ingress vo vnútri, tak to je buď nginx, alebo haproxy, alebo traefik, ale akoby zabudované v Kubernetes.
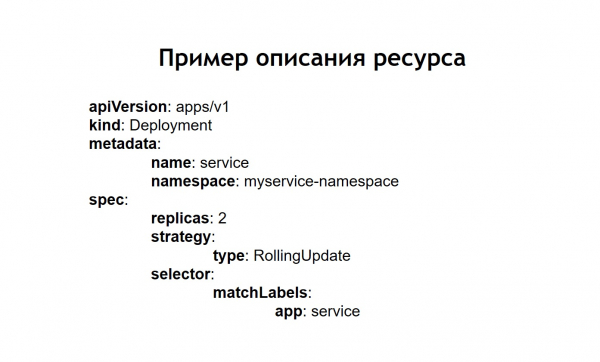
Všetky mnou popísané pojmy sú v podstate zdroje, ktoré existujú vnútri klastra Kubernetes. Na ich popis v kube sa používa yaml formát, ktorý je čitateľnejší a známysí ako HCL súbory v prípade Nomad. Ale štrukturálne popisujú v prípade, napríklad, podu to isté. Hovoria — chcem nasadiť takéto pody tamto, s takými imagami, v takomto množstve.
Okrem toho sme si uvedomili, že nechceme ručne vytvárať každú jednotlivú zložku: deployment, služby, Ingress a podobne. Namiesto toho sme chceli pri nasadení popísať každý systém, ktorý máme, v pojmoch Kubernetes, aby sme nemuseli ručne znova vytvárať všetky potrebné závislosti v správnom poradí. Ako taký systém, ktorý nám to umožnil, bol vybraný Helm.
Základné pojmy v Helme
Helm je správca balíkov pre Kubernetes. Je veľmi podobný tomu, ako fungujú správcovia balíkov v programovacích jazykoch. Umožňujú vám uchovávať službu, ktorá sa skladá napríklad z deployment nginx, deployment php-fpm, konfigurácie pre Ingress, configmaps (to je entita, ktorá vám umožňuje nastaviť env a ďalšie parametre pre váš systém) vo forme tzv. chartov. Helm funguje nad Kubernetes. To znamená, že to nie je nejaký systém, ktorý stojí bokom, ale jednoducho ešte jedna služba spustená vo vnútri klastru. Interagujete s ním cez jeho API pomocou príkazového rozhrania. Jeho pohodlie a krása spočíva v tom, že aj keď helm prestane fungovať alebo ho odstránite z klastru, vaše služby nezmiznú, pretože helm v podstate slúži len na spustenie systému. Za funkčnosť a stav služieb následne zodpovedá samotný Kubernetes.
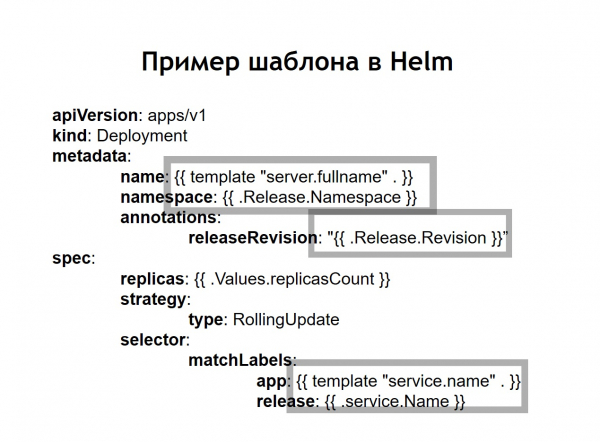
Tiež sme si uvedomili, že šablonizácia, ktorú sme predtým museli robiť sami prostredníctvom implementácie jinja do našich konfigurácií, je jednou z hlavných možností helmu. Všetky konfigurácie, ktoré vytvárate pre svoje systémy, sú uložené v helme vo forme šablón, ktoré sú trochu podobné jinja, ale v skutočnosti používajú šablonizáciu programovacieho jazyka Go, v ktorom je helm napísaný, rovnako ako Kubernetes.
Helm nám pridáva ešte niekoľko ďalších pojmov.
Chart je popis vašej služby. V iných správcovských balíkoch by sa nazval balík, bundle alebo niečo podobné. Tu sa to nazýva chart.
Values sú premenné, ktoré chcete použiť na zostavenie svojich konfigurácií zo šablón.
Verzia. Každý raz, keď sa služba nasadzuje pomocou helm, získa inkrementálnu verziu uvoľnenia. Helm si pamätá, aká bola konfigurácia služby pri predchádzajúcom, predpredchádzajúcom uvoľnení a tak ďalej. Preto, ak je potrebné sa vrátiť späť, stačí vykonať príkaz helm callback s uvedením predchádzajúcej verzie uvoľnenia. Aj keď v okamihu návratu nemusí byť príslušná konfigurácia vo vašom repozitári dostupná, helm si aj tak pamätá, aká bola, a vráti váš systém do stavu, v akom bol pri predchádzajúcom uvoľnení.
V prípade, že používame helm, sa bežné konfigurácie pre Kubernetes tiež menia na šablóny, v ktorých je možné používať premenné, funkcie a aplikovať podmienečné operátory. Takto môžete zostaviť konfiguráciu vašej služby v závislosti od prostredia.
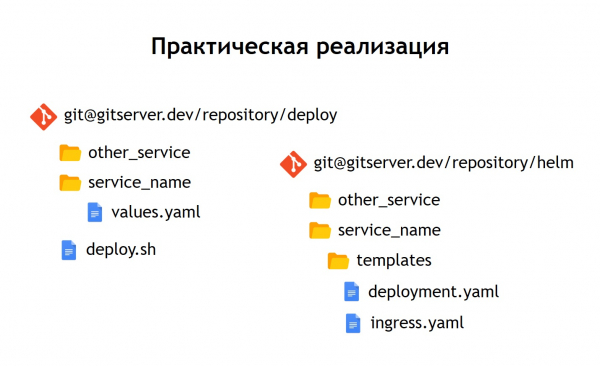
V praxi sme sa rozhodli postupovať trochu inak, než sme robili pri Nomad. Ak v Nomad v jednom repozitári boli uložené aj konfigurácie pre nasadenie, aj n-premenné potrebné na nasadenie našej služby, tu sme sa rozhodli ich rozdeliť na dva samostatné repozitáre. V repozitári „deploy“ sa ukladajú iba n-premenné potrebné na nasadenie, zatiaľ čo v repozitári „helm“ sa uchovávajú konfigurácie alebo grafy.
Čo nám to dalo?
Napriek tomu, že v samotných konfiguračných súboroch neuchovávame skutočne citlivé údaje. Napríklad, heslá k databázam. Tieto sú uchovávané vo forme secrets v Kubernetes, ale predsa len existujú jednotlivé veci, k ktorým nechceme poskytovať prístup všetkým. Preto je prístup k repozitáru „deploy“ obmedzenejší, zatiaľ čo repozitár „helm“ obsahuje iba popis služby. Z tohto dôvodu je možné mu bezpečne poskytovať prístup širšiemu okruhu osôb.
Keďže máme nielen produkciu, ale aj iné prostredia, vďaka takémuto rozdeleniu môžeme znovu používať naše helm-grafy na nasadenie služieb nielen do produkcie, ale aj napríklad do prostredia QA. Dokonca aj na to, aby sme ich nasadili lokálne, používajúc Minikube — to je vec na lokálne spustenie Kubernetes.
V každom repozitári sme ponechali rozdelenie na samostatné adresáre pre každú službu. To znamená, že v každom adresári sa nachádzajú šablóny, ktoré sa týkajú príslušného chartu a popisujú zdroje, ktoré je potrebné nasadiť na spustenie nášho systému. V repozitári „deploy“ sme ponechali len envy. V tomto prípade sme nepoužili šablonizáciu pomocou jinja, pretože helm sám poskytuje šablonizáciu priamo – to je jedna z jeho základných funkcií.
Ponechali sme skript na nasadenie – deploy.sh, ktorý uľahčuje a štandardizuje spustenie nasadenia pomocou helmu. Takže pre každého, kto chce nasadiť, vyzerá rozhranie nasadenia presne tak, ako to bolo pri nasadení cez Nomad. Ten istý deploy.sh, názov vašej služby a miesto, kam chcete, aby bola nasadená. To vedie k tomu, že sa spustí helm. Ten následne zhromažďuje konfigurácie zo šablón, vkladá do nich potrebné values-súbory, a potom nasadí, posielajúc ich do Kubernetes.
Zhrnutie
Služba Kubernetes vyzerá zložitejšie ako Nomad.
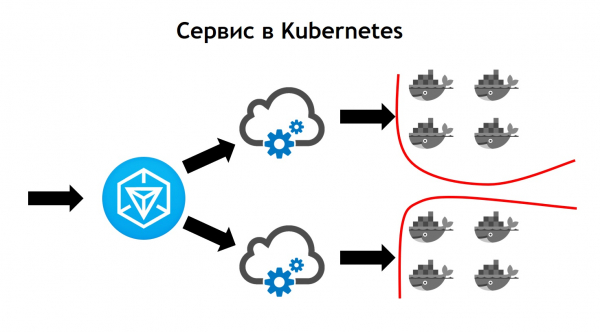
Tu prichádza odchádzajúci trafik do Ingressu. To je frontový kontrolér, ktorý prijíma všetky požiadavky a následne ich posiela do príslušných služieb na základe danej požiadavky. Určuje ich na základe konfigurácií, ktoré sú súčasťou popisu vašej aplikácie v helme a ktoré si vývojári nastavujú sami. Služba potom posiela požiadavky na svoje pod, teda konkrétne kontejnery, vyvažujúc prichádzajúci trafik medzi všetkými kontajnermi, ktoré sa týkajú danej služby. A samozrejme, nemali by sme zabúdať na to, že na úrovni siete, by sme nemali nikam odchádzať od bezpečnosti. Preto v klastre Kubernetes funguje segmentácia, ktorá je založená na označovaní. Všetky služby majú určité označenia, ku ktorým sú viazané práva prístupu služieb k tým alebo oným externým/vnútorným zdrojom vo vnútri alebo mimo klastra.
Pri prechode sme zistili, že Kubernetes má všetky funkcie, ktoré mal Nomad, ktorý sme predtým používali, a pridáva mnoho nového. Môže sa rozširovať cez pluginy a v skutočnosti aj prostredníctvom vlastných typov zdrojov. To znamená, že máte možnosť nielen používať niečo, čo je v Kubernetes zabudované, ale aj vytvoriť vlastný zdroj a službu, ktorá bude tento zdroj čítať. To poskytuje dodatočné možnosti rozšírenia vašej systému bez potreby preinštalovania Kubernetes a bez nutnosti zmien.
Príkladom takého využitia je Prometheus, ktorý beží u nás v klasttri Kubernetes. Aby začal zbierať metriky z rôznej služby, musíme pridať do popisu služby ďalší typ zdroja, takzvaný service-monitor. Vďaka tomu, že Prometheus dokáže čítať vlastné typy zdrojov, keď beží v Kubernetes, automaticky začína zbierať metriky z nového systému. Je to veľmi praktické.
Prvé nasadenie, ktoré sme urobili v Kubernetes, bolo v marci 2018. A od tej doby sme s ním nikdy nemali žiadne problémy. Funguje celkom stabilne bez podstatných chýb. Okrem toho ho môžeme ďalej rozširovať. V súčasnosti nám stačia možnosti, ktoré obsahuje, a veľmi sa nám páčia tempo rozvoja Kubernetes. Momentálne je v Kubernetes viac ako 3000 kontajnerov. Klaster sa skladá z niekoľkých uzlov. Je pritom spravovaný, stabilný a veľmi kontrolovateľný.
Zdroj: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish