

Úvod
Informačný systém je z pohľadu používateľa presne definovaný v normativite STN 51987 – "automatizovaný systém, ktorého výsledkom fungovania je prezentácia výstupných informácií na ďalšie využitie". Ak sa pozrieme na vnútornú štruktúru, v podstate každý IS predstavuje systém algoritmov realizovaných v kóde, ktoré sú navzájom prepojené. Vo všeobecnosti, podľa Turingovej–Churchovej tézy, algoritmus (a teda aj IS) uskutočňuje transformáciu množstva vstupných údajov na množstvo výstupných údajov.
Môžeme povedať, že významom existencie informačného systému je transformácia vstupných údajov. Tým pádom, hodnota IS a celého komplexu IS sa určuje cez hodnotu vstupných a výstupných údajov.
Na základe toho by malo projektovanie začínať a vychádzať z údajov, prispôsobujúc architektúru a metódy štruktúre a významu údajov.
Ukladané údaje
Kľúčovým krokom v príprave na projektovanie je získať charakteristiky všetkých súborov údajov, ktoré plánujeme spracovávať a uchovávať. Tieto charakteristiky zahŕňajú:
— Objem údajov;
— Informácie o životnom cykle údajov (prírastok nových údajov, doba životnosti, spracovanie zastaraných údajov);
— Klasifikácia údajov z pohľadu vplyvu na hlavný biznis spoločnosti (t.j. triáda dôvernosť, integrita, dostupnosť) spolu s finančnými ukazovateľmi (napr. cena straty údajov za poslednú hodinu);
— Geografia spracovania údajov (fyzická poloha systémov spracovania);
— Požiadavky regulátorov na každú triedu údajov (napr. Zákon č. 152, PCI DSS).
Informačné systémy
Údaje nesú len uložené, ale aj spracované (transformované) informačnými systémami. Nasledujúci krok po získaní charakteristík údajov je maximálne úplná inventarizácia informačných systémov, ich architektonických zvláštností, vzájomných závislostí a požiadaviek na infraštruktúru v podmienených jednotkách pre štyri druhy zdrojov:
— Procesorový výkon;
— Objem operačnej pamäte;
— Požiadavky na objem a výkon systému ukladania údajov;
— Požiadavky na sieť prenosu údajov (externé kanály, kanály medzi komponentmi IS).
Požiadavky by mali byť na každý servis/mikroslužbu v rámci IS.
Osobitne treba zdôrazniť, že pre správne navrhnutie je nevyhnutná existencia údajov o vplyve IS na hlavný biznis spoločnosti vo forme nákladov na prestoj IS (rubly za hodinu).
Model hrozieb
V nezáväzných prípadoch musí byť k dispozícii formálny model hrozieb, voči ktorým sa plánuje chrániť údaje/služby. Tento model hrozieb zahŕňa nielen aspekty dôvernosti, ale aj integritu a dostupnosť. T.j. napríklad:
— Zlyhanie fyzického servera;
— Zlyhanie prepínača top-of-the-rack;
— Pretrhnutie optického komunikačného kanála medzi DC;
— Zlyhanie operačnej SÚСD celkom.
V niektorých prípadoch sa modely hrozieb píšu nielen pre infraštruktúrne komponenty, ale aj pre konkrétne IS alebo ich komponenty, ako napríklad zlyhanie DBMS s logickým zničením štruktúry údajov.
Všetky rozhodnutia v rámci projektu ochrany pred nepopísanou hrozbou sú zbytočné.
Požiadavky regulátorov
Ak spracovávané údaje podliehajú osobitným pravidlám stanoveným regulátormi, je nevyhnutná informácia o súboroch údajov a pravidlách spracovania/ukladania.
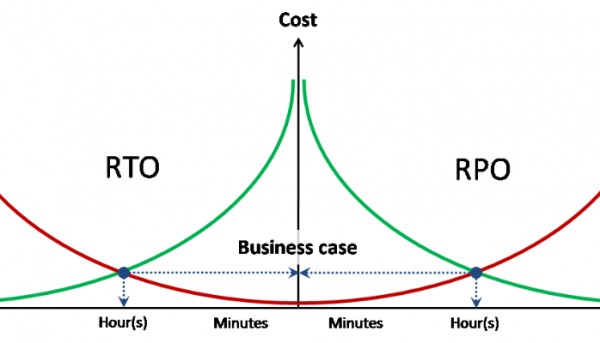
Cieľové ukazovatele RPO/RTO
Navrhovanie akéhokoľvek druhu ochrany si vyžaduje existenciu ukazovateľov cieľovej straty údajov a cieľového času na obnovenie služby pre každú z popísaných hrozieb.
Ideálne by mali mať RPO a RTO priradené náklady na stratu údajov a prestoj v jednotke času.
Rozdelenie na pooly zdrojov
Po zhromaždení všetkých základných vstupných informácií je prvým krokom skupinovanie súborov údajov a IS do poolov, vychádzajúc z modelov hrozieb a požiadaviek regulátorov. Určuje sa, aký typ rozdelenia rôznych poolov – softvérovo na úrovni systémového SW alebo fyzicky.
Príklady:
— Kontúra spracovávajúca osobné údaje je úplne fyzicky oddelená od ostatných systémov;
— Zálohy sa ukladajú na samostatnej SÚСD.
Pričom pooly môžu mať neúplnú nezávislosť, napríklad sa určuje dva pooly výpočtových zdrojov (procesorový výkon + operačná pamäť), ktoré využívajú jeden pool úložných údajov a jeden pool zdrojov prenosu údajov.
Procesorový výkon
Abstraktné požiadavky na procesorový výkon virtualizovaného dátového centra sa merajú počtom virtuálnych procesorov (vCPU) a koeficientom ich konsolidácie na fyzických procesoroch (pCPU). V tomto konkrétnom prípade 1 pCPU = 1 fyzické jadro procesora (bez ohľadu na Hyper-Threading). Počet vCPU sa sčíta vo všetkých definovaných bazénoch zdrojov (z každého z nich môže mať svoj koeficient konsolidácie).
Koeficient konsolidácie pre zaťažené systémy sa získava empiricky, vychádzajúc z už existujúcej infraštruktúry, alebo pri pilotnej inštalácii a záťažovom testovaní. Pre nezaťažené systémy platia „best practice“. Konkrétne, VMware označuje priemerný koeficient 8:1.
Operačná pamäť
Celková požiadavka na operačnú pamäť sa získava jednoduchým sčítaním. Používanie prepredaja operačnej pamäte sa neodporúča.
Skladovacie zdroje
Požiadavky na skladovacie zdroje sa získavajú jednoduchým sčítaním všetkých bazénov podľa objemu a výkonu.
Požiadavky na výkon sa vyjadrujú v IOPS v kombinácii so stredným pomerom čítanie/zápis a v prípade potreby maximálnou latenciou odpovede.
Samostatne by mali byť uvedené požiadavky na zabezpečenie kvality služby (QoS) pre konkrétne bazény alebo systémy.
Zdroje siete prenášania dát
Požiadavky na sieť prenášania dát sa získavajú jednoduchým sčítaním všetkých bazénov priepustnosti.
Samostatne by mali byť uvedené požiadavky na zabezpečenie kvality služby (QoS) a latencií (RTT) pre konkrétne bazény alebo systémy.
V rámci požiadaviek na zdroje siete prenášania dát sa tiež uvádzajú požiadavky na izoláciu a/alebo šifrovanie sieťového prenosu a preferované mechanizmy (802.1q, IPSec atď.)
Výber architektúry
V rámci tohto sprievodcu sa neberie do úvahy iný výber ako architektúra x86 a 100% virtualizácia serverov. Preto sa výber architektúry výpočtovej subsystémy zužuje na voľbu platformy serverovej virtualizácie, form factor serverov a celkové požiadavky na konfiguráciu serverov.
Kľúčovým bodom vo výbere je jednoznačnosť v používaní klasického prístupu s rozdelením funkcií spracovania, ukladania a prenosu dát alebo konvergovaného prístupu.
Klasická architektúra predpokladá používanie inteligentných externých úložných a prenosových systémov, zatiaľ čo servery do spoločného súboru fyzických zdrojov pridávajú iba procesorový výkon a operačnú pamäť. V extrémnom prípade sa servery stávajú úplne anonymnými, nemajú nielen vlastné disky, ale ani systémový identifikátor. V takomto prípade sa používa zavedenie operačného systému alebo hypervízora z integrovaných flash pamätí alebo z externého úložného systému (boot from SAN).
V rámci klasickej architektúry sa výber medzi blade a rack vykonáva predovšetkým na základe nasledujúcich princípov:
— Ekonomická efektívnosť (v priemere sú rackové servery lacnejšie);
— Výpočtová hustota (u blade je vyššia);
— Spotreba energie a tepelné vyžarovanie (u blade je vyššie na jednotku);
— Škálovateľnosť a spravovateľnosť (blade vo všeobecnosti vyžaduje menej úsilia pri veľkých inštaláciách);
— Používanie rozširujúcich kariet (pre blade je veľmi obmedzený výber).
Konvergentná architektúra (tiež známa ako hyperkonvergentná) predpokladá kombináciu funkcií spracovania a ukladania dát, čo vedie k používaniu lokálnych diskov serverov a ako dôsledok odmietaniu formátov klasických blade. Pre konvergentné systémy sa používajú buď rackové servery, alebo klastrové systémy, ktoré kombinujú v jednom šasi niekoľko blade serverov a lokálne disky.
CPU / Memory
Na správny výpočet konfigurácie je potrebné pochopiť typ zaťaženia pre prostredie alebo každého z nezávislých klastrov.
CPU bound – prostredie obmedzené výkonnosťou procesora. Pridanie operačnej pamäte nič nezmení z hľadiska výkonu (počet VM na server).
Memory bound – prostredie obmedzené operačnou pamäťou. Viac operačnej pamäte na serveri umožňuje spustiť viac VM na server.
GB / MHz (GB / pCPU) – priemerný pomer spotreby tejto konkrétnej zaťažením operačnej pamäte a procesorového výkonu. Môže sa používať na výpočty potrebného objemu pamäte pri určenej výkonnosti a naopak.
Výpočet konfigurácie servera
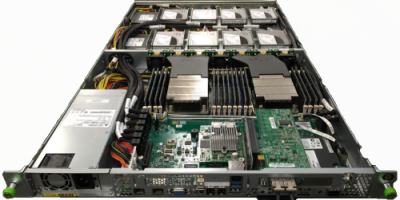
Na začiatok je potrebné určiť všetky druhy zaťaženia a rozhodnúť o kombinovaní alebo rozdelení rôznych výpočtových poolov do rôznych klastrov.
Ďalej sa pre každý z určených klastrov určuje pomer GB / MHz pri vopred známych zaťaženiach. Ak zaťaženie nie je známe vopred, ale existuje približná predstava o úrovni vyťaženia procesorovej kapacity, je možné použiť štandardné koeficienty vCPU:pCPU na prevedenie požiadaviek poolov na fyzické.
Pre každý klaster sa súčet požiadaviek poolov vCPU delí koeficientom:
vCPUsum / vCPU:pCPU = pCPUsum – požadovaný počet fyzických jadier
pCPUsum / 1.25 = pCPUht – počet jadier s ohľadom na Hyper-Threading
Predpokladajme, že je potrebné vykonať výpočet klastra na 190 jadier / 3.5TB RAM. Pri tom zohľadňujeme cieľovú 50% vyťaženosť procesorovej kapacity a 75% vyťaženie operačnej pamäte.
pCPU
190
CPU vyťaž.
50%
Pamäť
3500
Vyťaž. pamäť
75%
Socket
Jadro
Srv / CPU
Srv Pamäť
Srv / Pamäť
2
6
25,3
128
36,5
2
8
19,0
192
24,3
2
10
15,2
256
18,2
2
14
10,9
384
12,2
2
18
8,4
512
9,1
V tomto prípade vždy používame zaokrúhľovanie na najbližšie celé nahor (=ROUNDUP(A1;0)).
Z tabuľky je zrejmé, že vyváženými pre cieľové parametre sú niekoľko konfigurácií serverov:
— 26 serverov 2*6c / 192 GB
— 19 serverov 2*10c / 256 GB
— 10 serverov 2*18c / 512 GB
Výber z týchto konfigurácií je potrebné urobiť na základe ďalších faktorov, ako sú napríklad tepelný výkon a dostupné chladenie, už používané servery alebo náklady.
Špecifiká výberu konfigurácie servera
Široké VM. V prípade potreby umiestnenia širokých VM (porovnateľných s 1 uzlom NUMA a viac) sa odporúča, ak je to možné, vybrať server s konfiguráciou, ktorá umožní, aby také VM zostali v rámci uzla NUMA. Pri veľkom počte širokých VM hrozí riziko fragmentácie zdrojov klastrov, a v takom prípade sa vyberajú servery, ktoré umožňujú umiestniť široké VM maximálne tesne.
Veľkosť domény jedinečného zlyhania.
Výber veľkosti servera sa uskutočňuje aj na základe zásady minimalizácie domény jedinečného zlyhania. Napríklad pri výbere medzi:
— 3 x 4*10c / 512 GB
— 6 x 2*10c / 256 GB
Pri rovnakých podmienkach je potrebné vybrať druhú možnosť, pretože pri výpadku jedného servera (alebo údržbe) sa nestráca 33% zdrojov klastrov, ale 17%. Rovnako sa tiež zníži počet VM a IS, na ktorých sa odrazila havária.
Výpočet klasickej úložnej sústavy podľa výkonu
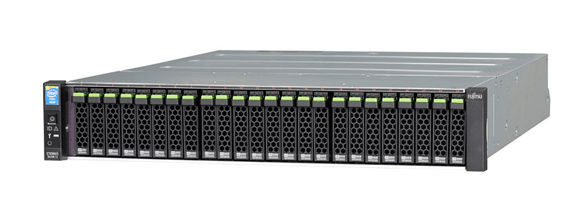
Klasická úložná sústava sa vždy vypočíta na základe najhoršieho scenára (worst case scenario), pričom sa vylučuje vplyv operačnej cache a optimalizácie operácií.
Ako základné ukazovatele výkonu vezmeme mechanický výkon z disku (IOPSdisk):
— 7,2k – 75 IOPS
— 10k – 125 IOPS
— 15k – 175 IOPS
Ďalej sa počet diskov v diskovom poole vypočíta podľa nasledujúcej formulácie: = TotalIOPS * ( RW + (1 –RW) * RAIDPen) / IOPSdisk. Kde:
— TotalIOPS – súhrnný požadovaný výkon v IOPS z diskového poolu
— RW – percentuálny podiel operácií čítania
— RAIDpen – RAID penalizácia pre zvolenú úroveň RAID
Viac o zariadení RAID a RAID penalizácii sa rozpráva tu — a a
Na základe získaného počtu diskov sa vypočítajú možné varianty, ktoré spĺňajú požiadavky na kapacitu úložiska, vrátane variantov s viacerými úrovňami uchovávania.
Výpočet systémov s použitím SSD ako úložnej úrovne sa posudzuje samostatne.
Špecifiká výpočtu systémov s Flash Cache
Flash Cache – všeobecný názov pre všetky firemné technológie používania flash pamäte ako cache druhej úrovne. Pri použití flash cache sa úložná sústava zväčša vypočíta pre zaistenie zaťaženej prevádzky z magnetických diskov, pričom vrcholovú prevádzku zabezpečuje cache.
Pri tom je potrebné pochopiť profil zaťaženia a stupňu lokalizácie prístupov k blokom úložných objemov. Flash cache je technológia pre zaťaženia s vysokou lokalizáciou požiadaviek a prakticky nie je aplikovateľná pre rovnomerne zaťažené objemy (ako napríklad pre analytické systémy).
Výpočet hybridných systémov low-end / mid-range
Hybridné systémy nižšej a strednej triedy používajú viaceré úrovne ukladaní s presunom údajov medzi úrovňami podľa časového plánu. Veľkosť bloku viacerých úrovní uchovávania u najlepších modelov dosahuje 256 MB. Tieto špecifiká neumožňujú považovať technológiu viacerých úrovní uchovávania za technológiu zvyšovania výkonu, ako sa mylne domnieva mnoho ľudí. Viacúrovňové uchovávanie v systémoch nižšej a strednej triedy je technológia optimalizácie nákladov na uchovávanie pre systémy s výraznou nerovnomernosťou záťaže.
Pri mnohovrstvovom úložení sa primárne posudzuje výkon na hornej úrovni, zatiaľ čo dolná úroveň ukladania sa považuje iba za doplnkovú kapacitu úložiska. Pre hybridný mnohovrstvový systém je nevyhnutné použiť technológiu flash cache pre mnohovrstvový pool s cieľom kompenzovať pokles výkonu pre náhle sa zahriate údaje z dolnej úrovne.
Použitie SSD v mnohovrstvovom diskovom poole
Použitie SSD v mnohovrstvovom diskovom poole má variácie v závislosti od špecifík implementácie algoritmov flash cache od tohto výrobcu.
Obecná prax politiky ukladania pre diskový pool s úrovňou SSD je - SSD najprv.
Read Only Flash Cache. Pre flash cache iba na čítanie úroveň ukladania na SSD sa objavuje pri významnej lokalizácii operácií zápisu nezávisle od cache.
Read / Write Flash Cache. V prípade flash cache na zápis sa najprv nastaví maximálny objem cache a úroveň ukladania na SSD sa objavuje len pri nedostatočnosti veľkosti cache na obsluhu celej lokalizovanej záťaže.
Výkon SSD a cache sa vypočítava každýkrát na základe odporúčaní výrobcu, ale vždy pre najhorší variant.
Zdroj: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish