

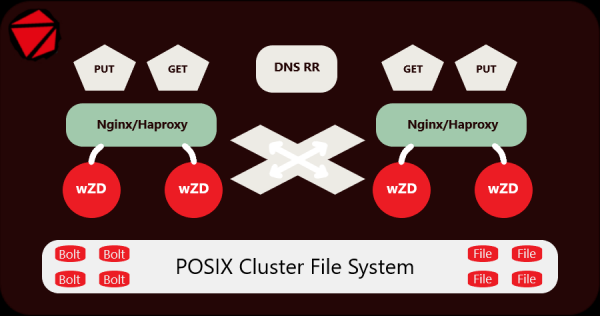
Vážené spoločenstvo, tento článok bude venovaný efektívnemu ukladaniu a správe stoviek miliónov malých súborov. V tejto fáze sa navrhuje konečné riešenie pre súborové systémy kompatibilné s POSIX, ktoré obsahuje plnú podporu zámkov, vrátane klastrových, a zdá sa, že už dokonca aj bez obmedzení.
Preto som pre túto úlohu napísal vlastný špecializovaný server.
Pri realizácii tejto úlohy sa podarilo vyriešiť základný problém, pričom sa zároveň dosiahlo úsporu diskového priestoru a operačnej pamäte, ktorú neúprosne spotrebúvala naša klastrová súborová sústava. Takéto množstvo súborov totiž poškodzovalo akýkoľvek klastrový súborový systém.
Nápad je nasledovný:
Jednoducho povedané, cez server sa nahrávajú malé súbory, tie sa ukladajú priamo do archívu a aj sa z neho čítajú, zatiaľ čo väčšie súbory sú umiestnené vedľa. Schéma: 1 priečinok = 1 archív, takže máme niekoľko miliónov archívov s malými súbormi, nie niekoľko stoviek miliónov súborov. A to všetko je implementované plne, bez akýchkoľvek skriptov a rozkladu súborov do tar/zip archívov.
Snažím sa to zhrnúť stručne, ospravedlňujem sa vopred, ak bude príspevok rozsiahly.
Všetko sa to začalo tým, že som nedokázal nájsť vhodný server na svete, ktorý by mohol ukladať dáta prijaté cez HTTP protokol priamo do archívov, aby sa predišlo nedostatkom, ktoré sa vyskytujú u bežných archívov a objektových úložísk. Hlavnou príčinou tohto hľadania bol rozrastúci sa do veľkých rozmerov klaster Origin z 10 serverov, v ktorom sa nazbieralo už 250 000 000 malých súborov, a tendencia rastu sa rozhodne nekončila.
Pre tých, ktorí nemajú radi čítanie článkov, a stručná dokumentácia je jednoduchšia:
a .
A docker zároveň, teraz existuje možnosť len spolu s nginx vo vnútri pre každý prípad:
docker run -d --restart=always -e host=localhost -e root=\var\storage
-v \var\storage:\var\storage --name wzd -p 80:80 eltaline\wzd
Ďalej:
Ak je súborov veľmi veľa, sú potrebné značné zdroje a, čo je najhoršie, časť z nich sa stráca zbytočne. Napríklad pri použití klastrového súborového systému (v tomto prípade – MooseFS) súbor, bez ohľadu na skutočnú veľkosť, vždy zaberá minimálne 64 KB. To znamená, že pre súbory veľkosti 3, 10 alebo 30 KB na disku je potrebných 64 KB. Ak je súborov štvrť miliardy, prichádzame o 2 až 10 terabajtov. Nebude možné nekonečne vytvárať nové súbory, pretože v tej istej MooseFS existuje obmedzenie: maximálne 1 miliarda s jednou replikou každého súboru.
S rastúcim počtom súborov je potrebné veľa operačnej pamäte na metadáta. Tiež časté veľké dumpy metadát prispievajú k opotrebovaniu SSD úložísk.
Server wZD. Usporiadame poriadok na diskoch.
Server je napísaný v jazyku Go. Najprv som potreboval znížiť počet súborov. Ako na to? Cez archiváciu, ale v tomto prípade bez kompresie, pretože mám súbory, ktoré sú čisté znížené obrázky. Na pomoc prišla BoltDB, ktorú bolo potrebné ešte zbaviť nedostatkov, čo je zdokumentované.
Celkovo z namiesto štvrť miliardy súborov v mojom prípade ostalo iba 10 miliónov Bolt archívov. Keby som mal možnosť zmeniť súčasnú štruktúru naplnenia adresárov súbormi, mohol by sa počet súborov znížiť približne na 1 milión.
Všetky malé súbory sa balia do Bolt archívov, ktoré automaticky získavajú názvy adresárov, v ktorých sa nachádzajú, a všetky veľké súbory zostávajú vedľa archívov, nemá zmysel ich baliť, to je nastaviteľné. Malé – archivujeme, veľké – nechávame bez zmien. Server funguje transparentne aj s týmito, aj s inými.
Architektúra a vlastnosti servera wZD.
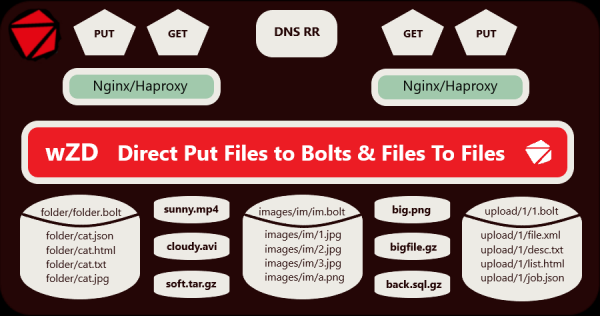
Server funguje pod operačnými systémami Linux, BSD, Solaris a OSX. Testoval som ho iba pre architektúru AMD64 pod Linuxom, ale mal by byť vhodný aj pre ARM64, PPC64, MIPS64.
Hlavné funkcie:
- Viacvlákno;
- Multiservernosť zaručujúca odolnosť voči zlyhaniu a vyváženie zaťaženia;
- Maximálna transparentnosť pre používateľa alebo vývojára;
- Podporované HTTP metódy: GET, HEAD, PUT a DELETE;
- Riadenie správania pri čítaní a zápise prostredníctvom klientskych hlavičiek;
- Podpora flexibilne nastaviteľných virtuálnych hostiteľov;
- Podpora CRC integrity dát pri zápise/čítaní;
- Polodynamické buffery pre minimálnu spotrebu pamäte a optimálne nastavenie sieťového výkonu;
- Odložená kompakcia dát;
- Navyše sa ponúka viacvláknový archívátor wZA pre migráciu súborov bez zastavenia služby.
Skutočná skúsenosť:
Vyvíjal a testoval som server a archívátor na živých dátach pomerne dlhý čas, teraz úspešne funguje na klastri zahŕňajúcom 250 000 000 drobných súborov (obrázkov) umiestnených v 15 000 000 adresároch na oddelených SATA diskoch. Klastr 10 serverov predstavuje Origin server, ktorý je nainštalovaný za CDN sieťou. Na jeho obsluhu sa používajú 2 servery Nginx + 2 servery wZD.
Tým, ktorí sa rozhodnú používať tento server, sa odporúča naplánovať štruktúru adresárov pred jeho použitím, ak je to relevantné. Hneď treba uviesť, že server nie je určený na to, aby sa všetko napchalo do jedného Bolt archívu.
Testovanie výkonnosti:
Čím menšia je veľkosť zaarchivovaného súboru, tým rýchlejšie sa vykonávajú operácie GET a PUT. Porovnáme celkový čas zápisu HTTP klientom do bežných súborov a do Bolt archívov, a rovnako aj čítanie. Porovnáva sa práca so súbormi veľkosti 32 KB, 256 KB, 1024 KB, 4096 KB a 32768 KB.
Pri práci s Bolt archívmi sa kontroluje integrita dát každého súboru (používa sa CRC), pred zápisom a rovnako aj po zápise sa vykonáva čítanie naživo a prepočet, čo samozrejme spôsobuje oneskorenia, ale hlavné je zabezpečenie dát.
Testy výkonnosti som vykonával na SSD úložiskách, pretože na SATA diskoch testy neukazujú jasný rozdiel.
Grafy podľa výsledkov testovania:
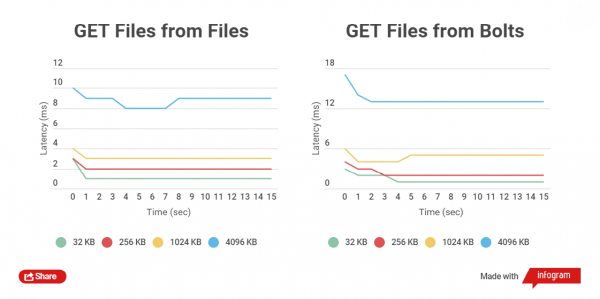
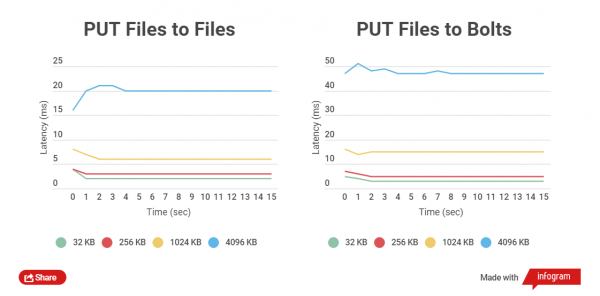
Ako vidno, pre malé súbory nie je rozdiel v čase čítania a zápisu medzi archívovanými a nearchívovanými súbormi veľký.
Úplne inú situáciu už dostaneme pri teste čítania a zápisu súborov veľkosti 32 MB:
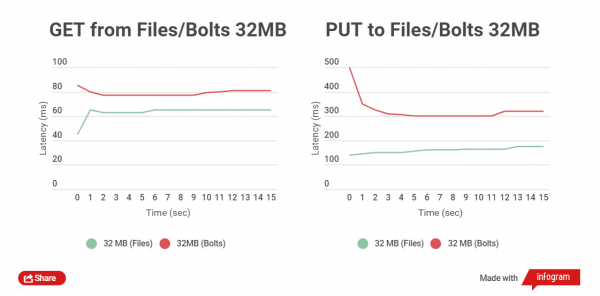
Rozdiel v čase medzi čítaním súborov sa pohybuje v rozmedzí 5-25 ms. So zápisom je to horšie, rozdiel je približne 150 ms. Ale v tomto prípade nie je potrebné nahrávať veľké súbory, v tom nie je žiadny zmysel, môžu existovať samostatne od archívov.
*Technicky je možné tento server použiť aj na úlohy vyžadujúce NoSQL.
Hlavné metódy práce so serverom wZD:
Nahrávanie bežného súboru:
curl -X PUT --data-binary @test.jpg http://localhost/test/test.jpgNahrávanie súboru do Bolt archívu (ak nepresahuje serverový parameter fmaxsize, určujúci maximálnu veľkosť súboru, ktorý môže byť zahrnutý do archívu, ak je presiahnutý, súbor sa nahrá ako obvykle vedľa archívu):
curl -X PUT -H "Archive: 1" --data-binary @test.jpg http://localhost/test/test.jpgSťahovanie súboru (ak sú na disku a v archíve súbory so zhodnými názvami, pri sťahovaní sa prednosť predvolene dáva nezabalenému súboru):
curl -o test.jpg http://localhost/test/test.jpgSťahovanie súboru z Bolt archívu (forced):
curl -o test.jpg -H "FromArchive: 1" http://localhost/test/test.jpgPopis ďalších metód je v dokumentácii.
Server v súčasnosti podporuje iba protokol HTTP, s HTTPS zatiaľ nefunguje. Taktiež nie je podporovaná metóda POST (ešte nie je rozhodnuté, či je potrebná alebo nie).
Kto sa zaoberá zdrojovým kódom, objaví tam sladkosti, ktoré nie všetci majú radi, ale ja som hlavný kód nepripúšťal k funkciám webového rámca, okrem obsluhy prerušenia, takže v budúcnosti môžem rýchlo prepísať takmer na akýkoľvek engine.
ToDo:
- Vývoj vlastného replikátora a distributora + geo na možnosť použitia vo veľkých systémoch bez klastra FS (Všetko vážne)
- Možnosť úplného reverzného obnovenia metadát pri ich úplnej strate (v prípade použitia distributora)
- Nativný protokol na možnosť použitia trvalých sieťových pripojení a ovládače pre rôzne programovacie jazyky
- Rozšírené možnosti využívania NoSQL zloženia
- Komprimácia rôznych typov (gzip, zstd, snappy) pre súbory alebo hodnoty v Bolt archívoch a pre bežné súbory
- Šifrovanie rôznych typov pre súbory alebo hodnoty v Bolt archívoch a pre bežné súbory
- Odložená serverová video konverzia, vrátane GPU
To je zatiaľ všetko, dúfam, že tento server niekomu príde vhod, licencia BSD-3, dvojité autorské práva, pretože keby nebolo spoločnosti, kde pracujem, nebol by som napísal ani server. Som jediný vývojár. Budem vďačný za nájdené chyby a žiadosti o funkcie.
Zdroj: habr.com
