

Pretože ClickHouse je špecializovaný systém, je pri jeho používaní dôležité zohľadniť zvláštnosti jeho architektúry. V tejto prezentácii Alexej povie o príkladoch typických chýb pri používaní ClickHouse, ktoré môžu viesť k neefektívnej práci. Na príkladoch z praxe bude ukázané, ako výber určitej schémy spracovania údajov môže zmeniť výkon o poriadky.
Ahojte všetci! Volám sa Alexej, robím ClickHouse.
Po prvé, hneď vás chcem potešiť, dnes vám nebudem rozprávať, čo je ClickHouse. Úprimne, už ma to nudí. Každý raz hovorím, čo to je. A asi to už všetci vedia.
Namiesto toho budem hovoriť o tom, aké sú možné pasce, t.j. ako sa dá ClickHouse nesprávne používať. Naozaj sa netreba báť, pretože vyvíjame ClickHouse ako systém, ktorý je jednoduchý, pohodlný a funguje out-of-the-box. Nainštalujete a všetko je vybavené, žiadne problémy.
Ale napriek tomu treba zohľadniť, že tento systém je špecializovaný a ľahko sa môžete stretnúť s neobvyklým scenárom použitia, ktorý vyvedie tento systém z komfortnej zóny.
Takže, aké sú pasce? V podstate budem hovoriť o samozrejmých veciach. Všetkým je všetko jasné, všetci rozumejú a môžu sa tešiť, akí sú múdri, a tí, ktorí nerozumejú, sa dozvedia niečo nové.
Prvý najjednoduchší príklad, ktorý sa, bohužiaľ, často vyskytuje, je veľké množstvo insertov s malými partami, t.j. veľké množstvo malých insertov.
Ak sa pozrieme na to, ako ClickHouse vykonáva insert, môžete jedným dopytom poslať aj prúd údajov na terabajt. To nie je problém.
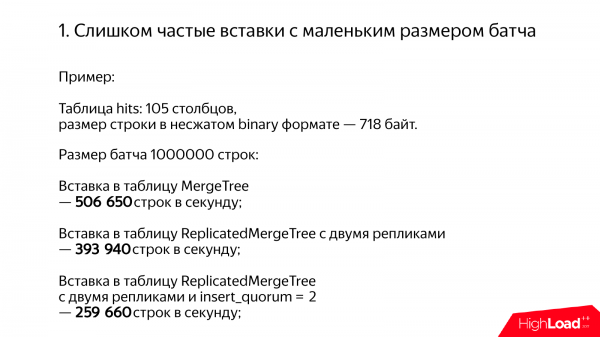
A poďme sa pozrieť, aká bude typická výkonnosť. Napríklad tabuľka s údajmi z Yandex.Metriky. Hity. 105 nejakých stĺpcov. 700 bajtov v nekomprimovanej podobe. A budeme vkladať poctivo dávkami po jednom milióne riadkov.
Vkladáme do tabuľky MergeTree, dostávame pol milióna riadkov za sekundu. Výborné. V replikovanej tabuľke – bude to o niečo menej, približne 400 000 riadkov za sekundu.
A ak zapneme kvórumový insert, dostaneme o niečo menej, ale aj tak slušnú výkonnosť, 250 000 riadkov za sekundu. Kvórumový insert – to je nedokumentovaná možnosť v ClickHouse*.
* k 2020 roku, .
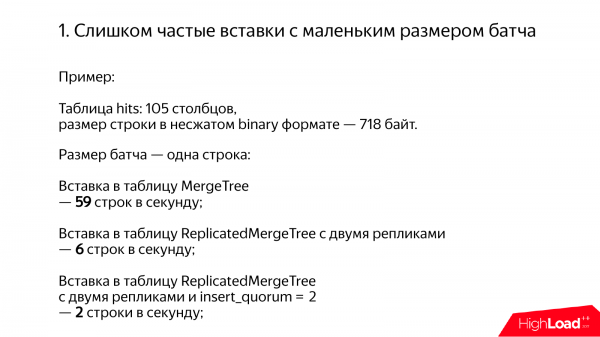
Čo sa stane, ak to robíme zle? Vkladáme po jednom riadku do tabuľky MergeTree a výsledok je 59 riadkov za sekundu. To je 10 000-krát pomalšie. V ReplicatedMergeTree – 6 riadkov za sekundu. A ak sa zapne aj kvórum, dostaneme 2 riadky za sekundu. Podľa mňa je to úplný prepadák. Ako je možné takto brzdiť? Mám dokonca na tričku napísané, že ClickHouse by nemal brzdiť. A predsa sa to občas stáva.
V skutočnosti – je to naša chyba. Mohli sme to zariadiť tak, aby to všetko fungovalo normálne, ale neurobili sme to. A neurobili sme to, pretože pre náš scenár to nebolo potrebné. Mali sme aj tak dávky. Jednoducho nám prichádzali dávky na vstup a neboli žiadne problémy. Vkladáme a všetko funguje normálne. Ale samozrejme, môžu nastať rôzne scenáre. Napríklad, keď máte množstvo serverov, na ktorých sa generujú dáta. A tie vkladajú dáta nie tak často, ale aj tak dochádza k častým vkladom. A je potrebné tomu nejako zabrániť.
Z technického hľadiska spočíva podstata v tom, že keď vykonávate insert do ClickHouse, dáta sa nedostanú do žiadnej memtabuľky. Nemáme ani skutočný log structure MergeTree, ale len MergeTree, pretože nie je žiadny log ani memTable. Jednoducho zapisujeme dáta priamo do súborového systému, už usporiadané podľa stĺpcov. A ak máte 100 stĺpcov, bude potrebné zapísať viac ako 200 súborov do samostatného adresára. To všetko je dosť robustné.
A vyvstáva otázka: „Ako to robiť správne?“, ak táto situácia nastane, že je potrebné nejako zapisovať dáta do ClickHouse.
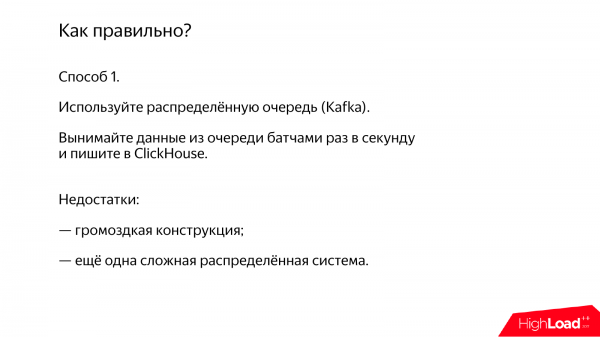
Spôsob 1. Toto je najjednoduchší spôsob. Použiť nejakú distribuovanú frontu. Napríklad, Kafka. Jednoducho vyberáte dáta z Kafky, dávkujete raz za sekundu. A všetko bude normálne, zapisujete a všetko funguje dobre.
Nevýhody sú, že Kafka je ďalší robustný distribuovaný systém. Ešte viem pochopiť, ak vo vašej firme už existuje Kafka. To je dobré, je to pohodlné. Ale ak ju nemáte, mali by ste trikrát premyslieť predtým, ako si do projektu pridáte ešte jeden distribuovaný systém. Preto stojí za to zvážiť alternatívy.
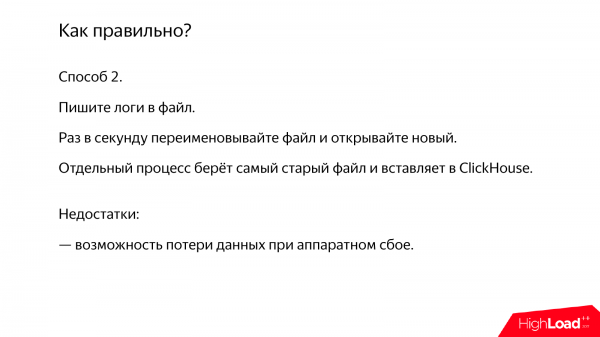
Spôsob 2. Takáto staromódna alternatíva je pritom veľmi jednoduchá. Máte server, ktorý generuje vaše logy. A jednoducho zapisuje vaše logy do súboru. A raz za sekundu, napríklad, tento súbor premenováme, otvoríme nový. A samostatný skript, buď cez cron, alebo nejaký daemon, vezme najstarší súbor a uloží ho do ClickHouse. Ak zapisujete logy raz za sekundu, všetko bude skvele.
Ale nevýhodou tohto spôsobu je, že ak váš server, na ktorom sa generujú logy, niekde zmizne, tak aj dáta zmiznú.
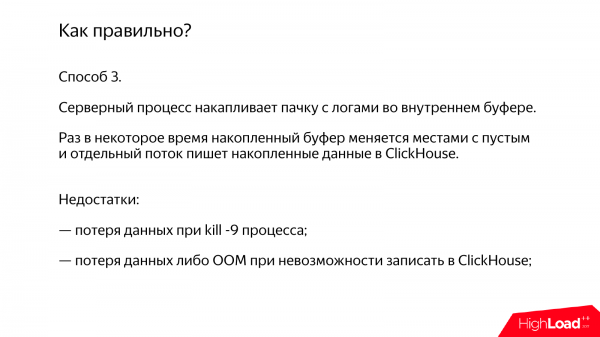
Spôsob 3. Existuje ešte jeden zaujímavý spôsob, ktorý je úplne bez dočasných súborov. Napríklad máte nejakú reklamnú rotáciu alebo iný zaujímavý daemon, ktorý generuje dáta. A môžete hromadiť dávku dát priamo v operačnej pamäti, v bufferi. A keď uplynie dostatočné množstvo času, tento buffer uložíte bokom, vytvoríte nový, a v samostatnom vlákne to, čo už sa nahromadilo, vložíte do ClickHouse.
Na druhej strane dáta tiež pri kill -9 zmiznú. Ak sa váš server zrúti, tieto dáta stratíte. A ďalším problémom je, že ak sa vám nepodarí zapísať do databázy, tie dáta sa budú hromadiť v operačnej pamäti. A buď sa pamäť minie, alebo jednoducho stratíte dáta.
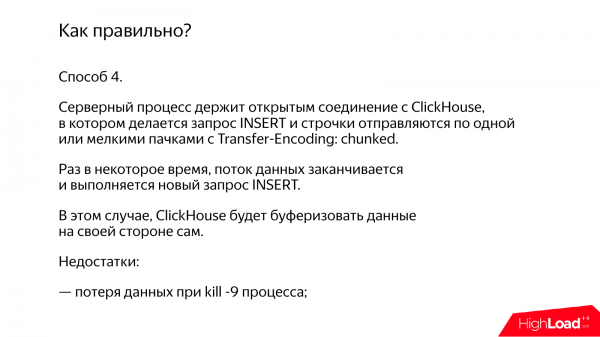
Spôsob 4. Ešte jeden zaujímavý spôsob. Máte nejaký serverový proces. A ten môže odosielať dáta do ClickHouse okamžite, ale robiť to v jednom spojení. Napríklad odoslal http-žiadosť s transfer-encoding: chunked s insertom. A generuje chunk-y už nie príliš zriedka, môžete posielať každú radu, hoci sa vyskytne overhead na rámcovanie týchto dát.
Ale aj tak, v tomto prípade dáta budú odoslané do ClickHouse okamžite. A ClickHouse si ich sám buferizuje.
Ale tiež sa objavujú problémy. Teraz stratíte dáta vrátane toho, keď sa váš proces skončí a ak sa proces ClickHouse zrúti, pretože to bude nedokončený insert. A v ClickHouse sú inserty atomárne do určitého stanoveného prahu počtu riadkov. V podstate je to zaujímavý spôsob. Môže sa tiež použiť.
Metóda 5. Tu je ďalší zaujímavý spôsob. Ide o nejaký komunitou vyvinutý server na dávkové spracovanie údajov. Ja som na to sám nekukal, takže nič zaručiť nemôžem. Napriek tomu ani pre samotný ClickHouse nie sú poskytované žiadne záruky. Je to tiež open source, ale na druhej strane, mohli by ste si zvyknúť na určitý štandard kvality, ktorý sa snažíme zabezpečiť. A ohľadom tejto veci - neviem, choďte na GitHub, pozrite sa na kód. Možno tam napísali niečo normálne.
* k 2020 roku, mal by sa tiež zohľadniť .
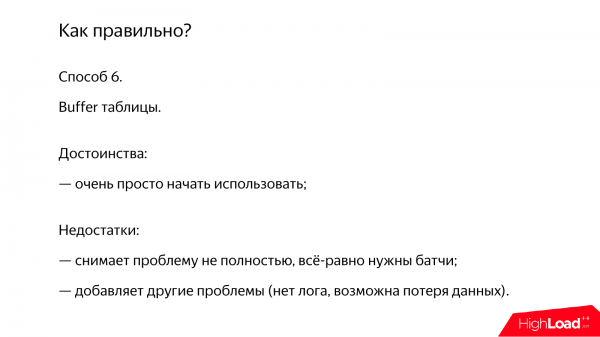
Metóda 6. Ďalší spôsob je použitie Buffer tabuliek. Výhodou tohto spôsobu je, že je veľmi jednoduché začať používať. Vytvoríte Buffer tabuľku a vložíte do nej dáta.
Nevýhodou je, že problém nie je úplne vyriešený. Ak pri vkladaní typu MergeTree musíte grupovať dáta po jednom batchi za sekundu, tak pri vkladaní do buffer tabuľky musíte grupovať aspoň na niekoľko tisíc za sekundu. Ak bude viac ako 10 000 za sekundu, bude to opäť zlý výkon. A ak vkladáte po dávkach, videli ste, že tam vychádza stotisíc riadkov za sekundu. A to už na dosť ťažkých dátach.
A tiež buffer tabuľky nemajú log. Ak je s vaším serverom niečo zlé, dáta budú stratené.
A ako bonus, nedávno sme v ClickHouse získali možnosť získavať dáta z Kafka. Existuje tabulkový motor - Kafka. Jednoducho vytvoríte. A na to môžete pripevniť materializované pohľady. V tomto prípade to samo vytiahne dáta z Kafka a vloží ich do potrebných tabuliek.
A obzvlášť nás teší, že túto možnosť nerobili my. Je to funkcia komunity. A keď hovorím 'funkcia komunity', hovorím to bez akéhokoľvek opovrhnutia. Kód sme čítali, robili sme revíziu, malo by to fungovať normálne.
* k 2020 roku, podobná podpora bola pridaná pre .
Čo ďalšie môže byť nepríjemné alebo prekvapujúce pri vkladaní údajov? Ak robíte dotaz insert values a vo values píšete nejaké vypočítavacie výrazy. Napríklad, now() – to je tiež vypočítavací výraz. A v tomto prípade ClickHouse musí na každý riadok spustiť interpreter týchto výrazov, a výkon výrazne klesne. Lepšie sa tomu vyhnúť.
* V súčasnosti je problém úplne vyriešený, regresie výkonu pri použití výrazov v VALUES už nie sú.
Ďalší príklad, kedy môžu vzniknúť problémy, je, keď máte v jednom dávkovaní dáta, ktoré sa týkajú viacerých partícií. Predvoleným nastavením v ClickHouse sú partície podľa mesiacov. A ak vložíte dávku z milióna riadkov, pričom údaje sú za niekoľko rokov, budete mať niekoľko desiatok partícií. A to je ekvivalentné tomu, že budú dávky o niekoľko desiatok krát menšie, pretože vo vnútri sa najprv rozdeľujú podľa partícií.
* Nedávno bola v ClickHouse v experimentálnom režime pridaná podpora kompaktného formátu kusov a kusov v operačnej pamäti s write-ahead logom, čo takmer úplne rieši problém.
Teraz si pozrime druhý typ problému – typizáciu dát.
Typizácia dát môže byť prísna alebo reťazcová. Reťazcová – to je, keď jednoducho oznámite, že všetky polia majú typ string. To je zlé. Tak to robiť netreba.
Poďme sa pozrieť na to, ako to robiť správne v prípadoch, keď chceme povedať, že nejaké pole máme ako reťazec, a nech ClickHouse s tým naloží, ale aj tak by sme mali vynaložiť nejaké úsilie.
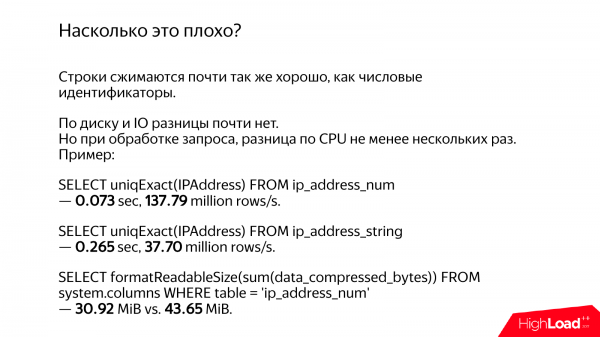
Napríklad máme IP adresu. V jednom prípade ju uchovávame ako reťazec. Napríklad 192.168.1.1. A v druhom prípade to bude číslo typu UInt32*. 32 bitov stačí na IPv4 adresu.
Prvýkrát, ako to súvisí, dáta sa skompresujú približne rovnako. Samozrejme, bude tam zmena, ale nie taká veľká. Takže pri diskovom vstupe-výstupe nie sú žiadne veľké problémy.
Ale existuje zásadný rozdiel v procesorovom čase a v čase vykonania dotazu.
Počítajme počet unikátnych IP adries, ak sú uložené ako čísla. Vyjde 137 miliónov riadkov za sekundu. Ak je to rovnaké ako reťazce, potom 37 miliónov riadkov za sekundu. Neviem, prečo to tak vyšlo. Sám som vykonával tieto dotazy. Ale aj tak je to približne 4 krát pomalšie.
Ak spočítame rozdiel v mieste na disku, existuje aj rozdiel. A rozdiel je asi jedna štvrtina, pretože unikátnych IP adries je dosť veľa. A keby tu boli reťazce s malým počtom rôznych hodnôt, tak by sa bez problémov skompresovali podľa slovníka na približne rovnaký objem.
A štvornásobný rozdiel v čase na ceste sa nepovažuje za zanedbateľný. Možno vám je to jedno, ale keď vidím taký rozdiel, je mi z toho smutno.
Pozrime sa na rôzne prípady.
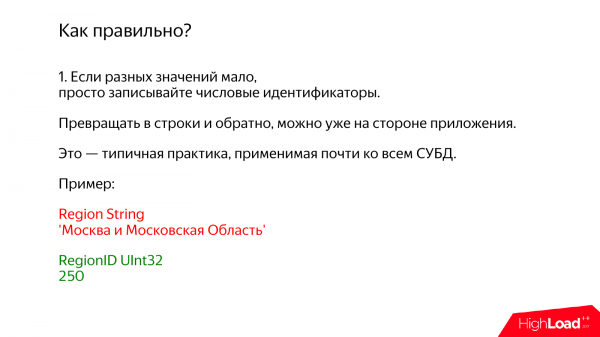
1. Prvý prípad, keď máte len niekoľko rôznych unikátnych hodnôt. V tomto prípade používame jednoduchú prax, ktorú pravdepodobne poznáte a môžete ju použiť pre akékoľvek databázy. To platí nielen pre ClickHouse. Jednoducho zapisujete číselné identifikátory do databázy. A konvertovať na reťazce a späť môžete už na strane vašej aplikácie.
Napríklad, máte región. A snažíte sa ho uložiť ako reťazec. A vypíše sa: Moskva a MO. A keď vidím, že je tam napísané „Moskva“, to ešte nie je zlé, ale keď je tam aj MO, tak je to už rozhodne smutnejšie. Koľko to môže byť bajtov.
Namiesto toho jednoducho zapisujeme číslo Ulnt32 a 250. Máme 250 v Yandexe, a u vás to môže byť inak. Len pre istotu poviem, že v ClickHouse je zabudovaná možnosť práce s geografickou databázou. Jednoducho zapisujete prehľad regiónov, vrátane hierarchického, to znamená, že tam bude aj Moskva, aj MO, a všetko, čo potrebujete. A môžete konvertovať na úrovni dotazu.
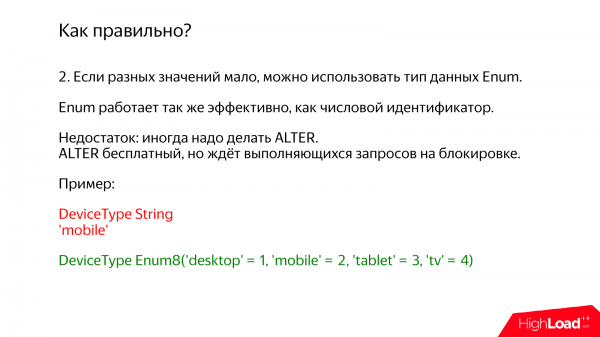
Druhý variant je podobný, ale už s podporou vnútri ClickHouse. To je typ dát Enum. Jednoducho do Enum zapíšete všetky potrebné hodnoty. Napríklad, typ zariadenia a tam napíšete: desktop, mobilný, tablet, televízor. Celkovo 4 varianty.
Nevýhodou je, že je potrebné čas od času robiť alter. Pridali sme len jeden variant. Robíme alter table. V skutočnosti je alter table v ClickHouse zadarmo. Osobitne zadarmo pre Enum, pretože dáta na disku sa nemenia. Napriek tomu však alter uzamkne tabuľku a musí počkať, kým sa vykonajú všetky selects. A až potom sa alter vykoná, čo znamená, že niektoré nepríjemnosti tu sú.
* V novších verziách ClickHouse je ALTER úplne neblokujúci.
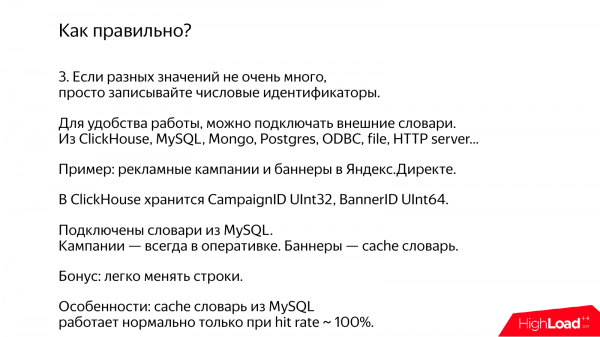
Ďalší dostatočne unikátny variant pre ClickHouse – to je pripojenie externých slovníkov. Môžete zapisovať čísla do ClickHouse a vaše prehľady držať v akomkoľvek systéme, ktorý vám vyhovuje. Napríklad, môžete použiť: MySQL, Mongo, Postgres. Môžete dokonca vytvoriť svoj mikroslužbu, ktorá bude cez http poskytovať tieto dáta. A na úrovni ClickHouse napíšete funkciu, ktorá tieto dáta prevedie z čísel na reťazce.
Toto je špecializovaný, no veľmi efektívny spôsob, ako vykonať join s externou tabuľkou. Existujú dva varianty. V jednom variante budú tieto údaje úplne vyrovnávané, budú plne v operačnej pamäti a budú sa aktualizovať s určitou periódou. V druhom variante, ak sa tieto údaje nezmestia do operačnej pamäte, môžeme ich čiastočne vyrovnať.
Tu je príklad. Existuje Yandex.Direct. A tam sú reklamné kampane a bannery. Reklamných kampaní je pravdepodobne okolo desať miliónov. A zhruba sa zmestia do operačnej pamäte. Ale bannerov je miliardy, tie sa nezmestia. A používame cachovaný slovník z MySQL.
Jediným problémom je, že cachovaný slovník bude fungovať normálne, ak je hit rate blízko 100 %. Ak je nižší, tak pri spracovaní požiadaviek na každú dávku údajov bude potrebné skutočne získať chýbajúce kľúče a vyzdvihnúť údaje z MySQL. O ClickHouse ešte môžem povedať, že - áno, nezadržiava, o iných systémoch rozprávať nebudem.
A ako bonus je to, že slovníky sú veľmi jednoduchý spôsob, ako aktualizovať údaje v ClickHouse pozadu. T. j. mali ste report o reklamných kampaniach, používateľ jednoducho zmenil reklamnú kampaň a vo všetkých starých údajoch, vo všetkých reportoch, sa tieto údaje tiež zmenili. Ak by ste zapisovali riadky priamo do tabuľky, aktualizovať ich by bolo nemožné.
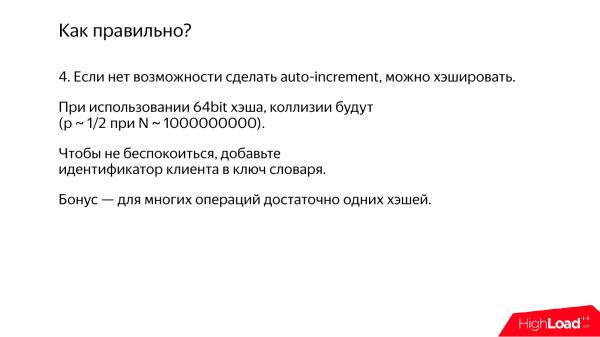
Ďalším spôsobom, keď neviete, odkiaľ vziať identifikátory pre vaše riadky, je jednoducho ich zahashovať. A najjednoduchšia možnosť je zobrať 64-bitový hash.
Jediný problém je, že ak je hash 64-bitový, kolízie sa vám takmer určite vyskytnú. Pretože ak tam máte miliardu riadkov, pravdepodobnosť sa už stáva významnou.
A nebolo by veľmi dobré takto hashovať mená reklamných kampaní. Ak sa reklamné kampane rôznych spoločností pomýlia, bude to niečo neprehľadné.
A existuje jednoduchý trik. Pravda, pro vážná data to také není moc vhodné, ale pokud jde o něco méně důležitého, stačí do klíče slovníku přidat ještě identifikátor klienta. Pak budou kolize, ale jen v rámci jednoho klienta. Tento způsob používáme pro mapu odkazů v Yandex.Metrice. Máme tam URL adresy, ukládáme hash. A víme, že kolize samozřejmě existují. Ale když se zobrazí stránka, pravděpodobnost, že na jedné stránce u jednoho uživatele se nějaké URL adresy sloučily a ještě si toho někdo všimne, je obvykle zanedbatelná.
Jako bonus – pro mnoho operací stačí pouze hashe a samotné řetězce nemusí být nikde ukládány.
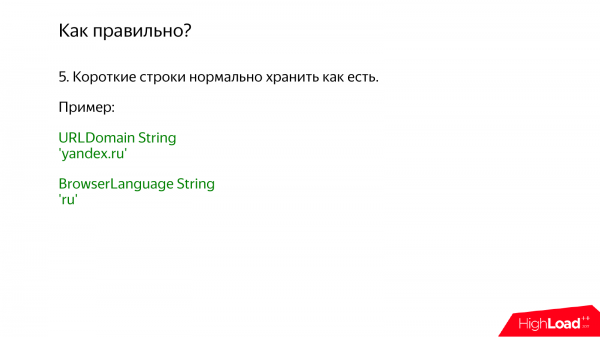
Další příklad je, pokud jsou řetězce krátké, například domény stránek. Ty lze uchovávat tak, jak jsou. Nebo třeba jazyk prohlížeče ru – 2 bajty. Samozřejmě, je mi líto každý byte, ale nebojte se, 2 bajty nejsou problém. Prosím, uchovávejte je tak, jak jsou, a neomezujte se.
Jiný případ je, když máme naopak hodně řetězců a v nich je hodně unikátních hodnot, přičemž množství není omezeno. Typickým příkladem jsou vyhledávací fráze nebo URL adresy. Vyhledávací fráze, včetně těch s překlepy. Podíváme se, kolik unikátních vyhledávacích frází máme za den. A zjistíme, že jich je téměř polovina ze všech událostí. A v tomto případě byste si mohli myslet, že je třeba data normalizovat, spočítat identifikátory a uložit do samostatné tabulky. Ale tak to dělat nemusíte. Jen je prostě uchovávejte tak, jak jsou.
Lepší je – nic si nevymýšlet, protože pokud je budete uchovávat odděleně, bude potřeba provádět join. A ten join – to je v tom nejlepším případě náhodný přístup do paměti, pokud se to vůbec vejde do paměti. Pokud ne, budou s tím úplně problémy.
A pokud jsou data ukládána na místě, pak se jednoduše načítají v požadovaném pořadí z souborového systému a všechno je v pořádku.
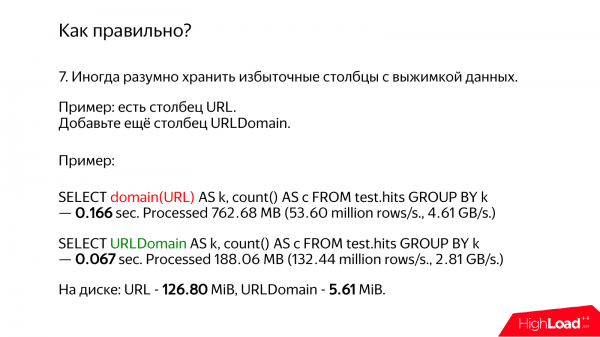
Pokud máte URL adresy nebo nějaké složité dlouhé řetězce, stojí za to uvažovat o tom, že byste mohli předem spočítat nějakou zkratku a zapsat ji do samostatného sloupce.
Pro URL adresy můžete například zvlášť uchovávat doménu. A pokud skutečně potřebujete doménu, prostě použijte tento sloupec, zatímco URL adresy budou uloženy a k nim se ani nedotknete.
Pozrime sa na rozdiel. V ClickHouse je špecializovaná funkcia, ktorá počíta doménu. Je veľmi rýchla, optimalizovali sme ju. A úprimne, ani to nevyhovuje RFC, ale aj tak počíta všetko, čo potrebujeme.
V jednom prípade jednoducho vytiahneme URL a vypočítame doménu. Dostaneme 166 milisekúnd. A ak vezmeme hotovú doménu, vychádza to iba 67 milisekúnd, t. j. takmer trikrát rýchlejšie. Rýchlejšie to nie je preto, že by sme museli robiť nejaké výpočty, ale preto, že čítame menej dát.
Prečo má jeden dopyt, ktorý je pomalší, väčšiu rýchlosť gigabajtov za sekundu? Lebo číta viac gigabajtov. Sú to úplne zbytočné dáta. Dopyt vlastne funguje rýchlejšie, ale trvá dlhšie.
Ak sa pozrieme na objem dát na disku, zistíme, že URL má 126 megabajtov, zatiaľ čo doména iba 5 megabajtov. To je 25-krát menej. Napriek tomu sa dopyt vykonáva iba 4-krát rýchlejšie. Ale to je preto, že dáta sú horúce. Ak by boli studené, určite by to bolo 25-krát rýchlejšie kvôli diskovému vstupu a výstupu.
Mimochodom, ak odhadneme, koľko je doména menšia ako URL, vyjde to niekde okolo 4-krát. Ale z nejakého dôvodu dáta na disku zabierajú 25-krát menej. Prečo? Kvôli kompresii. A URL je komprimované, a doména je komprimovaná. Ale často URL obsahuje množstvo odpadu.
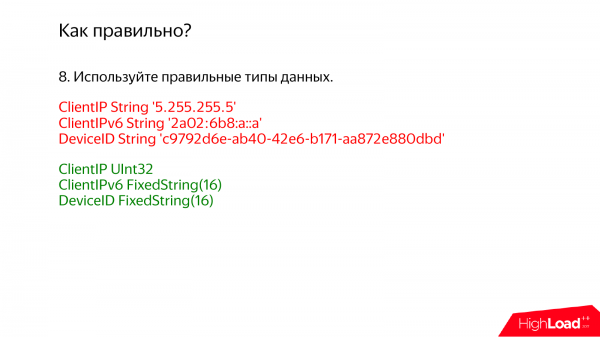
A samozrejme, je potrebné používať správne typy dát, ktoré sú špeciálne určené pre dané hodnoty alebo ktoré sa hodia. Ak máte IPv4, používajte UInt32*. Ak IPv6, tak FixedString(16), pretože IPv6 adresa má 128 bitov, t. j. uložte ju priamo v binárnom formáte.
Čo robiť, ak máte niekedy IPv4 adresy a inokedy IPv6? Áno, môžete uchovávať obe. Jeden stĺpec pre IPv4, druhý pre IPv6. Samozrejme, existuje možnosť zobraziť IPv4 v IPv6. To tiež bude fungovať, ale ak často potrebujete presne IPv4 adresu, bolo by dobré ju uložiť do samostatného stĺpca.
* teraz v ClickHouse existujú samostatné typy dát IPv4, IPv6, ktoré ukladajú údaje rovnako efektívne ako čísla, ale zobrazujú ich rovnako pohodlne ako reťazce.
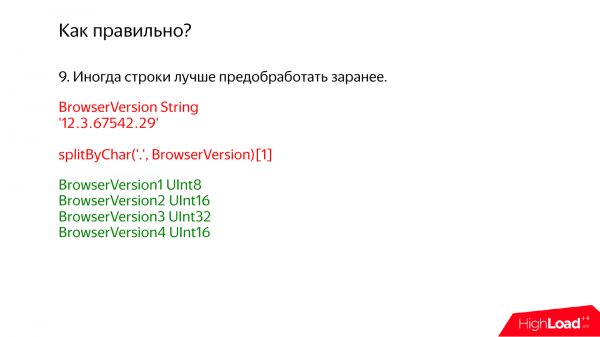
Je dôležité poznamenať, že je vhodné údaje predspracovať vopred. Napríklad, ak k vám prídu nejaké surové logy. A možno nie je najlepšie ich hneď poslať do ClickHouse, aj keď je lákavé nič neurobiť a všetko bude fungovať. Ale predsa len by ste mali vykonať výpočty, ktoré sú možné.
Napríklad, verzia prehliadača. V nejakom susednom oddelení, na ktoré sa mi nechce ukazovať prstom, sa verzia prehliadača uchováva takto, t. j. ako reťazec: 12.3. A potom, aby vytvorili report, vezmú tento reťazec a rozdelia ho na pole, a potom na prvú položku poľa. Samozrejme, všetko spomalí. Pýtal som sa, prečo to tak robia. Odpovedali mi, že nemajú radi predčasnú optimalizáciu. A ja nemám rád predčasnú pesimizáciu.
Takže v tomto prípade by bolo správnejšie rozdeliť na 4 stĺpce. Nebojte sa, pretože toto je ClickHouse. ClickHouse je stĺpcová databáza. A čím viac presných malých stĺpcov, tým lepšie. Ak bude 5 BrowserVersion, urobte 5 stĺpcov. To je v poriadku.
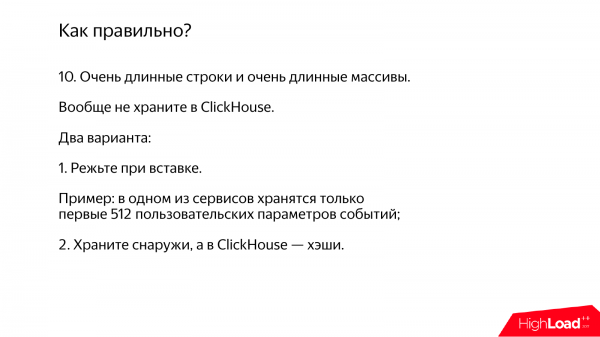
Poďme sa teraz pozrieť, čo robiť, ak máte veľa veľmi dlhých reťazcov, veľmi dlhých polí. Nemusíte ich vôbec uchovávať v ClickHouse. Namiesto toho môžete v ClickHouse uložiť len nejaký identifikátor. A tieto dlhé reťazce si dajte do iného systému.
Napríklad, v jednom z našich analytických služieb sú niektoré parametre udalostí. A ak na udalosti prichádza veľa parametrov, jednoducho uložíme prvých 512, ktoré sa nám naskytnú. Pretože 512 nie je škoda.
A ak si nie ste istí svojimi typmi údajov, môžete tiež zapísať údaje do ClickHouse, ale do dočasnej tabuľky typu Log, špeciálnej pre dočasné údaje. Potom môžete analyzovať, aké máte rozdelenie hodnôt, čo vlastne existuje a zostaviť správne typy.
* teraz v ClickHouse existuje typ údajov ktorý umožňuje efektívne uchovávanie reťazcov s nižšími nárokmi na zdroje.
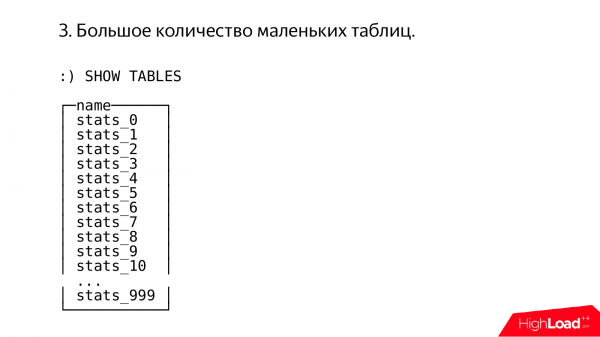
Poďme sa teraz pozrieť na ešte jeden zaujímavý prípad. Niekedy u ľudí všetko akosi zvláštne funguje. Vstúpim a vidím niečo také. A okamžite sa predstaviť, že to robil nejaký veľmi skúsený, múdry admin, ktorý má veľké skúsenosti so nastavovaním MySQL verzie 3.23.
Tu vidíme tisíc tabuliek, v každej z nich je zapísaný zostatok z delenia nejasne čoho na tisíc.
V podstate rešpektujem skúsenosti iných a chápem, aké utrpenia mohli viesť k týmto skúsenostiam.
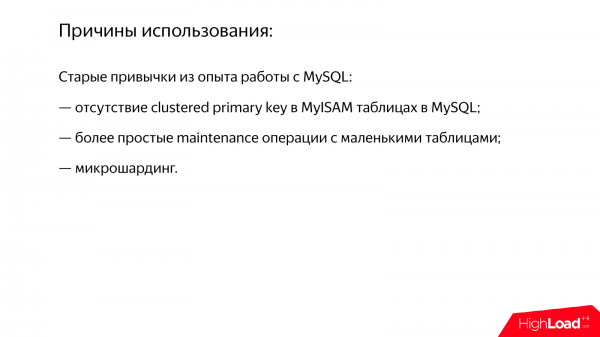
A dôvody sú viac-menej jasné. To sú staré stereotypy, ktoré sa mohli nahromadiť počas práce s inými systémami. Napríklad, v tabuľkách MyISAM neexistuje klastrový primárny kľúč. Takýto spôsob delenia dát môže byť zúfalým pokusom získať rovnakú funkčnosť.
Ďalší dôvod spočíva v tom, že akékoľvek operácie ako alter s veľkými tabuľkami sú ťažké. Všetko bude zablokované. Hoci v súčasných verziách MySQL už tento problém nie je taký vážny.
Alebo, napríklad, mikrošardovanie, ale o tom si povieme neskôr.
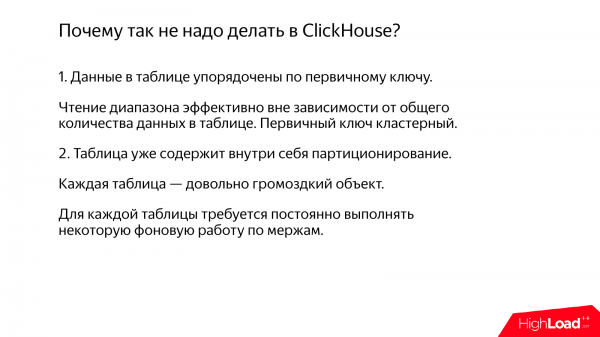
V ClickHouse to takto robiť netreba, pretože, po prvé, primárny kľúč je klastrový a dáta sú usporiadané podľa primárneho kľúča.
A niekedy sa ma pýtajú: „Ako sa mení výkonnosť rozsahových dotazov v ClickHouse v závislosti od veľkosti tabuľky?“. Hovorím, že sa vôbec nemení. Napríklad, máte tabuľku s miliardou riadkov a čítate rozsah jeden milión riadkov. Všetko je v poriadku. Ak je tabuľka s triliónom riadkov a čítate jeden milión riadkov, bude to skoro to isté.
A za druhé, nepotrebujete žiadne ručné partície. Ak sa pozriete na súborový systém, uvidíte, že tabuľka je dosť významná záležitosť. A vo vnútri je niečo ako partície. Teda ClickHouse všetko robí za vás a nemusíte trpieť.
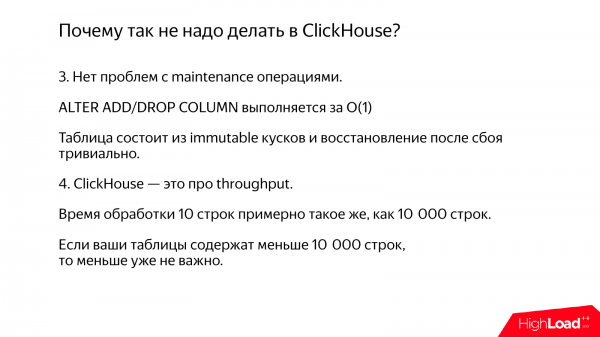
Alter v ClickHouse je bezplatný, ak ide o alter add/drop column.
A malé tabuľky netreba robiť, pretože ak máte v tabuľke 10 riadkov alebo 10 000 riadkov, nie je to vôbec dôležité. ClickHouse je systém, ktorý optimalizuje priepustnosť, a nie latenciu, takže mať 10 riadkov na spracovanie nemá zmysel.
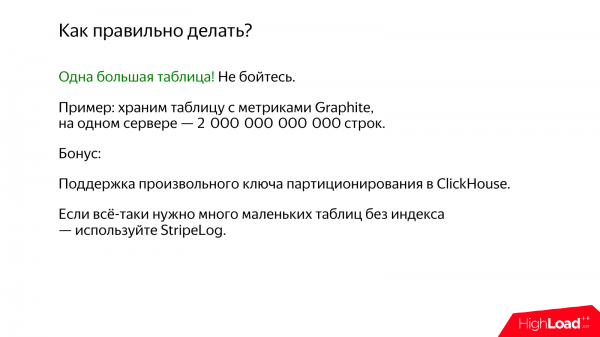
Správne je používať jednu veľkú tabuľku. Zbavte sa starých stereotypov, všetko bude v poriadku.
A ako bonus, v našej poslednej verzii sa objavila možnosť robiť ľubovoľný kľúč particionovania na vykonávanie rôznych údržbových operácií nad jednotlivými partíciami.
Napríklad, potrebujete veľa malých tabuliek, keď je potreba spracovania nejakých medzičasových údajov, prichádzajú vám časti a musíte nad nimi vykonať transformáciu predtým, než ich zapíšete do konečnej tabuľky. Pre tento prípad existuje skvelý engine tabuliek – StripeLog. Je to približne ako TinyLog, len lepšie.
* teraz v ClickHouse existuje aj .
Ďalší antipattern – mikrosharding. Napríklad, potrebujete shardovať údaje a máte 5 serverov, ale zajtra bude 6 serverov. A rozmýšľate, ako tieto údaje prebalancovať. Namiesto toho rozdelíte nie na 5 shardov, ale na 1 000 shardov. A ďalej mapujete každý z týchto mikroshardov na samostatný server. A na jednom serveri sa tak môže napríklad nachádzať 200 ClickHouse, napríklad. Samostatné inštancie na rôznych portoch alebo samostatné databázy.
Ale v ClickHouse to nie je veľmi dobre. Pretože aj jeden inštančný ClickHouse sa snaží využiť všetky dostupné zdroje servera na spracovanie jedného dopytu. T. j. máte nejaký server a tam je napríklad 56 procesorových jadier. Vykonávate dopyt, ktorý trvá jednu sekundu, a ten využíva 56 jadier. A ak ste umiestnili 200 ClickHouse na jeden server, tak sa spustí 10 000 vlákien. V skratke, všetko bude veľmi zlé.
Ďalší dôvod je ten, že rozdelenie práce medzi týmito inštanciami bude nevyvážené. Nejaká z nich skončí skôr, iná skončí neskôr. Keby sa to všetko dialo v jednej inštancii, ClickHouse by sám vedel, ako správne rozdeliť údaje medzi vláknami.
A ešte jeden dôvod je, že budete mať medziprocesorovú komunikáciu cez TCP. Údaje bude potrebné serializovať, deserializovať a s týmto obrovským množstvom mikroshardov to jednoducho nebude efektívne.
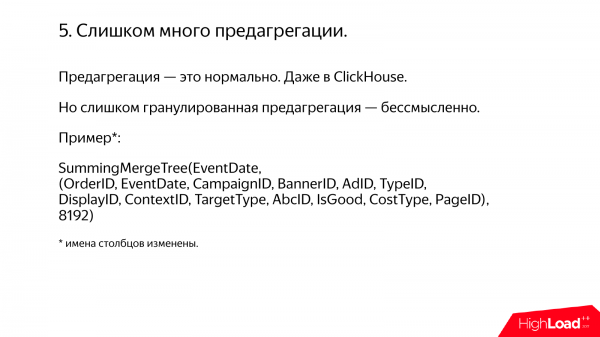
Ďalší antipattern, aj keď to ťažko nazvať antipatternom. Je to veľké množstvo predagregácie.
Celkom, predagregácia – to je dobre. Mali ste miliardu riadkov, aggreovali ste ich a vzniklo 1 000 riadkov, a teraz sa dopyt vykonáva okamžite. Všetko je skvelé. Takto sa to dá robiť. A pre to má ClickHouse dokonca špeciálny typ tabuľky AggregatingMergeTree, ktorý robí inkrementálnu agregáciu počas vkladania údajov.
Existujú však prípady, keď si myslíte, že budeme agregovať údaje takto a ešte takto. A v nejakom vedľajšom oddelení, o ktorom sa mi tiež nechce hovoriť, používajú tabuľky SummingMergeTree na sčítať podľa primárneho kľúča, pričom ako primárny kľúč používajú približne 20 rôznych stĺpcov. Pre konšpiráciu som zmenil mená niektorých stĺpcov, ale je to asi takto.
A objavujú sa takéto problémy. Po prvé, objem vašich údajov sa nezmenšuje príliš výrazne. Napríklad zníženie je len trojnásobné. Trojnásobné zníženie by bola dobrá cena na to, aby ste si mohli dovoliť neobmedzené možnosti analytiky, ktoré prichádzajú, ak údaje nie sú agregované. Ak sú údaje agregované, dostanete namiesto analytiky len slabú štatistiku.
A čo je obzvlášť frustrujúce? To, že títo ľudia z vedľajšieho oddelenia chodia a občas žiadajú pridať ďalší stĺpec do primárneho kľúča. T. j. takto sme agregovali údaje, a teraz chceme niečo viac. Ale v ClickHouse nie je možné upraviť primárny kľúč. Preto je potrebné písať nejaké skripty v C++. A ja nemám rád skripty, ani keď sú v C++.
A ak sa pozriete na to, na čo bol ClickHouse vytvorený, tak neagregované údaje sú presne ten scenár, pre ktorý bol zrodený. Ak používate ClickHouse na neagregované údaje, robíte to správne. Ak však agregujete, je to niekedy odpustiteľné.
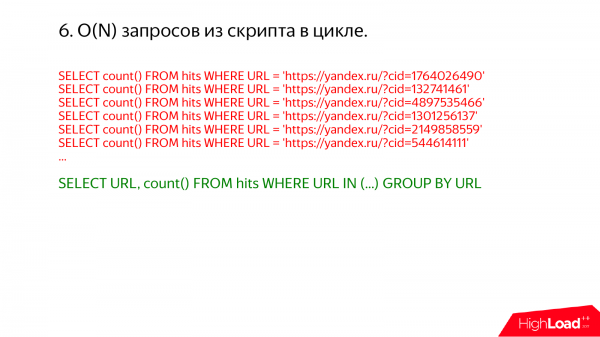
Ďalším zaujímavým prípadom sú dopyty v nekonečnej slučke. Niekedy sa prihlásim na nejaký produkčný server a pozriem sa na show processlist. A každý raz zistím, že sa deje niečo hrozné.
Napríklad toto. Tu je jasné, že všetko sa dalo vykonať v jednom dopyte. Stačí napísať tam url in a zoznam.
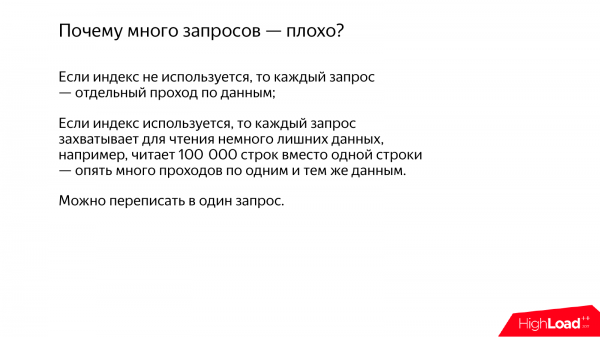
Prečo je veľa takých dopytov v nekonečnej slučke zlé? Ak sa index nepoužíva, budete mať veľa prechodov po tých istých údajoch. Ale ak sa index používa, napríklad máte primárny kľúč podľa ru a píšete url = niečomu. A myslíte si, že bude presne čítaný z tabuľky jeden url, bude to v poriadku. Ale v skutočnosti to tak nie je. Pretože ClickHouse robí všetko po dávkach.
Keď potrebuje prečítať určitý rozsah dát, číta o trochu viac, pretože index v ClickHouse je redovaný. Tento index neumožňuje nájsť v tabuľke jednu individuálnu položku, len určitý rozsah. A dáta sa komprimujú po blokoch. Na to, aby ste prečítali jednu položku, musíte vziať celý blok a dekomprimovať ho. A ak vykonávate množstvo dotazov, máte veľa takýchto prekrývaní, a veľa práce sa bude vykonávať znova a znova.
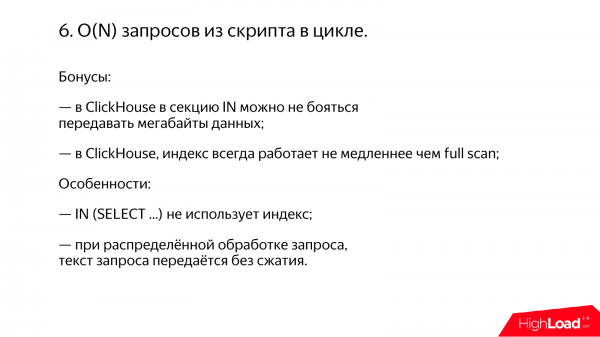
A ako bonus možno poznamenať, že v ClickHouse sa nemusíte báť posielať dokonca megabajty a stovky megabajtov do sekcie IN. Pamätám si z našej praxe, že ak v MySQL posielame veľa hodnôt do sekcie IN, napríklad posielame tam 100 megabajtov nejakých čísel, MySQL zje 10 gigabajtov pamäte a viac s tým nič neurobí, všetko funguje zle.
A druhá vec je, že v ClickHouse, ak vaše dotazy používajú index, tak to nikdy nie je pomalšie ako full scan, t. j. ak treba prečítať takmer celú tabuľku, ide postupne a prečíta celú tabuľku. V podstate sa s tým sám vysporiada.
Ale predsa existujú niektoré komplikácie. Napríklad to, že IN s poddotazom index nevyužíva. Ale to je náš problém a musíme to opraviť. Nič zásadné tu nie je. Budeme to opravovať*.
A ešte jedna zaujímavá vec – ak máte veľmi dlhý dotaz a rozdelené spracovanie dotazov prebieha, tak tento veľmi dlhý dotaz bude poslaný na každý server bez kompresie. Napríklad 100 megabajtov a 500 serverov. A, samozrejme, vám cez sieť prejde 50 gigabajtov. Bude prenesené a následne všetko úspešne vykonané.
* už používa; všetko sme opravili, ako bolo sľúbené.
A dosť častý prípad, ak dotazy prichádzajú z API. Napríklad ste vytvorili nejakú svoju službu. A ak je vaša služba niekomu potrebná, tak ste otvorili API a už doslova po dvoch dňoch vidíte, že sa deje niečo nepochopiteľné. Všetko je preťažené a prichádzajú nejaké hrozné dotazy, ktoré nikdy nemali byť.
A riešenie je jedno. Ak ste otvorili API, budete ho musieť orezávať. Napríklad zaviesť nejaké kvóty. Iné normálne možnosti nie sú. Inak okamžite napíšu skript a budú problémy.
V ClickHouse máte špeciálnu funkciu – počítanie kvót. Môžete predávať svoj kľúč kvóty. Napríklad, môže to byť interný identifikátor používateľa. Kvóty sa budú počítať samostatne pre každého z nich.
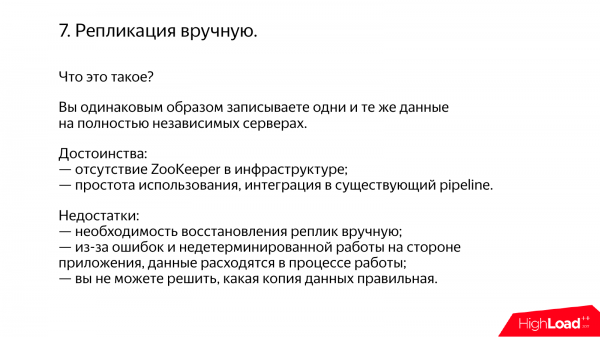
Teraz ďalšia zaujímavá vec. Je to replikácia na manuálny pohon.
Poznám množstvo prípadov, keď, aj keď ClickHouse má zabudovanú podporu replikácie, ľudia replikujú ClickHouse manuálne.
Aký je princíp? Máte pipeline na spracovanie údajov. A ten funguje nezávisle, napríklad, v rôznych dátových centrách. Rovnaké údaje zapisujete do ClickHouse rovnakým spôsobom. Pravda, prax ukazuje, že údaje sa aj tak rozchádzajú kvôli nejakým špecifikám vo vašom kóde. Dúfam, že vo vašom prípade nie.
A pravidelne budete musieť manuálne synchronizovať. Napríklad raz za mesiac administrátori robia rsync.
Naozaj je oveľa jednoduchšie používať zabudovanú replikáciu v ClickHouse. Ale tu môžu byť niektoré kontraindikácie, pretože na to potrebujete používať ZooKeeper. O ZooKeeperi nebudem hovoriť nič zlé, v zásade je systém funkčný, ale niektorí ľudia ho nepoužívajú z dôvodu java-fóbie, pretože ClickHouse je dobrý systém napísaný v C++, s ktorým sa dá pracovať a všetko bude skvelé. A ZooKeeper je na jave. A nejako sa nechce na to pozerať, ale potom môžete použiť replikáciu na manuálny pohon.
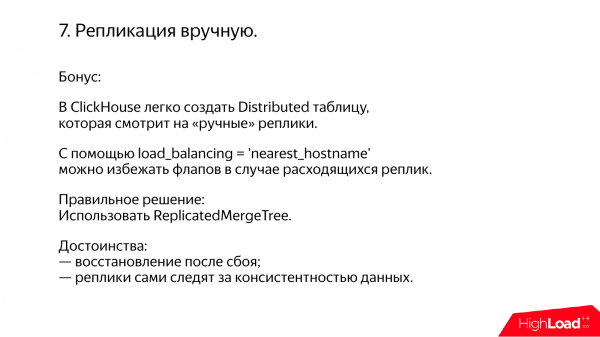
ClickHouse je praktický systém. Zohľadňuje vaše potreby. Ak máte replikáciu na manuálny pohon, môžete vytvoriť Distributed tabuľku, ktorá sleduje vaše manuálne repliky a sama robí failover medzi nimi. Existuje dokonca špeciálna možnosť, ktorá umožňuje vyhnúť sa zlyhaniam, aj keď sa vaše repliky systematicky rozchádzajú.
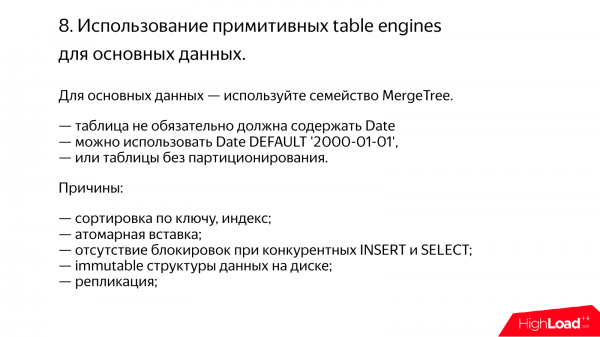
Sú možné problémy, ak používate primitívne table engines. ClickHouse je taký konštruktér, v ktorom je množstvo rôznych typov tabuliek. Pre všetky vážne prípady, ako je uvedené v dokumentácii, používajte tabuľky rodiny MergeTree. Ostatné sú len na samostatné prípady alebo na testovanie.
V tabuľke MergeTree nie je nutné, aby ste mali nejaký dátum a čas. Môžete ho stále používať. Ak nemáte dátum a čas, nastavte default – 2000 rok. To bude fungovať a nebude vyžadovať zdroje.
A v novej verzii servera môžete dokonca uviesť, aby ste mali vlastné rozdelenie bez kľúča partition. Bude to to isté.
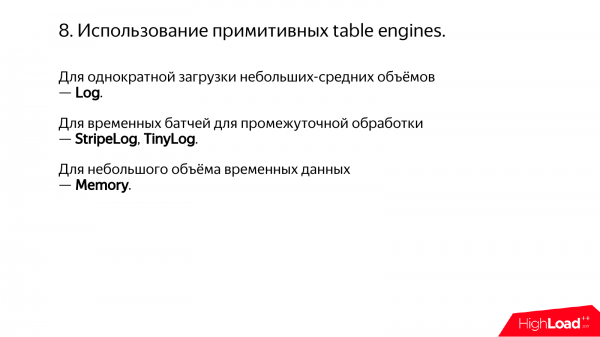
Na druhej strane, môžete použiť primitívne tabuľkové motory. Napríklad, načítať dáta raz a pozrieť sa, preklopiť a odstrániť. Môžete použiť Log.
Alebo uchovávanie malých objemov na medzizpracovanie – to je StripeLog alebo TinyLog.
Memory môžete použiť, ak máte malý objem dát a jednoducho skúšate niečo v operatívnej pamäti.
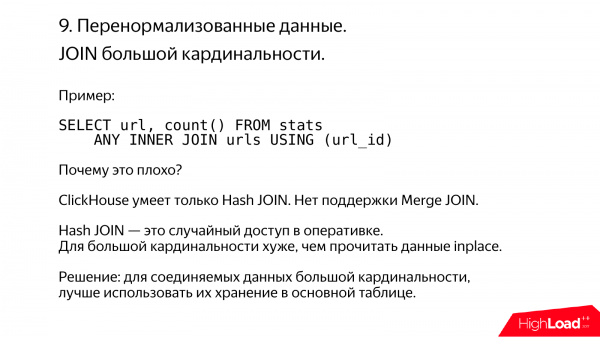
ClickHouse veľmi nepreferuje prenormalizované dáta.
Tu je typický príklad. Je to obrovské množstvo URL. Dali ste ich do susednej tabuľky. A potom ste sa rozhodli s nimi uskutočniť JOIN, ale to obvykle nebude fungovať, pretože ClickHouse podporuje iba Hash JOIN. Ak nie je dostatok pamäte pre množstvo dát, s ktorými sa má spojiť, JOIN nebude možné vykonať*.
Ak sú dáta veľkej kardinality, nebojte sa, uchovávajte ich v denormalizovanej podobe, URL priamo v hlavnej tabuľke.
* a teraz ClickHouse má aj merge join, ktorý funguje, keď sa medzidáta nezmestia do operatívnej pamäte. Ale to nie je efektívne a doporučenie zostáva v platnosti.
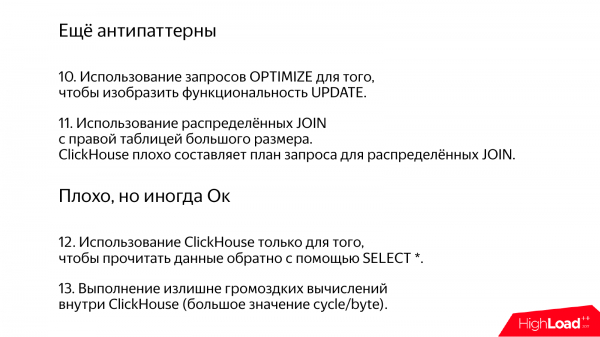
Ešte niekoľko príkladov, ale už pochybujem, či sú protikladné alebo nie.
V ClickHouse existuje jedna známa nevýhoda. Nevie vykonávať aktualizácie*. V istom zmysle je to dokonca dobré. Ak máte nejaké dôležité dáta, napríklad účtovníctvo, nikto ich nebude môcť odoslať, pretože aktualizácie neexistujú.
* dávno bola pridaná podpora pre update a delete v dávkovom režime.
Ale existujú niektoré špeciálne spôsoby, ktoré umožňujú aktualizácie akoby na pozadí. Napríklad tabuľky typu ReplaceMergeTree. Robia aktualizácie počas pozadových zlúčení. Môžete to vynútiť pomocou optimize table. Ale nerobte to príliš často, pretože to bude úplné prepísanie partition.
Distribuované JOIN v ClickHouse sú tiež ťažko spracovateľné plánovačom dotazov.
Zle, ale niekedy v poriadku.
Použitie ClickHouse iba na to, aby ste čítali dáta späť pomocou select*.
Odporúčam sa vyhnúť používaniu ClickHouse pre objemné výpočty. Ale nie je to úplne tak, pretože už z tejto rady ustupujeme. Nedávno sme pridali možnosť aplikovať modely strojového učenia v ClickHouse – Catboost. A to ma znepokojuje, pretože si hovorím: „Ako hrozné. Koľko cyklov sa vlastne na bajt spotrebuje!“. Je mi ľúto, že cykly idú na bajty.
Ale nebojte sa, nainštalujte si ClickHouse, všetko bude v poriadku. Ak niečo, máme komunitu. Mimochodom, komunita ste vy. A ak máte nejaké problémy, môžete aspoň zavítať do nášho chatu a dúfam, že vám pomôžu.
Otázky
Ďakujem za prezentáciu! Kde sa môžem sťažovať na pád ClickHouse?
Môžete sa sťažovať mne osobne hneď teraz.
Nedávno som začal používať ClickHouse. Hneď som zrútil cli rozhranie.
Máte šťastie.
Trochu neskôr som zrútil server malým selectom.
Máte talent.
Otváral som bug na GitHub, ale ignorovali ho.
Uvidíme.
Alexej ma podvodom nalákal na prednášku, sľúbil, že povie, ako stlačíte údaje vo vnútri.
Veľmi jednoducho.
To som ešte včera rozumel. Viac konkrétností.
Nie sú tam žiadne úžasné triky. Je tam jednoducho kompresia po blokoch. Predvolene sa používa LZ4, je možné aktivovať ZSTD*. Bloky od 64 kilobajtov do 1 megabajtu.
* existuje aj podpora špecializovaných kompresných kodekov, ktoré je možné použiť v reťazci s inými algoritmami.
Sú v blokoch len surové dáta?
Nie úplne surové. Sú tam polia. Ak máte číselný stĺpec, čísla sú uložené za sebou v poli.
Rozumiem.
Alexej, príklad, ktorý bol s uniqExact nad ip adresami, t. j. to, že uniqExact sa počíta dlhšie po reťazcoch ako po číslach a tak ďalej. A čo ak urobíme finty a budeme konvertovať v okamihu čítania? T. j. ste, akoby povedali, že na disku to moc nerôzni. Ak budeme čítať z disku reťazce a konvertovať, budú naše agregácie rýchlejšie alebo nie? Alebo tu predsa len nevyhráme nepatrne? Myslím, že ste to testovali, len to v benchmarku akosi nezazneli.
Myslím si, že to bude pomalšie ako bez castovania. V takom prípade je potrebné IP adresu z reťazca rozparsovať. U nás, samozrejme, je v ClickHouse parsovanie IP adries tiež optimalizované. Veľa sme sa snažili, ale čísla sú zapísané vo forme desatinného čísla. To je veľmi nepraktické. Na druhej strane, funkcia uniqExact bude na reťazcoch fungovať pomalšie nielen preto, že ide o reťazce, ale aj preto, že sa vyberá iná špecializácia algoritmu. Retyazce sa jednoducho spracúvajú inak.
A čo keby sme vzali primitívnejší typ údajov? Napríklad, sme zapísali user id, ktorý máme in, zapísali sme to ako reťazec a potom to spracovali, bude to zábavnejšie alebo nie?
Som skeptický. Myslím si, že to bude dokonca smutnejšie, pretože parsovanie čísel je vážny problém. Zdá sa mi, že tento kolega mal dokonca prednášku na tému, aké ťažké je parsovať čísla v desatinnom tvare, ale možno nie.
Alexej, veľmi pekne ďakujem za prednášku! A ešte raz ďakujem za ClickHouse! Mám otázku ohľadom plánov. Je v pláne funkcia pre aktualizáciu slovníkov nie úplne?
T. j. čiastočné obnovenie?
Áno-áno. Niečo ako možnosť zadať pole MySQL, t. j. aktualizovať po, aby sa nahrávali iba tieto údaje, ak je slovník veľmi veľký.
Veľmi zaujímavá funkcia. A myslím, že niekto to navrhol v našom chate. Možno to bol dokonca vy.
Nemyslím si, že ja.
Skvelé, teraz to vyzerá na dva dotazy. A môžeme začať v kľude pracovať. Ale chcem vás hneď varovať, že táto funkcia je veľmi jednoduchá na implementáciu. T. j. teoreticky stačí napísať do tabuľky číslo verzie a potom písať: verzia je menšia ako táto. A to znamená, že to pravdepodobne ponúkneme nadšencom. Ste nadšenec?
Áno, ale, žiaľ, nie v C++.
Vedia vaši kolegovia písať v C++?
Nájdem niekoho.
Skvelé*.
* funkcia bola pridaná dva mesiace po prednáške – vyvinul ju autor otázky a poslal svoj .
Ďakujeme!
Dobrý deň! Ďakujem za prednášku! Spomenuli ste, že ClickHouse veľmi dobre využíva všetky dostupné zdroje. A prednášajúci zo spoločnosti Luxoft hovoril o svojom riešení pre Poštu Ruska. Povedal, že sa im ClickHouse veľmi páčil, ale nepoužili ho namiesto svojho hlavného konkurenta práve preto, že zožral celý procesor. A nemohli ho zapojiť do svojej architektúry, do svojho ZooKeepera s docker-mi. Existuje nejaká možnosť, ako obmedziť ClickHouse, aby nespotrebovával všetko, čo sa mu stáva dostupným?
Áno, dá sa to a veľmi jednoducho. Ak chcete, aby spotreboval menej jadier, stačí napísať set max_threads = 1. A všetko, bude vykonávať dotazy na jednom jadre. A navyše, rôznym používateľom môžete nastaviť rôzne tieto nastavenia. Takže žiadne problémy. A kolegom z Luxoftu povedzte, že nie je dobré, že nenašli toto nastavenie v dokumentácii.
Alexey, dobrý deň! Chcel by som sa opýtať na jednu vec. Už nie prvýkrát počujem, že mnohí začínajú používať ClickHouse ako úložisko logov. Na prednáške ste hovorili, aby sa to nedialo, t.j. nie je potrebné uchovávať dlhé reťazce. Ako sa k tomu staviate?
Po prvé, logy nie sú zvyčajne dlhé reťazce. Samozrejme, sú aj výnimky. Napríklad, akýsi servis napísaný v jave vyhodí výnimku a tá sa loguje. A tak stále do nekonečna, a miesto na pevnom disku sa zaplní. Riešenie je veľmi jednoduché. Ak sú reťazce veľmi dlhé, tak ich skracujte. A čo znamená dlhé? Desiatky kilobajtov – to je zlé*.
* V nových verziách ClickHouse je zapnutá "adaptívna granularity indexu", čo väčšinou odstraňuje problém s uchovávaním dlhých reťazcov.
A kilobajt – to je normálne?
Normálne.
Dobrý deň! Ďakujem za prednášku! Už som sa na to pýtal v chate, ale nepamätám si, či som dostal odpoveď. Plánuje sa nejako rozšíriť sekcia WITH na spôsob CTE?
Zatiaľ nie. Sekcia WITH je u nás trochu neformálna. Máme ju ako malú funkciu.
Rozumiem. Ďakujem!
Ďakujem za prednášku! Veľmi zaujímavé! Veľká otázka. Plánuje sa vytvorenie, možno vo forme nejakých záložiek, modifikácia odstraňovania údajov?
Určite. Toto je naša prvá úloha v našom zozname. Aktívne premýšľame, ako všetko robiť správne. A mali by sme začať klikať na klávesnicu*.
* stlačili ste klávesy na klávesnici a všetko ste urobili.
Ovplyvní to nejakým spôsobom výkon systému alebo nie? Bude vkladanie rovnako rýchle ako doteraz?
Možno samotné mazania a aktualizácie budú veľmi náročné, ale na výkon vyhľadávaní a vkladania to nebude mať vplyv.
A ešte jedna malá otázka. Na prezentácii ste hovorili o primárnom kľúči. Teda máme partície, ktoré sú predvolene mesačné, je to správne? A keď zadáme rozsah dát, ktorý sa zmestí do mesiaca, tak sa načíta iba táto partícia, je to tak?
Áno.
Mám takú otázku. Ak nemôžeme určiť žiadny primárny kľúč, je správne urobiť ho na základe poľa „Dátum“, aby v pozadí bolo menej prestavieb týchto údajov, aby boli usporiadané? Ak nemáte rozsahové dopyty a ani nemôžete vybrať žiadny primárny kľúč, má zmysel zahrnúť dátum do primárneho kľúča?
Áno.
Možno by malo zmysel zahrnúť do primárneho kľúča také pole, podľa ktorého budú údaje lepšie komprimované, ak budú zoradené podľa tohto poľa. Napríklad identifikátor užívateľa. Užívateľ, povedzme, navštevuje tú istú stránku. V tomto prípade zahrňte id užívateľa a čas. A potom sa údaje budú lepšie komprimovať. Čo sa týka dátumu, ak naozaj nemáte a nikdy nemáte rozsahové dopyty týkajúce sa dátumov, môžete dátum nezahrnúť do primárneho kľúča.
Dobre, veľmi pekne ďakujem!
Zdroj: habr.com
